Monitoraggio dell'integrità dei dati: una guida pratica per il 2026
|
7
min di lettura

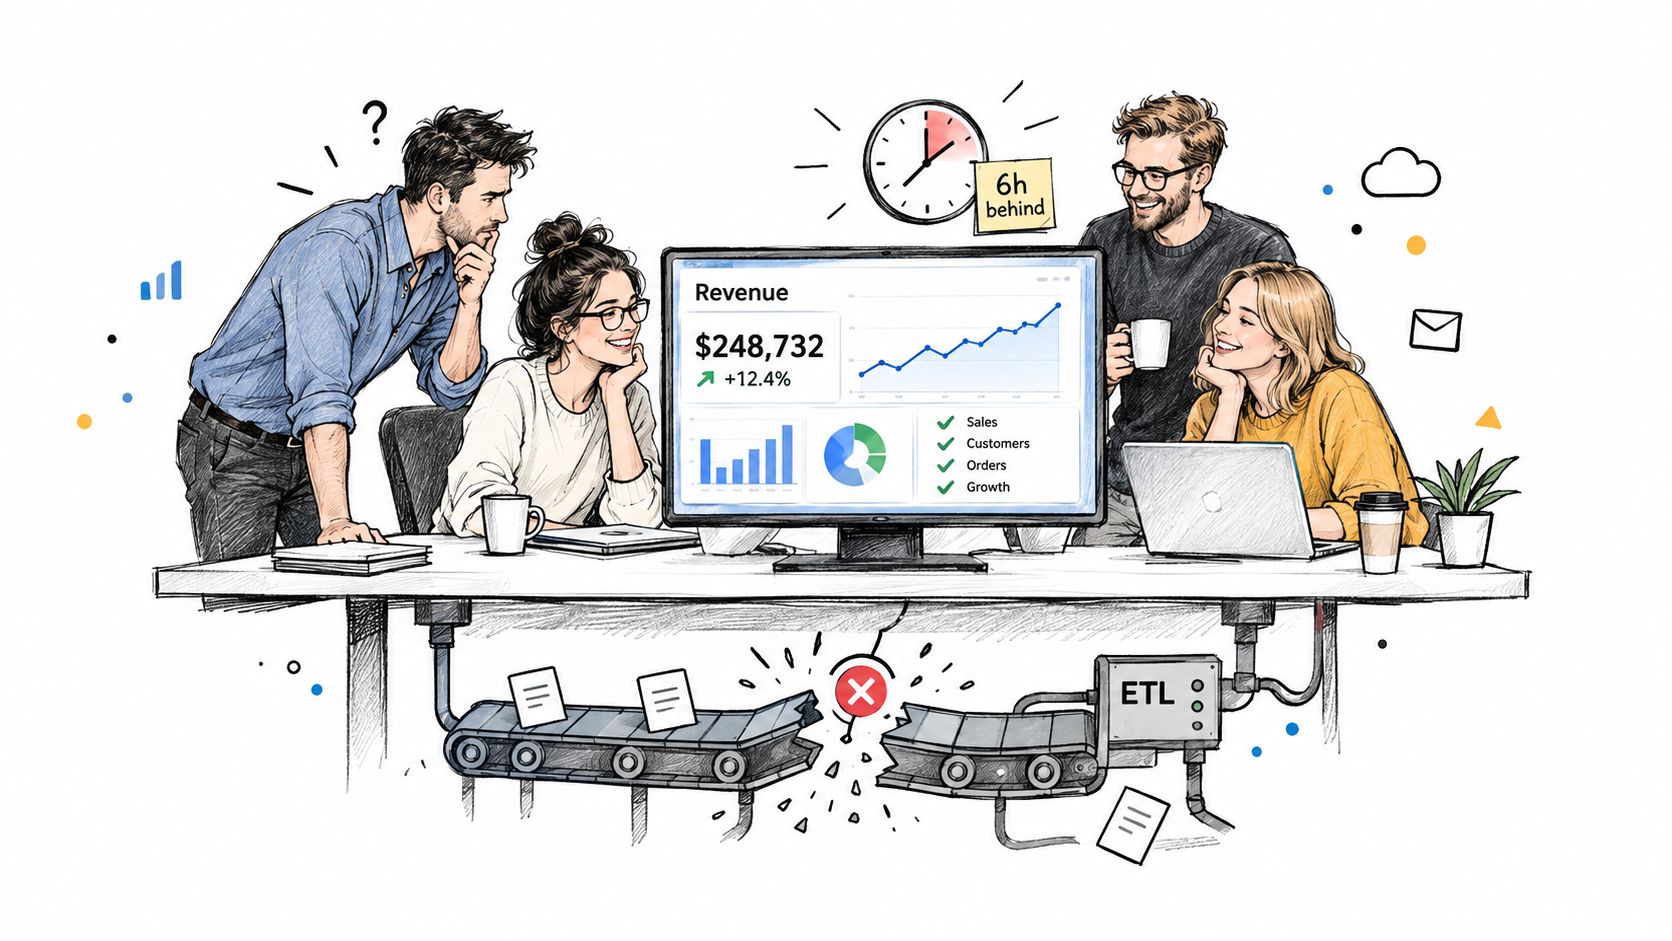
Le vostre dashboard raramente falliscono con un crollo clamoroso. Più spesso, qualcuno dell'area finance apre una vista dei ricavi il lunedì, vede i numeri di ieri e presume che l'azienda vada bene. Sotto la superficie, una tabella sorgente ha smesso di aggiornarsi, un job del fine settimana ha saltato un caricamento e un modello di AI già addestrato sui dati della settimana scorsa ora prende decisioni sicure su input obsoleti.
Ecco perché il monitoraggio dell'integrità dei dati conta oggi. Non è un'attività di pulizia di back-end e non equivale a test occasionali. È un livello di controllo continuo che sorveglia le interruzioni di freschezza, volume, distribuzione, schemae lineage, così i team vedono i guasti silenziosi prima degli stakeholder. Una rassegna accademica presenta questi cinque pilastri come il quadro di riferimento fondamentale per capire se i dati arrivano in tempo, mantengono le proprietà statistiche attese, restano completi, conservano la struttura e mantengono una provenienza tracciabile: esattamente il tipo di visibilità di cui hanno bisogno le pipeline moderne rassegna accademica.
Un modello mentale utile è considerare il monitoraggio dell'integrità come la rete di sicurezza tra un test e l'altro. I test vi dicono se una regola nota è ancora rispettata. Il monitoraggio vi dice se il sistema è scivolato in uno stato che più avanti romperà report, modelli o automazioni a valle. Se vi occupate già di rilevamento delle anomalie, una lettura complementare pratica è la guida di ELECTE per trovare pattern nascosti nei dati, perché lo stesso istinto vale quando il pattern che vi interessa è il degrado silenzioso delle pipeline.
Se state applicando tutto questo al vostro stack, anche il livello delle dashboard conta. Una vista condivisa di incidenti, trend e stato diventa molto più utile quando è supportata da controlli continui e non solo da verifiche a campione. Un'implementazione di riferimento per questo tipo di visibilità sono le dashboard di qualità dei dati di digna, che riflettono la stessa idea operativa da un'angolazione diversa.
Indice
Il momento in cui una dashboard si rompe senza che nessuno se ne accorga
Perché il monitoraggio dell'integrità è oggi un livello strategico
Il momento in cui una dashboard si rompe senza che nessuno se ne accorga
Il lunedì inizia con un messaggio che nessuno vuole ricevere. Il caricamento nel warehouse che doveva arrivare durante la notte non si è concluso correttamente, la tabella sorgente è vecchia di sei ore e la dashboard direzionale mostra ancora i ricavi di ieri senza alcun banner di errore. Nemmeno il team di prodotto se ne accorge, perché il modello di raccomandazione rilasciato la settimana scorsa continua a girare sulla vecchia coorte.
È proprio per questa modalità di guasto che è stato pensato il monitoraggio dell'integrità dei dati . Lo scopo è osservare i dati stessi, in modo continuo, così che caricamenti obsoleti, record mancanti, modifiche di schema e catene di dipendenze interrotte emergano quando c'è ancora tempo per intervenire.
Un guasto rumoroso è facile da individuare. La pipeline si rompe, scatta un alert e qualcuno viene chiamato. Un guasto silenzioso è più difficile, perché i numeri sembrano ancora credibili mentre i dati sottostanti si sono allontanati abbastanza da distorcere una decisione.
Regola pratica: se un controllo scatta solo dopo che uno stakeholder si è lamentato, è troppo tardi per chiamarlo monitoraggio.
È anche per questo che questo livello è diverso dai test una tantum. I test di solito avvengono in corrispondenza del deployment o dei punti di validazione. Il monitoraggio dell'integrità dei dati si colloca nel mezzo del ciclo di vita e osserva lo stato attivo della pipeline mentre cambia, come una sala di controllo che continua a verificare gli indicatori mentre la macchina è già in funzione.
La distinzione conta per i team che gestiscono sia analytics sia ML. Un modello può continuare a produrre previsioni quando la tabella di input è obsoleta, lo schema è cambiato o un feed sorgente ha smesso di inviare righe. Non si blocca nulla, ma la logica di business si degrada comunque. Ecco perché il livello di monitoraggio deve verificare sia che il job sia stato eseguito sia che i dati siano ancora affidabili.
Le configurazioni più solide correlano anche più segnali contemporaneamente. La sola freschezza può non accorgersi delle duplicazioni. Il solo volume può non accorgersi di una modifica di schema che elimina una colonna senza cambiare il numero di righe. I soli controlli di schema possono non accorgersi di un file in ritardo che arriva integro ma troppo tardi per supportare il reporting. Un'implementazione di riferimento per questo tipo di visibilità sono le dashboard di qualità dei dati di digna, che mostrano come le viste sugli incidenti possano affiancare i controlli continui. Per capire meglio come observability e viste sugli incidenti si integrano, una dashboard condivisa degli incidenti è utile perché riflette il tipo di visibilità operativa di cui i team hanno bisogno quando vanno oltre i controlli manuali a campione.
Le cinque lenti del monitoraggio dell'integrità dei dati
Pensate al triage di un pronto soccorso. Un medico non fa una diagnosi basandosi su un solo segnale. Controlla il polso, fa domande, esamina gli esami del sangue, guarda le immagini diagnostiche e confronta lo stato attuale con l'anamnesi e la storia familiare. Le pipeline di dati meritano la stessa disciplina.

Freschezza, volume, distribuzione, schema e lineage
La freschezza indica se i dati sono arrivati in tempo. Se il vostro feed delle vendite arriva di solito prima delle 6 del mattino e alle 8 non è ancora arrivato, non è un problema teorico: è reporting obsoleto. Lo stesso vale per job batch in ritardo, caricamenti incrementali saltati e feed dei partner in ritardo. Una guida alla data observability raggruppa freschezza, disponibilità, volume e modifiche di schema tra i controlli fondamentali per il monitoraggio dei dataset guida dasca.
Il volume considera il numero di righe, le dimensioni dei file e altri segnali basati sui conteggi. Un calo improvviso può significare che un estrattore a monte ha fallito. Un picco improvviso può indicare duplicati o una rielaborazione accidentale. Il numero in sé non spiega la causa, ma vi dice che qualcosa è cambiato.
La distribuzione riguarda intervalli, tassi di null, cardinalità e pattern dei valori. Qui emergono picchi improvvisi di null, equilibri tra categorie alterati e valori fuori famiglia. È la differenza tra “la tabella è stata caricata” e “i dati sembrano ancora lo stesso tipo di dati”.
Lo schema intercetta colonne aggiunte, rimosse, rinominate o con tipo modificato. Queste modifiche sono spesso il motivo per cui l'SQL a valle si rompe o i modelli dbt iniziano a restituire risultati incompleti. Un cambiamento strutturale è facile da non notare se guardate solo al successo dei job.
Il lineage traccia da dove provengono i dati e cosa dipende da essi. Questo conta quando dovete sapere se un difetto è nato in un'estrazione dalla sorgente, in una trasformazione o in un consumer a valle. È anche ciò che aiuta i team a capire perché un solo campo guasto può influire contemporaneamente su più dashboard.
I singoli segnali possono indicare un sintomo. I segnali correlati indicano la causa.
Questa è la lezione centrale. Un monitoraggio maturo non scatta semplicemente su una singola anomalia. Correla più lenti, così i team possono distinguere tra una tabella obsoleta, un'oscillazione dovuta alla stagionalità del business e un vero guasto della pipeline. Se volete un esempio pratico di come questi segnali si combinano in una vista di monitoraggio, la pagina data observability di digna rispecchia da vicino questo modello a cinque lenti.
Perché il monitoraggio dell'integrità è oggi un livello strategico
Qualche anno fa molti team consideravano la qualità dei dati un lavoro di pulizia. Si correggevano le righe errate, si sistemava la dashboard e si passava oltre. Questa mentalità non regge più quando analytics e AI iniziano a guidare le decisioni su larga scala.
Il cambiamento del settore è visibile nei dati di adozione. Un sondaggio del 2026 ha rilevato che solo il 35-36 percento circa delle organizzazioni monitora od ottimizza attivamente i propri programmi di integrità dei dati, mentre circa il 15-16 percento è ancora in fase di pre-pianificazione sondaggio. Ciò significa che la pratica è entrata nelle operations mainstream, ma è ancora lontana dall'essere universale.
Perché l'AI alza la posta in gioco
I sistemi di AI non si limitano a consumare dati, li amplificano. Se l'input è obsoleto, incompleto o strutturalmente modificato, il modello può comunque produrre un output dall'aspetto pulito. Quell'output può essere sbagliato, ma spesso sembrerà sicuro, ed è proprio questo a rendere il problema pericoloso.
Ecco perché il monitoraggio dell'integrità non è più solo una questione di igiene tecnica. Funziona da control plane per la preparazione all'AI, perché i team hanno bisogno di prove che i dati che alimentano analytics e modelli siano aggiornati, completi e tracciabili. Aiuta anche in termini di governance e verificabilità, perché il lineage e le modifiche strutturali diventano visibili invece di restare sepolti in log ad hoc.
A chi interessa e perché
Fattore | Stakeholder | Cosa si rompe senza monitoraggio |
|---|---|---|
Preparazione all'AI | Team data e ML | I modelli vengono addestrati o eseguono lo scoring su dati obsoleti, incompleti o strutturalmente modificati |
Governance | Team di rischio e compliance | I team non riescono a dimostrare cosa è cambiato, quando è cambiato o su cosa ha influito |
Affidabilità operativa | Team di piattaforma e di analytics | Dashboard, trasformazioni e consumer a valle derivano prima che qualcuno se ne accorga |
Il punto strategico è semplice. Se manca il monitoraggio dell'integrità dei dati, il costo non è solo una dashboard sbagliata. È una catena di decisioni sbagliate prese più velocemente grazie all'automazione. Per i team che valutano i controlli operativi, l'impostazione del monitoraggio della qualità dei dati di digna è utile perché tratta l'integrità come un controllo permanente anziché come un intervento di pulizia una tantum.
Approcci di monitoraggio che funzionano davvero a confronto
Non tutti gli approcci di monitoraggio vanno bene ovunque. Il design giusto dipende da dove risiedono i dati, dalla velocità con cui cambiano e da quanto rumore il vostro team può assorbire. I programmi migliori di solito combinano più metodi invece di puntare su uno solo.
Dove ogni approccio eccelle e dove fatica
L'esecuzione in-database mantiene i controlli vicino ai dati. Questo riduce gli spostamenti, il che conta negli ambienti sicuri o ad alto volume, ed è adatto ai team che vogliono che la logica di validazione venga eseguita dove si trovano già il warehouse o il lake. Il compromesso, però, è evidente. Ereditate i vincoli della piattaforma su cui lavorate, quindi la portabilità può essere più limitata rispetto agli strumenti esterni.
Gli scanner esterni sono più flessibili tra sistemi diversi. Possono ispezionare file, API, warehouse e applicazioni a valle dall'esterno del perimetro del database. Questa flessibilità comporta un overhead, soprattutto quando gli ambienti diventano grandi o quando cercate di mantenere bassa la latenza.
Le soglie basate su regole sono facili da comprendere. Intercettano i guasti evidenti, come una tabella che non dovrebbe mai scendere sotto un conteggio minimo o un feed che dovrebbe arrivare entro un orario fisso. Fanno fatica quando il business è stagionale, perché un limite statico può segnalare come problema un cambiamento normale.
Le baseline apprese dall'AI si adattano meglio a questo tipo di variazione. Sono utili quando un dataset ha cicli settimanali, una deriva graduale o una cronologia disordinata. Richiedono però un periodo di avviamento e il team deve accettare che la confidenza iniziale sarà inferiore rispetto a una regola fissa.
Usate regole statiche per le invarianti note, baseline apprese per i comportamenti che cambiano e la correlazione di più segnali quando un solo sintomo non basta.
Quest'ultimo punto è il più importante. Un singolo alert sulla freschezza può essere rumore. Freschezza più volume più deriva dello schema raccontano una storia più credibile. Un team che vuole mantenere i controlli vicino al warehouse pur gestendo una copertura ampia può considerare il data integrity checker di digna come esempio di come questi elementi possano essere combinati senza trattare ogni segnale allo stesso modo.
Approccio | Punto di forza | Limite | Uso ideale |
|---|---|---|---|
Esecuzione in-database | Pochi spostamenti di dati, ottimo per ambienti governati | Meno portabile tra piattaforme | Controlli su warehouse ad alto volume |
Scanner esterni | Ampia copertura tra sistemi | Più overhead su larga scala | Patrimoni multi-sistema e multi-strumento |
Soglie basate su regole | Chiare e facili da spiegare | Fragili durante le oscillazioni stagionali | Regole di business fisse e limiti rigidi |
Baseline apprese dall'AI | Si adattano alla variazione normale | Richiedono avviamento e messa a punto | Dataset volatili o in evoluzione |
Correlazione di più segnali | Riduce i falsi allarmi e migliora la diagnosi | Più lavoro di progettazione iniziale | Programmi di monitoraggio maturi |
Pattern di implementazione e best practice
La maggior parte dei programmi di monitoraggio fallisce perché cerca di fare troppo e troppo presto. Un rollout migliore inizia imparando la forma normale della pipeline, per poi aggiungere gli alert solo dopo che il team ha capito che aspetto ha davvero la “normalità”.
Il benchmark da tenere a mente è la scala. Un dataset di monitoraggio citato ha rilevato una media di 42 metriche distinte per pipeline, tra cui freschezza, varianza del volume, deriva dello schema e latenza di elaborazione querysurge. Ciò non significa che ogni team debba attivare alert su tutte e 42 contemporaneamente. Significa che i programmi maturi osservano più segnali e li usano insieme.

Un rollout che non sommerga il team
Imparate prima la baseline. Eseguite i controlli in modalità di osservazione prima di allertare qualcuno. I team devono conoscere il ritmo quotidiano ordinario prima di poter capire se un cambiamento è reale.
Date priorità in base all'impatto sul business. Iniziate da freschezza, volume, schema e dai controlli di distribuzione che proteggono i dataset più visibili. Non disperdete il team su ogni tabella solo perché gli strumenti lo rendono facile.
Usate soglie dinamiche. Impostate limiti per singolo asset, non un'unica soglia globale. Un feed delle vendite, un feed clinico e un feed di utilizzo telecom non condividono lo stesso pattern normale.
Affinate grazie al feedback. Ogni incidente risolto dovrebbe migliorare l'alert successivo. Se una notifica era rumorosa, regolatela. Se ha intercettato in anticipo un guasto reale, mantenete il pattern e magari estendetelo.
La ownership conta quanto la logica degli alert. Ogni asset monitorato dovrebbe avere uno steward nominato, perché gli alert senza un responsabile diventano ticket abbandonati. Anche una revisione trimestrale della copertura aiuta, dato che le pipeline cambiano più velocemente delle mappe di monitoraggio statiche.
La versione operativa di questo approccio emerge chiaramente nel modello di implementazione della qualità dei dati di digna, dove la disciplina del rollout conta quanto i controlli stessi.
Errori comuni che minano la fiducia nel monitoraggio
Il monitoraggio perde credibilità rapidamente quando si comporta come un sistema di allarme rumoroso. I team non smettono di fidarsi perché l'idea è sbagliata, ma perché l'implementazione è fastidiosa, fragile o cieca rispetto alle modalità di guasto reali.
I fallimenti che emergono nei programmi reali
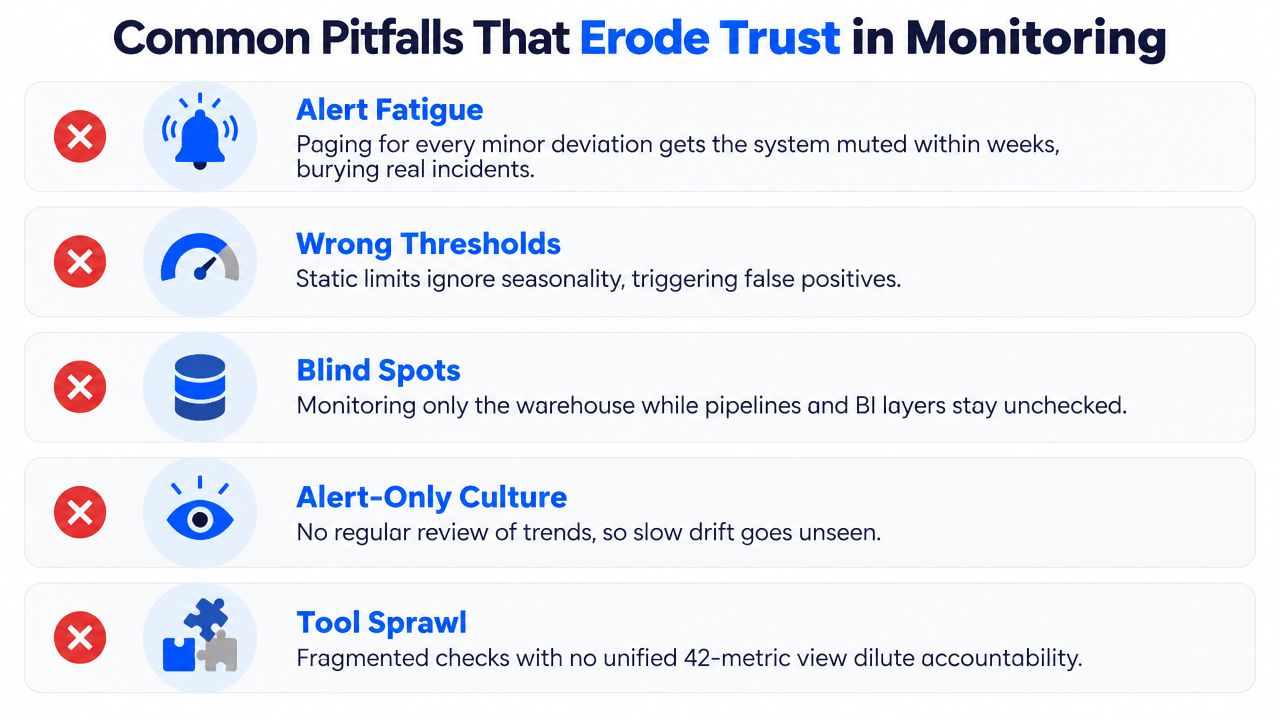
L'alert fatigue è il modo più rapido per perdere l'attenzione di tutti. Se il sistema invia notifiche per ogni minima deviazione, le persone lo silenziano e poi il vero disservizio passa inosservato.
Le soglie sbagliate generano un altro tipo di sfiducia. I limiti statici ignorano stagionalità, promozioni, picchi di fine mese e altri ritmi del business, così cambiamenti perfettamente normali sembrano incidenti.
I punti ciechi si creano quando i team osservano solo il warehouse e ignorano le fasi della pipeline e il livello BI che lo consumano. Il risultato è un falso senso di copertura.
La cultura del solo alert è un altro guasto silenzioso. Se nessuno esamina i trend, il sistema non si accorge della deriva lenta che non supera mai la soglia rigida finché non è già visibile agli utenti.
La proliferazione degli strumenti rende confuse le responsabilità. Controlli frammentati e sparsi su più sistemi raramente compongono un unico quadro operativo, ed è per questo che una vista unificata è importante.
La fiducia nasce da alert meno numerosi e migliori, non da più rumore.
Le contromisure sono semplici ma non facoltative. Usate livelli di gravità, legate le soglie al comportamento di baseline, aggiungete sottoscrizioni alle modifiche di schema e mantenete in calendario una cadenza di revisione. Soprattutto, trattate il monitoraggio come un controllo vivo, non come un progetto da dichiarare concluso dopo il lancio.
Cosa è in gioco nei diversi settori con dati regolamentati
La stessa logica di monitoraggio si applica in modo diverso a seconda del settore. Un team finance, un gruppo di analytics ospedaliero, un operatore di telecomunicazioni e un ente pubblico tengono tutti all'integrità, ma non temono gli stessi punti di rottura.
Quattro esempi, quattro diversi pattern di guasto
Nei servizi finanziariil guasto più pericoloso è spesso un feed di rischio obsoleto o alterato. Un modello può continuare a valutare le transazioni mentre il segnale di frode sottostante è vecchio, e questo può distorcere sia le decisioni sia gli audit trail.
Nella sanitàil punto critico è il cambiamento strutturale. Una colonna di diagnosi rinominata può spostare silenziosamente i casi ad alta gravità nella categoria sbagliata, il che significa che il problema emerge nel reporting clinico molto prima che qualcuno noti il problema di schema.
Nelle telecomunicazioniil problema è di solito la scala e la volatilità. Una dashboard sul churn può non accorgersi di un disservizio regionale se le tabelle dei ricavi o dell'utilizzo continuano a caricarsi normalmente mentre un altro feed resta indietro.
Nel settore pubblicole interruzioni delle dipendenze emergono spesso nei workflow di idoneità o di erogazione dei benefici. Una modifica di schema da parte di un fornitore può impedire a una join di abbinare correttamente i record, creando problemi di servizio a valle difficili da districare a posteriori.
Settore | Principale rischio per l'integrità | Segnale più prezioso | Posta in gioco normativa |
|---|---|---|---|
Servizi finanziari | Input di rischio obsoleti o alterati | Freschezza e lineage | Verificabilità e controlli di reporting |
Sanità | Cambiamento strutturale silenzioso | Schema e distribuzione | Affidabilità clinica e tracciabilità |
Telecomunicazioni | Deriva delle pipeline ad alto volume | Volume e freschezza | Continuità operativa e accuratezza del servizio |
Settore pubblico | Join interrotte dopo modifiche dei fornitori | Schema e lineage | Idoneità ai servizi, accountability e integrità dei registri |
L'errore è presumere che una sola configurazione vada bene per tutti. Il quadro di riferimento è lo stesso, ma cambia il peso dei fattori. Un ambiente regolamentato ha bisogno di segnali tarati sul guasto che meno può permettersi di non vedere, non di una checklist generica copiata dallo stack di un altro team.
Mettere tutto insieme con digna
Il guasto della dashboard descritto all'inizio, il modello a cinque lenti, il benchmark delle 42 metriche e gli esempi settoriali portano tutti alla stessa conclusione. Il monitoraggio dell'integrità dei dati funziona quando diventa un livello di controllo continuo, non un'attività di ispezione occasionale.

Un punto di riferimento pratico
digna è un modo per implementare questo modello all'interno dell'ambiente del cliente, con controlli eseguiti in-database che coprono freschezza, volume, distribuzione, schemae lineage in una configurazione modulare. Si allinea inoltre al pattern di rollout descritto sopra, in cui le baseline vengono prima e gli alert si fanno più stringenti solo dopo che il sistema ha compreso il comportamento normale.
Qui contano soprattutto alcuni punti:
Cinque lenti applicate. La stessa suite può osservare insieme tempestività, cambiamenti strutturali, contesto delle dipendenze e deviazioni dalla baseline.
Ragionare per 42 metriche. Un monitoraggio maturo non è un controllo per tabella, ma un insieme di segnali dimensionato sul dataset e sul rischio.
Rollout per fasi. L'osservazione viene prima delle notifiche, il che mantiene il programma utile anziché rumoroso.
Preservazione della fiducia. Soglie ben tarate fanno sì che il team venga svegliato solo quando qualcosa richiede davvero un intervento.
Il passo successivo pratico è semplice. Scegliete una pipeline critica, configurate le cinque lenti, imparate la baseline e lasciate che le anomalie emergano prima che le notino gli utenti. Se volete un riferimento concreto per questo tipo di configurazione, visitate digna e valutate come il suo approccio al monitoraggio si adatta all'unica pipeline che non potete permettervi di sbagliare.
Per le baseline apprese dall'AI descritte sopra, che si adattano ai cicli settimanali e alla deriva graduale invece di basarsi su soglie statiche, scoprite come digna Data Anomalies apprende il comportamento normale di ciascun dataset.
Domande frequenti
Che cos'è il monitoraggio dell'integrità dei dati?
Il monitoraggio dell'integrità dei dati è un livello di controllo continuo che osserva i dati attivi per individuare interruzioni di freschezza, volume, distribuzione, schema e lineage. A differenza dei test una tantum eseguiti al deployment, si colloca nel mezzo del ciclo di vita della pipeline, così caricamenti obsoleti, record mancanti e modifiche di schema emergono prima che gli stakeholder se ne accorgano.
Quali sono i cinque pilastri del monitoraggio dell'integrità dei dati?
Le cinque lenti sono freschezza, volume, distribuzione, schema e lineage. La freschezza indica se i dati sono arrivati in tempo, il volume tiene traccia del numero di righe e delle dimensioni dei file, la distribuzione copre tassi di null e pattern dei valori, lo schema intercetta colonne aggiunte o rinominate e il lineage mostra dove è nato un difetto e cosa ne dipende.
In cosa differisce il monitoraggio dell'integrità dei dati dal data testing?
I test verificano se una regola nota è ancora rispettata, di solito in corrispondenza del deployment o dei punti di validazione. Il monitoraggio osserva lo stato attivo della pipeline e intercetta la deriva che più avanti romperà report o modelli. La regola pratica dell'articolo: se un controllo scatta solo dopo che uno stakeholder si è lamentato, non è monitoraggio.
Quante metriche conviene monitorare per ogni pipeline di dati?
Un dataset di monitoraggio citato ha rilevato una media di 42 metriche distinte per pipeline, tra cui freschezza, varianza del volume, deriva dello schema e latenza di elaborazione. Ciò non significa attivare alert su tutte e 42 contemporaneamente; i programmi maturi osservano molti segnali e li correlano, partendo dai dataset con il maggiore impatto sul business.
Come introdurre il monitoraggio dell'integrità dei dati senza alert fatigue?
Iniziate in modalità di osservazione per imparare la baseline prima di allertare qualcuno, poi date priorità ai dataset più visibili. Impostate soglie dinamiche per singolo asset anziché un'unica soglia globale, regolate ogni alert rumoroso dopo un incidente, assegnate a ogni asset monitorato uno steward nominato e rivedete la copertura ogni trimestre.


