Data product management: guida per dati affidabili
|
7
min di lettura
Una dashboard del fatturato smette di funzionare poco prima di una riunione di pianificazione. L'aggiornamento è arrivato in ritardo, un campo a monte è cambiato senza preavviso e i dati non corrispondono più al report della finanza. Nello stesso momento, una funzionalità di AI inizia a produrre raccomandazioni instabili perché i dati di addestramento sono cambiati. Il problema visibile è un grafico rotto o un modello che deriva. Il problema di fondo è che nessuno ha gestito i dati come qualcosa su cui i consumatori potessero contare.
È qui che entra in gioco il data product management. Un data product non è semplicemente una tabella, una pipeline, una dashboard o un modello. È un'offerta di dati gestita, con un consumatore definito, una responsabilità chiara, aspettative di qualità, livelli di servizio e un ciclo di vita che prosegue dopo il rilascio. Questa guida costruisce il concetto partendo dai principi fondamentali, per poi collegare ruoli, decisioni lungo il ciclo di vita, KPI di affidabilità, flussi di governance e osservabilità.
Questo approccio si affianca in modo naturale alle pratiche DataOps per operazioni sui dati affidabili, in particolare quando ingegneri e analisti devono rilevare i guasti prima che raggiungano report, applicazioni o sistemi di AI.
Indice
Introduzione: perché oggi i dati hanno bisogno di una mentalità di prodotto
Il ciclo di vita del data product, dall'idea alla dismissione
Flussi di governance e osservabilità che mantengono affidabili i prodotti
Applicazioni reali e prossimi passi per i vostri data product
Introduzione: perché oggi i dati hanno bisogno di una mentalità di prodotto
Una pipeline può superare il primo test di consegna e poi deludere i team che ne dipendono. Un campo di origine cambia, un aggiornamento arriva in ritardo o due report applicano definizioni diverse alla stessa metrica. L'output esiste ancora, ma il suo comportamento non è più prevedibile.
Una riflessione di Thoughtworks del 2025 inquadra i dati come un prodotto con il proprio ciclo di vita, i propri standard di qualità e le esigenze dei propri consumatori. Questa impostazione sposta la domanda da “Abbiamo pubblicato il dataset?” a “Le persone e i sistemi possono usarlo in modo sicuro e ripetuto?”. La stessa riflessione collega la disciplina del data product alla proliferazione delle piattaforme, poiché le organizzazioni riferiscono di accumulare 10-15 piattaforme o più, con conseguente frammentazione, duplicazione degli sforzi e problemi di integrazione. (La riflessione di Thoughtworks del 2025 sui dati come prodotto descrive questa idea operativa e il suo rapporto con la proliferazione delle piattaforme.)
Anche la documentazione può restare indietro altrettanto rapidamente. La guida cita un Product Excellence Report secondo cui solo il 41% dei professionisti di prodotto mantiene le roadmap aggiornate e allineate alle aspettative degli stakeholder, un avvertimento per i team di dati le cui priorità, i cui schemi e i cui consumatori cambiano nel tempo.
Regola pratica: un data product si guadagna la fiducia con un comportamento affidabile, non con una voce di catalogo ben curata.
Questo comportamento richiede controlli operativi. I controlli di tempestività mostrano se la consegna rispetta le aspettative. La validazione intercetta valori inattesi. Il tracciamento dello schema fa emergere le modifiche incompatibili prima che i consumatori le incontrino. L'osservabilità collega questi segnali, in modo che ingegneri e analisti possano vedere se un dataset resta utilizzabile per report, applicazioni o sistemi di AI. I team che applicano pratiche DataOps per operazioni sui dati affidabili possono considerare questi controlli parte della consegna anziché una riparazione d'emergenza.
La mentalità di prodotto offre quindi al lavoro sui dati una disciplina dell'affidabilità: definire il consumatore, gestire l'interfaccia e conservare le evidenze dopo il rilascio.
Che cosa significa davvero data product management
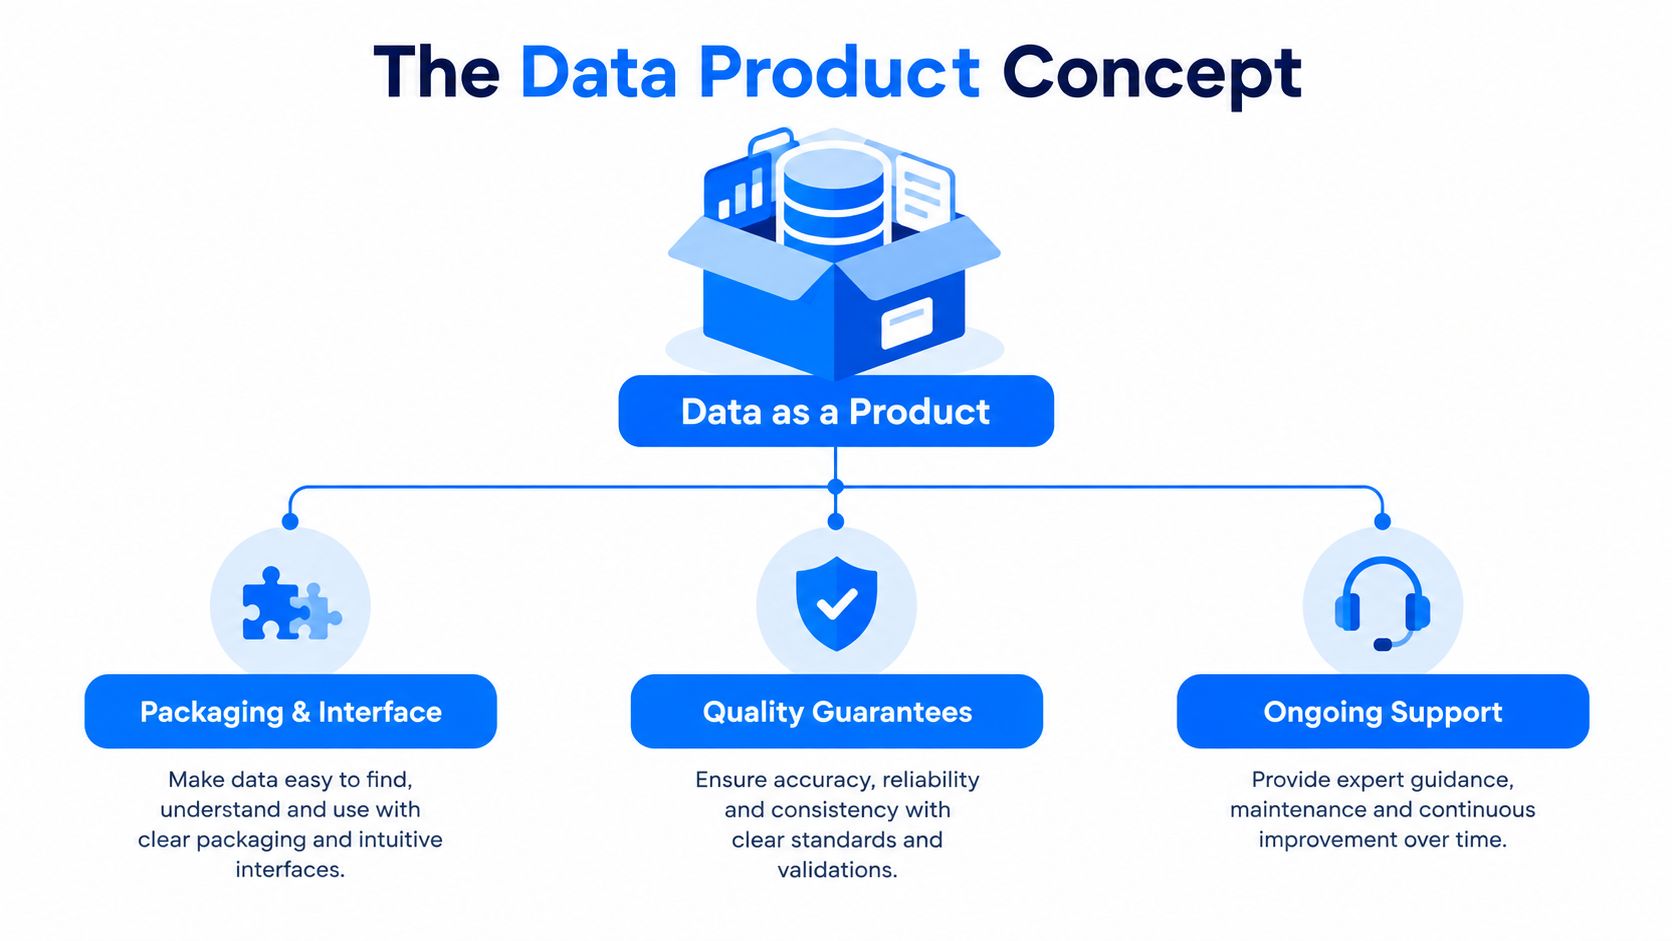
Partiamo da un'analogia familiare, quella dello scaffale. Un dataset grezzo è come un ingrediente senza etichetta in un magazzino. Qualcuno sa forse da dove proviene, ma un nuovo consumatore deve comunque chiedere che cosa contiene, se è fresco, come usarlo e a chi rivolgersi quando qualcosa non sembra a posto.
Un data product assomiglia di più a un articolo confezionato pensato per un uso ripetuto. Ha un nome chiaro, un'interfaccia, istruzioni, aspettative di qualità e supporto. La confezione può essere una vista SQL governata, un'API, un modello analitico, un set di feature o una dashboard basata su una logica semantica stabile. Il formato conta meno dell'impegno operativo che lo circonda.
I quattro test della mentalità di prodotto
Un data product utile deve superare quattro test:
Reperibilità: i consumatori possono trovarlo tramite un catalogo, un portale o un'interfaccia nota, senza dipendere da contatti personali.
Indirizzabilità: i consumatori sanno come accedervi, che sia tramite un endpoint di query, un'API, una condivisione governata o una vista documentata.
Affidabilità: il prodotto pubblica aspettative di qualità misurabili e monitora se le rispetta.
Autodescrizione: i metadati spiegano definizioni, responsabilità, lineage, sensibilità, usi consentiti e limiti noti.
Queste proprietà distinguono un prodotto da un deliverable di progetto. Un progetto di solito si ottimizza per un ambito definito e un punto di completamento. Un prodotto ha una responsabilità continua in termini di pertinenza, affidabilità, feedback dei consumatori, gestione controllata delle modifiche ed eventuale dismissione.
La distinzione diventa più importante man mano che gli stack tecnologici si moltiplicano. L'espansione delle piattaforme può dare ai team più funzionalità, rendendo però più difficile individuare il dataset di riferimento, la definizione attuale o il responsabile. Il product management fornisce la disciplina mancante. Si chiede chi consuma i dati, quale decisione supportano, quale livello di servizio richiede quella decisione e come risponderà il team quando la realtà cambia.
Che cosa gestisce davvero il product manager
Il manager non si limita a sistemare i campi del catalogo. Gestisce una promessa tra producer e consumatori. Questa promessa comprende lo scopo del prodotto, l'interfaccia, i controlli di qualità, il percorso di supporto, la roadmap e le condizioni di dismissione.
Un prodotto può supportare il reporting regolamentare, le operazioni verso i clienti, le previsioni o un flusso di lavoro di AI. Ogni caso d'uso crea aspettative diverse in termini di freschezza, validazione, accesso e sicurezza delle modifiche. La mentalità di prodotto rende esplicite queste aspettative prima che gli ingegneri le codifichino nelle pipeline.
Una breve spiegazione visiva può aiutare i team ad allinearsi sulla differenza tra un output e un'offerta gestita:
L'idea centrale è semplice: i dati diventano un prodotto quando i consumatori possono fare affidamento sul loro comportamento, non semplicemente quando un team dà una nuova etichetta a un asset esistente.
Ruoli e responsabilità in un team di data product
Un team di data product funziona meglio quando la responsabilità segue il prodotto anziché lo strumento. Il data product manager è responsabile della direzione del prodotto e del successo dei consumatori. Gli ingegneri fanno funzionare il prodotto. Analisti, data scientist, specialisti di governance e team di piattaforma apportano competenze distinte senza confondere i diritti decisionali.

La responsabilità deve essere visibile
Il data product manager risponde della visione, della definizione delle priorità, della ricerca sui consumatori, della roadmap e dei risultati del prodotto. Traduce un problema di business in una decisione di prodotto, stabilisce quali richieste meritano un investimento e mantiene allineati gli stakeholder quando emergono dei compromessi.
Il data engineer è responsabile dell'ingestion, dell'affidabilità delle trasformazioni, del comportamento in esecuzione e delle dipendenze operative. L'analytics engineer trasforma le definizioni di business in modelli governati, metriche riutilizzabili, test e documentazione. Il data scientist può utilizzare il prodotto per costruire modelli o sistemi decisionali, fornendo al tempo stesso feedback sulla stabilità delle feature, sui dati di addestramento e sulla maturità dei modelli.
I team di governance e di piattaforma forniscono dei guardrail anziché sostituirsi alla responsabilità di prodotto. Gli specialisti di governance definiscono policy, aspettative di accesso, regole di classificazione e requisiti di audit. I platform engineer forniscono infrastruttura, modelli di deployment, permessi e funzionalità di osservabilità che consentono ai team di prodotto di operare in sicurezza.
Una mappa pratica delle responsabilità può presentarsi così:
Visione e priorità: data product manager, con il contributo del dominio e del management.
Definizioni di business: analytics engineer ed esperto di dominio, con l'approvazione del prodotto.
Affidabilità di pipeline ed esecuzione: data engineer, con il supporto del platform engineering.
Controlli di qualità e di accesso: responsabile della governance e owner tecnico di riferimento.
Onboarding e feedback dei consumatori: product manager, con il supporto di analisti e referenti di dominio.
Risposta agli incidenti in produzione: owner operativo designato, con percorsi di escalation documentati.
La responsabilità diventa il collo di bottiglia quando un prodotto ha un nome ma nessuna persona con l'autorità per prendere decisioni, finanziarne la manutenzione o dismettere l'asset.
Il problema è particolarmente serio negli ambienti regolamentati. Un catalogo può indicare un owner, ma quell'owner potrebbe non avere l'autorità per approvare una modifica dello schema o dare priorità a un controllo di freschezza fallito. Una responsabilità efficace combina accountability, diritti decisionali, capacità operativa e un flusso di supporto chiaro.
Una dashboard condivisa può offrire a ingegneri, analisti e stakeholder la stessa visione di incidenti, tendenze e stato dei prodotti, senza spostare i dati fuori dall'ambiente del cliente. Il più ampio modello dei ruoli di data governance aiuta i team a rendere espliciti questi passaggi di consegne anziché lasciarli a conversazioni informali.
Il ciclo di vita del data product, dall'idea alla dismissione
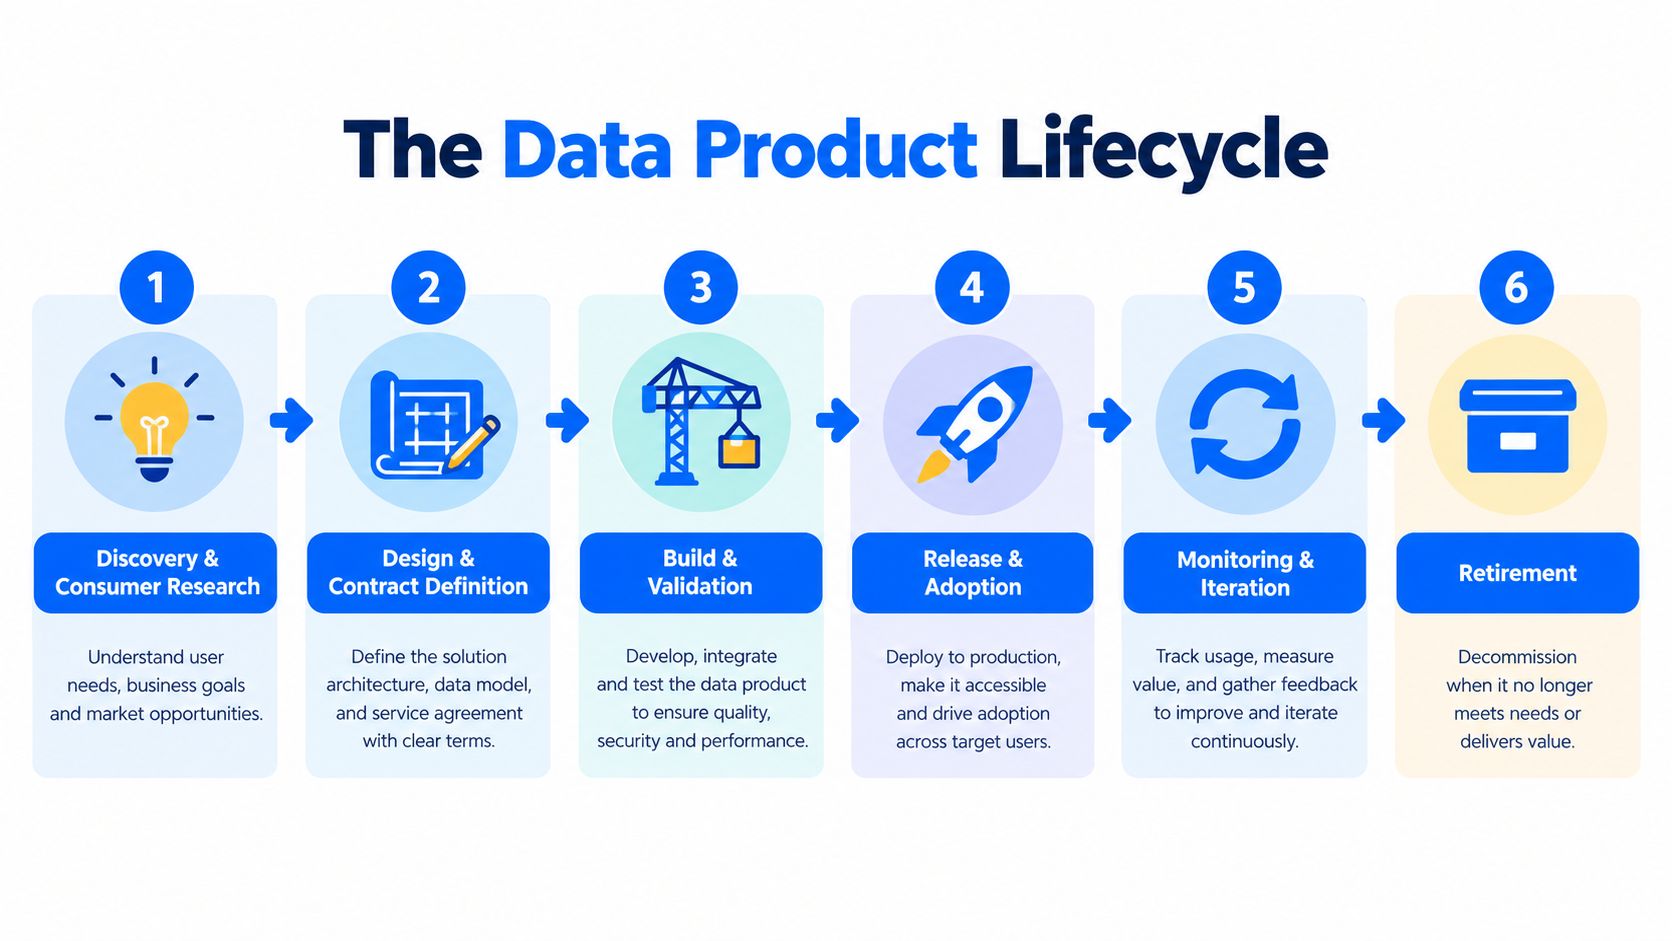
Il ciclo di vita di un data product inizia prima del codice e continua dopo il rilascio. Ogni fase risponde a una domanda diversa e ogni punto decisionale impedisce al team di portare in produzione ipotesi non risolte.
Discovery e ricerca sui consumatori
Partite dalla decisione, non dalla fonte disponibile. Individuate il gruppo di consumatori, il problema di business, l'azione che il prodotto deve supportare e le conseguenze di dati in ritardo o errati. Intervistate separatamente analisti, operatori, team applicativi e stakeholder della governance, perché ogni gruppo vede modalità di guasto diverse.
Un output utile della fase di discovery comprende una definizione del problema, un owner designato, i primi percorsi dei consumatori, la sensibilità dei dati, il modello di accesso previsto e una definizione approssimativa del successo. Se gli utenti non sanno spiegare che cosa faranno con il prodotto, il team dovrebbe verificare l'esigenza prima di impegnare capacità di engineering.
Progettazione e definizione del contratto
Successivamente, definite l'interfaccia e le garanzie del prodotto. Documentate entità, metriche, significato dei campi, valori consentiti, comportamento atteso della consegna, controlli di accesso e regole di gestione delle modifiche. I data contract devono descrivere ciò che i producer forniscono e ciò che i consumatori possono dare per scontato in sicurezza.
Il team deve inoltre decidere quali modifiche sono retrocompatibili, quali richiedono una nuova versione e quali richiedono una notifica ai consumatori. Analytics engineer ed esperti di dominio prevengono la deriva semantica prima che raggiunga dashboard o modelli.
Sviluppo e validazione
Gli ingegneri implementano poi ingestion, trasformazioni, test, metadati, lineage e controlli operativi. La validazione non va rimandata alla revisione finale. Regole di business note, aspettative strutturali e comportamento della consegna richiedono controlli durante tutto lo sviluppo e prima del rilascio.
Un prodotto non è pronto perché la sua query restituisce righe. È pronto quando il team è in grado di dimostrare che le righe seguono le definizioni documentate, arrivano entro le aspettative concordate e producono una risposta chiara quando una dipendenza a monte fallisce.
Rilascio e adozione
Il rilascio comprende onboarding, esempi, istruzioni di accesso, instradamento del supporto e formazione dei consumatori. Un prodotto tecnicamente solido può comunque fallire se gli utenti non comprendono le definizioni o non riescono ad accedervi tramite il loro normale flusso di lavoro.
Il product manager deve osservare i primi feedback e distinguere tra un problema di reperibilità, un problema di usabilità, un problema di fiducia e un'effettiva mancanza di domanda. Ognuno richiede una risposta diversa.
Monitoraggio e iterazione
Dopo il lancio, il team esamina segnali di qualità, incidenti, modelli di utilizzo e feedback. Il monitoraggio deve portare a decisioni sul backlog, non semplicemente a un rumore di alert. Se gli utenti hanno bisogno di una granularità, di una finestra di consegna o di un'interfaccia diversa, la roadmap deve riflettere questa evidenza.
La disciplina della roadmap è importante perché i data product si deteriorano quando le aspettative degli stakeholder si spostano mentre il prodotto resta fermo. L'analisi del 2026 citata in precedenza collega uno scarso allineamento della roadmap alle difficoltà del product management, il che rende comunicazione e definizione delle priorità parte dell'affidabilità anziché un onere amministrativo.
Dismissione
La dismissione è una decisione di prodotto controllata. Definite il motivo, individuate i consumatori rimanenti, comunicate il percorso di sostituzione o di archiviazione, conservate le evidenze necessarie e rimuovete gli accessi obsoleti. Una dismissione ordinata mantiene comprensibile il portafoglio e impedisce agli ingegneri di mantenere output che non supportano più alcuna decisione significativa.
Misurare il successo con KPI che dimostrano l'affidabilità
Un prodotto può avere molti consumatori ed essere comunque inaffidabile. Può anche avere un'adozione iniziale limitata perché serve un flusso di lavoro specialistico, pur mantenendo la propria promessa di servizio. Ecco perché i KPI dei data product devono collegare il valore per i consumatori alla salute operativa, invece di contare dashboard, tabelle o voci di catalogo.
Le indicazioni degli esperti raccomandano di monitorare rispetto degli SLA di freschezza, copertura delle responsabilità, copertura dei data contract e rilevamento dell'impatto prima del deployment, perché queste misure collegano l'affidabilità alla sicurezza delle modifiche (le indicazioni sulla governance dei data product spiegano questo approccio operativo). I framework di governance raccomandano anche misure di adozione e supporto come il tasso di riutilizzo da parte dei consumatori, la crescita dei consumatori attivi, il tempo di reperimento, l'instradamento dei problemi a un owner designato e i problemi risolti entro lo SLA (le indicazioni sul monitoraggio della governance del portafoglio collegano questi indicatori ai risultati in termini di riutilizzo e controllo).
Scegliere i KPI dei data product in base al risultato
Risultato desiderato | KPI principale | Che cosa indica |
|---|---|---|
Costruire la fiducia dei consumatori | Rispetto degli SLA di freschezza | Se la consegna rispetta le aspettative su cui i consumatori fanno affidamento |
Rendere visibile la responsabilità | Copertura delle responsabilità | Se ogni prodotto e ogni problema ha un responsabile |
Ridurre il rischio delle modifiche | Copertura dei data contract e rilevamento dell'impatto prima del deployment | Se le modifiche strutturali vengono comprese prima del rilascio |
Aumentare il riutilizzo | Tasso di riutilizzo e crescita dei consumatori attivi | Se il prodotto risolve esigenze ricorrenti per più consumatori |
Migliorare la reperibilità | Rapporto ricerche/aperture o tempo di reperimento | Se gli utenti riescono a trovare e comprendere il prodotto in modo efficiente |
Migliorare il supporto | Instradamento dei problemi a un owner designato e risoluzione entro lo SLA | Se i guasti passano rapidamente dal rilevamento alla risoluzione |
Questi KPI rispondono a domande diverse. La freschezza vi dice se un report o un modello riceve i dati in tempo. La responsabilità vi dice se qualcuno può intervenire quando non accade. La copertura dei contratti mostra se i consumatori sono protetti dalle sorprese strutturali. Il riutilizzo indica che il prodotto ha un'interfaccia affidabile anziché offrire una risposta una tantum.
La catena causale è importante. Se la consegna diventa imprevedibile, i consumatori possono creare copie private. Se la responsabilità non è chiara, gli incidenti restano irrisolti. Se gli utenti non riescono a trovare rapidamente i prodotti certificati, tornano alle richieste manuali. Nel tempo, questi comportamenti aumentano le duplicazioni e indeboliscono il valore della governance.
I team possono usare le indicazioni per misurare l'affidabilità per progettare una scorecard basata sugli impegni effettivi del loro prodotto verso i consumatori. La disciplina importante è scegliere un piccolo insieme di misure che inneschino decisioni. Un KPI che non cambia mai le priorità è un report, non uno strumento di gestione.
Flussi di governance e osservabilità che mantengono affidabili i prodotti
Una pipeline di reporting può consegnare un file nei tempi previsti e produrre comunque risultati inaffidabili. Un campo rinominato può rompere una dashboard, un improvviso cambiamento nella distribuzione può distorcere un modello e una consegna in ritardo può lasciare gli analisti a lavorare su informazioni obsolete. La governance diventa utile quando le sue regole operano insieme a consegna, validazione e risposta agli incidenti.
La data observability funziona come un pannello di controllo per un data product. Monitora in modo continuo salute, qualità, affidabilità e prestazioni dei sistemi lungo ingestion, archiviazione e analisi. I suoi segnali principali comprendono freschezza, volume, schema, distribuzione e lineage, come descritto nella ricerca sui segnali della data observability. I team possono anche approfondire le pratiche di data observability per vedere come questi segnali supportano il monitoraggio operativo.
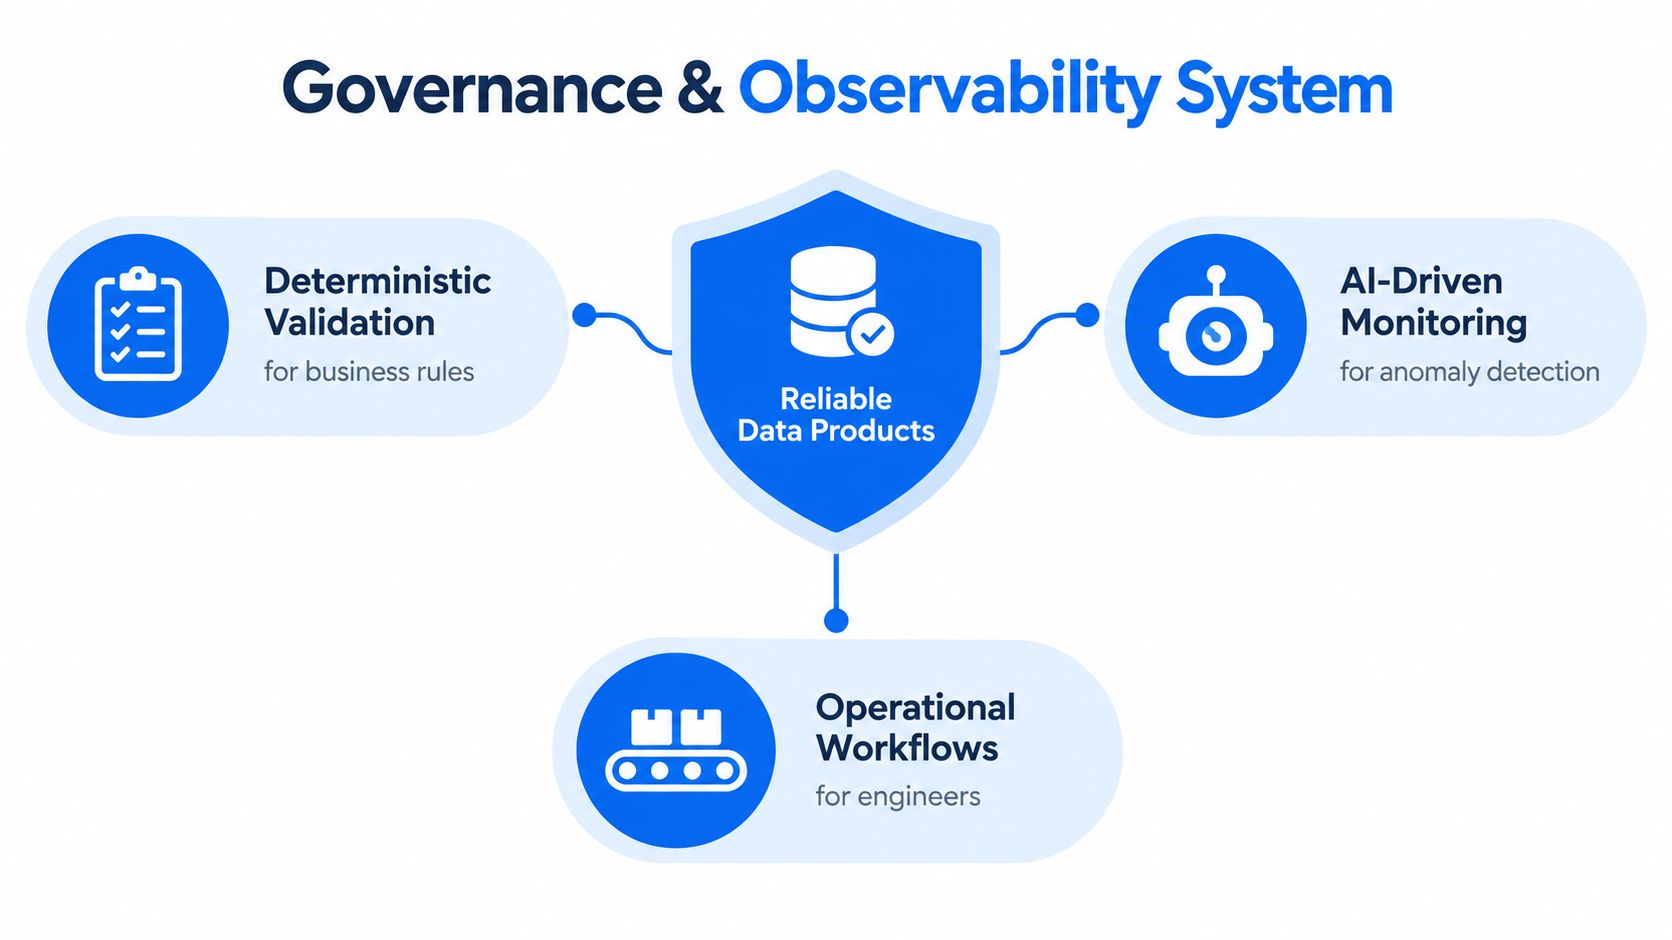
Quattro controlli con compiti diversi
La validazione deterministica verifica regole che il team conosce già. Valori di stato consentiti, identificativi obbligatori, regole di relazione e condizioni per il reporting regolamentare sono esempi comuni. Poiché ogni controllo rimanda a una regola definita, il suo risultato può essere spiegato e sottoposto ad audit.
Il rilevamento delle anomalie cerca comportamenti insoliti che le regole fisse potrebbero non cogliere. Ogni riga può superare un controllo di validità di base mentre la distribuzione complessiva cambia bruscamente. Il monitoraggio rispetto a una baseline aiuta i team a individuare volumi, schemi di valori o comportamenti di utilizzo insoliti prima che i consumatori segnalino un guasto.
Il monitoraggio della tempestività misura lo scarto tra la disponibilità prevista e quella effettiva delle informazioni. La guida alle metriche di qualità dei dati inquadra la tempestività in termini di accessibilità e disponibilità. Il ritardo diventa così un controllo misurabile anziché una lamentela soggettiva.
Il tracciamento dello schema protegge il contratto strutturale del prodotto. Colonne aggiunte o rimosse, campi rinominati e tipi di dati modificati possono rompere trasformazioni, dashboard, pipeline di feature e applicazioni a valle anche quando la consegna prosegue.
Un modello operativo utile combina la validazione per le regole note, il rilevamento delle anomalie per i comportamenti insoliti, i controlli di tempestività per il rischio legato alla consegna e il tracciamento dello schema per le modifiche strutturali. Deve registrare le consegne mancanti, in ritardo e inaspettatamente anticipate, per poi stabilire una finestra di consegna attesa a partire dal comportamento osservato, come descritto nel framework di qualità aziendale.
Trasformare i segnali in azioni
Un alert diventa utile solo quando qualcuno può agire di conseguenza. Ogni evento ha bisogno di un owner designato, una gravità, i prodotti interessati, il contesto delle dipendenze, un percorso di escalation e una registrazione della risoluzione. Se una modifica dello schema minaccia un consumatore, il team deve individuare i report, i modelli e le applicazioni esposti prima che la modifica raggiunga la produzione.
Piattaforme come digna implementano questo modello riunendo rilevamento delle anomalie, validazione, tempestività e tracciamento dello schema in un unico livello di osservabilità. Questa organizzazione offre a ingegneri, analisti e stakeholder una visione condivisa di incidenti, tendenze e stato per quanto riguarda qualità dei dati, monitoraggio del business e osservabilità della piattaforma.
Il ciclo operativo è semplice. La governance definisce il comportamento accettabile, l'osservabilità rileva le deviazioni e la responsabilità dei flussi di lavoro trasforma queste deviazioni in una risoluzione controllata. Questa disciplina rende i dataset riutilizzabili sistemi affidabili per l'analisi e l'AI.
Applicazioni reali e prossimi passi per i vostri data product
Nei servizi finanziari, un data product sulle transazioni o sul rischio ha bisogno di validazione, tracciamento della consegna e monitoraggio delle modifiche strutturali, in modo che i team di reporting non scoprano i guasti dopo una scadenza di segnalazione. Nella sanità, i data product clinici e operativi hanno bisogno di definizioni chiare, controlli di tempestività ed evidenze di qualità tracciabili. I team delle telecomunicazioni possono monitorare grandi volumi di dati su clienti e rete per individuare variazioni insolite, consegne mancanti e modifiche dello schema. I team del settore pubblico possono applicare la stessa disciplina ai dataset che richiedono coerenza, verificabilità e un accesso affidabile.
La differenza tra prima e dopo è operativa. Prima della disciplina di prodotto, un analista nota un numero strano, cerca tra i messaggi, trova diversi possibili owner e ricostruisce un report partendo da un foglio di calcolo familiare. Dopo, il prodotto ha un contratto documentato, controlli automatizzati, un owner visibile, un percorso per gli incidenti e un processo di risposta noto.
Una valutazione pratica può partire da queste domande:
Consumatore: chi usa questo prodotto e quale decisione supporta?
Contratto: che cosa possono dare per scontato i consumatori su schema, definizioni, accesso e consegna?
Responsabilità: quale persona o team può approvare le modifiche e risolvere gli incidenti?
Controlli: i controlli di validazione, anomalie, tempestività e schema coprono le modalità di guasto più importanti?
Ciclo di vita: quali evidenze farebbero scattare un miglioramento, una sostituzione o una dismissione?
Usate il modello operativo del team di qualità dei dati per chiarire come devono collaborare le responsabilità di prodotto, engineering, analisi e governance. Date priorità al prodotto il cui guasto creerebbe il maggior rischio decisionale, quindi rendete osservabili le sue promesse prima di ampliare il portafoglio.
digna aiuta i team di dati a monitorare le anomalie, validare le regole di business, tracciare la tempestività, rilevare le modifiche dello schema ed esaminare i segnali di business e di piattaforma all'interno del proprio ambiente. Visitate digna per scoprire come un approccio all'osservabilità in-database può supportare data product affidabili per l'analisi e l'AI.
Il contratto pubblicato da un data product vale quanto i controlli che lo sostengono: è questo il ponte tra la mentalità di prodotto e la gestione della qualità dei dati.
Domande frequenti
Che cosa trasforma un dataset in un data product?
Il superamento di quattro test: reperibilità tramite un catalogo o un portale anziché contatti personali, indirizzabilità tramite un endpoint o una vista documentati, affidabilità grazie ad aspettative di qualità pubblicate e monitorate, e autodescrizione tramite metadati che coprono responsabilità, lineage e usi consentiti.
Chi è responsabile di che cosa in un team di data product?
Il data product manager è responsabile di visione, priorità e roadmap; il data engineer di ingestion, affidabilità delle trasformazioni e comportamento in esecuzione; i team di governance e di piattaforma forniscono i guardrail. Il collo di bottiglia è un prodotto che ha un nome ma nessuno autorizzato a finanziarne la manutenzione o a dismetterlo.
Perché oggi si applica la mentalità di prodotto ai dati?
Perché la proliferazione delle piattaforme ha reso insufficiente la semplice pubblicazione. Le organizzazioni riferiscono di accumulare 10-15 piattaforme o più, il che frammenta gli sforzi, e la riflessione di Thoughtworks del 2025 sposta la domanda dal fatto che il dataset sia stato pubblicato alla possibilità per persone e sistemi di usarlo in modo sicuro e ripetuto.
Quali KPI dimostrano che un data product è affidabile?
Rispetto degli SLA di freschezza, copertura delle responsabilità, copertura dei data contract e rilevamento dell'impatto prima del deployment per l'affidabilità, oltre a tasso di riutilizzo da parte dei consumatori, crescita dei consumatori attivi, tempo di reperimento e problemi risolti entro lo SLA per adozione e supporto.
Perché i data product si deteriorano dopo il lancio?
Perché le aspettative cambiano mentre il prodotto resta fermo. Solo il 41% dei professionisti di prodotto mantiene le roadmap allineate alle aspettative degli stakeholder, il che rende la disciplina della roadmap parte dell'affidabilità anziché un onere amministrativo.


