Metriche di data observability: il catalogo di riferimento
|
7
min di lettura

State fissando una dashboard che sembra normale, ma ieri pomeriggio una tabella a monte ha rinominato una colonna e nessuno se n'è accorto finché il report dei ricavi non è rimasto bloccato sul dato di lunedì. La pipeline non ha dato l'allarme, i grafici non si sono rotti e il modello ha continuato a produrre NULL. È proprio il tipo di errore che le metriche di data observability dovrebbero intercettare, ma solo se il vostro team sa dare un nome al segnale, calcolarlo sempre allo stesso modo e concordare che cosa succede quando supera una soglia.
I team hanno già frammenti della risposta. Hanno controlli di freschezza in uno strumento, alert sul numero di righe in un altro, log dello schema in un terzo e qualche regola tramandata a voce nelle note di reperibilità. Ciò che di solito manca è un catalogo di riferimento facile da consultare, una mappa condivisa delle metriche stesse, di come viene calcolata ciascuna e di quale soglia giustifichi svegliare qualcuno. Un catalogo chiaro trasforma un monitoraggio disordinato in qualcosa che le persone possono usare durante un incidente, non solo ammirare in una demo. Come punto di partenza pratico, la panoramica di digna sulla data observability è un esempio utile di come i team affrontano il problema in produzione.
Indice
Perché le metriche di data observability hanno bisogno di un catalogo condiviso
Un vocabolario condiviso evita la deriva negli incidenti
Che cosa sono le metriche di data observability
Le metriche sono continue, i controlli sono puntuali
Le cinque categorie principali in sintesi
Freschezza, volume, schema, distribuzione, lineage
Metriche di freschezza e tempestività nel dettaglio
Quattro metriche che rendono la freschezza azionabile
Impostate la finestra in base alla classe di asset
Punteggi di anomalia e misure di drift o volatilità
Tre modi per rilevare comportamenti insoliti
Conteggi delle modifiche allo schema e segnali di drift strutturale
Quattro metriche che rendono visibile la struttura
I monitor dei KPI di business come livello decisionale
Costruite il KPI a partire dagli asset sottostanti
Matrice di riferimento rapido per il catalogo
Collegamenti tra le categorie di metriche
Dalla freschezza al volume, dallo schema alla distribuzione, dalla lineage al drift
Scegliere l'insieme minimo di metriche che contano
Perché le metriche di data observability hanno bisogno di un catalogo condiviso
La parte peggiore di uno schema drift silenzioso non è il drift in sé. È la mezza giornata che il vostro team perde a discutere su come chiamarlo. Un ingegnere dice che la tabella era obsoleta, un altro che l'estrazione è fallita, un terzo fa notare che l'output del modello era sbagliato perché una colonna di input era stata rinominata. La dashboard veniva comunque visualizzata, quindi l'errore sembrava innocuo finché qualcuno non l'ha usata per prendere una decisione.
Un catalogo cambia questa conversazione. Invece di un mucchio disordinato di controlli, ottenete metriche di osservabilità con un nome, ciascuna con una formula nota, un responsabile chiaro e una politica di alerting che può essere rivista a posteriori. È importante perché la stessa condizione può essere descritta in tre modi diversi se nessuno ha stabilito se si sta parlando di ritardo di freschezza, conformità dello schema o perdita di volume a valle.
Un vocabolario condiviso evita la deriva negli incidenti
Quando un data lead, un analista e un ingegnere intendono tutti la stessa cosa con «dati in ritardo», smettono di perdere tempo a tradurre. Un catalogo di metriche fornisce loro una definizione per ogni segnale, un percorso di calcolo e una regola di escalation. È particolarmente utile quando una tabella si comporta diversamente durante l'orario lavorativo rispetto alla notte, perché la stessa parola può descrivere modalità di errore molto diverse.
Un catalogo riduce anche la proliferazione delle soglie. Senza di esso, ogni ingegnere reperibile inventa un nuovo limite per ogni asset, e il risultato sono chiamate incoerenti, gravità incoerenti e fiducia incoerente. Con il catalogo, il team può stabilire se un segnale appartiene al livello di avviso, al livello di chiamata o al livello «monitorare ma non svegliare nessuno».
Regola pratica: se due persone possono non essere d'accordo sul fatto che il problema riguardi freschezza, volume o schema, il vostro catalogo non è ancora abbastanza specifico.
Il valore diventa più chiaro in un incidente reale. Una dashboard può mostrare ricavi piatti alle 9 del mattino, mentre la metrica di freschezza può mostrare che la tabella degli ordini ha smesso di aggiornarsi alle 2:14. Quello è il primo anello rotto, ed è ciò che va sistemato prima che qualcuno inizi a discutere dei report a valle. Come punto di partenza pratico, la panoramica di digna sulla data observability mostra come i team affrontano il problema in produzione.
Che cosa sono le metriche di data observability
Le metriche di data observability sono misure in serie temporale rilevate sugli asset di dati e sulle pipeline che li movimentano. Includono conteggi delle righe, tassi di valori nulli, impronte dello schema, sintesi delle distribuzioni, lacune nella lineage e indicatori derivati come punteggi di anomalia o di drift. In pratica sono i segnali di cui seguite l'andamento nel tempo per capire quando una tabella smette di comportarsi come al solito.
Un catalogo utile rende questi segnali leggibili a colpo d'occhio. Una metrica chiamata null_rate_email_hourly dice a un analista molto più di check_7, perché il nome contiene già l'oggetto, la misura e la cadenza. Le convenzioni di denominazione strutturate, come il pattern dei tag di dati per la creazione di contenuti con l'AI, funzionano allo stesso modo: le etichette dovrebbero aiutare le persone a riconoscere che cosa stanno guardando prima ancora di aprire la definizione.
Le metriche sono continue, i controlli sono puntuali
Un controllo di base sulla qualità dei dati di solito risponde a una domanda sì/no. Questa colonna è nulla? Questo ID è univoco? Il valore rientra nell'intervallo? Sono controlli utili, ma verificano una regola nota in un solo momento.
Le metriche di osservabilità funzionano diversamente. Vengono misurate in modo continuo, confrontate con una baseline specifica per quell'asset e generano alert in caso di scostamento, non solo di violazione di una regola. Un controllo del tasso di valori nulli su un campo email è un test di qualità statico. Una serie oraria del tasso di valori nulli con una baseline mobile è una metrica di osservabilità, perché può far emergere un lento problema di estrazione a monte molto prima che qualcuno noti campagne compromesse.
Questa distinzione conta per il modo in cui i team documentano il catalogo. Ogni voce dovrebbe rispondere a tre domande, in modo coerente e senza congetture.
Definizione: che cosa significa la metrica in parole semplici.
Metodo di calcolo: la formula o l'aggregazione che la sostiene.
Politica di alerting: se genera un avviso, una chiamata o alimenta solo l'analisi.
Distinzione utile: se il team esegue il controllo solo quando qualcuno sospetta un problema, è un test. Se la metrica viene seguita nel tempo, ha una baseline e può generare alert, è osservabilità.
Il modo più chiaro di pensare al catalogo è come a un livello tra la telemetria grezza e l'azione umana. Conteggi e timestamp grezzi diventano metriche. Le metriche diventano soglie. Le soglie diventano decisioni del runbook.
Le cinque categorie principali in sintesi
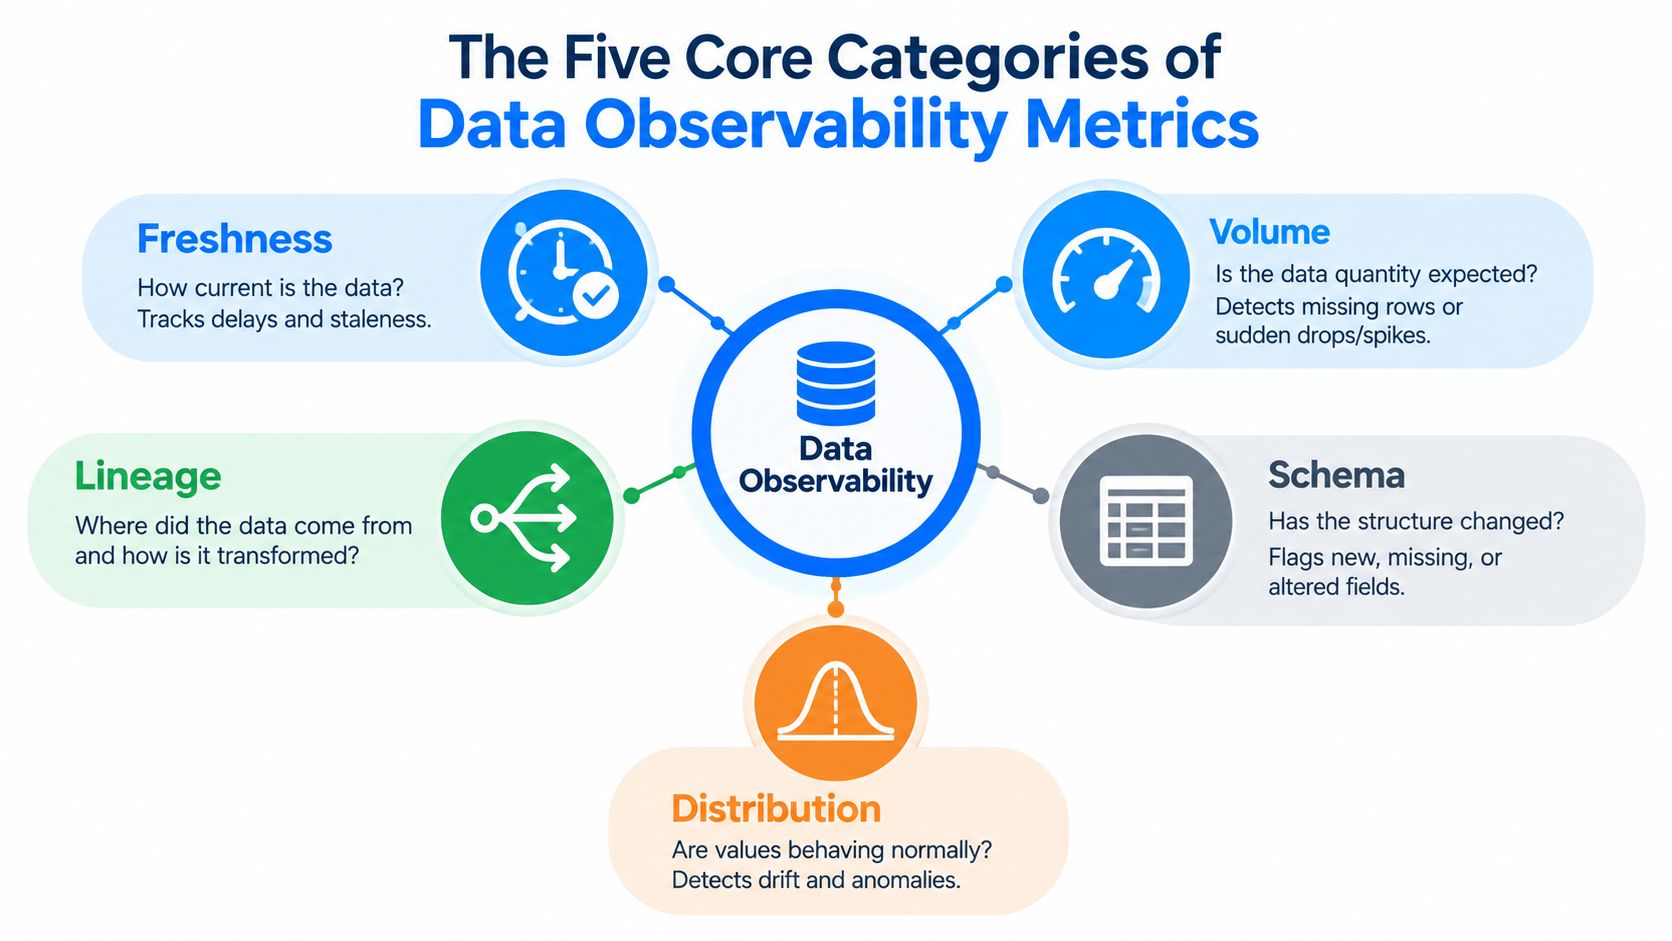
Il settore di solito si organizza attorno a cinque categorie di misura, e ciascuna intercetta una classe diversa di errori. Non sono tassonomie in competizione, ma viste sovrapposte dello stesso asset. Un catalogo sano le nomina tutte e cinque, così che i team non si concentrino troppo sull'unico segnale che sanno già raccogliere.
Freschezza, volume, schema, distribuzione, lineage
La freschezza verifica se i dati sono abbastanza aggiornati per il caso d'uso di business. Intercetta le partizioni in ritardo e i job ELT bloccati, quelli che lasciano una dashboard non aggiornata.
Il volume verifica se la quantità di record è più o meno quella attesa. È la prima linea di difesa contro caricamenti vuoti, caricamenti troncati e ingestion duplicate.
Lo schema sorveglia le modifiche strutturali come nuove colonne, campi mancanti, campi rinominati e cambi di tipo. Intercetta le rotture che fanno restituire NULL ai modelli a valle anche quando la tabella continua a caricarsi.
La distribuzione guarda al comportamento dei valori, non solo ai conteggi. Le variazioni nei tassi di valori nulli, nella cardinalità, negli intervalli o nella forma dei dati spesso emergono prima che un utente di business noti la risposta sbagliata.
La lineage mappa i percorsi di dipendenza. Vi dice quale dashboard, modello o tabella a valle dipende dall'asset che è cambiato, ed è la categoria che impedisce a una singola sorgente guasta di trasformarsi in un'ora di ricerca alla cieca.
Il vantaggio di raggruppare queste metriche in categorie è che ciascuna ha una diversa firma di errore. Un job in ritardo spesso si presenta prima come problema di freschezza, poi di volume. La migrazione di un'API di un fornitore spesso si manifesta con schema drift e picchi di valori nulli insieme. Un'interruzione della sorgente può propagarsi lungo la lineage e comparire infine come drift della distribuzione a valle.
Usate la categoria che corrisponde al sintomo che potete misurare per primo, poi verificate le altre prima di fare escalation.
Metriche di freschezza e tempestività nel dettaglio
La freschezza riguarda il ritardo, non solo il fatto che un job sia stato eseguito. Una pipeline può andare a buon fine e consegnare comunque i dati troppo tardi perché siano utili. Per eventi di prodotto, feed degli ordini e dashboard operative, il ritardo stesso è l'incidente.
Il modo più chiaro di esprimere la freschezza è misurare il divario tra disponibilità attesa e disponibilità effettiva. Così ottenete una metrica su cui costruire una baseline, generare alert e da affidare al responsabile della pipeline. Le note di digna su definizione e monitoraggio della tempestività si adattano bene a questo caso d'uso se cercate un esempio di piattaforma che tratta i tempi di consegna come un segnale di primo piano.
Quattro metriche che rendono la freschezza azionabile
max_event_lag_seconds è la misura di ritardo più semplice. Una formula pratica è now() - max(event_time), che indica di quanto l'evento più recente è in ritardo rispetto al momento attuale.
row_arrival_rate traccia il throughput nel tempo, di solito come righe acquisite al minuto. Un calo improvviso può significare che la sorgente ha smesso di inviare dati, che un filtro è diventato troppo aggressivo o che il job a monte è bloccato.
pipeline_completion_lag confronta l'orario di fine pianificato con quello effettivo. Rileva i casi in cui il job tecnicamente si completa, ma solo dopo che lo SLA è già stato mancato.
sla_breach_minutes misura per quanto tempo l'asset è rimasto oltre il suo budget di freschezza. È il numero che trasforma un ritardo tecnico nella durata di un incidente.
Metrica | Formula | Esempio | Avviso | Chiamata |
|---|---|---|---|---|
max_event_lag_seconds |
| L'ultimo evento è indietro rispetto all'ora attuale | Al 50 percento dello SLA | Al 100 percento dello SLA |
row_arrival_rate |
| Il tasso di ingestion scende sotto la cadenza prevista | Al 50 percento del throughput atteso | Al 100 percento del throughput atteso |
pipeline_completion_lag |
| Il job termina dopo la chiusura della finestra | Al 50 percento del budget di freschezza | Al 100 percento del budget |
sla_breach_minutes | Tempo oltre il budget di freschezza | L'asset resta in ritardo oltre la finestra dello SLA | Al 50 percento del ritardo consentito | Al 100 percento, con escalation al 200 percento |
Impostate la finestra in base alla classe di asset
Usate budget di freschezza diversi per data product diversi. Gli eventi di prodotto di solito richiedono finestre inferiori al minuto. I data mart transazionali spesso tollerano circa 5 minuti. Gli aggregati notturni rientrano spesso in un intervallo da 15 a 60 minuti. Le estrazioni per la compliance possono essere misurate su finestre di 24 ore quando il processo di business lo consente.
Ecco perché i limiti globali sono una cattiva abitudine. Un'unica soglia di freschezza non può servire sia un clickstream ad alta frequenza sia una tabella di regolamento giornaliera senza generare rumore da qualche parte. Un alerting a livelli è più stabile: avviso al 50 percento dello SLA, chiamata al 100 percento ed escalation al 200 percento se l'asset è ancora in ritardo.
Regola operativa: scrivete lo SLA accanto al nome della metrica. Se il budget di freschezza non è evidente nel runbook, l'alert non sarà azionabile.
Punteggi di anomalia e misure di drift o volatilità
Non tutti i dataset compromessi sono in ritardo o mancanti. A volte i dati arrivano puntuali e si comportano comunque in modo insensato. È qui che punteggi di anomalia e misure di drift dimostrano il loro valore, perché trasformano un «sembra strano» in un segnale confrontabile con lo storico.
Tre modi per rilevare comportamenti insoliti
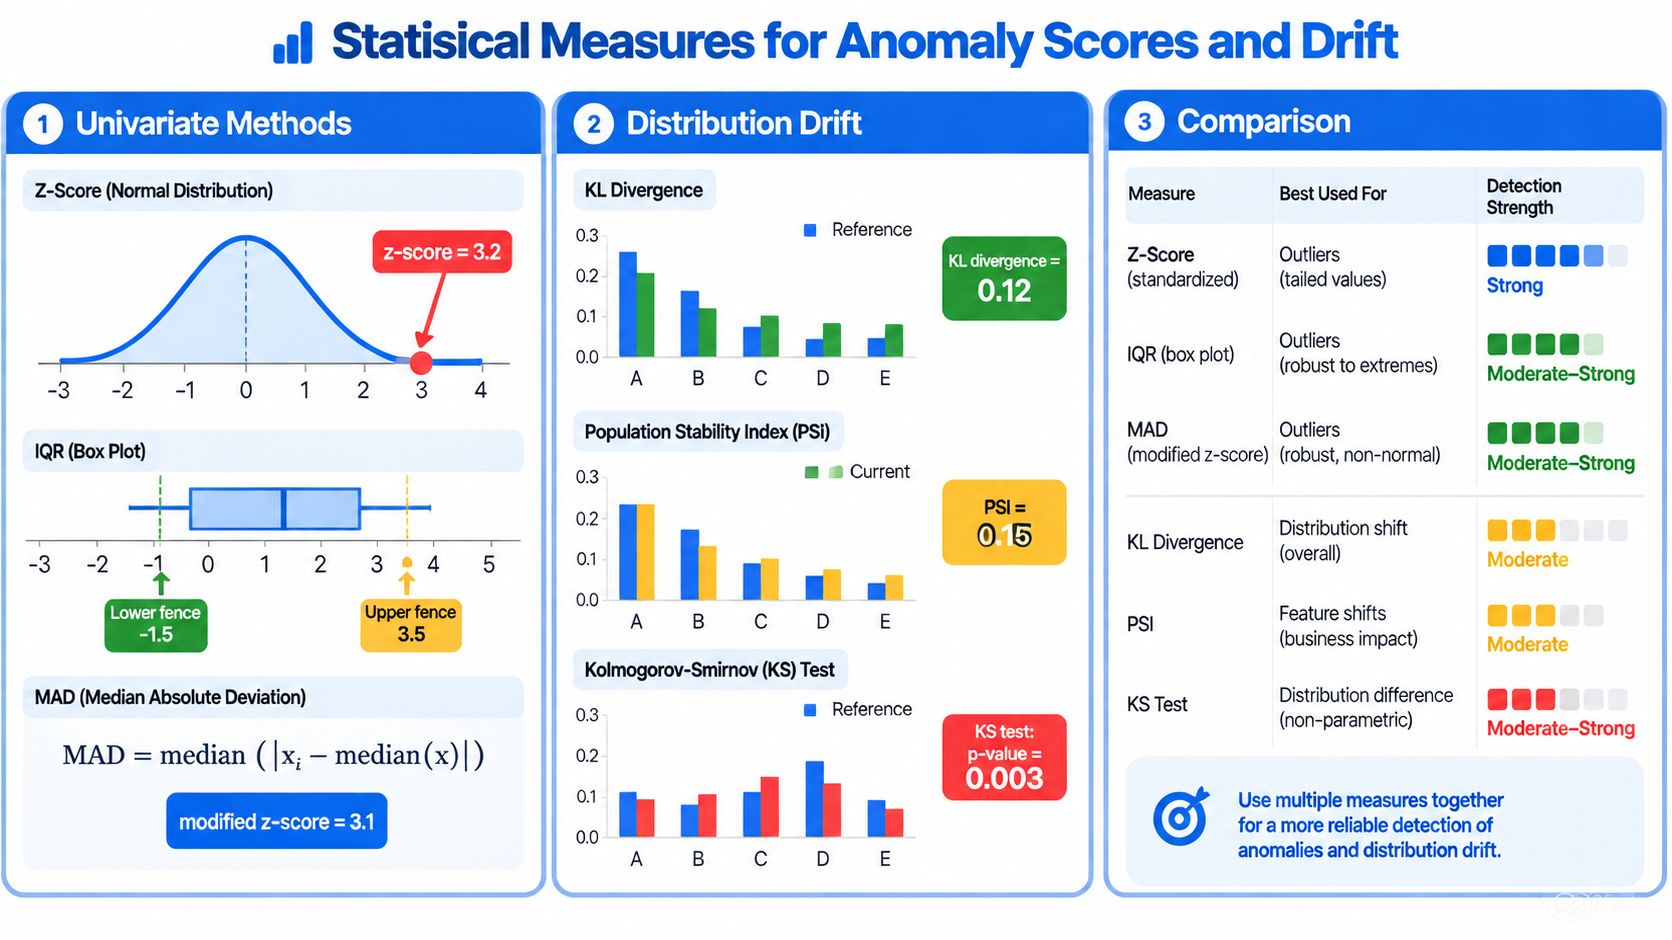
I metodi univariati esaminano una metrica alla volta. Uno z-score indica quante deviazioni standard separano il valore di oggi dalla media. Uno z-score modificato usa la mediana e il MAD, utile quando i dati contengono outlier. Anche le soglie IQR sono semplici, perché segnalano i valori che cadono oltre la dispersione centrale della distribuzione.
I metodi basati sulla distribuzione confrontano la forma di un campione con quella di un altro. La divergenza KL, il PSI e il test KS sono scelte comuni quando volete sapere se l'istogramma di una colonna si è spostato in modo significativo.
Le baseline consapevoli del tempo gestiscono la stagionalità. Una metrica giornaliera può sembrare allarmante se confrontate il lunedì mattina con la domenica sera, quindi le baseline mobili per giorno della settimana, ora del giorno o calendario aziendale sono di solito più sicure di un'unica soglia fissa.
Per un esempio concreto, prendete daily_active_users. Se calcolate media e deviazione standard mobili su 14 giorni, il volume di oggi può essere confrontato con questa baseline mobile. Un semplice alert può scattare quando il valore supera i 3 sigma o scende sotto la baseline del 10° percentile. Questa impostazione bilaterale è importante perché sia i picchi sia i cali possono invalidare le ipotesi a valle.
L'errore più grave in questo caso è usare soglie unilaterali per dati stagionali. Una serie di traffico retail, un batch di regolamento e un feed di login di un'app B2B non hanno la stessa forma, quindi un'unica regola universale tende a creare alert fatigue invece di chiarezza. Il costo di troppi falsi positivi è reale, perché i team reperibili smettono di fidarsi degli alert che avrebbero dovuto proteggerli.
Le indicazioni sul rilevamento del data drift sono un utile complemento se volete vedere come il monitoraggio del drift si traduce in pattern di produzione. L'idea chiave è la stessa: misurate lo scostamento rispetto alla baseline giusta, non rispetto a un'idea astratta di normalità.
Conteggi delle modifiche allo schema e segnali di drift strutturale
Lo schema drift diventa gestibile quando smettete di trattarlo come un vago problema di compatibilità e iniziate a misurarlo. Un campo rinominato, un cambio di tipo o una colonna rimossa sono più facili da indirizzare quando l'alert nomina l'esatto evento strutturale e indica il responsabile prima del deploy.
Quattro metriche che rendono visibile la struttura
schema_change_count conta aggiunte, rimozioni e cambi di tipo per ogni esecuzione della pipeline. Se una sorgente inizia ad aggiungere colonne ogni settimana, il conteggio mostrerà il pattern molto prima che il modello a valle si rompa.
backward_incompatible_change_rate è la quota di modifiche allo schema che possono compromettere i consumatori esistenti. Vi dice se il cambiamento avviene in modo sicuro o pericoloso.
drift_detection_latency_minutes misura il tempo che intercorre tra un commit o un rilascio a monte e l'alert. Se non sapete quanto tempo serve per accorgervi del drift, non sapete davvero quanto sono esposti i vostri consumatori.
orphaned_column_rate traccia i campi che non vengono più letti da alcun modello o dashboard a valle. Queste colonne sono spesso il segno di dipendenze obsolete, logiche dimenticate o un contratto che nessuno mantiene più.
Metrica di drift | Definizione | Calcolo | Esempio | Responsabile |
|---|---|---|---|---|
schema_change_count | Numero di modifiche strutturali per esecuzione | Aggiunte + rimozioni + cambi di tipo | Nel caricamento compare una colonna rinominata | Data platform engineer |
backward_incompatible_change_rate | Quota di modifiche che possono compromettere i consumatori | Modifiche incompatibili / modifiche totali | Un cambio di tipo tronca i valori a valle | Code owner |
drift_detection_latency_minutes | Tempo dal commit all'alert | Orario dell'alert meno orario della modifica | Una migrazione viene notata solo dopo il guasto di una dashboard | Responsabile della pipeline |
orphaned_column_rate | Campi non utilizzati dai consumatori a valle | Colonne non lette / colonne totali | Un campo resta nella tabella ma nessuno lo legge | Analytics engineer |
Qui contano le baseline per singola tabella. Una tabella di eventi ad alta velocità non dovrebbe essere giudicata come una tabella di riferimento che cambia lentamente, perché una delle due sembrerà sempre rumorosa se le costringete nella stessa regola. Indirizzate le modifiche che causano rotture al code owner prima del deploy, non dopo che la dashboard è già andata in errore.
I monitor dei KPI di business come livello decisionale
Le metriche di osservabilità grezze vi dicono che cosa si è rotto. I monitor dei KPI di business dicono al management che cosa significa. Questo livello si colloca sopra freschezza, volume, schema, distribuzione e lineage, e collega questi segnali a risultati come l'accuratezza dei ricavi, l'andamento dei rimborsi, il churn e l'evasione degli ordini.

Costruite il KPI a partire dagli asset sottostanti
Un monitor di livello decisionale parte da una metrica di business affidabile e poi la riconduce agli asset di dati che vi contribuiscono. Una volta note le dipendenze, potete associare metriche di osservabilità a ogni asset e lasciare che il KPI aggregato erediti quei segnali. Se i ricavi del checkout si muovono, non vi limitate a fissare il grafico dei ricavi. Controllate insieme la freschezza degli eventi d'ordine, le anomalie di volume delle righe d'ordine e la stabilità dello schema del catalogo prodotti.
È la differenza tra una dashboard di facciata e un vero monitor di business. Un grafico di facciata può restare verde anche quando uno degli input è mancante o malformato. Un monitor di livello decisionale cerca il percorso di errore sotto il KPI e indirizza il problema al team responsabile del processo di business.
Un buon modello di ownership è semplice. Finanza od operations dovrebbero essere responsabili della definizione del KPI, il team della piattaforma dati dei segnali di osservabilità grezzi e l'analytics engineering della mappa delle dipendenze. In questo modo l'alert non rimbalza tra team che possiedono ciascuno solo una parte del problema.
digna è una piattaforma che combina business monitoring con tempestività, rilevamento delle anomalie, validazione e tracciamento dello schema all'interno dell'ambiente del cliente. Il punto importante non è il marchio, ma il pattern, perché il KPI diventa azionabile solo quando i segnali sottostanti sono visibili e legati a un responsabile chiaro.
I monitor dei KPI dovrebbero essere pochi, perché ognuno richiede una decisione umana associata.
Matrice di riferimento rapido per il catalogo
Un catalogo di riferimento dovrebbe stare in un'unica schermata quando qualcuno sta esaminando un ticket di incidente. L'obiettivo non è mostrare ogni metrica possibile, ma aiutare un responsabile a rispondere rapidamente a una sola domanda: su che cosa dovrei impostare gli alert per questo asset?
La matrice seguente condensa le categorie comuni in un'unica vista operativa. Le soglie sono punti di partenza, non verità universali, e vanno adattate a ogni asset dopo aver stabilito una baseline del comportamento reale.
Categoria di metrica | Calcolo principale | Soglia di alert consigliata | Responsabile tipico | Livello di gravità |
|---|---|---|---|---|
Freschezza |
| Violazione assoluta dello SLA in minuti | Data platform engineer | Alto |
Anomalia di volume | Media e deviazione standard mobili, oppure z-score | Scostamento dalla baseline basato sulla distribuzione | Analytics engineer | Da medio ad alto |
Conteggio delle modifiche allo schema | Numero di aggiunte, rimozioni e cambi di tipo per esecuzione | Numero assoluto di modifiche che causano rotture | Code owner | Alto |
Drift della distribuzione | PSI, test KS o spostamento dell'istogramma | Variazione relativa rispetto alla distribuzione di baseline | Data quality lead | Medio |
Interruzione della lineage | Dipendenza a monte o a valle mancante | Interruzione assoluta nel grafo delle dipendenze | Platform engineer | Alto |
Tasso di valori nulli | Valori nulli divisi per il totale dei record | Aumento relativo rispetto alla baseline | Analytics engineer | Medio |
Univocità | Numero di valori distinti diviso per il numero di righe | Calo assoluto o relativo dell'univocità | Data steward | Medio |
Monitor dei KPI di business | KPI derivato da più segnali | Scostamento dalla banda di tolleranza di business | Business owner | Critico |
Se cercate una tabella di piattaforma che rifletta questo tipo di approccio a catalogo, la tabella di sistema delle metriche di digna mostra come le famiglie di metriche possono essere organizzate per l'uso operativo. La matrice migliore è quella che il vostro team riesce a mantenere durante un incidente, non quella con più righe.
Collegamenti tra le categorie di metriche
Una pipeline in ritardo spesso inizia con un mancato rispetto della freschezza e poi si manifesta come anomalia di volume, perché sono arrivate meno righe rispetto alla baseline. Trattate questa coppia come un unico percorso di incidente, non come due alert scollegati.

Dalla freschezza al volume, dallo schema alla distribuzione, dalla lineage al drift
Una modifica allo schema e un picco del tasso di valori nulli arrivano spesso insieme dopo la migrazione di un'API di un fornitore. Una sola modifica al payload può creare sia un problema di campi mancanti sia un problema di forma dei valori, quindi un alert sullo schema dovrebbe essere verificato rispetto al monitor della distribuzione prima di chiudere il ticket.
Le interruzioni della lineage possono anche attivare alert di drift a valle quando una sorgente mancante modifica ogni tabella dipendente. Le baseline per singolo asset mantengono il confronto onesto, perché una tabella di regolamento giornaliera e un flusso di eventi ad alta frequenza possono essere entrambi sani pur comportandosi in modo molto diverso.
Codificate queste tre coppie come controlli di follow-up nel vostro strumento di alerting, in modo che il secondo segnale venga interrogato automaticamente quando scatta il primo.
Scegliere l'insieme minimo di metriche che contano
Un insieme di metriche è utile solo quando cambia una decisione. Se un alert non indica un responsabile o una probabile soluzione, diventa rumore.
Iniziate con uno SLA di freschezza per ogni livello critico, un punteggio di anomalia sui volumi legati ai ricavi, conteggi delle modifiche allo schema sulle tabelle che possono compromettere i consumatori a valle e un monitor dei KPI per ogni processo di business principale. Per una piattaforma di pagamenti, questo set iniziale potrebbe comprendere uno SLA di freschezza sulla tabella delle transazioni, un punteggio di anomalia a 3 sigma sul volume di regolamento giornaliero, conteggi delle modifiche allo schema sulla tabella clienti e un monitor dei KPI sul tasso di rimborso.
Scegliete le metriche in base a ownership, storico degli incidenti e raggio d'impatto. Rivedete l'elenco ogni trimestre, perché gli asset cambiano, le modalità di errore cambiano e il catalogo dovrebbe cambiare con loro.
Domande frequenti
Che cosa sono le metriche di data observability?
Misure in serie temporale rilevate sugli asset di dati e sulle pipeline che li movimentano. Un nome come null_rate_email_hourly dice a un analista molto più di check_7, perché contiene già l'oggetto, la misura e la cadenza prima ancora che qualcuno apra la definizione.
In che cosa le metriche differiscono dai controlli di qualità dei dati?
Un controllo risponde a una domanda sì/no in un determinato momento; una metrica viene seguita nel tempo, ha una baseline e può generare alert. Il criterio utile è semplice: se il team la esegue solo quando qualcuno sospetta un problema, è un test, non osservabilità.
Quali sono le cinque categorie di metriche?
Freschezza, volume, schema, distribuzione e lineage. Ognuna ha una diversa firma di errore: la freschezza riguarda il ritardo più che il fatto che un job sia stato eseguito, il volume verifica se il numero di record è più o meno quello atteso e la distribuzione guarda al comportamento dei valori anziché ai conteggi.
Perché un team ha bisogno di un catalogo di metriche condiviso?
Per fermare la deriva negli incidenti. Quando un data lead, un analista e un ingegnere intendono tutti la stessa cosa con «dati in ritardo», smettono di tradurre e iniziano a risolvere. Se due persone possono non essere d'accordo sul fatto che un problema riguardi freschezza, volume o schema, il catalogo non è ancora abbastanza specifico.
Che cosa dovrebbe documentare ogni voce del catalogo?
Tre elementi: la definizione in parole semplici, il metodo di calcolo che la sostiene e la politica di alerting, cioè se la metrica genera un avviso, una chiamata o alimenta solo l'analisi. È quest'ultimo campo a impedire che un catalogo si trasformi in rumore indistinto.


