Guida ai data design pattern per team moderni
|
8
min di lettura

Il vostro team dispone di un warehouse, di una pipeline di streaming e di dashboard che non concordano sulla stessa metrica relativa ai clienti. Un analista si fida della tabella finance, un altro di un mart dipartimentale e un terzo ha aggiunto un filtro per far quadrare il report di ieri. Il problema non è necessariamente la tecnologia del database. È che nessuno si è accordato sul data design pattern, ovvero le regole che stabiliscono come le informazioni vengono strutturate, governate e verificate una volta in produzione.
Un buon pattern non si limita a produrre un diagramma architetturale accattivante. Offre agli ingegneri un modo ripetibile per acquisire i dati, collegare fatti correlati, servire carichi di lavoro diversi e far emergere i problemi prima che gli utenti prendano decisioni basate su informazioni errate. I pattern più solidi rendono inoltre esplicita la responsabilità, definiscono quali cambiamenti sono accettabili e conservano le prove di ciò che il sistema sapeva in un determinato momento.
Indice
Che cosa significa davvero data design pattern
Di solito i team ricorrono a un pattern dopo il primo, doloroso disaccordo. Una pipeline funziona per un reparto, poi un altro team ha bisogno degli stessi dati con una definizione, una pianificazione di consegna o uno storico diversi. Gli ingegneri iniziano ad aggiungere eccezioni. Gli analisti creano trasformazioni duplicate. Alla fine l'organizzazione si ritrova con più risposte a una domanda che dovrebbe averne una sola.
Pensate a un data design pattern come a una ricetta di cucina. La ricetta non impone la marca del forno né il colore dei piatti. Specifica gli ingredienti, l'ordine di preparazione, le relazioni tra i componenti e i controlli che dicono al cuoco se il piatto può essere servito in sicurezza. Un pattern di dati fa lo stesso per i sistemi informativi.

La struttura è solo il primo livello
Un pattern è una risposta riutilizzabile a un problema di progettazione ricorrente. Può organizzare fatti e dimensioni analitici, conservare ogni evento di business, centralizzare definizioni condivise o consentire ai domini di pubblicare data product secondo standard comuni. Il pattern fornisce al team un vocabolario per prendere decisioni prima che i dettagli implementativi prendano il sopravvento.
Un diagramma architetturale mostra componenti e connessioni. Un pattern va oltre, spiegando perché quei componenti esistono e come si comportano quando le cose cambiano. Due diagrammi possono sembrare simili e produrre risultati molto diversi se uno definisce ownership, storico e validazione e l'altro lascia queste domande senza risposta.
Un pattern pratico risponde a tre domande:
Come sono strutturati i dati? Identificate entità, eventi, relazioni, granularità, chiavi, storico e modelli di serving.
Come sono governati i dati? Definite ownership, convenzioni di denominazione, significato di business, accessi, lineage e regole di compatibilità.
Come diventano visibili i problemi? Specificate aspettative di freschezza, controlli di validazione, monitoraggio dello schema, soglie per le anomalie ed escalation.
Regola pratica: se un pattern non spiega che cosa succede quando un caricamento arriva in ritardo o un campo cambia tipo, è uno schizzo strutturale, non un design operativo.
Questa distinzione è importante prima di scegliere un warehouse, un lakehouse, un message broker o uno strumento di orchestrazione. La tecnologia può implementare un pattern, ma non può decidere se lo storico degli indirizzi di un cliente debba stare in uno stream di eventi immutabile, in una tabella dello stato corrente o in entrambi. È il team che deve prendere prima questa decisione e poi codificarla in modo coerente.
Come l'enterprise data warehousing ci ha dato i primi pattern
Alla fine degli anni '80 le aziende cercavano di trasformare informazioni sparse tra i sistemi operativi in qualcosa che i dirigenti potessero usare per le analisi. Un articolo pubblicato nel 1988 sull'IBM Systems Journal utilizzò l'espressione “business data warehouse”, una tappa importante nella formalizzazione dell'idea di integrare le informazioni provenienti da più sistemi operativi per l'analisi di business. William Inmon sviluppò in seguito il pattern di warehouse orientato all'impresa e pubblicò Building the Data Warehouse nel 1992.
Considerate un'organizzazione sanitaria che cerca di rispondere a una domanda semplice: quanto ha speso ciascun reparto per un episodio di cura di un paziente? I sistemi sorgente potrebbero registrare separatamente appuntamenti, richieste di rimborso, pagamenti e informazioni sui fornitori di prestazioni. Con l'approccio di Inmon, l'organizzazione porta prima dati dettagliati, storici e integrati in un enterprise warehouse centrale. Il livello di integrazione riduce le definizioni incoerenti prima che i team a valle ricevano sottoinsiemi tematici. Il pattern di Inmon utilizza in genere strutture relazionali normalizzate, che favoriscono la tracciabilità e riducono la ridondanza nel livello condiviso.
Questo approccio tratta il warehouse come il registro del significato, gestito con cura, dell'organizzazione. Un team finance e un team di operazioni cliniche possono comunque ricevere viste diverse, ma entrambi ereditano le stesse fondamenta governate.
L'approccio dimensionale di Ralph Kimball parte da una domanda diversa: quale processo di business devono analizzare gli utenti? Il suo metodo, formalizzato in The Data Warehouse Toolkit, pubblicato per la prima volta nel 1996, ha reso popolari fact table, dimension table, star schema e dimensioni conformi. Il team sanitario potrebbe costruire una fact table delle richieste di rimborso collegata alle dimensioni paziente, fornitore di prestazioni, reparto, ente pagatore e tempo. Gli analisti possono interrogare direttamente il processo di business senza dover navigare un modello aziendale fortemente normalizzato.
La maggior parte delle organizzazioni combina le due filosofie. Mantiene un livello canonico o integrato per significato condiviso, lineage e governance, e poi pubblica mart dimensionali per il reporting e l'analisi dei KPI. Questo modello ibrido è ancora visibile nelle moderne architetture di enterprise data warehouse, anche quando l'infrastruttura sottostante è un cloud warehouse o un lakehouse.
La lezione duratura è semplice. Dove risiede la verità e come la verità viene consumata sono decisioni correlate, ma non sono la stessa decisione.
La modellazione dimensionale nella pratica
Un team commerciale raramente chiede: “Posso esplorare il vostro modello relazionale normalizzato?”. Chiede: “Quanto abbiamo venduto, a chi, in quale punto vendita e in quale periodo?”. La modellazione dimensionale funziona bene perché organizza i dati attorno a queste domande di business.
Partite da un evento misurabile, come una riga d'ordine. La fact table memorizza i dettagli numerici e operativi dell'evento, tra cui quantità, ricavo, sconto, timestamp dell'ordine, chiave del prodotto, chiave del cliente e chiave del punto vendita. Le dimension table forniscono il contesto descrittivo che rende utile ogni riga. Il prodotto descrive l'articolo, il cliente descrive l'acquirente, il punto vendita descrive la sede e il tempo fornisce gli attributi di calendario e di reporting.
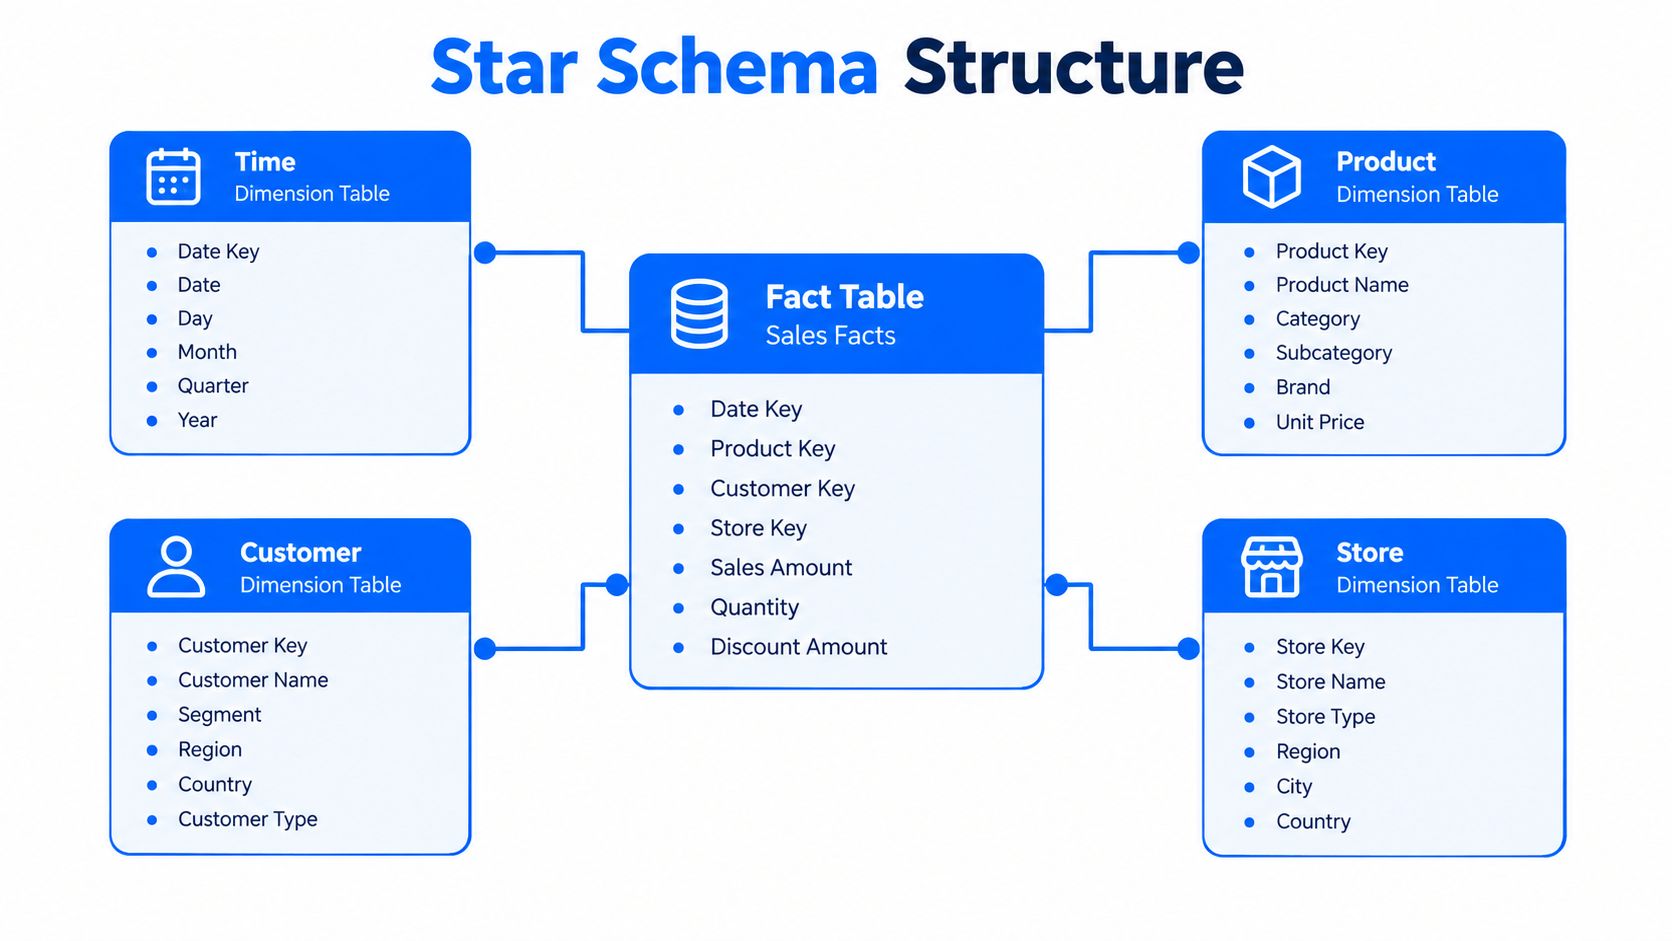
La granularità viene prima delle colonne
Prima di aggiungere campi, dichiarate la granularità in una frase: “Una riga rappresenta un prodotto in un ordine”. Questa frase previene un errore comune, ovvero mescolare valori a livello di ordine e a livello di riga nella stessa fact table. Se il ricavo viene ripetuto su più righe di prodotto, una semplice somma può sovrastimare le vendite.
Una dimensione conforme utilizza la stessa definizione di business in tutti i mart. Se la dimensione cliente significa “cliente di fatturazione” in ambito finance ma “utente finale” nella product analytics, il nome condiviso crea una falsa coerenza. I team devono definire significato, chiavi, storico e relazioni valide, e poi rendere queste regole disponibili a ogni consumatore. Le indicazioni su fact table e dimension table possono aiutare i team a stabilire questo vocabolario prima di costruire i report.
L'accuratezza storica comporta un'ulteriore scelta di design. Supponiamo che un cliente passi dal segmento piccole imprese al segmento enterprise. Una dimensione dello stato corrente mostrerà il segmento più recente, ma un report storico sulle vendite potrebbe aver bisogno del segmento valido al momento di ciascun ordine. Le tecniche di slowly changing dimension conservano lo storico appropriato, a seconda che il business voglia mantenere i valori precedenti, sovrascriverli o registrare periodi di validità.
Dove il pattern dimostra il suo valore
La modellazione dimensionale ripaga quando le domande prevalenti riguardano quanto, quanto spesso, dove, quando o da parte di chi. Gli star schema sono accessibili per gli analisti, supportano join prevedibili e rendono più facile condividere la logica dei KPI. Un contratto stabile tra fatti e dimensioni offre inoltre ai team di qualità punti chiari in cui verificare l'integrità referenziale, i tassi di valori nulli, le chiavi duplicate e le misure inattese.
Il pattern mostra i suoi limiti quando il carico di lavoro dipende da documenti irregolari, da eventi non strutturati ad alto volume o dalla ricostruzione, a livello di audit, di ogni cambiamento di stato. Può rappresentare questi input, ma forzare ogni problema in uno star schema spesso nasconde lo storico originale degli eventi. Per questo molte piattaforme mature conservano record grezzi o canonici ed espongono i mart dimensionali come livello di serving.
Event sourcing e logica append-only
Il saldo di un conto sembra un valore di stato corrente, ma la riconciliazione dipende dallo storico che c'è dietro. Se un saldo viene modificato in modo errato e il sistema memorizza solo l'ultimo numero, chi indaga non ha un modo affidabile per ricostruire come è stato ottenuto.
L'event sourcing adotta l'approccio opposto. Invece di aggiornare sul posto una riga di saldo, il sistema registra eventi come un deposito, un prelievo, un bonifico o una rettifica. Il saldo corrente diventa una proiezione calcolata a partire da quello storico ordinato.

Dagli eventi a uno stato utilizzabile
Il pattern si compone di tre parti pratiche:
Event store append-only: ogni cambiamento di business viene registrato come nuovo evento. Gli eventi esistenti non vengono sovrascritti.
Proiezione: un consumatore legge gli eventi e costruisce una rappresentazione interrogabile, come il saldo corrente del conto.
Replay e correzione: se la logica di proiezione cambia o lo stato si corrompe, il team può ricostruirlo a partire dallo storico degli eventi.
Una rettifica non cancella la transazione originale. Aggiunge un evento compensativo che preserva la cronologia. Questo rende il sistema utile per audit, debugging, analisi storiche e riproduzione degli incidenti.
Il modello di lettura potrebbe non aggiornarsi esattamente nello stesso istante del log degli eventi. I team devono quindi accettare e comunicare la consistenza eventuale laddove si adatta al processo di business. Servono inoltre versioning degli eventi, consumatori idempotenti, regole di ordinamento, decisioni sulla conservazione dei dati e una strategia di snapshot per quando il replay di uno storico lungo diventa troppo oneroso.
Sceglietelo per la tracciabilità, non per moda
L'event sourcing è una base solida quando il business deve rispondere alla domanda: “Che cosa è successo, in quale ordine e perché lo stato corrente appare così?”. Registri contabili, storici dei workflow, movimenti di magazzino ed eventi di dominio distribuiti sono candidati naturali.
Non è una buona scelta predefinita per ogni applicazione CRUD. Le letture diventano più complesse perché gli utenti hanno spesso bisogno di una proiezione anziché del log sorgente. I team devono mantenere il codice delle proiezioni e gestire la convergenza ritardata. Una tabella convenzionale dello stato corrente può essere più chiara quando il business ha bisogno solo dell'ultimo valore e non richiede uno storico ricostruibile.
I team che lavorano con un lakehouse possono combinare un'ingestione orientata agli eventi con un open table format e modelli di serving materializzati. La panoramica sugli open table format offre un contesto utile per separare lo storico durevole dei dati dai modelli interrogati dai consumatori.
Il log degli eventi è la prova. La proiezione è l'interpretazione comoda.
Modelli canonici e ownership di dominio a confronto
Un modello canonico sostiene che l'organizzazione debba accordarsi su definizioni condivise a livello di integrazione. Un modello di proprietà del dominio sostiene che il team più vicino a una capacità di business debba pubblicare un data product utilizzabile e assumersi la responsabilità della sua qualità.
Nessuna delle due posizioni risolve ogni problema. Un modello centrale può prevenire definizioni contrastanti, ma un team centrale può diventare una coda per ogni modifica. Un modello di dominio può avvicinare le decisioni alla sorgente, ma team separati possono pubblicare significati incompatibili di “cliente”, “conto attivo” o “ordine completato”.
Dimensione | Modello canonico | Data Mesh |
|---|---|---|
Ownership | Un team centrale dei dati o dell'integrazione gestisce le definizioni condivise | I team di dominio sono proprietari dei data product creati a partire dalle loro capacità di business |
Governance | Regole aziendali coerenti sono più facili da applicare in modo centralizzato | Standard federati coordinano i team senza togliere responsabilità ai domini |
Velocità di delivery | Le modifiche trasversali ai domini possono richiedere revisione e allineamento centrali | I domini possono iterare più velocemente nel rispetto di regole di interoperabilità condivise |
Rischio | Il team centrale può diventare un collo di bottiglia o allontanarsi dal contesto delle sorgenti | Definizioni, qualità e interfacce possono divergere in assenza di contratti solidi |
Il caso del modello canonico
I modelli canonici sono adatti alle organizzazioni che necessitano di un vocabolario normativo comune, di controlli finanziari condivisi o di tracciabilità tra reparti. Il livello di integrazione funziona come un dizionario: risolve le differenze tra i sistemi sorgente prima che analisti e applicazioni consumino i dati.
Il costo è il coordinamento. Un team centrale deve conoscere molti domini, gestire le richieste di modifica e mantenere il modello rilevante man mano che il business evolve. Se diventa l'unico gruppo autorizzato a pubblicare dati utili, la delivery rallenta e gli esperti di dominio perdono la ownership.
Il caso del modello di dominio
Il data mesh assegna la ownership a domini come fatturazione, logistica o assistenza clienti. Ogni dominio pubblica i dati come prodotto, con documentazione, aspettative di qualità, controlli di accesso e un impegno di servizio. Un livello di governance federata definisce comunque regole condivise per interoperabilità, sicurezza e reperibilità.
Questo funziona solo se i team di dominio hanno le competenze e la capacità per gestire data product. L'organizzazione deve fornire strumenti comuni e far rispettare i contratti, altrimenti la decentralizzazione si traduce in pipeline duplicate con presupposti diversi. I team che lavorano lungo i confini di dominio possono trarre vantaggio anche da questa guida sulla modellazione degli aggregati per il SaaS, soprattutto quando ownership di business e confini di sistema devono essere allineati.
Un compromesso pratico mantiene un livello canonico per i concetti condivisi ad alto rischio e consente ai domini di pubblicare prodotti specializzati attorno a esso. La data governance federata può sostenere questo equilibrio definendo che cosa deve essere coerente ovunque e che cosa i domini possono adattare a livello locale.
I tre pattern principali a confronto
I tre pattern risolvono problemi primari diversi. La modellazione dimensionale ottimizza la navigazione analitica. L'event sourcing preserva una sequenza di cambiamenti. La modellazione canonica stabilisce un significato condiviso tra sistemi e team.
Le loro differenze diventano più chiare quando li valutate in base al carico di lavoro anziché alle preferenze personali.
Criterio | Modellazione dimensionale | Event sourcing | Modello canonico |
|---|---|---|---|
Prestazioni delle query | Ottime per query BI e aggregazioni ripetute | Spesso richiede proiezioni o snapshot per letture comode | Dipendono dal livello di serving, le strutture normalizzate possono richiedere modelli a valle |
Adeguatezza per la governance | Contratti chiari per metriche e dimensioni | Storico e tracciabilità solidi, con una maggiore disciplina nella gestione degli eventi | Il più forte per definizioni centrali, lineage e dati condivisi regolamentati |
Preparazione per l'AI | Utile per feature curate e metriche di business etichettate | Prezioso per replay, feature temporali e storici comportamentali | Utile per feature coerenti e semantica condivisa tra domini |
Costo operativo | Moderato, con manutenzione della modellazione e delle dimensioni storiche | Più elevato, perché log, proiezioni, versioning e replay devono essere gestiti | Costo di coordinamento più elevato, soprattutto quando molti domini dipendono da modifiche centrali |
Domanda di partenza migliore | “Che cosa devono aggregare e confrontare gli utenti?” | “Quale sequenza ha prodotto questo stato?” | “Quale definizione deve condividere ogni sistema?” |
La tabella non indica un vincitore universale, perché una piattaforma reale ha spesso bisogno di tutti e tre. Un livello canonico può stabilire definizioni condivise di cliente, prodotto e dati finanziari. I mart dimensionali possono trasformare queste definizioni in modelli di reporting accessibili. I log degli eventi possono conservare le prove necessarie per ripetere o sottoporre ad audit i cambiamenti importanti.
Individuate il carico di lavoro dominante
Chiedete al team quale problema sarebbe più dannoso:
Un report lento o poco chiaro: partite dalla modellazione dimensionale e definite la granularità di ogni fatto.
Un cambiamento di stato non tracciabile: conservate gli eventi e costruite le proiezioni a partire dallo storico append-only.
Definizioni aziendali contrastanti: stabilite concetti canonici, ownership e controllo delle modifiche.
Input per l'AI che derivano senza preavviso: aggiungete monitoraggio comportamentale e ownership a qualunque pattern strutturale scegliate.
La preparazione per l'AI non è solo una questione di storage. Embedding, distribuzioni delle feature, risultati del retrieval e tempestività degli input dei modelli possono cambiare mentre lo schema della tabella resta valido. Un pattern che governa solo le colonne può non accorgersi di un errore semantico.
Perché un diagramma pulito non basta
Una lavagna può mostrare un flusso impeccabile dai sistemi sorgente a un warehouse, a un mart, a una dashboard e a un modello. Non può mostrare chi riceve l'alert quando il file di ieri arriva in ritardo, quale regola valida l'importo di una richiesta di rimborso o come un auditor dimostra che un report ha utilizzato i dati corretti in un determinato momento storico.
Questo divario trasforma l'architettura in rischio operativo. Un pattern affidabile definisce il comportamento di consegna atteso, il punto in cui avviene la validazione, la ownership, la politica di compatibilità e le prove conservate dopo ogni caricamento importante.
Affiancate controlli di affidabilità al movimento dei dati
Un team che sceglie un pattern dovrebbe specificare i controlli in tre punti:
Ingestione: verificate arrivo, volume, struttura di base, duplicati e campi obbligatori.
Trasformazione: validate regole di business, relazioni, valori ammessi e logica di riconciliazione.
Consumo: monitorate il comportamento dei KPI, la freschezza percepita dagli utenti, i guasti a valle e l'idoneità degli input dei modelli.
L'evoluzione dello schema richiede lo stesso trattamento. L'aggiunta di campi nullable può essere compatibile con i consumatori esistenti, mentre il restringimento di un tipo o una ridenominazione semantica possono comprometterli. Il layout delle partizioni dovrebbe restare, ove possibile, un dettaglio implementativo, in modo che i consumatori interroghino tabelle logiche anziché percorsi di directory codificati. L'evoluzione guidata dai metadati, come documentato nelle linee guida di design di Apache Iceberg, consente di modificare i layout fisici mentre i file storici mantengono le loro specifiche originali.
Le evidenze cambiano lo standard
Oltre il 56% degli intervistati in un sondaggio sull'analytics engineering ha indicato la qualità dei dati come la sfida segnalata più frequentemente, mentre il 38% prevedeva di aumentare gli investimenti in qualità dei dati o observability nell'anno successivo, secondo lo State of Analytics Engineering 2025 di dbt. Questi dati sostengono una conclusione pratica: governance e observability fanno parte del pattern, non di un backlog operativo successivo.
Un design affidabile rende i dati errati più facili da individuare, spiegare, contenere e correggere.
Per ogni dataset critico, registrate il responsabile, il comportamento di consegna atteso, la versione dello schema, i risultati della validazione, il lineage e lo storico degli incidenti. Poi definite che cosa succede quando un controllo fallisce. La pipeline si ferma, mette in quarantena i record, pubblica un avviso o prosegue con uno stato degradato esplicito? La risposta giusta dipende dall'impatto sul business, ma lasciarla indefinita garantisce reazioni incoerenti.
Scegliere e rendere operativo il vostro pattern
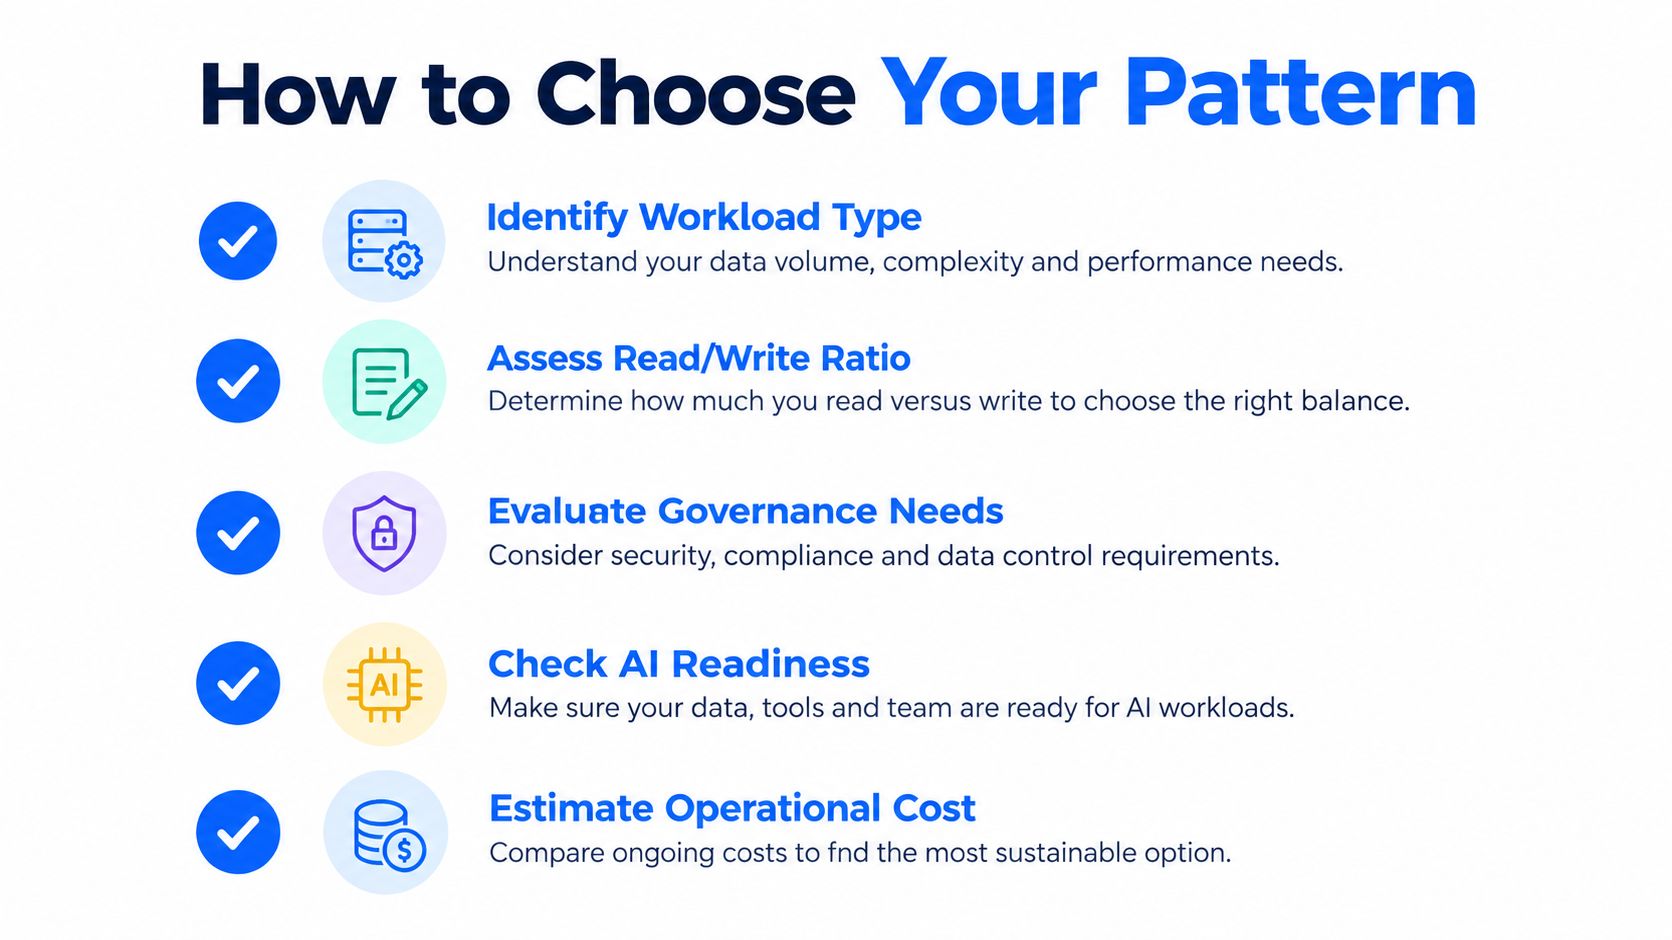
Conducete una breve revisione del design e mettete per iscritto cinque decisioni:
Individuate il carico di lavoro dominante. Reporting, audit, serving operativo, reazione in tempo reale e generazione di feature per l'AI richiedono strutture diverse.
Scegliete il pattern principale. Selezionate il modello che risolve il problema più importante, poi aggiungete consapevolmente i livelli di supporto.
Definite i contratti. Stabilite granularità, chiavi, significati, aspettative di freschezza, compatibilità dello schema e ownership.
Associate i controlli. Aggiungete monitoraggio degli arrivi, validazione dei record, rilevamento delle anomalie, alert sullo schema drift, lineage ed evidenze storiche.
Testate il comportamento in caso di errore. Simulate dati in ritardo, valori inattesi, modifiche strutturali, eventi duplicati e ricostruzioni delle proiezioni.
Per i carichi di lavoro di AI, estendete la checklist oltre le colonne. Decidete come il team rileverà l'embedding drift, i cambiamenti nella distribuzione delle feature, il degrado del retrieval e gli input obsoleti dei modelli. Una tabella tecnicamente valida può comunque produrre un modello inaffidabile se il suo comportamento cambia senza un responsabile identificato.
Una piattaforma come l'approccio di digna al data product management può inserirsi in questo livello operativo combinando validazione in-database, monitoraggio della tempestività, rilevamento delle anomalie e tracciamento delle modifiche allo schema all'interno dell'ambiente del cliente. La decisione importante non è solo lo strumento. È se il pattern fornisce a persone identificate prove sufficienti per agire quando i dati smettono di comportarsi come previsto.
digna aiuta i team a monitorare il comportamento dei dati all'interno del proprio ambiente tramite validazione in-database, monitoraggio della tempestività, rilevamento delle anomalie e tracciamento delle modifiche allo schema. Se state trasformando un diagramma architetturale statico in un contratto operativo di affidabilità, visitate digna per scoprire come la piattaforma può supportare questo lavoro.
Poiché il restringimento di un tipo o una ridenominazione semantica possono compromettere i consumatori mentre ogni pipeline continua a funzionare, lo Schema Tracker di digna registra le modifiche strutturali nelle tabelle monitorate, così la politica di compatibilità del vostro pattern ha un alert a supporto.
Domande frequenti
Che cos'è un data design pattern?
Un data design pattern è una risposta riutilizzabile a un problema ricorrente nei dati che copre tre aspetti: come i dati sono strutturati, come sono governati e come i problemi diventano visibili. Come una ricetta, definisce ingredienti, ordine e controlli, non la marca del forno, e quindi orienta le decisioni prima che scegliate un warehouse o uno strumento.
Qual è la differenza tra l'approccio di Inmon e quello di Kimball?
Inmon parte da un enterprise warehouse centrale e normalizzato che integra lo storico dettagliato prima che i team ricevano sottoinsiemi tematici. Kimball parte dal processo di business, costruendo fact table, dimension table e star schema per l'analisi diretta. La maggior parte delle organizzazioni combina entrambi, mantenendo un livello integrato per il significato condiviso e pubblicando mart dimensionali per il reporting.
Perché si dovrebbe definire per prima la granularità di una fact table?
Dichiarare la granularità, ad esempio una riga per prodotto in un ordine, evita di mescolare valori a livello di ordine e a livello di riga nella stessa tabella. Senza di essa, un ricavo ripetuto su più righe di prodotto viene sommato più volte e sovrastima le vendite. La frase sulla granularità va scritta prima di aggiungere qualsiasi colonna.
Quando conviene usare l'event sourcing invece di una tabella dello stato corrente?
Usate l'event sourcing quando il business deve spiegare che cosa è successo, in quale ordine e perché lo stato corrente appare così. Registri contabili, storici dei workflow e movimenti di magazzino sono casi adatti. Per le applicazioni CRUD che necessitano solo dell'ultimo valore, una tabella semplice è più chiara, poiché proiezioni e consistenza eventuale comportano costi operativi reali.
Una piattaforma dati dovrebbe usare un modello canonico o il data mesh?
Spesso entrambi. Un compromesso pratico mantiene un livello canonico per i concetti condivisi ad alto rischio, come le definizioni di cliente, prodotto e dati finanziari, mentre i team di dominio pubblicano data product specializzati attorno a esso. La governance federata stabilisce poi che cosa deve essere coerente ovunque e che cosa i domini possono adattare localmente, evitando sia un collo di bottiglia centrale sia definizioni divergenti.


