10 strumenti di data testing per workflow di dati affidabili
|
10
min di lettura

Il consiglio più diffuso sugli strumenti di data testing è anche il meno utile: scegliere la piattaforma con l'elenco di funzionalità più lungo. Questo approccio ignora il guasto che dovete intercettare. Una regola deterministica può dimostrare che una chiave è univoca, ma non rileverà necessariamente una distribuzione insolita. Un rilevatore di anomalie può segnalare uno spostamento inatteso, ma potrebbe non dimostrare che un campo regolamentare rispetta una regola di business esatta. Una piattaforma di lineage può mostrare chi è interessato, mentre uno strumento di diffing può dirvi con precisione che cosa è cambiato dopo un aggiornamento del codice.
La scelta pratica consiste nel distinguere test deterministici, rilevamento delle anomalie, observability, diffing di regressione e validazione su scala Spark. Poi confrontate ogni strumento in base al perimetro di deployment, all'impegno di configurazione, all'integrazione nei workflow, alla copertura, all'onere di manutenzione e ai limiti. I team che valutano dati immobiliari, ad esempio, hanno comunque bisogno di un processo più ampio per garantire l'accuratezza dei dati immobiliari, non solo di una dashboard di alert.
L'elenco seguente confronta gli strumenti in base al workflow che supportano. digna è incluso per i team che necessitano di monitoraggio nel proprio ambiente e nel database e di controllo enterprise, ma non è il vincitore universale. La scelta giusta dipende dal fatto che il vostro team debba prevenire rilasci difettosi, monitorare il comportamento dei dati in produzione, validare workload Spark o proteggere dati di produzione sensibili.
Indice
I 10 migliori strumenti di data testing: confronto di funzionalità e capacità
Scegliete lo strumento adatto al guasto che dovete intercettare
1. digna
digna è una piattaforma di data quality e observability sovrana by design di livello enterprise, pensata per i team che non possono trasferire i dati di produzione in un servizio esterno. Viene eseguita nel cloud privato, nella VPC o nell'ambiente on-premises del cliente, e i suoi controlli vengono eseguiti nel database. Questo perimetro è importante nei settori finanziario, sanitario, delle telecomunicazioni e pubblico, dove copiare record sensibili in una piattaforma SaaS può creare complicazioni di sicurezza, privacy e governance.
La piattaforma combina l'apprendimento delle baseline basato sull'IA con metodi statistici. Può rilevare comportamenti insoliti dei dati, monitorare la tempestività, validare i record rispetto alle regole di business, tracciare le modifiche di schema e fornire analytics storiche. Il design modulare consente a un team di iniziare con le anomalie o la tempestività e di aggiungere poi validazione, tracciamento dello schema o analytics man mano che le esigenze operative diventano più chiare. Le funzionalità incluse di scheduling, catalogo, integrazioni e collaborazione riducono la necessità di assemblare un livello operativo separato.
Regola di deployment: se i dati di produzione devono rimanere all'interno della vostra infrastruttura, trattate questo requisito come un vincolo architetturale prima di confrontare gli elenchi di funzionalità.
Il modulo Data Validation di digna supporta controlli a livello di record per campi obbligatori, formati, intervalli, liste di riferimento, condizioni tra campi e vincoli referenziali o di business. Il suo approccio nel database riduce inoltre i trasferimenti di dati non necessari e offre ai team di governance un perimetro di controllo più chiaro. La piattaforma descrive un percorso rapido dall'installazione ai primi insight, disponibili in meno di due ore, anche se il rollout in produzione richiede comunque decisioni interne su infrastruttura, accessi e responsabilità.
Scoprite come digna gestisce la data quality observability quando lo stesso ambiente richiede monitoraggio continuo e controlli basati su regole.
Il principale compromesso è la responsabilità operativa. Il deployment privato dà il controllo al cliente, ma il cliente si fa carico anche di capacity planning, aggiornamenti e supporto dell'infrastruttura. La licenza prevede un canone base più un prezzo per tabella attiva e per modulo, quindi i team dovrebbero stimare il perimetro delle tabelle prima di impegnarsi. È adatto alle organizzazioni che danno più valore alla sovranità e alla tracciabilità che a un'esperienza SaaS completamente senza pensieri.
2. Great Expectations
Great Expectations, comunemente chiamato GX, è una libreria orientata al testing. Gli engineer definiscono controlli dichiarativi chiamati Expectations, li raggruppano in suite ed eseguono validazioni su warehouse, lake, file e altri backend supportati. Il workflow è più vicino al testing del software che al monitoraggio passivo. Scrivete ciò che dovrebbe essere vero, lo eseguite in sviluppo o in CI/CD e conservate il risultato come artefatto verificabile.
La libreria dà il meglio quando un team dati vuole test versionati insieme al codice e spiegati in un formato leggibile. Data Docs trasforma i risultati della validazione in report che analisti, engineer e auditor possono esaminare. Le interfacce Python e CLI rendono GX flessibile tra diversi sistemi di orchestrazione, anche se questa flessibilità comporta lavoro di engineering.
Dove GX si adatta meglio
GX funziona bene per i team che necessitano di controlli personalizzati oltre le regole standard di una piattaforma. Una suite può combinare univocità, valori ammessi, gestione dei null, vincoli di intervallo e logica Python personalizzata. I team possono eseguire questi controlli prima di pubblicare un modello, dopo un caricamento o come parte di una pipeline di rilascio. Il modello open source evita i costi di licenza e dà agli engineer il controllo sul livello di test.
Il limite è la manutenzione. Qualcuno deve progettare le suite, aggiornare le expectation quando cambiano gli schemi o la logica di business, gestire l'esecuzione e decidere quali errori devono bloccare un workflow. GX non sostituisce inoltre una observability completa. Può validare le expectation dichiarate, ma i team potrebbero aver bisogno di un altro sistema per lineage ampio, contesto di utilizzo e comportamento appreso in modo continuo.
GX Core resta l'opzione open source di riferimento. GX Cloud è stato dismesso dopo un'acquisizione a metà 2026, quindi gli acquirenti non dovrebbero contare su una futura GUI ospitata da Great Expectations. I team che valutano la libreria dovrebbero quindi verificare la propria capacità di gestire autonomamente il workflow circostante. L'approccio di digna alle regole di validazione dei dati e alla qualità continua è un utile termine di paragone per i team che desiderano la validazione insieme a un livello di monitoraggio operativo.
3. Soda
Soda si colloca tra un framework di testing orientato agli sviluppatori e una piattaforma di observability gestita. Soda Core offre un punto di ingresso open source, mentre Soda Cloud aggiunge collaborazione, scheduling, rilevamento delle anomalie, data contract e workflow di gestione degli incidenti. Questa suddivisione consente ai team di integrare i controlli nelle pipeline prima di decidere se hanno bisogno di un control plane ospitato più ampio.
Il workflow di base è guidato da YAML. Gli engineer definiscono controlli per condizioni come freschezza, completezza, univocità o valori ammessi, quindi li eseguono tramite il modello ad agente di Soda all'interno del proprio ambiente. È un approccio accessibile per i team che preferiscono una configurazione leggibile a un esteso codice Python. I Data Contracts offrono al team un modo per esprimere le aspettative tra produttori e consumatori, il che può migliorare la responsabilizzazione oltre i confini delle piattaforme.
Il compromesso pratico
Soda Core è utile quando il problema immediato è inserire controlli ripetibili nei workflow di ingestion o trasformazione. Soda Cloud diventa più rilevante quando i team necessitano di una UI condivisa, diagnostica delle anomalie, scheduling e collaborazione oltre il gruppo di engineering. La distinzione è importante perché le capacità avanzate dipendono dal prodotto gestito, e la sua valutazione commerciale passa dal team vendite.
Il modello a contratti richiede anche un accordo organizzativo. Un contratto di cui nessuno è responsabile diventa un altro file di configurazione che perde lentamente rilevanza. I team devono decidere chi definisce la regola, chi riceve l'alert e se una violazione blocca la pubblicazione o genera un avviso.
La generazione di regole e contratti assistita dall'IA di Soda può ridurre l'impegno di configurazione, ma i controlli generati vanno comunque revisionati. I suggerimenti automatici possono accelerare la copertura, ma non possono decidere se una metrica di business può cambiare durante una campagna, un'acquisizione o un periodo di reporting.
I team che confrontano i modelli di deployment possono anche consultare le alternative a Soda per i workflow di data quality, in particolare quando i controlli devono restare vicini al database.

4. Monte Carlo
Monte Carlo è progettato per la data observability end-to-end, non solo per scrivere asserzioni esplicite. Monitora segnali di freschezza, volume, schema e distribuzione, quindi combina il rilevamento delle anomalie con il lineage per consentire ai team di analizzare il probabile impatto. Ciò lo rende particolarmente adatto a una grande piattaforma dati, dove un incidente può interessare molte dashboard, modelli o consumatori a valle.
Il workflow importante è il triage. Un alert di freschezza da solo vi dice che qualcosa è in ritardo. Il lineage può aiutare a capire quali asset dipendono dalla tabella interessata, quali team li utilizzano e da dove dovrebbe partire l'indagine. Il contesto a livello di colonna può inoltre restringere il raggio d'impatto quando cambia solo una parte di un dataset.
Che cosa non sostituisce
Monte Carlo non sostituirà una suite di test guidata dal codice per ogni regola di business. Una regola come “una transazione deve fare riferimento a un conto approvato” richiede un approccio di validazione esplicito. L'observability vi dice che un comportamento è cambiato o che una pipeline non è in salute, ma non codifica automaticamente ogni vincolo di dominio.
L'ampio perimetro della piattaforma può inoltre risultare eccessivo per un piccolo team con una manciata di modelli dbt e un processo di CI chiaro. Il pricing passa dal team vendite, con informazioni pubbliche limitate sui prezzi self-service, quindi una valutazione dovrebbe includere il perimetro delle tabelle monitorate, la retention, le integrazioni e il volume di alert previsto. Chiedete una proof of value realistica basata sugli incidenti che il vostro team ha effettivamente vissuto, non solo una dimostrazione del fornitore.
Monte Carlo è più convincente quando l'analisi d'impatto basata sul lineage e il rilevamento delle anomalie contano quanto l'esecuzione dei test. Lo è meno quando il team ha bisogno soprattutto di controlli deterministici nelle pull request o di una libreria di validazione leggera.

I team dovrebbero distinguere il workflow di observability di Monte Carlo dalla simulazione Monte Carlo, che è un concetto analitico diverso. Il confronto con la simulazione Monte Carlo aiuta a tenere separati questi casi d'uso.
5. Bigeye
Bigeye tratta la data quality come un insieme di metriche su tabelle e colonne. Questa impostazione funziona bene per i team di engineering che desiderano profilazione, rilevamento algoritmico delle anomalie e hook di automazione anziché un'ampia raccolta di asserzioni scritte manualmente. I suoi strumenti per sviluppatori e i workflow API-first si adattano agli ambienti in cui i team gestiscono le data operations tramite codice, pipeline di deployment e integrazioni di servizi.
La piattaforma offre controlli predefiniti, metriche come codice, profilazione, workflow abilitati dal lineage e un'ampia copertura di connettori. Le viste di lineage orientate al business aiutano a tradurre un'anomalia tecnica in una domanda operativa, ad esempio quale report o team potrebbe essere interessato. Ciò può ridurre la distanza tra la diagnosi tecnica e la comunicazione con gli stakeholder.
Metriche e regole a confronto
Un modello mentale basato sulle metriche può richiedere un periodo di onboarding per i team abituati a un testing incentrato sulle regole. Gli engineer devono capire quali metriche meritano di essere monitorate, come si comportano le baseline e quando un alert rappresenta un incidente significativo anziché una normale variazione. È un'abitudine operativa diversa dallo scrivere un test che deve passare o fallire.
L'approccio di Bigeye a sicurezza e integrazioni si adatta agli ambienti enterprise, ma i prezzi non sono pubblicati e il packaging passa dal team vendite. Gli acquirenti dovrebbero chiedere chiarezza su perimetro monitorato, confini di deployment, supporto e lavoro necessario per collegare i sistemi esistenti di orchestrazione e gestione degli incidenti.
La piattaforma è una buona scelta quando i team vogliono che l'observability diventi parte dei workflow di sviluppo. Può essere meno adatta quando l'esigenza principale è un insieme piccolo e trasparente di asserzioni SQL eseguite accanto al codice di trasformazione. In tal caso, i test dbt o un'altra libreria orientata al testing possono essere più facili da mantenere.
6. Anomalo
Anomalo è una piattaforma di monitoraggio AI-native per i team che vogliono scoprire problemi sconosciuti nei dati senza scrivere una regola per ogni possibile guasto. I suoi controlli di machine learning non supervisionato esaminano valori e strutture in dati strutturati, semi-strutturati e non strutturati. Il prodotto copre anche freschezza e comportamento dello schema, con contesto di lineage e un feed di insight che spiega i cambiamenti e suggerisce azioni.
Questo workflow è utile quando un team sa che i dati cambiano in modo inatteso ma non può prevedere ogni modalità di guasto. Segmentazione e spiegabilità possono aiutare a distinguere uno spostamento significativo in un gruppo di clienti o in una regione da un movimento innocuo sull'intera tabella. La configurazione no-code abbassa la barriera iniziale, mentre le API supportano l'integrazione con i workflow di piattaforma esistenti.
Dove i controlli deterministici contano ancora
Il punto di forza di Anomalo è la scoperta. I requisiti di compliance e contrattuali richiedono comunque controlli espliciti. Se un campo deve essere presente, un valore deve rientrare in un intervallo definito o un record deve corrispondere a una lista di riferimento, una regola deterministica è più facile da verificare e sottoporre ad audit rispetto a una baseline inferita.
L'opzione di deployment è importante negli ambienti sensibili. Anomalo può essere fornito come SaaS o installato nella VPC del cliente, ma i team dovrebbero verificare quali dati, metadati, log e accessi di supporto attraversano il perimetro scelto. Dovrebbero anche verificare se le spiegazioni della piattaforma aiutano gli engineer a risolvere gli incidenti o si limitano a descriverli.
Con un pricing gestito dal team vendite, il costo dipende dal volume e dal perimetro monitorati. Un pilota dovrebbe includere la normale stagionalità, segmenti sparsi, modifiche di schema e incidenti noti. Altrimenti, un team potrebbe giudicare il prodotto su dati puliti e trascurare l'onere di manutenzione che emerge dopo l'adozione.
7. Datafold
Datafold affronta un guasto più circoscritto ma importante: che cosa è cambiato dopo una modifica al codice dei dati? Il suo workflow di data diff confronta righe e colonne tra database o ambienti, aiutando gli engineer a esaminare l'effetto di migrazioni, refactoring e aggiornamenti dei modelli. Invece di chiedersi se un dataset appare insolito in generale, Datafold si chiede se il nuovo risultato differisce da quello precedente e dove.
Questa distinzione lo rende prezioso nelle pull request. Uno sviluppatore può revisionare una trasformazione proposta, confrontare gli output e usare i controlli di CI per bloccare una modifica che produce differenze inattese. L'integrazione con dbt aggiunge il contesto dei modelli, mentre i monitor di produzione estendono il workflow oltre il merge.
Usate il diffing quando la domanda è causale: “Che cosa ha modificato questa modifica al codice?” Il monitoraggio delle anomalie risponde a una domanda diversa: “Che cosa appare insolito adesso?”
Datafold è particolarmente efficace durante le migrazioni di warehouse e i refactoring su larga scala, dove i controlli aggregati possono non cogliere le modifiche a livello di riga. Può fornire evidenze ad alto segnale legate alla code review, anziché generare un flusso generico di alert di produzione.
Il limite è il perimetro. Datafold non è una suite di observability completa, quindi i team necessitano comunque di una copertura separata per freschezza, comportamento continuo dello schema, metriche di business e lineage ampio. Inoltre si adatta meglio dove gli engineer hanno già una cultura di CI attiva. Senza integrazione con la code review e responsabilità chiare, i risultati del diff possono diventare un altro report su cui nessuno agisce.
Un'opzione di deployment in VPC supporta requisiti più rigorosi sul perimetro dei dati, ma il team dovrebbe valutare i costi di configurazione e delle query rispetto alla dimensione del carico di confronto. Con un pricing gestito dal team vendite, un test di migrazione rappresentativo è più utile di una generica revisione delle funzionalità.
8. Test dbt
I test dbt sono la scelta più naturale per i team che già costruiscono trasformazioni in dbt. Risiedono accanto ai modelli, vengono eseguiti tramite i normali comandi di sviluppo e restano sotto controllo di versione. I test generici integrati coprono unique, not null, accepted values e relationships, mentre i test SQL singolari gestiscono condizioni di business più specifiche.
Il valore deriva dalla vicinanza al codice di trasformazione. Uno sviluppatore può aggiornare un modello e i relativi test nella stessa pull request. I test generici riutilizzabili e pacchetti come dbt-utils e dbt-expectations ampliano la libreria senza costringere il team a costruire ogni asserzione da zero.
I limiti del testing con dbt
I test dbt sono principalmente deterministici. Possono stabilire se una condizione è vera o falsa, ma non offrono la stessa ampiezza di rilevamento adattivo delle anomalie di una piattaforma di observability. Inoltre non spiegheranno automaticamente come un caricamento a monte in ritardo influisca su ogni consumatore a valle.
Alcuni warehouse trattano i vincoli dichiarati come informativi anziché come meccanismi di enforcement. Ciò significa che un test dbt superato resta un'evidenza importante, ma non impedisce necessariamente ogni scrittura non valida al di fuori del workflow dbt. I team dovrebbero decidere quali controlli eseguire prima della pubblicazione, quali far fallire una build e quali debbano generare un alert operativo.
dbt è una base solida, ma non sempre una strategia di monitoraggio completa. Aggiungete controlli di freschezza, lineage, monitoraggio delle distribuzioni o workflow di gestione degli incidenti quando l'ambiente di produzione lo richiede. Per i team che valutano in particolare la freschezza, la prospettiva di digna su dbt source freshness mostra come la tempestività possa andare oltre le asserzioni a livello di modello.
Visitate la documentazione di dbt.

9. Amazon Deequ e AWS Glue Data Quality
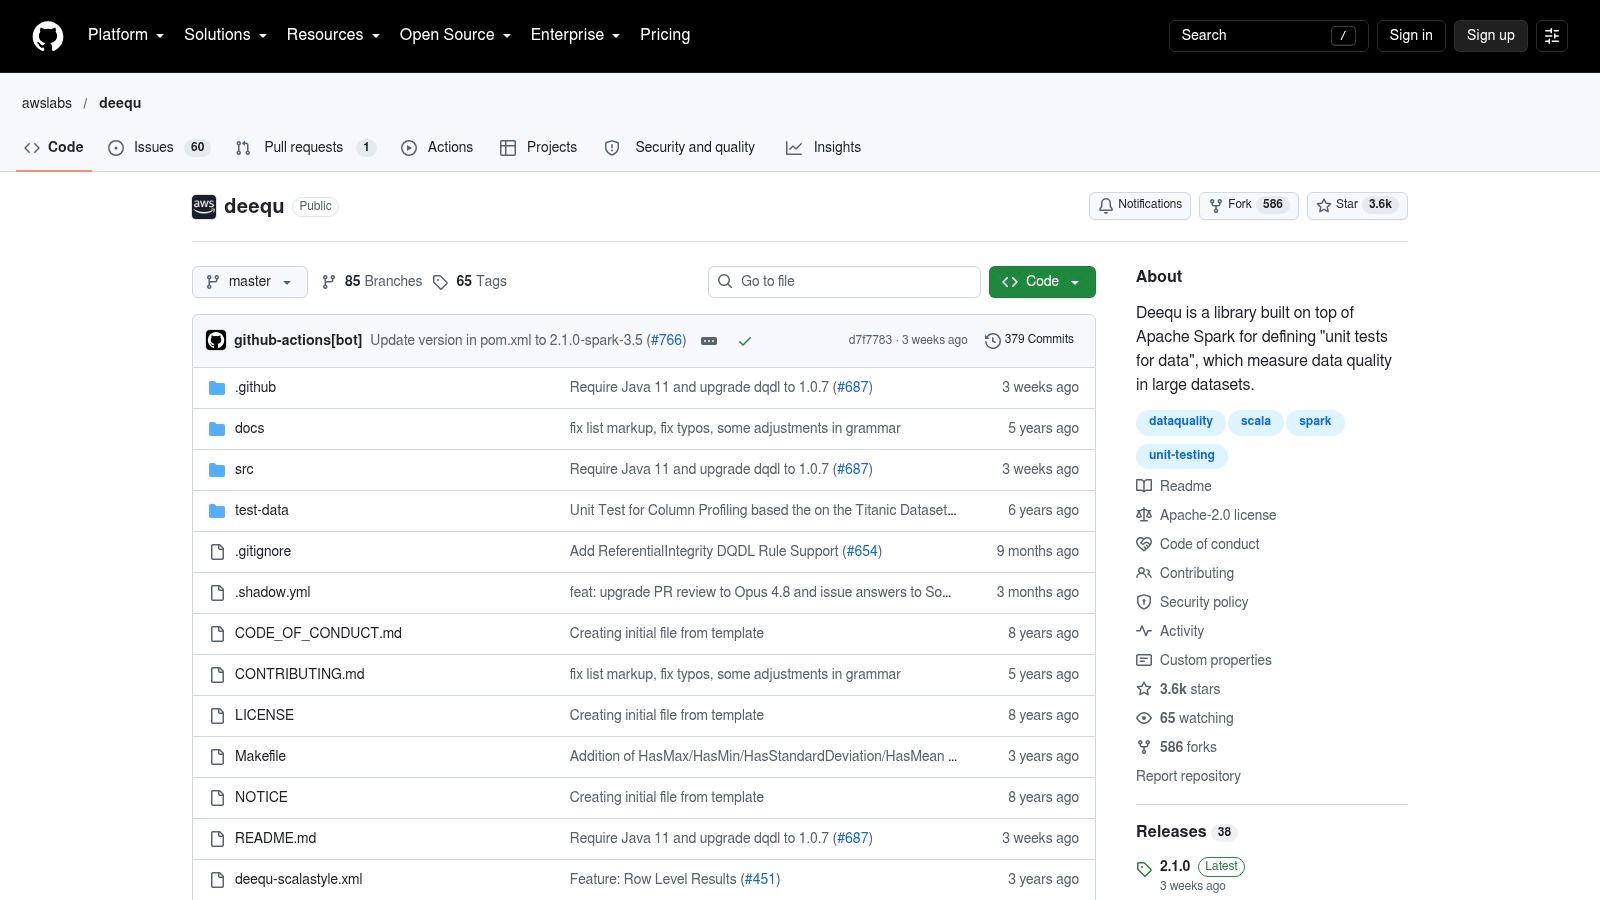
Amazon Deequ è una libreria di validazione su scala Spark di AWS Labs. Consente agli engineer di definire vincoli, profilare i dataset e tracciare le metriche nel tempo. PyDeequ offre un accesso tramite Python, ma il workflow sottostante resta strettamente legato a Scala e Spark. AWS Glue Data Quality si basa su Deequ per offrire funzionalità di data quality gestite all'interno dell'ecosistema AWS.
Deequ ha senso quando la validazione deve essere eseguita dove già girano grandi workload Spark. I vincoli candidati possono essere suggeriti a partire dai profili, e i team possono usare le metriche dei vincoli come base per il monitoraggio. Il rilevamento opzionale delle anomalie su tali metriche aggiunge un livello statistico senza modificare il modello di vincoli di base.
Perché l'adattamento a Spark è importante
Un team che lavora solo in SQL potrebbe trovare Deequ più difficile da adottare rispetto ai test dbt o a una libreria nativa del warehouse. Gli engineer necessitano di competenze Spark, di operazioni consapevoli della JVM e di un approccio chiaro a packaging e scheduling. Inoltre, la libreria open source da sola non fornisce un'interfaccia utente gestita e multipiattaforma.
AWS Glue Data Quality riduce parte del lavoro operativo, ma è un servizio AWS a pagamento e mantiene il workflow strettamente legato a servizi AWS come Glue ed EMR. Questa stretta integrazione è un vantaggio per i team AWS-native e un limite per le organizzazioni che operano su più cloud o su sistemi on-premises.
Deequ è una scelta pratica quando la domanda è se un grande dataset Spark rispetta vincoli dichiarativi su larga scala. Non è la risposta predefinita per il lineage a livello di warehouse, la collaborazione con gli utenti business o il monitoraggio nel database su piattaforme eterogenee.
Visitate Amazon Deequ su GitHub.
10. Metaplane
Metaplane si rivolge ai team che desiderano una observability rapida e self-service senza partire da una grande suite enterprise. Monitora freschezza, volume, schema e distribuzione, quindi utilizza baseline apprese per generare alert sui comportamenti insoliti. Il lineage a livello di colonna e l'analisi d'impatto aggiungono contesto quando un problema interessa modelli o dashboard a valle.
L'approccio all'onboarding del prodotto si adatta a team dati snelli e a progetti pilota. Un piano gratuito e un pricing basato sull'utilizzo, legato alle tabelle monitorate attive, rendono più semplice testare il workflow prima di estendere la copertura. I controlli di CI sulle modifiche ai dati e l'allineamento con dbt mantengono inoltre la piattaforma vicina al processo di sviluppo.
Il costo dell'estensione della copertura
Il pricing basato sull'utilizzo è accessibile su un perimetro ridotto, ma il numero di tabelle monitorate può aumentare quando i team passano da un pilota a una copertura a livello di organizzazione. Gli acquirenti dovrebbero stimare l'inventario di tabelle previsto, la retention, i destinatari degli alert e le funzionalità avanzate, anziché considerare la configurazione di prova iniziale come il costo a lungo termine.
Metaplane offre un'ampiezza enterprise inferiore rispetto alle suite di observability più grandi. Questo non è automaticamente un punto debole. Una piattaforma più piccola può essere preferibile quando un team privilegia una configurazione rapida e un chiaro focus operativo rispetto a workflow di governance estesi e a un'ampia superficie di prodotto.
Il pilota giusto dovrebbe includere caricamenti in ritardo, variazioni stagionali attese, modifiche di schema e almeno un incidente di data quality noto. Una piattaforma che appare semplice su tabelle stabili può generare troppo rumore quando monitora i dataset che causano realmente problemi operativi.
I 10 migliori strumenti di data testing: confronto di funzionalità e capacità
Prodotto | Funzionalità principali (✨) | Qualità (★) | Prezzo / Valore (💰) | Pubblico di riferimento (👥) | Punti di forza distintivi (🏆 / ✨) |
|---|---|---|---|---|---|
digna 🏆 | ✨ Anomalie con baseline IA, tempestività, validazione a livello di record, tracciamento dello schema, analytics nel database | ★★★★★ | 💰 Trasparente: canone base + per tabella attiva / per modulo | 👥 Data engineer, analytics, governance, settori regolamentati | 🏆 Sovrano (eseguito nell'infrastruttura del cliente); esecuzione nel database; modulare + time-to-value rapido |
Great Expectations (GX) | ✨ Expectations dichiarative, Data Docs, supporto multi-backend | ★★★★☆ | 💰 OSS gratuito (GX Core) | 👥 Engineer, QA, team di compliance | ✨ Documentazione pronta per l'audit, ricca libreria di expectation, ampia community OSS |
Soda (Core + Cloud) | ✨ Controlli YAML e Data Contracts, rilevamento delle anomalie, modello ad agente, scheduling | ★★★★☆ | 💰 Core OSS + Soda Cloud (tramite vendite) | 👥 Engineer + operations e stakeholder (con Cloud) | ✨ Data contract, generazione di regole assistita dall'IA, collaborazione in Cloud |
Monte Carlo | ✨ Monitor di freschezza/volume/schema, anomalie con ML, lineage a livello di colonna, workflow degli incidenti | ★★★★★ | 💰 Pricing enterprise tramite vendite | 👥 Grandi piattaforme dati, dataops, SRE | ✨ Lineage solido + triage del raggio d'impatto per una root cause rapida |
Bigeye | ✨ Metriche come codice, oltre 70 controlli predefiniti, profilazione, workflow di lineage | ★★★★☆ | 💰 Pricing enterprise tramite vendite | 👥 Team orientati allo sviluppo, aziende attente alla sicurezza | ✨ Hook di automazione per sviluppatori, sicurezza e integrazioni enterprise |
Anomalo | ✨ Controlli ML non supervisionati, observability delle tabelle, feed di insight, opzione VPC | ★★★★☆ | 💰 Tramite vendite (in base al volume) | 👥 Team che necessitano di rilevamento rapido delle anomalie con poche regole | ✨ Feed di insight no-code con azioni suggerite; installabile in VPC |
Datafold | ✨ Data diffing tra database, regression testing, integrazione dbt + CI/CD | ★★★★☆ | 💰 Tramite vendite | 👥 Engineer impegnati in migrazioni, controlli sulle PR, workflow di CI | ✨ Diff ad alto segnale per code review e rollout sicuri |
Test dbt (Core/Platform) | ✨ Test integrati SQL-first, macro riutilizzabili, ecosistema di pacchetti, esecuzione in CI | ★★★☆☆ | 💰 OSS (dbt Core) / dbt Cloud a pagamento | 👥 Utenti dbt, analytics engineer, team SQL | ✨ I test risiedono con il codice e sotto controllo di versione; adatti alla CI |
Amazon Deequ / AWS Glue DQ | ✨ Vincoli dichiarativi, profilazione, serie temporali di metriche, scala Spark | ★★★★☆ | 💰 Deequ OSS; Glue Data Quality (a pagamento) | 👥 Team JVM/Spark, piattaforme incentrate su AWS | ✨ Scala a workload Spark da petabyte; stretta integrazione con AWS |
Metaplane | ✨ Monitor con apprendimento delle baseline (freschezza/volume/schema), lineage delle colonne, controlli di CI | ★★★★☆ | 💰 Pricing basato sull'utilizzo + piano gratuito | 👥 Team snelli, progetti pilota, organizzazioni allineate a dbt | ✨ Onboarding rapido, pricing trasparente basato sull'utilizzo, piano gratuito |
Scegliete lo strumento adatto al guasto che dovete intercettare
La strategia di data testing più solida di solito combina più livelli, perché ciascuno risponde a una diversa domanda operativa. I test deterministici verificano se una condizione nota è soddisfatta. Il rilevamento delle anomalie verifica se il comportamento attuale si discosta da una baseline consolidata. L'observability aggiunge freschezza, lineage, contesto degli incidenti e analisi d'impatto. Il diffing verifica che cosa è cambiato tra due versioni, mentre le librerie su scala Spark validano i grandi job di elaborazione là dove vengono eseguiti.
Partite dal guasto che costa più tempo al vostro team. Se gli sviluppatori rilasciano ripetutamente valori non validi, chiavi mancanti, relazioni interrotte o logica di business errata, scegliete una base guidata dal codice. I test dbt sono l'opzione a basso attrito per i team dbt. Great Expectations offre ai team orientati a Python una libreria open source flessibile con Data Docs e artefatti versionati. Soda offre un percorso Core adatto agli sviluppatori e un livello gestito per contratti, rilevamento delle anomalie e collaborazione. Deequ si adatta ai team il cui principale carico di validazione gira su Spark.
Usate Datafold quando il rischio di rilascio deriva da migrazioni, refactoring o modifiche alle trasformazioni. Il suo valore non è il monitoraggio ampio, ma la capacità di confrontare i risultati vecchi e nuovi all'interno di una pull request o di un workflow di CI e di mostrare agli engineer dove si è verificata la modifica. Ciò lo rende un complemento a test e observability, non un sostituto di nessuno dei due.
Scegliete una piattaforma di observability quando il problema si manifesta dopo il deployment. Monte Carlo, Bigeye, Anomalo e Metaplane si concentrano su freschezza, volume, schema, distribuzione, lineage e workflow delle anomalie, con equilibri diversi tra ampiezza enterprise, configurazione no-code, integrazione per sviluppatori e trasparenza dei prezzi. Confrontate la qualità degli alert e la velocità di indagine, non solo il numero di monitor che un prodotto può creare.
digna merita un posto nella shortlist quando esecuzione nel proprio ambiente, controlli nel database, monitoraggio modulare e controllo enterprise sono requisiti centrali. Le sue opzioni di deployment in cloud privato, VPC e on-premises mantengono i dati di produzione all'interno del perimetro del cliente. La combinazione di rilevamento delle anomalie, tempestività, validazione a livello di record, tracciamento dello schema e analytics storiche può ridurre la necessità di mettere insieme funzioni di monitoraggio separate. Il compromesso è che l'infrastruttura interna e il supporto restano parte del modello operativo, e il pricing per tabella attiva e per modulo richiede un'attenta pianificazione del perimetro.
Eseguite un pilota su dataset rappresentativi anziché su un campione pulito. Includete una tabella finanziaria o operativa critica, un feed che arriva in ritardo, una modifica di schema, una condizione nota di record non validi e un dataset con una normale variazione stagionale. Documentate dove vengono eseguiti i controlli, quali metadati escono dall'ambiente, chi è responsabile di ciascun alert, quali errori bloccano i rilasci e come gli engineer accedono alle evidenze.
Misurate la copertura dei test per tabella critica, la precisione degli alert, il tempo medio di rilevamento e il tempo medio di risoluzione. Queste misure distinguono i controlli utili da un'ampia raccolta di controlli rumorosi. Offrono inoltre ai responsabili della governance e della piattaforma dati un modo per valutare se lo strumento scelto riduce l'impegno di indagine e le interruzioni a valle.
Infine, modellate il pricing in base al perimetro monitorato che prevedete dopo l'adozione. Includete tabelle attive, moduli, ambienti, supporto, infrastruttura e il tempo di engineering necessario per mantenere i test. Lo strumento migliore non è quello con il maggior numero di funzionalità. È quello che il vostro team può gestire in modo continuativo, di cui può fidarsi durante gli incidenti e che può estendere man mano che i sistemi di dati diventano più importanti.
digna offre data quality e observability nel vostro ambiente e nel database per i team che necessitano di rilevamento delle anomalie, monitoraggio della tempestività, validazione a livello di record e tracciamento dello schema senza trasferire i dati di produzione al di fuori della propria infrastruttura. Se questo workflow corrisponde ai vostri requisiti di sicurezza e governance, visitate digna per valutare la piattaforma per la vostra strategia di data testing.
Se la vostra lacuna è il livello deterministico descritto sopra, con campi obbligatori, intervalli, liste di riferimento e condizioni tra campi verificati all'interno del database, scoprite come digna Data Validation definisce e applica regole a livello di record.
Domande frequenti
Qual è la differenza tra data testing e data observability?
Il data testing verifica se una condizione nota è soddisfatta, come una chiave univoca o un valore ammesso, mentre l'observability tiene sotto controllo freschezza, volume, schema, distribuzione e lineage dopo il deployment. La maggior parte dei team ha bisogno di entrambi i livelli, perché una regola deterministica raramente intercetta una distribuzione insolita e un rilevatore di anomalie non può dimostrare una regola di business esatta.
I test dbt sono sufficienti per la data quality?
Di solito non da soli. I test dbt coprono unique, not null, accepted values e relationships, oltre ai test SQL singolari, e risiedono accanto ai modelli sotto controllo di versione. Restano però deterministici, per cui gli ambienti di produzione spesso vi aggiungono controlli di freschezza, monitoraggio delle distribuzioni, lineage o workflow di gestione degli incidenti.
Great Expectations è ancora gratuito dopo la dismissione di GX Cloud?
Sì, GX Core resta l'opzione open source senza costi di licenza. Secondo l'articolo, GX Cloud è stato dismesso dopo un'acquisizione a metà 2026, quindi gli acquirenti non dovrebbero contare su una GUI ospitata e devono essere pronti a gestire autonomamente suite, Data Docs e workflow di esecuzione.
Quando conviene usare uno strumento di data diffing come Datafold?
Ricorrete al diffing quando il rischio deriva da una modifica al codice, una migrazione o un refactoring. Datafold confronta i risultati vecchi e nuovi riga per riga all'interno di una pull request o di un workflow di CI, intercettando modifiche che i controlli aggregati non rilevano. Integra test e observability, ma non copre freschezza, lineage né il comportamento continuo dello schema.
Quale strumento di data testing mantiene i dati di produzione all'interno della propria infrastruttura?
digna viene eseguito in un cloud privato, in una VPC o in un ambiente on-premises ed esegue i controlli nel database, quindi i record di produzione non escono mai dal perimetro del cliente. Anche Anomalo e Datafold offrono opzioni VPC, ma prima di scegliere i team dovrebbero verificare quali metadati, log e accessi di supporto attraversano tale perimetro.


