Analisi dei pericoli operativi per i team di dati
|
6
min di lettura

Molti team trattano ancora l'analisi dei pericoli operativi come un esercizio di approvazione formale. Scrivono la checklist, approvano il rilascio e presumono che il quadro dei rischi resti stabile fino alla revisione successiva. Questa abitudine non regge nelle moderne operazioni su dati e AI, dove i guasti più rilevanti emergono di solito dopo il deployment, non prima.
Le revisioni statiche non colgono i segnali che cambiano gli esiti: schema drift, caricamenti in ritardo, percorsi di validazione interrotti, autorità dell'automazione che si sposta e soluzioni di ripiego adottate dalle persone che non compaiono mai in un documento pre-lancio. L'approccio più sicuro è un'analisi dei pericoli continua e basata sui dati, in cui le metriche di observability fungono da evidenza in tempo reale e ogni cambiamento dell'ambiente operativo può riaprire la questione del rischio.
Indice
Ripensare l'analisi dei pericoli operativi per le data operations
L'analisi dei pericoli operativi funziona solo se segue il sistema, non il calendario. Una revisione una tantum può individuare evidenti difetti di progettazione, ma non può tenere il passo con una pipeline i cui dati di origine, la cui logica di orchestrazione o il cui utilizzo a valle cambiano di settimana in settimana. Questo divario è importante perché il pericolo raramente risiede in un unico sintomo. Di solito si manifesta come una catena di piccoli guasti che si allineano nel momento sbagliato.
Perché le revisioni puntuali falliscono
Una pipeline può superare la checklist di lancio e diventare comunque rischiosa in seguito. Un team a monte modifica uno schema, una trasformazione continua a girare, una tabella di reporting si riempie di valori null e il business continua ad agire su dati obsoleti perché nessuno ha collegato questi eventi tra loro. È proprio qui che conta una visione sull'intero ciclo di vita, perché il pericolo non è la sola modifica dello schema, ma il percorso causale che va dalla modifica alla decisione compromessa.
Regola pratica: se l'ambiente può cambiare senza un rilascio formale, l'analisi dei pericoli deve cambiare senza attendere una revisione trimestrale.
In questo contesto la data observability diventa più di una comodità ingegneristica. Quando ritardi, errori di validazione, discontinuità nel numero di righe o schema drift vengono registrati come evidenze operative, diventano la materia prima dell'analisi dei pericoli, non semplice rumore nella dashboard. Un team che tratta questi segnali come input di sicurezza può reagire prima che il problema si traduca in perdita di reporting, degrado del modello o fallimento di un controllo.
La data observability funziona al meglio quando è integrata nella stessa mentalità di controllo che i programmi di sicurezza adottano nei settori regolamentati. La domanda utile non è se una pipeline abbia “superato” i controlli, ma se il sistema si stia ancora comportando come l'analisi dei pericoli presupponeva.
Dalle checklist qualitative ai modelli quantitativi

La disciplina moderna non è nata con le dashboard. È nata quando gli ingegneri della sicurezza hanno smesso di considerare sufficienti le checklist generiche e hanno iniziato a modellare il modo in cui i guasti si combinano. La Fault Tree Analysis è emersa all'inizio degli anni Sessanta come metodo deduttivo che parte da un evento indesiderato a livello di sistema e risale ai guasti dei componenti, alle azioni umane e alle condizioni esterne che potrebbero causarlo. I Bell Laboratories la svilupparono tra il 1961 e il 1962 per il sistema di controllo del lancio dei missili Minuteman e Boeing la adottò nel 1963 per l'analisi di sicurezza degli aerei commerciali, spingendo l'analisi dei pericoli verso modelli logici espliciti e calcoli probabilistici. La revisione della FTA della NASA ripercorre questo sviluppo in settori critici per la sicurezza come l'energia nucleare, l'industria chimica e quella farmaceutica. Panoramica della FTA della NASA
Perché la vecchia logica conta ancora
La lezione centrale della FTA è strutturale: i pericoli si comprendono meglio come combinazioni di condizioni osservabili che come incidenti isolati. Nelle data operations, un file sorgente in ritardo, una validazione fallita e una modifica dello schema non rilevata costituiscono un modello di rischio più utile di “la pipeline è fallita”. La prima versione supporta l'indagine e la prevenzione. La seconda serve soprattutto a cercare colpevoli.
Un buon modello dei pericoli indica le condizioni che possono essere misurate, non solo l'esito che tutti notano quando il danno è ormai fatto.
Questa logica aiuta anche i team a individuare i single point of failure e i minimal cut set, aspetto importante quando una singola dipendenza fragile può interrompere un'intera catena di reporting. L'obiettivo non è trasformare le piattaforme dati in sistemi aerospaziali, ma applicare la stessa disciplina che ha reso più affidabile l'ingegneria ad alto rischio.
Per i team che vogliono tradurre queste idee nella pratica moderna dell'analytics, la simulazione Monte Carlo è un utile complemento quando lo spazio degli input è incerto. Non sostituisce l'analisi causale, ma permette di sottoporre a stress test il comportamento sotto carico delle combinazioni di errori di tempistica, volume e trasformazione.
Mappare i confini del sistema e le catene causali

Un'analisi dei pericoli è debole se il confine del sistema è vago. Le linee guida della FAA sulla gestione della sicurezza richiedono agli analisti di definire il sistema e il contesto operativo, identificare i pericoli con un livello di dettaglio sufficiente a determinarne il rischio, analizzare gravità e probabilità, confrontare il rischio con gli obiettivi di performance e rivalutare i controlli sulla base dei dati operativi. Questa visione sull'intero ciclo di vita si adatta bene alle piattaforme dati, perché il sistema comprende di solito ingestion, trasformazione, archiviazione, orchestrazione, revisione umana e consumatori a valle. Linee guida della FAA sulla gestione della sicurezza
Una mappa pratica dei confini
Partite dall'intero percorso dei dati, non solo dalla tabella del data warehouse che le persone interrogano ogni mattina. Includete feed a monte, finestre batch, stream processor, modelli dbt, fasi di approvazione, override manuali e i team che utilizzano i dati per il reporting o l'automazione. Se un rischio può entrare da un sistema a monte e manifestarsi tre livelli più avanti, rientra nella stessa analisi.
Descrivete poi i pericoli come catene causali. Una modifica dello schema può interrompere una trasformazione, che può produrre un reporting normativo incompleto, che a sua volta può causare il fallimento di un controllo nel processo di revisione aziendale. È una registrazione più solida di “schema drift”, perché identifica la condizione scatenante, la conseguenza e il contesto operativo in cui la perdita diventa visibile.
L'architettura dei sistemi di dati è importante in questo contesto, perché definisce dove sono disponibili le evidenze e dove si possono collocare i controlli. Se un team non sa indicare la fase esatta in cui vengono rilevati ritardi, picchi di null o record non validi, l'analisi resta astratta.
La sicurezza degli agenti AI nella finanza è un riferimento utile se volete vedere come cambia l'analisi del rischio quando nel processo entra un processo decisionale automatizzato. Il filo conduttore è semplice: quando il software può agire, il confine deve includere sia l'azione sia le condizioni che la rendono non sicura.
Cosa deve contenere ogni registrazione di pericolo
Una registrazione utile riporta modalità operativa, condizione scatenante, conseguenza, gravità, probabilità, salvaguardie esistenti, responsabile del controllo, segnale di rilevamento e autorità di accettazione. In questo modo un pericolo passa da semplice ricordo a oggetto gestito. Diventa anche più facile rivalutarlo quando il sistema cambia, perché il team sa esattamente quale ipotesi è stata violata.
Valutare il rischio con metriche dei dati osservabili
I punteggi di rischio più solidi nascono dalla combinazione di conseguenza e probabilità, non dal conteggio dei sintomi. La policy della FAA definisce il rischio per la sicurezza come la combinazione di gravità e probabilità, e la prassi basata sulla MIL-STD-882 valuta i pericoli considerando hardware, software, interfacce umane e ambienti operativi. Questo è importante nelle data operations, perché lo stesso guasto tecnico può essere a basso rischio in un processo aziendale e grave in un altro. FAA Order 8040.4B
Trasformare l'observability in un segnale di rischio
Un caricamento in ritardo non è solo un fastidio ingegneristico. Se il caso d'uso a valle dipende da dati aggiornati, il ritardo aumenta l'esposizione, perché rinvia una decisione o alimenta un modello con un punteggio obsoleto. Un picco anomalo del tasso di null può indicare un'acquisizione incompleta dalla sorgente, una join fallita o una trasformazione interrotta, e ciascuna di queste cause incide in modo diverso sulla credibilità del risultato.
Componente del rischio | Definizione astratta | Metrica dei dati osservabile |
|---|---|---|
Probabilità | Con quale frequenza il pericolo può verificarsi | Ritardi di caricamento, tassi di validazione falliti |
Gravità | Quanto grave potrebbe essere l'esito | Impatto sui KPI di business, completezza del reporting normativo |
Rilevamento | Con quale rapidità il team può vedere il problema | Latenza degli alert, discontinuità nel numero di righe |
Forza dei controlli | Quanto efficacemente le salvaguardie bloccano o fanno emergere il problema | Rilevamento delle modifiche di schema, copertura delle validazioni |
La tabella è più utile quando i team smettono di trattarla come un artefatto di reporting e iniziano a usarla per stabilire le priorità del lavoro. Un feed che arriva ripetutamente in ritardo con un rilevamento debole richiede un piano di controllo diverso rispetto a un problema di formattazione isolato intercettato prima della pubblicazione. È la differenza tra un registro ordinato e un vero modello di rischio.
Regola operativa: classificate la conseguenza credibile dello scenario causale, poi rivedete il punteggio dopo l'applicazione dei controlli.
Cosa rende il punteggio difendibile
Un punteggio difendibile è tracciabile. Se un dataset di sinistri arriva in ritardo, il team deve poter indicare la frequenza dei ritardi, il percorso di rilevamento, l'esposizione per il business e il controllo che ha ridotto il rischio residuo. Solo così l'accettazione del rischio residuo smette di essere un gesto vago e diventa una decisione documentata.
Per una visione più approfondita del livello delle metriche, le metriche di data observability sono il ponte pratico tra il comportamento della piattaforma e la valutazione del rischio. Offrono all'analisi una base misurabile invece di una generica dichiarazione rassicurante.
Progettare controlli verificabili per la supervisione umana
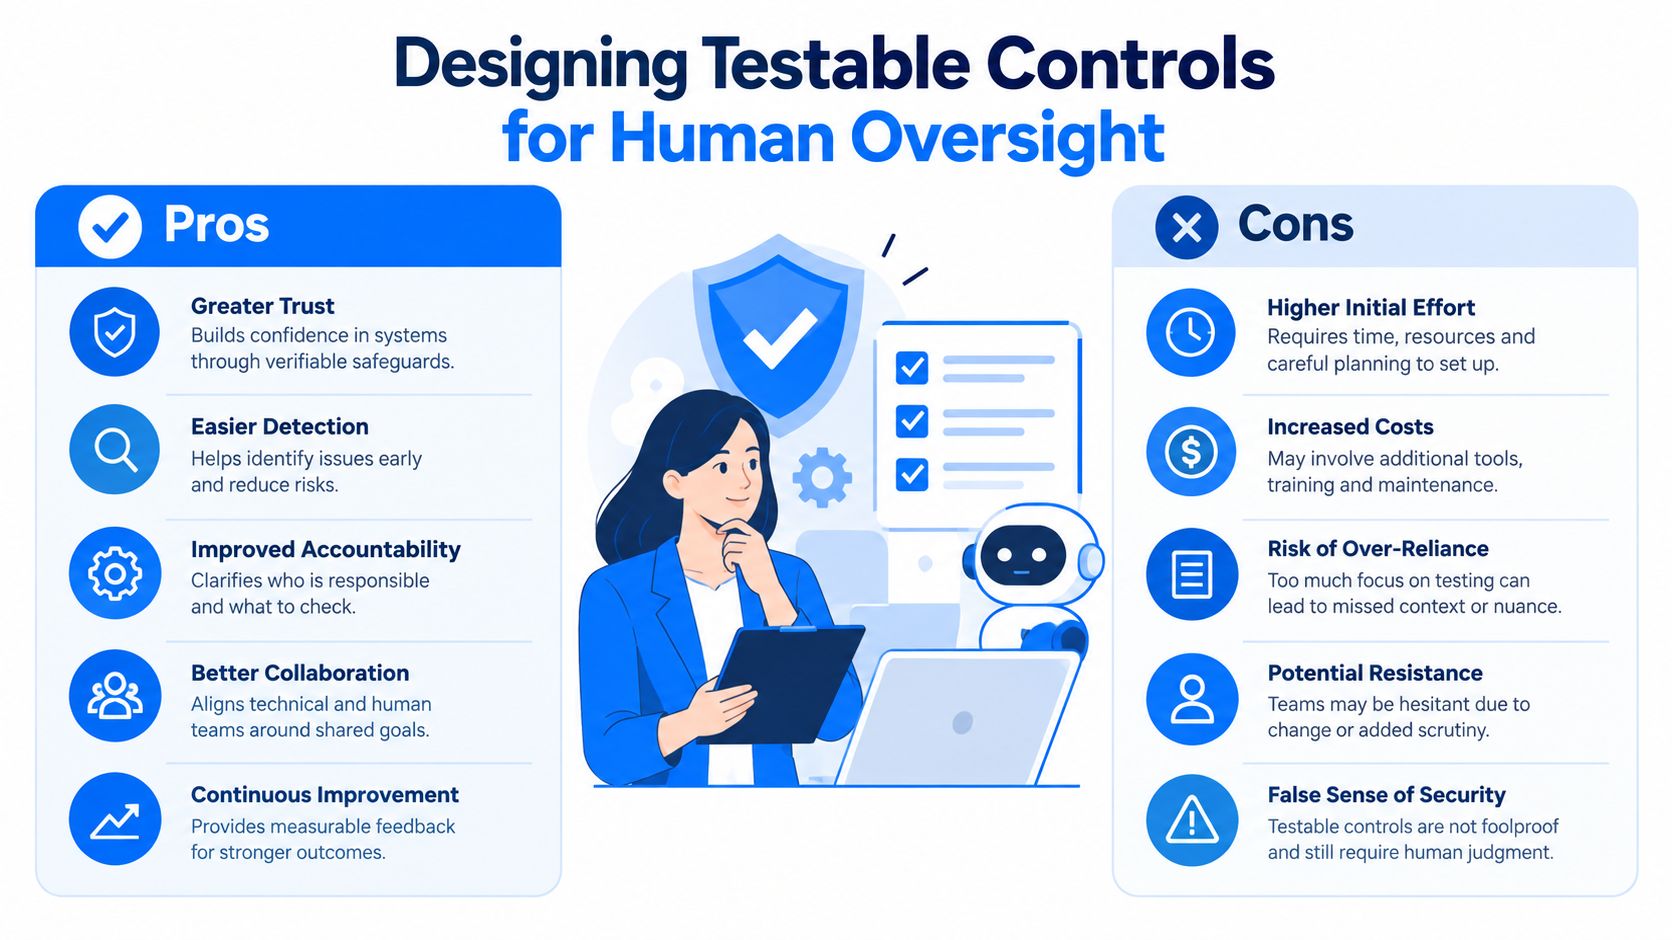
La revisione umana viene aggiunta a molti piani di controllo perché sembra sicura. Nella pratica, però, può fallire in modi sottili. Autorità di regolamentazione e organizzazioni per la sicurezza continuano a sottolineare che la responsabilità umana non scompare quando è coinvolta l'AI, e raccomandano di verificare carico di lavoro, attenzione, processo decisionale, chiarezza dei ruoli, comportamento nell'escalation e reazioni a raccomandazioni errate o mancanti. Linee guida sui fattori umani
Lo human-in-the-loop non è di per sé un controllo
Un revisore che riceve troppi alert inizierà a fare triage, non a validare. Un revisore che vede spiegazioni poco chiare accetterà l'output del sistema perché contestarlo richiede troppo tempo. Un revisore che non sa chi è responsabile dell'escalation può notare il problema e lasciarlo comunque correre.
Per questo la supervisione umana deve essere verificabile. Simulate dati degradati, input in ritardo, modifiche dello schema, segnali contrastanti, interruzioni dell'automazione e carichi di lavoro elevati, poi misurate il tempo di rilevamento, la qualità degli override, il completamento delle escalation, il tempo di ripristino e la ricorrenza. Questi risultati vi dicono se la persona dispone del tempo, delle informazioni, dell'autorità e della competenza necessari per intervenire.
Aggiungere un revisore può aumentare il rischio se il revisore è sommerso, non adeguatamente formato o impossibilitato ad agire.
È l'aspetto che molti team trascurano. Un livello umano non è automaticamente un controllo preventivo. In alcuni ambienti diventa un collo di bottiglia che aggiunge ritardo senza aggiungere sicurezza, soprattutto quando il flusso di alert è rumoroso o le spiegazioni del sistema sono deboli.
Come rendere misurabile la supervisione
Registrate quando l'operatore ha visto il problema, se lo ha contestato, quale azione ha intrapreso e se il sistema si è ripristinato correttamente. Conservate queste evidenze accanto alla telemetria tecnica, perché un workflow apparentemente riuscito può comunque nascondere comportamenti umani non sicuri. Se l'operatore deve tirare a indovinare, rimandare o aggirare il processo, il controllo non è ancora maturo.
Monitoraggio continuo nei settori regolamentati
Un team dei servizi finanziari può fare tutto correttamente sulla carta e non cogliere comunque il pericolo nella pratica. Un feed transazionale che di solito arriva puntuale inizia a slittare più tardi del normale, ma la variazione di volume è così piccola che una soglia statica non scatta mai. Il report viene comunque generato, la dashboard si aggiorna comunque e i dati obsoleti confluiscono inosservati in un processo decisionale che ne presuppone l'attualità.
Il monitoraggio continuo cambia questa modalità di guasto. In un ambiente regolamentato, KPI di business, schema drift, tempestività, validazione e condizioni della piattaforma devono essere tenuti sotto osservazione insieme. Il caso d'uso di digna per data quality e compliance si adatta a questo modello perché la piattaforma resta nell'ambiente del cliente e monitora il comportamento dei dati là dove si trovano, mantenendo le evidenze operative vicine al sistema che protegge.
Perché le soglie rigide falliscono nei contesti regolamentati
Una regola rigida vede solo ciò per cui è stata scritta. Non coglie un caricamento presente ma in ritardo, né una modifica dello schema che supera i controlli sintattici ma compromette un'ipotesi a valle. Resta inoltre indietro quando il contesto di business cambia più rapidamente dell'insieme di regole.
Il monitoraggio continuo funziona meglio perché può intercettare combinazioni insolite di comportamenti, non solo superamenti isolati di soglie. Questo è importante nelle operazioni dei settori sanitario, finanziario, delle telecomunicazioni e pubblico, dove un lieve cambiamento di volume o di struttura può trasformarsi in un problema di reporting o di servizio prima che qualcuno apra un ticket di incidente.
I migliori alert sono tempestivi, specifici e legati a una conseguenza di business che il responsabile già comprende.
Qui la piattaforma dati e il sistema di controllo si sovrappongono. Se il livello di observability è in grado di validare le regole di business critiche, tracciare le modifiche strutturali e far emergere pattern anomali senza spostare i dati di produzione fuori dall'ambiente, le evidenze di rischio restano utilizzabili sia per le operations sia per l'audit. Per le data operations regolamentate, queste stesse evidenze supportano anche una traccia di compliance pulita, come mostra il caso d'uso di digna per data quality e compliance.
Di cosa ha bisogno un buon monitoraggio operativo
Un buon monitoraggio fa tre cose contemporaneamente: rileva il comportamento della pipeline, valida il significato di business e conserva le evidenze che il controllo ha funzionato. Quando manca anche solo uno di questi elementi, il team riceve rumore invece di garanzie.
Avviare una nuova valutazione quando i sistemi cambiano

L'analisi dei pericoli operativi per le operazioni basate sull'AI viene ancora troppo spesso trattata come un esercizio una tantum prima del deployment, anche se i rischi maggiori di solito emergono dopo il deployment. Le linee guida di sicurezza più recenti pongono l'accento su implementazione incrementale, monitoraggio continuo, change control, validazione locale e responsabilità esplicite, invece di presumere che un modello o un sistema automatizzato resti sicuro dopo l'approvazione. Linee guida di sicurezza della FAA sulle operazioni basate sull'AI
Cosa dovrebbe avviare una nuova revisione
Una nuova valutazione dovrebbe partire quando il sistema cambia in un modo che può alterare il rischio. Ciò include cambi di versione del modello o del software, variazioni nelle distribuzioni dei dati di input, nuova autorità attribuita all'automazione, pattern anomali di override, cambiamenti nel personale, incidenti e quasi incidenti. Include anche modifiche di processo che cambiano chi vede un alert, chi può approvare una decisione o la rapidità con cui può avvenire il ripristino.
Per i team che gestiscono dati regolamentati o contenuti automatizzati, un riferimento affine utile sono le norme sui video generati dall'AI. Il motivo è semplice: se un sistema automatizzato cambia ciò che le persone vedono, ciò di cui si fidano o ciò che approvano, l'analisi del rischio deve coprire sia l'output sia la risposta umana.
Come mantenere utilizzabile la traccia delle evidenze
Registrate incertezza, risposta degli utenti, azione a valle, gravità, sottogruppo interessato, azione correttiva e ricorrenza. In questo modo la revisione successiva dispone di contesto sufficiente per stabilire se il pericolo è stato davvero risolto o solo soppresso. Si evita inoltre il caso frequente in cui un modello appare accurato nel complesso ma crea comunque danni operativi, perché le persone se ne fidano troppo, lo ignorano o non riescono ad agire sul suo output abbastanza rapidamente.
Il processo più solido è basato su fattori scatenanti, non sul calendario. Quando cambiano i dati, il workflow o il modello di autorità, l'analisi dei pericoli dovrebbe riaprirsi automaticamente e le evidenze dei controlli dovrebbero essere aggiornate di conseguenza.
digna aiuta i team a trasformare metriche delle pipeline, schema drift, esiti delle validazioni e segnali di tempestività in indicatori di pericolo continui all'interno del proprio ambiente. Se state sostituendo le checklist statiche con evidenze operative in tempo reale, visitate digna e scoprite come la data observability può supportare data operations più sicure e responsabili.
I caricamenti in ritardo sono tra le condizioni scatenanti più comuni in queste catene causali, quindi il punteggio di probabilità dipende dalla capacità di intercettarli presto. Il modulo Timeliness di digna apprende il normale pattern di arrivo di ogni tabella e segnala i dati che arrivano in ritardo o non arrivano affatto, fornendo alla registrazione del pericolo un segnale di rilevamento misurabile.
Domande frequenti
Che cos'è l'analisi dei pericoli operativi nelle data operations?
L'analisi dei pericoli operativi è la pratica di individuare come i guasti in un sistema in esercizio possano combinarsi fino a causare danni, per poi tenerli sotto controllo. Nelle data operations segue l'intero percorso dei dati, dai feed a monte e dai modelli dbt fino agli override manuali e ai consumatori a valle, e viene riaperta ogni volta che il sistema cambia.
Perché le revisioni puntuali dei pericoli falliscono per le data pipeline?
Perché la maggior parte dei guasti dannosi emerge dopo il deployment. Una pipeline può superare la checklist di lancio, poi una modifica dello schema a monte riempie di valori null una tabella di reporting mentre la trasformazione continua a girare, e il business agisce su dati obsoleti. Una revisione trimestrale non può intercettare una catena causale che si forma tra una revisione e l'altra.
Come si possono usare le metriche di observability per valutare il rischio di un pericolo?
Associate ogni componente del rischio a un segnale misurabile. La probabilità può derivare dai ritardi di caricamento e dai tassi di validazione falliti, la gravità dall'impatto sui KPI di business o dalla completezza del reporting normativo, il rilevamento dalla latenza degli alert e dalle discontinuità nel numero di righe, e la forza dei controlli dal rilevamento delle modifiche di schema e dalla copertura delle validazioni. Rivalutate il punteggio dopo l'applicazione dei controlli.
Cosa deve includere una registrazione di pericolo?
Una registrazione di pericolo utile riporta modalità operativa, condizione scatenante, conseguenza, gravità, probabilità, salvaguardie esistenti, responsabile del controllo, segnale di rilevamento e autorità di accettazione. Descrivere i pericoli come catene causali, ad esempio dalla modifica dello schema alla trasformazione interrotta fino al reporting normativo incompleto, mostra esattamente quale ipotesi è stata violata quando il sistema cambia.
Quando va rivalutata un'analisi dei pericoli operativi?
Rivalutatela ogni volta che un cambiamento può alterare il rischio, non secondo un calendario fisso. Tra i fattori scatenanti rientrano cambi di versione del modello o del software, variazioni nelle distribuzioni dei dati di input, nuova autorità attribuita all'automazione, pattern anomali di override, cambiamenti nel personale, incidenti e quasi incidenti, oltre a modifiche di processo che incidono su chi vede un alert o su chi può approvare una decisione.


