Elementi di dati critici: una guida pratica per il 2026
|
7
min di lettura

Probabilmente il vostro team ha una dashboard, un modello o un report regolamentare che tutti considerano affidabile, finché un lunedì mattina non lo è più in modo evidente. I ricavi calano in un grafico che dovrebbe essere stabile. Una coda delle operations clienti raddoppia senza alcun motivo di business. La finanza chiede se l'ultima estrazione può essere usata, e nessuno vuole rispondere per primo.
Quando succede, il problema di solito non sono i “dati errati” in astratto. È che un piccolo insieme di campi contava molto più degli altri, e nessuno li aveva trattati in modo diverso. L'identificativo cliente che collega i sistemi. L'importo della transazione che alimenta il reporting. Il codice paese che incide su instradamento, compliance e segmentazione. Sono questi i campi che possono trasformare un normale incidente in un'escalation al management.
Ecco perché gli elementi di dati critici sono importanti. Offrono ai team dati un modo per smettere di cercare di governare tutto con la stessa intensità e iniziare a proteggere i dati che comportano un rischio per il business. Il metodo tradizionale si basava su workshop, fogli di calcolo e revisioni periodiche. Ha ancora valore, ma è lento. Un approccio più moderno usa lineage, pattern di utilizzo e observability continua per far emergere ciò che è critico e tenerlo sotto controllo man mano che lo stack cambia.
Indice
Il rischio nascosto nel vostro stack dati
Uno schema di guasto ben noto inizia con un report che sembra sbagliato e si diffonde rapidamente. Le vendite dicono che la vista della pipeline commerciale non può essere corretta. La finanza nota una discrepanza con i numeri contabilizzati. Il team di BI controlla il livello semantico, poi le tabelle del warehouse, poi il job di ingestion. I data engineer cercano nei log mentre gli utenti di business aggiornano la dashboard e chiedono novità ogni dieci minuti.
La causa principale è spesso banale. Un campo chiave ha cambiato formato. Un file in ritardo ha mancato una scadenza. Un record duplicato è sfuggito a un join. Il danno significativo deriva dal raggio d'impatto. Un singolo elemento alimenta un KPI, avvia un workflow operativo e finisce in una dashboard per il management, tutto nello stesso momento.
È questo il rischio nascosto nella maggior parte degli stack dati. I team sanno che alcuni dati sono più importanti di altri, ma continuano a operare come se ogni tabella meritasse lo stesso livello di controllo. Sembra equo. Non è pratico.
Quando tutti i dati sono importanti, nessuno riceve abbastanza attenzione
La maggior parte delle organizzazioni non ha la capacità di applicare la stessa profondità di governance a ogni campo di ogni sistema. I data owner vengono coinvolti in ampi cicli di revisione. Gli engineer costruiscono controlli generici che generano rumore. Gli analisti imparano ad aggirare i dati sospetti invece di fidarsi della piattaforma.
Il modo più rapido per perdere fiducia in un programma dati è trattare un campo guasto sulle preferenze di marketing e un campo guasto sul saldo di un conto come la stessa classe di problema.
Un modello operativo migliore inizia separando gli elementi ad alte conseguenze da tutto il resto. Se un campo può distorcere il reporting finanziario, compromettere un processo rivolto ai clienti o creare un'esposizione regolamentare, merita un responsabile designato, controlli più stringenti e un rilevamento più rapido.
Gli elementi di dati critici trasformano il caos in focus
È questo il ruolo degli elementi di dati critici, o CDE (critical data elements). Creano una lista ristretta di campi che meritano un'attenzione sproporzionata, perché anche le conseguenze di business di un errore su di essi sono sproporzionate.
Non è un esercizio teorico di governance. Cambia il lavoro quotidiano:
I data engineer sanno quali pipeline necessitano del monitoraggio più solido.
Gli analisti sanno quali campi di origine non possono essere trasformati con leggerezza senza una revisione.
I team di rischio e compliance sanno dove le evidenze dei controlli devono essere più solide.
I responsabili ottengono risposte più chiare quando qualcosa si rompe, perché i dati più importanti hanno già responsabili e controlli.
Senza questo focus, i team restano reattivi. Inseguono i sintomi. Ricostruiscono la fiducia un incidente alla volta. Con questo focus, iniziano a controllare i punti dello stack che possono incidere su ricavi, compliance ed esperienza del cliente.
Che cosa sono esattamente gli elementi di dati critici
Il modo più semplice per capire gli elementi di dati critici è smettere di pensare ai dati come a un inventario piatto. Pensate al vostro patrimonio dati come a un edificio. Alcune parti migliorano l'esperienza. Altre reggono la struttura. Potete ridipingere una stanza senza conseguenze per l'edificio. Non potete rimuovere un muro portante e aspettarvi che l'edificio resti in piedi.
Gli elementi di dati critici sono i muri portanti. Sono i campi la cui accuratezza, disponibilità e tempestività sostengono le operations principali, il reporting, la compliance o le decisioni importanti.
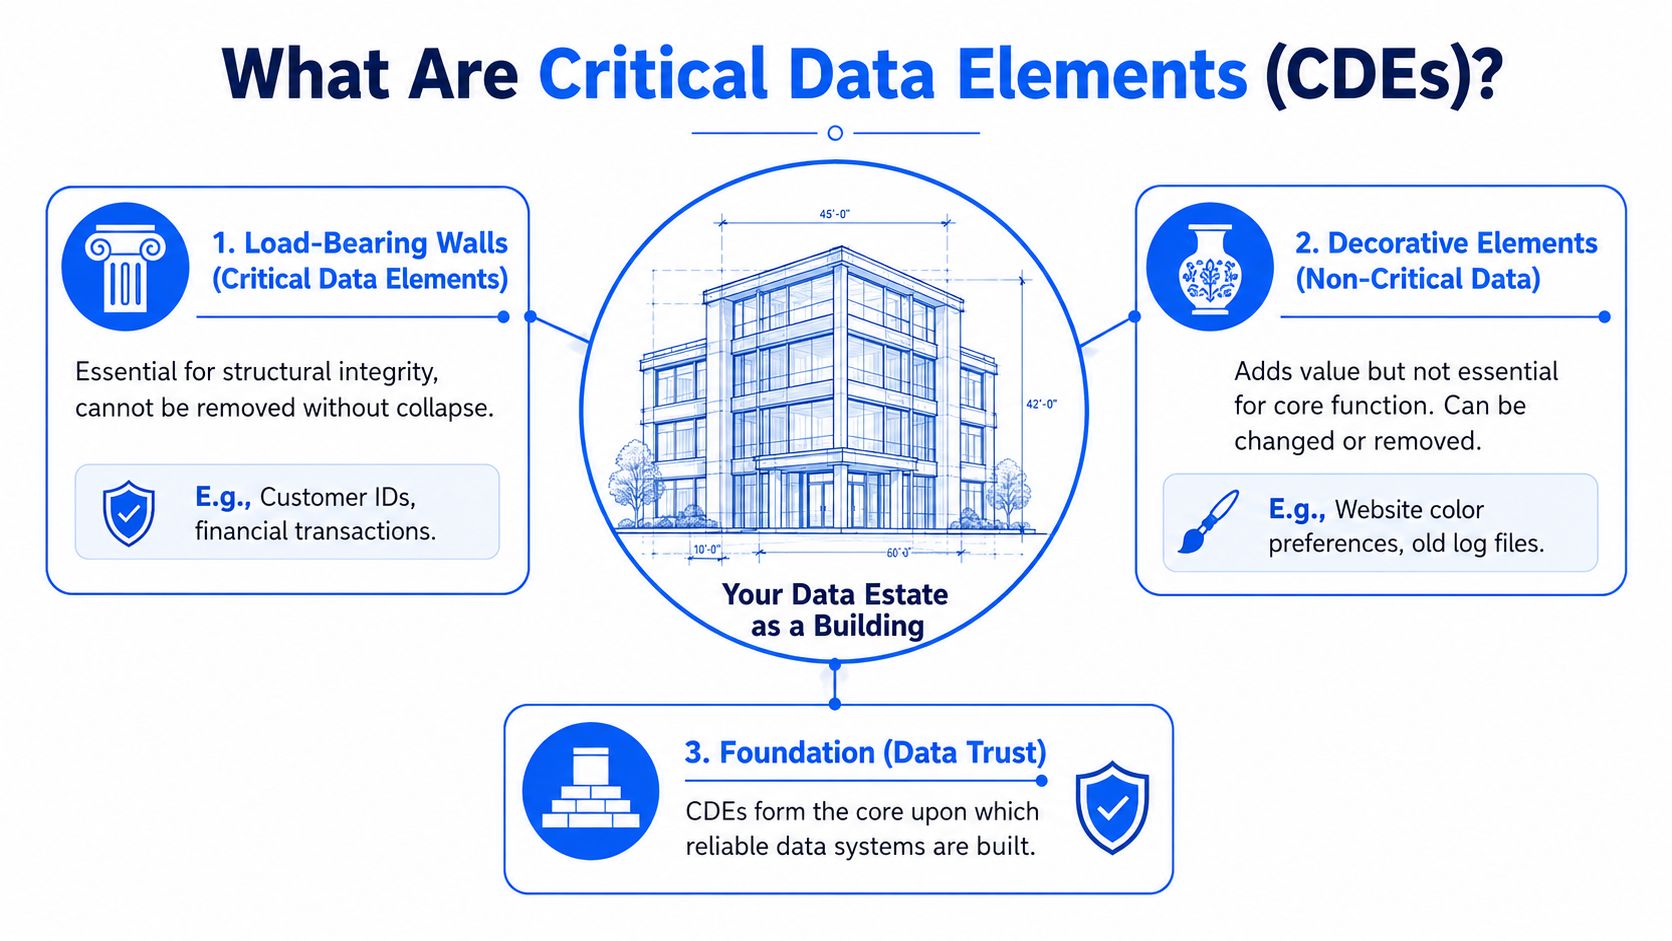
Le organizzazioni di solito restringono il proprio focus invece di cercare di classificare tutto. Le organizzazioni in genere considerano prioritari come elementi di dati critici tra i 200 e i 250 elementi di dati specifici, oggetto di una governance mirata, riconoscendo che alcuni dati comportano un rischio finanziario, regolamentare o reputazionale molto più elevato di altri, come descritto in questa panoramica pratica sulla prioritizzazione dei CDE.
Perché il contesto di business conta più del tipo di dato
Un campo non diventa critico perché sembra importante o perché risiede in una tabella di produzione. Diventa critico perché il business ne dipende.
Un codice fiscale, un numero di conto, un importo di transazione o un codice paese rientrano spesso nella categoria critica, perché un errore su di essi incide su identità, reporting, controlli antifrode, join a valle od obblighi di legge. Un campo sulle preferenze di marketing può essere importante per un team che gestisce campagne, ma di solito non comporta lo stesso rischio trasversale.
Questa distinzione è importante perché i team spesso classificano in modo intuitivo. Dicono che i dati dei clienti sono critici, quelli di prodotto hanno priorità media e i log priorità bassa. È una classificazione troppo ampia per essere utile. Il lavoro sui CDE avviene a livello di singolo elemento, non di etichetta di dominio.
Che cosa rientra di solito in un insieme di CDE
Nella pratica, i CDE presentano di solito una o più di queste caratteristiche:
Alimentano il reporting esterno. Se un campo confluisce nel reporting per il consiglio di amministrazione, nelle segnalazioni regolamentari o nel bilancio, gli errori diventano visibili rapidamente e costano cari.
Avviano processi di business. Uno stato, un saldo o un identificativo errato può avviare o bloccare workflow reali.
Collegano i sistemi tra loro. Chiavi e valori di riferimento sembrano spesso semplici, ma una chiave guasta può invalidare tutto ciò che sta a valle.
Alimentano KPI o modelli considerati affidabili. Se i dirigenti o i sistemi automatizzati si basano su un campo, la sua qualità diventa strategica.
Regola pratica: non chiedetevi se un campo è importante. Chiedetevi che cosa si rompe se è sbagliato, in ritardo o mancante.
Questa è la definizione. Gli elementi di dati critici sono i campi che non potete permettervi di fraintendere.
Perché i CDE sono il fondamento della fiducia nei dati
La fiducia nei dati non nasce dal design di una dashboard, dall'introduzione di un catalogo o da una policy di governance. Nasce dalla prova ripetuta che i numeri su cui le persone fanno affidamento sono corretti quando le decisioni hanno conseguenze. I CDE sono al centro di questa prova, perché indicano i campi in cui un guasto è più costoso.
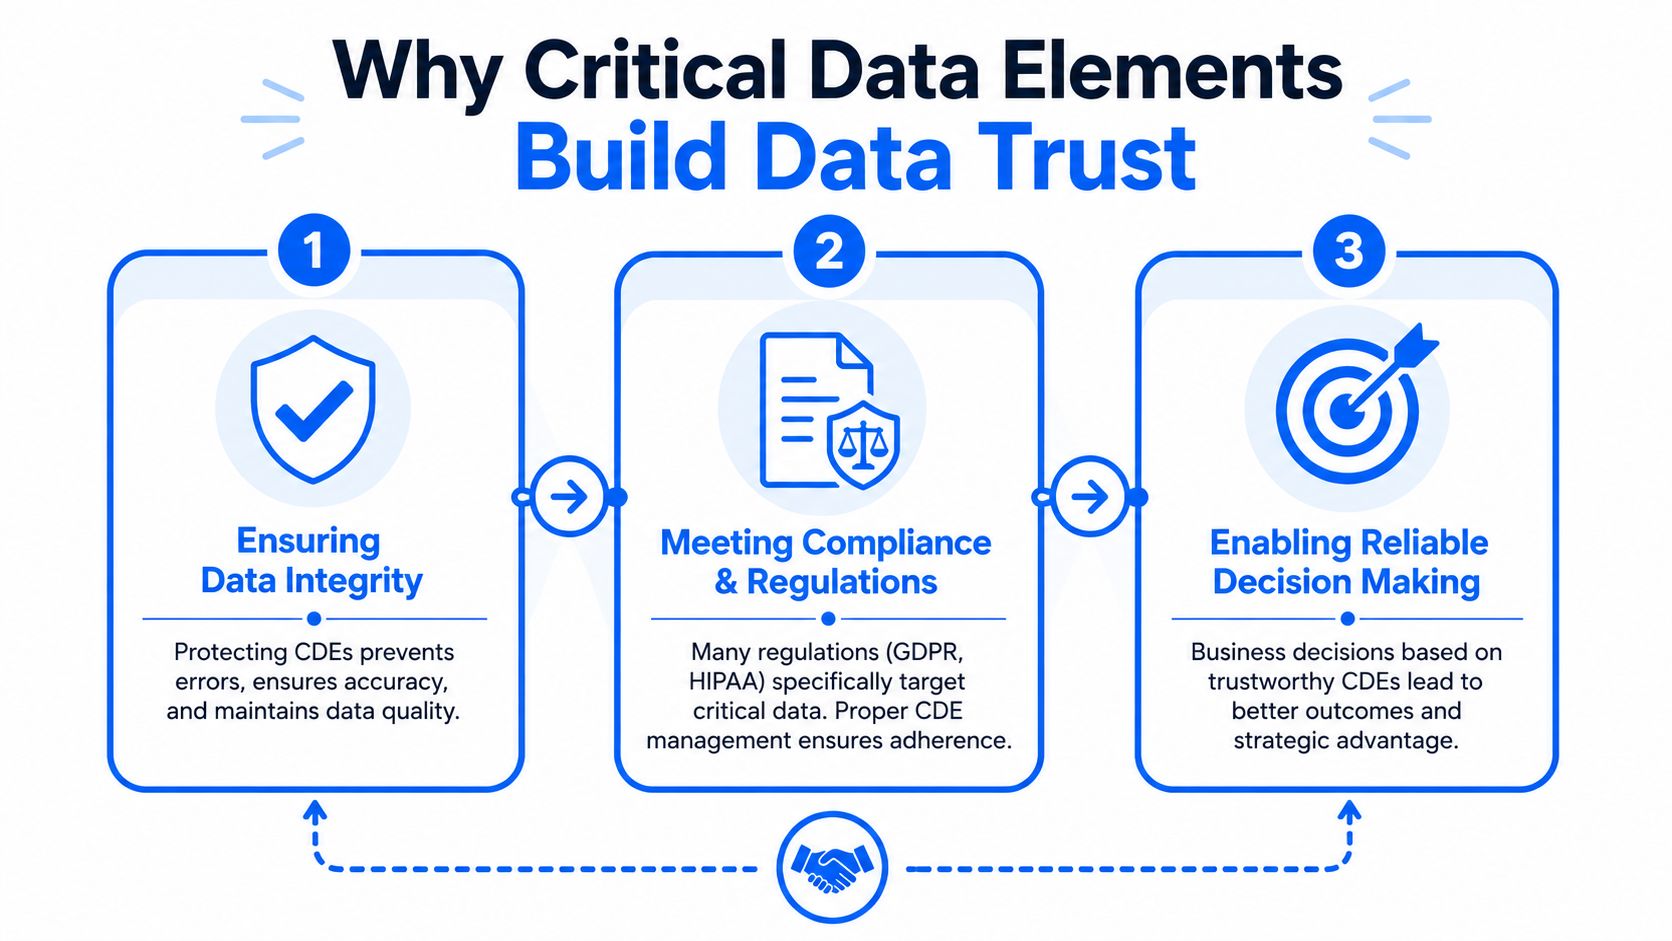
Quando le organizzazioni saltano questa fase di prioritizzazione, di solito ottengono uno di due risultati negativi. O controllano eccessivamente dati di scarso valore e sfiniscono i propri team, oppure distribuiscono i controlli in modo così sottile che guasti di importanza critica passano inosservati. I team impegnati a risolvere i problemi di qualità dei dati nei team B2B si scontrano continuamente con questa situazione. Il problema non è l'impegno. È il focus.
La fiducia si rompe nel punto in cui ci sono conseguenze
Le persone smettono di fidarsi dei dati quando il guasto incide su qualcosa di visibile. Può essere un estratto conto per il cliente, un KPI sui ricavi, un workflow di compliance o la documentazione per il consiglio di amministrazione. La causa tecnica può essere piccola, ma l'impatto sulla fiducia è grande perché il campo sbagliato si trovava su un percorso critico.
La governance dei CDE riduce questo rischio rendendo esplicite le conseguenze. Invece di dire “migliorare la qualità dei dati”, il team può dire:
questo campo incide sull'onboarding dei clienti
questo alimenta un report regolamentato
questo determina se un processo operativo viene avviato
questo è un input di un modello che modifica le decisioni di business
Questo tipo di specificità cambia i comportamenti. I responsabili reagiscono più in fretta. I controlli diventano più facili da giustificare. Le soglie di alerting vengono legate all'impatto sul business invece che a generiche preferenze ingegneristiche.
Un'analytics affidabile parte da input protetti
Una dashboard di BI non diventa affidabile perché il livello di visualizzazione è curato. Un modello di AI non diventa attendibile perché l'algoritmo è complesso. Entrambi dipendono dagli input che li alimentano.
Se i CDE alla base di un KPI subiscono un drift impercettibile, la dashboard continua a essere visualizzata. Semplicemente mostra la risposta sbagliata. Lo stesso vale per le tabelle di feature e gli input dei modelli. I data product spesso falliscono senza preavviso prima di fallire in modo visibile.
Ecco perché i team dovrebbero definire un piccolo insieme di metriche di qualità per ciascun elemento critico e rivederle continuamente. Un punto di partenza utile è un framework di metriche documentato, come le metriche di qualità dei dati per il monitoraggio operativo, in cui i team possono associare i campi ad aspettative misurabili come completezza, validità, tempestività e stabilità.
I programmi di analytics solidi non iniziano monitorando ogni campo. Iniziano proteggendo i campi che possono invalidare il risultato.
I CDE sono il fondamento della fiducia nei dati perché collegano i controlli tecnici al rischio di business. Senza questo collegamento, la fiducia resta soggettiva. Con esso, la fiducia diventa operativa.
Un metodo per identificare e prioritizzare i CDE
Spesso le organizzazioni non hanno bisogno di un framework perfetto per iniziare. Ne hanno bisogno di uno ripetibile. Il metodo tradizionale per i CDE è manuale, ma funziona ancora quando l'organizzazione ha bisogno di un linguaggio comune e di un primo inventario difendibile.
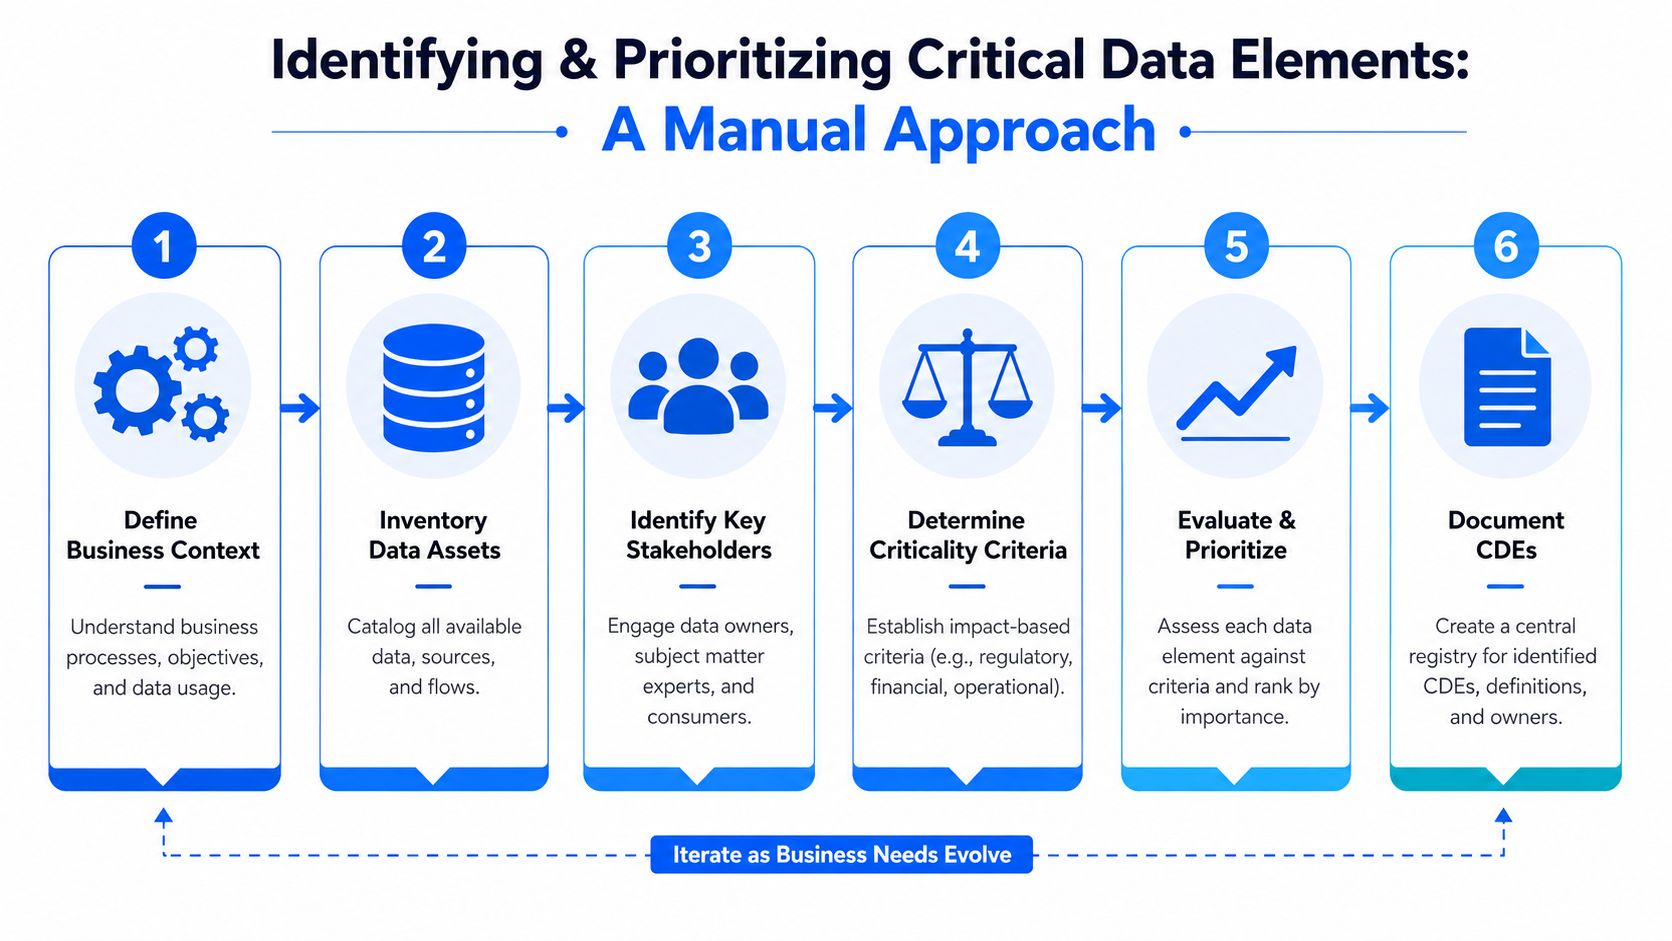
Un processo manuale pratico inizia di solito con un gruppo interfunzionale. Ciò significa data engineering, analytics, responsabili di business, compliance o rischio e le persone che gestiscono i workflow principali. Se è solo il team dati a definire la criticità, l'elenco tende a essere troppo tecnico. Se sono solo gli stakeholder di business a definirla, l'elenco di solito diventa troppo ampio.
Il metodo manuale che funziona ancora
Partite dalla mappatura dei processi, non da quella delle tabelle. Individuate i processi di business che non possono tollerare guasti dei dati. Ad esempio fatturazione, gestione dei sinistri, onboarding dei clienti, reporting regolamentare, viste di tesoreria, pricing e reporting dei KPI per il management.
Poi risalite da questi processi ai sistemi e ai campi da cui dipendono. Per ogni elemento candidato documentate:
Dove ha origine l'elemento. Sistema di origine e responsabile.
Dove viene usato. Report, API, modelli, workflow e tabelle a valle.
Che cosa succede se fallisce. Impatto sui clienti, finanziario, operativo o regolamentare.
Quale controllo esiste oggi. Regole di validazione, riconciliazioni, monitoraggio o revisione manuale.
Chi ne risponde. Responsabilità chiare del data owner evitano che gli elenchi di CDE diventino documentazione orfana.
Una volta ottenuto un inventario dei candidati, assegnate un punteggio agli elementi. Una regola pratica molto diffusa prevede che un elemento di dati venga in genere classificato come CDE se ottiene 5 o più punti in un modello di punteggio manuale che valuta l'impatto sull'esperienza del cliente, sul reporting regolamentare, sul calcolo dei KPI e sull'avvio di processi a valle, come illustrato in questa guida alla governance dei CDE.
Il punteggio manuale è utile perché costringe i team a rendere esplicito il rischio. È limitato perché congela il mondo così com'era durante il workshop.
Esempio di matrice di prioritizzazione dei CDE
Per iniziare di solito basta una matrice semplice.
Elemento di dati | Processo di business | Impatto regolamentare (1-3) | Impatto finanziario (1-3) | Impatto operativo (1-3) | Punteggio totale |
|---|---|---|---|---|---|
ID cliente | Onboarding dei clienti e abbinamento tra sistemi | 2 | 2 | 3 | 7 |
Saldo del conto | Reporting finanziario ed estratti conto dei clienti | 3 | 3 | 3 | 9 |
Codice paese | Gestione fiscale e segmentazione del reporting | 2 | 2 | 2 | 6 |
Preferenza di marketing | Esecuzione delle campagne | 1 | 1 | 1 | 3 |
Questo approccio manuale crea allineamento rapidamente. Ma ha anche limiti evidenti. Dipende da interviste, memoria e disponibilità degli stakeholder. È difficile da mantenere aggiornato quando compaiono nuove dashboard, nuovi casi d'uso di AI o nuove pipeline. E può diventare politico quando ogni team vuole che i propri dati siano considerati critici.
Resta comunque il punto di partenza giusto, perché vi offre una lista ristretta e controllata invece della vaga ambizione di governare tutto.
Automatizzare la governance dei CDE con la data observability
L'identificazione manuale dei CDE è utile per l'allineamento iniziale, ma non tiene il passo con una piattaforma in evoluzione. Un campo che il trimestre scorso sembrava non critico può diventarlo nel momento in cui una dashboard finanziaria, una pipeline di feature di ML o un workflow operativo iniziano a dipenderne.
Ecco perché i team moderni stanno passando dalla classificazione periodica alla discovery continua.
Dove il modello manuale inizia a cedere
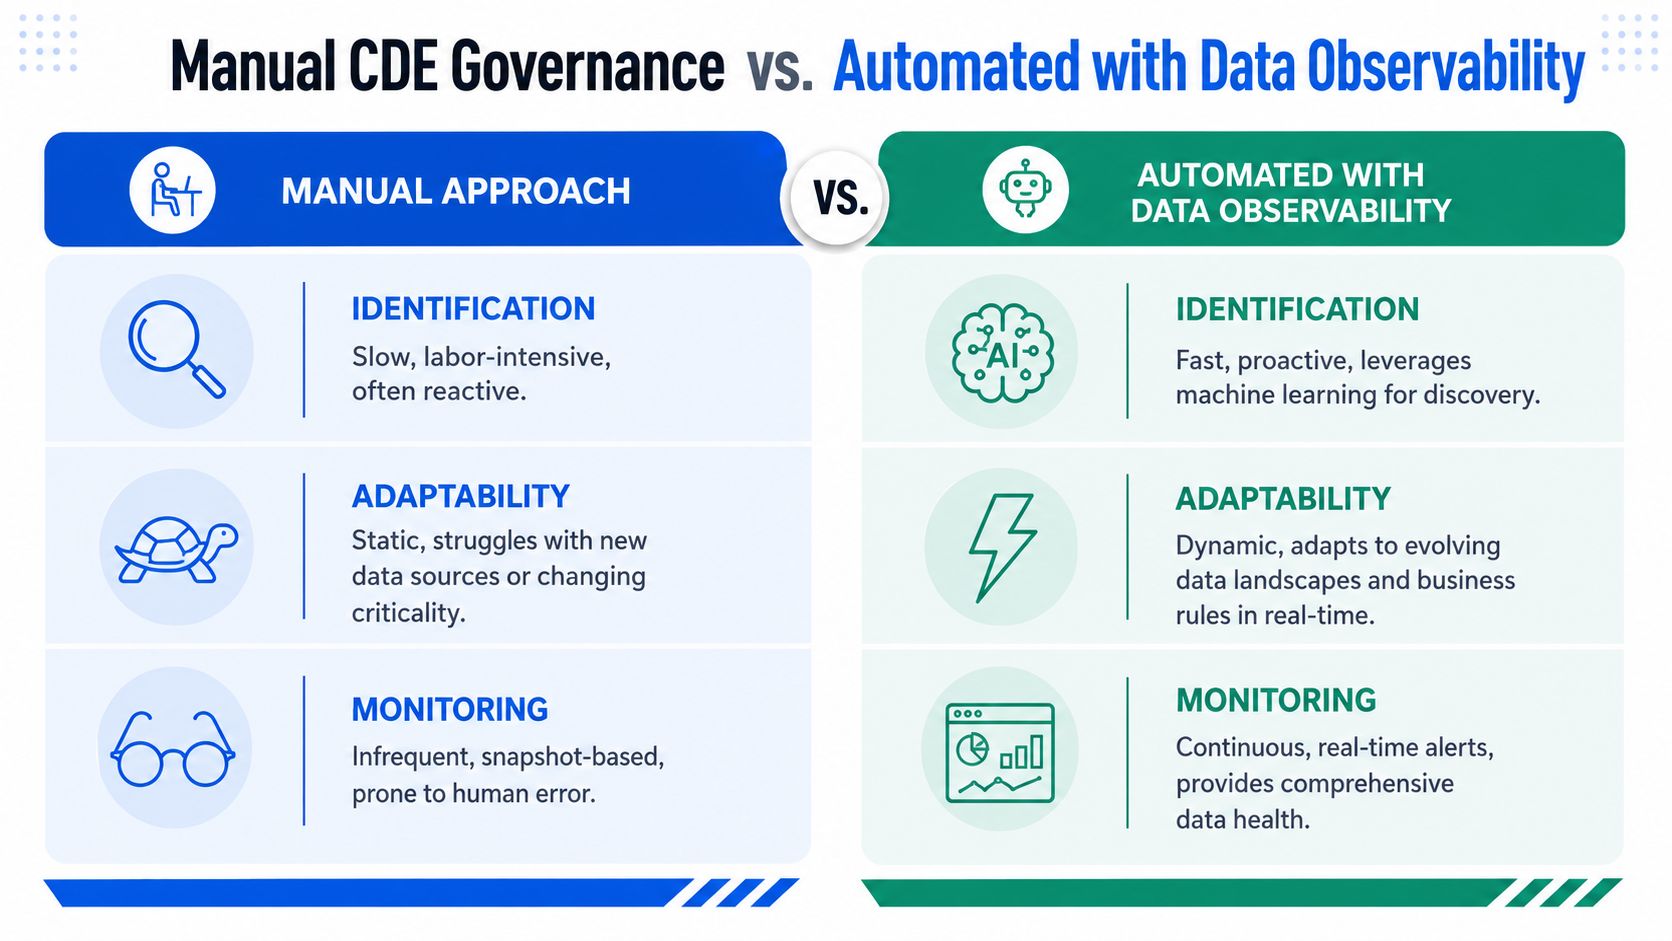
Il processo tradizionale presuppone che la criticità cambi lentamente. In molti stack non è così. Compaiono nuovi modelli dbt. Una sincronizzazione di reverse ETL inizia a usare un campo prima ignorato. Un team di prodotto rilascia una funzionalità che dipende da una colonna che nessuno aveva classificato come importante durante l'ultimo ciclo di governance.
Il punto di vista di un professionista del settore, riassunto in questa discussione sulla discovery moderna dei CDE, rende evidente il problema: molti team dati riferiscono che l'identificazione manuale dei CDE è troppo lenta e soggetta a distorsioni, e l'alternativa più attuale usa il data lineage e l'analisi dei metadati per segnalare dinamicamente i CDE in base ai pattern di utilizzo in tempo reale e all'impatto sul business.
È questo il divario che la data observability colma. Invece di chiedere alle persone di ricordare che cosa conta, la piattaforma osserva che cosa sta facendo l'ambiente.
Come si presenta l'identificazione dinamica dei CDE
Un approccio automatizzato combina diversi segnali:
Profondità e portata del lineage. Se un campo alimenta più report, trasformazioni o sistemi a valle, il suo raggio d'impatto è maggiore.
Intensità di utilizzo. Un campo che compare in dashboard molto consultate, report pianificati o pipeline di modelli merita un'attenzione più stretta.
Contesto di business. Tag, ownership del dominio e metadati delle policy aiutano a separare gli elementi operativamente importanti da quelli secondari.
Stabilità osservata. Drift, problemi di freschezza o modifiche strutturali contano di più quando riguardano percorsi ad alto impatto.
Un livello di data observability riunisce questi segnali e li mantiene aggiornati. Se vi serve una base sintetica sul modello operativo, questa spiegazione su che cos'è la data observability nella pratica è un riferimento utile.
Una buona governance dei CDE non dovrebbe dipendere da chi ha partecipato all'ultimo workshop. Dovrebbe riflettere il grafo reale delle dipendenze del vostro stack dati.
Il grande cambiamento è operativo. La governance manuale vi dà un elenco statico. L'observability vi dà un sistema vivo. Aiuta i team a individuare i CDE emergenti, ad adattare il monitoraggio al variare delle dipendenze e a ridurre il ritardo tra un cambiamento di business e la risposta della governance.
Questo non elimina il giudizio umano. Migliora il punto in cui viene applicato. Le persone continuano a decidere policy, ownership e correzioni. Il sistema si occupa della scansione, della correlazione e dell'allerta precoce, cose che gli esseri umani non sanno fare bene in modo continuo.
Come digna protegge i vostri elementi di dati critici
Una volta che un team sa quali campi sono critici, la domanda successiva è pratica. Come evitare che questi campi subiscano drift, si rompano, arrivino in ritardo o cambino forma senza che qualcuno debba fare da balia a ogni pipeline?
È qui che conta un approccio di piattaforma.
Associare ogni rischio sui CDE a un tipo di controllo
Guasti diversi dei CDE richiedono controlli diversi. Trattarli tutti come generici “controlli di qualità” crea punti ciechi.
Per i cambiamenti di comportamento silenziosi, digna Data Anomalies apprende i pattern normali e segnala le variazioni inattese senza affidarsi a regole statiche. Questo conta per i campi critici le cui distribuzioni, volumi o pattern di null possono subire un drift molto prima che una dashboard fallisca in modo visibile.
Per il rischio legato alle pianificazioni, digna Timeliness monitora le consegne previste e il comportamento dei ritardi. Molti incidenti non iniziano con valori errati. Iniziano con dati mancanti o in ritardo che vengono interpretati come completi.
Per i vincoli di business rigidi, digna Data Validation applica regole a livello di record. È il livello giusto per controlli come il popolamento obbligatorio, i valori ammessi, la coerenza tra campi e i controlli specifici di dominio che auditor o team di rischio si aspettano di vedere documentati.
Per le rotture strutturali, digna Schema Tracker intercetta colonne aggiunte o rimosse e cambi di tipo di dato. È particolarmente utile quando un campo critico fa parte di un contratto di pipeline e i team a monte lo modificano senza rendersi conto dell'impatto a valle.
Perché l'esecuzione in-database cambia il modello operativo
L'architettura conta quanto la logica di rilevamento. I CDE sensibili si trovano spesso in warehouse e ambienti operativi in cui i team non vogliono che i dati grezzi vengano copiati in un'altra piattaforma gestita da un fornitore.
Secondo la guida di digna all'automazione del rilevamento delle anomalie, le architetture con calcolo delle metriche in-database eliminano il 95% dei costi di spostamento dei dati analizzandoli direttamente dove risiedono, garantendo che i dataset di produzione grezzi non lascino mai l'ambiente del cliente pur generando punteggi di confidenza e segnalazioni di anomalie.
Questo cambia la discussione sulla governance in tre modi:
I team di sicurezza ottengono un modello che mantiene i dati di produzione all'interno di ambienti controllati.
I team di piattaforma evitano spostamenti aggiuntivi e la duplicazione della complessità operativa.
I data owner ricevono comunque segnali, trend e alert utilizzabili invece di rumore tecnico grezzo.
Il valore pratico è chiaro. Un programma di CDE fallisce se la protezione è troppo costosa, troppo invasiva o troppo difficile da mantenere. Una piattaforma che gira all'interno dell'ambiente del cliente e copre anomalie, tempestività, validazione, analytics e modifiche degli schemi offre ai team un percorso praticabile dalla policy al controllo quotidiano.
Dal caos dei dati alla fiducia nei dati
La maggior parte delle organizzazioni non ha un problema di qualità dei dati. Ha un problema di prioritizzazione. Chiede a team piccoli di proteggere un universo in espansione di tabelle, campi e pipeline, e poi si chiede perché la fiducia resti fragile.
Una strategia incentrata sui CDE risolve il problema restringendo la missione. Proteggete i campi che comportano reali conseguenze di business. Assegnate loro dei responsabili. Collegate i controlli al rischio effettivo. Monitorateli in modo continuo. Trattate tutto il resto con una governance proporzionata invece che con la stessa intensità.
Il metodo manuale merita ancora un posto nella cassetta degli attrezzi, perché crea una comprensione condivisa. Ma non dovrebbe essere il punto di arrivo. Gli elenchi statici invecchiano in fretta. Gli stack dati cambiano più velocemente di quanto si riuniscano i comitati di governance. Ecco perché l'observability è importante. Trasforma la criticità dal risultato di un workshop in un segnale operativo vivo.
Se lo fate bene, la cultura cambia. I team smettono di affannarsi a ricostruire il lineage nel mezzo di un incidente. Gli utenti di business smettono di chiedersi se l'ultimo aggiornamento della dashboard sia affidabile. I responsabili dei dati smettono di difendere programmi di governance generici che non riducono chiaramente il rischio.
La fiducia nasce dal sapere quali dati contano di più e dall'avere controlli che li sorvegliano costantemente.
È questa la strada pratica da seguire. Non cercate di governare tutto come se fosse ugualmente importante. Identificate i vostri elementi di dati critici, proteggeteli in modo deciso e lasciate che l'automazione mantenga il quadro aggiornato man mano che il vostro business cambia.
Se il vostro team è pronto a passare da elenchi statici di CDE a una protezione continua, digna merita un'attenta valutazione. Combina rilevamento delle anomalie, validazione, monitoraggio della tempestività, tracciamento degli schemi ed esecuzione in-database, così potete proteggere i dati che contano di più senza spostare dataset di produzione sensibili fuori dal vostro ambiente.
Domande frequenti
Che cosa sono gli elementi di dati critici?
Gli elementi di dati critici, o CDE, sono i campi specifici su cui un'organizzazione non può permettersi errori: quelli che alimentano report regolamentari, bilanci, processi rivolti ai clienti o modelli. Sono definiti dalle conseguenze per il business, non dal tipo di dato.
Perché le organizzazioni hanno bisogno dei CDE?
Perché trattare tutti i dati come ugualmente importanti significa che nessuno riceve abbastanza attenzione. Individuare il piccolo insieme di elementi in cui gli errori causano danni reali permette di concentrare monitoraggio, ownership e correzioni dove rendono di più.
Come si identificano gli elementi di dati critici?
Risalendo a ritroso dalle conseguenze: i report, gli obblighi e le decisioni che devono essere corretti, e poi i campi da cui dipendono. L'insieme risultante è di solito molto più piccolo di quanto i team si aspettino.
Chi è responsabile degli elementi di dati critici?
La responsabilità spetta alla funzione di business che subisce le conseguenze, con il supporto del team dati che gestisce i controlli. I CDE senza un responsabile designato tendono a ricadere nel backlog generale.
Come vengono monitorati i CDE nella pratica?
Osservando in modo continuo il comportamento di quei campi specifici (completezza, distribuzioni, freschezza e relazioni), così che un cambiamento venga intercettato proprio nel campo che conta anziché da qualche parte a valle.


