Classi di dati spiegate: una guida pratica per i team moderni
|
7
min di lettura

Il consiglio più diffuso è classificare i dati una volta sola, applicare etichette come pubblico o riservato e considerare risolto il problema della governance. Questo approccio confonde la descrizione con il controllo. Un'etichetta che non modifica accesso, validazione, conservazione, monitoraggio o risposta agli incidenti è documentazione, non governance.
Un framework utile di classi di dati deve descrivere cosa contiene un asset, come si comporta e cosa deve fare l'organizzazione quando il suo rischio cambia. Ciò significa combinare tipo analitico, significato statistico, rappresentazione, contesto di business e impatto sulla sicurezza. Il lavoro difficile inizia dopo la pubblicazione della tassonomia, perché i team devono collegare ogni classe a controlli che operano in database, pipeline, warehouse, data lake e repository documentali reali.
Indice
Il rischio nascosto delle etichette statiche sui dati
Molti programmi di classificazione falliscono senza far scattare alcun allarme: un team di governance crea una policy, i responsabili etichettano i dataset importanti e gli auditor ricevono un'esportazione del catalogo, mentre i permessi restano invariati. Il monitoraggio continua a trattare tutte le tabelle allo stesso modo e chi gestisce gli incidenti non dispone di un segnale affidabile quando un normale dataset operativo diventa un asset a rischio più elevato.
Categorie come pubblico, interno, riservato e regolamentato offrono comunque un utile vocabolario condiviso. Il fallimento inizia quando i team presumono che quel vocabolario imponga qualcosa da solo. Un'etichetta statica non maschera un campo, non riduce la conservazione, non aumenta la frequenza di validazione né porta un alert in escalation.
Il divario tra classificazione e applicazione
Le evidenze indicano un divario operativo misurabile. Il 55% delle organizzazioni intervistate non aveva raggiunto una classificazione automatizzata su tutti i sistemi principali, e solo il 47% disponeva di una classificazione che applicava controlli a valle invece di limitarsi ad assegnare etichette, secondo il Kiteworks 2026 Data Security and Compliance Risk Report.
Queste cifre separano due risultati che i team spesso confondono. L'accuratezza della classificazione chiede se la classe assegnata sia corretta. L'efficacia della classificazione chiede se quella classe modifichi il comportamento dei sistemi che archiviano, elaborano, monitorano e proteggono i dati.
Un team può identificare correttamente una tabella clienti come riservata lasciando però in essere un ampio accesso per gli analisti. Può etichettare un report regolamentare come ad alta integrità e poi permettere che una modifica dello schema non revisionata ne alteri gli input. Può classificare una pipeline come ad alta disponibilità monitorando soltanto se un job è stato completato, non se i dati attesi sono arrivati in tempo.
Regola pratica: trattate ogni classe come l'innesco di una decisione di controllo. Se nessun controllo cambia, chiedetevi se la classe abbia un valore operativo.
Perché aggiungere categorie raramente risolve il problema
Un'applicazione debole spinge spesso i team ad ampliare la tassonomia. Aggiungono etichette per dati personali, dati finanziari, dati critici, dati riservati, dati approvati per l'AI, dati d'archivio ed eccezioni locali. Il risultato sembra preciso, eppure responsabili e strumenti si trovano davanti a maggiore ambiguità su quale etichetta prevalga e quale azione ne derivi.
Un insieme più piccolo di classi affidabili, collegate ad azioni esplicite, di solito funziona meglio. Ogni classe dovrebbe rispondere a domande pratiche:
Chi può accedere all'asset? Definite il livello di accesso e le eccezioni consentite.
Cosa deve essere validato? Specificate i controlli su campi, record, riconciliazioni o regole di business.
Con quale rapidità devono emergere i problemi? Stabilite la gravità degli alert e le aspettative di risposta.
Come vanno documentate le modifiche? Conservate lineage, eventi di audit e responsabilità.
Cosa succede quando il contesto cambia? Avviate una revisione invece di lasciare che la vecchia etichetta resti in vigore indefinitamente.
La classe di dati dimostra il suo valore quando un processo automatizzato è in grado di rilevare una discrepanza tra l'etichetta e il comportamento attuale. Una modifica dello schema, un pattern di consegna inatteso, un nuovo utilizzo a valle o un significato di business cambiato possono richiedere una riclassificazione.
Senza questo ciclo di feedback, la tassonomia diventa obsoleta mentre gli stakeholder continuano a fidarsene. La governance produce allora un catalogo che descrive il rischio di ieri, anche se permessi, pipeline e utilizzi di business sono cambiati. La classificazione deve quindi collegarsi a monitoraggio e risposta, altrimenti le sue etichette diventano passività anziché tutele.
Comprendere le tre dimensioni delle classi di dati
Un sistema di classificazione affidabile ha bisogno di più di una scala di sensibilità. Dovrebbe valutare insieme sensibilità, formato e dominio, perché ogni dimensione cambia il significato delle altre.
La sensibilità descrive la conseguenza di una compromissione. Il formato descrive come l'asset è rappresentato e cosa si può testare. Il dominio fornisce contesto di business, responsabilità e aspettative normative. La classe di un dataset dovrebbe emergere dalla loro interazione, non da un'unica etichetta scelta isolatamente.
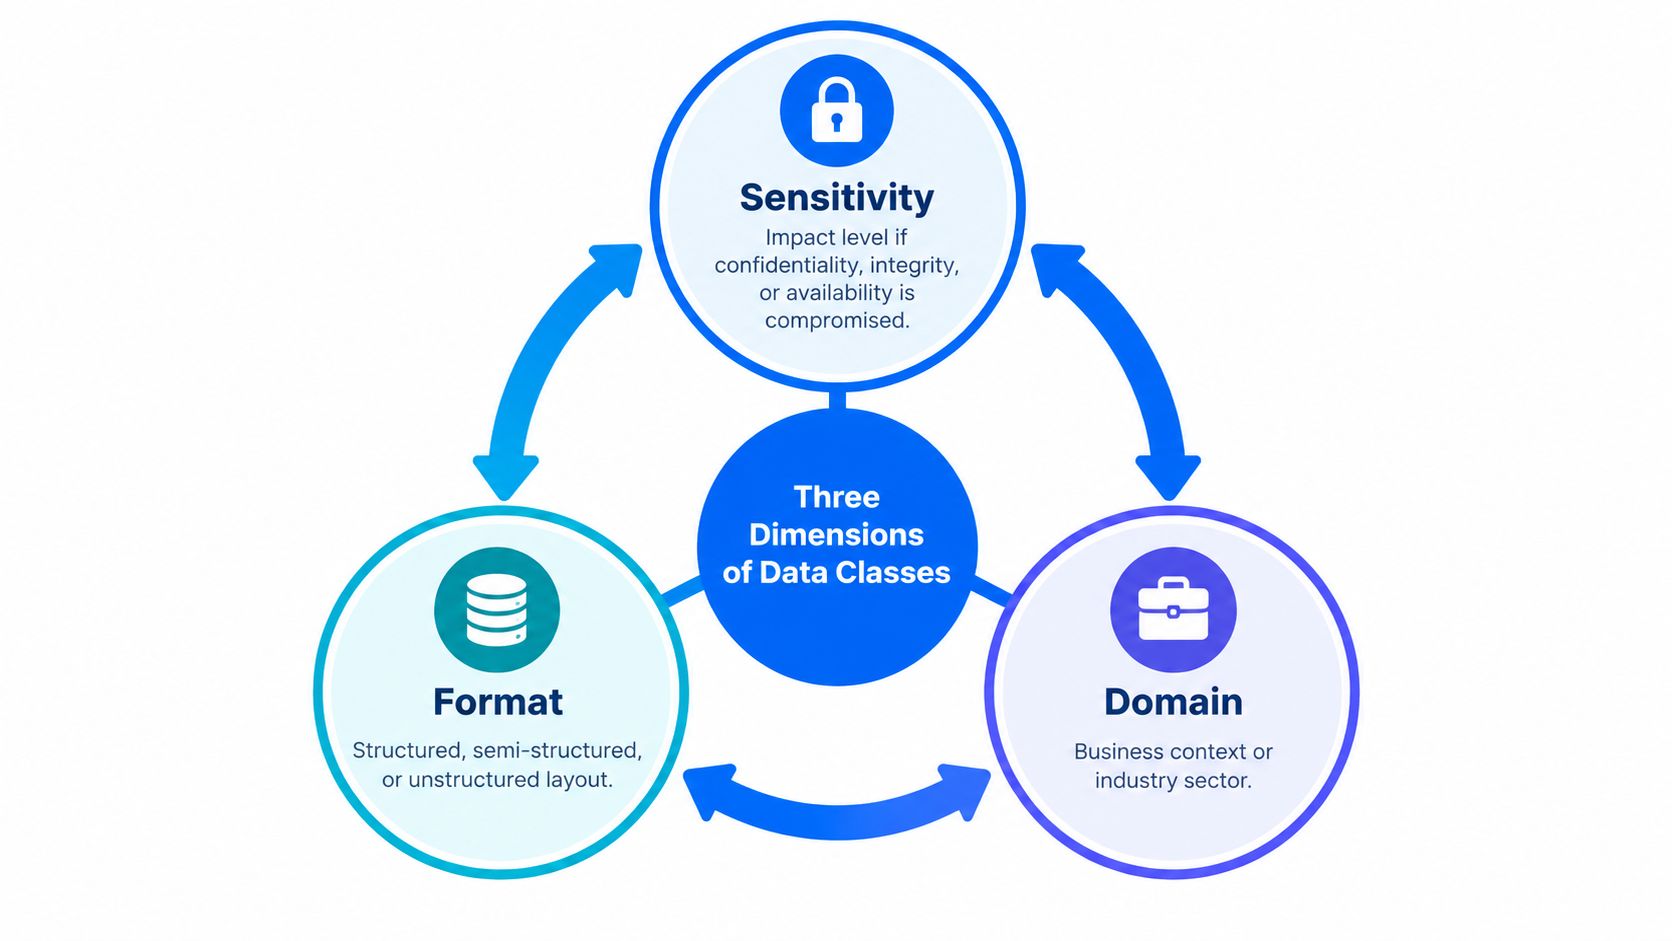
La sensibilità cambia la conseguenza
La classificazione di sicurezza valuta ogni tipo di informazione in modo indipendente rispetto a riservatezza, integrità e disponibilità. Una classe può essere bassa su una dimensione e alta su un'altra. Un feed pubblico di KPI può non contenere alcuna informazione riservata, eppure valori errati potrebbero guidare decisioni normative od operative, attribuendo all'integrità una conseguenza elevata.
Questa distinzione previene un errore comune, ovvero trattare “pubblico” come sinonimo di “a basso rischio”. I dati pubblici possono comunque richiedere un rigoroso controllo delle modifiche, riconciliazione, lineage o monitoraggio della freschezza. Al contrario, i dati privati potrebbero non richiedere controlli identici su ogni dimensione.
Il formato cambia il test
Una tabella relazionale supporta controlli su colonne, tipi di dati, unicità, relazioni e regole a livello di record. Uno stream di eventi JSON richiede attenzione a percorsi annidati, attributi opzionali, varianti di payload ed errori di parsing. Un repository documentale può richiedere lo stato di estrazione, controlli sui metadati e la conferma che i file archiviati restino utilizzabili.
La rappresentazione determina quali guasti sono visibili. Un test generico sui valori mancanti potrebbe essere superato anche quando un attributo JSON annidato è scomparso o quando un job di ingestione documentale archivia file senza contenuto estraibile.
Il dominio cambia la decisione
Lo stesso campo può richiedere controlli diversi in contesti diversi. Un timestamp in un workflow sanitario può determinare la tempestività clinica. Lo stesso tipo di campo in un feed di reporting pubblico può supportare i calendari di pubblicazione e la rendicontazione. I team di finanza, telecomunicazioni, sanità e settore pubblico attribuiscono ciascuno conseguenze diverse a ritardi, alterazioni e record incompleti.
Un modello pratico registra quindi il business owner dell'asset, il caso d'uso, la criticità, il formato e l'impatto CIA. I team che cercano un approfondimento su come le dimensioni della qualità influenzano queste decisioni possono usare questa guida per comprendere le dimensioni della qualità dei dati.
Il risultato è una classe che dice agli engineer non solo che cosa sono i dati, ma anche come dovrebbero monitorarli.
Applicare la triade CIA alla classificazione dei dati
Una classificazione orientata alla sicurezza dovrebbe valutare ogni tipo di informazione in modo indipendente rispetto a riservatezza, integrità e disponibilità, assegnando un livello di impatto in base al danno causato dalla perdita di ciascun obiettivo. Questo principio è documentato nelle linee guida sulla classificazione dei dati aziendali dell'Organizzazione degli Stati Americani.
L'errore pratico consiste nel ridurre le tre dimensioni a un unico punteggio di sensibilità. Un singolo punteggio nasconde il motivo per cui un dataset è importante e rende più difficile scegliere il controllo giusto. Il principio dell'high-watermark affronta questo problema: la dimensione CIA con le conseguenze più gravi determina il requisito di protezione complessivo.
La riservatezza richiede controlli sull'esposizione
I dati riservati causano danni quando persone non autorizzate possono visualizzarli, copiarli o dedurli. Record dei clienti, informazioni sanitarie, informazioni sui dipendenti e materiale commercialmente sensibile richiedono controlli come accesso limitato, mascheramento, crittografia e monitoraggio dell'esposizione.
La classificazione dovrebbe identificare il tipo di informazione e l'uso consentito, non solo il nome della tabella. Una tabella chiamata customer_summary può contenere valori aggregati in un ambiente e record direttamente identificativi in un altro. Il controllo deve seguire il contenuto e il contesto effettivi.
L'integrità richiede prove di correttezza
L'integrità riguarda le alterazioni non autorizzate o errate. Registrazioni finanziarie, dati regolamentari e metriche decisionali possono essere pubblicamente visibili e richiedere comunque una protezione rigorosa contro le modifiche silenziose.
Questo porta a un insieme di controlli diverso:
Validazione dei record: testate i valori rispetto alle regole di business e alle relazioni consentite.
Riconciliazione: confrontate totali correlati o risultati tra sorgente e destinazione.
Lineage: conservate il percorso dai record sorgente alle metriche pubblicate.
Evidenza di manomissione: registrate le modifiche e rendete visibili le alterazioni non spiegate.
Un feed di dati pubblico può quindi ricevere un impatto elevato sull'integrità pur restando basso in termini di riservatezza. La classe dovrebbe comunicare questa distinzione ai data engineer e a chi gestisce gli incidenti.
La disponibilità richiede consapevolezza delle consegne
La disponibilità riguarda l'accesso nel momento in cui utenti e sistemi hanno bisogno dei dati. Dataset operativi, feed e dipendenze di piattaforma possono fallire per consegne in ritardo, caricamenti mancanti o interruzioni, anche quando il loro contenuto resta accurato e protetto in termini di riservatezza.
Il monitoraggio dovrebbe quindi tracciare freschezza, latenza di consegna, pattern di arrivo attesi e condizioni di caricamento mancante. Un task di pipeline completato non prova che siano arrivati dati utilizzabili. Il controllo deve osservare l'evento dei dati da cui dipendono effettivamente i consumatori a valle.
Una classe basata sulla triade CIA dovrebbe corrispondere direttamente a gravità degli alert, frequenza di validazione, conservazione e obiettivi di risposta agli incidenti. Dovrebbe anche restare rivedibile. Gli utilizzi di business cambiano, le dipendenze si estendono e gli schemi evolvono. Una classificazione che non riesce ad assorbire questi cambiamenti diventa un'ipotesi superata anziché un segnale di sicurezza affidabile.
Strutturare la classificazione in base al formato dei dati
La prima domanda strutturale non è se un dataset sia sensibile. È come sono rappresentati i dati. Asset strutturati, semi-strutturati e non strutturati presentano modalità di guasto diverse, quindi richiedono controlli di observability diversi. La Commissione europea indica qualità, struttura, interoperabilità, autenticità e integrità come condizioni importanti per estrarre valore dai dati, in particolare nei contesti di AI, come sintetizzato nel suo documento su data governance e politiche dei dati.
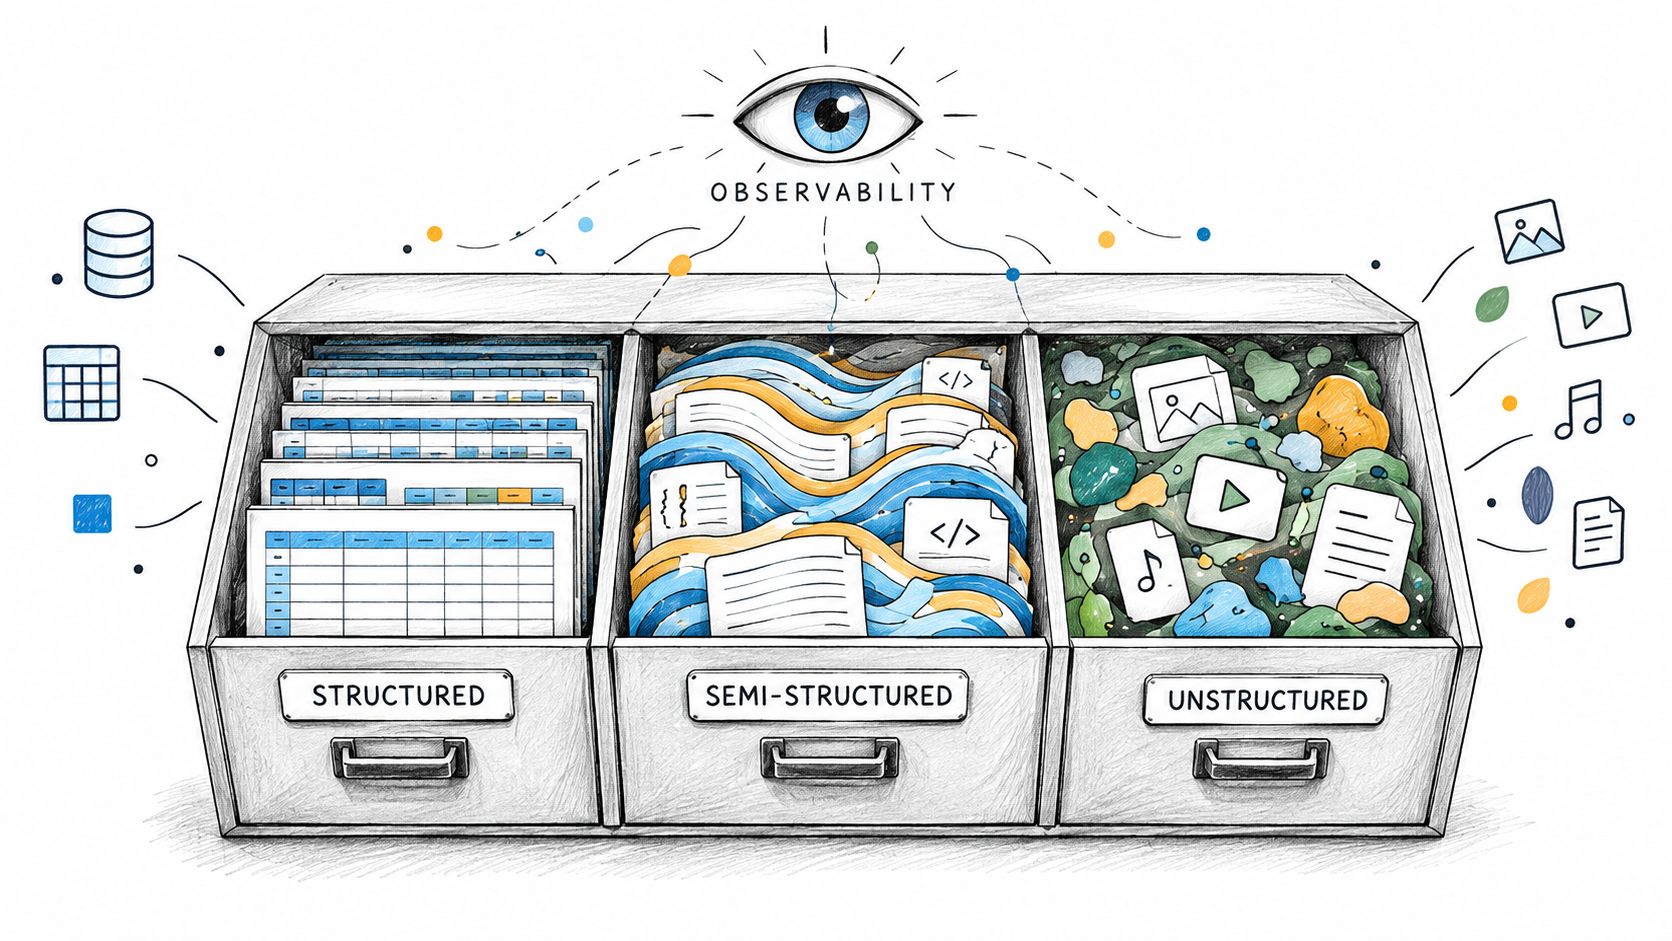
Asset strutturati
Le tabelle strutturate seguono un modello definito. Questo le rende adatte a controlli mirati:
Conformità allo schema: rilevate colonne mancanti, aggiunte o rinominate.
Validazione dei tipi: verificate che i valori corrispondano all'aspettativa analitica.
Unicità: individuate chiavi duplicate o ripetizioni inattese.
Integrità referenziale: verificate le relazioni tra tabelle.
Regole di business: testate le condizioni a livello di record e le combinazioni consentite.
Il tipo di archiviazione, tuttavia, non coincide con il significato analitico. Un campo numerico può codificare una categoria, come un codice di stato, invece di rappresentare una quantità misurabile. I dati statistici sono comunemente suddivisi in classi categoriali e quantitative, e questa distinzione determina se i team debbano usare conteggi di frequenza e rilevamento di valori inattesi oppure distribuzioni, medie, percentili, varianza e analisi degli outlier. Il glossario OCSE dei termini statistici documenta questa differenza.
Payload semi-strutturati
Gli eventi JSON e payload simili possono avere una forma riconoscibile senza uno schema applicato in modo coerente. Il monitoraggio dovrebbe verificare la presenza dei campi annidati, le strutture varianti, gli errori di parsing, le modifiche agli array e la deriva semantica.
Un controllo sul tasso di valori nulli può non accorgersi di un guasto in cui un produttore sposta un valore in un percorso diverso o ne cambia il significato mantenendo il campo valorizzato. I team che lavorano con lo storage colonnare dovrebbero anche conoscere il formato di file Parquet, incluso il modo in cui la sua struttura influisce sulla validazione a valle e sullo schema tracking.
Documenti e contenuti multimediali non strutturati
Documenti, immagini e altri contenuti multimediali richiedono un modello di controllo diverso. Un caricamento di file riuscito non dimostra che l'estrazione abbia funzionato, che i metadati siano completi o che l'elaborazione a valle sia in grado di interpretare il contenuto.
Monitorate lo stato di ingestione, la completezza dell'estrazione, la validità dei metadati e gli esiti dell'elaborazione dei contenuti. Classificare l'asset come non strutturato dovrebbe selezionare automaticamente questi controlli invece di applicare ipotesi relazionali.
I cataloghi più efficaci registrano rappresentazione, rigidità dello schema, responsabilità, comportamento di aggiornamento atteso e criticità a valle. Il formato non è una nota descrittiva a margine. Determina quali segnali possono dimostrare che l'asset resta utilizzabile.
Collegare la classificazione a controlli eseguibili
Una volta assegnate le classi, la domanda è cosa ogni classe faccia fare a un sistema. La tabella associa quattro classi comuni a un controllo principale e alle evidenze che dimostrano che il controllo è scattato.
Confrontare le scelte operative
Classe di dati | Controllo principale | Metrica di monitoraggio |
|---|---|---|
Dati riservati dei clienti | Limitazione degli accessi, mascheramento e revisione dell'esposizione | Accessi non autorizzati, stato del mascheramento ed esposizione dei campi sensibili |
Dati finanziari ad alta integrità | Validazione dei record, riconciliazione, lineage ed evidenza di manomissione | Violazioni delle regole, differenze di riconciliazione e modifiche strutturali |
Dati operativi ad alta disponibilità | Rilevamento di freschezza, consegne e interruzioni | Orario di arrivo, caricamenti mancanti, latenza e disponibilità |
Metriche pubbliche ma critiche per le decisioni | Governance della pubblicazione e validazione dell'integrità | Deriva dei valori, riconciliazione con la sorgente e modifiche non spiegate |
Ogni riga collega un'etichetta a una risposta operativa. I responsabili non devono interpretare “critico” in modo diverso da un sistema all'altro. Possono identificare il controllo richiesto, assegnare la responsabilità ed esaminare le evidenze prodotte quando quel controllo riesce o fallisce.
Una classe ha valore solo quando la sua policy raggiunge i sistemi che la applicano. I metadati del catalogo potrebbero dover guidare limitazioni degli accessi, mascheramento, conservazione, monitoraggio, instradamento degli incidenti o revisione delle pubblicazioni. Se queste destinazioni sono scollegate, l'etichetta resta descrittiva e può creare una falsa sicurezza.
Mappare le classi sull'intero patrimonio dati
Partite dagli asset ad alto impatto anziché da ogni oggetto dell'organizzazione. Assegnate la classe multidimensionale, identificate il responsabile, definite la destinazione del controllo e verificate che la classificazione raggiunga ogni sistema pertinente. Controllate che ogni sistema registri un'evidenza, come un risultato di validazione, un evento di accesso, un esito di riconciliazione o un alert, quando il controllo viene eseguito.
La guida alle regole di validazione dei dati e alla qualità dei dati continua aiuta a tradurre le classi in controlli a livello di record, regole di business e controlli di qualità ricorrenti. La scelta pratica è definire controlli corrispondenti al rischio, non associare un punteggio di qualità generico a ogni asset.
La responsabilità deve includere la riclassificazione. Un dataset può acquisire un nuovo consumatore, cambiare schema, spostarsi tra domini o entrare in un workflow regolamentato. Ognuno di questi eventi dovrebbe avviare una revisione della classe e un aggiornamento delle policy a valle.
Testate la catena regolarmente. Una classificazione che aggiorna un catalogo ma non modifica il monitoraggio, gli accessi o il comportamento dei workflow non è governance. È un'intenzione non verificata.
Integrare l'observability nell'infrastruttura
La classificazione diventa applicabile quando il monitoraggio viene eseguito vicino ai dati e può agire sullo stesso contesto che ha definito la classe. Spostare i record di produzione in un servizio di analisi esterno può creare un'esposizione non necessaria, complicare i requisiti di residenza e separare le decisioni di governance dalle evidenze operative.
Un'architettura integrata mantiene l'analisi all'interno di un'infrastruttura controllata dal cliente. Questo è importante per le organizzazioni con requisiti rigorosi di sicurezza, compliance o residenza dei dati, compresi i team che operano on-premises o in ambienti private cloud.

Mantenere i controlli vicino alla sorgente
L'esecuzione in-database permette ai team di calcolare metriche ed eseguire validazioni senza estrarre i dati di produzione in un ambiente separato ospitato dal fornitore. Rende inoltre più facile collegare una classe ai segnali che contano:
Comportamento dello schema: rilevate campi aggiunti, rimossi o modificati.
Comportamento dei record: applicate controlli basati su regole di business ai singoli record.
Tempestività: individuate ritardi, caricamenti mancanti e pattern di arrivo inattesi.
Metriche di business: monitorate il comportamento delle misure critiche.
Salute della piattaforma: osservate carico di lavoro, disponibilità e modifiche operative.
È questo il ruolo architetturale descritto per la piattaforma di data observability di digna, progettata per operare all'interno dell'ambiente dell'organizzazione. La documentazione di digna descrive una piattaforma di qualità dei dati e observability basata sull'AI che supporta il deployment on-premises e in private cloud, mantiene il monitoraggio all'interno di un'infrastruttura controllata dal cliente e riduce la necessità di estrarre i dati di produzione verso un servizio esterno.
Usare il comportamento appreso dove le soglie diventano fragili
Le soglie manuali sono utili per i limiti di business rigidi, ma diventano difficili da mantenere quando ogni dataset ha volatilità, stagionalità, tempi di consegna o comportamento operativo diversi. Una baseline basata sull'AI può apprendere il comportamento normale di ogni dataset e individuare cambiamenti inattesi senza che i team debbano configurare una soglia per ogni metrica.
L'analisi storica aggiunge il contesto mancante. Gli engineer possono esaminare trend, volatilità e pattern statistici per distinguere una deviazione occasionale da un problema in evoluzione. Questa distinzione favorisce un triage degli incidenti migliore ed evita che i team trattino ogni alert come un guasto isolato.
La scelta progettuale importante non è “AI contro regole”. Una governance affidabile usa la validazione deterministica per i requisiti espliciti e il rilevamento comportamentale per i pattern difficili da codificare manualmente. La classe determina quale combinazione sia appropriata, mentre l'infrastruttura determina se le evidenze restano sicure, tempestive e utilizzabili.
Costruire un framework di classificazione operativo
Un framework pratico parte da un inventario circoscritto degli asset critici. Selezionate i dataset che supportano reporting importante, attività regolamentari, operazioni con i clienti, processi clinici, servizi di telecomunicazione o decisioni del settore pubblico. Non iniziate cercando di classificare ogni file e ogni tabella con la stessa precisione.
Assegnate a ogni asset selezionato una scheda multidimensionale:
Descrivete la sensibilità: registrate separatamente l'impatto su riservatezza, integrità e disponibilità.
Descrivete il formato: identificate la rappresentazione strutturata, semi-strutturata o non strutturata e il comportamento del suo schema.
Descrivete il dominio: annotate business owner, finalità, contesto normativo e dipendenze a valle.
Assegnate i controlli: associate la classe ai requisiti di accesso, validazione, freschezza, schema, conservazione e risposta.
Verificate l'esecuzione: confermate che i sistemi di monitoraggio e di policy abbiano applicato i controlli previsti.
Rivedete i cambiamenti: rivalutate la classe quando cambiano comportamento, schema, responsabilità o utilizzo di business.
La scheda di classificazione dovrebbe essere utile sia ai team di governance sia a quelli di engineering. Un responsabile della sicurezza deve conoscere la conseguenza di un'esposizione. Un data engineer deve sapere quali test devono essere eseguiti. Chi gestisce gli incidenti deve sapere con quale rapidità il problema va portato in escalation e quali evidenze raccogliere.
Una classe è attuale solo quando i suoi controlli corrispondono ancora al modo in cui le persone usano i dati.
Questo modello operativo supporta anche le decisioni sulla sovranità dei dati. I team che valutano requisiti di residenza e governance possono trovare utile rispettare le normative sui dati con Stoa quando considerano come interagiscono obblighi legali, ubicazione dell'infrastruttura e pratiche di gestione dei dati.
Rivedete la classificazione rispetto al comportamento osservato invece di affidarvi a pratiche burocratiche annuali. Un dataset può restare riservato mentre i suoi requisiti di integrità aumentano dopo essere diventato un input regolamentare. Una tabella strutturata può acquisire payload semi-strutturati attraverso un nuovo percorso di ingestione. Un feed a bassa disponibilità può diventare operativamente critico dopo che un processo di business inizia a dipenderne.
Le indicazioni di digna sull'implementazione della data governance possono aiutare i team a collegare responsabilità, controlli di qualità, monitoraggio e workflow di governance. L'obiettivo non è la tassonomia più ampia. È un insieme di classi che cambia in modo coerente ciò che i sistemi misurano, proteggono, conservano e portano in escalation.
digna aiuta i team a trasformare una classe di dati in controlli eseguibili grazie a validazione in-database, schema tracking, monitoraggio della tempestività, monitoraggio del business e anomaly detection basata sull'AI, all'interno di ambienti private cloud o on-premises. Visitate digna per vedere come il vostro team può monitorare i dati critici senza spostare i record di produzione in un servizio esterno.
La classificazione decide anche dove i dati possono essere archiviati ed elaborati. La nostra guida ai requisiti di residenza dei dati spiega come le regole sull'ubicazione interagiscono con le classi che assegnate e con i controlli che queste attivano.
Domande frequenti
Che cos'è una classe di dati?
Una classe di dati è la categoria a cui appartiene un asset in base alla sua sensibilità, al suo formato e al suo dominio di business. Una classe utile fa più che descrivere i dati: stabilisce quali controlli di accesso, validazione, conservazione e monitoraggio si applicano, quindi un'etichetta che non cambia nulla a valle è documentazione, non governance.
Quali sono le tre dimensioni della classificazione dei dati?
Sensibilità, formato e dominio. La sensibilità descrive la conseguenza se i dati vengono compromessi, il formato descrive come sono rappresentati e quindi cosa si può testare, e il dominio fornisce contesto di business, responsabilità e aspettative normative. Valutarle tutte e tre insieme produce una classe più affidabile di una singola scala di sensibilità.
Come si applica la triade CIA alla classificazione dei dati?
Ogni tipo di informazione viene valutato separatamente per riservatezza, integrità e disponibilità, in base al danno causato dalla perdita di ciascuna. Un feed pubblico di KPI può non richiedere controlli di riservatezza ma esigere comunque controlli di integrità rigorosi, perché valori errati potrebbero guidare decisioni normative od operative. Ridurre le tre dimensioni a un unico punteggio nasconde questo aspetto.
Perché i programmi di classificazione dei dati falliscono?
La maggior parte fallisce in silenzio perché le etichette non cambiano mai i controlli. I responsabili etichettano i dataset e gli auditor ricevono un'esportazione del catalogo, ma permessi e monitoraggio restano invariati. Un report del 2026 citato ha rilevato che solo il 47% delle organizzazioni disponeva di una classificazione che applicava controlli a valle, e aggiungere altre categorie di solito aumenta l'ambiguità invece di risolvere il problema dell'applicazione.
In che modo i dati strutturati e non strutturati vanno monitorati diversamente?
Le tabelle strutturate si prestano a controlli su schema, tipi, unicità, integrità referenziale e regole di business. Il JSON semi-strutturato richiede il monitoraggio di percorsi annidati, varianti ed errori di parsing, perché i valori possono spostarsi senza diventare nulli. Documenti e contenuti multimediali non strutturati richiedono controlli su ingestione, completezza dell'estrazione e metadati, poiché un caricamento riuscito non dimostra che il contenuto sia utilizzabile.


