Requisiti di residenza dei dati: guida pratica per il 2026
|
6
min di lettura

Siete nel mezzo di una revisione di routine e qualcuno dell'ufficio legale, del procurement o di un'autorità di vigilanza pone una domanda che sembra semplice finché non provate a rispondere in modo netto: dove risiedono questi dati dei clienti? Indicare il database primario è abbastanza facile. La parte difficile è dimostrare dove si trovano le repliche, dove finiscono i backup, cosa contengono i vostri log, quali esportazioni escono dalla regione e se il personale di supporto può accedere ai dati da un altro luogo.
È questa la vera forma dei requisiti di residenza dei dati nel 2026. Non è una casella da spuntare sulla regione di archiviazione, ma un problema di controllo dell'intero ciclo di vita, e i team che lo gestiscono bene trattano geografia, elaborazione, copie, accessi ed evidenze come un unico sistema. Quelli che falliscono di solito non falliscono sulla tabella master. Falliscono sull'esportazione, sul backup, sull'estratto da un notebook o sul workflow del fornitore che nessuno ha mappato.
Indice
Quando l'autorità di vigilanza chiede dove risiedono i vostri dati
Perché la compliance si rompe sulle copie, non sul sistema primario
On-premises, private cloud e public cloud vincolato a una regione
Pratiche di observability che riducono nel tempo il rischio di residenza
Quando l'autorità di vigilanza chiede dove risiedono i vostri dati
Un responsabile finanziario di una multinazionale, un platform engineer di una rete ospedaliera e un responsabile della sicurezza di un operatore di telecomunicazioni finiscono tutti nella stessa situazione scomoda. Arriva il questionario, e non chiede soltanto dove è ospitato il database primario. Chiede dove finiscono repliche, backup, log, allegati del supporto ed esportazioni, perché è lì che nella pratica la residenza spesso si rompe.
Ecco perché l'estensione delle regole sulla residenza conta a livello operativo. Secondo l'Information Technology and Innovation Foundation, il numero di giurisdizioni con una qualche forma di requisito di localizzazione dei dati è passato da 35 nel 2017 a 62 nel 2026, e solo 18 di queste 62 impongono obblighi assoluti di permanenza nel paese, mentre 44 adottano modelli condizionali che consentono trasferimenti transfrontalieri sulla base di meccanismi giuridici definiti. Per l'engineering la conclusione è semplice: la maggior parte dei regimi non richiede un confinamento totale, ma richiede il controllo su ogni percorso che i dati possono seguire. Benchmark globale sulla residenza dei dati
Regola pratica: se non potete tracciare una copia, non potete dimostrare la residenza.
Cosa verifica davvero questa domanda
Chi pone la domanda non sta solo controllando la posizione di un server. Sta verificando se la vostra architettura è in grado di raccontare in modo chiaro archiviazione, elaborazione, copie e accessi tra le diverse giurisdizioni. Se la vostra risposta inizia e finisce con “il database è nella regione”, avete già ammesso il punto cieco.
Questo vale soprattutto nei settori regolamentati, dove gli obblighi di residenza emergono nei flussi di dati di finanza, sanità, telecomunicazioni e pubblica amministrazione. Questi ambienti non perdonano confini approssimativi. Un singolo CSV esportato, un dump del supporto fatto a tarda notte o una destinazione di backup nel posto sbagliato possono trasformare una policy ordinata in un evento di non conformità.
I team migliori rispondono con evidenze, non con rassicurazioni. Sono in grado di mostrare mappe delle regioni, meccanismi di trasferimento e l'inventario effettivo delle copie. Sanno anche che l'observability deve fare da rete di sicurezza alla progettazione, perché l'architettura cambia nel tempo e le nuove pipeline tendono a creare proprio la deriva che gli audit scoprono.
Definire la residenza dei dati e i concetti affini
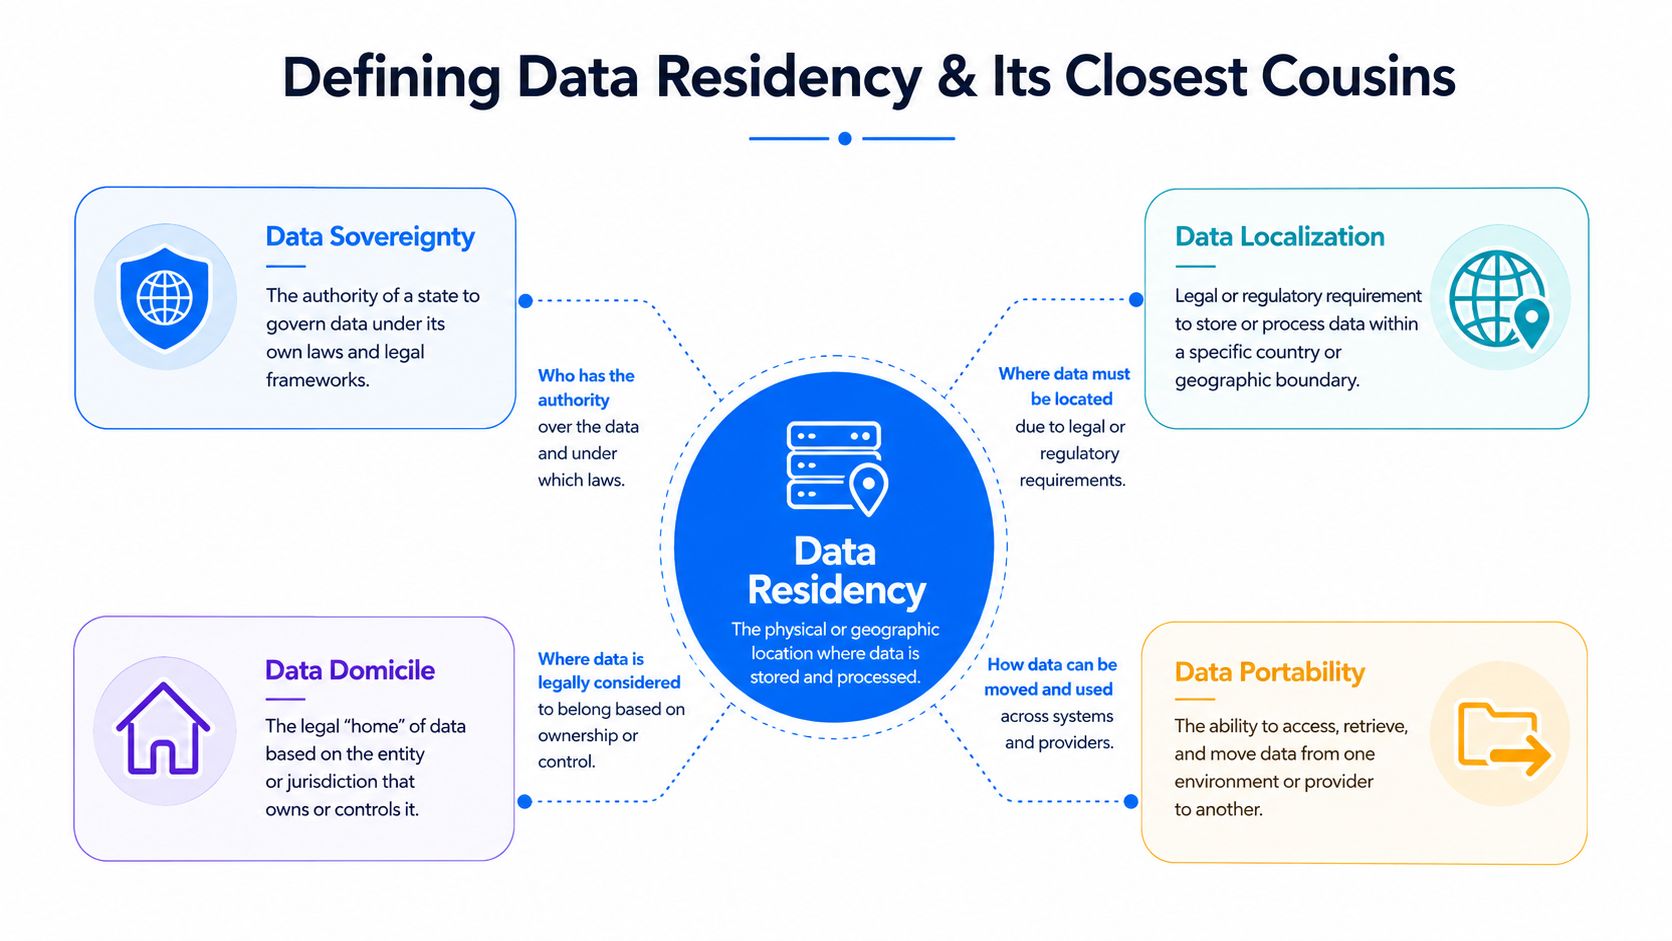
Il modo più chiaro per distinguere i termini è un'analogia postale. La residenza dei dati è l'indirizzo sulla busta, la sovranità dei dati indica le leggi di quale giurisdizione regolano la posta, la localizzazione dei dati è la regola secondo cui la posta deve essere smistata o conservata all'interno del paese, e il trattamento dei dati riguarda chi apre la lettera e la legge. Questa distinzione conta perché due regimi possono condividere la stessa regione di archiviazione pur imponendo regole di trasferimento completamente diverse.
La residenza indica dove i dati si trovano e si spostano
In termini pratici, la residenza riguarda dove i dati vengono archiviati, elaborati e copiati. Questo perimetro è più ampio di quanto molti team pensino, perché anche i dati cifrati possono creare un'esposizione in termini di residenza quando chiavi, amministratori o percorsi di supporto si trovano al di fuori della regione richiesta. L'etichetta della regione di un database non risolve il problema da sola.
L'esempio dell'UE è il primo che si incontra. Secondo il GDPR, i dati personali possono lasciare lo Spazio economico europeo solo se la destinazione beneficia di una decisione di adeguatezza o se l'esportatore adotta garanzie come le clausole contrattuali standard o le norme vincolanti d'impresa, e in assenza di adeguatezza è richiesta anche una valutazione d'impatto sul trasferimento. Non si tratta di una vaga preferenza per la localizzazione, ma di un meccanismo di trasferimento concreto legato alle scelte di progettazione transfrontaliera. I requisiti di trasferimento del GDPR spiegati
Perché i confini contano nei sistemi reali
La trappola concettuale è presumere che “archiviato nel paese” equivalga a “residente nel paese”. Non è così. Elaborazione, backup, logging, disaster recovery e accesso del fornitore possono tutti creare un problema di residenza anche quando i dati, in senso stretto, non si spostano lontano.
L'etichetta della regione aiuta, ma non governa il resto del ciclo di vita.
Ecco perché il modello mentale più utile è giurisdizione più control plane. Quando avvocati, auditor e ingegneri usano le stesse parole in modo diverso, i sistemi derivano. Un vocabolario rigoroso mantiene onesta l'architettura e impedisce che le dichiarazioni dei fornitori sembrino migliori di quanto siano.
I principali regimi normativi che incontrerete davvero
I regimi più rilevanti nelle revisioni architetturali rientrano in due categorie: localizzazione assoluta e trasferimento condizionato. La localizzazione assoluta stabilisce che il database stesso deve restare nel paese. Il trasferimento condizionato consente ai dati di spostarsi, ma solo sulla base di specifici meccanismi giuridici e di garanzie documentate.
I regimi che determinano la progettazione
La Russia è l'esempio più rigido tra quelli considerati qui. La norma citata per gli operatori di dati personali stabilisce che devono localizzare i propri database nella Federazione Russa. Si tratta di un vincolo sull'architettura di archiviazione con implicazioni immediate per replica, disaster recovery e collocazione dei backup. Panoramica sulla localizzazione in Russia
L'India è diversa. Il suo regime Digital Personal Data Protection si applica alle organizzazioni che trattano dati personali digitali di persone in India, indipendentemente da dove abbia sede l'organizzazione, e il calendario di attuazione citato concede alle organizzazioni tempo fino a maggio 2027 per raggiungere la piena conformità, con sanzioni fino a 250 crore di INR. La stessa fonte distingue inoltre i Significant Data Fiduciaries, soggetti a obblighi più stringenti, tra cui un responsabile della privacy dedicato e valutazioni dei rischi. Panoramica dei requisiti del DPDP indiano
L'UE rientra nel campo condizionale. I trasferimenti al di fuori del SEE dipendono dall'adeguatezza o da garanzie riconosciute, oltre a una valutazione d'impatto sul trasferimento quando l'adeguatezza non è disponibile. Questo spinge l'architettura verso un instradamento consapevole della regione, controlli contrattuali e disciplina sugli accessi dei fornitori, invece che verso dichiarazioni generiche di “hosting solo nell'UE”. Regole UE sui trasferimenti
I principali regimi di residenza dei dati in sintesi
Regime | Ambito | Tipo di localizzazione | Meccanismo chiave |
|---|---|---|---|
GDPR (UE) | Dati personali in uscita dal SEE | Condizionale | Adeguatezza, SCC, BCR, valutazione d'impatto sul trasferimento |
DPDP (India) | Dati personali digitali di persone in India | Condizionale con livelli più stringenti | Conformità entro la scadenza del 2027 citata, obblighi maggiori per i Significant Data Fiduciaries |
Russia | Operatori di dati personali | Assoluta | Database localizzati nella Federazione Russa |
Benchmark globale | 62 giurisdizioni con una qualche forma di requisito di localizzazione | Mista | Prevalgono i modelli di trasferimento condizionato, gli obblighi assoluti sono una minoranza |
La tendenza generale conta perché non si tratta più di un problema di nicchia per pochi settori fortemente regolamentati. Per i team di finanza, sanità, telecomunicazioni e servizi pubblici, la residenza è sempre più una questione architetturale predefinita, non un'eccezione.
Per una prospettiva normativa più ampia, la risorsa China network security compliance 2026 è utile perché mostra come residenza, sicurezza e governance siano spesso legate tra loro nella pratica.
Se vi serve una visione complementare sui confini della governance, la guida interna sulla compliance per la sovranità dei dati di digna si abbina bene alle regole regionali descritte sopra.
Perché la compliance si rompe sulle copie, non sul sistema primario
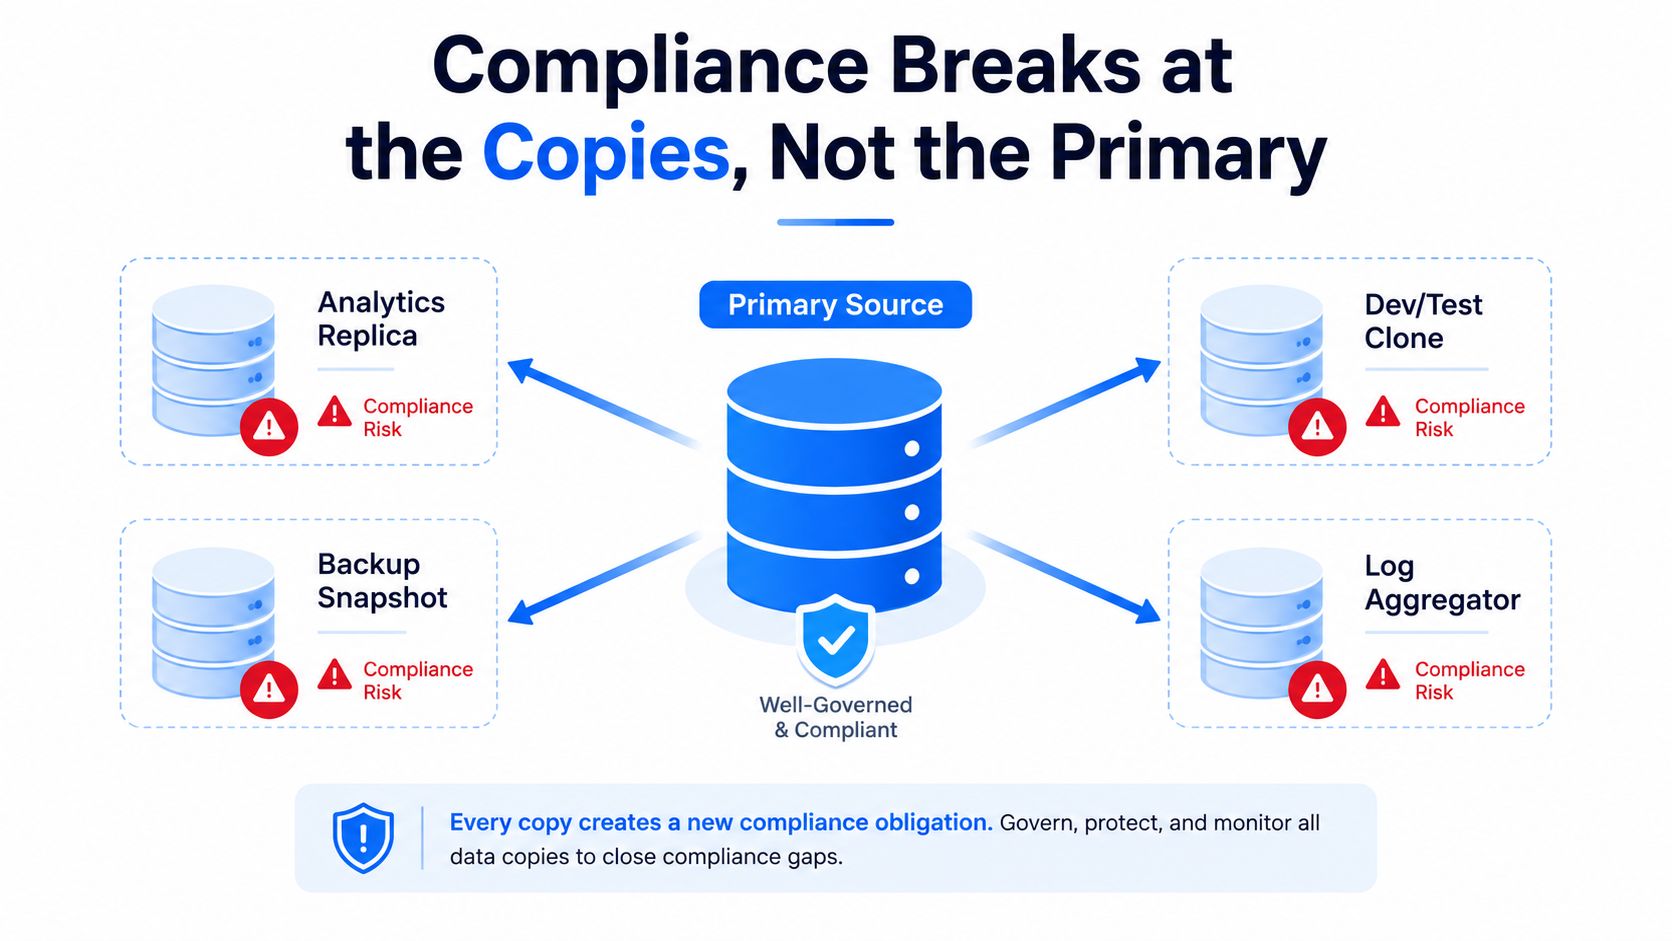
La maggior parte delle violazioni della residenza inizia dai dati secondari, non dalla fonte di verità. La tabella primaria resta dove deve stare, poi un job di analytics crea un caricamento nel warehouse, un tecnico del supporto salva un pacchetto di log o un'esportazione da notebook finisce in un luogo che la policy non ha mai approvato.
Le copie da censire
L'inventario deve includere repliche, caricamenti nel warehouse, viste materializzate, log, trace, snapshot, archivi, download CSV, esportazioni in fogli di calcolo, estratti da notebook e file ad hoc. L'elenco sembra noioso perché lo è, ma è lì che si verificano le violazioni dei confini. Un dataset master consentito può comunque diventare non conforme nel momento in cui una copia derivata attraversa un confine.
La risposta pratica è una matrice di residenza dei dati. Registra il sistema primario, le copie derivate e operative, la giurisdizione di ciascuna e, dove pertinente, la base giuridica del trasferimento. Una volta costruita questa matrice, le lacune diventano evidenti. Il vincolo di regione da solo sembra ordinato finché non vi accorgete che la destinazione di backup, l'allegato del supporto o l'estratto per la BI non hanno mai ereditato lo stesso vincolo.
Il tipo di guasto che gli ingegneri vedono davvero
Basta un'esportazione. Un singolo CSV inviato in una regione non consentita può trasformare una situazione di archiviazione pulita in una violazione della residenza, perché di fatto i dati regolamentati hanno lasciato il confine giurisdizionale, anche se il database sorgente è rimasto al suo posto. Ecco perché ciò che va sorvegliato è la copia, non solo il sistema sorgente.
Abitudine operativa: trattate ogni pipeline che crea una nuova copia come un punto di controllo della residenza, non solo come un'attività di data engineering.
La mentalità di chi è pronto per l'audit consiste nel chiedersi dove viene creata la copia, dove viene archiviata, chi può leggerla e se può essere cancellata su richiesta. Se non conoscete queste quattro cose, non conoscete ancora lo stato di residenza.
On-premises, private cloud e public cloud vincolato a una regione
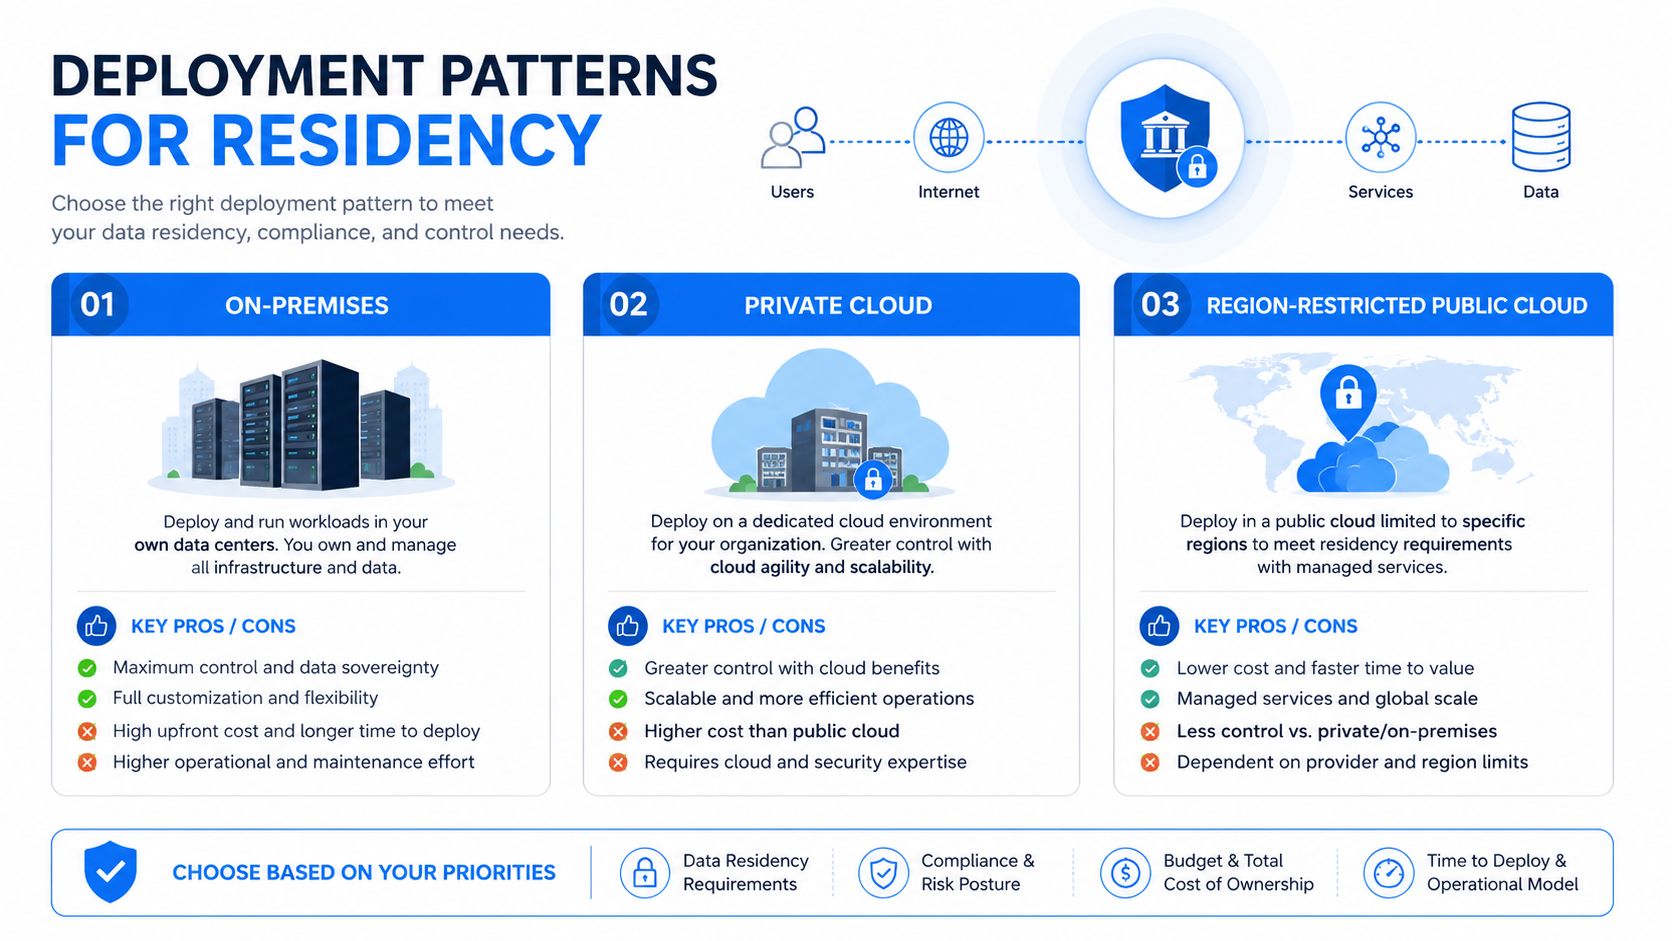
La scelta del deployment cambia la dimensione del problema, non la sua esistenza. L'on-premises offre il confine fisico e logico più solido, il private cloud sposta quel confine verso un operatore controllato e il public cloud vincolato a una regione offre scalabilità con un elenco più lungo di avvertenze sulla residenza.
I compromessi che contano
L'on-premises funziona quando i dati sono altamente sensibili o quando la posizione regolamentare è più facile da difendere con un controllo diretto. Lo svantaggio è evidente: vi fate carico di una parte maggiore del lavoro operativo, dalle patch alla pianificazione della capacità fino ai test di resilienza.
Il private cloud di solito ha senso quando un team regolamentato vuole elasticità senza cedere il controllo dell'ambiente. È una solida via di mezzo, ma solo se svolgete la due diligence sull'operatore, sul modello di supporto e sulla collocazione dei backup e degli accessi amministrativi.
Il public cloud vincolato a una regione è la via più rapida per scalare, ma è anche il contesto in cui i team sottovalutano più spesso le fuoriuscite dal perimetro di residenza. Accesso del supporto, telemetria, failover e comportamento dei servizi gestiti possono estendersi oltre il confine previsto se non sono vincolati in modo esplicito.
Dove si colloca il modello senza accesso del fornitore
Il modello senza accesso del fornitore sta guadagnando interesse perché riduce la superficie di fiducia. Gli strumenti vengono eseguiti all'interno dell'ambiente del cliente e il fornitore non vede i dati di produzione. Questo schema si abbina naturalmente all'esecuzione in-database, che mantiene le analisi vicine al dataset governato ed evita spostamenti inutili.
digna rientra in questo stile di deployment come una delle opzioni. Esegue le analisi all'interno dell'ambiente del cliente, supporta il deployment private cloud o on-premises ed è progettata in modo che il fornitore non acceda ai dataset di produzione. Questo non elimina il lavoro sulla residenza, ma riduce una delle parti più difficili della catena di fiducia.
La decisione spesso si riduce a scegliere se il vostro team preferisce un problema di sicurezza o un problema operativo. Potete averli entrambi. La maggior parte delle organizzazioni sceglie semplicemente quello che è più attrezzata a gestire.
I controlli tecnici che garantiscono davvero la residenza
Il linguaggio delle policy, da solo, non tiene i dati entro i confini. L'architettura deve fare in modo che il percorso corretto sia quello predefinito, e ciò significa controllare l'ingestione, le chiavi, gli accessi e l'impronta regionale di ogni servizio operativo che ruota attorno ai dati.
Quattro livelli di controllo che reggono
Il primo livello è l'instradamento basato sulla geografia. Instradate i dati al momento dell'ingestione, così che i dati personali di origine UE finiscano fin dall'inizio nel percorso UE, invece di essere acquisiti a livello globale e sistemati in seguito. Questa singola scelta progettuale elimina gran parte del rischio a valle, perché la regione sbagliata non diventa mai la zona di destinazione predefinita.
Il secondo livello è la gestione delle chiavi per giurisdizione. La cifratura non risolve la residenza se le chiavi si trovano altrove, perché il confine di sicurezza dipende comunque da chi può accedere ai dati. Conservate le chiavi nella stessa giurisdizione dei dati protetti quando il regime lo prevede, e documentatelo chiaramente.
Il terzo livello sono i controlli di accesso vincolati alla regione del tenant o a ruoli amministrativi onshore. I workflow di supporto, SRE e amministrazione della piattaforma possono diventare falle nella residenza anche quando l'archiviazione sembra conforme. Limitate rigorosamente questi permessi e trattate i percorsi di eccezione come eventi controllati e verificabili.
Il quarto livello sono audit e monitoraggio. Gli auditor vogliono mappe delle regioni, meccanismi di trasferimento ed evidenze sulla localizzazione delle chiavi. Vogliono anche vedere che i percorsi di archiviazione, calcolo, logging, backup e disaster recovery siano tutti vincolati, non solo il database primario.
Regola pratica: l'architettura di residenza è un problema di control plane, non un'impostazione del bucket.
Una progettazione solida di solito combina instradamento, chiavi, IAM ed evidenze documentate in un unico modello operativo. Se anche uno solo di questi livelli è vago, la posizione di compliance diventa rapidamente fragile.
Pratiche di observability che riducono nel tempo il rischio di residenza
La deriva della residenza di solito arriva senza preavviso. Una nuova pipeline esporta nella regione sbagliata, una modifica allo schema aggiunge una colonna sensibile a una replica transfrontaliera, oppure un feed rallenta e nasconde un disallineamento dei backup finché qualcuno non chiede le evidenze.
Cosa monitorare in modo continuo
Uno stack di observability utile sorveglia tre categorie di cambiamento. L'anomaly detection fa emergere comportamenti inattesi nei metadati di residenza o negli spostamenti delle pipeline, senza costringervi a mantenere a mano ogni regola. Lo schema tracking intercetta colonne aggiunte, colonne rimosse e cambi di tipo prima che amplino silenziosamente l'impronta dei dati sensibili. Il monitoraggio della tempestività confronta gli schemi di consegna attesi con gli arrivi effettivi, così che un feed bloccato non nasconda un passaggio regionale fallito.
È qui che conta anche l'esecuzione in-database. Quando le analisi vengono eseguite all'interno dell'ambiente del cliente, potete esaminare segnali di anomalia, variazioni dei trend, deriva dello schema e tempi di arrivo senza inviare dati di produzione grezzi a uno spazio di lavoro del fornitore. Questo riduce gli spostamenti e mantiene il ciclo di monitoraggio allineato ai vincoli di residenza.
Lo schema pratico è la prova continua, non la sorpresa periodica. Se lo stack è in grado di dirvi che una copia è comparsa in una regione non consentita, che una modifica allo schema ha introdotto un campo soggetto a restrizioni o che un feed specifico di una regione è in ritardo, state intercettando la deriva mentre è ancora correggibile.
Per i team che cercano un'analisi più operativa degli schemi di monitoraggio, la guida alle best practice di observability è un utile complemento.
Vale la pena consultare anche le indicazioni di IT Cloud Global LLC se volete un'altra prospettiva su come vengono di solito affrontati i controlli di sicurezza e compliance negli ambienti cloud.
Una checklist pratica di compliance e cosa tenere d'occhio
Un programma di residenza efficace parte da una breve checklist e da alcuni alert ad alto valore informativo.
Copertura della matrice di residenza: mappate sistemi primari, copie, giurisdizioni e base dei trasferimenti.
Instradamento obbligatorio all'ingestione: inviate i dati nella regione corretta prima ancora che vengano archiviati.
Audit trail per giurisdizione: conservate le evidenze su localizzazione delle chiavi, accessi amministrativi e meccanismi di trasferimento.
Individuazione e mappatura delle copie: tracciate in modo continuo repliche, esportazioni, log, snapshot e backup.
I segnali di monitoraggio più importanti sono la replica inattesa tra regioni, le modifiche allo schema che introducono colonne sensibili, l'anomaly detection sui metadati di residenza e il monitoraggio della tempestività che individua un failover o un feed in ritardo diretto nel posto sbagliato. Sono questi i segnali che trasformano la residenza da policy sulla carta a controllo operativo.
La direzione è chiara. Sempre più regimi sono condizionali anziché assoluti, sempre più obblighi coprono l'intero ciclo di vita e sempre più team avranno bisogno di strumenti di observability che dimostrino di non essere essi stessi la causa della falla nella residenza.
Se state costruendo o rafforzando un programma di residenza, partite dall'inventario delle copie, poi consolidate instradamento, chiavi e accessi, e infine aggiungete il rilevamento continuo della deriva. Se volete un modo pratico per mantenere visibili questi controlli all'interno del vostro ambiente, valutate come digna si inserisce nei workflow di monitoraggio private cloud o on-premises e usatela per verificare se la vostra attuale posizione sulla residenza regge a un audit.
Per il livello di monitoraggio continuo descritto sopra, con segnali di anomalia, schema e tempestività calcolati all'interno del vostro ambiente invece che in uno spazio di lavoro del fornitore, leggete la data platform observability con digna.
Domande frequenti
Cosa sono i requisiti di residenza dei dati?
I requisiti di residenza dei dati regolano dove i dati vengono archiviati, elaborati e copiati, non solo dove si trova il database primario. L'articolo li tratta come un problema di controllo dell'intero ciclo di vita che riguarda repliche, backup, log, esportazioni e accessi del supporto, perché anche i dati cifrati possono creare un'esposizione quando chiavi, amministratori o percorsi di supporto si trovano al di fuori della regione richiesta.
Qual è la differenza tra residenza, sovranità e localizzazione dei dati?
Con un'analogia postale, la residenza dei dati è l'indirizzo sulla busta, la sovranità dei dati indica le leggi di quale giurisdizione regolano la posta e la localizzazione dei dati è la regola secondo cui la posta deve essere smistata o conservata all'interno del paese. Due regimi possono quindi condividere una regione di archiviazione pur imponendo regole di trasferimento completamente diverse.
Quanti paesi hanno leggi sulla localizzazione dei dati?
Secondo l'Information Technology and Innovation Foundation, le giurisdizioni con una qualche forma di requisito di localizzazione dei dati sono passate da 35 nel 2017 a 62 nel 2026. Solo 18 di queste impongono obblighi assoluti di permanenza nel paese, mentre 44 adottano modelli condizionali che consentono trasferimenti transfrontalieri sulla base di meccanismi giuridici definiti.
Perché si verificano di solito le violazioni della residenza dei dati?
La maggior parte delle violazioni della residenza inizia dalle copie secondarie e non dalla tabella primaria. Repliche, caricamenti nel warehouse, log, snapshot, download CSV ed estratti da notebook possono attraversare un confine senza che nessuno se ne accorga, e basta un singolo CSV inviato in una regione non consentita per compromettere la compliance. Una matrice di residenza dei dati che mappa ogni copia fa emergere queste lacune.
Quali controlli tecnici garantiscono la residenza dei dati?
Nella pratica reggono quattro livelli di controllo: instradamento basato sulla geografia al momento dell'ingestione, gestione delle chiavi per giurisdizione, controlli di accesso vincolati alla regione del tenant o a ruoli amministrativi onshore, e audit e monitoraggio. Insieme rendono il percorso conforme quello predefinito e forniscono agli auditor mappe delle regioni, meccanismi di trasferimento ed evidenze sulla localizzazione delle chiavi.


