10 strumenti di validazione dei big data a confronto
|
10
min di lettura

I migliori strumenti di validazione dei big data non sono quelli con l'elenco di funzionalità più lungo. Una piattaforma può offrire profiling, alert, lineage e decine di connettori e lasciare comunque un team finance nell'impossibilità di dimostrare se una regola critica sulle transazioni è stata eseguita, dove è stato eseguito un controllo fallito o chi è responsabile dell'eccezione.
La validazione su larga scala copre problemi diversi. Le regole di business a livello di record verificano se valori e relazioni hanno senso. Il rilevamento statistico delle anomalie individua distribuzioni insolite. Il monitoraggio della freshness intercetta caricamenti in ritardo o mancanti. Lo schema tracking rileva le modifiche strutturali. Il test delle migrazioni confronta gli output tra sistemi, mentre lineage e monitoraggio della salute della piattaforma spiegano l'impatto e il contesto operativo. Questi controlli si sovrappongono, ma non sono intercambiabili. Questa distinzione è centrale per capire perché il validation testing è importante.
Questo confronto valuta dieci strumenti in base a perimetro della validazione, modello di esecuzione, deployment, responsabilità operativa, impegno di implementazione, governance, trasparenza dei prezzi e adeguatezza ai casi d'uso. Tratta inoltre i test basati su regole e l'osservabilità automatizzata come approcci complementari anziché concorrenti. digna è un'opzione rilevante per i team che necessitano di validazione e osservabilità in-database all'interno della propria infrastruttura, ma non è la soluzione vincente per ogni patrimonio di dati.
Indice
1. Data Validation
Il ruolo operativo di digna
Punti di forza e compromessi
2. Great Expectations, GX Cloud e open source
3. Soda, Soda Core e Soda Cloud
4. Monte Carlo
5. Anomalo
6. Bigeye
7. Datafold
8. AWS Deequ
9. Acceldata
10. Talend Data Quality, ora parte di Qlik Talend Cloud e Talend Data Fabric
Confronto dei 10 migliori strumenti di validazione dei big data
Scegliete lo strumento in base al guasto da prevenire
1. Data Validation
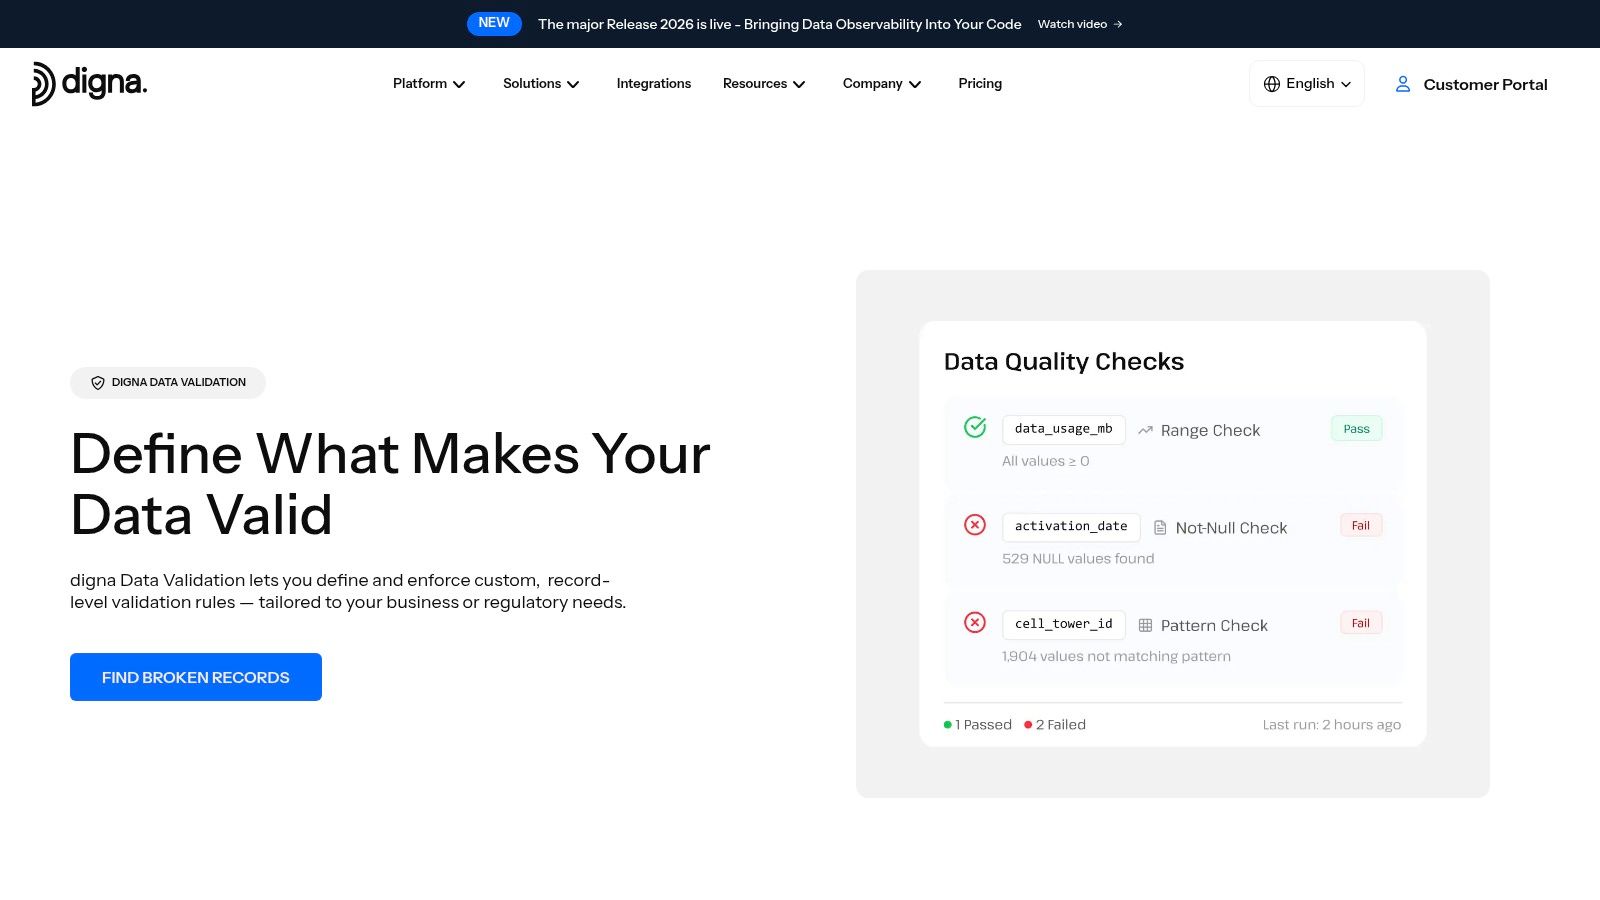
Il modulo Data Validation di digna è pensato per il problema che i punteggi di anomalia da soli non possono risolvere: dimostrare che i singoli record rispettano una logica di business esplicita. I team possono definire controlli su valori esatti, soglie, intervalli, gestione dei null, liste di riferimento e coerenza tra colonne, per poi usare i risultati a supporto di analytics, reporting, workflow operativi e verifiche regolamentari. La distinzione è importante perché un dataset può seguire un andamento statistico consueto e violare comunque una regola di business critica.
Il ruolo operativo di digna
digna esegue la validazione e il calcolo delle metriche all'interno dei database del cliente, invece di spostare i dati di produzione in un ambiente di elaborazione esterno. Funziona nel cloud, nel VPC o nel data center del cliente, il che rende il modello di deployment rilevante per le organizzazioni con requisiti stringenti di residenza dei dati, accesso o governance. La documentazione di prodotto descrive l'esecuzione su database come Teradata, Snowflake, Databricks e PostgreSQL, con risultati pass/fail registrati e audit trail.
Il modulo collega inoltre i fallimenti a livello di record con il rilevamento delle anomalie basato sull'AI, il monitoraggio della tempestività e lo schema tracking. Questa correlazione può essere più utile di un alert isolato. Una regola fallita accompagnata da un caricamento in ritardo o da una recente modifica strutturale offre a chi indaga un punto di partenza più solido rispetto a una regola fallita senza contesto.
Regola pratica: scegliete digna quando le evidenze alla base di un controllo fallito contano quanto l'alert stesso.
Punti di forza e compromessi
Esecuzione in-database: i dati di produzione restano dove sono, riducendo lo spostamento dei dati e allineando la validazione ai requisiti di deployment privato.
Controlli pronti per l'audit: i risultati a livello di riga forniscono evidenze per regole di business, gestione delle eccezioni e verifiche di compliance.
Incidenti correlati: anomalie, ritardi di consegna e modifiche allo schema possono essere analizzati insieme ai fallimenti di validazione.
Espansione modulare: i team possono partire dalle tabelle prioritarie e aggiungere moduli di monitoraggio man mano che la copertura cresce.
Il compromesso riguarda la responsabilità dell'implementazione. digna richiede deployment e integrazione con i database del cliente, quindi può comportare più lavoro infrastrutturale rispetto a un servizio esclusivamente SaaS. Anche la scrittura e la manutenzione delle regole restano necessarie, e il prezzo per tabella attiva implica che costi e impegno operativo possono crescere con l'aumentare della copertura. I team che lo valutano dovrebbero definire ownership delle tabelle, responsabili delle regole, scadenza delle eccezioni e livelli di servizio per la remediation prima di un rollout esteso.
Per un approfondimento sui modelli di implementazione, leggete la guida di digna a regole di data validation, controlli e qualità dei dati continua. Visitate la pagina prodotto di digna Data Validation per i dettagli aggiornati su deployment e licenze.
2. Great Expectations, GX Cloud e open source
Great Expectations è particolarmente adatto quando un team vuole una validazione dichiarativa basata su regole con fondamenta open source. Il suo modello di Expectations consente agli ingegneri di definire asserzioni su dataset, colonne, distribuzioni e valori, per poi eseguire queste suite su warehouse SQL, data lake, file o dataframe. La separazione tra scrittura dei test e gestione delle esecuzioni è utile per i team che vogliono controlli sottoposti a code review ma hanno anche bisogno di una vista operativa condivisa.
GX open source è la scelta migliore per i team a proprio agio nel mantenere workflow basati su Python, repository e infrastruttura di esecuzione. GX Cloud aggiunge collaborazione in hosting, storico delle validazioni, alerting e workflow di governance. Il prodotto diventa così non tanto una singola scelta di deployment quanto un percorso dai test code-first verso operazioni gestite.
Il limite principale è l'impegno necessario per la copertura. Un ricco catalogo di expectation non elimina la necessità di decidere quali regole siano critiche per il business, come funzionino le eccezioni e dove vengano eseguite le suite in produzione. La scrittura delle regole può diventare onerosa quando un patrimonio di dati esteso richiede una copertura esplicita su molte tabelle. GX inoltre non è principalmente una piattaforma di osservabilità automatizzata, quindi i team che cercano apprendimento di baseline, intelligence sulla freshness o un'ampia correlazione degli incidenti potrebbero aver bisogno di funzionalità complementari.
Per un contesto pratico sul panorama open source della qualità dei dati, confrontate il framework con la rassegna di digna sulle funzionalità degli strumenti open source per la qualità dei dati. Verificate le opzioni di prodotto attuali su Great Expectations, soprattutto se prezzi, limiti dell'hosting o packaging cloud influenzeranno l'acquisto.
3. Soda, Soda Core e Soda Cloud
Soda separa il motore di esecuzione dal control plane operativo. Soda Core e Soda Library consentono agli sviluppatori di esprimere i controlli in SodaCL, una sintassi basata su YAML pensata per l'integrazione nelle pipeline. Soda Cloud aggiunge un'interfaccia condivisa per risultati, alert, trend, accessi basati sui ruoli e triage.
Questa suddivisione è adatta ai team che vogliono la validazione vicina al warehouse, offrendo al contempo ad analisti e data owner un'interfaccia cloud per la revisione. Le integrazioni di Soda con piattaforme come Snowflake e Databricks, insieme ai collegamenti CI/CD, supportano controlli eseguiti come parte dei workflow di delivery, e non solo come scansioni pianificate da dashboard.
La distinzione utile è l'accessibilità. YAML può abbassare la barriera d'ingresso per gli ingegneri che non vogliono ogni controllo incorporato nel codice applicativo, mentre il profiling e i suggerimenti automatici possono aiutare i team a stabilire una baseline iniziale di qualità. Il prodotto richiede comunque decisioni su severità, ownership ed escalation. Un controllo che viene eseguito correttamente ma non ha un responsabile è solo un evento tecnico, non un controllo operativo.
Il luogo di esecuzione conta più della schermata degli alert. Un'interfaccia cloud curata non significa automaticamente che i dati di produzione abbiano lasciato il warehouse.
Il caso d'uso più forte di Soda è un programma di qualità incentrato sul warehouse che combina controlli scritti dagli sviluppatori con un triage collaborativo. Il suo limite è il packaging. Alcune funzionalità avanzate sono disponibili solo nello SKU Cloud e i prezzi non sono pubblicati, quindi gli acquirenti devono verificare direttamente i confini attuali delle funzionalità e le ipotesi dei preventivi. I team che lo confrontano con digna dovrebbero chiarire se hanno bisogno di un control plane SaaS, di un'installazione privata o di un monitoraggio correlato più ampio. La piattaforma Soda fornisce il perimetro di prodotto aggiornato, i dettagli di deployment e le informazioni commerciali. Per alternative orientate alla validazione e all'osservabilità in loco, leggete le alternative a Soda di digna.
4. Monte Carlo
Monte Carlo affronta un tipo di guasto diverso rispetto a una libreria di regole. La sua proposta centrale è la data observability su freshness, volume, schema, lineage e BI, supportata da monitor basati sul machine learning e da workflow di gestione degli incidenti. Questo lo rende una scelta naturale per i team di dati più grandi che devono identificare comportamenti inattesi senza scrivere una regola per ogni tabella e metrica.
Le funzionalità di lineage e di analisi d'impatto della piattaforma sono particolarmente importanti durante le indagini. Un problema di freshness diventa più gestibile quando un team può vedere gli asset, le dashboard o i workflow a valle interessati. Le funzionalità di triage degli incidenti e di runbook spostano inoltre il prodotto verso la risposta operativa, anziché la sola scrittura di test.
Monte Carlo viene spesso valutato attraverso canali di procurement enterprise, tra cui AWS Marketplace. Il suo modello di consumo basato su crediti può semplificare l'acquisto per le organizzazioni che già utilizzano quel canale, ma introduce questioni di costo variabile. I team dovrebbero modellare come asset monitorati, frequenza delle scansioni, conservazione dello storico e volume degli incidenti influenzino i consumi, invece di considerare il percorso marketplace una risposta completa sui prezzi.
Il limite è la copertura deterministica. L'osservabilità può rilevare che una distribuzione è cambiata o che un caricamento è arrivato in ritardo, ma non sostituisce una regola esplicita per una condizione rilevante dal punto di vista legale o operativo. Un'implementazione solida affianca i monitor automatici di Monte Carlo a test mirati di cui è responsabile il team di dominio competente.
Verificate il perimetro attuale e le opzioni di acquisto su Monte Carlo. Gli acquirenti dovrebbero richiedere un modello di costo basato sul patrimonio effettivamente monitorato, quindi confrontare la risposta con strumenti che eseguono i controlli nella propria infrastruttura. Per una prospettiva di prodotto diversa, leggete l'analisi di digna sulle alternative a Monte Carlo.
5. Anomalo
Anomalo è pensato per i team che vogliono un rilevamento automatico delle anomalie per ottenere rapidamente un'ampia copertura. Analizza il comportamento di tabelle, colonne, metriche e distribuzioni, e supporta poi una validazione configurabile a livello di tabella, colonna e riga. Questa combinazione risolve una tensione comune nelle implementazioni: i team hanno bisogno di controlli espliciti, ma spesso non possono scrivere a mano ogni baseline utile prima che il monitoraggio inizi.
L'interfaccia punta sulla revisione su larga scala. Le connessioni native a warehouse moderni e a cataloghi come Alation aiutano a mostrare lo stato di salute dei dati dove consumatori e steward già lavorano. Il rilevamento automatico può far emergere variazioni insolite che una soglia scelta manualmente non coglierebbe, in particolare in ambienti warehouse estesi dove la baseline rilevante non è evidente in fase di progettazione.
Il compromesso è la calibrazione degli alert. I monitor basati sul machine learning richiedono comunque policy di triage, decisioni di soppressione e ownership. Se i team considerano ogni deviazione un difetto, generano rumore. Se sopprimono in modo troppo aggressivo, il sistema perde copertura. Il modello operativo corretto classifica i problemi in base alle conseguenze di business e mantiene controlli deterministici per le condizioni che non devono mai essere ambigue.
La copertura automatizzata riduce l'impegno di scrittura delle regole, ma non elimina la necessità di decisioni di cui qualcuno sia responsabile.
Anomalo è adatto alle organizzazioni che danno priorità a un'osservabilità rapida su grandi patrimoni warehouse e a un workflow visuale per la revisione dei problemi. Può essere meno indicato quando i criteri di selezione principali sono il deployment privato, le evidenze in-database o audit trail rigorosi a livello di record. I prezzi sono gestiti dal team commerciale e non sono pubblicati, quindi gli acquirenti dovrebbero verificare in fase di valutazione il perimetro dei connettori, i confini di accesso ai dati e il supporto alla calibrazione. Consultate l'offerta attuale su Anomalo e confrontate il suo approccio incentrato sulle anomalie con la guida di digna per individuare presto i problemi dei dati con il rilevamento delle anomalie.
6. Bigeye
Bigeye posiziona l'osservabilità come parte di un modello operativo di AI Trust. Il suo monitoraggio copre freshness, volume, schema e distribuzioni, mentre lineage e analisi d'impatto collegano un dataset anomalo ai consumatori a valle. Questa enfasi lo rende rilevante quando i team di governance hanno bisogno di più di una notifica: serve contesto su cosa è cambiato e su quali carichi di lavoro potrebbero essere interessati.
Il punto di forza pratico del prodotto è il triage basato sul lineage. Chi indaga può usare le relazioni a monte e a valle per restringere la ricerca della causa principale, mentre le funzionalità di sicurezza enterprise e un ampio portafoglio di connettori supportano patrimoni eterogenei. Bigeye fornisce inoltre guide e documentazione che possono aiutare i team a standardizzare il rollout, invece di lasciare che ogni dominio inventi il proprio processo di monitoraggio.
Il suo perimetro più ampio è anche un potenziale svantaggio. Un team che cerca una piccola libreria di controlli deterministici potrebbe trovare una piattaforma di AI Trust più grande dell'esigenza immediata. Più funzionalità significano più decisioni su ownership, integrazione, severità degli incidenti e procedure operative. Il team di acquisto dovrebbe separare l'esigenza di osservabilità da quella di controlli di governance dei modelli e verificare quali componenti del prodotto siano necessari.
Bigeye è un buon candidato quando il lineage è centrale per le indagini e l'organizzazione vuole un'implementazione enterprise strutturata. Non è la prima scelta ovvia per una libreria nativa Spark per sviluppatori o per un workflow di diff delle migrazioni. I prezzi non sono pubblicati e l'acquisto passa principalmente da una demo, quindi la valutazione dovrebbe includere confini di deployment, gestione dei dati sensibili e conservazione delle evidenze. Le informazioni aggiornate sul prodotto sono disponibili su Bigeye.
7. Datafold
Datafold risolve in modo eccellente un problema più circoscritto: il confronto a livello di valore e il regression testing. La sua funzionalità Data Diff confronta gli output su grandi dataset, mentre il lineage a livello di colonna collega le modifiche tra warehouse, progetti dbt e asset di BI. Questo lo rende utile prima del merge di una pull request, durante una migrazione del warehouse o quando una trasformazione è stata riscritta e il team deve vedere l'impatto reale sui dati.
Non è la stessa cosa dell'osservabilità continua. Datafold dà il meglio quando c'è una modifica nota e serve la prova che il nuovo risultato coincida con il vecchio, lo migliori o se ne discosti intenzionalmente. Le integrazioni CI rendono questo confronto parte del workflow di sviluppo, dove gli ingegneri possono intercettare le regressioni prima che le incontrino i consumatori in produzione.
Un'opzione di deployment in VPC supporta le organizzazioni che necessitano di esecuzione privata. La questione chiave dell'implementazione è la progettazione del confronto. I team devono definire quali righe, colonne, aggregati, tolleranze ed esclusioni costituiscano un test di parità significativo. Un diff meccanicamente completo può comunque produrre un risultato inutile dal punto di vista operativo se le modifiche approvate dal business non sono rappresentate nel test.
Datafold è adatto ad ambienti ricchi di migrazioni, incentrati su dbt e sensibili alle regressioni. Non sostituisce il monitoraggio della freshness, le baseline delle anomalie o le regole di compliance a livello di record. Il prezzo della piattaforma completa è personalizzato e gestito dal team commerciale, e il progetto open source data-diff è stato dismesso a favore del prodotto cloud, quindi gli acquirenti dovrebbero verificare il percorso commerciale attuale. Scoprite le funzionalità più recenti su Datafold.
8. AWS Deequ
AWS Deequ è una libreria Scala e Apache Spark, non una piattaforma di osservabilità completa. Questa distinzione determina sia la sua attrattiva sia il suo costo operativo. I team di dati che lavorano direttamente nell'ecosistema JVM e Spark possono esprimere vincoli su completezza, unicità, distribuzioni e metriche correlate, per poi eseguirli insieme a job ETL o ELT su larga scala.
Il pattern Metrics Repository di Deequ consente ai team di conservare i profili nel tempo. Questo crea una base per l'analisi dei trend, ma l'esperienza circostante resta responsabilità del cliente. Gli ingegneri devono costruire scheduling, alerting, presentazione dei risultati, workflow di ownership e conservazione degli incidenti, se queste funzioni non sono fornite dalla piattaforma esistente.
La libreria è interessante quando è importante evitare il vendor lock-in e Spark è già l'ambiente di esecuzione. Può essere incorporata in job ETL e workflow CI, ed esistono binding Python della community per i team che necessitano di un'interfaccia Python. La sua flessibilità comporta un requisito di competenze. I team senza una solida conoscenza operativa di Scala o Spark potrebbero dedicare più impegno alla manutenzione del livello di validazione che alla scrittura dei vincoli stessi.
Deequ è un componente da assemblare in un sistema di validazione. Non è un workflow di governance pronto all'uso.
Usate Deequ per test di vincoli nativi Spark quando il controllo ingegneristico e la licenza open source contano più di un'interfaccia integrata. Scegliete invece una piattaforma quando analisti, steward o auditor hanno bisogno di un contesto condiviso sugli incidenti senza sviluppo personalizzato. Il codice e la documentazione aggiornati del progetto sono disponibili nel repository AWS Deequ.
9. Acceldata
Acceldata combina l'affidabilità dei dati con ottimizzazione dei costi e salute della piattaforma. Questo lo rende un candidato per patrimoni complessi in cui i team non vogliono alert di qualità dei dati isolati dal comportamento dei carichi di lavoro, dai segnali di performance e dalle variazioni dei consumi. Il suo perimetro va oltre i controlli sulle righe, fino alle condizioni operative che determinano se le piattaforme dati restano utilizzabili e con costi sotto controllo.
La piattaforma supporta monitor di affidabilità, alert e controlli in stile data contract su stack eterogenei. Le funzionalità di deployment e sicurezza enterprise sono rilevanti per le organizzazioni che operano sia on-premises sia in cloud, soprattutto quando platform engineer e team di governance condividono la responsabilità dei livelli di servizio.
L'ampiezza può essere preziosa, ma amplia anche il perimetro dell'implementazione. Un team che cerca solo controlli sui null, validazione di liste di riferimento o un piccolo insieme di controlli sullo schema potrebbe ritrovarsi a valutare funzionalità che non metterà mai in produzione. Il processo di selezione dovrebbe identificare il guasto che giustifica la piattaforma, quindi verificare se i segnali di costo e di salute saranno gestiti dallo stesso team o da funzioni di piattaforma separate.
Acceldata è adatto a patrimoni in cui qualità, affidabilità ed economia della piattaforma devono essere valutate insieme. I prezzi sono gestiti dal team commerciale e basati su preventivo, quindi gli acquirenti dovrebbero richiedere un dettaglio chiaro di moduli, asset monitorati, deployment e supporto. Il posizionamento attuale del prodotto e i dettagli della piattaforma sono disponibili su Acceldata.
10. Talend Data Quality, ora parte di Qlik Talend Cloud e Talend Data Fabric
Talend Data Quality è l'opzione enterprise consolidata di questo elenco, con funzionalità che spaziano da profiling, cleansing, standardizzazione, arricchimento e stewardship fino al trust scoring. Ha più senso per le organizzazioni che stanno già standardizzando su Qlik o Talend per integrazione, governance e gestione dei dati, perché il valore deriva tanto dall'ecosistema circostante quanto dalle singole regole di validazione.
Il set di strumenti supporta regole di qualità e profiling insieme a workflow di stewardship. I piani in abbonamento sono disponibili tramite Qlik Talend Cloud, mentre opzioni on-premises e gestite dal cliente esistono all'interno della più ampia famiglia Data Fabric. Questa gamma può aiutare le organizzazioni con requisiti di deployment misti, ma rende anche importante verificare il packaging del prodotto.
Talend non è tanto una libreria leggera per sviluppatori quanto uno strumento per istituzionalizzare i workflow di qualità tra i diversi ruoli. I data steward possono partecipare alla remediation, mentre i team di integrazione collegano i processi di qualità al più ampio movimento dei dati e alla governance. Il compromesso è la complessità. I prezzi di listino non sono pubblicati, livelli e SKU possono essere difficili da confrontare e il rebranding sotto Qlik implica che gli acquirenti debbano verificare quali funzionalità appartengono a quale pacchetto attuale.
Talend è particolarmente adatto alle aziende che hanno già investito nell'ecosistema Qlik e Talend. Può essere eccessivo per un diff mirato di una migrazione, una libreria di vincoli Spark o un rollout limitato alle anomalie. Verificate packaging, deployment, supporto e licenze attuali tramite Qlik Talend Data Fabric.
Confronto dei 10 migliori strumenti di validazione dei big data
Strumento | Funzionalità principali | UX e qualità (★) | Punti di forza distintivi (✨ / 🏆) | Pubblico di riferimento (👥) | Prezzo / valore (💰) |
|---|---|---|---|---|---|
Data Validation (digna) | Validazione in‑database a livello di record, integrata con anomalie, tempestività e schema | ★★★★★ UI condivisa, livello enterprise | ✨ Funziona nell'infrastruttura del cliente; incidenti correlati → RCA più rapida 🏆 | 👥 Aziende regolamentate (finanza, sanità, telco, settore pubblico) | 💰 Licenza modulare + per tabella attiva; trasparente, stabile rispetto all'utilizzo |
Great Expectations (GX) | Suite di expectation dichiarative, profiling, supporto multi‑backend | ★★★★ UX code‑first; GX Cloud aggiunge una UI gestita | ✨ Ricca libreria di expectation, documentazione e lineage dei test 🏆 | 👥 Data engineer, team code‑first | 💰 OSS gratuito; GX Cloud con piani a pagamento (variabili) |
Soda (Core + Cloud) | Controlli YAML (SodaCL), profiling, UI cloud, esecuzione vicino ai dati | ★★★★ Adatto agli sviluppatori; Cloud per triage e RBAC | ✨ YAML + facile integrazione nelle pipeline, suggerimenti automatici 🏆 | 👥 Team di sviluppo che vogliono CI/CD + UX cloud | 💰 Core OSS gratuito; Cloud = commerciale/preventivo |
Monte Carlo | Monitor ML (freshness, volume, schema), lineage, monitoraggio BI | ★★★★★ Triage degli incidenti e runbook maturi | ✨ Monitoraggio ML enterprise + ricchi workflow di triage 🏆 | 👥 Grandi organizzazioni con data ops mature | 💰 Vendita diretta; modello a crediti/consumo (variabile) |
Anomalo | Rilevamento anomalie con AI, validazioni dichiarative, integrazioni con cataloghi | ★★★★ Copertura rapida; UI per la revisione dei problemi | ✨ Controlli automatici per una copertura rapida 🏆 | 👥 Team che necessitano di rilevamento rapido delle anomalie su larga scala | 💰 Prezzi enterprise tramite team commerciale |
Bigeye | Monitoraggio automatico (freshness/volume/schema), lineage approfondito | ★★★★ Triage basato sul lineage e UX di governance | ✨ Lineage + osservabilità per la governance 🏆 | 👥 Team focalizzati su governance/compliance | 💰 Basato su demo/preventivo (enterprise) |
Datafold | Data diffing a livello di valore, regression testing in CI, lineage delle colonne | ★★★★ Ottima UX di validazione pre‑merge | ✨ Data diff + integrazione CI per PR e migrazioni 🏆 | 👥 Team di engineering, workflow dbt e di migrazione | 💰 Vendita diretta; opzione di deployment in VPC |
AWS Deequ (OSS) | Vincoli Spark dichiarativi, repository di metriche, controlli su scala Spark | ★★★ Libreria (nessuna UI integrata), codice/nativo | ✨ Gratuito, nativo Spark su larga scala per team JVM 🏆 | 👥 Big data engineer JVM/Spark | 💰 Open source (gratuito); solo costi di infrastruttura/sviluppo |
Acceldata | Monitor di affidabilità, ottimizzazione dei costi, salute della piattaforma | ★★★★ Dashboard enterprise e strumenti SLO | ✨ Combina qualità dei dati e insight su costi/piattaforma 🏆 | 👥 Aziende complesse e multipiattaforma | 💰 Prezzi enterprise su preventivo |
Talend Data Quality (Qlik) | Profiling, cleansing, stewardship, trust scoring | ★★★★ UX matura per governance e stewardship | ✨ Lunga tradizione in qualità dei dati + integrazione 🏆 | 👥 Aziende che standardizzano su Talend/Qlik | 💰 Piani in abbonamento (tramite team commerciale) |
Scegliete lo strumento in base al guasto da prevenire
La scelta dello strumento diventa più chiara quando il team dà un nome al guasto prima di confrontare le funzionalità. Se il rischio principale è un importo non valido, uno stato non consentito, un valore di riferimento mancante o una coppia di campi incoerente, partite dalla validazione deterministica dei record. digna, Great Expectations, Soda, Talend e Deequ supportano tutti controlli basati su regole, ma differiscono per esecuzione, interfacce, deployment e quantità di workflow di contorno che il team deve costruire.
Se la preoccupazione è una variazione inattesa su un patrimonio esteso, date priorità al rilevamento automatico delle anomalie. Monte Carlo, Anomalo, Bigeye, Acceldata e digna affrontano questo problema attraverso il monitoraggio e il contesto comportamentale. La domanda importante non è se uno strumento usa il machine learning. Chiedetevi come i team calibrano gli alert, assegnano i responsabili, spiegano una deviazione e collegano l'evento all'impatto a valle.
I guasti di freshness e di schema richiedono una valutazione a sé. Una suite di regole può dare esito positivo mentre un caricamento arriva in ritardo, oppure una modifica dello schema può essere tecnicamente accettata da un formato di tabella e rompere al contempo un'ipotesi a valle. La documentazione di Apache Iceberg mostra perché l'evoluzione dello schema richiede un tracciamento attivo: i campi possono essere aggiunti, eliminati, aggiornati o rinominati come modifiche ai metadati, e i dati più vecchi possono restare sotto specifiche di partizionamento precedenti. Una modifica strutturalmente valida richiede comunque una registrazione operativa di cosa è cambiato, quando è diventato effettivo e quali consumatori ne dipendono.
Le modifiche a migrazioni e trasformazioni richiedono diffing ed evidenze di regressione, ambito in cui Datafold è più adatto di una piattaforma di osservabilità generica. I team incentrati su Spark potrebbero preferire Deequ perché i controlli vengono eseguiti nello stesso ambiente di elaborazione. Le organizzazioni che necessitano di un triage guidato dal lineage dovrebbero valutare Monte Carlo, Bigeye, Acceldata o Talend in base alla profondità dell'analisi d'impatto e ai ruoli coinvolti nella remediation.
Seguite questa sequenza durante la valutazione:
Definite il guasto: distinguete violazioni dei record, comportamenti anomali, consegne in ritardo, deriva strutturale, discrepanze di migrazione e degrado della piattaforma.
Individuate il luogo di esecuzione: verificate se i controlli vengono eseguiti nel warehouse, nell'ambiente Spark, in un VPC, in un cloud privato, su infrastruttura on-premises o in un servizio controllato dal fornitore.
Assegnate la responsabilità: identificate chi scrive le regole, indaga sugli alert, approva le eccezioni e conferma la remediation.
Verificate le evidenze: richiedete risultati riproducibili, record o metriche interessati, timestamp, contesto di lineage e uno storico delle eccezioni verificabile.
Modellate il costo operativo: confrontate tabelle attive, comportamento delle scansioni, consumo di calcolo, crediti, moduli, supporto e impegno di implementazione, invece di basarvi sul numero di licenze.
Eseguite un pilota rappresentativo: includete una tabella critica, un caricamento in ritardo, una modifica dello schema, una violazione nota di una regola di business e una modifica deliberata a una trasformazione.
La scarsa qualità dei dati è un rischio di business concreto. In un report del 2025 dell'IBM Institute for Business Value, il 43% dei chief operating officer ha indicato i problemi di qualità dei dati come la propria priorità più significativa in ambito dati. Lo stesso report ha rilevato che oltre il 25% delle organizzazioni stimava perdite annue superiori a 5 milioni di USD, mentre il 7% dichiarava perdite di almeno 25 milioni di USD. Si tratta di stime basate su sondaggi, non di una misura contabile universale, ma spiegano perché la validazione dovrebbe essere trattata come un controllo di governance e operativo.
Un sondaggio del 2025 su oltre 200 professionisti dei dati ha rilevato che il 23,4% utilizzava strumenti dedicati di data observability, rispetto al 39,2% che utilizzava test automatizzati e al 22,6% che utilizzava strumenti di validazione come Great Expectations. Questo modello di adozione supporta un approccio a più livelli. I team non dovrebbero scegliere tra regole e osservabilità quando i dati critici richiedono sia vincoli di business espliciti sia un allarme tempestivo sui cambiamenti di comportamento. Misurate copertura in produzione, tempo di indagine, onere dei falsi positivi, responsabilità della remediation ed evidenze conservate.
digna è particolarmente rilevante quando esecuzione in-database, deployment privato, monitoraggio correlato ed espansione modulare sono requisiti centrali. Offre ai team un modo per combinare la validazione a livello di record con controlli su anomalie, tempestività e schema all'interno del proprio ambiente. Per altre priorità, Great Expectations, Soda, Monte Carlo, Anomalo, Bigeye, Datafold, Deequ, Acceldata o Talend potrebbero essere la scelta più diretta.
digna combina la validazione dei record in-database con rilevamento delle anomalie, monitoraggio della tempestività e schema tracking nel vostro cloud, VPC o data center. Se il vostro team ha bisogno di controlli pronti per l'audit senza spostare i dati di produzione, scoprite digna e valutate la piattaforma su un dataset critico rappresentativo.
Se per ora il budget esclude una piattaforma commerciale, la nostra rassegna di strumenti gratuiti di data validation presenta le opzioni open source da mettere alla prova prima di impegnarvi con uno dei prodotti sopra elencati.
Domande frequenti
Che cos'è uno strumento di validazione dei big data?
È un software che verifica se grandi dataset rispettano le regole e il comportamento attesi. Alcuni strumenti controllano regole di business a livello di record come intervalli, null e valori di riferimento, altri rilevano anomalie in freshness, volume o distribuzioni, e alcuni confrontano gli output tra versioni per intercettare le regressioni prima del merge di una modifica.
Quali strumenti di validazione dei big data sono open source?
Great Expectations, Soda Core e AWS Deequ hanno tutti fondamenta open source. Great Expectations usa Expectations dichiarative, Soda Core usa la sintassi SodaCL basata su YAML e Deequ è una libreria Scala e Apache Spark. Ciascuno dispone di un livello a pagamento o gestito, come GX Cloud o Soda Cloud, per risultati condivisi e alerting.
Qual è la differenza tra data validation e data observability?
La validazione dimostra che i singoli record rispettano una logica di business esplicita, come uno stato consentito o un importo valido. L'osservabilità monitora freshness, volume, schema e distribuzioni per individuare comportamenti inattesi senza una regola per ogni tabella. Monte Carlo e Bigeye sono orientati all'osservabilità, mentre Great Expectations e Soda sono orientati alle regole.
La data validation può essere eseguita senza spostare i dati fuori dal warehouse?
Sì. digna calcola le metriche ed esegue la validazione all'interno dei database del cliente, nel suo cloud, VPC o data center, quindi i dati di produzione restano dove sono. Anche Deequ viene eseguito insieme ai job Spark dove i dati già risiedono, mentre diverse piattaforme SaaS elaborano i risultati in un ambiente ospitato dal fornitore.
Come scegliere lo strumento di validazione dei big data giusto?
Date un nome al guasto da prevenire prima di confrontare le funzionalità. Valori non validi e relazioni tra campi compromesse richiedono una validazione deterministica dei record, variazioni inattese di volume o distribuzione richiedono il rilevamento delle anomalie, e le modifiche rischiose al codice richiedono un diffing a livello di valore come Datafold prima del merge di una pull request.


