Processo di monitoraggio dei KPI: guida completa passo per passo
|
6
min di lettura

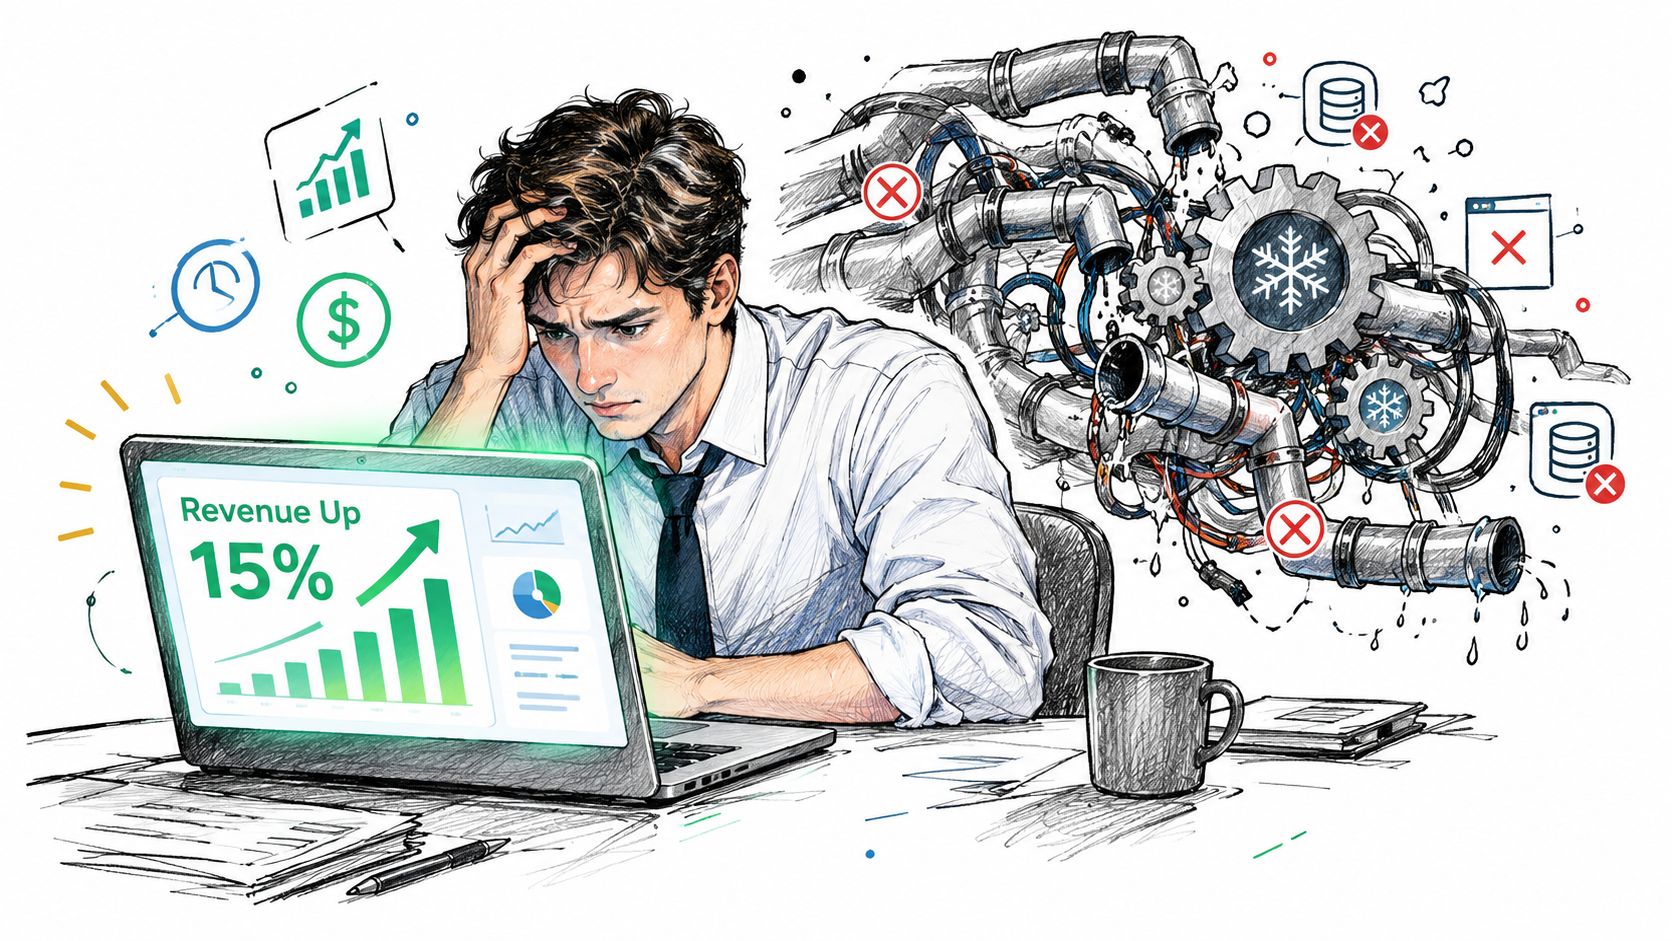
Alle 9 del mattino, uno stakeholder chiama perché la dashboard dei ricavi segna +15%. Il team festeggia per un attimo, poi qualcuno controlla il feed delle transazioni e scopre che la pipeline ha caricato in ritardo e ha omesso gli ultimi due giorni. Il KPI non rivelava performance migliori. Rifletteva dati incompleti.
Ecco perché un processo di monitoraggio dei KPI affidabile deve monitorare più dei valori delle metriche. Deve stabilire se i dati sono aggiornati, completi, strutturalmente validi e idonei all'interpretazione. Una dashboard può essere visivamente curata e dare comunque ai decisori una falsa sicurezza.
Indice
Perché la vostra dashboard dei KPI vi mente
Le sei fasi di un processo di monitoraggio dei KPI
Definire la decisione e il responsabile
Stabilire una baseline rappresentativa
Validare il lineage prima di interpretare le variazioni
Calcolare alla fonte autorevole
Rilevare limiti e comportamenti insoliti
Instradare, risolvere e migliorare gli alert
Separare le performance di business dall'idoneità dei dati
Usare due percorsi di alert
Rendere il risultato verificabile
Regole tradizionali e rilevamento delle anomalie basato sull'AI a confronto
Dove funzionano le regole deterministiche
Dove aiuta il rilevamento adattivo
Ruoli, responsabilità e pratiche operative
Assegnare le responsabilità in modo esplicito
Definire la cadenza in base all'azionabilità
Errori comuni e come evitarli
Schemi di fallimento comuni
Costruire la vostra strategia di monitoraggio dei KPI con digna
Perché la vostra dashboard dei KPI vi mente
Il problema di solito nasce da un design ragionevole. Un analytics engineer definisce i ricavi, collega il calcolo a una tabella del warehouse, aggiunge una linea obiettivo e pubblica il risultato in Power BI o in un'altra piattaforma di BI. Dal punto di vista dello strumento di reporting, l'aggiornamento della dashboard riesce, ma il caricamento delle transazioni a monte è arrivato in ritardo o conteneva solo una parte dei dati previsti.
Lo stakeholder vede una variazione positiva. Il data engineer vede un incidente di consegna. Entrambi guardano lo stesso KPI, ma solo uno dei due ha il contesto necessario per interpretarlo.
Regola pratica: non considerate mai affidabile il valore di un KPI finché accanto non sono disponibili il suo stato di freshness, completezza, lineage e validazione.
Il monitoraggio tradizionale spesso osserva solo il numero finale. Una soglia può generare un alert quando i ricavi scendono sotto un obiettivo fisso, ma non segnalerà necessariamente un caricamento in ritardo, una partizione mancante, un tipo di colonna modificato o un'estrazione parziale. I team ricevono quindi alert che non spiegano se è cambiato il business o se è fallita la misurazione.
Questa distinzione incide su ogni risposta operativa. Un calo reale può richiedere un'indagine commerciale. Un dataset in ritardo richiede un intervento sulla pipeline. Una modifica dello schema può richiedere aggiornamenti delle trasformazioni. Se il processo di monitoraggio invia lo stesso alert in tutti e tre i casi, la responsabilità diventa poco chiara e chi interviene perde tempo a diagnosticare il problema sbagliato.
Le dashboard restano importanti, soprattutto quando i team devono creare visualizzazioni Power BI utili all'azione. Ma la visualizzazione è il livello finale, non il sistema di monitoraggio in sé. Il processo sottostante deve collegare il KPI mostrato alle condizioni dei dati che lo hanno prodotto.
Una dashboard di monitoraggio dei KPI pratica dovrebbe quindi mostrare il segnale di business e le evidenze che ne supportano la validità. Ciò significa registrare orari di consegna previsti ed effettivi, conteggi delle righe, esiti della validazione, versioni dello schema e stato del calcolo. Senza questi controlli, una dashboard verde può solo significare che la dashboard è stata visualizzata correttamente.
Le sei fasi di un processo di monitoraggio dei KPI
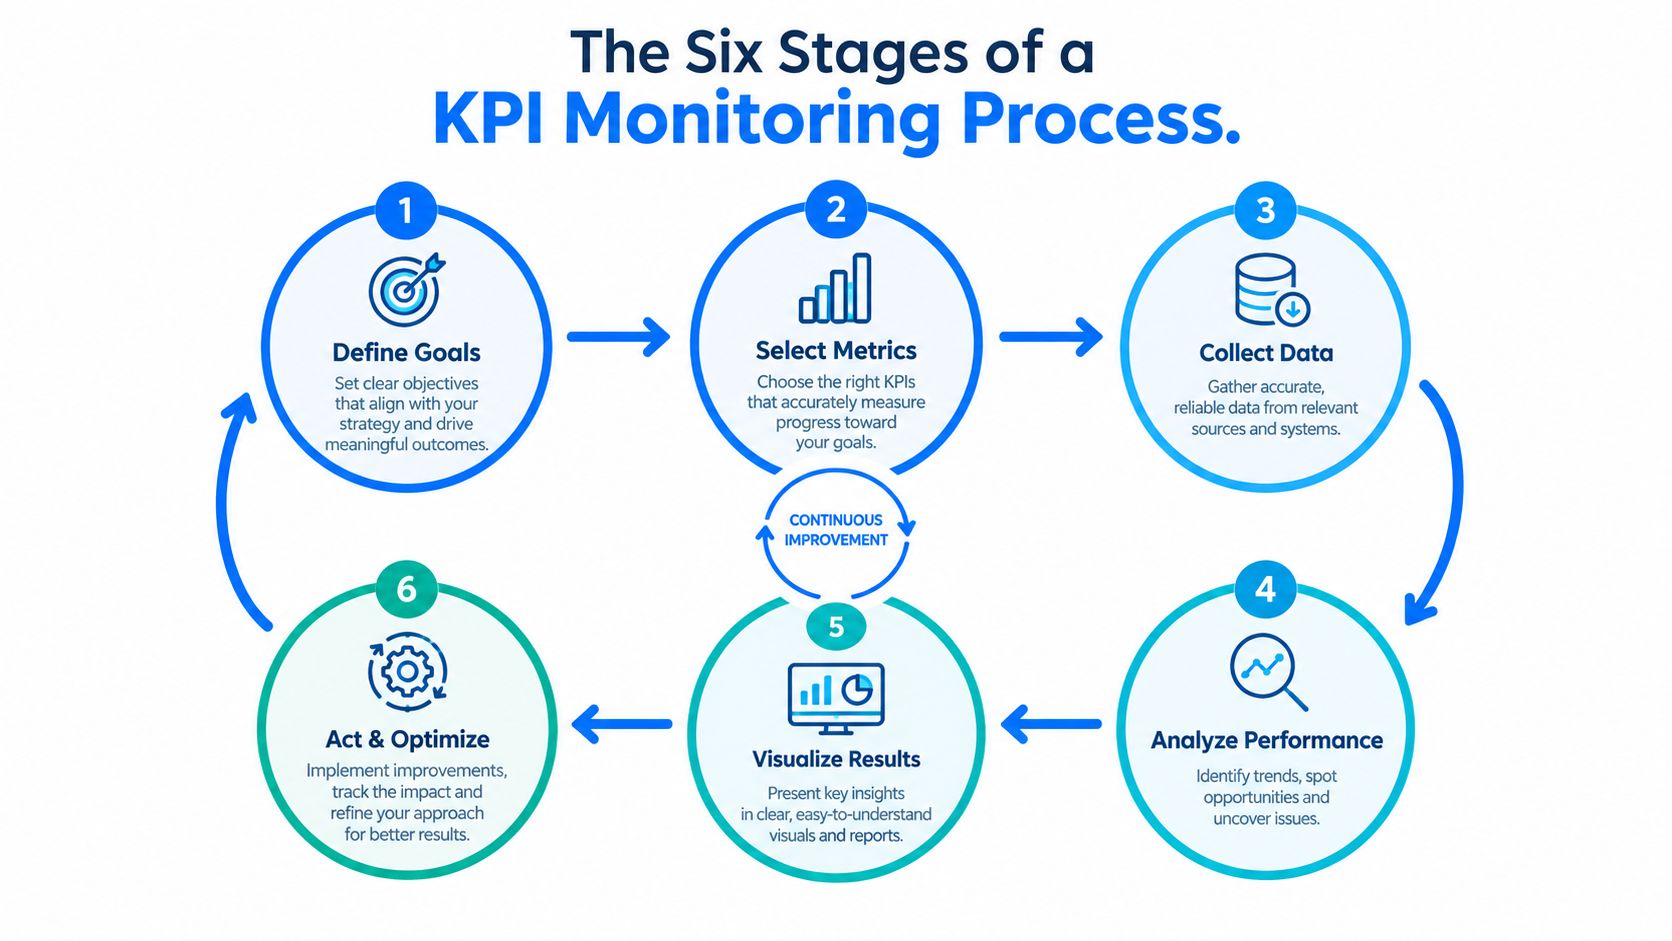
Un processo difendibile è un ciclo chiuso. Il modello operativo dettagliato comprende otto fasi distinte, dalla definizione della decisione e del responsabile fino alla revisione delle soglie rispetto ai falsi positivi e alle condizioni che cambiano, come descritto nel NIST AI Risk Management Framework Playbook. In pratica, queste attività possono essere organizzate in sei fasi di implementazione che i team possono gestire giorno per giorno.
Definire la decisione e il responsabile
Partite dalla decisione, non dal grafico. Mettete per iscritto quale azione il KPI dovrebbe influenzare, chi è responsabile del risultato e chi indaga su una deviazione. Definite numeratore, denominatore, granularità del calcolo, filtri, aspettativa di freshness, intervallo operativo accettabile e percorso di escalation.
Un team di servizi finanziari potrebbe assegnare un KPI sui volumi di regolamento a un responsabile delle operations, mentre un'organizzazione sanitaria potrebbe assegnare un KPI sulla completezza delle richieste di rimborso a un responsabile della data governance. In entrambi i casi, il responsabile ha bisogno di un dettaglio semantico sufficiente per stabilire se una variazione è significativa.
Stabilire una baseline rappresentativa
Un obiettivo non è la stessa cosa di una baseline. Costruite il comportamento storico a partire da periodi rappresentativi e separate la normale stagionalità, gli effetti di calendario, le promozioni, la manutenzione pianificata e le interruzioni note dai cambiamenti reali. Un limite fisso può essere utile per un confine di compliance rigido, ma non descriverà la variazione normale.
Validare il lineage prima di interpretare le variazioni
Verificate che tabelle sorgente, trasformazioni, join, filtri e job di consegna funzionino come previsto. Un KPI dovrebbe riportare il lineage fino alla sua fonte autorevole, insieme ai risultati della validazione e allo stato di idoneità dei dati. Se la fonte è incompleta, etichettate o sopprimete il risultato di business anziché presentarlo come aggiornato.
Calcolare alla fonte autorevole
Il calcolo in-database riduce gli spostamenti non necessari e mantiene la logica vicina ai dati governati. Rende inoltre il calcolo più facile da verificare, perché il team può associare il risultato al timestamp della fonte, alla versione della query, allo stato dello schema e all'esito della validazione.
Rilevare limiti e comportamenti insoliti
Usate controlli deterministici per i confini definiti e i problemi di integrità. Aggiungete un monitoraggio statistico per livelli insoliti, variazioni del tasso di cambiamento, volatilità e cambiamenti di distribuzione. La combinazione intercetta sia le violazioni note sia i comportamenti che non rientrano nella baseline storica.
Instradare, risolvere e migliorare gli alert
Inviate gli alert in base alla severità a un responsabile. Una deviazione persistente di bassa severità può generare un ticket, mentre un grave problema di integrità può richiedere un paging immediato. Ogni alert dovrebbe includere un runbook, una finestra di soppressione, un percorso di escalation, la diagnosi, la remediation e l'impatto sul business.
Il processo diventa affidabile solo quando i team ne esaminano le prestazioni. Tracciate falsi positivi, incidenti non rilevati, tempo di rilevamento, tempo di presa in carico e tempo di remediation, quindi ricalibrate le soglie quando cambiano le condizioni operative.
Separare le performance di business dall'idoneità dei dati
Un alert sulle performance di business risponde alla domanda: “Il business si è comportato diversamente?”. Un alert sull'idoneità dei dati risponde alla domanda: “Possiamo fidarci della misurazione?”. Le due domande sono correlate, ma non dovrebbero condividere lo stesso stato né la stessa risposta.
Una lacuna importante nelle indicazioni sul monitoraggio dei KPI è che spiegano come scegliere le metriche senza specificare come operare quando i dati sottostanti sono in ritardo, incompleti o strutturalmente modificati. I consigli convenzionali spesso adeguano la frequenza di monitoraggio all'azionabilità, ma raramente definiscono cosa accade quando un aggiornamento pianificato manca la propria finestra di arrivo o quando una colonna viene aggiunta, rimossa o cambia tipo, come descritto in questa guida alla progettazione dei KPI.
Usare due percorsi di alert
Supponiamo che un KPI di un operatore di telecomunicazioni mostri un calo improvviso dell'attività dei clienti. Esistono almeno due spiegazioni plausibili:
Segnale di business: il comportamento dei clienti è cambiato, quindi il team commerciale o operativo dovrebbe indagare.
Segnale di consegna: manca l'ultima partizione di eventi, quindi il team della piattaforma dati dovrebbe riparare il caricamento.
Segnale strutturale: una colonna sorgente ha cambiato tipo o è scomparsa, quindi i responsabili delle trasformazioni e della governance dovrebbero valutarne l'impatto.
Un singolo riquadro rosso non può distinguere questi casi. Il sistema dovrebbe associare al calcolo del KPI lo stato di freshness, completezza, schema e validazione. Se i dati sono arrivati in ritardo, il risultato può essere contrassegnato come compromesso e l'alert di business soppresso finché la fonte non torna in salute.
Rendere il risultato verificabile
Ogni esecuzione del KPI dovrebbe conservare il timestamp dei dati, l'orario di consegna previsto rispetto a quello effettivo, il conteggio delle righe, la versione dello schema, lo stato del calcolo, la versione della soglia e l'identificativo dell'incidente. Questi campi consentono a un analista di spiegare perché un valore è cambiato senza ricostruire l'intera storia della pipeline durante un incidente.
La distinzione è particolarmente importante nella sanità e nel settore pubblico, dove un report apparentemente aggiornato può influenzare decisioni operative o normative. Un risultato che riflette dati parziali non dovrebbe apparire identico a un risultato prodotto da un caricamento completo e validato.
L'approccio di digna alla data quality observability riflette questo modello operativo, collegando le metriche di business a controlli su tempestività, validazione, anomalie e modifiche dello schema all'interno dell'ambiente dati del cliente. Il vantaggio pratico non è un'altra dashboard. È una risposta più chiara alla prima domanda che chi interviene dovrebbe porsi: la variazione del KPI è reale o la misurazione è diventata inaffidabile?
Regole tradizionali e rilevamento delle anomalie basato sull'AI a confronto
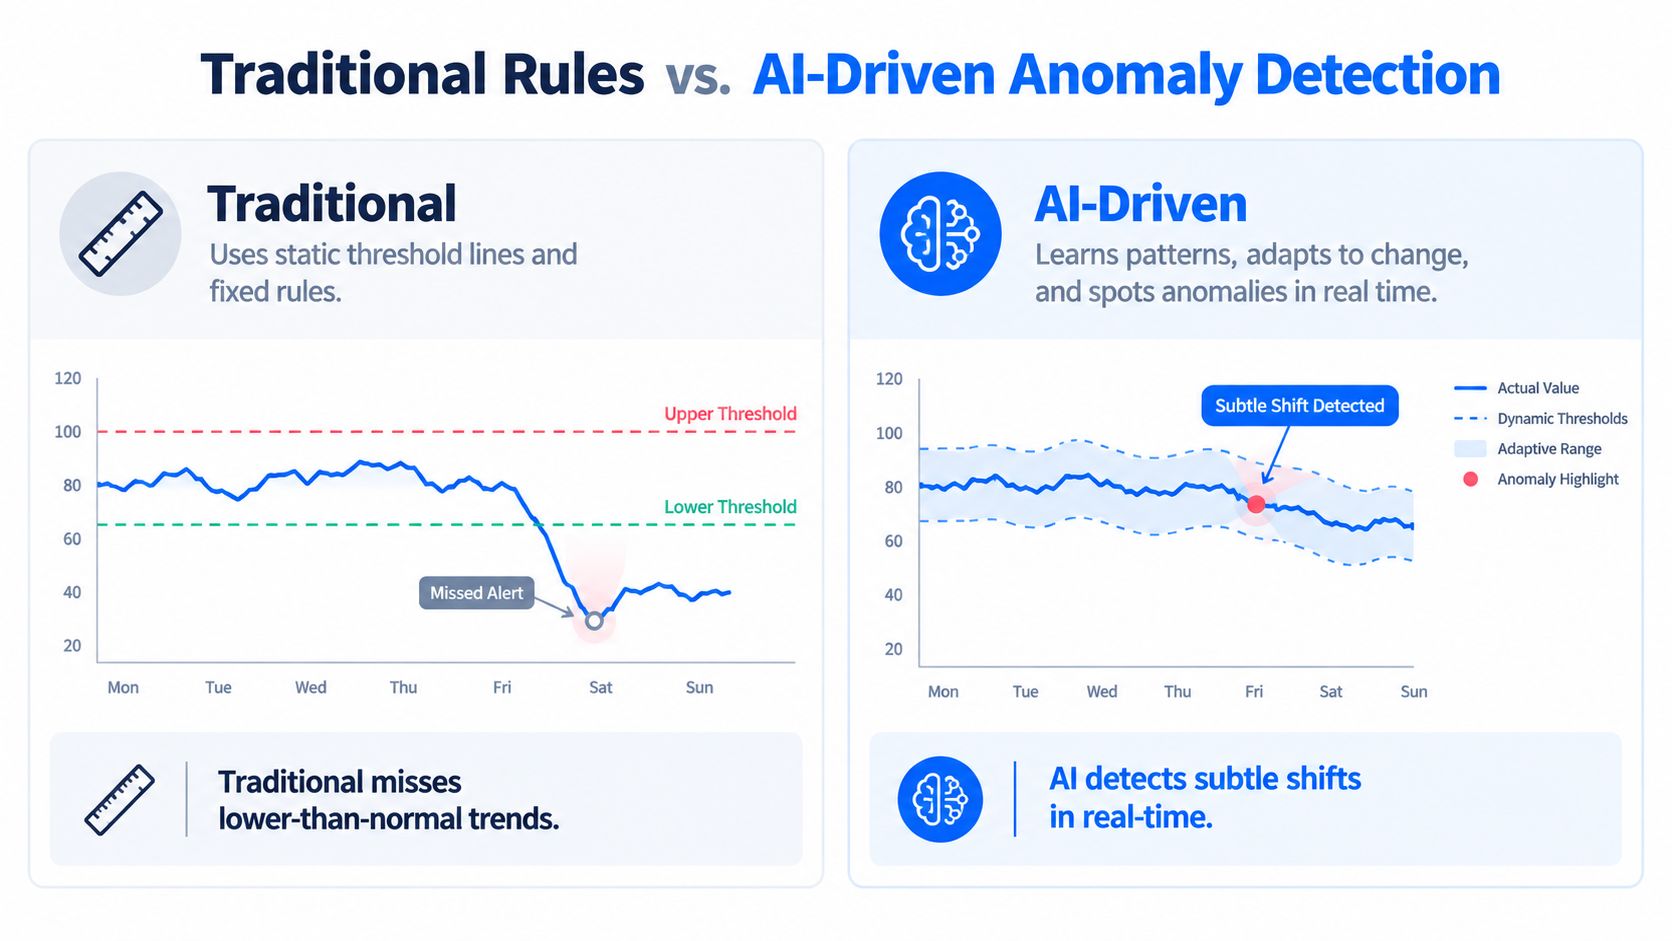
Una soglia fissa può proteggere un confine di business chiaro, ad esempio generando un alert quando le transazioni scendono sotto un limite approvato. Non può però descrivere ogni condizione operativa normale. Fine settimana, domanda stagionale, periodi di basso traffico, deriva graduale e volatilità variabile possono rendere fuorviante la stessa soglia.
Ciò genera due fallimenti operativi. Una soglia sensibile produce rumore, mentre una soglia ampia non coglie un calo significativo. I team iniziano a ottimizzare il volume degli alert anziché la qualità delle decisioni, un problema trattato in queste indicazioni sul monitoraggio dei golden signal SRE.
Dove funzionano le regole deterministiche
I controlli deterministici sono adatti a condizioni esplicite e verificabili:
Controlli sui null: i campi obbligatori devono contenere valori.
Controlli di unicità: gli identificativi non devono essere duplicati alla granularità definita.
Controlli di integrità referenziale: i record figli devono corrispondere a record padre validi.
Controlli dello schema: le colonne obbligatorie e i tipi di dato devono restare compatibili.
Controlli di freshness: i dati attesi devono arrivare entro la finestra di consegna definita.
Controlli sui limiti: un confine normativo od operativo non deve essere superato.
Questi controlli sono trasparenti, spiegabili e facili da collegare a un runbook. Sostituirli con il rilevamento delle anomalie indebolirebbe i controlli proprio dove la condizione attesa è già nota.
Dove aiuta il rilevamento adattivo
Il monitoraggio statistico confronta il comportamento attuale con lo storico del dataset stesso. La panoramica sui tipi di rilevamento delle anomalie descrive come questo approccio possa individuare un livello, un tasso di cambiamento, un andamento di volatilità o una variazione di distribuzione inattesi senza che gli ingegneri debbano codificare manualmente ogni condizione normale. È utile quando una metrica cambia durante periodi di basso traffico o deriva prima di superare un limite fisso.
Il modulo Data Anomalies di digna applica l'apprendimento della baseline basato sull'AI e il rilevamento continuo delle anomalie senza configurazione manuale delle regole. La sua esecuzione in-database mantiene i calcoli all'interno dell'ambiente del cliente, riducendo lo spostamento dei dati ed evitando l'accesso del fornitore ai dati di produzione. Questo design aiuta inoltre a collegare un alert su una metrica di business al relativo problema di idoneità dei dati, invece di trattare il KPI come un segnale isolato.
Usate un modello ibrido. Le regole deterministiche dovrebbero far rispettare contratti noti e condizioni di compliance, mentre il monitoraggio adattivo dovrebbe coprire i comportamenti che nessuna singola soglia può rappresentare. Inviate entrambi i tipi di alert attraverso lo stesso workflow di gestione degli incidenti, ma conservate il metodo di rilevamento, le evidenze e il KPI interessato, così chi interviene può distinguere un reale cambiamento del business da un problema di misurazione.
Ruoli, responsabilità e pratiche operative
Un processo di monitoraggio dei KPI fallisce quando la responsabilità si ferma alla dashboard. I data engineer gestiscono consegna e calcolo, gli analytics engineer tutelano l'accuratezza semantica, i team di governance definiscono le aspettative di qualità e i business owner decidono quale azione richiede un cambiamento.
Il NIST raccomanda di selezionare metriche che forniscano indicazioni significative sullo stato ai livelli pertinenti, di definire le frequenze di monitoraggio e di valutazione dei controlli e di automatizzare ove possibile raccolta, analisi e reporting, come illustrato nella sua pubblicazione sul monitoraggio continuo.
Assegnare le responsabilità in modo esplicito
Il data engineer è responsabile della salute delle pipeline, delle pianificazioni di consegna, delle modifiche alle fonti e delle procedure di ripristino. L'analytics engineer è responsabile delle definizioni dei KPI, di join, filtri, logica di aggregazione e correttezza delle dashboard. Il team di governance o di qualità dei dati definisce regole di validazione, requisiti di evidenza e condizioni accettabili dei dati.
Il business owner interpreta il KPI e decide cosa deve accadere quando si discosta. Questa persona potrebbe approvare una risposta commerciale, accettare un'eccezione nota o scalare un incidente operativo. Un modello condiviso di ruoli e responsabilità per la qualità dei dati aiuta a evitare la situazione comune in cui tutti ricevono un alert ma nessuno è responsabile della decisione.
Definire la cadenza in base all'azionabilità
Gli indicatori operativi ad alta volatilità possono richiedere valutazioni frequenti, mentre le misure strategiche più lente possono essere riviste meno spesso. L'importante è registrare esplicitamente la cadenza, inclusi l'intervallo di misurazione, la pianificazione prevista degli aggiornamenti, il timestamp e il gruppo di destinatari.
Ogni esecuzione dovrebbe riportare:
Metadati di consegna: orari di arrivo previsti ed effettivi.
Evidenze sui dati: conteggio delle righe, timestamp della fonte e stato di completezza.
Contesto tecnico: versione dello schema e stato del calcolo.
Contesto dei controlli: versione della soglia ed esito della validazione.
Traccia operativa: identificativo dell'incidente, responsabile e stato di risoluzione.
Prima di attivare un alert in produzione, richiedete una severità, un runbook, una finestra di soppressione, un responsabile e un percorso di escalation. L'automazione dovrebbe raccogliere e analizzare le evidenze, ma le persone devono restare responsabili del giudizio e della remediation.
Errori comuni e come evitarli
Più alert non significano un monitoraggio migliore. Se ogni piccola deviazione genera una notifica, chi interviene impara a ignorare il canale, e un incidente rilevante può perdersi tra gli avvisi di routine.
L'errore più dannoso è ottimizzare il volume degli alert anziché la qualità delle decisioni. Misurate se gli alert portano ad azioni concrete usando precisione, copertura degli incidenti o recall, tempo medio di rilevamento, tempo medio di presa in carico e tempo medio di remediation. Un sistema di alerting silenzioso può essere sano, oppure può non rilevare gli incidenti. Servono evidenze.
Schemi di fallimento comuni
Alert fatigue: troppe notifiche abituano i team a ignorare gli alert. Combinate i livelli di severità, sopprimete i duplicati durante le finestre di manutenzione note e inviate solo eventi su cui si può agire.
Vanity metric: una metrica può sembrare impressionante senza supportare alcuna decisione. Collegate ogni KPI a un obiettivo di business e identificate l'azione che segue un cambiamento significativo.
Nessuna ownership: un alert senza un responsabile designato diventa rumore di fondo condiviso. Assegnate un unico responsabile, anche quando più team contribuiscono alla diagnosi.
Soglie statiche: i limiti fissi non colgono stagionalità, guasti nelle fasce di basso traffico e deriva graduale. Affiancate ai confini un monitoraggio basato sulla baseline.
Dati non verificati: un KPI può variare perché la fonte è in ritardo o incompleta. Mantenete lo stato di idoneità dei dati accanto al valore di business e separate i percorsi di risposta.
Ogni alert ha bisogno di una risposta predefinita prima dell'attivazione in produzione. Se il team non sa spiegare chi indaga, di quali evidenze ha bisogno, quanto dura la soppressione e quando scatta l'escalation, l'alert non è pronto dal punto di vista operativo.
Costruire la vostra strategia di monitoraggio dei KPI con digna
Partite dai KPI che guidano decisioni reali, non da tutte le metriche disponibili nel warehouse. Definite responsabili e logica di calcolo, stabilite baseline rappresentative, validate il lineage, associate i metadati di idoneità dei dati e combinate controlli fissi con il rilevamento adattivo delle anomalie.
Un rollout pratico può iniziare da un singolo dataset critico o dominio di business. Aggiungete poi il monitoraggio della tempestività per il rischio di consegna, la validazione per le regole di business, lo schema tracking per le modifiche strutturali e l'osservabilità della piattaforma dove carichi di lavoro o prestazioni influiscono sul reporting. Gli strumenti di monitoraggio dei KPI dovrebbero adattarsi al modello operativo anziché imporre a ogni team lo stesso schema di alerting.
digna funziona all'interno dell'ambiente del cliente, con controlli eseguiti in-database su warehouse, lake e pipeline. I team possono sfruttare il suo approccio di licenza modulare per iniziare con un solo modulo ed espandersi, mentre l'SDK Python supporta l'integrazione programmatica nei workflow esistenti. Una dashboard condivisa e incentrata sull'utente offre a data engineer, analisti e stakeholder un unico punto in cui esaminare incidenti, trend e stato.
L'implementazione più solida collega la progettazione delle metriche a raccolta, interpretazione, escalation e remediation. Con digna, i team possono passare dall'installazione ai primi insight in meno di due ore, per poi affinare soglie e workflow man mano che imparano come si comportano i propri dati in produzione.
digna collega il monitoraggio dei KPI di business con qualità dei dati, tempestività, validazione, rilevamento delle anomalie e schema tracking all'interno del vostro ambiente. Visitate digna per vedere come potete costruire un processo di monitoraggio verificabile che distingua i reali cambiamenti di performance dai dati inaffidabili.
Per quantificare quanto costa davvero al business un feed di KPI in ritardo o incompleto, inserite i vostri dati nel calcolatore del costo del data downtime prima di decidere quanto monitoraggio merita ciascuna metrica.
Domande frequenti
Che cos'è un processo di monitoraggio dei KPI?
Un ciclo chiuso che definisce la decisione e il responsabile di ogni KPI, stabilisce una baseline rappresentativa, valida il lineage, calcola alla fonte autorevole, rileva limiti e comportamenti insoliti e instrada gli alert a una persona responsabile. L'obiettivo è sapere sia che cosa dice la metrica sia se ci si può fidare dei dati che la sostengono.
Perché una dashboard dei KPI può mostrare numeri fuorvianti?
Lo strumento di reporting può aggiornarsi correttamente mentre il caricamento a monte è arrivato in ritardo o solo in parte. Nell'esempio dell'articolo, i ricavi sembravano superiori del 15% perché la pipeline aveva omesso gli ultimi due giorni di transazioni. Senza controlli di freshness e completezza, i dati incompleti sembrano esattamente performance di business migliori.
Qual è la differenza tra un alert di business e un alert sull'idoneità dei dati?
Un alert sulle performance di business verifica se il business si è comportato diversamente, quindi indaga il responsabile commerciale o delle operations. Un alert sull'idoneità dei dati verifica se ci si può fidare della misurazione, quindi il team della piattaforma dati ripara una partizione mancante o uno schema modificato. Mantenere due percorsi di alert indirizza ogni problema al team giusto.
Il monitoraggio dei KPI dovrebbe usare soglie fisse o il rilevamento delle anomalie?
Entrambi. Le soglie fisse sono adatte a confini rigidi ed espliciti come controlli sui null, unicità, integrità referenziale, compatibilità dello schema e finestre di consegna. Il rilevamento adattivo delle anomalie confronta una metrica con il proprio storico, quindi intercetta livelli insoliti, variazioni del tasso di cambiamento e derive che un singolo limite statico non coglierebbe o segnalerebbe come rumore.
Chi dovrebbe essere responsabile del monitoraggio dei KPI?
La responsabilità è suddivisa. I data engineer sono responsabili della salute delle pipeline e delle pianificazioni di consegna, gli analytics engineer delle definizioni dei KPI e della logica delle dashboard, i team di governance stabiliscono regole di validazione e requisiti di evidenza, e il business owner decide quale azione richiede una deviazione. Un KPI senza un responsabile designato tende a diventare un problema di tutti e un compito di nessuno.


