Architettura di data observability spiegata in modo semplice
|
8
min di lettura

Una dashboard può essere verde mentre la decisione che la sostiene è già sbagliata. La pipeline è stata completata, il data warehouse è disponibile e ogni job pianificato segnala un esito positivo, eppure un sistema sorgente ha consegnato dati in ritardo, un team a monte ha cambiato il tipo di una colonna oppure un caricamento parziale ha rimosso dei record. Il team finance vede i ricavi di ieri, un team operativo non si accorge di un problema in evoluzione e una funzionalità di AI consuma input che non corrispondono più alle ipotesi usate durante l'addestramento.
Spesso i team iniziano aggiungendo altri alert. Questo approccio aiuta finché un alert non scatta senza un responsabile, senza contesto o senza una visione chiara dell'impatto a valle. Il problema più profondo è architetturale: dove vengono eseguiti i calcoli di observability, dove risiedono i metadati e come collega il sistema un segnale tecnico alle persone e ai processi di business che ne sono interessati?
L'architettura di data observability risponde a queste domande. Estende il tradizionale monitoraggio dell'infrastruttura con una visibilità continua su pipeline di dati, data warehouse, data lake, dashboard e input di machine learning. La categoria commerciale si è espansa rapidamente. Una stima di settore del 2026 valuta il mercato della data observability in 3,51 miliardi di USD e prevede 6,03 miliardi di USD entro il 2031, con un CAGR dell'11,42% tra il 2026 e il 2031 (stima di mercato di Mordor Intelligence). Un altro report del 2026 valuta il mercato in 3,4 miliardi di USD nel 2026, rispetto ai 2,94 miliardi di USD del 2025 (report di mercato di Spherical Insights).
La lezione pratica è semplice. Un'architettura affidabile non dovrebbe limitarsi a dirvi che una tabella è cambiata. Dovrebbe mostrare che cosa è cambiato, se il cambiamento è atteso, quali asset a valle ne dipendono e se il segnale incide su reporting, operazioni, governance o AI. I team che vogliono un modo strutturato di ragionare sull'affidabilità possono usare anche questa guida per misurare l'affidabilità dei dati.
Indice
Introduzione: perché l'architettura di data observability conta oggi
Che cosa significa davvero architettura di data observability
Livelli e componenti fondamentali di un'architettura moderna
I cinque pilastri che rilevano gli errori silenziosi nei dati
Dove dovrebbe essere eseguita l'observability e come distribuirla
Dai segnali tecnici all'impatto sul business, con esempi reali
La vostra roadmap per implementare un'architettura di data observability
Introduzione: perché l'architettura di data observability conta oggi
Un incidente tipico inizia in modo sottile. Un job di ingestion riceve meno record del solito, ma termina con successo. Una trasformazione continua a essere eseguita perché lo schema è tecnicamente valido. La dashboard si aggiorna secondo la pianificazione, quindi il suo indicatore di stato resta verde. Nessuno se ne accorge finché un responsabile non chiede perché una metrica di business si è mossa in modo inatteso.
Il monitoraggio tradizionale è bravo a rispondere a domande operative, ad esempio se un server è disponibile, se un job è terminato o se un processo ha restituito un errore. I sistemi di dati hanno bisogno di più contesto. I dati cambiano forma, volume, distribuzione, tempistica e significato mentre attraversano ingestion, trasformazione, archiviazione e consumo. Una pipeline può essere operativamente sana e allo stesso tempo produrre dati incompleti, obsoleti o strutturalmente incompatibili con l'uso a valle.
Il punto cieco è di solito architetturale
La moderna architettura di data observability è nata perché le metriche di base dell'infrastruttura e il monitoraggio delle prestazioni applicative non riuscivano a spiegare questi errori. Man mano che le pipeline diventavano più distribuite, i team hanno aggiunto controlli su qualità dei dati, lineage, anomalie e comportamento in tempo reale. Oggi la disciplina funziona come un livello architetturale per affidabilità e governance, non semplicemente come una dashboard per la risposta agli incidenti.
Questa distinzione è importante per diversi gruppi:
I data engineer devono trovare l'origine di un errore senza cercare tra strumenti scollegati.
Gli analytics engineer e gli sviluppatori BI hanno bisogno della certezza che trasformazioni e dashboard riflettano input aggiornati e strutturalmente validi.
I responsabili della governance hanno bisogno di evidenze che i controlli si applicano in modo continuo su data warehouse, data lake e pipeline.
I team di AI hanno bisogno di tracciabilità dai record sorgente fino a feature, dati di addestramento e input dei modelli.
L'architettura determina se questi gruppi condividono un unico contesto o se devono ricostruirlo manualmente durante un incidente. Un livello di metadati centrale può collegare ownership, lineage, comportamento storico e utilizzo. L'esecuzione distribuita può mantenere i controlli vicini ai sistemi che contengono i dati. Gli alert possono quindi instradare un evento significativo invece di inviare una metrica isolata a un generico canale operativo.
Che cosa rende possibile una buona architettura
Un sistema ben progettato rileva sia le modalità di errore note sia quelle inattese. I controlli deterministici possono imporre regole esplicite, mentre i metodi statistici possono individuare comportamenti insoliti senza che qualcuno debba prevedere ogni possibile problema. Il risultato non sono dati perfetti per definizione. È un sistema di feedback che offre ai team evidenze più tempestive, una diagnosi migliore e una base più chiara per stabilire le priorità di intervento.
L'architettura incide anche su governance, portabilità e controllo della spesa. Spostare i dati in un servizio esterno può semplificare alcune analisi, ma può introdurre ulteriori questioni di accesso, spostamento dei dati e infrastruttura. Eseguire i controlli all'interno di un ambiente di data warehouse o data lake esistente può preservare la località dei dati, anche se richiede un'attenta pianificazione di permessi, carichi di lavoro e motori supportati. Questi compromessi meritano la stessa attenzione dell'elenco delle metriche monitorate.
Che cosa significa davvero architettura di data observability
Un'analogia utile è il cruscotto di un'auto. Il monitoraggio tradizionale può dirvi se il motore è acceso e se il veicolo ha alimentazione. L'observability vi offre una visione più ricca: velocità, livello del carburante, temperatura, spie di avviso e contesto sufficiente per capire perché l'auto non si comporta come previsto.

Applicate questa analogia a una piattaforma dati. Il data plane è il luogo in cui i dati vengono generati, spostati, trasformati e archiviati. Il control plane definisce pianificazioni, policy, soglie, workflow e risposte. Il livello dei metadati spiega che cos'è ogni asset, chi ne è responsabile, come si collega agli altri asset e come si è comportato nel tempo.
Costruire la definizione in tre passaggi
Primo, identificate il sistema osservabile. Comprende applicazioni sorgente, job di ingestion, strumenti di trasformazione, data warehouse, data lake, dashboard e input dei modelli. L'observability deve seguire i dati lungo tutto questo percorso, senza fermarsi al primo job completato con successo.
Secondo, identificate i segnali. Le metriche descrivono comportamenti misurabili come tempi di arrivo, volume o distribuzione. I log registrano eventi ed errori. I segnali predittivi evidenziano scostamenti rispetto ai pattern attesi. Lineage e metadati aggiungono il contesto che trasforma un avviso in un percorso di indagine.
Terzo, identificate il ciclo decisionale. La piattaforma raccoglie o calcola i segnali, li valuta rispetto a regole o baseline apprese, arricchisce gli eventi con il contesto e instrada le azioni verso i responsabili o i workflow di gestione degli incidenti. È questo ciclo a distinguere l'observability da un report statico sulla qualità.
Perché gli strumenti di qualità da soli non bastano
Uno strumento di data quality può verificare che i valori siano conformi a regole note. È prezioso, ma non spiega automaticamente se una tabella in ritardo incide su un report regolamentare, quale team è responsabile della sorgente a monte o se lo stesso comportamento è normale per una determinata pianificazione delle consegne. L'observability combina la validazione con tempestività, rilevamento delle anomalie, lineage e contesto operativo.
L'architettura dovrebbe inoltre restare indipendente dalle pipeline che osserva. Le indicazioni pratiche separano la piattaforma di observability dal sistema di dati osservato, consentendo alla piattaforma di monitorare ambienti nuovi e legacy senza imporre riscritture architetturali (indicazioni accademiche sull'architettura). Questa indipendenza permette ai team di aggiungere copertura in modo incrementale invece di riprogettare prima ogni data warehouse, data lake o workflow di orchestrazione.
In parole semplici, l'architettura di data observability è l'organizzazione di esecuzione, raccolta, metadati, analisi e azione che consente a un team di comprendere lo stato attuale e atteso dei dati lungo tutto il loro ciclo di vita.
Livelli e componenti fondamentali di un'architettura moderna
Un'architettura moderna funziona al meglio come insieme di livelli specializzati. Ogni livello ha una responsabilità diversa, ma tutti condividono metadati e contesto degli eventi a sufficienza per supportare la diagnosi.

Sistemi sorgente e data plane
In questo piano hanno origine i dati di business e vengono eseguite le trasformazioni. Può includere database operativi, applicazioni SaaS, sistemi di streaming, cloud storage, data warehouse e data lake. Il data plane dovrebbe restare responsabile del lavoro di spostamento ed elaborazione dei dati.
Una scelta progettuale importante è se eseguire qui i calcoli di observability. L'esecuzione nel database può calcolare metriche ed effettuare controlli all'interno di sorgenti dati compatibili, mentre un design esterno estrae le informazioni per analizzarle altrove. Mantenere l'esecuzione vicina ai dati può ridurre gli spostamenti non necessari e preservare i confini di sicurezza esistenti, ma i team devono comunque gestire permessi e isolamento dei carichi di lavoro.
Raccolta e ingestion
Il livello di raccolta acquisisce telemetria e metadati dal data plane. Può catturare statistiche delle tabelle, eventi delle pipeline, modifiche dello schema, comportamento delle query, tempi di consegna, risultati delle validazioni e aggiornamenti del lineage. Lo scopo non è copiare ogni record nel sistema di observability, ma raccogliere i segnali e i riferimenti necessari per comprendere il comportamento.
Un livello di raccolta solido supporta sia pattern pianificati sia pattern guidati dagli eventi. I controlli pianificati sono utili per le finestre di consegna note. Gli eventi sono utili quando cambia uno schema, si completa una pipeline o una sorgente emette una transizione di stato rilevante.
Orchestrazione centralizzata e metadati
Il livello di controllo pianifica i controlli, applica le policy, memorizza la configurazione e coordina gli alert. Il livello dei metadati arricchisce ogni segnale con ownership, definizioni, lineage, utilizzo, ambiente e contesto storico. Insieme rispondono alle domande a cui le metriche grezze non possono rispondere.
Questo livello dovrebbe supportare anche ambienti legacy ed eterogenei. Una piattaforma che comprende un solo data warehouse lascia punti ciechi su sistemi on-premises, più cloud o strumenti di orchestrazione meno recenti. L'obiettivo architetturale è un modello di contesto condiviso, non un'uniformità forzata in ogni sistema sottostante.
Observability e azione
Il livello superiore presenta stato di salute, trend, anomalie, incidenti e impatto. Dovrebbe aiutare chi interviene a passare da un segnale a una decisione:
Rilevamento: quale comportamento è cambiato?
Diagnosi: quale evento o trasformazione a monte potrebbe spiegarlo?
Impatto: quali dataset, dashboard, modelli o processi ne dipendono?
Azione: chi è responsabile della correzione e come dovrebbe essere tracciato l'evento?
Questa struttura è in linea con le più ampie indicazioni sull'architettura dei sistemi di dati, in cui i confini tra elaborazione, orchestrazione, metadati e consumo devono restare espliciti.
Regola architetturale: mantenete l'esecuzione vicina ai dati quando governance e costi richiedono località, ma mantenete il contesto abbastanza centralizzato da permettere a chi interviene di comprendere l'impatto sull'intera piattaforma.
I cinque pilastri che rilevano gli errori silenziosi nei dati
Il modello a cinque pilastri offre ai team un punto di partenza pratico: freschezza, qualità, volume, schema e lineage. Ogni pilastro affronta una diversa modalità di errore. Le implementazioni mature combinano validazione deterministica e rilevamento statistico delle anomalie, perché le regole esplicite intercettano le violazioni note mentre l'analisi comportamentale può far emergere scostamenti inattesi.
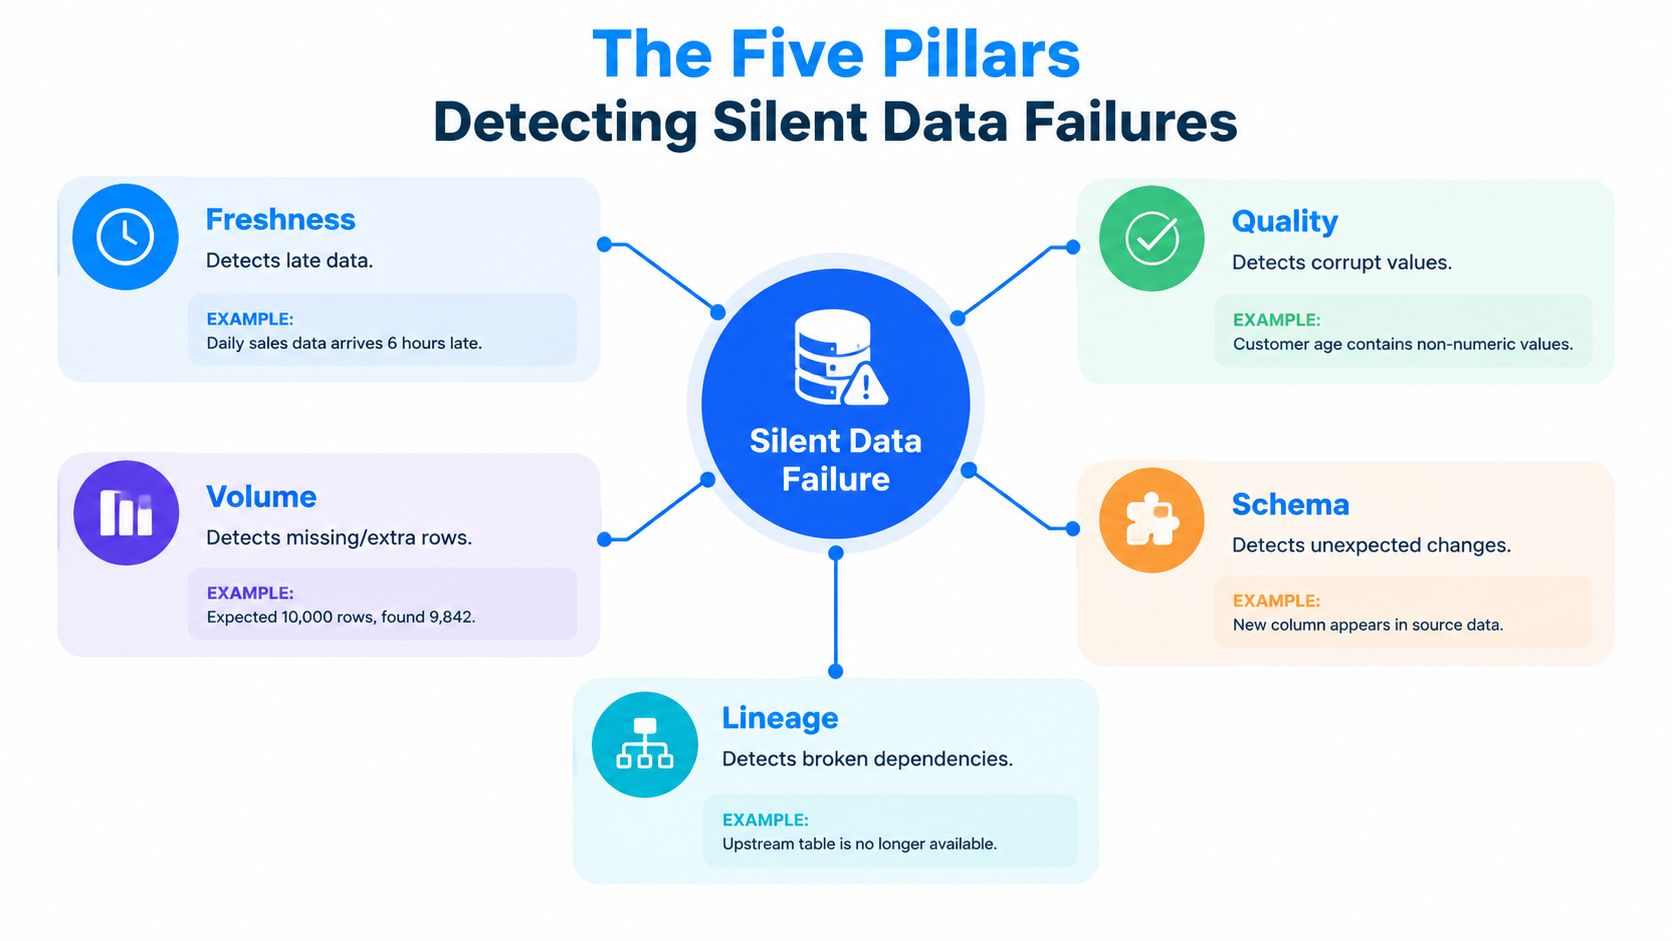
Freschezza
La freschezza indica se i dati sono abbastanza aggiornati per l'uso previsto. Non si limita a verificare se un job è stato eseguito. Un job completato con successo può comunque consegnare dati in ritardo, saltare una partizione o pubblicare un'estrazione incompleta.
Freschezza significa tempestività. Monitorate arrivo ed elaborazione rispetto al comportamento storico o a un'aspettativa di servizio esplicita, poi trattate i ritardi come potenziali errori della sorgente o dell'ingestion.
Un controllo utile confronta l'orario di arrivo effettivo con la pianificazione prevista. Il sistema dovrebbe anche distinguere una consegna in ritardo da una consegna in anticipo, quando questa distinzione è rilevante. Un file arrivato in anticipo può indicare che un processo sorgente è cambiato, anche se i dati sembrano disponibili.
Qualità
I controlli di qualità validano record e valori rispetto alle aspettative tecniche o di business. Tra gli esempi figurano campi obbligatori, intervalli validi, relazioni referenziali, categorie consentite e coerenza tra dataset correlati. Queste regole sono particolarmente importanti per il reporting regolamentare e per i workflow operativi critici.
La qualità non è un punteggio unico. I team dovrebbero definire quali dimensioni contano per ciascun caso d'uso, poi collegare i controlli falliti all'asset e al responsabile interessati. Una regola per una tabella di transazioni finanziarie può essere diversa da quella per un dataset esplorativo. Maggiori dettagli su come organizzare queste dimensioni si trovano nella guida di digna alle dimensioni della qualità dei dati.
Volume
I controlli sul volume cercano dati mancanti, duplicati o inaspettatamente aumentati. Una variazione nel numero di righe può indicare un caricamento incompleto, un'interruzione della sorgente, un problema di join o un evento di business legittimo. Il controllo diventa più utile quando considera i pattern storici e le dipendenze a valle anziché applicare un'unica soglia universale.
Schema
Il monitoraggio dello schema traccia le modifiche strutturali, come colonne aggiunte o rimosse, campi rinominati e tipi di dato modificati. Spesso fornisce un preavviso, perché le modifiche strutturali possono rompere trasformazioni, dashboard, contratti o feature dei modelli prima che qualcuno noti un errore visibile nel reporting.
I team dovrebbero classificare le modifiche attese e quelle inattese. Una migrazione controllata può aggiungere intenzionalmente una colonna, mentre un'API a monte può modificare un tipo senza preavviso. Lo stesso evento richiede un instradamento diverso a seconda di ownership, ambiente e utilizzo a valle.
Lineage
Il lineage mostra come i dati passano dalla sorgente alla trasformazione fino al consumo. Trasforma un alert isolato in una mappa dell'impatto. Se una tabella sorgente cambia, il lineage può rivelare quali tabelle derivate, report, metriche o input di AI dipendono dal campo interessato.
L'observability end-to-end collega gli eventi della sorgente all'impatto a valle lungo ingestion, trasformazione, archiviazione e consumo (ricerca sull'observability delle pipeline). Senza lineage, i team possono rilevare rapidamente un problema ma impiegare comunque troppo tempo a decidere da dove iniziare.
Dove dovrebbe essere eseguita l'observability e come distribuirla
Una pipeline può rilevare un controllo di qualità fallito e creare comunque problemi di governance, costi o portabilità. La decisione architetturale più rilevante riguarda dove dovrebbero risiedere calcolo, metadati e alerting, più che quali controlli attivare. I design nel database calcolano i controlli compatibili all'interno del data warehouse o della piattaforma dati. I design esterni estraggono dati o metriche verso un servizio separato per l'elaborazione.
L'esecuzione nel database può eseguire job all'interno di sistemi come Databricks, SAP HANA o Snowflake, mantenendo l'elaborazione nel SQL warehouse invece di spostare i dati all'esterno per l'analisi (indicazioni sull'observability in pushdown). Questo approccio ricorda l'ispezione delle merci in fabbrica: i dati restano vicini alla loro sorgente, mentre la piattaforma assorbe il carico di lavoro. L'esecuzione esterna crea un modello operativo centralizzato, ma può richiedere permessi, connettori e spostamenti di dati più ampi. I team che costruiscono la propria pratica di data platform engineering dovrebbero considerare questa decisione di collocazione come parte della progettazione della piattaforma.
Criterio | Esecuzione nel database | Esecuzione esterna |
|---|---|---|
Governance | I controlli operano entro i confini di accesso ai dati e le policy esistenti. | Un servizio separato può aver bisogno di permessi per estrarre o ispezionare i dati. |
Spostamento dei dati | Metriche e validazioni possono essere calcolate dove risiedono i dati. | I dati o i risultati della profilazione vengono spostati verso un livello di elaborazione esterno. |
Controllo dei costi | Usa la capacità di calcolo del data warehouse o della piattaforma, quindi la governance dei carichi di lavoro è importante. | Aggiunge costi di infrastruttura o di servizio separati, riducendo parte del lavoro all'interno della piattaforma. |
Portabilità | Funziona bene quando i motori supportati e i pattern SQL sono coerenti. | Può centralizzare la logica su sistemi eterogenei, ma può creare dipendenza dal servizio. |
Sicurezza | Favorisce la località dei dati e riduce al minimo l'esposizione dei record di produzione. | Richiede controlli accurati su estrazione, archiviazione, crittografia e conservazione. |
Prestazioni | Beneficia dell'accesso locale ai dati e dell'ottimizzazione del motore. | Può introdurre overhead di trasferimento, pianificazione o serializzazione. |
Operatività | I team gestiscono l'impatto sui carichi di lavoro all'interno di ciascuna piattaforma. | I team gestiscono connettori, affidabilità delle estrazioni e capacità esterna. |
Adattare il deployment all'ambiente
Le opzioni di cloud privato, VPC e on-premises sono importanti quando la residenza dei dati, la rete o le regole di accesso limitano il deployment. Un'organizzazione regolamentata può installare il sistema di observability nel proprio account cloud, VPC o data center, mantenendo i dati di produzione entro un perimetro approvato.
La portabilità merita la stessa attenzione. Approcci aperti e interoperabili, tra cui adozione di OpenTelemetry, observability-as-code e consolidamento degli strumenti, compaiono tra le priorità nelle recenti analisi sui trend dell'observability (trend di observability secondo IBM). Per i team dati, portabilità significa conservare metadati, policy, lineage e storico operativo quando le piattaforme cambiano. Esportare solo le dashboard non preserva questo contesto operativo.
Prima di scegliere, ponetevi tre domande:
La piattaforma può osservare ogni ambiente critico senza imporre il trasferimento dei dati?
Chi paga la capacità di calcolo usata per la profilazione e il rilevamento delle anomalie?
I team di governance possono verificare controlli, permessi, output e modello di conservazione?
Un alert tecnicamente accurato non basta se l'architettura aumenta il rischio di accesso o produce una spesa imprevedibile. Scegliete il design che bilancia la qualità del rilevamento con località dei dati, portabilità e controllo operativo.
Dai segnali tecnici all'impatto sul business, con esempi reali
Un alert sulla freschezza diventa più utile quando è collegato a un processo di business. Un alert sullo schema diventa urgente quando identifica un campo usato da un report regolamentare o da una feature di AI. Un segnale sul carico di lavoro della piattaforma diventa azionabile quando spiega quale team, pattern di query o data product sta consumando risorse.
Questo collegamento nasce dalla combinazione di lineage, metadati di utilizzo, ownership, definizioni di business e segnali di observability in un grafo contestuale delle dipendenze. Il grafo non sostituisce i controlli tecnici. Dà a ciascun controllo una collocazione nel modello operativo.

Servizi finanziari
Un dataset di transazioni può superare un controllo di base sul completamento della pipeline e allo stesso tempo violare una regola di business o arrivare dopo una finestra di reporting. Il Data Quality Management combina validazione, rilevamento delle anomalie, monitoraggio della tempestività e monitoraggio dello schema per identificare il problema. Il lineage mostra poi se i record interessati alimentano calcoli del rischio, reporting regolamentare o riconciliazioni a valle.
La priorità della risposta dovrebbe riflettere questo impatto. Uno scostamento in una tabella analitica inutilizzata non equivale a una modifica strutturale in un dataset usato da un processo finanziario critico.
Sanità
I team sanitari hanno spesso bisogno di dati clinici, operativi e regolamentari affidabili su sistemi con ownership e modalità di consegna diverse. Un'estrazione in ritardo può ritardare una vista operativa, mentre un tipo di campo modificato può rompere un'integrazione a valle. Freschezza, validazione, tracciamento dello schema e lineage forniscono evidenze diverse per la stessa indagine.
L'architettura dovrebbe mantenere i dati sensibili all'interno degli ambienti approvati, esponendo al contempo metadati sufficienti affinché i team autorizzati comprendano stato e responsabilità.
Telecomunicazioni e settore pubblico
Una piattaforma di telecomunicazioni può monitorare i dati dei clienti e operativi per individuare comportamenti insoliti di volume, disponibilità o distribuzione. Un'organizzazione del settore pubblico può dare priorità a tracciabilità, coerenza ed evidenze pronte per l'audit lungo processi di dati di lunga durata. In entrambi i contesti, la scelta progettuale importante è collegare gli eventi tecnici agli obblighi di servizio e ai responsabili.
Il Business Monitoring può anche valutare i KPI direttamente sui dati sottostanti. La Data Platform Observability aggiunge una vista correlata su carichi di lavoro, consumi, disponibilità e comportamento della piattaforma. L'observability fa sempre più parte della gestione dei costi e della strategia sugli standard aperti, non è solo un livello di dashboard.
Prontezza per l'AI
I team di AI hanno bisogno di più di una tabella pulita al momento dell'addestramento. Hanno bisogno di lineage dai dati sorgente attraverso trasformazioni, feature e input di addestramento fino agli output dei modelli. Se uno schema sorgente cambia o un ritardo di freschezza incide su una pipeline di feature, il grafo delle dipendenze dovrebbe rivelare quali input dei modelli potrebbero essere obsoleti o strutturalmente incompatibili.
La domanda utile non è più soltanto: “Il controllo è stato superato?” È: “Quale risultato di business, processo operativo o input di AI dipende da questo segnale, e chi può intervenire?”
La vostra roadmap per implementare un'architettura di data observability
Iniziate con un perimetro ristretto e un responsabile chiaro. Un rollout ampio senza priorità produce rumore prima che il team capisca come rispondere.
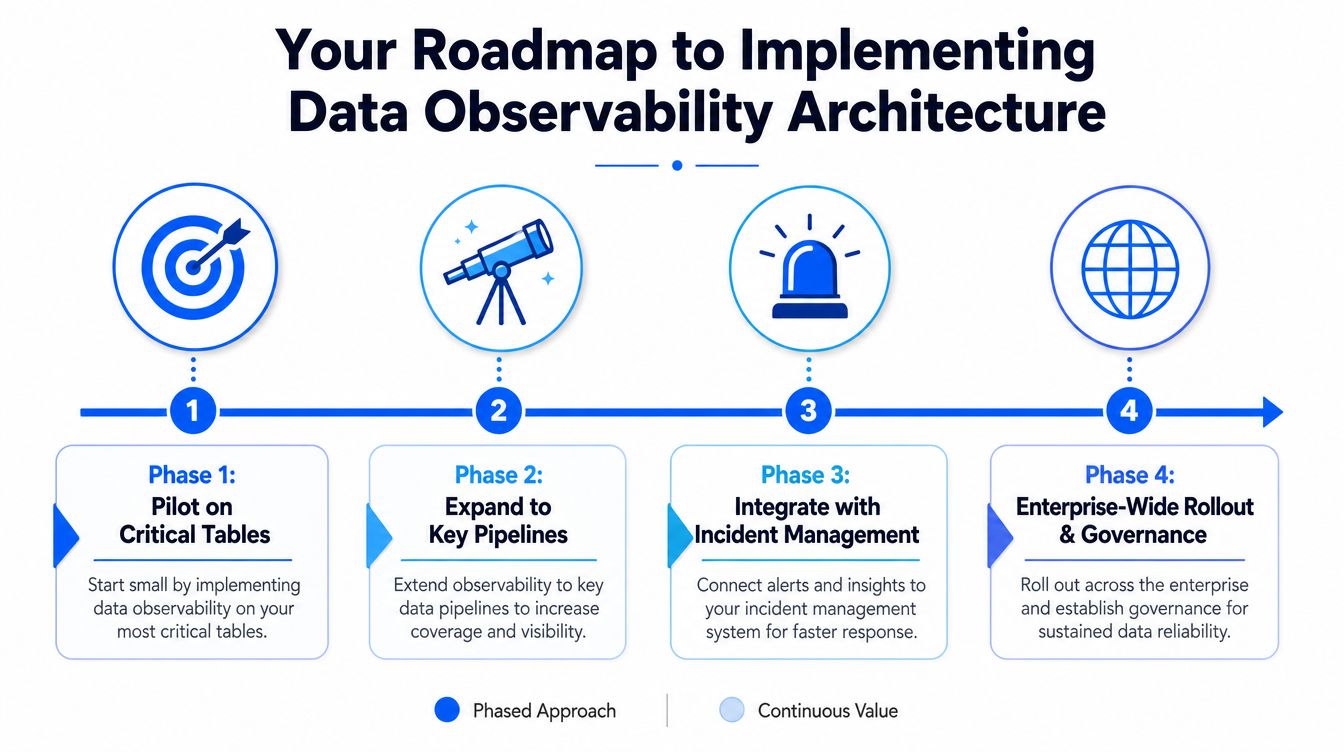
Fase uno: pilota sulle tabelle critiche
Scegliete dataset che supportano reporting, operazioni, governance o workflow di AI importanti. Definite il comportamento di consegna atteso, i pattern di volume di base, le aspettative sullo schema e un piccolo insieme di validazioni di business. Assegnate un responsabile a ogni alert prima di attivare le notifiche.
Fase due: estensione alle pipeline chiave
Aggiungete copertura a monte e a valle, così che il team possa ricostruire gli errori invece di vedere sintomi isolati nelle tabelle. Includete metadati su lineage, utilizzo e ownership, poi confrontate esecuzione nel database ed esecuzione esterna per gli ambienti nel perimetro.
Fase tre: collegamento alla gestione degli incidenti
Instradate gli alert verso i team responsabili della risoluzione. Registrate gli asset interessati, la causa sospetta, l'impatto sul business, lo stato e la risoluzione. Analizzate gli incidenti ricorrenti per individuare correzioni architetturali invece di ripetere interventi manuali di ripristino.
Fase quattro: definizione della governance enterprise
Standardizzate le policy su freschezza, modifiche dello schema, validazione, accesso, conservazione ed escalation. Estendete la copertura a data warehouse, data lake, pipeline e ambienti on-premises, verificando portabilità e consumo di risorse di calcolo. Un'implementazione modulare può iniziare con una sola funzionalità e crescere secondo un modello con canone base più costo per tabella attiva per modulo, invece di richiedere fin dall'inizio tutti i casi d'uso.
Una dashboard incentrata sull'utente dovrebbe servire ingegneri, analisti e stakeholder della governance con viste diverse dello stesso contesto sottostante. I team che cercano indicazioni pratiche possono usare questo framework di implementazione della qualità dei dati per definire ownership, controlli e priorità di rollout.
L'architettura più solida tratta qualità del rilevamento, governance, portabilità e controllo della spesa come un unico problema di progettazione. Iniziate da un data product critico, misurate quanto bene il team riesce a rilevare e spiegare gli errori, poi espandete solo quando il modello operativo è pronto.
digna offre una piattaforma enterprise di qualità dei dati e observability con esecuzione nel database, rilevamento delle anomalie, monitoraggio della tempestività, validazione, tracciamento dello schema e monitoraggio di business e della piattaforma. Visitate digna per vedere come un'architettura che mantiene i dati al loro posto può supportare analytics, governance e AI affidabili in tutto il vostro ambiente dati.
Domande frequenti
Che cos'è l'architettura di data observability?
È l'organizzazione di esecuzione, raccolta, metadati, analisi e azione che consente a un team di comprendere lo stato attuale e atteso dei dati lungo tutto il loro ciclo di vita. L'analogia utile è il cruscotto di un'auto: non più indicatori, ma la disposizione che permette al conducente di agire correttamente.
Perché il monitoraggio tradizionale non basta?
Perché risponde a domande operative, ad esempio se un server è disponibile, se un job è terminato o se un processo ha restituito un errore. Nessuna di queste spiega una tabella arrivata in orario, completata con successo e che contiene comunque valori errati: proprio l'errore che arriva fino a una decisione.
Dove dovrebbero essere eseguiti i calcoli di observability?
È la scelta progettuale chiave nel data plane. Eseguire i controlli dove i dati di business hanno già origine mantiene il contesto vicino all'errore, evita spostamenti non necessari ed è particolarmente importante quando privacy e carico operativo limitano ciò che può uscire dall'ambiente.
Chi trae vantaggio da una buona architettura di observability?
Quattro gruppi con esigenze diverse: i data engineer, che devono individuare un errore senza cercare tra strumenti scollegati; gli analytics engineer, che hanno bisogno di fiducia in input strutturalmente validi; i responsabili della governance, che necessitano di evidenze che i controlli si applicano in modo continuo; e i team di AI, che hanno bisogno di tracciabilità dai record sorgente fino a feature e input dei modelli.
Quanto è grande il mercato della data observability?
Una stima di settore del 2026 lo valuta in 3,51 miliardi di USD e prevede 6,03 miliardi di USD entro il 2031, con un CAGR dell'11,42% tra il 2026 e il 2031. La crescita riflette la crescente sovrapposizione tra governance, affidabilità e responsabilità operativa, più che una tendenza passeggera negli strumenti.


