Tableau de bord de suivi des KPI : conception et mise en œuvre
|
6
minute de lecture

La plupart des conseils sur un tableau de bord de suivi des KPI partent du mauvais endroit. Les équipes s'obsèdent sur les styles de graphiques, les palettes de couleurs et les grilles de mise en page, puis s'étonnent que les parties prenantes cessent de faire confiance aux chiffres. En entreprise, les tableaux de bord échouent rarement parce qu'ils sont laids : ils échouent parce que les données sous-jacentes changent de structure, deviennent obsolètes ou s'éloignent de la définition métier que tout le monde croyait utiliser.
Un tableau de bord peut être à la fois visuellement impeccable et dangereux sur le plan opérationnel. Si l'équipe finance, un workflow CRM et un modèle marketing calculent chacun le même KPI différemment, le graphique peut sembler soigné alors que la décision qu'il soutient est déjà compromise. C'est pourquoi un suivi fiable commence par la confiance, pas par la décoration, et pourquoi les meilleurs tableaux de bord fonctionnent moins comme des tableaux de scores que comme des systèmes de contrôle.
Table des matières
Pourquoi la plupart des tableaux de bord de suivi des KPI échouent
Choisir des métriques qui déclenchent de vraies actions métier
Concevoir des mises en page pour le management par exception
Mettre en place l'alerting et les contrôles d'observabilité des données
Maintenir la gouvernance des métriques et l'intégrité sémantique
Pourquoi la plupart des tableaux de bord de suivi des KPI échouent
Le mode d'échec le plus courant est simple. Les équipes construisent un tableau de bord qui semble complet, puis supposent que la présence de graphiques signifie que la métrique sous-jacente est stable. En réalité, un tableau de bord de suivi des KPI devient souvent fragile dès que les données en amont évoluent, qu'une transformation change ou qu'une règle métier est réécrite sans que personne ne mette à jour la couche de définition.
Une belle vue peut masquer de profonds problèmes opérationnels. L'un des exemples les plus parlants est l'écart entre ce que voient les utilisateurs et ce que fait réellement le pipeline de données. Si le tableau de bord est alimenté par un cycle de rechargement nocturne avec historique conservé, comme dans le guide KPI public du comté de Los Angeles, il fonctionne déjà comme un système opérationnel plutôt que comme un rapport statique, car sa valeur vient de la continuité, de l'historique et d'un rafraîchissement maîtrisé, et pas seulement de la présentation (guide utilisateur des tableaux de bord KPI du comté de Los Angeles).
La dérive silencieuse détruit la confiance
La dérive silencieuse est pire qu'un graphique cassé, car elle ne se signale pas. Un graphique avec des données manquantes paraît suspect, mais un graphique à la logique légèrement fausse semble souvent assez normal pour passer la revue. C'est tout le danger en environnement d'entreprise, surtout lorsque différentes équipes calculent le même KPI à partir de systèmes sources différents.
La confiance meurt bien avant que le graphique ne semble cassé.
La réponse pragmatique consiste à traiter le tableau de bord comme un produit supervisé, et non comme un artefact statique. Cela signifie surveiller ensemble les entrées, la définition et les usages. L'usage compte, car la valeur d'un tableau de bord se mesure souvent au fait que les utilisateurs visés l'ouvrent sur une période donnée ; les recommandations sur l'adoption suivent couramment les lecteurs actifs hebdomadaires, le taux de retour d'une semaine à l'autre, le volume d'exports et le nombre de citations en revue métier (recommandations sur l'adoption des tableaux de bord).
Un tableau de bord que personne ne rouvre vous dit généralement quelque chose. Soit les données sont obsolètes, soit les définitions sont confuses, soit la mise en page noie le signal sous trop de bruit. Pour une approche concrète de la qualité, une référence interne utile est l'article pourquoi les problèmes de données continuent de créer des conflits et comment améliorer la qualité des données, car les conflits autour des données sont souvent, au fond, des conflits de confiance, de responsabilité ou de lignage.
Choisir des métriques qui déclenchent de vraies actions métier
Un tableau de bord rempli de métriques de vanité est pire qu'un écran vide. Il crée l'illusion du contrôle tout en ne laissant aux opérationnels aucun levier d'action. Choisissez des KPI associés à une conséquence métier, à un seuil et à un responsable nommé.
Commencez par la décision, pas par le graphique. Demandez-vous quelle action doit suivre si le KPI bouge, qui doit la mener et quelle ampleur le changement doit atteindre avant de mériter l'attention. Si ces trois réponses ne sont pas claires, la métrique a sa place dans un rapport, pas dans un tableau de bord de suivi.

Construire la métrique autour de la décision
Un KPI utile remplit trois conditions. Il reflète un résultat métier plutôt qu'une activité brute. Il possède une zone d'alerte et une zone critique. Et il a un responsable humain capable d'agir lorsque la métrique franchit une limite.
Cette structure correspond aux recommandations pratiques du management par exception, où chaque KPI dispose d'une cible, d'un seuil d'alerte et d'un seuil critique. Elle invite aussi à limiter la vue principale à environ 5 à 10 KPI, afin que le tableau de bord ne se transforme pas en backlog visuel (bonnes pratiques de Domo pour les tableaux de bord KPI). L'objectif n'est pas de réduire l'information au minimum, mais de préserver l'attention pour les anomalies qui méritent une action.
Règle pratique : si une métrique ne déclenche aucune réaction, ce n'est pas un KPI de suivi, c'est une valeur de référence.
Les OKR et les KPI ne remplissent pas le même rôle. Un OKR décrit une direction ou un objectif. Un KPI vérifie que le système se comporte comme prévu. Le guide OKR vs KPI pour les dirigeants aide les équipes à séparer l'ambition du pilotage opérationnel.
La responsabilité compte autant que la métrique elle-même. Les recommandations sur les tableaux de bord KPI en temps réel préconisent des limites fixes liées à l'impact métier, ainsi qu'un responsable désigné, afin qu'une baisse entraîne une escalade plutôt qu'une observation passive (recommandations sur les tableaux de bord KPI en temps réel). Si un seuil est franchi et que personne ne sait à qui revient la réponse, le tableau de bord ne fait que documenter l'échec.
Pour les équipes qui construisent un reporting qualité en parallèle du suivi, l'approche de digna en matière de reporting sur la qualité des données est utile, car elle privilégie des preuves structurées plutôt qu'une interprétation approximative. C'est essentiel lorsque le KPI touche l'audit, la finance ou des activités réglementées.
Concevoir des mises en page pour le management par exception
Les meilleurs tableaux de bord restent silencieux jusqu'à ce que quelque chose change. Les métriques stables doivent rester en arrière-plan, et la mise en page doit orienter l'attention vers les quelques signaux qui exigent une action. Cette approche correspond à la manière dont travaillent les équipes opérationnelles : par sessions courtes, sous pression, avec peu de tolérance pour le bruit.
Le management par exception fonctionne parce que personne ne peut parcourir cinquante jauges et leur accorder le même poids. La mise en page doit hiérarchiser les signaux avant même que l'utilisateur ne les voie. Des seuils clairs, des métriques stables atténuées et un état d'échec unique et évident font ce travail à la place du lecteur.

Concevoir pour l'attention sélective
Placez uniquement les indicateurs les plus importants sur le plan opérationnel dans la vue principale, puis reléguez les diagnostics complémentaires plus bas. Cela évite que le tableau de bord devienne un mur de tuiles de même poids où rien ne ressort.
La fatigue d'alerte est le compromis à surveiller. Si chaque métrique est traitée comme une urgence, aucune n'est entendue. Des seuils d'avertissement et d'astreinte donnent du sens au signal lorsqu'une alerte se déclenche enfin, et l'équipe réagit avec plus d'attention parce que l'escalade est précise.
Une bonne mise en page rend aussi la stabilité visible. Lorsqu'un KPI reste dans sa plage cible, c'est une information utile, car elle indique à l'équipe où ne pas passer de temps. Les recommandations pour l'entreprise font le même constat sous un autre angle : définitions cachées, rafraîchissements obsolètes et absence de responsable sont des modes d'échec fréquents dans une vue principale surchargée (bonnes pratiques de Domo pour les tableaux de bord KPI).
Une structure pratique organise la vue par niveau d'urgence.
Niveau supérieur : les KPI qui exigent un examen immédiat lorsqu'ils franchissent un seuil.
Niveau intermédiaire : le contexte des tendances et les comparaisons complémentaires.
Niveau inférieur : les vues détaillées, le lignage et le diagnostic.
Cette hiérarchie s'articule bien avec les workflows qualité internes, en particulier lorsqu'une équipe utilise les tableaux de bord de qualité des données de digna comme couche de diagnostic sous les métriques métier. Le tableau de bord devient alors un point d'entrée vers l'investigation plutôt qu'une impasse.
Mettre en place l'alerting et les contrôles d'observabilité des données
Un KPI n'est fiable que si le pipeline qui l'alimente l'est aussi. C'est pourquoi l'alerting doit commencer sous la couche métier, là où la fraîcheur, le schéma, le volume et les taux de valeurs nulles peuvent être vérifiés avant que des données erronées n'atteignent un tableau de bord de direction. Une fois ces contrôles en place, la supervision cesse d'être un théâtre réactif et commence à fonctionner comme un véritable système de gestion des incidents.
Le modèle le plus efficace que j'aie observé est une chaîne de contrôle qui suit les données à chaque étape. D'abord, recensez les étapes du pipeline. Ensuite, définissez les modes d'échec, comme les fichiers manquants, les doublons, le schema drift ou les chargements obsolètes. Enfin, codez les contrôles sous forme de requêtes exécutables et conservez les résultats pour que chaque exécution laisse une trace historique.
Transformer les contrôles en preuves d'incident
L'historique des contrôles est précieux, car il permet aux équipes de voir des tendances, et pas seulement des échecs. Une alerte ponctuelle vous dit que quelque chose a cassé aujourd'hui. Un historique conservé vous dit si le problème est récurrent, s'il s'étend ou s'il se déplace d'une étape à l'autre. C'est une base bien plus utile pour l'escalade.
La couche d'observabilité doit aussi correspondre directement à des piliers de contrôle connus. L'observabilité des données s'organise couramment autour de la fraîcheur, la distribution, le volume, le schéma et le lignage, qui correspondent aux contrôles de ponctualité, à la détection d'anomalies, aux contrôles d'exhaustivité, à la détection des changements structurels et au suivi de la provenance (piliers de l'observabilité des données). En pratique, ces piliers sont plus faciles à gérer lorsque les contrôles sont explicites et rattachés à des responsables.
Un bon jeu de contrôles est précis. Les recommandations sur le monitoring de la qualité des données préconisent de vérifier la fraîcheur, le volume de lignes, le schema drift, les valeurs nulles dans les colonnes obligatoires, l'unicité des clés primaires et les valeurs ou plages autorisées, à l'ingestion, après transformation et à nouveau au niveau de la table de restitution, avec des contrôles bloquants à chaque exécution et des tâches de rapprochement quotidiennes (bonnes pratiques de qualité des données). C'est aussi le bon état d'esprit pour les systèmes de KPI, car le tableau de bord ne devrait jamais être le premier endroit où des données erronées deviennent visibles.
Attribuez chaque constat à un responsable nommé. Si personne n'en répond, l'alerte devient du bruit.
Le monitoring du schéma mérite un traitement à part, car les changements structurels peuvent casser la logique en aval même lorsque le nombre de lignes semble correct. Les travaux de recherche sur les systèmes d'observabilité décrivent des alertes qui se déclenchent lorsque les métadonnées des tables sources changent, afin que les structures ajoutées, supprimées ou modifiées soient détectées avant que les hypothèses de reporting ne soient invalidées (recherche sur le monitoring des changements de schéma). Ce contrôle est particulièrement important dans la finance, la santé, les télécoms et le secteur public, où le coût d'une erreur de reporting silencieuse est bien plus élevé que celui d'un contrôle trop bavard.
Une référence interne pratique pour cette couche est l'observabilité des données de digna, puisque cette catégorie réunit la ponctualité, la validation, la détection d'anomalies et le suivi des schémas dans une seule vue opérationnelle.
Adapter les vues aux différentes équipes
Un seul tableau de bord convient rarement à toutes les parties prenantes. Les data engineers ont besoin de signaux d'échec, les analystes de contexte, et les dirigeants d'une vue synthétique qui aide à décider sans les obliger à trier le bruit des pipelines. Si vous donnez le même écran aux trois groupes, les profils techniques passent à côté des détails dont ils ont besoin et les profils métier sont noyés sous l'encombrement.
La meilleure approche consiste en une couche de métriques gouvernée unique, surmontée de vues propres à chaque rôle. Les définitions des KPI restent ainsi alignées, tandis que chaque équipe voit le niveau de détail sur lequel elle peut agir.
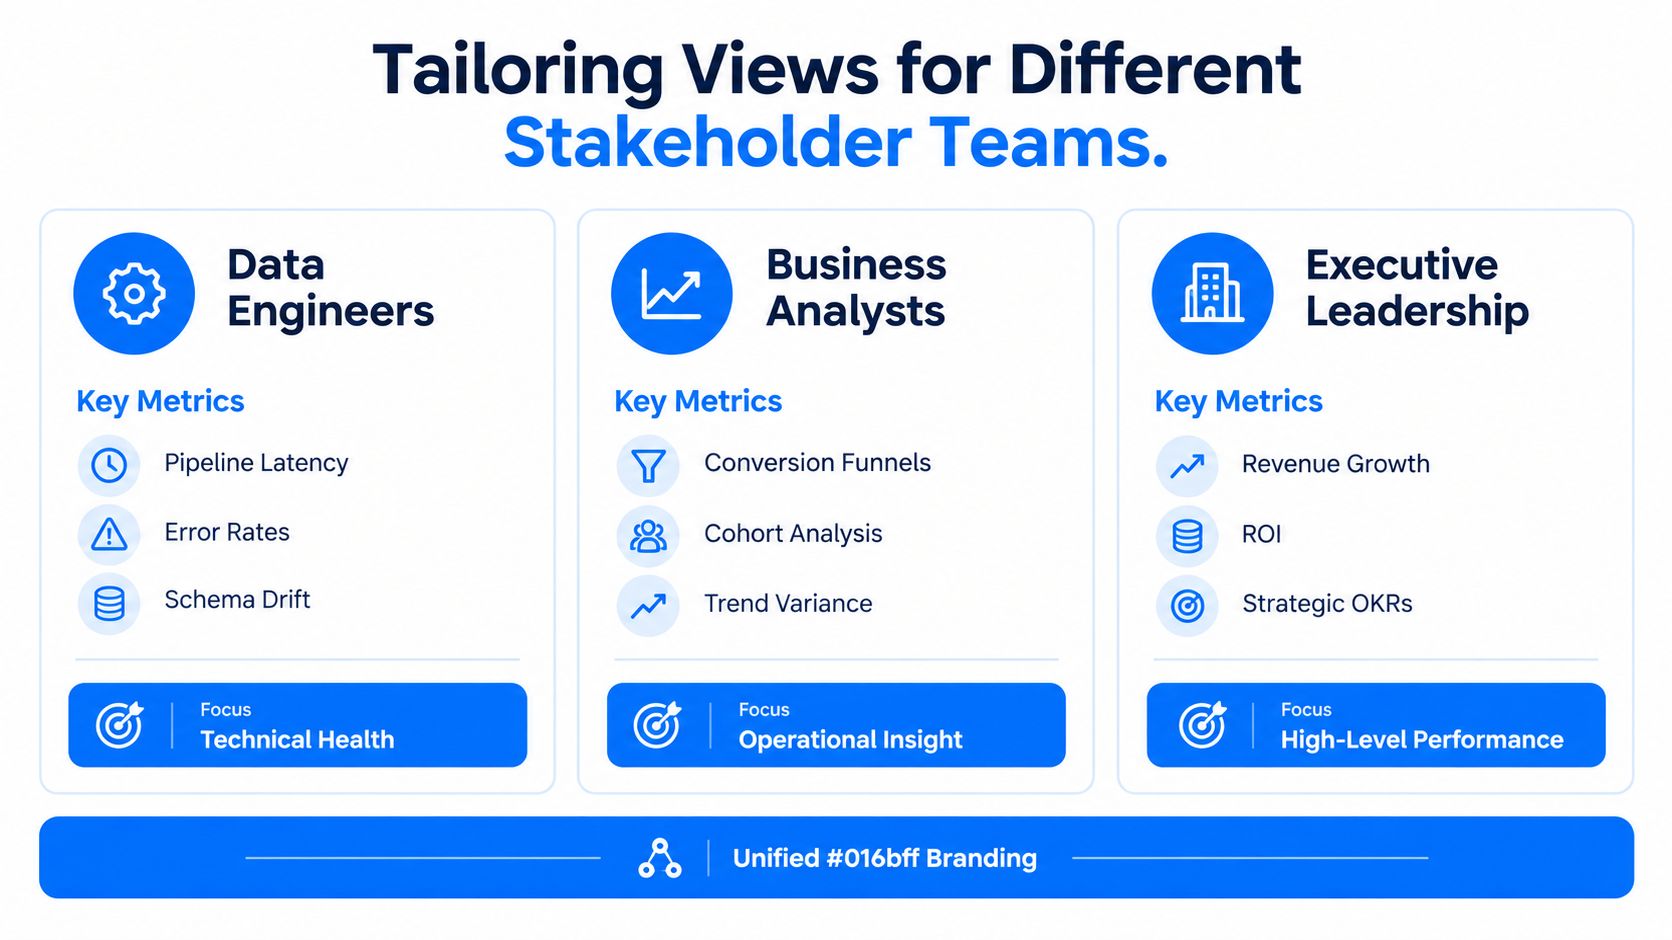
Ingénieur, analyste, dirigeant
Les data engineers ont besoin de signaux sur la santé technique. Ils doivent voir si des chargements sont en retard, si des schémas ont changé, si des contrôles échouent ou si une hypothèse de lignage est rompue. Leur vue doit exposer le pipeline, pas seulement le résultat métier. Si la métrique restituée est fausse, ils ont besoin d'un chemin rapide vers la source.
Les analystes métier ont besoin d'un contexte qu'ils peuvent expliquer. Les tendances, les écarts et les schémas opérationnels comptent, mais pas un mur de bruit d'infrastructure. Il leur faut suffisamment de détails sur le lignage et la définition pour expliquer pourquoi le KPI a bougé, sans devoir reconstruire la métrique de zéro.
Les dirigeants ont besoin d'une vision compacte de la performance. Ils veulent un petit ensemble d'indicateurs qui montre si l'activité est sur la bonne trajectoire, en dérive ou sous pression. S'ils exportent la synthèse dans des slides pour la reconstruire ailleurs, la vue de direction ne porte pas la décision.
L'usage par rôle est un meilleur signal que les statistiques de trafic génériques. Si la vue d'ingénierie est ignorée pendant les incidents, si les analystes exportent sans cesse une métrique retraitée vers des tableurs, ou si les dirigeants contournent le tableau de bord au profit d'une synthèse séparée, la vue ne correspond pas à la mission qu'elle est censée remplir.
Une manière utile de structurer les vues est simple.
Ingénieurs : latence des pipelines, schema drift, contrôles en échec, ruptures de lignage.
Analystes : écarts de tendance, comportements par cohorte, contexte des métriques, explication des exceptions.
Dirigeants : une synthèse resserrée de la santé de l'activité, avec un statut clair par rapport aux seuils.
Une référence pratique pour construire ce type d'organisation par rôle est l'analytique en libre-service de digna. Le libre-service ne fonctionne que si la couche gouvernée sous-jacente est suffisamment fiable pour que différents utilisateurs s'y appuient sans recréer la métrique dans leur propre tableur.
Maintenir la gouvernance des métriques et l'intégrité sémantique
Le tableau de bord le plus dangereux est celui qui semble juste tout en calculant la mauvaise chose. Cela arrive lorsque les définitions des KPI dérivent entre les systèmes finance, marketing, CRM ou opérationnels, et que personne ne vérifie en continu si un même libellé correspond toujours au même calcul. À ce stade, le graphique n'est plus une source de vérité, c'est une source de confusion.
La gouvernance des métriques est la couche manquante de nombreux projets de tableaux de bord. Les équipes consacrent souvent tous leurs efforts à la mise en page et aux seuils, puis laissent la couche sémantique sans surveillance. Il en résulte une faille où un KPI peut rester visuellement stable alors que la logique sous-jacente change, et c'est exactement ainsi que s'installent le risque d'audit et le risque décisionnel.
Gouverner la définition, pas seulement l'affichage
Une stratégie de suivi sérieuse doit permettre de détecter la dérive des définitions. Cela implique de repérer les désaccords sur la source de vérité, les données obsolètes, les changements de transformation en amont et les incohérences de logique métier avant qu'ils ne se propagent dans les rapports. C'est particulièrement important dans les environnements réglementés, où une logique de KPI incohérente peut créer des problèmes de conformité bien avant qu'une tendance visuelle ne paraisse suspecte.
La démarche pragmatique consiste à traiter les définitions de métriques comme des actifs de production. Versionnez-les, documentez-les et surveillez le moment où un consommateur en aval ne correspond plus au calcul de référence. Ce n'est pas un problème de visualisation, c'est un problème d'intégrité sémantique.
Des analyses indépendantes ont déjà mis en garde contre les métriques contradictoires, les désaccords sur la source de vérité, les données obsolètes et l'absence de contexte opérationnel, ce qui mène à la même conclusion : le problème de fond relève de la gouvernance, pas du cadre du tableau de bord. Pour les grandes entreprises, le risque est plus important, car différentes équipes peuvent extraire le même KPI de systèmes différents sans jamais réaliser qu'elles divergent, jusqu'à ce qu'une revue métier ou un audit le révèle. Une référence interne utile sur ce sujet est la couche sémantique dbt vue par digna, car c'est dans la couche sémantique que des définitions cohérentes tiennent ou s'effondrent.
La norme pratique est simple.
Définir le KPI une seule fois.
Suivre où il est réutilisé.
Alerter lorsque sa signification change.
Documenter le responsable qui approuve le changement.
Lorsque cette discipline est en place, le tableau de bord devient suffisamment crédible pour un usage opérationnel. Sans elle, même l'interface la plus soignée n'est qu'une manière très élégante de propager l'ambiguïté.
Si vous voulez construire un tableau de bord de suivi des KPI qui détecte la dérive silencieuse, et pas seulement de jolis graphiques, travaillez avec digna. Ses capacités de qualité et d'observabilité des données aident les équipes à surveiller la fraîcheur, la validation, les changements de schéma et les métriques métier au sein de leur propre environnement. Rendez-vous sur digna pour découvrir comment il s'intègre dans une supervision gouvernée.
Lorsque les KPI du tableau de bord sont des métriques métier comme le chiffre d'affaires, les commandes ou le nombre de transactions, la même logique d'exception peut s'appliquer directement aux métriques : le business monitoring de digna apprend le comportement normal de chaque métrique et signale une variation avant qu'elle n'atteigne la vue de direction.
Questions fréquentes
Combien de KPI un tableau de bord de suivi des KPI doit-il afficher ?
Limitez la vue principale à environ 5 à 10 KPI. Chacun doit avoir une cible, un seuil d'alerte, un seuil critique et un responsable nommé. Les tendances et diagnostics complémentaires relèvent de niveaux plus profonds, afin que les quelques signaux qui exigent une action ne soient pas noyés parmi des tuiles de même poids.
Pourquoi les utilisateurs cessent-ils de faire confiance aux tableaux de bord KPI ?
Rarement parce que les graphiques sont laids. La confiance s'érode lorsque les données deviennent obsolètes, que les schémas changent en amont ou que les équipes calculent le même KPI différemment dans les systèmes finance, CRM et marketing. La dérive silencieuse est le vrai danger, car un chiffre légèrement faux semble encore assez normal pour passer la revue.
Qu'est-ce que le management par exception dans la conception de tableaux de bord ?
C'est une approche de mise en page où les métriques stables restent visuellement discrètes et où seuls les KPI qui franchissent un seuil attirent l'attention. Un niveau supérieur regroupe les métriques à examiner immédiatement, un niveau intermédiaire apporte le contexte des tendances et un niveau inférieur propose des vues détaillées et le lignage pour le diagnostic.
Quels contrôles de données exécuter avant qu'un KPI n'atteigne le tableau de bord ?
Vérifiez la fraîcheur, le volume de lignes, le schema drift, les valeurs nulles dans les colonnes obligatoires, l'unicité des clés primaires et les plages de valeurs autorisées. Exécutez ces contrôles à l'ingestion, après transformation et à nouveau au niveau de la table de restitution, et conservez chaque résultat pour que les problèmes récurrents ou croissants deviennent visibles dans le temps.
Comment empêcher la définition d'un KPI de dériver d'une équipe à l'autre ?
Traitez les définitions de métriques comme des actifs de production. Définissez chaque KPI une seule fois, versionnez-le et documentez-le, suivez tous les endroits où il est réutilisé et déclenchez une alerte lorsqu'un calcul en aval ne correspond plus au calcul de référence. Un responsable nommé doit approuver chaque modification de la définition.


