Compter les lignes d'un fichier : méthodes rapides pour tout OS
|
5
minute de lecture

Vous avez sous les yeux un fichier journal, un export CSV ou une entrée de pipeline, et le décompte est décalé d'une unité. Le fichier semble correct dans votre éditeur, mais le script affirme le contraire, et ce minuscule écart peut faire échouer un chargement, un contrôle de validation ou une étape de validation de déploiement.
La cause n'est généralement pas un outil défaillant. C'est un problème de définition. Compter les lignes d'un fichier paraît simple jusqu'à ce que les fins de ligne, l'absence de saut de ligne final, les conventions Windows et Unix et les choix d'encodage commencent à modifier ce que signifie « une ligne ».
Table des matières
Le piège caché des simples comptages de lignes
Un schéma d'échec courant apparaît lorsqu'un pipeline de données attend un nombre d'enregistrements exact, puis qu'un fichier arrive sans saut de ligne final. L'éditeur affiche une dernière ligne, mais le comptage en ligne de commande ne concorde pas. Cet écart suffit à déclencher une fausse alerte dans une tâche d'import ou à fausser un contrôle de fraîcheur.
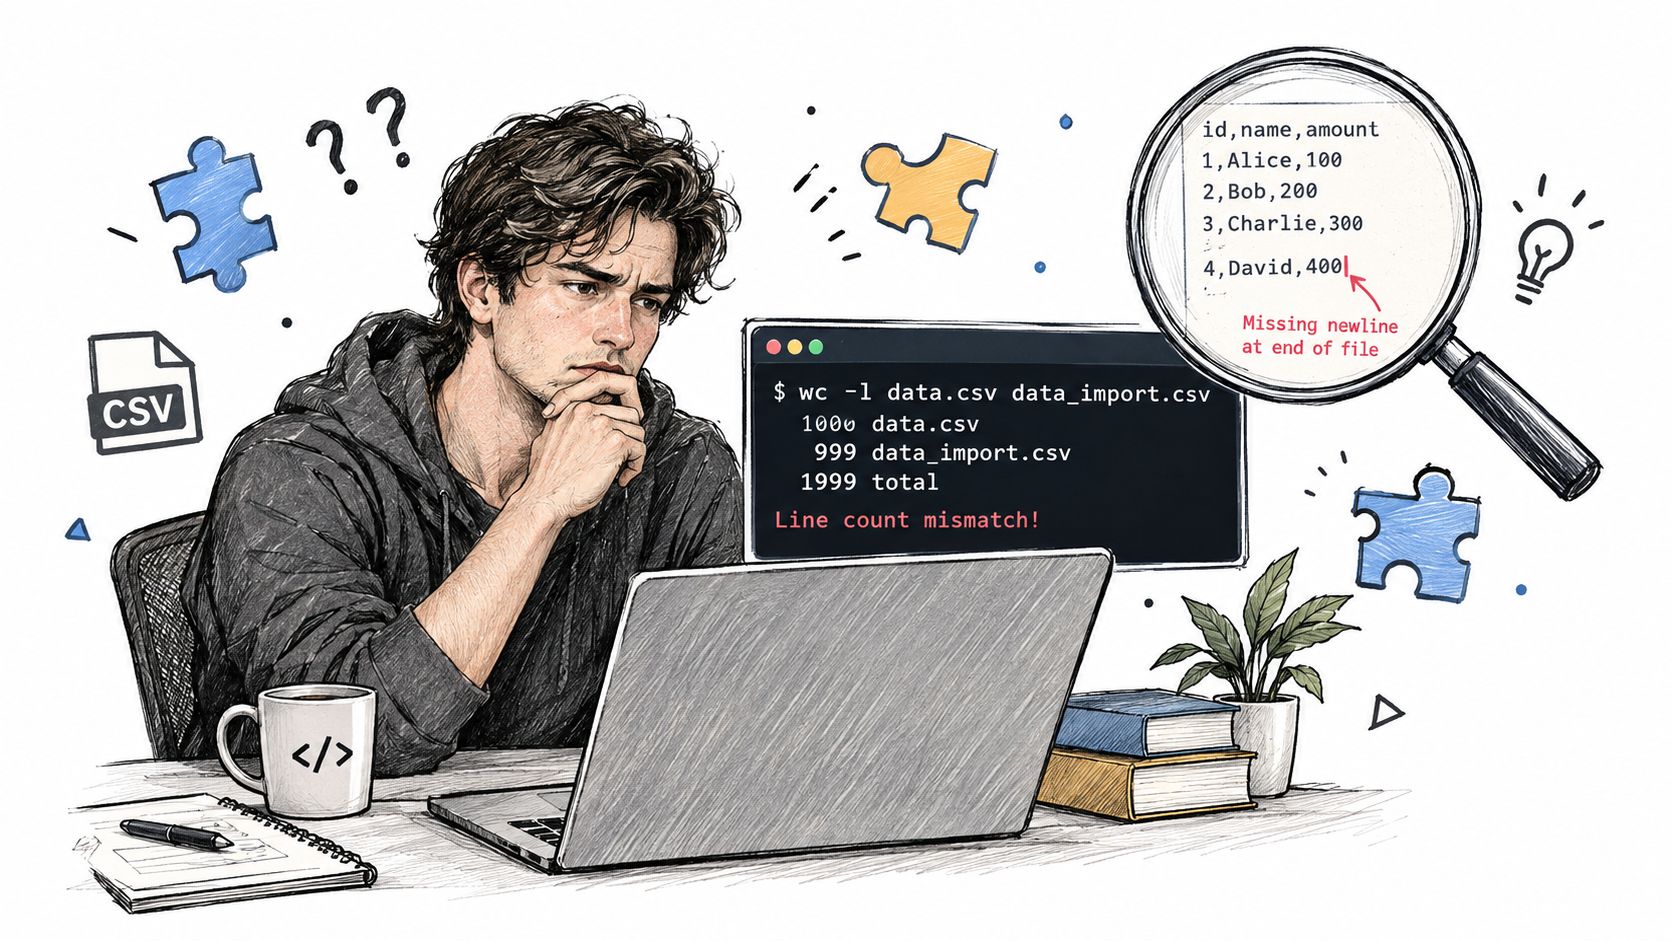
Le fond du problème est que les outils comptent souvent les caractères de fin de ligne, et non ce que les humains considèrent comme des lignes visuelles. GNU wc -l se comporte ainsi et ne comptera pas une dernière ligne partielle si le fichier se termine sans saut de ligne : un fichier d'une seule ligne peut donc afficher 0 ligne dans ce cas limite (manuel de wc de GNU). C'est cette même divergence sémantique qui fait que la question n'est pas seulement « quelle commande est la plus rapide », mais « que doit signifier le décompte ».
Règle pratique : si le décompte alimente une automatisation, décidez dès le départ si ce sont les sauts de ligne physiques ou les enregistrements logiques qui vous intéressent.
Cette distinction compte dans les fichiers générés, les journaux et les flux qui ne sont pas modifiés à la main. Un analyseur peut considérer la dernière ligne comme présente même en l'absence de saut de ligne, alors qu'un outil de comptage en shell peut ne pas le faire. Pour le travail sur la qualité des données, ce décalage relève de la même discussion que les règles de validation et la complétude des enregistrements, c'est pourquoi un contrôle structuré comme l'approche de digna en matière de validation des données et de qualité continue constitue un meilleur cadre de réflexion que « compter simplement les lignes ».
Compter les lignes sous Linux et macOS
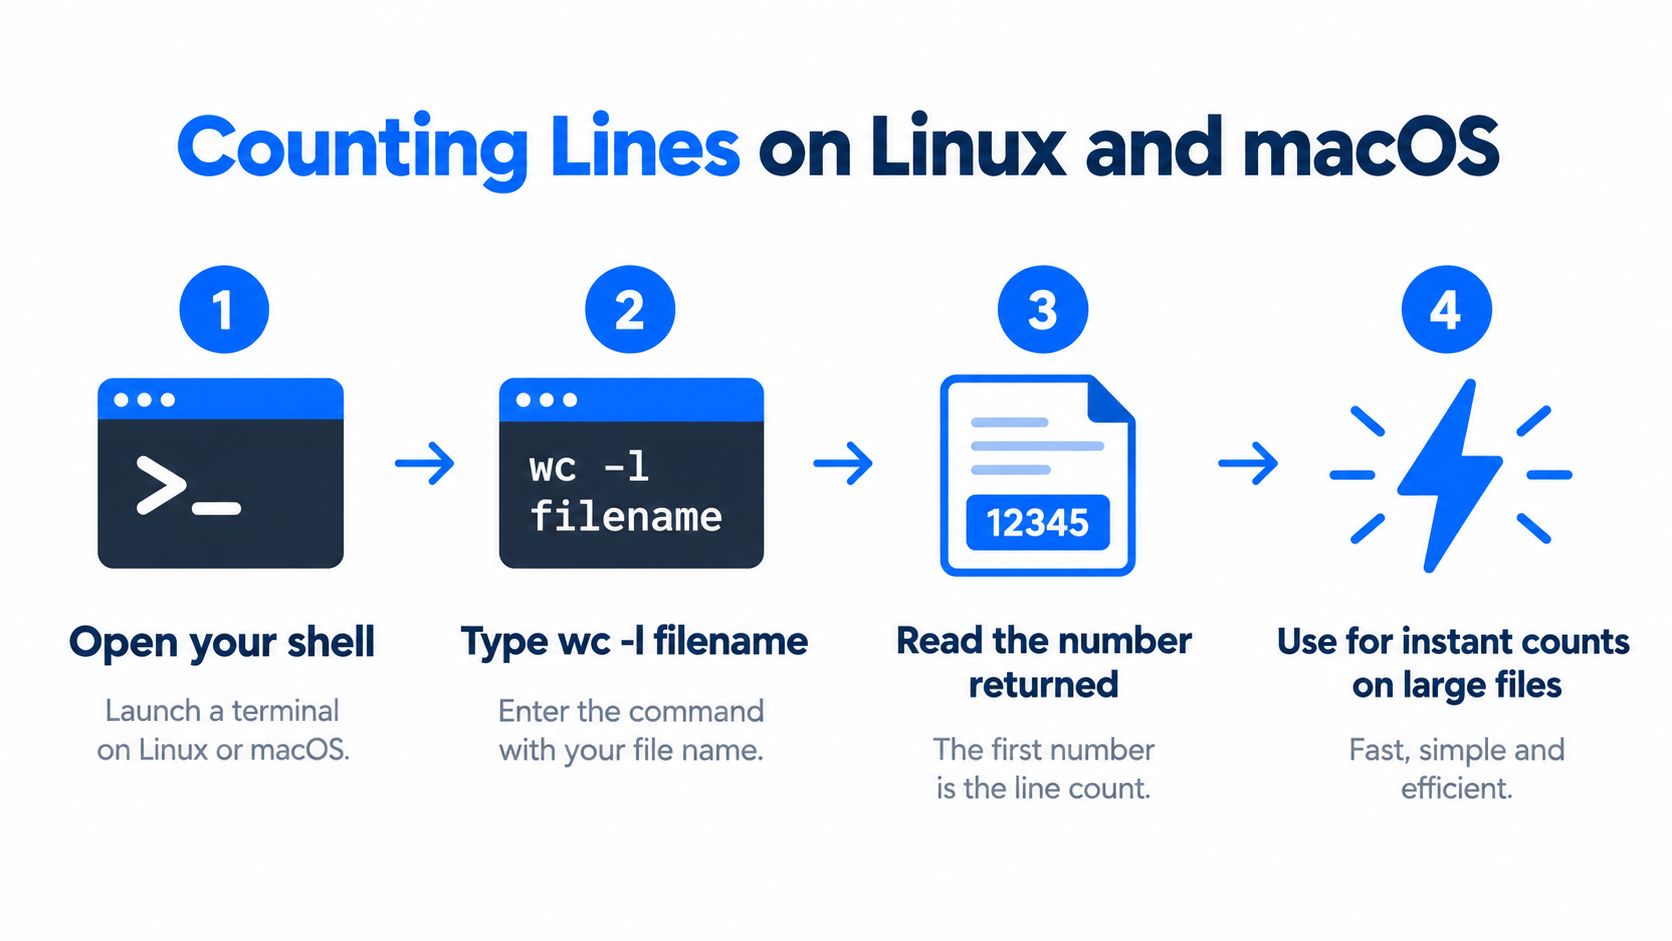
Sous Linux et macOS, commencez par wc -l. Cette commande fait partie du traitement de texte Unix depuis longtemps et reste le choix le plus rapide pour de simples comptages de lignes, car elle est simple, native du shell et facile à intégrer dans un script.
Les commandes à exécuter
Utilisez celle-ci lorsque vous voulez le nom du fichier dans la sortie :
wc -l filename
Utilisez celle-ci lorsque vous ne voulez que le nombre :
wc -l < filename
La seconde forme est plus propre pour les scripts, car elle supprime le nom du fichier et ne renvoie que le décompte. Les pages de manuel actuelles décrivent wc comme affichant le nombre de sauts de ligne, de mots, d'octets et de caractères, et l'outil prend également en charge les totaux lorsque vous lui transmettez plusieurs fichiers. Les exemples de traitement de texte de Red Hat illustrent le même style de comptage simple en shell, notamment grep -c '.' /usr/share/dict/words qui renvoie 479 826 lignes correspondantes (exemples de traitement de texte de Red Hat).
Quand la vitesse compte
Pour de simples totaux, wc -l est généralement la bonne réponse, car il parcourt directement les flux d'octets. Lors d'un test de performance sur un fichier synthétique de 110 Mo / 10 000 000 de lignes, wc -l < big.txt s'est terminé en 0,13 s contre 0,33 s pour awk 'END{print NR}' big.txt, AWK étant donc environ 2,5 fois plus lent dans ce test (détails du test de performance). Utilisez awk lorsque vous avez besoin de filtrage ou d'une logique par fichier. Conservez wc -l lorsque seul le décompte vous intéresse.
Habitude opérationnelle : utilisez d'abord
wc -l, puis passez à AWK uniquement lorsque le décompte fait partie d'une transformation plus large.
Pour les tâches d'ingestion de fichiers, placez le décompte à côté de vos contrôles de zone d'atterrissage et de la validation des enregistrements, en particulier si les données transitent par le pipeline d'ingestion de données de digna. L'objectif est de lever toute ambiguïté avant que le fichier ne poursuive son chemin en aval.
Compter les lignes sous Windows et PowerShell
Windows vous offre deux voies pratiques : PowerShell et CMD. PowerShell est la plus propre pour compter les lignes, car il manipule le contenu des fichiers sous forme d'objets, tandis que CMD repose encore sur d'anciennes astuces textuelles qui fonctionnent mais sont peu pratiques à automatiser.
PowerShell en priorité
Le comptage de base est le suivant :
(Get-Content "file.txt").Count
Pour une sortie adaptée aux pipelines, utilisez :
(Get-Content "file.txt" | Measure-Object -Line).Lines
La documentation PowerShell indique que Get-Content renvoie par défaut le contenu du fichier sous forme de tableau de chaînes délimitées par des sauts de ligne, tandis que -Raw renvoie l'ensemble du fichier sous forme d'une seule chaîne en conservant les sauts de ligne ; si le délimiteur n'existe pas, Get-Content peut renvoyer tout le fichier sous la forme d'un seul objet non délimité (documentation PowerShell de Get-Content, documentation PowerShell 5.1). C'est important, car le décompte peut varier selon que PowerShell traite le fichier comme une collection de lignes ou comme un bloc de texte unique.
CMD quand vous n'avez pas le choix
CMD ne dispose d'aucun équivalent direct à wc -l. La solution de contournement habituelle est :
find /c /v "" file.txt
La sortie inclut le nom du fichier et une mise en forme supplémentaire : elle convient donc pour des vérifications rapides, mais s'avère peu pratique dans les scripts. Si vous avez besoin du décompte dans une automatisation, encapsulez-la dans une boucle for /f, même si PowerShell reste le choix le plus adapté.
Règle empirique : utilisez PowerShell pour les scripts, et CMD uniquement lorsque la machine est verrouillée et que rien d'autre n'est disponible.
Si vous développez des automatisations Windows et avez besoin d'un contrôle de qualité de base avant une validation plus approfondie, le comptage des lignes est souvent le premier test peu coûteux. Une plateforme comme digna peut y trouver sa place en tant qu'option d'observabilité au niveau des jeux de données, car elle suit l'évolution du nombre de lignes dans le temps au lieu de traiter chaque fichier de manière isolée.
Compter les lignes avec Python pour les fichiers volumineux
Python est un bon choix lorsque le fichier est volumineux, que la plateforme varie ou que le comptage des lignes s'inscrit dans un traitement plus large. Le piège consiste à charger l'intégralité du fichier en mémoire alors que vous n'avez besoin que d'un décompte.
Utiliser des lectures binaires avec tampon
Ouvrez le fichier en mode binaire, lisez-le par blocs de 64 Kio ou plus, comptez les octets \n et ajoutez une ligne supplémentaire uniquement si le fichier n'est pas vide et ne se termine pas par \n. Vous évitez ainsi les E/S caractère par caractère, qui sont lentes dans n'importe quel langage. Un test de performance en C a montré que fgetc/fputc prenait 5,90 s pour un passage sur 150 Mo, tandis que fread/fwrite par blocs de 65 536 octets prenait 0,63 s (notes de test de performance en C), soit le même goulet d'étranglement que la boucle Python évite en lisant des blocs de 64 Kio.
Pourquoi la lecture par blocs l'emporte
L'analyse binaire est portable, mais la sémantique reste importante. Le comptage des sauts de ligne mesure les sauts de ligne physiques : les \r\n de Windows, l'absence de saut de ligne final et les sauts de ligne intégrés dans les enregistrements peuvent donc modifier le résultat si vous attendez des lignes logiques plutôt que des lignes de texte brutes. Le mode binaire de Python et bytes.count rendent ce comportement explicite, et la règle relative aux sauts de ligne est la même que celle décrite dans les recommandations de File::CountLines.
Pour les contrôles de pipeline, des statistiques structurées sur les lignes sont souvent plus utiles que des décomptes ponctuels. Un outil qui surveille l'évolution du nombre de lignes dans le temps, comme l'approche d'observabilité de digna axée sur les anomalies, est pertinent lorsqu'un chargement incomplet importe davantage que la commande exacte utilisée pour le repérer.
Cas limites et pièges sémantiques
Le comptage au niveau des octets n'est pas universel. Les encodages non compatibles ASCII, comme UTF-16 ou UTF-32, peuvent fausser un comptage de lignes naïf, et les conventions de fin de ligne diffèrent entre Unix et Windows. Un fichier peut également contenir des enregistrements qui semblent complets dans un éditeur, mais qui se comportent différemment lorsqu'un outil lit les octets bruts.
GNU grep -c compte les lignes correspondantes, et son comportement orienté lignes peut varier lorsque le dernier octet n'est pas un saut de ligne (manuel GNU grep). C'est important dans les pipelines où le décompte fait partie de la validation, et ne se limite pas à une vérification rapide.
L'encodage change la donne
Les approches caractère par caractère sont mal adaptées aux fichiers volumineux. Le problème pratique ne tient pas seulement à la vitesse, mais aussi à l'interprétation. UTF-16 et UTF-32 stockent le texte d'une manière qui rend les simples analyses d'octets peu fiables, si bien qu'un outil qui suppose des sauts de ligne de type ASCII peut renvoyer un résultat erroné.
Python vous offre davantage de contrôle à cet égard, mais l'approche la plus sûre dépend toujours du format du fichier et de la manière dont il a été produit. Dans le stockage structuré, le nombre de lignes peut relever du format lui-même plutôt que de la couche texte, c'est pourquoi les pipelines basés sur Parquet nécessitent des contrôles différents de ceux des fichiers texte brut.
Les conventions de fin de ligne ne sont pas interchangeables
Unix utilise \n, Windows utilise généralement \r\n, et un même fichier peut être traité différemment selon l'outil. Get-Content de PowerShell renvoie par défaut le texte délimité par des sauts de ligne sous forme de chaînes, tandis que -Raw conserve le fichier sous forme d'une seule chaîne : la forme de la sortie modifie donc la méthode de comptage (documentation PowerShell de Get-Content).
Si vous contrôlez des fichiers générés, cette différence compte davantage que le nom de la commande. Un décompte correct pour du texte brut peut être erroné pour des enregistrements logiques.
Voilà le piège. Le comptage dans un fichier n'est simple que lorsque l'encodage, la convention de fin de ligne et le modèle d'enregistrement concordent.
Choisir la méthode adaptée à vos besoins
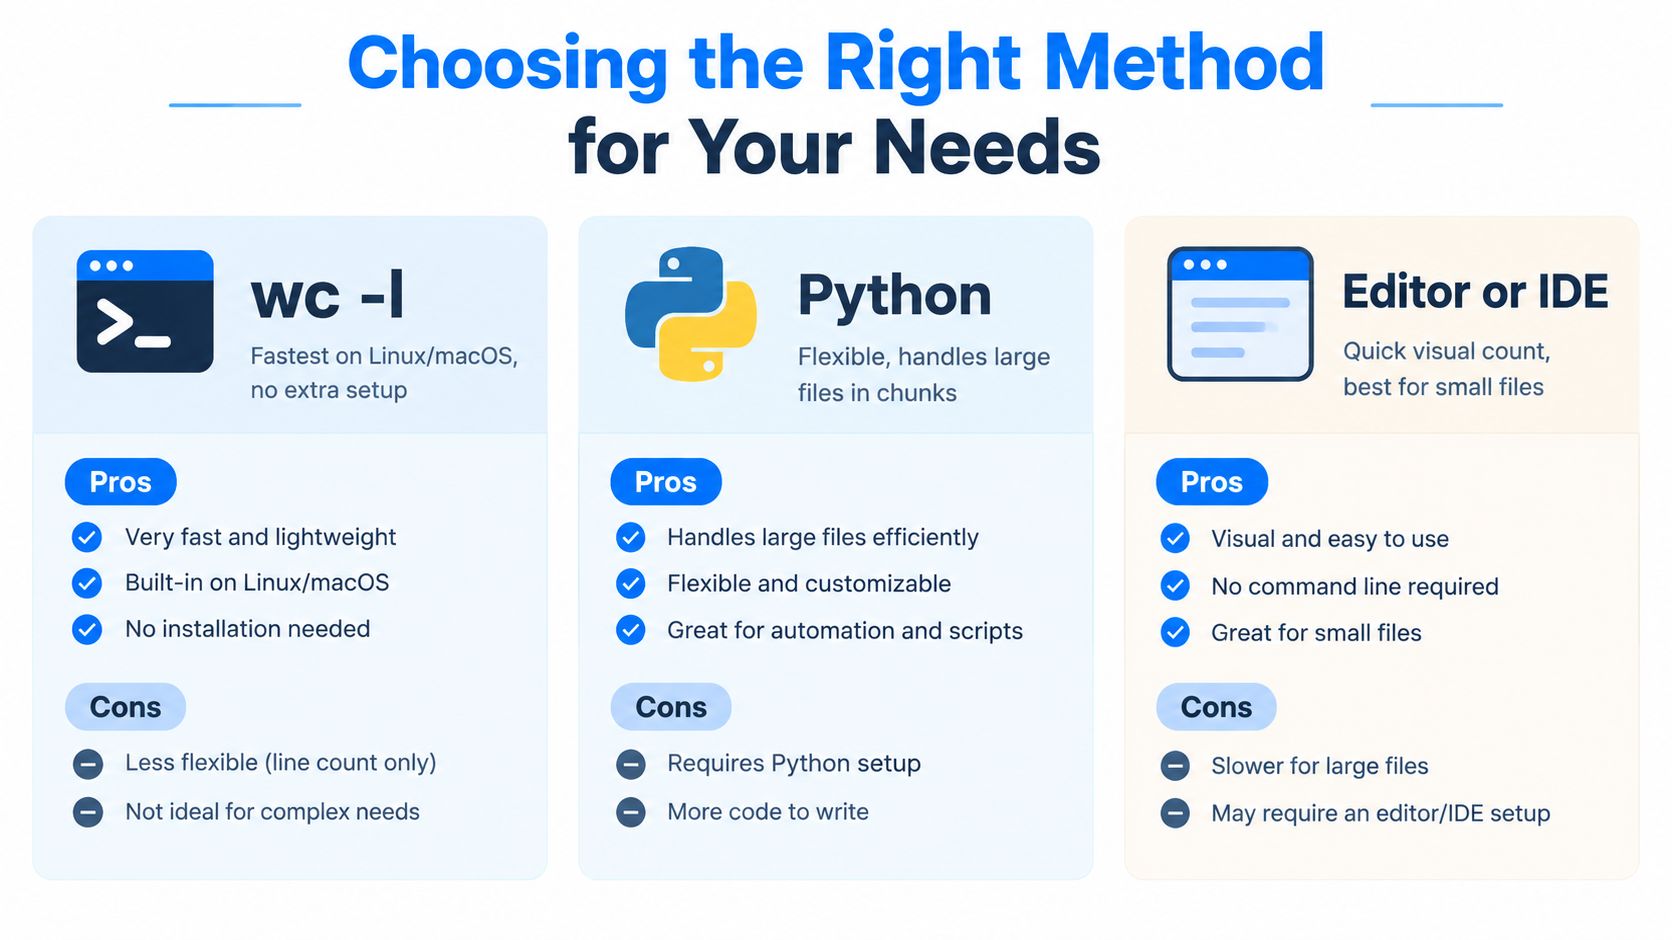
La meilleure méthode est celle qui correspond à la plateforme, à la taille du fichier et à la signification du décompte. Sous Linux et macOS, wc -l est l'option par défaut pour un total brut. Sous Windows, PowerShell est le choix natif le plus propre, et pour les traitements programmatiques, Python vous permet de maîtriser la mise en tampon et la gestion des cas limites.
Repères de décision rapides
Utilisez
wc -llorsque vous êtes sous Linux ou macOS et avez besoin du comptage simple le plus rapide, sans logique supplémentaire.Utilisez PowerShell lorsque vous êtes sous Windows et voulez un résultat que vous pouvez transmettre au reste d'un script.
Utilisez Python lorsque le fichier est volumineux, que l'encodage est incertain ou que le décompte nécessite un traitement personnalisé.
Utilisez un éditeur ou un IDE lorsque le fichier est petit et qu'une simple vérification visuelle suffit.
La différence pratique est simple. wc -l est l'outil de comptage brut le plus rapide, PowerShell est l'option shell la plus naturelle sous Windows, et Python est la solution de repli la plus sûre lorsque la sémantique compte plus que la commodité. Pour les workflows d'équipe, une couche d'observabilité des données comme la plateforme de surveillance modulaire de digna peut se placer au-dessus de ces contrôles ponctuels et regrouper en un seul endroit le nombre de lignes, les anomalies et le comportement d'arrivée des fichiers.
Si vous en avez assez de traquer après coup les décalages d'une ligne dans vos fichiers, utilisez digna pour surveiller les données derrière ces décomptes et détecter les chargements vides ou incomplets avant qu'ils n'atteignent les systèmes en aval. Rendez-vous sur digna pour découvrir comment ses fonctionnalités de validation, de détection d'anomalies et de contrôle de la ponctualité s'intègrent à un pipeline de données en production.
Lorsqu'un nombre de lignes sert en réalité d'indicateur du nombre d'enregistrements arrivés, digna Data Anomalies suit l'évolution du nombre de lignes dans la base de données au fil du temps et signale les chargements vides ou incomplets qu'un simple wc -l ponctuel ne comparerait jamais à l'historique.
Questions fréquentes
Comment compter les lignes d'un fichier sous Linux ou macOS ?
Utilisez wc -l filename pour afficher le décompte avec le nom du fichier, ou wc -l < filename pour ne renvoyer que le nombre dans les scripts. Lors d'un test de performance sur un fichier de 10 000 000 de lignes, wc -l s'est terminé en 0,13 s contre 0,33 s pour awk : réservez donc awk à la logique de filtrage.
Pourquoi wc -l affiche-t-il une ligne de moins que mon éditeur ?
Parce que wc -l compte les caractères de fin de ligne, et non les lignes visuelles. Si un fichier se termine sans saut de ligne final, la dernière ligne partielle n'est pas comptée, si bien qu'un fichier d'une seule ligne peut même afficher 0 ligne. Décidez dès le départ si l'automatisation a besoin des sauts de ligne physiques ou des enregistrements logiques.
Comment compter les lignes d'un fichier avec PowerShell ?
Exécutez (Get-Content "file.txt").Count pour un comptage de base, ou (Get-Content "file.txt" | Measure-Object -Line).Lines pour une sortie adaptée aux pipelines. Get-Content renvoie par défaut des chaînes délimitées par des sauts de ligne, tandis que -Raw renvoie une seule chaîne : la forme choisie modifie donc la façon dont PowerShell perçoit les lignes du fichier.
Quel est l'équivalent de wc -l dans l'invite de commandes Windows (CMD) ?
CMD ne dispose d'aucun équivalent direct à wc -l, et la solution de contournement habituelle est find /c /v "" file.txt. Sa sortie inclut le nom du fichier et une mise en forme supplémentaire : elle convient donc pour des vérifications rapides, mais reste difficile à automatiser sans l'encapsuler dans une boucle for /f. PowerShell est le meilleur choix pour les scripts.
Quelle est la méthode la plus rapide pour compter les lignes d'un fichier volumineux avec Python ?
Ouvrez le fichier en mode binaire, lisez-le par blocs de 64 Kio et comptez les octets de fin de ligne, en ajoutant une ligne uniquement si le fichier n'est pas vide et ne se termine pas par un saut de ligne. La lecture par blocs évite les E/S lentes caractère par caractère : un test de performance en C a pris 0,63 s par blocs contre 5,90 s caractère par caractère.


