Que signifie « fédéré » dans les données et l'IA ?
|
5
minute de lecture

Fédéré signifie que les données restent à la source tandis que des modèles, des politiques ou des requêtes partagés opèrent sur des systèmes indépendants. En informatique et dans le travail sur les données, cette idée est apparue très tôt dans les bases de données fédérées, puis dans l'apprentissage fédéré, avec toujours le même fil conducteur : un contrôle local et un accès coordonné.
Ce qui sème la confusion chez beaucoup, c'est que « fédéré » paraît simple, mais le terme est employé dans l'administration publique, la gestion des identités, les bases de données, la gouvernance et l'IA pour désigner des notions voisines aux compromis très différents. C'est pourquoi une définition pratique compte davantage qu'un slogan.
Table des matières
Comment l'apprentissage fédéré fonctionne sans déplacer les données
Modèles de gouvernance fédérée pour les données d'entreprise
Pourquoi fédéré ne signifie pas automatiquement confidentiel
Le véritable sens des systèmes fédérés
Fédéré signifie que des éléments distincts travaillent ensemble sans céder leur propriété à un lieu central unique. En technologie, cela veut généralement dire qu'une organisation conserve ses données, ses identités ou ses traitements au plus près de la source, puis relie ces éléments grâce à des règles, des normes ou des couches de coordination partagées. Le terme est utilisé pour les bases de données fédérées depuis la fin des années 1970 et les années 1980, et dès la fin des années 1980 et le début des années 1990, il désignait déjà une manière d'intégrer des systèmes autonomes dans une vue logique unique tout en préservant le contrôle local graphapp.ai.
Une analogie utile est celle d'un réseau de banques locales. Chaque agence gère ses propres comptes, mais toutes s'accordent sur des normes de compensation afin que les clients puissent transférer de l'argent d'un établissement à l'autre sans que chaque banque fusionne dans un gigantesque registre unique. La fédération fonctionne de la même manière dans les données et l'IA : l'autonomie locale d'abord, les règles partagées ensuite.
Règle pratique : si le système source reste propriétaire des données ou de la décision, et qu'une autre couche ne fait que coordonner l'accès ou l'agrégation, vous avez probablement affaire à une conception fédérée.
Quatre domaines, un seul mot déroutant
Le problème, c'est que le mot s'étend à des contextes très différents. L'usage recensé par les dictionnaires couvre la fédération politique, la fédération d'identités et l'informatique ou la recherche fédérées, tandis que la fédération d'identités désigne spécifiquement le fait de relier l'identité d'un utilisateur entre des systèmes distincts au moyen d'attributs et de règles d'authentification convenus Merriam-Webster. C'est pourquoi une discussion sur un gouvernement fédéral, une connexion fédérée et une analytique fédérée peut donner l'impression d'un dialogue de sourds.
En pratique, le point d'ancrage utile est le suivant : les systèmes fédérés assurent une coordination entre des éléments indépendants sans les centraliser entièrement. Cette définition convient aux bases de données fédérées, à l'apprentissage fédéré et à la gouvernance fédérée, même si chacun applique le principe différemment. Elle explique aussi pourquoi les détails de mise en œuvre comptent davantage que l'étiquette.
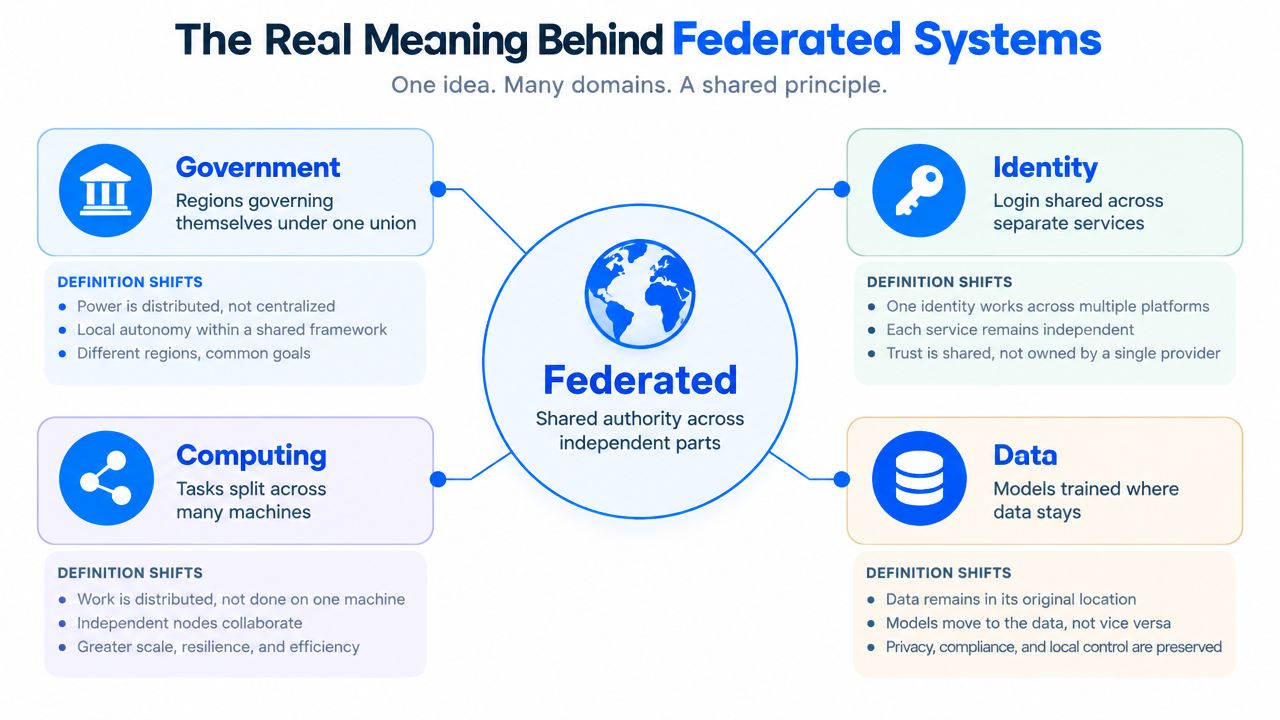
Pour les équipes qui construisent des plateformes de données modernes, le lien entre fédération et choix d'architecture devient plus clair lorsqu'on la compare à d'autres approches. Une bonne introduction aux compromis de conception associés est comprendre le data mesh dans les architectures modernes, car les deux modèles accordent une importance centrale à l'autonomie, à la gouvernance et aux normes partagées.
Architectures de données centralisées ou fédérées
Une architecture de données centralisée rassemble les données dans un entrepôt ou un lac commun, puis s'attend à ce que les pipelines, la modélisation et la gouvernance s'y déroulent. Une architecture fédérée laisse les données là où elles se trouvent déjà, puis s'appuie sur un serveur fédéré ou une couche d'accès pour coordonner les requêtes et les réponses entre les sources. La description des systèmes fédérés par IBM est claire sur le fonctionnement : un serveur fédéré, une ou plusieurs sources de données et des applications clientes coopèrent afin qu'une seule instruction SQL puisse accéder à des données réparties sur plusieurs sources IBM.
La différence n'est pas seulement technique : elle modifie qui contrôle quoi. Dans une configuration centralisée, l'équipe plateforme devient souvent le goulet d'étranglement pour l'intégration, les normes et l'accès. Dans un modèle fédéré, les équipes métier conservent la propriété, tandis que l'entreprise définit les règles d'interopérabilité, les exigences en matière de métadonnées et les périmètres de sécurité. Ce changement explique pourquoi les architectures fédérées se retrouvent dans les environnements réglementés et multi-domaines.
À retenir sur le plan opérationnel : les conceptions centralisées privilégient le contrôle et la consolidation, tandis que les conceptions fédérées privilégient l'autonomie et une coordination maîtrisée.
Comparaison entre architecture fédérée et architecture centralisée
Dimension | Centralisée | Fédérée |
|---|---|---|
Emplacement des données | Déplacées vers un entrepôt ou un lac partagé | Conservées dans les systèmes sources |
Propriété | Équipe plateforme ou équipe data centrale | Équipe métier ou équipe source |
Coordination des accès | Accès direct au stockage central | Requêtes acheminées via une couche de coordination |
Mode d'intégration | Consolider d'abord, utiliser ensuite | Accéder sur place, agréger à la demande |
Gouvernance | Application centralisée | Normes partagées avec une exécution locale |
L'approche fédérée est apparue parce que les grandes organisations se sont heurtées aux limites d'un modèle reposant sur un pipeline unique et gigantesque. À mesure que les équipes, les systèmes et les contraintes de conformité s'accumulent, une zone d'atterrissage unique peut devenir coûteuse à maintenir et difficile à concilier avec les exigences de résidence des données. Cela ne signifie pas que la centralisation soit une erreur, mais que le compromis change dès lors qu'une seule équipe ne peut raisonnablement pas être propriétaire de chaque jeu de données et de chaque politique.
Si vous évaluez la différence sous l'angle de la qualité des données, la distinction se manifeste aussi dans les contrôles opérationnels. Cette comparaison des compromis de qualité entre plateformes de données fédérées et centralisées est utile lorsque la question n'est plus tant « laquelle paraît la plus propre ? » que « quelle structure pouvons-nous gouverner ? »
Comment l'apprentissage fédéré fonctionne sans déplacer les données
L'apprentissage fédéré est l'usage moderne du terme fédéré que la plupart des équipes d'analytique rencontrent en premier. Il entraîne des modèles sur des appareils distants ou des centres de données cloisonnés tout en gardant les données localisées, puis utilise un serveur central pour coordonner des cycles d'entraînement successifs et agréger les mises à jour de modèle provenant des participants distribués revue arXiv. Les enregistrements bruts restent sur le téléphone, dans le système hospitalier ou sur le site. Ce qui circule, c'est le signal de mise à jour, pas le jeu de données.
Ce mode de fonctionnement est important, car il transforme la nature des discussions sur la confidentialité et la conformité. Au lieu de copier des données sensibles dans un environnement unique de construction de modèles, chaque participant apprend localement et ne transmet que ce qui est nécessaire à l'agrégation. C'est pourquoi l'apprentissage fédéré est souvent évoqué pour les téléphones, les hôpitaux et d'autres contextes où le déplacement des données est strictement encadré.
Le déroulement pratique
L'entraînement local démarre sur chaque client à partir des données qui s'y trouvent déjà.
Les mises à jour du modèle sont envoyées à un coordinateur, et non le jeu de données brut.
L'agrégation s'effectue de manière centralisée et produit un modèle global affiné.
Le modèle mis à jour est renvoyé pour un nouveau cycle local.
Ce schéma réduit les déplacements inutiles, mais il ne rend pas le processus simple pour autant. Les différents appareils peuvent disposer de capacités de calcul, d'une fiabilité réseau ou d'une qualité de données différentes. La charge de coordination fait partie intégrante de la conception, et les calendriers d'entraînement comptent davantage que dans un pipeline de ML centralisé classique.
Règle empirique : l'apprentissage fédéré est d'abord un modèle de coordination, et seulement ensuite une fonctionnalité de confidentialité.
L'aspect opérationnel devient encore plus important lorsque les équipes cherchent à surveiller la dérive ou le comportement des modèles sur de nombreux participants. Si vous suivez la stabilité d'un modèle dans une configuration distribuée, les pratiques de détection de la dérive des modèles vous aident à cerner les changements observables sans prétendre que le système est statique.
Modèles de gouvernance fédérée pour les données d'entreprise
La gouvernance fédérée est la version organisationnelle de la même idée. Une instance centrale définit les politiques, les normes et les contrôles partagés à l'échelle de l'organisation, tandis que les unités métier appliquent ces règles au sein de leurs propres domaines Atlan. Ce partage est utile lorsque l'entreprise a besoin de cohérence, mais que les domaines doivent conserver une marge de manœuvre pour exploiter leurs propres pipelines, définir des règles de données locales et gérer des exceptions propres à leur domaine.
La distinction essentielle porte sur l'autorité. La gouvernance fédérée ne signifie pas que chaque décision est décentralisée, ni que les équipes centrales microgèrent chaque jeu de données. Elle signifie que le centre définit les garde-fous et que les domaines opèrent à l'intérieur de ceux-ci. En pratique, cela inclut généralement des métadonnées partagées, des contrôles de sécurité et des normes de qualité, ainsi qu'une responsabilité clairement établie pour leur application.
Là où le modèle fonctionne et là où il atteint ses limites
La gouvernance fédérée convient généralement aux organisations comptant plusieurs unités métier, des données réglementées ou des lignes de propriété complexes. Elle est également plus adaptée lorsque les équipes locales connaissent les données mieux que ne pourrait jamais le faire un groupe plateforme central. Le compromis réside dans la charge de coordination, car les politiques doivent être interprétées de manière cohérente d'un domaine à l'autre, et pas seulement rédigées une fois.
Elle échoue lorsque la couche de politiques centrale est floue ou lorsque les équipes métier travaillent en vase clos. Vous obtenez alors le pire des deux mondes : un règlement central que personne n'utilise et des pratiques locales que personne ne peut auditer. C'est pourquoi la gouvernance fédérée exige une responsabilité partagée, et pas seulement un organigramme indiquant « central plus local ».
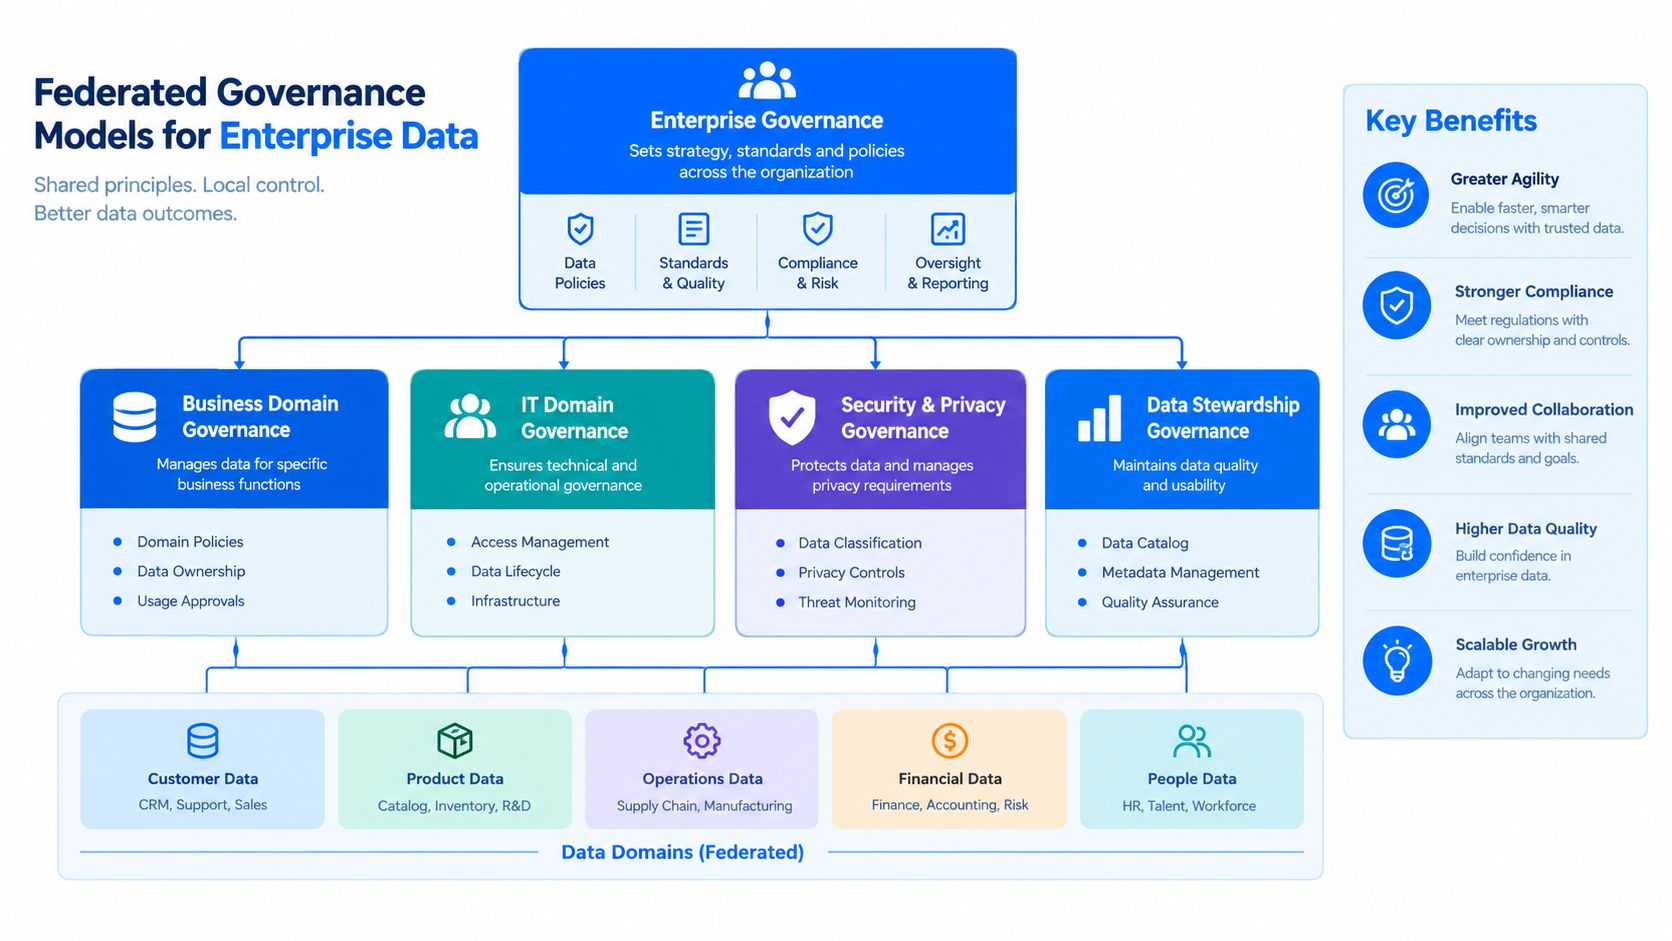
Pour les équipes qui formalisent ce modèle opérationnel, les recommandations sur la gouvernance fédérée des données sont surtout utiles lorsqu'elles s'accompagnent de décisions concrètes sur la propriété, l'escalade et les preuves de qualité. Sans ces éléments, « fédéré » devient une étiquette dépourvue de tout moyen d'application.
Pourquoi fédéré ne signifie pas automatiquement confidentiel
Le mythe le plus tenace veut que les systèmes fédérés soient confidentiels par défaut. Ce n'est pas le cas. Le NIST souligne que, même dans l'apprentissage fédéré, des informations peuvent encore être extraites des mises à jour du modèle ou du modèle entraîné lui-même, ce qui signifie que l'apprentissage fédéré réduit l'exposition sans éliminer le risque pour la confidentialité NIST.
C'est la partie que beaucoup d'articles explicatifs passent sous silence. Le fait que les données brutes restent locales est un contrôle important, mais ce n'est pas tout en matière de sécurité. Des recherches indépendantes et des recommandations réglementaires décrivent le même mécanisme : les clients conservent les données brutes sur l'appareil ou sur site, effectuent un calcul local et n'envoient que des mises à jour ciblées pour l'agrégation, parfois en y ajoutant la confidentialité différentielle afin de limiter les fuites CACM. C'est préférable à l'envoi de tous les enregistrements vers un jeu d'entraînement central, mais cela laisse subsister les fuites via les mises à jour, l'inversion de modèle et les risques liés à la coordination.
Ce que les équipes soumises à la réglementation doivent présumer
Une architecture fédérée doit être considérée comme une stratégie de réduction des déplacements de données, et non comme une garantie générale de confidentialité. Si vous travaillez dans la finance, la santé, les télécommunications ou le secteur public, cela signifie que vous avez toujours besoin de contrôles d'accès, d'auditabilité et de protections cryptographiques autour du circuit des mises à jour. La conception aide en matière de résidence et d'autonomie, mais elle ne remplace pas l'ingénierie de la sécurité.
Pour les équipes qui se concentrent sur le volet conformité de cette équation, protéger la confidentialité de vos données rappelle utilement que les protections de la vie privée exigent toujours des contrôles à plusieurs niveaux, et non des vœux pieux. La même logique s'applique aux systèmes fédérés, où la surface d'attaque change de forme au lieu de disparaître.
Les systèmes fédérés déplacent souvent le risque, ils ne le suppriment pas. Les déploiements les plus solides partent du principe que les mises à jour du modèle sont, elles aussi, des actifs sensibles.
Si votre organisation cherche à aligner son architecture sur des exigences de résidence ou de souveraineté, la conformité en matière de souveraineté des données fait partie intégrante de la réflexion sur la conception, et non d'une considération après coup. La question n'est jamais uniquement de savoir où se trouvent les données brutes, mais aussi qui peut déduire quoi à partir du système qui les entoure.
Quand les architectures fédérées sont pertinentes
Les architectures fédérées sont les plus pertinentes lorsque des équipes indépendantes doivent conserver la propriété de leurs données tout en participant à un modèle opérationnel commun. Elles conviennent particulièrement lorsque la confidentialité, la souveraineté ou l'autonomie des domaines sont importantes, car les sources indépendantes gardent le contrôle tout en offrant un accès interopérable au moyen de politiques, d'API ou d'algorithmes partagés MIT. C'est là leur valeur fondamentale : la coordination sans consolidation complète.
Elles conviennent également lorsque les pipelines centralisés sont devenus des goulets d'étranglement. Si chaque nouvelle source de données doit passer par la même équipe centrale pour être ingérée, modélisée, approuvée et publiée, la plateforme commence à ralentir l'activité. Un modèle fédéré peut alléger cette pression, mais uniquement si l'entreprise est prête à investir dans les normes, les métadonnées, la sécurité et la supervision de la qualité à travers les domaines.
Optez pour une conception fédérée lorsque
Plusieurs domaines ont besoin de la propriété : chaque équipe garde le contrôle de ses propres données et de sa propre logique.
La résidence des données est importante : vous ne pouvez pas, ou ne devriez pas, déplacer toutes les données vers une seule plateforme.
Les pipelines centraux sont surchargés : l'équipe plateforme consacre plus de temps à la coordination qu'à l'accompagnement.
L'autonomie et la conformité comptent toutes deux : l'entreprise a besoin d'une prise de décision locale dans le cadre de garde-fous globaux.
Une approche purement centralisée reste pertinente pour les jeux de données de taille modeste, les charges de travail à domaine unique ou les organisations qui n'ont pas encore la maturité de gouvernance nécessaire pour coordonner plusieurs domaines. S'il n'y a qu'une équipe, une charge de travail et un modèle de sécurité, la fédération peut ajouter plus de processus que de valeur. Le compromis structurel est simple : centraliser pour la simplicité, fédérer pour une indépendance maîtrisée.
digna assure la qualité et l'observabilité des données au sein même de l'environnement du client, ce qui la rend pertinente lorsque des équipes fédérées ont besoin de preuves issues de domaines distincts sans tout rapatrier en un seul endroit. Si vous évaluez une architecture fédérée et avez besoin de visibilité sur les anomalies, les changements de schéma, la ponctualité et la validation à travers les domaines, rendez-vous sur digna pour découvrir comment la plateforme s'intègre à ce modèle opérationnel.
Lorsque des domaines fédérés conservent leurs données sur place tout en ayant besoin de preuves de qualité partagées, une observabilité de la plateforme de données exécutée au sein de votre propre environnement peut surveiller chaque source là où elle se trouve, au lieu de la copier dans un stockage central.
Questions fréquentes
Que signifie « fédéré » dans le domaine des données et de l'IA ?
Fédéré signifie que les données restent à la source tandis que des modèles, des politiques ou des requêtes partagés opèrent sur des systèmes indépendants. Chaque élément conserve sa propriété et son contrôle local, et une couche de coordination gère l'accès ou l'agrégation. L'idée remonte aux bases de données fédérées de la fin des années 1970 et des années 1980, et elle sous-tend aujourd'hui l'apprentissage fédéré.
Quelle est la différence entre une architecture de données fédérée et une architecture centralisée ?
La différence essentielle tient à l'emplacement des données et à leur propriétaire. Une architecture centralisée déplace les données vers un entrepôt ou un lac partagé géré par une équipe centrale, tandis qu'une architecture fédérée conserve les données dans les systèmes sources et achemine les requêtes via une couche de coordination, comme un serveur fédéré, les équipes métier conservant la propriété.
Comment l'apprentissage fédéré fonctionne-t-il sans déplacer les données ?
L'apprentissage fédéré entraîne un modèle localement sur chaque client, qu'il s'agisse d'un téléphone, d'un système hospitalier ou d'un site. Seules les mises à jour du modèle sont transmises à un coordinateur, qui les agrège en un modèle global affiné et le renvoie pour un nouveau cycle local. Les enregistrements bruts ne quittent jamais leur emplacement d'origine.
L'apprentissage fédéré est-il confidentiel par défaut ?
Non. Le NIST souligne que des informations peuvent encore être extraites des mises à jour du modèle ou du modèle entraîné lui-même : l'apprentissage fédéré réduit donc l'exposition sans éliminer le risque. Les équipes réglementées de la finance, de la santé, des télécommunications ou du secteur public ont toujours besoin de contrôles d'accès, d'auditabilité et de protections cryptographiques autour du circuit des mises à jour.
Quand une organisation doit-elle recourir à une architecture fédérée ?
Optez pour la fédération lorsque plusieurs domaines ont besoin de la propriété de leurs données, que les règles de résidence des données empêchent la consolidation ou que les pipelines centraux sont devenus un goulet d'étranglement. Pour les jeux de données de taille modeste, les charges de travail à domaine unique ou les équipes n'ayant pas la maturité de gouvernance nécessaire pour coordonner plusieurs domaines, une approche purement centralisée ajoute généralement moins de processus et reste l'option la plus simple.


