Le monitoring en management : un guide pratique
|
6
minute de lecture

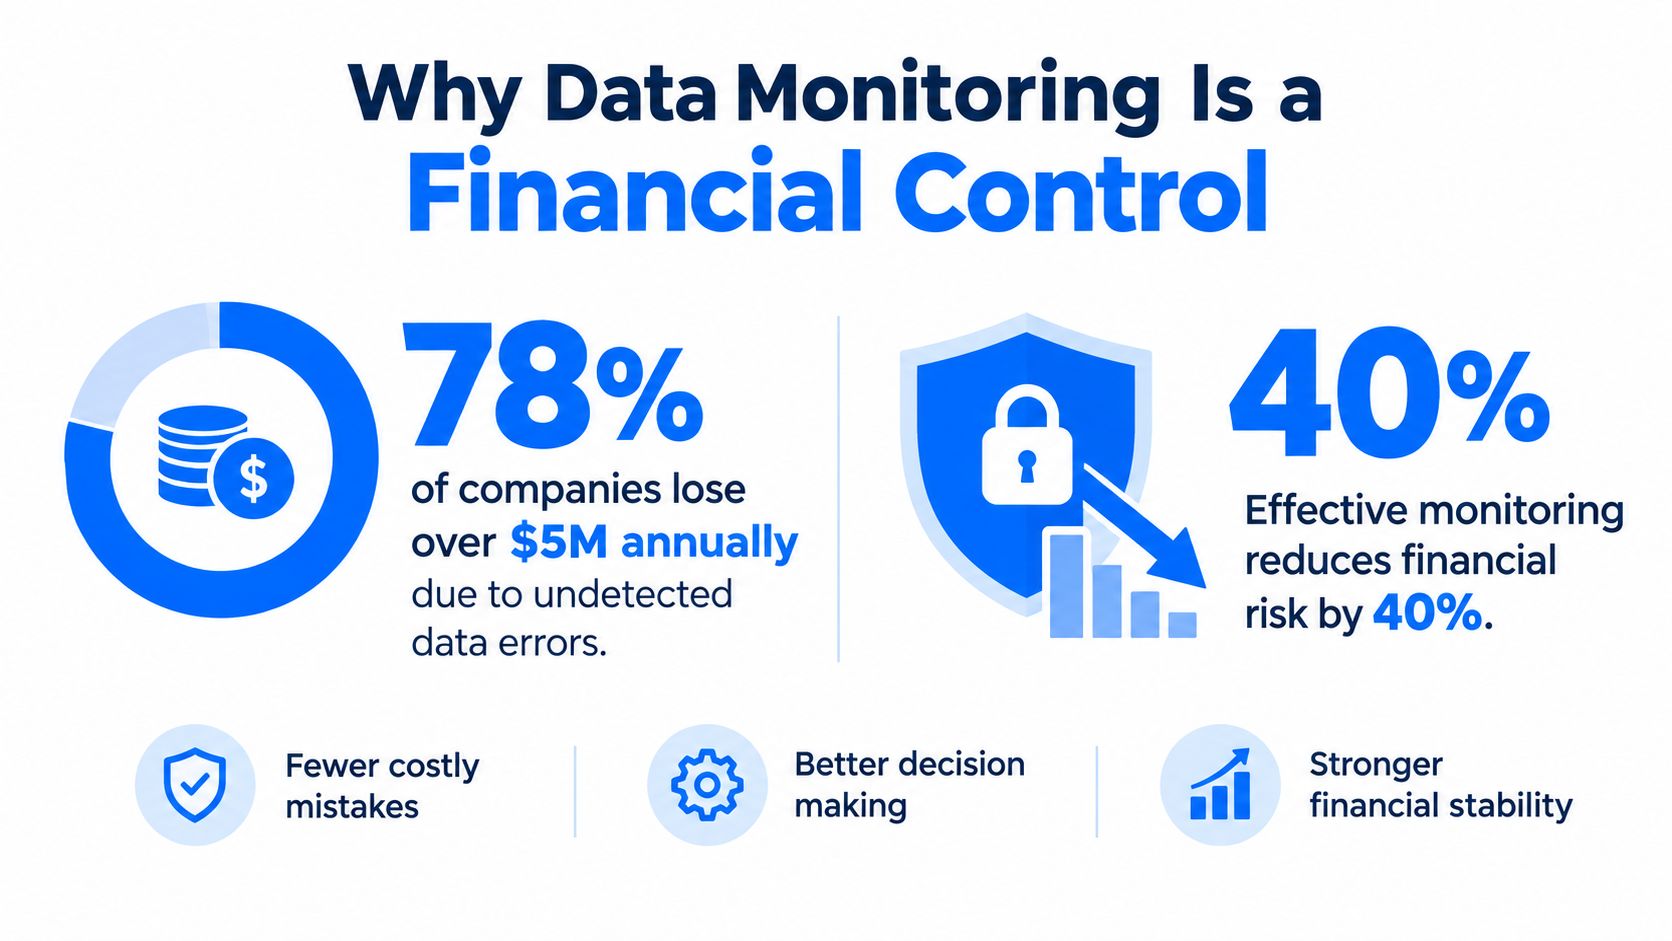
Plus d’un quart des organisations estiment leurs pertes annuelles liées à la mauvaise qualité des données à plus de 5 millions USD, et 7 % déclarent des pertes d’au moins 25 millions USD. Le monitoring en management prévient cette exposition en reliant les signaux de données à des responsables identifiés, à l’impact métier et à des actions correctives.
Cette distinction est importante, car un tableau de bord peut afficher une défaillance sans que personne ne soit chargé de la résoudre. Un monitoring efficace est un système de contrôle de gestion : les équipes définissent les conditions attendues, observent le comportement réel, comparent les deux et agissent lorsque l’écart compte.
Table des matières
Pourquoi le monitoring des données est un contrôle financier
La mauvaise qualité des données n’est pas un simple désagrément technique. Elle peut fausser les prévisions, interrompre les opérations, fragiliser le reporting réglementaire et orienter les décisions automatisées dans la mauvaise direction. L’analyse d’IBM sur le coût de la mauvaise qualité des données indique que plus d’un quart des organisations estiment leurs pertes annuelles à plus de 5 millions USD, tandis que 7 % déclarent des pertes d’au moins 25 millions USD.
Le monitoring en management ne se limite pas à afficher une valeur actuelle. Il consiste à définir une plage ou une condition attendue, observer un processus de données ou métier, repérer un écart significatif, attribuer la responsabilité, conserver les preuves et vérifier que la correction a fonctionné. Un tableau de bord soutient ce processus, mais ne le remplace pas.
Visibilité du tableau de bord ou contrôle de gestion
Un tableau de bord répond à la question « Que se passe-t-il ? ». Un contrôle de gestion répond à un ensemble de questions plus complet :
Attente : Que devrait-il se passer, et quelle norme le définit ?
Matérialité : Quelle conséquence métier, financière, opérationnelle ou réglementaire en découle si les conditions changent ?
Responsabilité : Quelle personne ou quelle équipe doit enquêter ?
Preuve : Quels enregistrements montrent quand l’écart a commencé et ce qui a changé ?
Réponse : Quelle action est requise, et quand le problème peut-il être clos ?
Dans une banque, un jeu de données de risque arrivé en retard peut perturber le reporting ou les circuits de décision. Les équipes chargées de la gestion des données dans les banques ont besoin de plus qu’un statut de pipeline. Il leur faut des signaux de ponctualité, de validation, de schéma et de règles métier reliés aux processus que ces données alimentent.
L’arbitrage pratique est simple. Un monitoring large apporte de la visibilité, mais une collecte sans discernement crée du bruit et des coûts. Un monitoring ciblé sur les tables financièrement significatives, les jeux de données réglementaires, les fichiers clients et les pipelines critiques pour la décision produit un ensemble de preuves plus restreint, réellement exploitable par la direction.
L’évolution de la théorie du contrôle de gestion
L’observabilité moderne peut sembler rompre avec le management traditionnel, surtout lorsque le machine learning détecte un comportement inhabituel sans règle écrite à la main. La logique sous-jacente est pourtant plus ancienne et plus stable que la technologie. Les équipes comparent toujours les conditions réelles aux conditions attendues et décident si un écart appelle une action.
Henri Fayol a formulé une première définition du contrôle de gestion en 1916, décrivant le contrôle comme la vérification que les activités suivent le plan adopté, les ordres donnés et les principes établis, comme le documente cette synthèse de la théorie du contrôle de gestion. Cette définition a fait du contrôle une responsabilité managériale récurrente, et non une inspection ponctuelle.
Les travaux antérieurs du management scientifique ont renforcé le même schéma. Frederick Taylor a traité le contrôle comme un objectif dans des expériences menées en 1906, tandis que Copley a décrit le contrôle comme l’idée centrale du management scientifique en 1923. Des synthèses ultérieures retiennent cinq principes proposés par Urwick en 1929 : responsabilité, preuve, standardisation, comparaison et utilité.
Le cycle de contrôle dans une plateforme de données
Ces principes s’appliquent directement aux opérations de données en entreprise :
Fixer une norme. Définir la fraîcheur acceptable, les enregistrements valides, le schéma attendu, le comportement de livraison ou l’évolution des KPI.
Mesurer la performance. Collecter des observations sur les tables, les pipelines, les charges de travail et les processus métier.
Comparer les résultats. Évaluer le comportement actuel par rapport à une référence, une règle, une cible ou un historique.
Évaluer la portée. Distinguer une variation anodine d’un écart susceptible d’affecter les décisions.
Corriger. Transmettre le constat à un responsable, consigner la réponse et vérifier que les conditions sont revenues à un état acceptable.
La détection d’anomalies par l’IA change la façon dont les équipes établissent leurs références et repèrent les écarts. Elle ne supprime pas le cycle de contrôle. Elle automatise une partie de l’observation et de la comparaison, tandis que des personnes décident toujours de ce que signifie le signal et de la réponse acceptable.
Une synthèse scientifique de 2024 a passé en revue la recherche sur le contrôle organisationnel au moyen d’une analyse de cocitations portant sur 1 148 articles publiés entre 1938 et 2022. Sa méta-analyse pluridisciplinaire couvrait 293 articles, 310 échantillons indépendants et au total 110 585 observations, selon l’introduction de Cambridge sur le contrôle organisationnel. Cette tradition de recherche dépasse aujourd’hui la comptabilité financière pour englober les indicateurs non financiers, les systèmes d’information, le comportement organisationnel et la performance stratégique.
Cette évolution explique pourquoi une plateforme comme digna peut combiner détection d’anomalies, suivi de la ponctualité, validation, surveillance des schémas et observation des KPI. Il ne s’agit pas de fonctionnalités isolées, mais de mises en œuvre modernes d’une discipline managériale établie de longue date.
Les principaux types de monitoring
Le monitoring échoue lorsque les équipes traitent chaque signal comme le même type de problème. Un retard de pipeline, une variation inattendue du chiffre d’affaires et l’échec d’une validation liée à la confidentialité peuvent tous déclencher des alertes, mais ils exigent des normes, des responsables, des délais de réponse et des preuves différents.

Monitoring opérationnel
Le monitoring opérationnel vérifie que l’environnement de données fonctionne comme prévu. Il couvre la disponibilité, le comportement des charges de travail, la performance, le débit, la fraîcheur des données, l’exactitude, la qualité et la couverture. Un job terminé n’est pas forcément un job réussi. Le résultat peut être en retard, incomplet, structurellement modifié ou inutilisable en aval.
Parmi les signaux utiles :
Ponctualité : La table ou la partition attendue est-elle arrivée dans la fenêtre convenue ?
Comportement du schéma : Des colonnes ont-elles été ajoutées, supprimées ou modifiées d’une manière qui affecte les consommateurs ?
Santé du pipeline : Un processus a-t-il échoué, été relancé de façon inhabituelle ou produit moins d’enregistrements que prévu ?
Comportement de la plateforme : La consommation ou la performance des charges de travail est-elle sortie de son profil habituel ?
Monitoring des KPI
Le monitoring des KPI évalue la signification métier portée par les données. Il suit le chiffre d’affaires, les ventes, les transactions, l’activité client, les volumes opérationnels ou d’autres mesures par rapport aux attentes métier. Le choix de conception essentiel consiste à distinguer un changement métier légitime d’un défaut de données.
Une alerte KPI doit donc apporter du contexte. Quelles tables sources alimentent l’indicateur ? Un changement de schéma a-t-il eu lieu auparavant ? Les volumes d’enregistrements, les distributions ou les résultats de validation ont-ils bougé ? Le responsable métier peut-il confirmer que la variation reflète la réalité ?
Monitoring fondé sur les risques
Le monitoring fondé sur les risques détermine avec quelle attention chaque contrôle doit être observé. Le guide du NIST sur la surveillance continue recommande une stratégie qui module la fréquence selon la volatilité du contrôle, la tolérance au risque du système, les menaces et vulnérabilités, le niveau d’impact, les faiblesses connues et la criticité de la fonction surveillée. Il recommande aussi de combiner des indicateurs avancés, comme les changements de schéma, avec des indicateurs retardés, comme la récurrence des incidents.
Type de monitoring | Question principale | Réponse type |
|---|---|---|
Opérationnel | Le service de données se comporte-t-il correctement ? | Examiner la livraison, l’infrastructure ou l’état du pipeline |
KPI | La performance métier évolue-t-elle comme prévu ? | Valider l’indicateur et impliquer le responsable métier |
Fondé sur les risques | Quelle attention ce contrôle exige-t-il ? | Ajuster la fréquence, les seuils, l’escalade ou l’acceptation |
Un programme de monitoring a besoin des trois. L’observabilité de la qualité des données peut révéler une règle d’enregistrement en échec, mais la direction doit encore déterminer la conséquence, désigner le responsable et documenter la décision.
Le déficit de responsabilité dans le monitoring moderne
Beaucoup d’organisations ont investi dans les tableaux de bord plus vite qu’elles n’ont construit leurs modèles de responsabilité. Le résultat est connu : une équipe voit un indicateur rouge, suppose qu’une autre équipe s’en occupe, puis découvre plus tard que personne n’a conservé les preuves ni testé la correction.
Une enquête de gouvernance de 2025 a placé la gestion et la responsabilité des données parmi les priorités absolues, tandis que des comptes rendus indépendants de la même étude ont montré que certaines organisations n’ont toujours pas de programme d’observabilité des modèles ni de capacités de base en qualité des données ou en gouvernance des accès, comme le documente le rapport 2025 State of Enterprise Data Governance.
Ce constat révèle un décalage fréquent. Les équipes abordent parfois l’observabilité comme une capacité technique, alors que les responsables de la gouvernance posent une question plus opérationnelle : qui répond du signal, de son interprétation et de sa clôture ?
Rendre chaque alerte actionnable
Un enregistrement de monitoring utile doit relier cinq éléments :
Responsable désigné : L’équipe ou le rôle chargé de l’enquête.
Impact métier : La décision, le processus, le client ou l’obligation exposé au risque.
Seuil d’action : La condition qui fait passer le constat de l’observation à l’escalade.
Piste de preuves : L’historique de l’indicateur, les enregistrements en échec, l’événement de schéma ou le résultat de validation qui étayent le constat.
Test de clôture : La preuve nécessaire pour montrer que la correction a fonctionné.
Règle pratique : une alerte sans responsable relève de la télémétrie, pas du contrôle.
Ajouter des alertes peut augmenter le volume de notifications sans améliorer la fiabilité. Un ensemble plus restreint de signaux fiables, acheminés via des rôles de gouvernance des données, produit souvent de meilleurs résultats de gestion qu’un vaste catalogue d’événements techniquement intéressants.
L’arbitrage se joue entre couverture et attention. Une large couverture aide à découvrir des modes de défaillance inconnus, mais chaque alerte consomme de la capacité d’analyse. Des seuils fondés sur les risques, des circuits d’escalade clairs et un contexte historique permettent aux dirigeants de réserver leur attention aux écarts susceptibles de changer une décision métier.
Mettre en œuvre une stratégie de monitoring pragmatique
Commencez par les décisions que votre organisation ne peut pas se permettre de prendre sur de mauvaises données. Cette liste comprend généralement le reporting réglementaire, les contrôles financiers, l’éligibilité des clients, la capacité opérationnelle et les résultats analytiques ou d’IA qui influencent des choix importants. Cartographiez les jeux de données et les pipelines derrière ces décisions avant de choisir des indicateurs.
Choisir des indicateurs qui révèlent différents modes de défaillance
Utilisez des indicateurs avancés pour détecter des conditions avant qu’un incident ne devienne visible pour les utilisateurs. Changements de schéma, partitions arrivées en retard, écarts de fraîcheur, variations du taux de valeurs nulles, consommation inhabituelle des charges de travail et changements de distribution peuvent révéler une dégradation précoce.
Les indicateurs retardés montrent si le système de contrôle fonctionne après un problème. Récurrence des incidents, rapprochements en échec, retraitements de rapports et exceptions de contrôle répétées indiquent à la direction où la correction ou la conception des contrôles reste fragile.
Pour la ponctualité, définissez un objectif de niveau de service plutôt que de dire que les données doivent être « quasi temps réel ». Le guide SRE de Google sur les objectifs de niveau de service note que des données datant de plus de quatre à cinq minutes peuvent retarder sensiblement la réponse aux incidents dans les systèmes de monitoring. Le bon seuil dépend du processus, mais le principe reste le même : mesurez la part des données ou des exécutions de pipeline qui respectent une condition de fraîcheur convenue sur une fenêtre définie.
Fixer la fréquence selon le risque
Ne contrôlez pas toutes les tables au même rythme. Un jeu de données financièrement significatif, une table liée aux identités ou un flux réglementaire mérite une surveillance plus étroite qu’une table exploratoire à faible impact. Ajustez la fréquence lorsque la volatilité, l’exposition, les faiblesses connues ou la criticité métier évoluent.
Évitez aussi les moyennes qui masquent la traîne du comportement opérationnel. La documentation SRE de Google juge utiles les mesures par percentiles, comme les 50e, 95e et 99e percentiles, car les moyennes peuvent masquer une petite population de requêtes lentes aux conséquences importantes. Le même raisonnement s’applique à la latence des pipelines et à la performance des charges de travail.
Définir le circuit de réponse avant d’activer les alertes
Pour chaque indicateur, consignez la référence, le responsable, le seuil, le circuit d’escalade, l’emplacement des preuves et le test de rétablissement. Le monitoring doit mesurer non seulement le délai entre l’écart et sa détection, mais aussi le délai de prise en charge et de rétablissement.
Une plateforme comme digna peut soutenir ce modèle opérationnel en surveillant le comportement des données, en validant les enregistrements, en suivant la ponctualité, en détectant les changements de schéma et en observant les indicateurs métier et plateforme dans l’environnement du client. Les équipes doivent néanmoins valider le déploiement, les responsabilités et les seuils au regard de leur propre architecture et de leur politique de risque. La capacité de monitoring et de reporting s’inscrit dans ce processus de gestion plus large, et non à côté.
Applications concrètes dans les secteurs réglementés
Une équipe de services financiers peut surveiller une table de risques pour repérer des changements de schéma inattendus avant un cycle de reporting. Une colonne supprimée ou un type de données modifié peut casser la logique en aval sans prévenir ; le contrôle utile n’est donc pas une simple alerte d’échec de job. Il combine surveillance structurelle, connaissance des dépendances, résultats de validation et un responsable capable d’évaluer si le rapport concerné reste fiable.
Les équipes de santé font face à une autre version du même problème. Un dossier patient peut arriver à temps et passer les contrôles techniques tout en enfreignant une règle métier ou juridique. La validation au niveau de l’enregistrement permet d’identifier l’enregistrement en échec, de conserver la règle évaluée, de transmettre le cas pour examen et de garder la preuve de sa résolution.
L’article 5 du Règlement général sur la protection des données de l’UE exige que les données personnelles soient exactes et tenues à jour. Il impose aussi une sécurité appropriée, y compris la protection contre le traitement non autorisé ou illicite et contre la perte, la destruction ou les dégâts d’origine accidentelle. La surveillance continue aide à traduire ces obligations en preuves opérationnelles plutôt que de s’en remettre à des revues manuelles périodiques.
Appliquer les contrôles par secteur
Services financiers : Valider les données transactionnelles et réglementaires, surveiller la ponctualité des livraisons, détecter les changements structurels et relier les exceptions aux responsables du reporting et des risques.
Santé : Contrôler les dossiers cliniques et opérationnels au regard des règles métier, repérer les valeurs inexactes ou incohérentes et conserver les preuves d’examen.
Télécommunications : Observer de gros volumes de données clients et réseau, distinguer les vraies évolutions d’usage des défauts de pipeline et escalader les défaillances avant qu’elles ne faussent le reporting opérationnel.
Secteur public : Conserver des preuves traçables pour les jeux de données critiques, notamment la règle évaluée, les enregistrements concernés, la décision prise et l’action corrective.
Les organisations dotées de contrôles financiers complexes peuvent aussi étudier des ressources sur l’application automatisée des politiques dans la FinTech lorsqu’elles doivent relier des exigences réglementaires à des contrôles opérationnels reproductibles. Le principe de conception reste le même : le monitoring doit produire des preuves qu’une équipe responsable peut interpréter et exploiter.
Pour les organisations de santé, la conformité des données de santé exige la même discipline en matière de qualité, de ponctualité, de validation et de changements structurels. La conformité ne se démontre pas par un score seul. Elle dépend de la capacité des équipes à montrer ce qu’elles ont contrôlé, ce qui a échoué, qui a réagi et si le résultat a été corrigé.
L’avenir de la gouvernance fondée sur les preuves
La prochaine étape du monitoring n’est pas un mur de graphiques plus grand. C’est un lien plus étroit entre observation, jugement managérial et preuve. L’IA peut apprendre le comportement propre à chaque jeu de données, corréler les signaux, hiérarchiser les anomalies et réduire la maintenance manuelle des règles. Elle ne peut pas décider si une exception métier est acceptable sans politique définie ni autorité responsable.
La boucle opérationnelle la plus durable comporte quatre étapes :
Observer les conditions réelles sur les données, les plateformes, les indicateurs métier et les contrôles.
Comparer les conditions aux attentes à l’aide de règles, de références, d’objectifs de service ou de seuils de risque.
Attribuer et exécuter les actions correctives avec un responsable documenté et un circuit d’escalade.
Vérifier le résultat grâce à des mesures ultérieures et des preuves conservées.
Cette approche aide aussi à distinguer les problèmes de données des problèmes de modèles. Une sortie de modèle inattendue peut provenir d’un schéma modifié en amont, de données en retard, d’une distribution décalée, d’une règle de validation en échec ou d’un événement métier légitime. Suivre la chaîne causale évite de traiter le monitoring des modèles comme une solution isolée à tous les problèmes de fiabilité de l’IA.
Le monitoring prend toute sa valeur managériale lorsque les preuves changent une décision.
Le changement pratique consiste à passer d’une visibilité passive à une gouvernance fondée sur les preuves. Les data engineers deviennent responsables non seulement de la disponibilité des pipelines, mais aussi de l’intégrité, de la ponctualité et de la traçabilité des informations utilisées par les analystes, les dirigeants, les régulateurs et les systèmes d’IA. Les responsables métier gagnent un rôle plus clair, car ils définissent la matérialité et les résultats acceptables. Les équipes de gouvernance reçoivent des preuves produites dans le cours normal des opérations au lieu de les reconstituer sous pression.
Voilà le sens utile du monitoring en management. Les équipes ne surveillent pas pour accumuler davantage de télémétrie. Elles surveillent pour détecter tôt les changements significatifs, rendre la responsabilité explicite et protéger les décisions contre des données peu fiables.
digna propose une plateforme d’entreprise de qualité et d’observabilité des données qui s’exécute dans l’environnement propre du client, avec des modules de détection d’anomalies, de ponctualité, de validation au niveau de l’enregistrement, de suivi des schémas et de monitoring métier et plateforme. Rendez-vous sur digna pour découvrir comment votre équipe peut relier les signaux de monitoring à une correction responsable et à des preuves fiables.
Si votre principal déficit de responsabilité se situe dans le monitoring des KPI, découvrez comment le monitoring métier avec digna distingue les vraies variations du chiffre d’affaires, des transactions et des volumes des défauts de données dans les tables qui les alimentent.
Questions fréquentes
Que signifie le monitoring en management ?
Le monitoring en management est un processus de contrôle, pas un simple tableau de bord. Les équipes définissent une plage attendue, observent un processus de données ou métier, repèrent les écarts significatifs, désignent un responsable, conservent les preuves et vérifient que la correction a fonctionné. Le tableau de bord soutient ce cycle sans le remplacer.
Quelle différence entre un tableau de bord et un contrôle de gestion ?
Un tableau de bord montre seulement ce qui se passe maintenant. Un contrôle de gestion couvre aussi l’attente, la matérialité, la responsabilité, la preuve et la réponse : quelle norme s’applique, quelle conséquence métier en découle, qui doit enquêter, quels enregistrements montrent le changement et quand clore le problème.
Quels sont les principaux types de monitoring en management ?
L’article en distingue trois. Le monitoring opérationnel vérifie la fraîcheur, le schéma, la santé des pipelines et le comportement de la plateforme. Le monitoring des KPI suit le chiffre d’affaires, les transactions ou les volumes face aux attentes métier. Le monitoring fondé sur les risques fixe la fréquence et l’intensité de chaque contrôle.
Pourquoi chaque alerte de monitoring a-t-elle besoin d’un responsable ?
Sans responsable désigné, une alerte relève de la télémétrie, pas du contrôle. Une équipe voit un indicateur rouge, suppose qu’une autre s’en charge, puis découvre que personne n’a conservé les preuves ni testé la correction. Une alerte utile relie responsable, impact métier, seuil d’action, piste de preuves et test de clôture.
À quelle fréquence faut-il surveiller les données ?
La fréquence doit suivre le risque plutôt qu’un rythme unique pour toutes les tables. Les jeux de données financièrement significatifs, les tables d’identité et les flux réglementaires méritent une surveillance plus étroite que les tables exploratoires. Le NIST recommande de l’ajuster selon la volatilité, le niveau d’impact, les faiblesses connues et la criticité.



