Algorithmes de correspondance floue : guide pratique
|
7
minute de lecture

Avec un niveau de confiance de 0,95 ou plus, une approche d'ensemble avec intervention humaine (human-in-the-loop) a atteint une précision de 88,0 %, tandis que la similarité de Jaccard atteignait 85,0 % dans la même plage de scores élevés. La réponse pratique : aucun algorithme de correspondance floue n'est le meilleur dans tous les cas, car une résolution d'identité fiable dépend de la normalisation, de la génération de candidats, des preuves par champ, des seuils et de la revue.
Vous y êtes probablement déjà confronté. Un client apparaît sous des noms légèrement différents dans les systèmes de facturation, de support et produit. L'adresse d'un fournisseur change de format d'une filiale à l'autre. Un dossier patient utilise une écriture dans un système et une version translittérée dans un autre. Les jointures exactes manquent des liens légitimes, tandis qu'une règle floue trop permissive peut fusionner des personnes qui ne font que se ressembler.
Le plus difficile n'est pas de produire un score de similarité. C'est de décider ce que ce score signifie, de prouver pourquoi une correspondance a été approuvée et de détecter le moment où le processus de rapprochement commence à défaillir sans prévenir.
Table des matières
Fondements : de la distance d'édition au couplage probabiliste
Comparer les grandes familles d'algorithmes et leurs compromis de performance
Pourquoi les scores de similarité ne sont pas des probabilités
Rapprochement multilingue et goulot d'étranglement du blocking
Stratégies de mise en œuvre pour les environnements de production
Intégrer la correspondance floue à l'observabilité des données
Le coût caché d'un rapprochement de données imprécis
Un prestataire de santé international peut construire une vue patient à partir des systèmes d'admission, de laboratoire, de facturation et cliniques. Une source enregistre « Muller », une autre « Miller », et une troisième inclut un deuxième prénom ou un autre format d'adresse. Une jointure d'égalité les traite comme des enregistrements distincts, même lorsque le personnel reconnaît immédiatement le lien probable.
L'erreur inverse est plus dangereuse. Deux patients peuvent partager un nom de famille, une adresse ou un prénom proche sans être la même personne. Une fusion erronée peut rattacher des résultats de laboratoire ou des antécédents cliniques au mauvais profil. Un doublon non résolu peut fragmenter les informations de soins, générer un travail administratif répété et affaiblir le reporting.
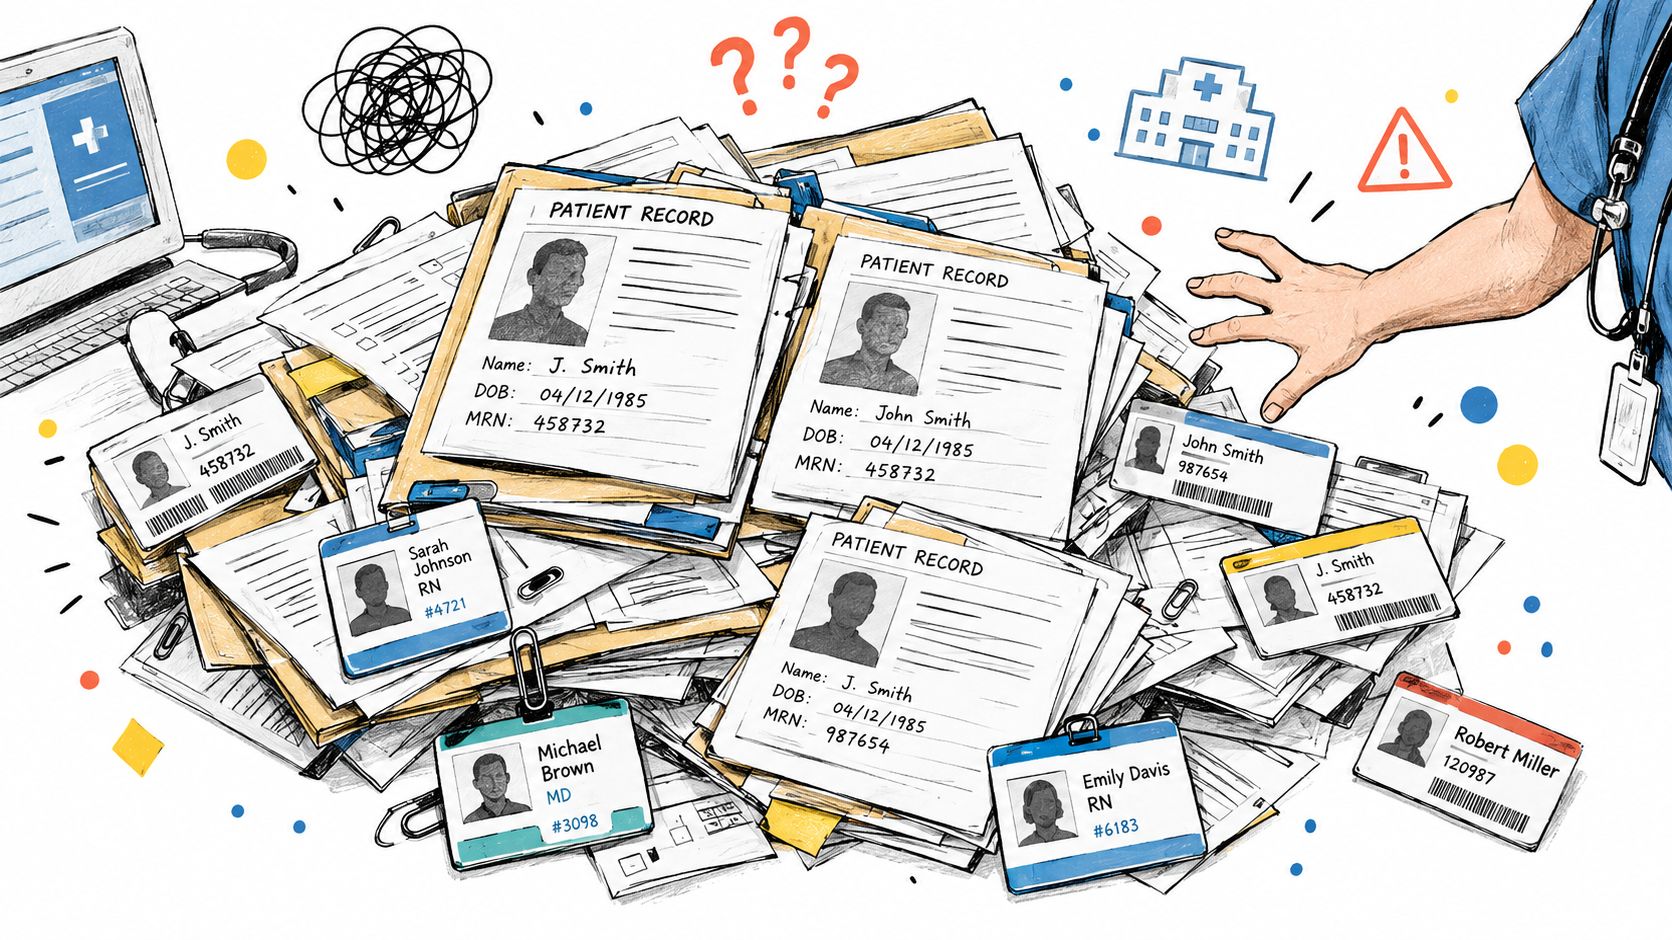
Pourquoi les jointures exactes échouent
La correspondance exacte suppose que les valeurs ont été saisies de façon cohérente et transmises sans variation notable. Les données d'entreprise respectent rarement cette hypothèse. Les noms comportent des variantes orthographiques, les adresses des abréviations et des éléments réordonnés, et les identifiants peuvent être incomplets ou copiés avec du bruit de formatage.
Les algorithmes de correspondance floue aident en mesurant la ressemblance plutôt qu'en exigeant une égalité caractère par caractère. Mais la ressemblance n'est qu'un indice. Un score sur le nom peut repérer une paire candidate, sans pouvoir établir l'identité sans le contexte des autres champs ni les conséquences métier d'une erreur.
Règle de production : traitez la correspondance floue comme un workflow de décision, pas comme une version plus intelligente d'une jointure d'égalité.
Cette distinction compte dans la finance, la santé, les services publics et la relation client. Une fausse correspondance relie des enregistrements sans rapport. Une fausse non-correspondance laisse la même entité fragmentée. Le coût de chaque erreur dépend du domaine, du champ et de ce que les systèmes en aval font de l'identité obtenue.
Les équipes devraient donc relier la conception du rapprochement à une prise de décision fondée sur la qualité des données plus large. La bonne question n'est pas « Quelles chaînes se ressemblent ? », mais « Quelles preuves étayent ce lien d'identité, quel risque crée une fusion erronée, et une autre personne pourra-t-elle auditer la décision plus tard ? »
Fondements : de la distance d'édition au couplage probabiliste
La correspondance floue est passée des méthodes de distance d'édition au couplage probabiliste formel d'enregistrements. En 1966, Vladimir Levenshtein a introduit la distance qui porte aujourd'hui son nom, soit le nombre minimal d'insertions, de suppressions ou de substitutions d'un seul caractère nécessaires pour transformer une chaîne en une autre, comme le décrit la littérature fondatrice sur le couplage d'enregistrements publiée par Fellegi et Sunter.
Une faute de frappe d'un caractère a une distance de 1. Les chaînes qui exigent davantage de modifications reçoivent des distances plus grandes. Comme l'opération est indépendante de la langue, elle s'est révélée utile pour la correction orthographique, la déduplication, la normalisation d'adresses et la résolution d'entités.
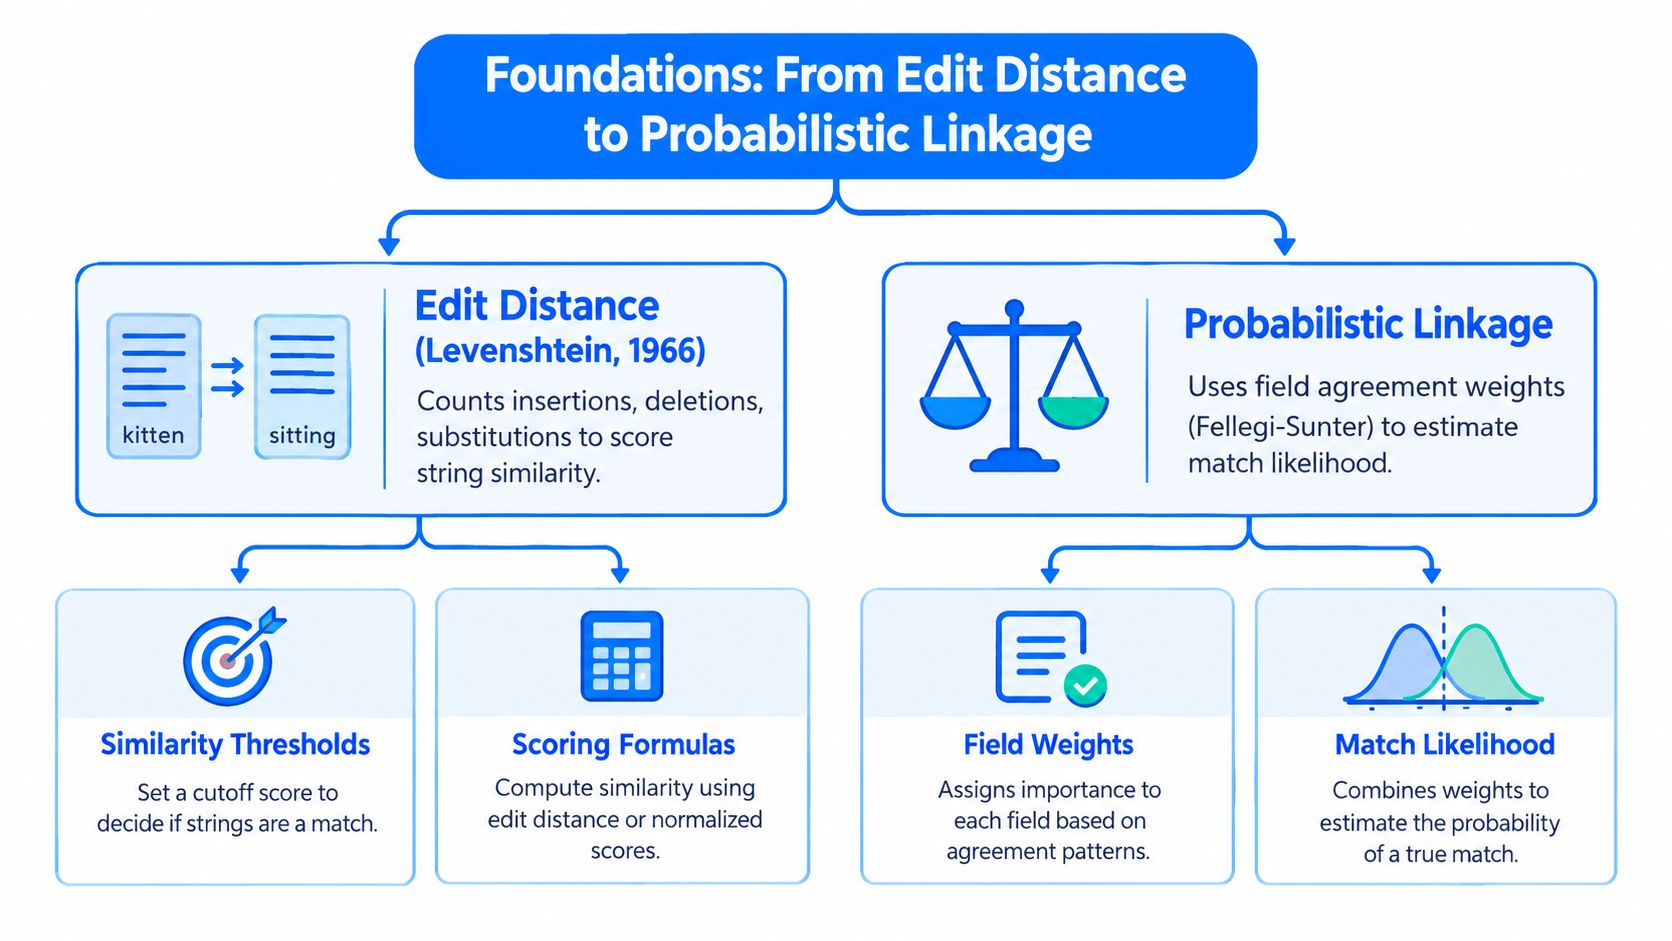
La distance mesure l'écart
La distance de Levenshtein répond à une question étroite mais précieuse : quelle quantité de texte doit changer pour obtenir l'autre valeur ? Elle ne sait pas si les valeurs appartiennent à la même personne, entreprise, au même compte ou à la même adresse.
Cela en fait une couche de comparaison utile. Elle peut repérer une faute de frappe dans un nom ou une petite altération d'un identifiant, mais ne devrait pas déclencher seule une fusion irréversible. Une même distance peut avoir un sens différent pour un nom court, une adresse longue ou un identifiant à haut risque.
Le couplage prend une décision
En 1969, Ivan Fellegi et Alan Sunter ont publié « A Theory for Record Linkage ». Leur cadre traitait le rapprochement comme un problème de décision statistique plutôt que comme un simple seuil de similarité. Il combine les preuves issues de champs comme les noms, les adresses, les dates de naissance et les identifiants, puis classe les paires candidates en correspondances, non-correspondances ou cas incertains à examiner.
Le cadre sépare explicitement les fausses correspondances des fausses non-correspondances et fixe les seuils en fonction des bornes supérieures souhaitées pour ces types d'erreur. Cette séparation reste centrale dans le rapprochement en entreprise, car automatisation et revue impliquent un arbitrage mesurable.
Couche | Question principale | Résultat type |
|---|---|---|
Distance d'édition | À quel point ces valeurs diffèrent-elles ? | Distance ou similarité |
Comparaison de champs | Quels attributs concordent ? | Preuves par champ |
Couplage probabiliste | Comment interpréter les preuves ? | Correspondance, non-correspondance ou revue |
Gouvernance | La décision pourra-t-elle être justifiée plus tard ? | Preuves versionnées et piste d'audit |
La leçon pratique est simple : utilisez la distance pour mesurer l'écart textuel, puis appuyez-vous sur des preuves multi-champs et des seuils gouvernés pour prendre une décision d'identité. C'est le pont entre la reconnaissance statistique de formes et les opérations de données en production.
Comparer les grandes familles d'algorithmes et leurs compromis de performance
En production, il existe rarement un seul meilleur algorithme. Le bon choix dépend du champ, de ses schémas d'erreur, du volume de candidats et du coût d'une mauvaise décision. Une étude comparative a évalué sept approches, à savoir la similarité de Jaccard, Jaro-Winkler, la plus longue sous-séquence commune, la distance de Levenshtein, la similarité cosinus, la correspondance par n-grammes et Damerau-Levenshtein, selon la précision, le rappel, la F-mesure, l'exactitude et la performance de calcul dans sa comparaison publiée.
L'expérience a montré que la correspondance par n-grammes offrait la meilleure précision, la meilleure F-mesure et la meilleure exactitude, tandis que la similarité cosinus était la plus rapide. N-grammes et Damerau-Levenshtein étaient les plus lents de cette comparaison. Ces résultats sont des preuves de benchmark, pas une règle de déploiement. Ils illustrent le compromis pratique : conserver davantage de détails locaux sur les caractères peut améliorer la qualité du rapprochement, mais augmente aussi le coût de traitement.
Adapter la famille aux données
Levenshtein convient aux chaînes courtes touchées par des erreurs d'insertion, de suppression ou de substitution. Damerau-Levenshtein ajoute les transpositions adjacentes, ce qui la rend utile lorsque les fautes de frappe comme les caractères inversés sont fréquentes.
Jaro-Winkler fonctionne souvent bien pour les noms et les identifiants courts, car des préfixes identiques peuvent porter un signal utile. Jaccard mesure le recouvrement de tokens, ce qui convient aux noms d'entreprises et aux éléments d'adresse lorsque l'ordre des mots compte moins. La similarité cosinus représente le texte sous forme de vecteurs et peut traiter efficacement des champs plus longs.
Famille d'algorithmes | Points forts | Meilleur cas d'usage | Coût de calcul |
|---|---|---|---|
Levenshtein | Comparaison claire fondée sur les éditions | Fautes de frappe et identifiants courts | Modéré |
Damerau-Levenshtein | Gère les transpositions adjacentes | Fautes de saisie dans les noms et les codes | Élevé |
Jaro-Winkler | Valorise les préfixes identiques | Noms de personnes et champs courts | Modéré |
Jaccard | Mesure le recouvrement d'ensembles de tokens | Adresses et noms d'entreprises | Modéré |
Similarité cosinus | Comparaison vectorielle rapide | Champs de texte plus longs | Faible dans la comparaison citée |
Correspondance par n-grammes | Capture la structure locale des caractères | Texte bruité et recouvrement partiel | Élevé dans la comparaison citée |
Plus longue sous-séquence commune | Préserve la structure de séquence partagée | Variations textuelles ordonnées | Dépend des données |
Pourquoi le scoring hybride l'emporte généralement
Les enregistrements combinent des champs aux modes de défaillance différents. Un nom peut nécessiter une similarité de caractères, une adresse peut tirer parti d'une comparaison de tokens et un identifiant peut exiger une validation déterministe. Appliquer une seule métrique partout crée des erreurs évitables et gaspille de la puissance de calcul sur des champs qui demandent un autre traitement.
Attribuez les algorithmes par champ, puis combinez leurs preuves selon des règles liées au risque d'identité. N'exécutez les comparaisons coûteuses qu'après que le blocking a réduit l'ensemble des candidats. Les résultats de benchmark peuvent guider la conception initiale, mais ce sont les paires étiquetées issues de vos propres données qui doivent déterminer si le calcul supplémentaire améliore suffisamment les décisions pour justifier son coût opérationnel. Conservez les algorithmes retenus, leurs versions, les seuils et les résultats de revue dans une piste d'audit afin que les changements ultérieurs restent explicables.
Pourquoi les scores de similarité ne sont pas des probabilités
Un moteur de rapprochement en production peut attribuer à deux fiches clients un score de similarité de 0,87 sans pour autant fournir de réponse directe sur l'identité. Le score mesure la ressemblance selon une métrique choisie. Il ne représente pas la probabilité que les enregistrements appartiennent à la même entité, n'indique pas quels champs ont produit le résultat et ne chiffre pas le coût d'une fusion erronée.
Les seuils révèlent l'écart entre mesure et décision. À 0,95 ou plus, une approche d'ensemble avec intervention humaine a atteint une précision de 88,0 %, contre 85,0 % pour la similarité de Jaccard dans cette plage de scores élevés. La précision de Jaccard est tombée à 53,0 % pour les scores compris entre 0,90 et 0,95, selon l'étude publiée sur la correspondance floue. Comme l'a montré le benchmark, un score élevé peut encore produire des correspondances dangereuses.
Le seuil appartient à la population
Un seuil réglé pour des noms de clients peut être risqué pour des adresses de fournisseurs. La translittération peut modifier le comportement des scores d'un pays à l'autre, et les identités de santé n'ont pas les mêmes conséquences que les contacts marketing lorsqu'une fusion est erronée.
Réglez les seuils avec des paires étiquetées issues de la population que le système traitera. Mesurez la précision et le rappel aux seuils utilisés en exploitation, puis ventilez les résultats par champ, type d'entité, zone géographique, langue et système source. Un score agrégé peut masquer une défaillance grave qui touche une seule langue ou une seule source.
Utiliser l'abstention à dessein
Un moteur de rapprochement en production a besoin d'un chemin maîtrisé pour l'incertitude. Définissez une bande d'abstention qui envoie les paires ambiguës à un réviseur habilité au lieu d'imposer une décision automatique.
Liaison automatique : exiger des preuves ayant passé les contrôles de risque applicables.
Revue : afficher les valeurs candidates, les preuves par champ, le seuil et la version de la règle.
Rejet : garder les enregistrements séparés lorsque les preuves disponibles ne justifient pas un lien.
Les décisions des réviseurs doivent devenir des données de gouvernance, et non disparaître dans une file d'attente. Stockez les valeurs candidates et normalisées, les scores par champ, le seuil de décision, la version de l'algorithme, le résultat de la revue et l'horodatage. Cette piste d'audit facilite les investigations, les changements de seuil et la reproductibilité des décisions.
Un score élevé est une mesure. Un lien d'identité approuvé est une décision gouvernée.
C'est ici que le coût des faux positifs et des faux négatifs devient opérationnel. Dans un domaine à haut risque, laisser un doublon possible non résolu peut être plus sûr que de créer une fusion erronée. Ailleurs, une génération large de candidats suivie d'une revue humaine peut offrir un meilleur contrôle. La bonne politique dépend de l'entité, des preuves et des conséquences d'une erreur.
Rapprochement multilingue et goulot d'étranglement du blocking
Les fautes de frappe à l'anglaise sont la démonstration facile. Les données de production apportent translittération, écritures multiples, changements d'ordre des noms, signes diacritiques, traits d'union et identifiants propres à chaque pays. Ces variations influent à la fois sur le rappel et sur le risque de faux positifs avant même qu'un algorithme de scoring n'évalue la paire.
La génération de candidats est le goulot d'étranglement caché. Si une stratégie de blocking place deux enregistrements correspondants dans des groupes différents, aucun algorithme de correspondance floue en aval ne peut retrouver cette relation.
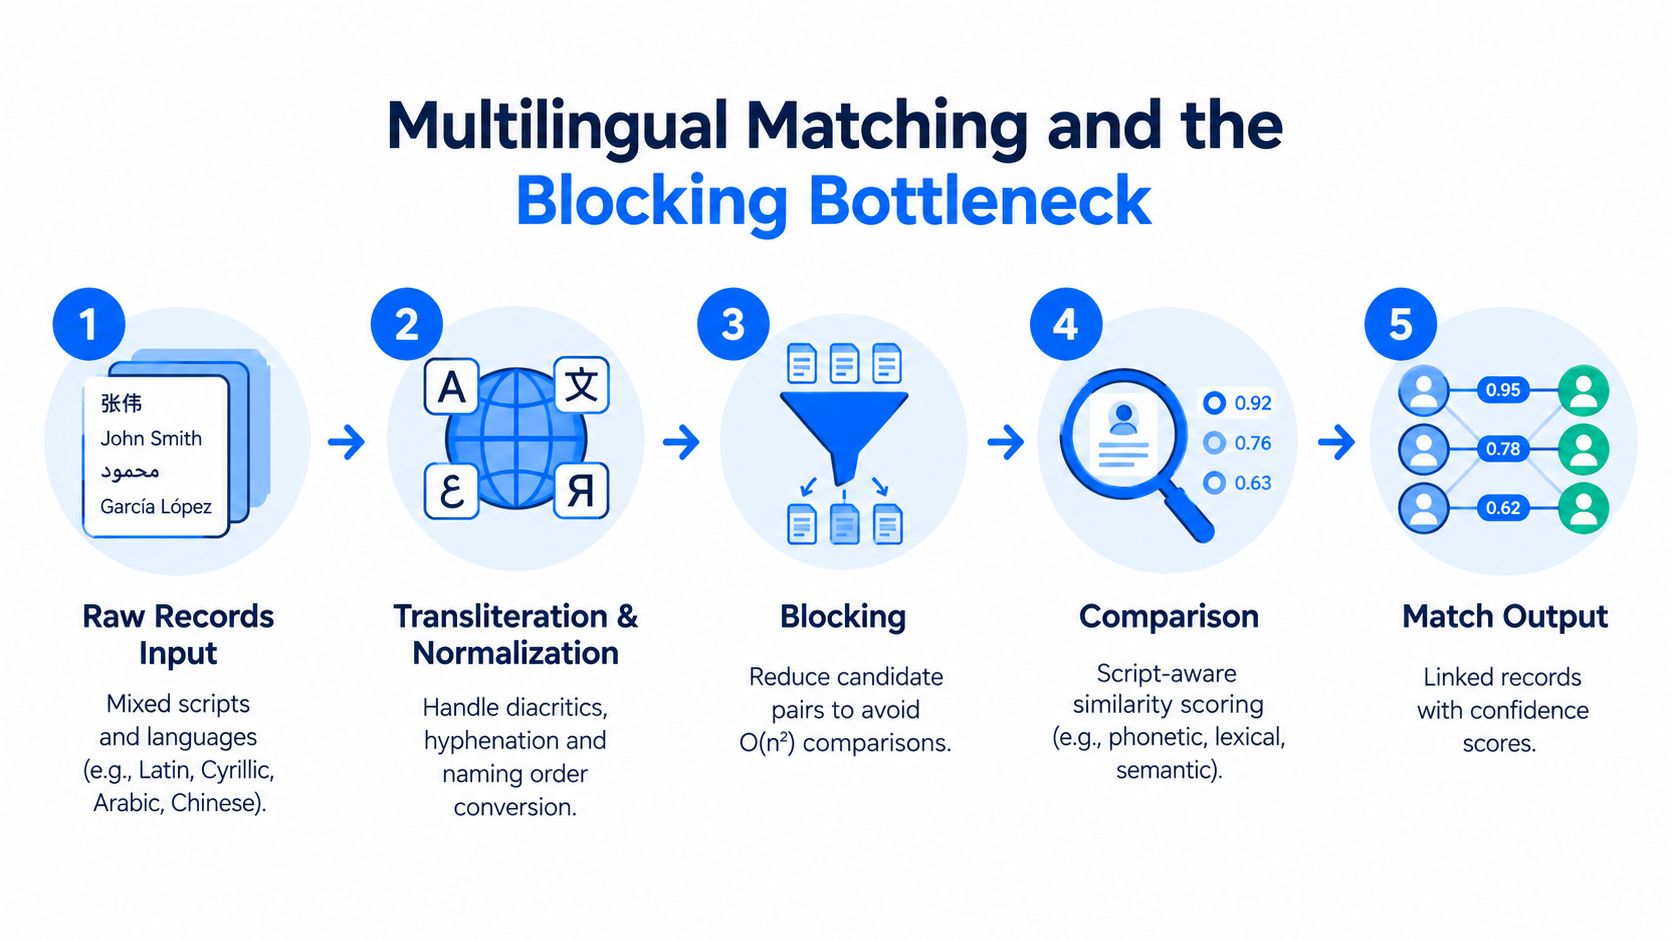
Normaliser sans détruire les preuves
Conservez les valeurs d'origine et créez des représentations normalisées à côté. La translittération peut faciliter la comparaison entre écritures, tandis que l'écriture d'origine reste indispensable pour la revue et l'audit. Normalisez les signes diacritiques, la ponctuation, les traits d'union et l'ordre des noms avec des règles adaptées à la langue et au type d'entité.
Le pays ou la juridiction peut fournir un contexte utile, mais ne devrait pas devenir une règle d'identité absolue. Une correspondance transfrontalière peut être légitime, alors qu'une correspondance apparemment locale peut être fausse. Les paires inter-écritures à faible confiance méritent une revue explicite plutôt qu'un rejet silencieux ou une approbation automatique.
Des travaux récents sur le couplage d'enregistrements indiquent que le blocking hiérarchique apporte la plus forte amélioration pour le rapprochement multilingue de parties et que le blocking par pays peut réduire les faux positifs entre pays, selon l'étude décrite.
Le blocking échange vitesse contre rappel
La comparaison naïve par paires croît de manière quadratique avec le nombre d'enregistrements. Le blocking et l'indexation réduisent l'ensemble des candidats, mais introduisent un nouveau mode de défaillance : une vraie paire peut être exclue avant le scoring.
Utilisez une génération de candidats en plusieurs couches plutôt qu'une clé unique et fragile :
Bloc principal : utiliser des signaux contextuels fiables comme la juridiction, le type d'entité ou des fragments d'identifiants normalisés.
Bloc de repli : autoriser des combinaisons plus larges pour les valeurs manquantes ou incertaines.
Chemin inter-écritures : comparer les représentations translittérées lorsque les écritures diffèrent.
Chemin de revue : conserver les candidats à faible confiance qui franchissent des frontières importantes.
Mesurez le rappel du blocking séparément de la qualité du scoring. Un modèle de scoring peut sembler excellent sur les candidats qu'il reçoit alors que la couche de blocking a déjà écarté des correspondances valides. Des tests par langue, écriture, pays et source mettront au jour ces pertes silencieuses.
Lors du prétraitement, même des tokens apparemment anodins peuvent fausser la comparaison. Les équipes devraient donc définir des règles de nettoyage propres à chaque champ plutôt que d'appliquer aveuglément une liste universelle de mots vides. Une référence pratique pour ce travail est cette ressource sur les mots vides, utilisée une fois dans la conception de la normalisation et non comme substitut à des règles adaptées à la langue.
Stratégies de mise en œuvre pour les environnements de production
Un rapprochement en production réussit grâce au contrôle, pas au seul choix de l'algorithme. Commencez par un workflow restreint, créez des exemples étiquetés et définissez ce que le système peut lier automatiquement, ce qui nécessite une revue et ce qui doit rester séparé.
Construire le pipeline de décision
Profiler d'abord les sources. Identifier les champs manquants, les variantes courantes, les schémas de doublons et le bruit propre à chaque source.
Normaliser dans des champs parallèles. Conserver les valeurs brutes pour l'audit et créer des valeurs normalisées pour la comparaison.
Appliquer un blocking prudent. Mesurer combien de vraies paires connues survivent à la génération de candidats.
Scorer par champ. Choisir les métriques selon le comportement du champ au lieu d'appliquer une fonction universelle.
Classer avec abstention. Séparer liaisons automatiques, candidats à revoir et non-correspondances.
Consigner les décisions. Stocker les preuves, les versions des règles, les seuils et les résultats de revue.
Une correspondance candidate n'est pas un lien d'identité approuvé. Cette distinction doit exister dans le modèle de données, dans l'interface utilisateur et dans les API en aval. Elle empêche que des recommandations provisoires soient consommées comme des données de référence faisant autorité.
Surveiller les erreurs qui comptent
Rapportez la précision et le rappel aux seuils opérationnels, puis ventilez les résultats par zone géographique, source, type d'entité et langue. Mesurez séparément les fausses correspondances et les fausses non-correspondances. Les réviseurs doivent voir les champs et les règles qui ont influencé chaque recommandation, et pas seulement un score opaque.
L'exécution dans la base de données peut réduire les mouvements de données et aligner le rapprochement sur les exigences de sécurité et de gouvernance. Un déploiement en cloud privé ou sur site (on-premises) peut aussi maintenir le processus dans l'environnement du client lorsque les contraintes de conformité rendent un traitement externe inadapté.
Une approche modulaire est plus simple à exploiter qu'un moteur de règles tentaculaire. Ajoutez une capacité de surveillance, validez son utilité et étendez le dispositif à mesure que les besoins mûrissent. Le modèle de gouvernance doit être versionné, vérifiable et réversible lorsqu'une nouvelle source modifie le comportement du moteur de rapprochement.
Les équipes qui évaluent la gestion des données de référence clients doivent porter une attention particulière à la survivance des valeurs (survivorship) et à la conception de l'audit. Le rapprochement détermine quels enregistrements sont liés, mais les processus de données de référence doivent aussi établir clairement quelles valeurs font autorité et comment les corrections ultérieures se propagent.
Intégrer la correspondance floue à l'observabilité des données
Un moteur de rapprochement peut terminer chaque tâche planifiée et pourtant se dégrader. De nouveaux formats de source, une composition de population différente, des conventions de nommage modifiées et des changements de schéma peuvent déplacer les distributions de scores sans provoquer de panne visible du pipeline.
C'est pourquoi la surveillance doit porter sur le comportement, pas seulement sur la disponibilité. Suivez les taux de correspondance, les distributions de scores, les volumes de revue, les franchissements de seuil, les exclusions dues au blocking et les schémas de faux positifs confirmés. Un changement soudain de l'un de ces signaux peut indiquer une dérive en amont ou une hypothèse qui ne tient plus.
Relier les décisions d'identité au comportement des données
Les changements de schéma méritent une attention particulière. Des colonnes ajoutées, des types de données modifiés ou de nouvelles catégories d'entités peuvent modifier la disponibilité et la pondération des champs. Si la logique de rapprochement ne détecte pas ces changements, elle peut continuer à fonctionner tout en produisant des liens moins fiables.
Une pratique plus large d'observabilité des données peut relier les résultats du rapprochement à la ponctualité, à la validation, à la détection d'anomalies et à la surveillance des schémas. Les data engineers disposent ainsi d'une vue partagée pour savoir si un problème de rapprochement trouve son origine dans l'algorithme, les données sources, le pipeline ou la politique de décision.
Pour les équipes soumises à une réglementation, le socle utile comprend :
Preuves de décision : quelles valeurs et quels champs ont étayé chaque lien ?
Historique des politiques : quel seuil et quelle version d'algorithme étaient actifs ?
Segments de population : la performance a-t-elle changé selon la zone géographique, la langue ou la source ?
Retour humain : quels candidats les réviseurs ont-ils acceptés ou rejetés ?
Dérive opérationnelle : les arrivées de données, les schémas ou les distributions ont-ils changé ?
La mise en œuvre la plus solide traite la correspondance floue comme un produit de données gouverné. Elle ne s'arrête pas à la liaison des enregistrements. Elle observe comment ces liens se comportent dans le temps et donne aux équipes assez de preuves pour enquêter, corriger et expliquer le résultat.
digna aide les équipes data à surveiller les signaux de qualité autour de la correspondance floue, notamment la validation des enregistrements, les anomalies, la ponctualité et les changements de schéma, tout en maintenant l'exécution dans l'environnement du client. Rendez-vous sur digna pour découvrir comment relier la gouvernance des décisions de rapprochement à une observabilité des données plus large.
Comme une colonne renommée ou un type de données modifié peut changer discrètement les champs qui parviennent au moteur de rapprochement, il vaut la peine de surveiller les structures sources d'aussi près que les taux de correspondance. Découvrez comment le suivi des changements de schéma signale ces modifications avant qu'elles ne faussent les décisions d'identité.
Questions fréquentes
Quel est le meilleur algorithme de correspondance floue ?
Aucun n'est le meilleur dans tous les cas. Dans une comparaison publiée de sept approches, la correspondance par n-grammes a obtenu la meilleure précision, F-mesure et exactitude, tandis que la similarité cosinus était la plus rapide. En production, on attribue généralement une métrique par champ, comme Jaro-Winkler pour les noms et Jaccard pour les adresses, puis on combine les preuves.
Quelle est la différence entre la distance de Levenshtein et celle de Jaro-Winkler ?
Levenshtein compte le nombre minimal d'insertions, de suppressions ou de substitutions d'un caractère pour transformer une chaîne en une autre, ce qui convient aux fautes de frappe et aux identifiants courts. Jaro-Winkler valorise les préfixes identiques et s'impose donc pour les noms de personnes et les autres champs courts dont les premiers caractères portent l'essentiel du signal.
Un score de similarité en correspondance floue est-il une probabilité de correspondance ?
Non. Un score comme 0,87 mesure seulement la ressemblance selon une métrique donnée. Il n'indique ni quels champs ont déterminé le résultat ni ce que coûte une fusion erronée. Dans l'étude citée, la précision de Jaccard est tombée à 53 % pour les scores entre 0,90 et 0,95 : un score élevé peut donc rester risqué.
Qu'est-ce que le blocking dans le couplage d'enregistrements ?
Le blocking limite les comparaisons aux paires candidates qui partagent une clé, comme la juridiction ou un fragment d'identifiant normalisé, car la comparaison naïve par paires croît de façon quadratique. La contrepartie est le rappel : si deux vrais enregistrements tombent dans des blocs différents, aucun algorithme en aval ne peut retrouver le lien. Il faut donc le mesurer séparément.
Comment fixer un seuil de correspondance floue ?
Réglez-le avec des paires étiquetées issues de la population que le moteur traitera réellement, puis contrôlez la précision et le rappel par langue, zone géographique, source et type d'entité. Plutôt qu'un seuil unique, prévoyez une bande d'abstention qui envoie les paires ambiguës à un réviseur et conserve les preuves, le seuil et la version de la règle pour l'audit.



