Contrôle qualité des KPI : un guide pratique de gouvernance
|
8
minute de lecture

Un tableau de bord peut se charger parfaitement et raconter malgré tout la mauvaise histoire. C'est la faiblesse inconfortable de la plupart des programmes de contrôle qualité des KPI : les équipes vérifient que les données sont arrivées, que les colonnes respectent un schéma et que les rapports se sont actualisés, puis considèrent ces succès techniques comme la preuve que l'indicateur peut être utilisé sans risque.
Ce n'est pas le cas. Un KPI peut être complet, à jour et correctement typé tout en devenant stratégiquement trompeur après une acquisition, une modification tarifaire, une variation de change, une évolution du mix clients ou un changement de dénominateur. Une surveillance fiable doit tester l'adéquation à la décision, pas seulement la santé du pipeline. Il s'agit de se demander si l'indicateur signifie toujours ce que la direction pense, s'il reste comparable aux périodes précédentes et s'il soutient la décision qui lui est rattachée.
Table des matières
Comprendre le contrôle qualité des KPI dans les plateformes de données modernes
Mettre en place une gouvernance et des responsabilités claires
Comprendre le contrôle qualité des KPI dans les plateformes de données modernes
La plupart des équipes data commencent par des questions opérationnelles : le job s'est-il exécuté ? La table a-t-elle été mise à jour ? La requête du tableau de bord a-t-elle réussi ? Ces contrôles comptent, mais ils décrivent l'état de la plateforme de données plutôt que la fiabilité de la conclusion métier.
Un calcul de croissance du chiffre d'affaires techniquement valide peut tout de même induire en erreur si une acquisition modifie la population, si des hausses de prix expliquent la variation ou si le dénominateur exclut une cohorte devenue pertinente. Un KPI de fidélisation client peut aussi paraître stable alors que la définition du client a changé. Rien ne casse forcément au niveau du schéma. La défaillance se situe dans la relation entre l'indicateur et la décision qu'il doit éclairer.
La propreté technique n'est que la première étape
Un système de contrôle des KPI utile distingue trois questions :
Le pipeline peut-il produire la valeur ? Vérifiez la livraison, le schéma, les types, les valeurs nulles, le volume et le statut de traitement.
La valeur signifie-t-elle ce que dit la définition ? Vérifiez les filtres, les cohortes, les jointures, les dénominateurs, les fenêtres temporelles, les données de référence et le rapprochement avec le système de référence.
L'indicateur reste-t-il utile pour la décision prévue ? Vérifiez la comparabilité, la matérialité, le contexte métier et les hypothèses que la direction utilise pour interpréter les variations.
C'est à la troisième question que de nombreux programmes s'arrêtent. Les équipes peuvent alerter sur des valeurs inhabituelles sans déterminer si la variation reflète un défaut ou un événement opérationnel légitime. Cela crée deux risques opposés. Un KPI discret mais faussé passe inaperçu, tandis qu'un changement saisonnier ou stratégique valable génère un bruit que les utilisateurs apprennent à ignorer.
Une approche pratique de la data observability doit donc relier les signaux techniques à une responsabilité sémantique. Chaque KPI critique a besoin d'une définition approuvée, d'un responsable métier nommé, d'un lien avec le système de référence et d'une explication des décisions qui en dépendent.
Règle pratique : Un pipeline qui passe prouve que les données ont circulé. Il ne prouve pas que l'indicateur métier est resté adapté à la décision.
Faire de la comparabilité un contrôle explicite
Commencez par documenter la population de l'indicateur, son numérateur, son dénominateur, ses filtres, sa granularité, sa fenêtre temporelle, le traitement des devises et les exclusions. Consignez ensuite les événements susceptibles de modifier l'interprétation, notamment les lancements de produits, les acquisitions, les changements de prix, les redécoupages de territoires et les mises à jour de politiques.
Le contrôle doit distinguer un changement de calcul d'un changement métier. Si la formule a changé, le responsable doit évaluer la comparabilité historique et versionner la définition. Si l'activité a changé, le responsable peut approuver l'anomalie en documentant pourquoi le KPI reste utile, ou expliquer pourquoi une série retraitée, une nouvelle cohorte ou un indicateur de remplacement est nécessaire.
Le contrôle qualité des KPI passe ainsi d'une collection de tests de données à un système de protection des décisions. Les ingénieurs continuent de surveiller la mécanique, mais les responsables métier valident le sens.
Le vrai coût d'une qualité des données KPI négligée
Une validation faible des indicateurs provoque rarement une panne spectaculaire. Le plus souvent, une valeur incorrecte se retrouve dans une présentation de planification, une évaluation de performance, une prévision, un rapport de conformité ou un workflow d'IA. L'organisation passe alors du temps à débattre du résultat, à corriger les supports en aval, à relancer des analyses et à restaurer la confiance dans le processus de reporting.
Selon Gartner, la mauvaise qualité des données coûte aux organisations au moins 12,9 millions de dollars par an en moyenne, d'après une étude de 2020, tandis que 59 % des organisations ne mesurent pas la qualité des données, comme le résume la synthèse de Docsumo sur le coût des mauvaises données. L'estimation provient d'une enquête menée auprès de 154 clients de référence de 16 éditeurs de solutions de qualité des données : elle ne doit donc pas être considérée comme un coût universel pour toute entreprise. Elle montre néanmoins pourquoi les organisations doivent relier les défauts à leurs conséquences métier plutôt que de traiter la qualité comme un score d'ingénierie abstrait.
Construire une chaîne de preuves du défaut à la décision
Un programme de contrôle mature enregistre plus qu'une alerte. Il doit conserver :
Le défaut, par exemple un chargement manquant, une valeur invalide, une jointure modifiée, un enregistrement obsolète ou une définition divergente.
Le KPI concerné, avec son responsable, ses consommateurs, ses supports de reporting et ses modèles dépendants.
L'impact métier, par exemple une prévision faussée, une action retardée, un rapport inexact ou une investigation inutile.
La correction, avec la modification technique, l'approbation métier, les preuves de validation et la date de clôture.
La mesure de prévention, par exemple une nouvelle règle, une définition révisée, une mise à jour du lignage ou un ajustement de seuil.
Cette chaîne donne aux responsables financiers et à la direction une raison défendable de financer les contrôles. Elle aide aussi l'ingénierie à prioriser. Un défaut dans une table exploratoire peu utilisée ne devrait pas recevoir la même réponse qu'un défaut touchant le reporting réglementaire, la gestion des revenus ou un KPI de direction.
L'argument financier dépasse les équipes data. Un rapport 2025 de l'IBM Institute for Business Value indique que 43 % des directeurs des opérations considèrent les problèmes de qualité des données comme leur priorité data la plus importante, et que plus d'un quart des organisations estiment leurs pertes annuelles dues à la mauvaise qualité des données à plus de 5 millions de dollars. Ces chiffres figurent dans l'analyse d'IBM sur la mauvaise qualité des données, qui présente le sujet comme un enjeu opérationnel plutôt qu'un problème de plateforme limité.
Les équipes qui évaluent l'impact commercial peuvent aussi utiliser corriger les données erronées pour le chiffre d'affaires comme référence pratique pour relier des données peu fiables aux processus de revenus. La bonne question n'est pas : « Combien d'enregistrements ont échoué ? » Mais : « Quelles décisions ces enregistrements ont-ils influencées, et qu'a fait l'organisation parce que le KPI était faux ? »
Mesurer ensemble la qualité et ses conséquences
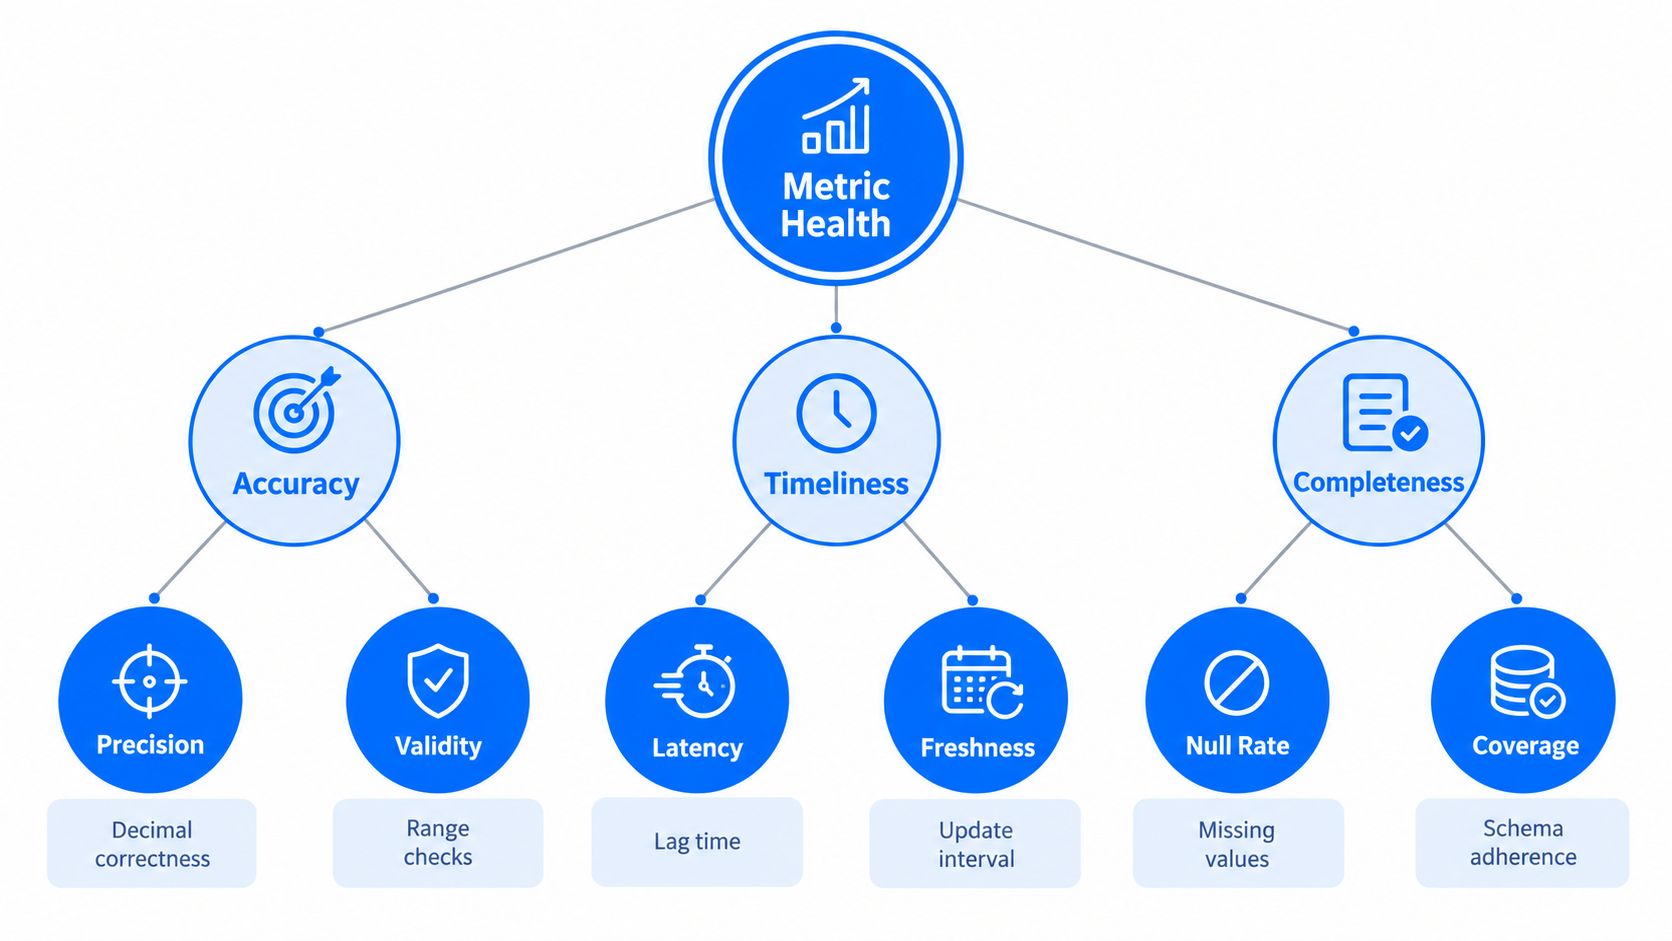
Suivez des dimensions telles que l'exactitude, la complétude, la cohérence, la validité, la ponctualité, l'unicité et la pertinence. Associez-les ensuite à des mesures opérationnelles comme la gravité des incidents, les rapports concernés, le délai de correction, la récurrence et la part d'anomalies acceptées par rapport aux anomalies défectueuses.
Un score composite unique masque les arbitrages. Une complétude élevée peut coexister avec une faible exactitude. Une excellente fraîcheur peut coexister avec une définition métier erronée. Des dimensions séparées rendent la défaillance diagnosticable et permettent aux responsables de choisir les contrôles selon la matérialité.
Pour les dirigeants qui ont besoin d'un business case concis, le guide de digna sur le business case de la qualité des données peut appuyer la discussion. L'argument le plus solide est généralement un lien auditable entre un défaut de données, un KPI faussé, une décision retardée ou erronée et un contrôle qui réduit le risque de récidive.
Les dimensions clés d'indicateurs métier fiables
Un KPI ne devrait pas recevoir une simple étiquette réussi ou échoué puis disparaître dans un tableau de bord. La qualité est multidimensionnelle, et chaque dimension exige un test différent. Une colonne peut respecter son type déclaré tout en portant un sens métier erroné. Un jeu de données complet peut tout de même contenir des valeurs incorrectes.
Séparer syntaxe, sens et utilité
La norme ISO 8000-1:2022 définit des concepts de qualité qui peuvent être opérationnalisés par des contrôles : la qualité syntaxique concerne la conformité à un format approuvé, la qualité sémantique le fait que les valeurs représentent bien le sens voulu, et la qualité pragmatique l'adéquation des données aux utilisateurs et aux décisions prévus. Le cadre est résumé dans la présentation d'ISO 8000.
Appliquez directement ces concepts :
Couche de qualité | Ce qui est testé | Contrôle KPI pratique |
|---|---|---|
Syntaxique | Si les données suivent la structure approuvée | Contrôles de schéma, de type, de format et de valeurs autorisées |
Sémantique | Si les valeurs représentent le concept voulu | Validation de la définition, des jointures, des cohortes, du dénominateur et des données de référence |
Pragmatique | Si le KPI soutient la décision prévue | Acceptation par le responsable, revue de comparabilité, matérialité et tests d'usage décisionnel |
Les contrôles syntaxiques sont généralement les plus faciles à automatiser. Vérifiez que les dates sont des dates, que les identifiants suivent le format attendu, que les champs numériques restent dans des formats acceptables et que les colonnes obligatoires existent. Ces contrôles détectent tôt les défaillances structurelles, mais ils ne peuvent pas déterminer si « client actif » correspond toujours à la définition métier approuvée.
Les contrôles sémantiques demandent une documentation plus solide. Rapprochez les totaux du KPI du système de référence concerné, testez séparément les populations du numérateur et du dénominateur et comparez les résultats entre cohortes et fenêtres temporelles approuvées. Si un indicateur utilise des données de référence, surveillez les modifications de ces données avec autant de soin que celles de la table de faits.
Les contrôles pragmatiques appartiennent à ceux qui utilisent l'indicateur. Le responsable métier doit confirmer si le KPI reste adapté aux décisions de planification, de tarification, de risque, d'exploitation ou de conformité. C'est aussi là que les anomalies légitimes reçoivent un contexte au lieu d'être automatiquement supprimées.
Traiter la complétude et la validité comme des contrôles distincts
Le cadre de qualité des données du gouvernement britannique distingue la complétude de la validité. La complétude demande si les enregistrements requis et les champs essentiels sont présents. La validité demande si les valeurs correspondent aux plages et formats attendus. Le cadre avertit explicitement que des données complètes ne sont pas nécessairement exactes.
Cette distinction change la manière dont les équipes conçoivent leurs tests :
Les contrôles de couverture identifient les enregistrements, périodes, entités ou flux sources manquants.
Les contrôles de champs obligatoires identifient les valeurs absentes dans les champs nécessaires au calcul.
Les contrôles de validité imposent formats, plages, valeurs autorisées et types attendus.
Les contrôles d'exactitude rapprochent les valeurs d'une source fiable ou d'un processus métier.
Les contrôles de cohérence comparent un même concept entre systèmes, produits et couches de reporting.
Les contrôles de ponctualité comparent les arrivées au comportement de livraison attendu, et pas seulement à une heure fixe.
Utilisez les dimensions de la qualité des données de digna comme référence pour transformer ces catégories en inventaire de surveillance. Le choix de conception essentiel consiste à garder les dimensions visibles. Un simple badge « sain » peut masquer précisément la faiblesse qui invalide une décision.
Mettre en place une gouvernance et des responsabilités claires
Le plus difficile dans le contrôle qualité des KPI n'est pas d'écrire une règle de validation. C'est de décider qui agit quand la règle se déclenche, qui peut accepter une anomalie comme légitime et qui doit prouver que l'indicateur peut de nouveau être publié en toute sécurité.
L'enquête 2025 d'Actian menée auprès de plus de 600 professionnels de la donnée en entreprise a montré que 83 % rencontraient des difficultés de gouvernance et de conformité, alors même que les organisations évaluaient leur maturité en gouvernance à 4,13 sur 5, les dirigeants notant la maturité des données 12 % plus haut que les praticiens. Ces résultats sont publiés dans l'enquête d'Actian sur la maturité de la gouvernance. Cet écart révèle un problème concret : la confiance de la direction peut progresser plus vite que la clarté opérationnelle.
Inscrire la responsabilité dans le contrat de l'indicateur
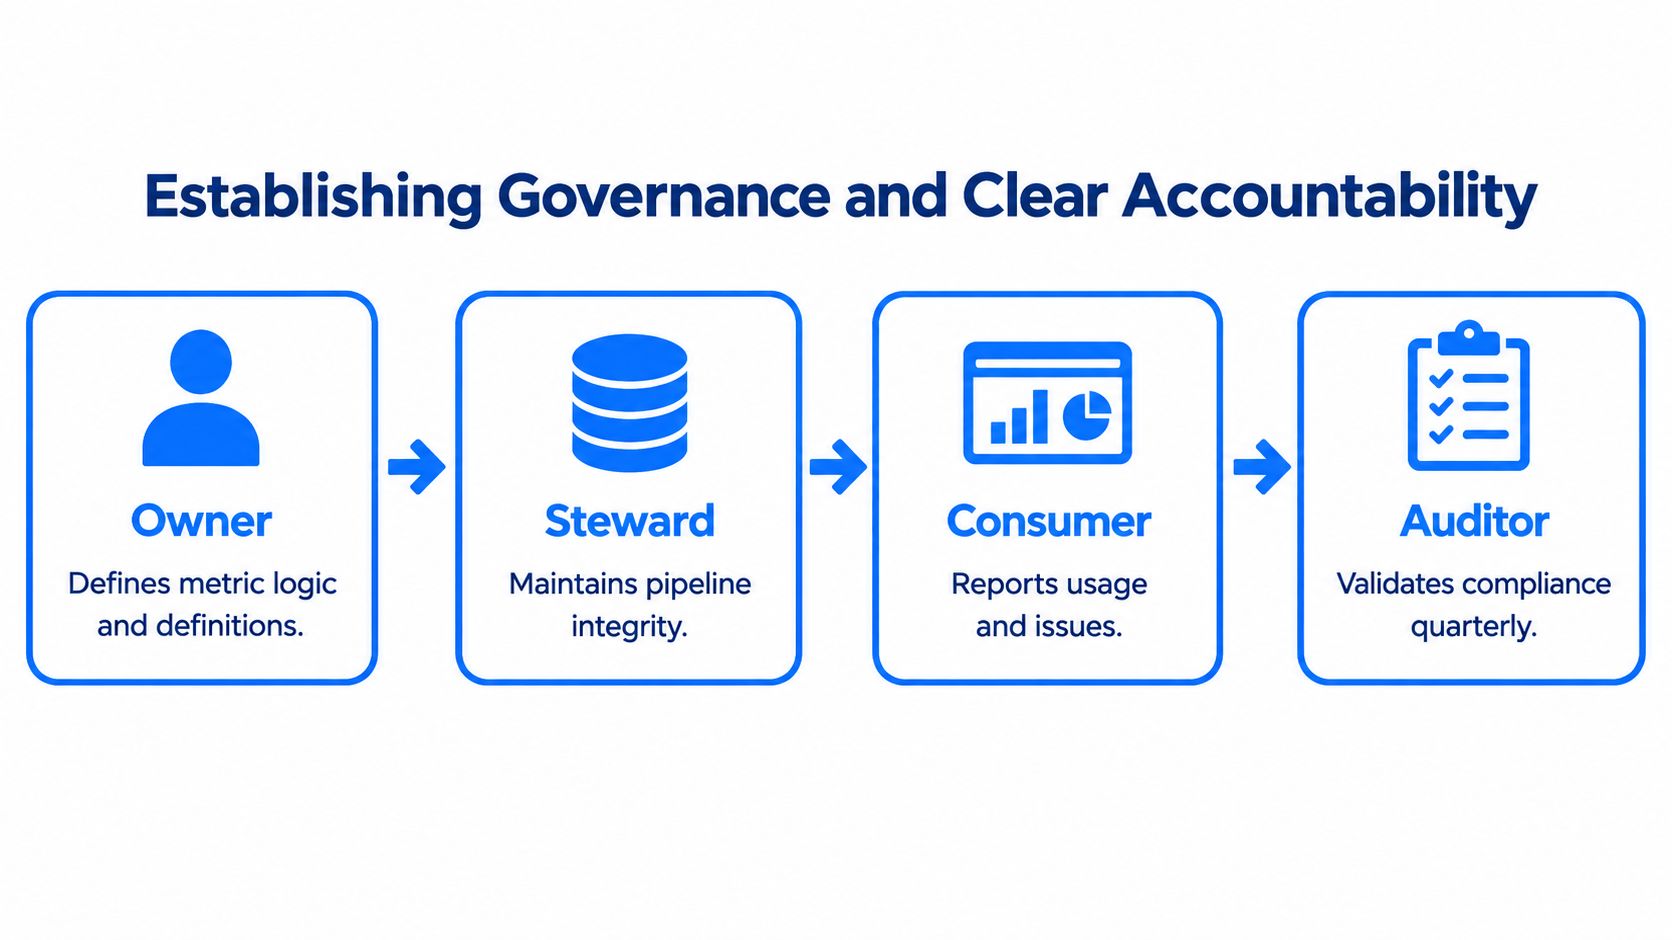
Pour chaque KPI critique, consignez :
Responsable métier : Définit ce que signifie l'indicateur, approuve son interprétation et décide s'il reste adapté à son usage.
Responsable technique : Maintient les pipelines, les transformations, les tests et les dépendances.
Data steward : Maintient les définitions, les données de référence, le lignage et la documentation.
Consommateur : Signale les comportements inattendus et explique comment le KPI est utilisé.
Auditeur ou contrôleur : Vérifie les preuves, les approbations et l'historique des corrections.
Le responsable doit aussi approuver un seuil de matérialité. Une variation mineure peut ne nécessiter qu'une observation, tandis qu'un mouvement brutal sur un KPI réglementaire, financier ou opérationnel peut exiger un gel de la publication et une escalade auprès de la direction. Les seuils doivent refléter l'impact sur les décisions, pas seulement le caractère statistiquement inhabituel.
Concevoir la fiche d'incident avant l'incident
Une fiche d'incident utile consigne la condition détectée, la période concernée, la version actuelle de la définition, les changements de source, la gravité, le responsable, l'impact sur les décisions, la qualification, la correction et les preuves de revalidation. Elle doit distinguer trois issues :
Défaut technique, lorsque la source ou la transformation est erronée.
Défaut sémantique, lorsque le calcul ne correspond plus au sens approuvé.
Événement légitime, lorsque l'activité a changé et que le KPI reflète correctement ce changement.
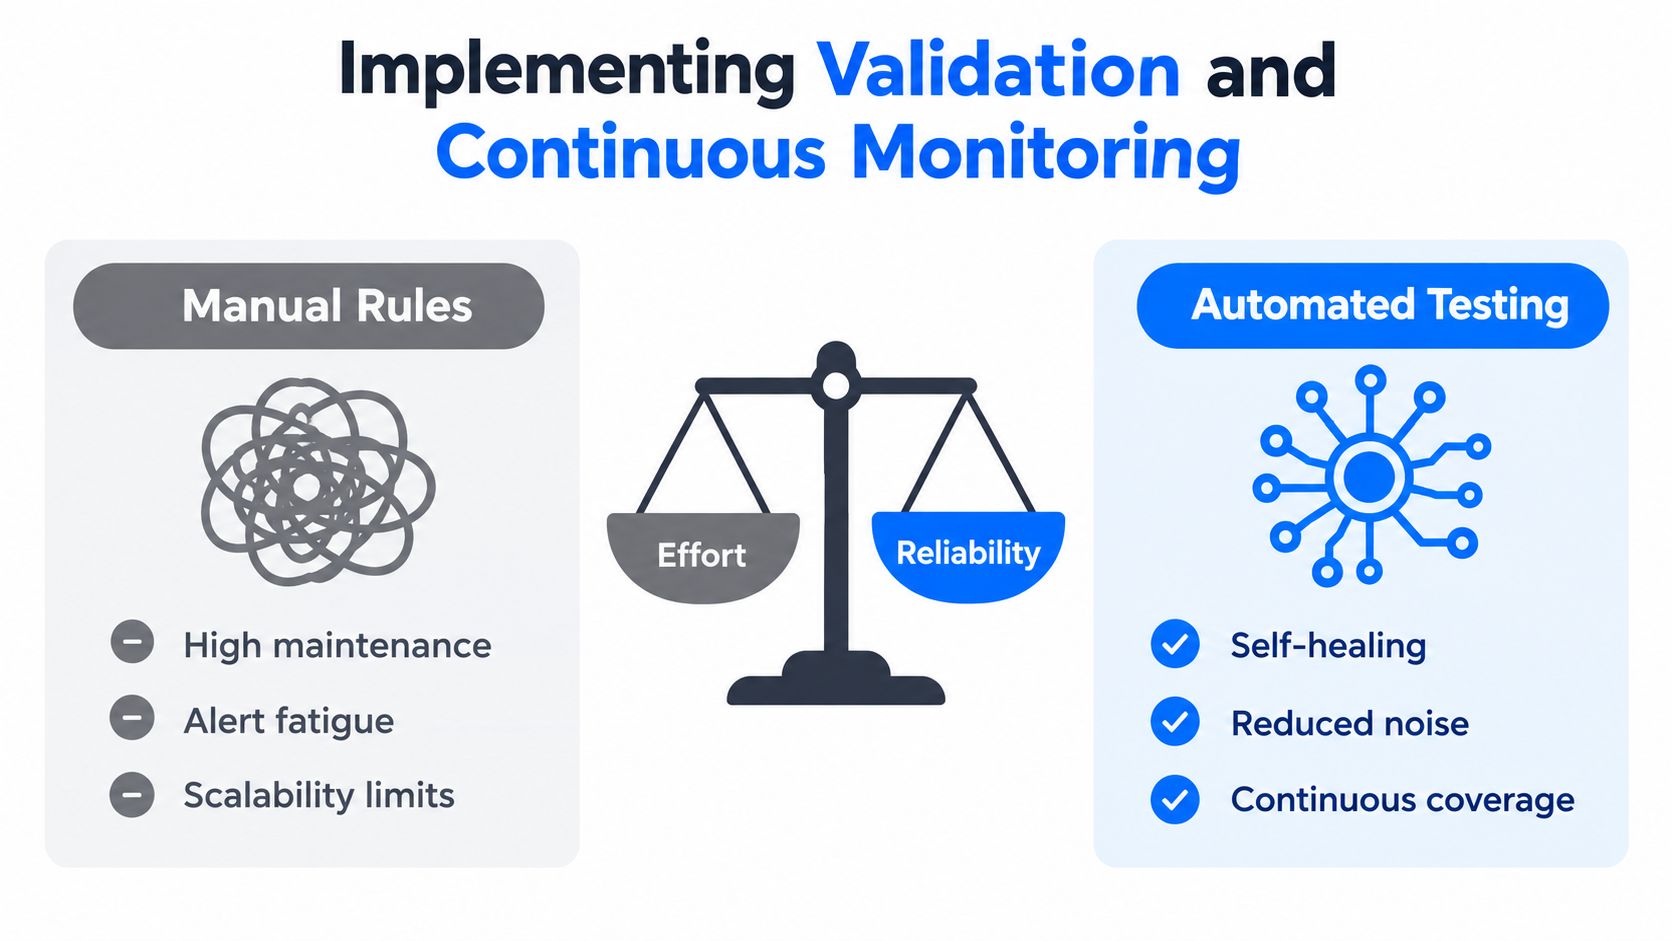
Les règles manuelles restent précieuses pour des assertions stables à fort enjeu. Elles deviennent coûteuses lorsque les équipes écrivent des seuils distincts pour chaque table, cohorte et contexte de reporting, puis les réajustent après chaque évolution normale de l'activité. Les références automatiques peuvent réduire la maintenance et révéler des dérives inconnues, mais elles ne remplacent pas l'approbation métier. Un détecteur d'anomalies peut dire « inhabituel ». Il ne peut pas décider si une nouvelle politique tarifaire rend la variation correcte.
Utilisez la ressource de digna sur la gouvernance de la qualité des données pour façonner le modèle opérationnel. Le résultat essentiel est une responsabilité mesurable, incluant le délai de tri, le délai de correction, les preuves de clôture, la récurrence et la part des alertes que les responsables classent comme événements métier valides.
Un programme de gouvernance efficace rend les désaccords visibles. Si les dirigeants voient de la maturité dans un score alors que les praticiens manquent de responsables et de circuits d'escalade, l'environnement de contrôle n'est pas encore mature. Il est documenté, mais pas opérationnel.
Mettre en œuvre la validation et la surveillance continue
Les règles écrites à la main sont précises, mais elles ne passent pas indéfiniment à l'échelle. Elles conviennent bien aux conditions contractuelles, aux exigences réglementaires et à la logique métier connue. Elles conviennent mal comme unique méthode pour découvrir des comportements inattendus dans un parc de pipelines vaste et changeant.
Combiner contrôles déterministes et comportementaux
La validation déterministe vérifie si une valeur ou un enregistrement satisfait une condition explicite. Par exemple :
Une commande doit faire référence à un client existant.
La date d'une transaction doit se situer dans une période de reporting autorisée.
Le dénominateur d'un KPI ne doit pas être nul.
Un champ réglementé doit utiliser un code approuvé.
Un événement métier requis doit arriver avant l'exécution de l'agrégation dépendante.
Ces règles sont explicables et auditables. Elles exigent aussi de la maintenance. Les définitions métier changent, les systèmes sources évoluent et les exceptions se multiplient. Sans responsables, les collections de règles deviennent fragiles et le volume d'alertes augmente jusqu'à ce que les ingénieurs cessent de leur faire confiance.
La surveillance comportementale adopte une autre approche. Elle apprend le comportement normal d'un jeu de données, d'un calendrier de livraison, d'un profil de volume ou d'un KPI métier, puis met en évidence les mouvements inhabituels. C'est utile pour les défaillances inconnues, les dérives progressives, une volatilité inhabituelle, les chargements manquants et les changements que personne n'avait anticipés lors de l'écriture des règles d'origine.
Le compromis porte sur l'interprétabilité. Une règle fixe peut expliquer exactement pourquoi une ligne a échoué. Une alerte comportementale peut détecter un écart significatif sans en identifier la cause. C'est pourquoi l'architecture la plus solide combine les deux méthodes au lieu de les opposer.
Garder les données sensibles là où elles sont
Dans les environnements d'entreprise, l'architecture de surveillance compte autant que la logique de détection. Exécuter le calcul des indicateurs et les contrôles au niveau des enregistrements dans les propres bases de données du client peut réduire les mouvements de données et faciliter le respect des exigences de sécurité. Les équipes peuvent aussi valider les données de l'entrepôt et du lac là où elles se trouvent déjà, au lieu de créer des circuits d'extraction supplémentaires pour l'observabilité.
Une séquence de mise en œuvre pratique se présente ainsi :
Commencer par les KPI critiques, leurs tables sources, définitions, responsables et décisions métier.
Ajouter des contrôles déterministes pour les conditions connues d'exactitude, de conformité et de rapprochement.
Établir des références comportementales pour le volume, la fraîcheur, les distributions et les variations des KPI.
Acheminer les alertes selon la responsabilité, et non vers un canal partagé sans personne chargée de répondre.
Analyser l'issue des alertes, puis ajuster les seuils, les définitions et la gravité en fonction des décisions réelles.
Le guide sur la validation des données, les règles, les contrôles et la qualité continue aide à organiser cette combinaison de validation au niveau des enregistrements et de surveillance continue. Le choix de la plateforme compte moins que la discipline opérationnelle. Chaque alerte a besoin d'un destinataire, d'un circuit de décision et d'une trace de ce qui s'est passé ensuite.
Gérer la sensibilité des alertes comme un budget opérationnel
Une sensibilité élevée détecte davantage de défaillances potentielles, mais génère aussi plus de bruit. Une sensibilité faible préserve l'attention, mais peut manquer des défauts progressifs ou de faible volume. Fixez la gravité selon l'impact métier, puis passez en revue les faux positifs et les incidents manqués dans le cadre du programme de contrôle.
Ne supprimez pas automatiquement les mouvements inhabituels. Demandez-vous d'abord si l'événement est réel, si la définition s'applique toujours et si la décision concernée exige un indicateur retraité. La détection statistique doit déclencher une investigation, pas se substituer à la responsabilité.
Concevoir des workflows de correction efficaces
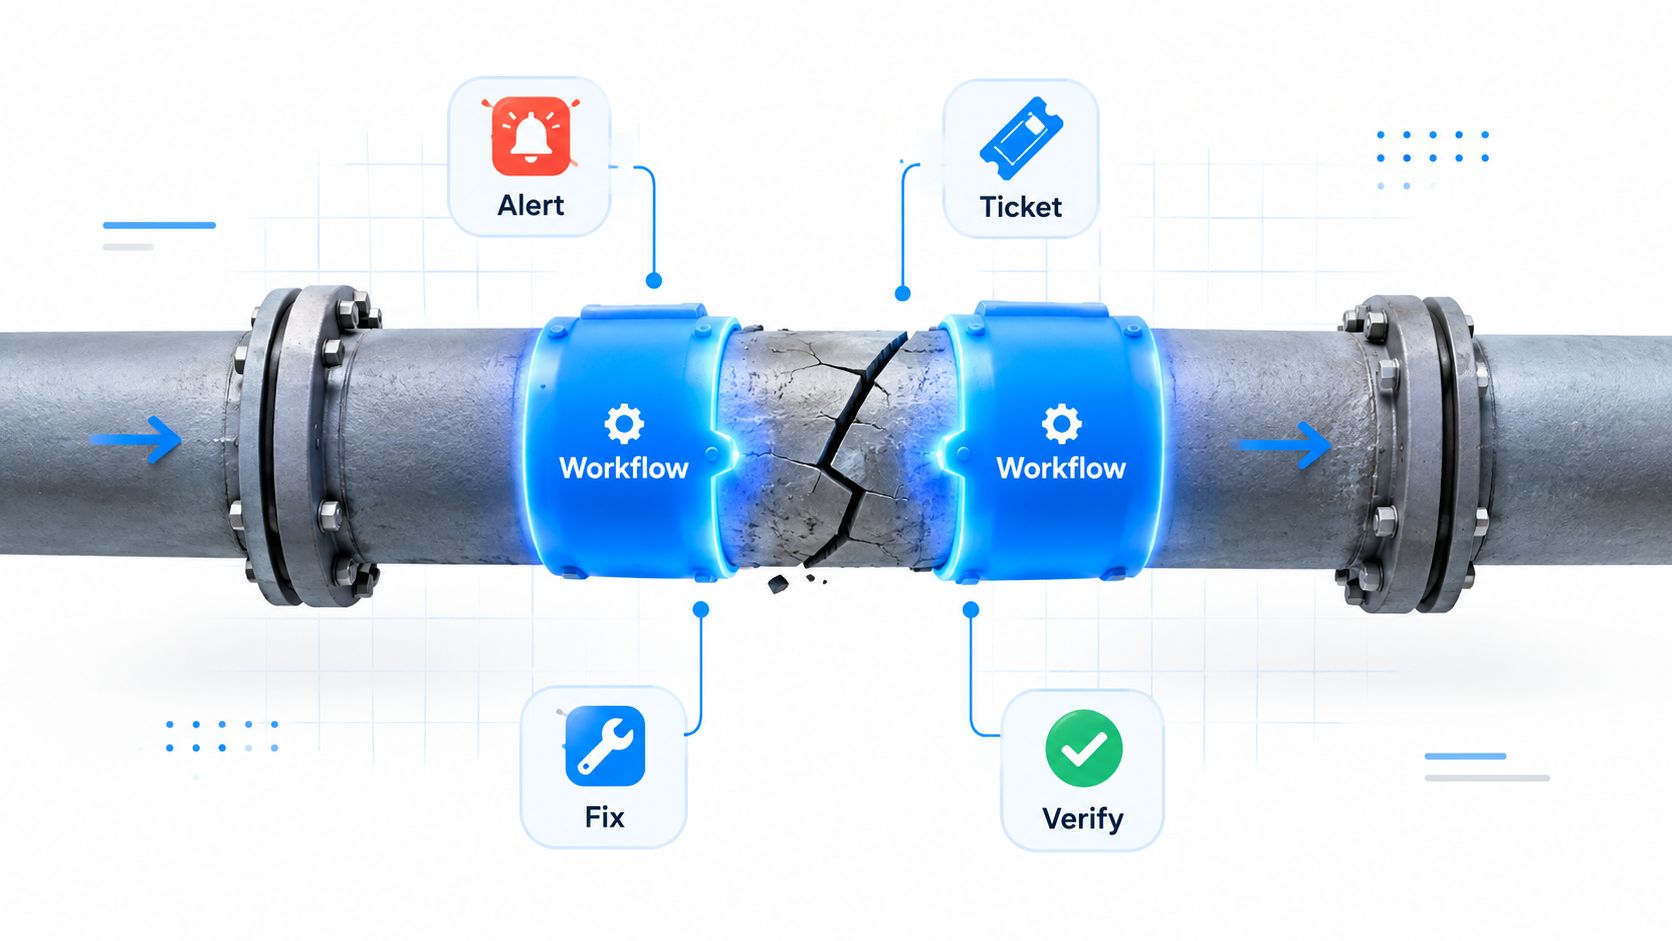
Détecter sans réagir, c'est de la télémétrie coûteuse. Un workflow utile transforme un contrôle échoué en une décision assumée par un responsable, avec suffisamment de preuves pour qu'une autre personne comprenne ce qui s'est passé sans reconstituer toute l'investigation.
Séparer la réparation technique de la revue sémantique
Un pipeline cassé et un sens métier modifié nécessitent des intervenants différents. Un ingénieur peut réparer une transformation en échec, mais un responsable métier doit décider si un nouveau segment de clients appartient à la population du KPI. Diriger les deux incidents vers la même file ralentit le rétablissement et brouille les responsabilités.
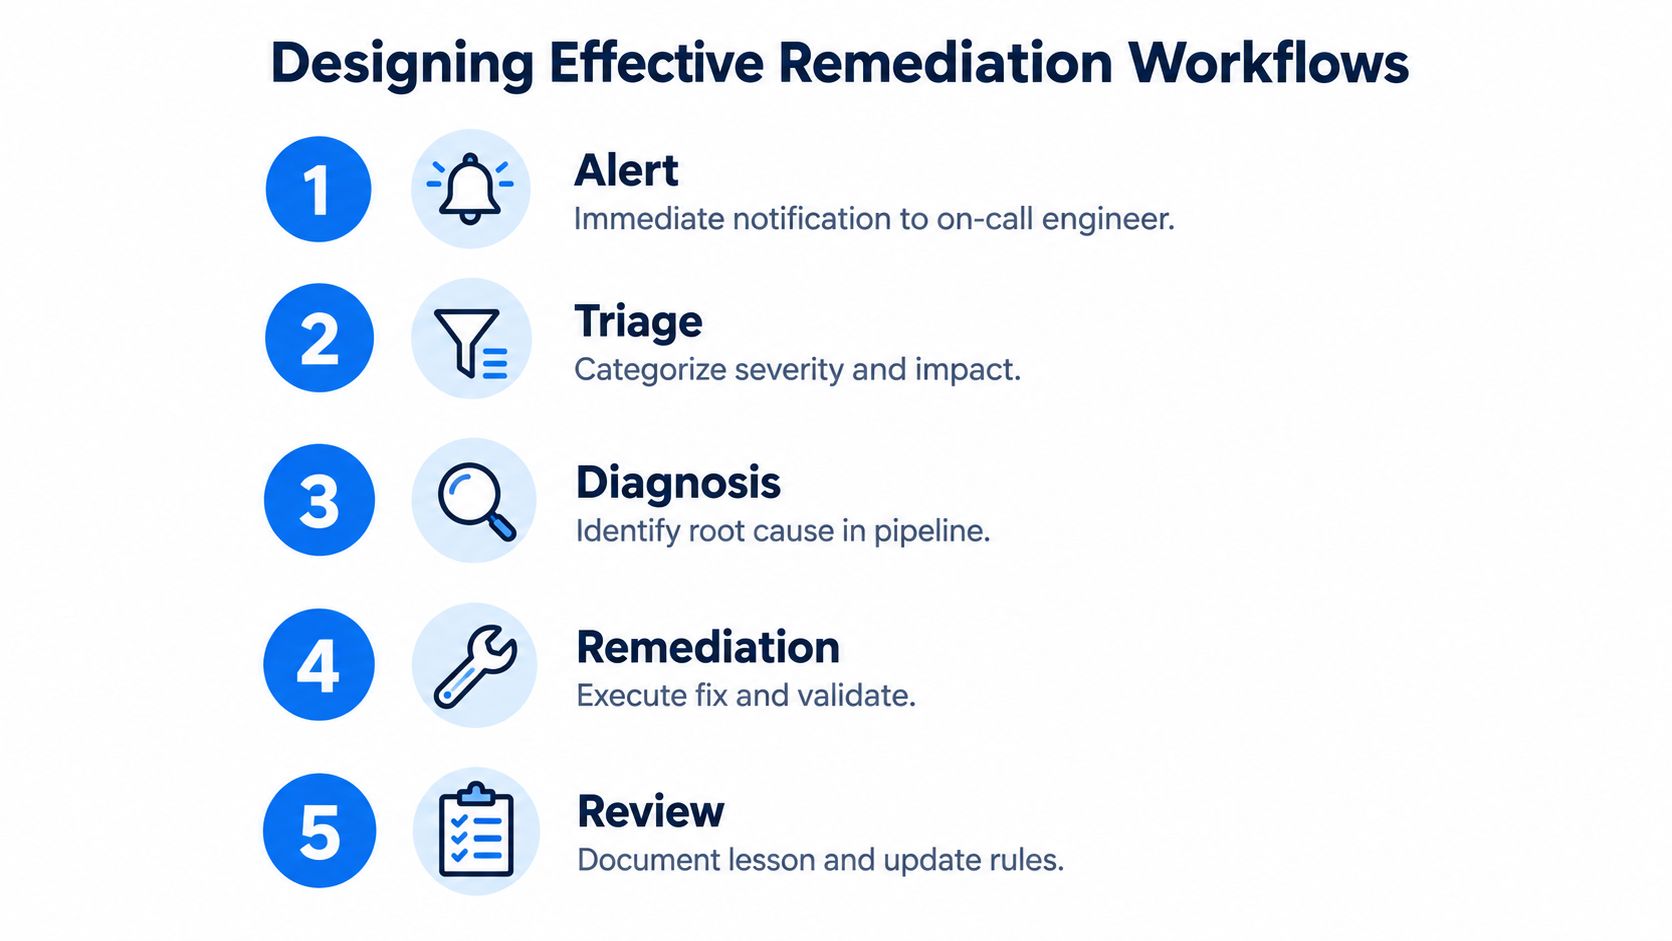
Utilisez un workflow commun avec des branches de décision distinctes :
Alerte : Consignez le contrôle échoué, le KPI concerné, l'intervalle de données et le contexte de détection.
Tri : Qualifiez la gravité, les consommateurs concernés et l'impact sur les décisions, et déterminez si la publication doit être suspendue.
Diagnostic : Remontez le problème à travers les systèmes sources, les transformations, les données de référence, les définitions et les changements métier récents.
Correction : Corrigez la source ou la logique, retraitez l'indicateur si nécessaire et validez les résultats en aval.
Revue : Consignez la cause racine, la décision du responsable, les preuves, la prévention des récidives et la clôture.
Le responsable doit consigner explicitement le moment où une anomalie est acceptée comme légitime. Cette approbation évite à l'organisation de rouvrir sans cesse un événement métier connu, tout en conservant le raisonnement pour les auditeurs et les futurs analystes.
Suivre les obligations de correction comme des objectifs de service
Les données personnelles introduisent une exigence opérationnelle concrète. Selon l'article 5 du RGPD, les données personnelles doivent être exactes et, si nécessaire, tenues à jour. Les organisations doivent prendre des mesures raisonnables pour rectifier ou effacer sans tarder les données inexactes, tout en limitant les données à ce qui est nécessaire à la finalité et en ne les conservant que le temps nécessaire. Le règlement est disponible via le texte du RGPD sur EUR-Lex.
Les indications de la Commission européenne sur les demandes des personnes précisent que, lorsqu'une personne demande à une organisation de corriger des données personnelles inexactes, l'organisation doit agir dans les meilleurs délais, en principe dans un délai d'un mois, ou expliquer par écrit les raisons de son refus. Pour la gouvernance des KPI, cela crée un objectif mesurable pour les incidents impliquant des données personnelles.
Suivez l'ensemble du cycle de vie :
Champ du workflow | Question opérationnelle |
|---|---|
Réception | Quand le défaut ou la demande de correction a-t-il été reçu ? |
Responsabilité | Qui est responsable de la décision et de la correction ? |
Périmètre | Quels enregistrements, KPI, rapports et résultats d'IA sont concernés ? |
Correction | Qu'est-ce qui a changé, et la source a-t-elle été corrigée ou seulement le rapport ? |
Vérification | Quelles preuves montrent que la correction a fonctionné ? |
Clôture | L'incident a-t-il été résolu dans le délai applicable ? |
Un bon workflow ne promet pas que chaque incident sera simple. Il garantit que la complexité n'efface pas la responsabilité.
Bâtir une stratégie de qualité des KPI résiliente
Une stratégie de qualité des KPI résiliente grandit avec l'organisation au lieu de tenter de modéliser toutes les défaillances possibles dès le premier jour. Commencez par les indicateurs qui pilotent des décisions importantes, puis étendez la couverture à mesure que les responsables, les définitions et les routines d'incident gagnent en maturité.
La plateforme doit prendre en charge plusieurs types de contrôle sans obliger les équipes à reconstruire leur modèle opérationnel pour chacun. Le business monitoring, Timeliness, le suivi des schémas, la validation au niveau des enregistrements, la détection d'anomalies et l'analyse historique couvrent des modes de défaillance différents. Ils doivent néanmoins produire une fiche d'incident commune et un modèle de responsabilité partagé.
Passer à l'échelle par couches
Une progression pratique se présente ainsi :
Fondation : Définir les KPI critiques, les responsables, les systèmes sources, les populations, les dénominateurs et l'usage décisionnel.
Fiabilité : Surveiller la fraîcheur, le volume, la complétude, la validité, les changements de schéma et le rapprochement des sources.
Sens : Versionner les définitions, tester les cohortes et les filtres, documenter les événements métier et exiger l'acceptation des responsables.
Réponse : Ajouter la gravité, l'acheminement, les délais de correction, la conservation des preuves et le reporting de clôture.
Optimisation : Analyser les incidents récurrents, la précision des alertes, l'impact sur les décisions et la couverture des contrôles.
L'exécution dans la base de données peut aider les équipes à surveiller des données sensibles sans mouvements inutiles. Un déploiement modulaire permet aussi à une organisation de commencer par une capacité ciblée, comme la détection d'anomalies ou Timeliness, puis de s'étendre aux règles métier et à la surveillance des schémas à mesure que le programme de contrôle prouve sa valeur.
La bonne mesure de la maturité n'est pas le nombre de contrôles configurés. C'est la capacité des équipes à répondre rapidement, preuves à l'appui, à quatre questions : qu'est-ce qui a changé ? Le KPI signifie-t-il toujours ce que nous pensons ? Qui décide de la suite ? Comment savons-nous que le problème est clos ?
Traitez le contrôle qualité des KPI comme un contrôle métier permanent, et non comme une fonctionnalité de tableau de bord. Les ingénieurs protègent le chemin des données, les responsables métier protègent le sens et les équipes de gouvernance rendent les preuves réutilisables pour le reporting, la conformité et l'IA. C'est cette répartition des responsabilités qui empêche un indicateur d'apparence irréprochable de devenir une décision erronée et coûteuse.
digna fournit une data observability modulaire pour la détection d'anomalies, Timeliness, la validation au niveau des enregistrements, les changements de schéma et la surveillance des KPI métier au sein de votre propre environnement. Utilisez digna pour relier les contrôles techniques à une validation adaptée à la décision, à des workflows d'incident avec des responsables clairs et à des preuves sur lesquelles vos équipes data et métier peuvent agir.
Si vos KPI critiques nécessitent une surveillance continue au plus près des données qui les alimentent, découvrez comment le business monitoring avec digna suit l'évolution des indicateurs et transmet les variations inhabituelles aux responsables concernés.
Questions fréquentes
Qu'est-ce que le contrôle qualité des KPI ?
C'est la pratique qui consiste à vérifier qu'un indicateur métier est non seulement techniquement correct, mais toujours adapté à la décision qu'il éclaire. Elle combine des contrôles du pipeline, comme le schéma, les valeurs nulles et le volume, avec des tests sémantiques des définitions, dénominateurs et cohortes, et une revue de comparabilité.
Pourquoi un KPI peut-il être trompeur alors que le pipeline passe tous les contrôles ?
Parce qu'un pipeline qui passe prouve seulement que les données ont circulé. Un KPI de croissance du chiffre d'affaires peut être complet, à jour et bien typé, mais trompeur si une acquisition modifie la population, si une hausse de prix explique la variation ou si le dénominateur exclut une cohorte devenue pertinente.
Qui doit être responsable de la qualité d'un KPI ?
La responsabilité est partagée, mais le responsable métier a le dernier mot sur le sens. Le guide recommande de consigner cinq rôles par KPI critique : un responsable métier, un responsable technique des pipelines et des tests, un data steward pour les définitions et le lignage, des consommateurs et un auditeur.
Quelle différence entre qualité des données syntaxique, sémantique et pragmatique ?
La norme ISO 8000-1:2022 distingue ces trois niveaux. La qualité syntaxique vérifie la conformité à un format approuvé, comme le schéma et les valeurs autorisées. La qualité sémantique demande si les valeurs représentent le concept voulu, via jointures, cohortes et dénominateurs. La qualité pragmatique vérifie que le KPI soutient encore sa décision.
Faut-il supprimer automatiquement les anomalies des KPI ?
Non. Un détecteur d'anomalies peut signaler une variation inhabituelle, mais il ne peut pas décider si une nouvelle politique tarifaire la rend correcte. Il faut d'abord vérifier si l'événement est réel, si la définition s'applique toujours et si la décision exige un indicateur retraité. Le responsable consigne ensuite les anomalies acceptées.



