Modèle opérationnel de qualité des données : guide pratique pour l'entreprise
|
7
minute de lecture

Une équipe régionale de prévision a ouvert son tableau de bord de revenus en fin de trimestre et y a vu un chiffre plausible, alors que la population clients sous-jacente avait doublé. Une migration du système source avait fusionné comptes actifs et inactifs, personne n'était responsable de la logique de fusion et aucune alerte n'a signalé la variation du nombre de lignes assez tôt pour arrêter la décision. Une décision tarifaire a été annulée, un audit a relevé l'absence de traçabilité, et les ingénieurs ont reconstruit trois fois le même pipeline avant qu'un data steward ne bloque enfin la source.
Ce genre d'incident est souvent décrit comme un problème d'outillage. Il l'est rarement. L'organisation disposait de pipelines, de tableaux de bord, d'ingénieurs et probablement d'un volume confortable de code de validation. Ce qui manquait, c'était une réponse claire à quatre questions opérationnelles : qui définit la qualité acceptable, qui répond de la défaillance, qui peut bloquer les données et qui décide que le dossier est clos ?
Un modèle opérationnel de qualité des données apporte précisément cette structure de décision manquante. Il relie validation, observabilité, ponctualité, responsabilité et escalade pour que la qualité devienne une capacité opérationnelle récurrente plutôt qu'un ensemble de règles déconnectées. Le besoin est de plus en plus difficile à ignorer. Une estimation de marché de 2026 évaluait le marché mondial de la gestion de la qualité des données à 2,66 Md USD en 2025, avec une projection de 4,95 Md USD d'ici 2030 et un TCAC de 13,2 % (rapport sur le marché mondial de la qualité des données). La croissance compte, mais la question opérationnelle compte davantage : votre organisation sait-elle réagir à un signal qualité avant qu'il ne fausse une décision métier ?
Sommaire
Pourquoi la qualité des données échoue, même dans des équipes matures
Ce qu'est réellement un modèle opérationnel de qualité des données
Les cinq composants qui le rendent opérationnel
Les quatre modèles types et comment choisir
Un guide de décision pour le modèle de départ
Niveaux de maturité et KPI mesurables
Relier observabilité, validation et ponctualité
La validation détecte les violations explicites
L'observabilité détecte ce que les règles ignorent
La ponctualité mérite son propre contrôle
Feuille de route, du pilote à l'échelle entreprise
Fondations
Domaine pilote
Extension
Échelle entreprise
Spécificités sectorielles dans les secteurs régulés
Idées fausses courantes et votre liste d'actions pour la semaine prochaine
Cinq actions pour la semaine prochaine
Pourquoi la qualité des données échoue, même dans des équipes matures
L'incident de prévision présentait tous les signes extérieurs d'un environnement de données mature. La migration était approuvée, le pipeline s'est exécuté avec succès et le tableau de bord s'est rafraîchi comme prévu. Pourtant, aucun contrôle ne demandait si la population de comptes représentait encore la population métier visée.
La défaillance a commencé en amont mais est devenue un problème d'entreprise. L'équipe de prévision s'est fiée à la vue de revenus gonflée et a annulé une décision tarifaire en fin de trimestre. Lors de la revue d'audit, les auditeurs ont noté que la traçabilité s'arrêtait à la source migrée et n'expliquait pas comment comptes actifs et inactifs avaient été combinés. Les ingénieurs ont ensuite reconstruit le pipeline trois fois, chaque tentative traitant un symptôme en aval plutôt que la responsabilité non résolue.
Le data steward a fini par bloquer la source. Cela a supprimé le risque immédiat, mais a aussi révélé la mécanique opérationnelle absente. Personne n'était responsable de la logique de fusion, il n'existait aucune voie d'escalade pour une variation inhabituelle du nombre de lignes, et aucune métrique convenue ne classait la dérive de population comme un événement bloquant la publication.
Règle pratique : une exécution réussie du pipeline prouve que le logiciel a tourné. Elle ne prouve pas que les données produites correspondent toujours à la décision métier.
Ce schéma se retrouve aussi dans des organisations dotées d'ingénieurs compétents. Après un incident, beaucoup d'équipes ajoutent des tests, mais ces nouvelles règles deviennent la prochaine charge de maintenance si personne n'est responsable de leurs définitions, seuils ou exceptions. Une analyse des raisons structurelles de l'échec des projets de qualité des données fait la même distinction opérationnelle : le travail qualité échoue quand les organisations le traitent comme un projet ou un déploiement d'outil plutôt que comme un changement dans la manière dont les équipes décident.
La recherche indépendante sur la gouvernance explique pourquoi l'écart persiste. Dans une enquête auprès de 825 participants, 75 % citaient la qualité des données comme objectif prioritaire, tandis qu'une autre étude montrait que seuls 10 % jugeaient leurs données excellentes et 30 % bonnes, soit 40 % d'évaluations positives (étude de gouvernance Precisely). Les équipes ignorent souvent d'où viennent les données, à quel point elles sont fiables et qui corrige les erreurs.
Le modèle opérationnel existe pour éviter exactement cette ambiguïté. Il répartit les droits de décision avant la prochaine migration, définit le signal qui déclenche l'intervention et donne à une personne nommée l'autorité d'arrêter des données peu fiables.
Ce qu'est réellement un modèle opérationnel de qualité des données
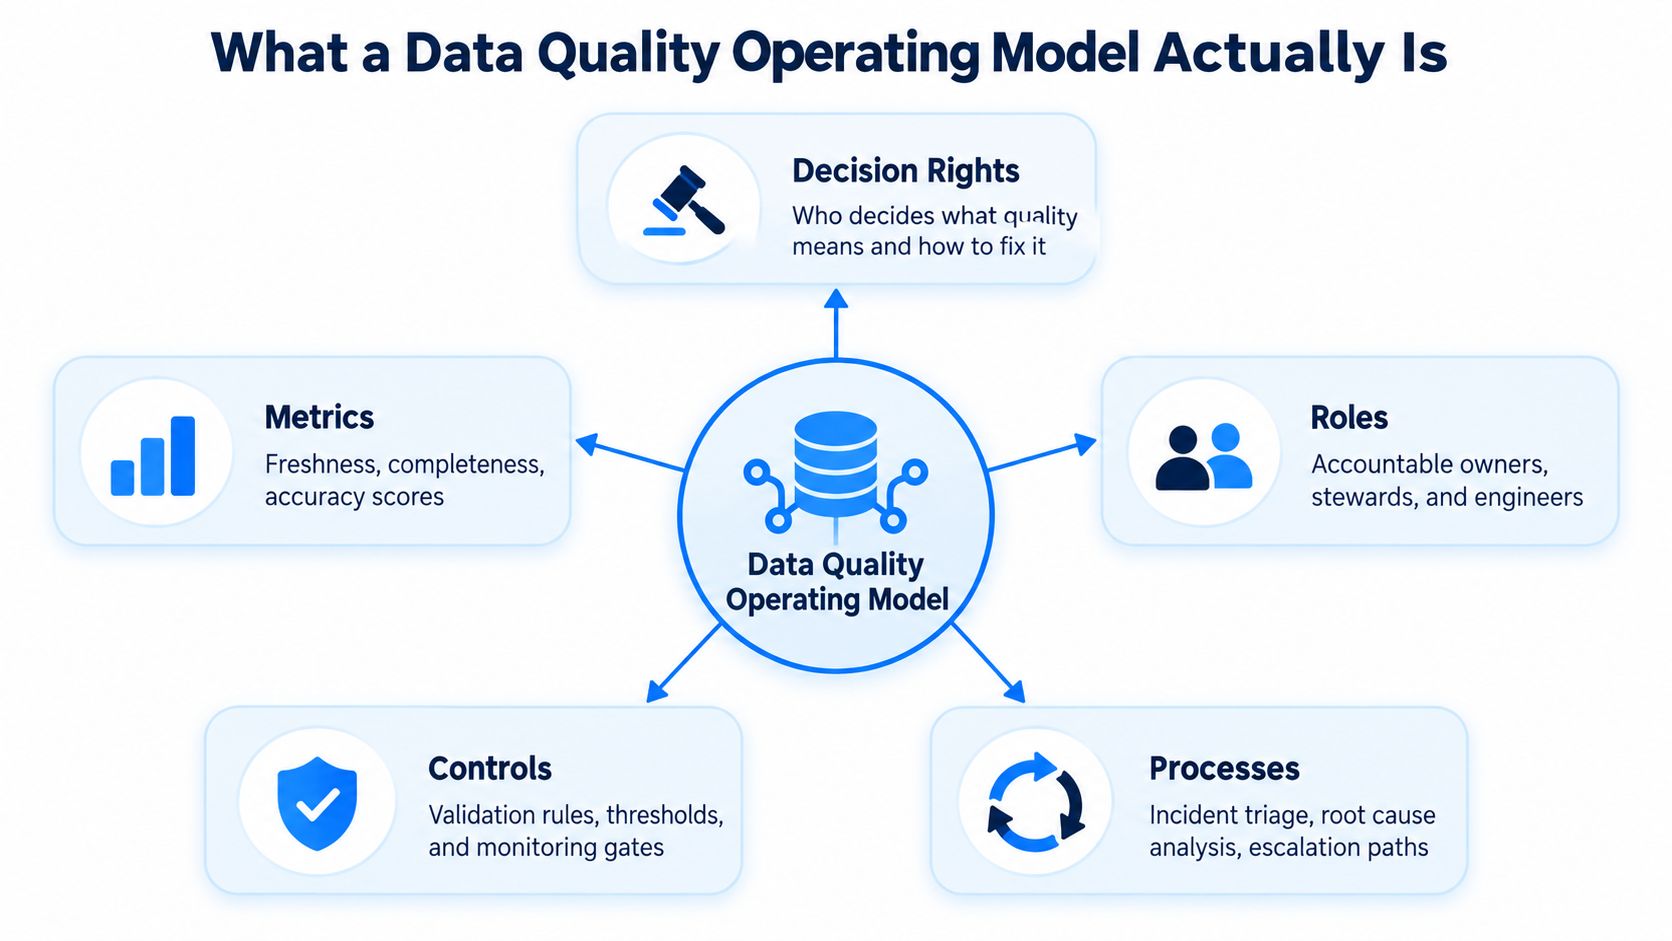
Un modèle opérationnel de qualité des données est le système codifié de droits de décision, rôles, processus, contrôles et métriques qui détermine comment les problèmes de qualité sont détectés, pris en charge, escaladés et résolus tout au long du cycle de vie de la donnée. Il décrit le travail que les personnes accomplissent de façon répétée, pas seulement les normes qu'elles publient.
Une politique de gouvernance exprime une intention. Une bibliothèque de règles stocke des tests. Une plateforme d'observabilité détecte des changements de comportement dans les systèmes ou les jeux de données. Aucun de ces composants ne répond à lui seul à la question de savoir qui approuve un seuil, qui accepte une exception ou qui a autorité pour bloquer un flux défectueux. Le modèle opérationnel relie ces composants à des personnes responsables.
Les cinq composants qui le rendent opérationnel
La responsabilité et la propriété identifient le responsable métier, le data steward, le producteur, l'équipe plateforme et le répondant en cas d'incident pour chaque produit ou élément de données critique. Le responsable approuve ce que signifie « apte à l'usage ». Le steward maintient définitions et exceptions. Les ingénieurs implémentent et exploitent les contrôles.
Les normes et les règles traduisent les attentes métier en exigences mesurables. Elles peuvent couvrir complétude, validité, unicité, intégrité référentielle, exactitude, ponctualité et stabilité structurelle. Chaque règle a besoin d'un responsable et d'une réponse documentée en cas d'échec.
La détection et les contrôles associent validation et observabilité. La validation vérifie si les valeurs satisfont des critères métier ou structurels explicites. L'observabilité surveille les comportements inattendus : variations de volume, écarts de fraîcheur, changements de distribution et évolution de schéma.
Le workflow d'incident définit tri, sévérité, quarantaine, analyse des causes, escalade, remédiation et clôture. Une anomalie détectée n'est pas un contrôle abouti. Le workflow doit consigner qui l'a évaluée et pourquoi.
La mesure et le retour d'expérience indiquent si les contrôles évitent un préjudice métier. Des mesures utiles incluent la performance des règles, les délais de réponse, la couverture par responsable, les défaillances récurrentes et les reprises. Ces métriques doivent alimenter la planification et les revues produit, pas dormir dans un tableau de bord inutilisé.
Une vue pratique de la gestion de la qualité des données aide les équipes à aligner leur vocabulaire, mais la terminologie n'est pas le résultat. Le résultat est un accord opérationnel sur ce qui se passe quand les données défaillent.
Les quatre modèles types et comment choisir
En pratique, l'un de quatre modèles finit généralement par s'imposer. Le bon choix dépend moins des modes organisationnelles que du risque, de la complexité des domaines, de la capacité d'ingénierie et de la base de gouvernance déjà en place.
Modèle | Droits de décision | Où réside la responsabilité | Défaillance typique |
|---|---|---|---|
Équipe centrale | Une fonction centrale qualité des données ou CDO définit les normes et priorise la remédiation | Équipe qualité centrale, les producteurs restant responsables des corrections | Le centre devient un goulot d'étranglement et les équipes métier attendent une validation |
Domaines fédérés | Les équipes de domaine définissent les critères d'aptitude des données qu'elles produisent, dans le cadre de normes partagées | Responsables et stewards de domaine | Les définitions et les seuils divergent entre domaines |
Ingénieurs intégrés | Les équipes produit ou plateforme portent les contrôles dans le cadre du développement et de l'exploitation | Équipes d'ingénierie et de produit | Le sens métier est sous-représenté dans les tests techniques |
Hybride hub-and-spoke | Un centre d'excellence fournit normes, outils et accompagnement, tandis que les domaines répondent des résultats | Responsabilité partagée entre équipes centrale et de domaine | Le hub publie des recommandations, mais personne n'en impose l'application |
Un modèle central fonctionne quand l'interprétation réglementaire doit être cohérente ou quand la capacité d'ingénierie des domaines est limitée. Il atteint ses limites quand on attend d'une seule équipe qu'elle comprenne tous les contextes métier. Un modèle fédéré rapproche les décisions des données, mais exige un vocabulaire commun solide, un contrôle des changements et un mécanisme d'escalade. La propriété intégrée fait de la qualité une partie de la livraison, mais les ingénieurs ne devraient pas avoir à deviner la définition métier de l'exactitude.
Le modèle hybride est souvent le point de départ le plus praticable pour les grandes organisations. Une équipe centrale porte le cadre de contrôle, les outils partagés et le reporting. Les responsables de domaine décident de l'aptitude, les producteurs corrigent les causes amont et les équipes plateforme exploitent l'infrastructure commune. C'est la logique opérationnelle derrière la gouvernance des données fédérée, où les normes restent cohérentes sans faire passer chaque décision par une file d'attente centrale.
Un guide de décision pour le modèle de départ
Domaines régulés : plusieurs domaines régulés plaident pour un modèle central ou hybride, car approbations, preuves et escalade doivent être traitées de façon uniforme.
Maturité d'ingénierie : des équipes produit solides peuvent porter une propriété intégrée ou fédérée. Les équipes sans pratiques de livraison fiables ont besoin de plus d'accompagnement central.
Investissement en gouvernance : comités, catalogues et routines de stewardship existants facilitent l'adoption hybride. Avec un faible investissement, mieux vaut un pilote central ciblé avant de fédérer.
Ne copiez pas le modèle d'une entreprise plus grande. Choisissez la plus petite structure qui donne à chaque défaillance critique un responsable, une voie de réponse et une personne habilitée à décider.
Niveaux de maturité et KPI mesurables
Une étiquette de maturité n'a de valeur que si elle change les décisions quotidiennes. « Gouvernance avancée » ne signifie pas grand-chose si les consommateurs trouvent encore les erreurs en premier, si la responsabilité est floue ou si les ingénieurs réparent sans cesse la même perturbation amont. Utilisez un modèle de maturité de la qualité des données pour relier le comportement opérationnel à des résultats mesurables.
Niveau de maturité | Signaux observables | KPI clés |
|---|---|---|
Ad hoc | Les contrôles varient selon les équipes, la propriété est informelle, les utilisateurs découvrent les erreurs dans les rapports | Responsables nommés pour les actifs critiques, nombre de contrôles actifs |
Réactif | Les incidents sont enregistrés après la panne, la priorisation est informelle, les urgences se répètent | MTTD, MTTR, arriéré d'incidents ouverts |
Défini | Les jeux de données critiques ont des règles, responsables, niveaux de sévérité et voies d'escalade documentés | Taux de validation au premier passage, actifs critiques avec responsable |
Mesuré | Les métriques qualité figurent dans les revues opérationnelles et les équipes analysent les causes récurrentes | Tendance du MTTD et du MTTR, taux de récurrence, heures de reprise |
Optimisé | Les contrôles influencent les mises en production, les contrats, les budgets et les priorités d'amélioration | Coût de la non-qualité, ancienneté des exceptions ouvertes, couverture des contrôles, impact sur les KPI métier |
Au niveau ad hoc, ne construisez pas de score composite. Commencez par un inventaire et marquez les actifs qui soutiennent le revenu, le pilotage des risques, le reporting réglementaire ou les décisions opérationnelles. Le premier KPI utile peut être simple : quand un contrôle critique échoue, y a-t-il quelqu'un d'habilité à décider ?
Les équipes réactives ont besoin de discipline de réponse. Le délai moyen de détection et le délai moyen de remédiation — MTTD et MTTR — montrent si la surveillance et la responsabilité progressent. Complétez-les par le taux de récurrence : un contournement rapide ne prouve pas que la cause racine est corrigée.
Au niveau défini, mesurez si les contrôles documentés s'exécutent de façon cohérente et si les actifs critiques ont des responsables. Le taux de validation au premier passage indique à quelle fréquence les données passent sans intervention. Au niveau mesuré, le taux de récurrence et les heures de reprise révèlent le coût d'une analyse des causes insuffisante. Le coût de la non-qualité relie ces défaillances aux discussions de capacité et de budget.
Les KPI doivent soutenir des décisions, pas décorer un tableau de bord. Un contrôle au taux de réussite élevé protège peut-être un champ sans importance, alors qu'un taux plus faible sur un jeu de données décisif appelle un investissement immédiat.
Un programme mature mesure si les contrôles protègent les décisions métier et si les équipes apprennent des défaillances. L'étude EY sur les tendances FP&A de 2025 indiquait que seules 16 % des organisations disposaient de données de haute qualité faciles à analyser, tandis que 25 % décrivaient leurs données comme médiocres ou mauvaises (étude EY sur les tendances FP&A). Concrètement, cela implique de relier les mesures de qualité à l'usage analytique et à la réaction des responsables, plutôt que d'optimiser seulement des taux techniques de réussite.
Relier observabilité, validation et ponctualité
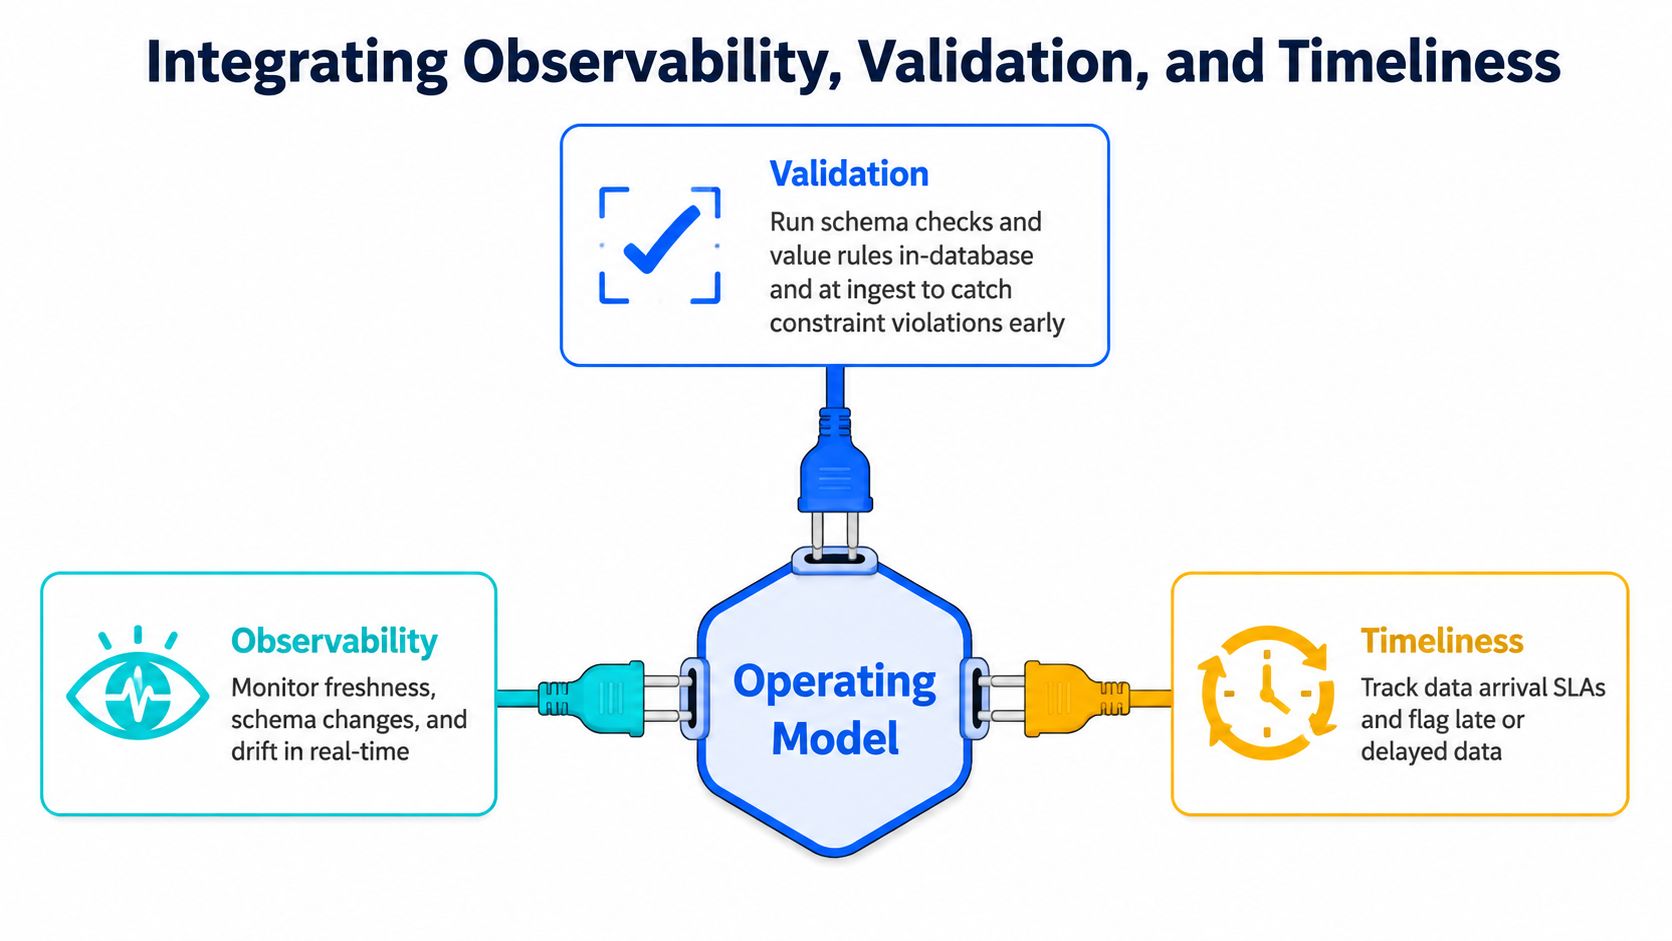
Ces contrôles ne devraient pas devenir trois chaînes d'outils parallèles avec trois files d'alertes. Ce sont des couches complémentaires d'un modèle opérationnel, et chaque couche a besoin d'un responsable clair, d'un niveau de sévérité et d'une passation.
La validation détecte les violations explicites
La validation vérifie si un enregistrement satisfait une exigence définie. Au niveau de l'entrepôt, une contrainte NOT NULL sur les identifiants clients et un contrôle référentiel sur la dimension client peuvent intercepter les enregistrements invalides à l'écriture. Le producteur répond de la correction à la source, le steward du sens de la règle et l'ingénieur plateforme de son exécution fiable.
Utilisez des portes strictes pour les défaillances qui rendent l'usage aval dangereux. Utilisez des portes souples ou des voies de quarantaine quand le métier tolère des exceptions contrôlées. La décision revient au responsable des données, pas à l'ingénieur qui reçoit l'alerte par hasard.
L'observabilité détecte ce que les règles ignorent
L'observabilité surveille le comportement des systèmes et des jeux de données dans le temps. Elle détecte volumes, distributions, fraîcheur, charges et changements de schéma inattendus, même si chaque ligne satisfait une règle statique. Une anomalie soudaine du volume de transactions peut signaler une partition source manquante, un chargement dupliqué ou un événement métier à investiguer.
La réponse doit relier le signal au contexte. Les métadonnées devraient identifier les produits de données affectés, les rapports en aval et le producteur responsable du processus amont. Sans ce contexte, une plateforme d'observabilité génère des alertes sans améliorer les décisions. L'équipe centrale d'accompagnement peut maintenir le schéma de surveillance pendant que le responsable de domaine juge si le changement constitue un incident.
La ponctualité mérite son propre contrôle
La ponctualité demande si les valeurs reflètent encore l'état actuel des objets réels qu'elles représentent. Les équipes opérationnelles la mesurent généralement comme la latence entre l'origine et la disponibilité : instrumentez donc event_time, processed_time et available_time pour distinguer les retards de captation, de traitement et de mise à disposition (recherche sur la ponctualité en qualité des données).
Un seuil de fraîcheur devrait devenir un objectif de niveau de service opposable du produit de données. Des contrôles d'ancienneté automatiques peuvent marquer les enregistrements dépassant l'âge accepté, transformant des données périmées en incident plutôt qu'en note passive sur un tableau de bord (guide de surveillance de la ponctualité). Le responsable décide alors de bloquer l'usage, de publier un avertissement ou d'activer une solution de repli.
La validation demande « cette valeur est-elle acceptable ? ». L'observabilité demande « ce comportement est-il inhabituel ? ». La ponctualité demande « est-ce arrivé assez tôt pour être utile ? ». Le modèle opérationnel affecte chaque réponse à une personne et à une voie de réaction. C'est pourquoi les équipes qui évaluent l'observabilité des données devraient examiner le workflow et la responsabilité autant que la capacité de détection.
Feuille de route, du pilote à l'échelle entreprise
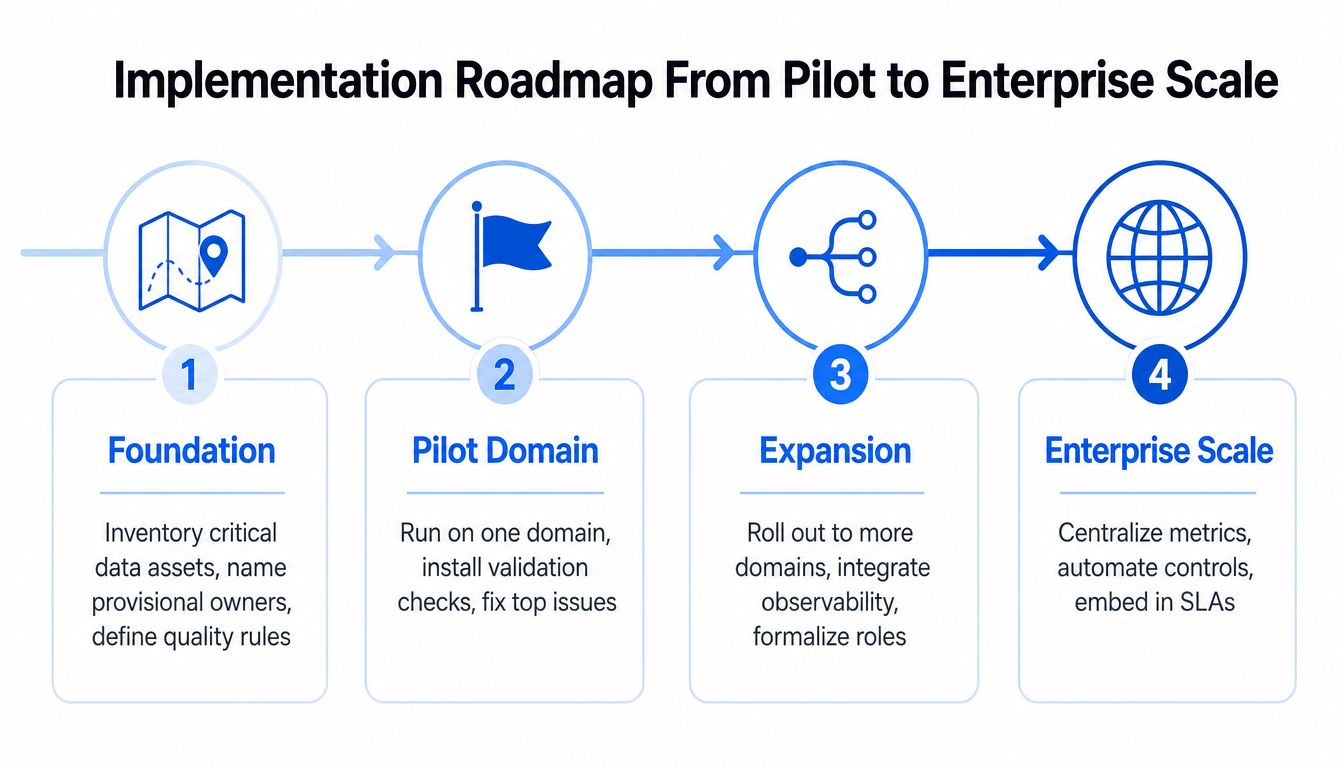
Un déploiement fiable commence par un risque métier restreint et ne s'élargit que lorsque la boucle de responsabilité fonctionne. De larges inventaires et de grandes bibliothèques de règles paraissent productifs, mais produisent souvent des constats sans responsable qui érodent la confiance dans le programme.
Fondations
Inventoriez les actifs de données critiques et cartographiez consommateurs, producteurs, responsables et modes de défaillance connus. Nommez des responsables métier et stewards provisoires, définissez une taxonomie de sévérité et publiez un workflow d'incident couvrant détection, tri, quarantaine, escalade, remédiation et clôture.
Le responsable gouvernance porte la conception opérationnelle. Un responsable plateforme porte la voie d'exécution, tandis que les référents de domaine confirment quels actifs comptent. La condition de sortie est concrète : chaque actif critique retenu a un responsable provisoire et chaque incident a une voie documentée.
Domaine pilote
Choisissez un domaine à forte valeur comme le revenu ou Customer 360. Définissez les premiers contrats de données, mettez en place des contrôles ciblés de validation et de ponctualité, et reliez un signal d'observabilité à l'astreinte. Le responsable de domaine évalue les défaillances, le producteur corrige la logique source, l'équipe plateforme exploite l'exécution des contrôles.
Le pilote se termine quand l'équipe peut démontrer détection, affectation, analyse des causes, remédiation et clôture par la même voie opérationnelle. Ne le jugez pas au nombre de règles livrées, mais à la capacité de la responsabilité à survivre à une vraie défaillance.
Extension
Répliquez le modèle sur plusieurs domaines, créez un conseil qualité des données et standardisez les exigences minimales de contrôles et de métadonnées. Le conseil devrait arbitrer les conflits inter-domaines, valider les définitions partagées et examiner les défaillances récurrentes. Les domaines conservent la responsabilité de leurs résultats de données.
Des critères de sortie utiles sont un MTTD inférieur à 24 heures et 80 % des actifs critiques avec des responsables documentés. Ce sont des objectifs opérationnels locaux, pas des références universelles. S'ils ne sont pas atteints, revoyez les passations et l'autorité d'escalade avant d'ajouter de l'automatisation.
Échelle entreprise
Intégrez les mesures de qualité aux scorecards des produits de données, aux revues de mise en production, aux accords de niveau de service et aux discussions budgétaires. Suivez le coût de la non-qualité via les heures de reprise, les remédiations répétées et les décisions retardées. La fonction centrale devient une couche d'accompagnement et d'assurance, tandis que les domaines gardent la responsabilité de leurs données.
L'amélioration continue consiste à retirer les règles inefficaces, ajuster les seuils quand les cas d'usage changent et vérifier si les contrôles évitent un préjudice métier. L'échelle entreprise n'est pas un tableau de bord plus grand. C'est un système reproductible qui rend les décisions de qualité visibles au quotidien.
Spécificités sectorielles dans les secteurs régulés
L'ossature du modèle opérationnel reste stable d'un secteur régulé à l'autre, mais les droits de décision et les obligations de preuve changent. La finance a besoin de preuves de traçabilité pour BCBS 239 et pour le reporting soumis à SOX, avec une responsabilité proche du grand livre et pas seulement d'un jeu de données générique. La santé a besoin de stewards de sécurité clinique capables d'arrêter un pipeline quand les données de référence changent, avec des contrôles de complétude et d'exactitude liés au risque HIPAA.
Les équipes télécoms devraient relier la qualité des CDR à l'assurance revenus. L'exploitation réseau doit siéger au conseil qualité, car des enregistrements perdus ou corrompus peuvent affecter la facturation et l'analyse de service. Le secteur public a besoin de contrôles sur les données citoyennes, où fraîcheur et accessibilité soutiennent des obligations de transparence et d'égalité.
Pour les organisations actives dans la recherche clinique, la réglementation et les fonctions commerciales, les annuaires de dirigeants du secteur biotech peuvent apporter un contexte utile sur les profils à représenter dans les décisions de qualité. L'objectif n'est pas de créer quatre programmes de gouvernance séparés, mais de préserver un mécanisme de responsabilité et d'adapter preuves, responsables et seuils d'escalade à l'environnement de risque.
Secteur | Point d'ancrage de la responsabilité | Principal moteur de KPI | Couche de contrôle spécifique |
|---|---|---|---|
Finance | Responsables du grand livre et du reporting | Complétude de la traçabilité et aptitude du reporting | Preuves pour BCBS 239 et SOX |
Santé | Sécurité clinique et data stewards | Complétude, exactitude et fiabilité pour les soins | Intervention sur les pipelines orientée sécurité |
Télécoms | Exploitation réseau et assurance revenus | Intégrité des enregistrements et sécurité de la facturation | Validation et rapprochement des CDR |
Secteur public | Responsables de programmes, d'accessibilité et d'archives | Fraîcheur, accessibilité et fiabilité du service public | Contrôles de transparence et d'égalité |
Une politique unique peut couvrir les quatre secteurs, mais les responsables locaux doivent garder l'autorité sur ce qui constitue une défaillance inacceptable. Cet équilibre rend le modèle modulaire sans le rendre flou.
Idées fausses courantes et votre liste d'actions pour la semaine prochaine
Acheter un logiciel ne crée pas un modèle opérationnel. Une plateforme peut détecter des anomalies ou exécuter des validations, mais des personnes doivent toujours établir la responsabilité, approuver les seuils, décider des exceptions et escalader les défaillances.
Les data stewards ne peuvent pas non plus corriger tous les défauts amont. Si un steward n'a pas autorité pour modifier un système source, lui affecter l'incident ne fait que masquer le vide de responsabilité. Le producteur doit répondre de la correction, le steward maintient le sens et l'instance de gouvernance tranche.
Des tableaux de bord au vert ne prouvent pas que la qualité est réglée. Un jeu de données peut satisfaire les règles qui le testent pendant qu'une source non surveillée change, qu'un engagement de fraîcheur est rompu ou qu'une métrique métier dévie du comportement attendu. Ajouter des règles peut aggraver la situation si elles créent du bruit, dupliquent de la logique ou poussent les équipes à optimiser des taux de réussite plutôt que la confiance dans la décision.
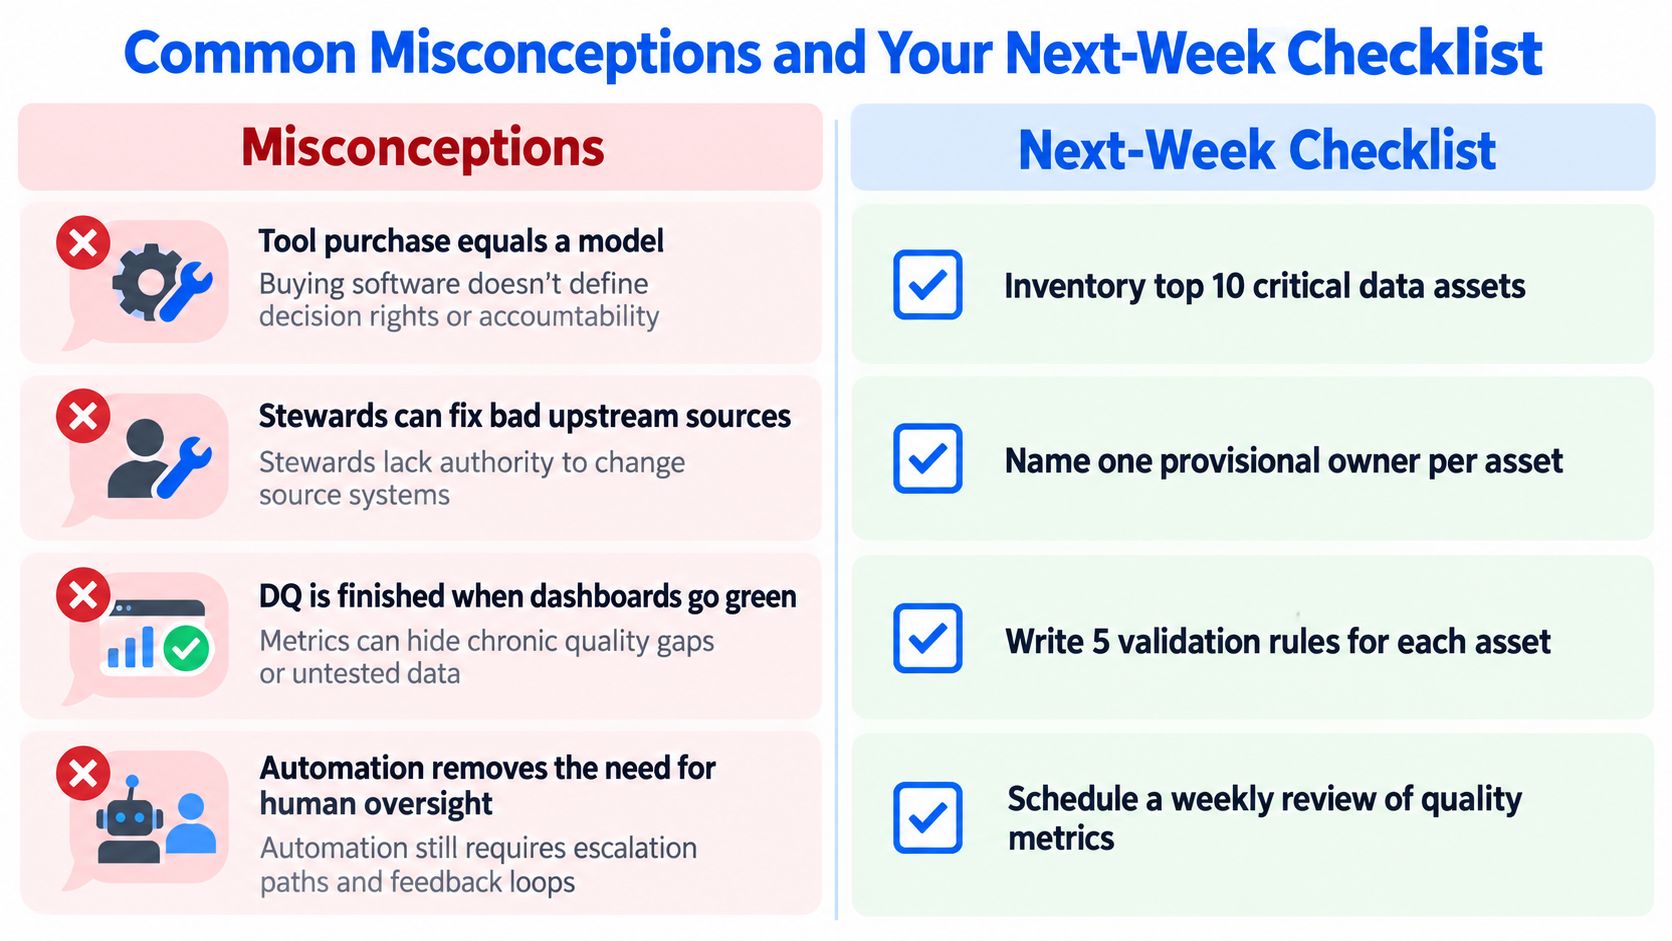
Cinq actions pour la semaine prochaine
Nommez des responsables : confirmez un responsable qualité pour chaque élément ou actif de données critique.
Documentez les droits de quarantaine : notez qui peut bloquer, mettre en quarantaine ou libérer des données quand un contrôle critique échoue.
Reliez un signal à l'astreinte : connectez une alerte d'observabilité à une rotation d'ingénierie ou d'exploitation existante.
Retirez une règle inutilisée : supprimez un contrôle que personne n'examine ni ne sait expliquer, et documentez la décision.
Publiez un KPI de fraîcheur : portez une mesure de ponctualité dans une instance de direction où quelqu'un peut agir.
Un modèle opérationnel pratique de gouvernance des données exige droits de décision, rôles, instances, routines, passations, évaluation de la performance, contrôle des changements et feuille de route. Gardez ce niveau d'exigence en revoyant votre liste : si une tâche ne dit pas qui décide et ce qui se passe ensuite, ce n'est pas encore un contrôle opérationnel.
digna aide les équipes data à relier validation en base, détection d'anomalies, surveillance de la ponctualité et suivi des changements de schéma dans une vue d'incidents commune, au sein de leur propre environnement. Visitez digna pour voir comment la plateforme soutient un modèle opérationnel de qualité des données avec des responsables, des contrôles mesurables et une escalade actionnable.
Voyez comment digna procède en pratique : surveillance de la qualité des données sur l'ensemble de vos plateformes.
Questions fréquentes
Qu'est-ce qu'un modèle opérationnel de qualité des données ?
Un modèle opérationnel de qualité des données est la structure qui fait passer la qualité d'une série de projets à l'exploitation quotidienne. Il définit qui répond de quelles données, quels contrôles s'exécutent, comment les résultats sont mesurés et ce qui se passe quand quelque chose casse.
Quels sont les composants d'un modèle opérationnel de qualité des données ?
Cinq le rendent opérationnel : la propriété et la responsabilité, des contrôles définis couvrant validation, observabilité et ponctualité, des KPI montrant si la qualité progresse, les outils qui exécutent les contrôles et les routines — tri, escalade, revue — qui maintiennent le modèle vivant.
La qualité des données doit-elle être centralisée ou fédérée ?
Cela dépend de l'endroit où réside déjà la responsabilité. Une équipe centrale fonctionne tant que le paysage est restreint ; un modèle fédéré convient aux organisations à forte propriété de domaine ; la plupart des grandes entreprises aboutissent à un hybride : normes et outils centraux, exécution dans les domaines.
Quels KPI mesurent l'exploitation de la qualité des données ?
Sont utiles la couverture des jeux de données critiques, les délais moyens de détection et de résolution, la fréquence et la récurrence des incidents, et la part des problèmes trouvés par la surveillance plutôt que signalés par un utilisateur métier.
Combien de temps faut-il pour mettre en place un modèle opérationnel de qualité des données ?
La séquence pratique est fondations, domaine pilote, extension, échelle entreprise. Un pilote ciblé montre généralement une amélioration mesurable de la détection en un trimestre, et c'est cette preuve qui rend l'extension finançable.