Types de données Snowflake : référence pour le design de schéma
|
8
minute de lecture
Le conseil le plus répandu au sujet d'un type de données Snowflake est aussi incomplet : choisissez le type qui décrit le plus précisément la valeur. La justesse sémantique compte, mais les schémas de production ne fonctionnent pas en vase clos. Un type change la façon dont se comportent les prédicats, l'efficacité de l'élagage des micro-partitions par Snowflake, la manière dont les jointures comparent les valeurs, le compute consommé par les tableaux de bord et l'interprétation de la dérive par les outils d'observabilité.
Une colonne VARIANT peut préserver élégamment une charge utile évolutive tout en imposant des extractions et des conversions répétées dans les chemins de reporting critiques. Un timestamp peut porter la bonne signification métier et produire malgré tout un comportement déroutant lié au fuseau de session. Une définition numérique ou texte trop large accepte les données d'aujourd'hui et rend le monitoring de demain moins utile. Un bon design de schéma équilibre justesse, performance, coût et visibilité opérationnelle.
Table des matières
Pourquoi le choix d'un type de données Snowflake dépasse la modélisation
La précision peut créer des frictions opérationnelles
L'observabilité commence par des types stables
Les types numériques et texte expliqués
Virgule fixe ou virgule flottante
Les types texte sont souples, ce n'est pas une autorisation à la négligence
Types date, heure et timestamp pour les données temporelles
Aligner le type sur le contrat d'événement
Le comportement des fuseaux horaires influence aussi le filtrage
Types de données semi-structurés et structurés
Les types structurés rendent les contrats visibles
Un modèle hybride fonctionne bien
Règles de cast et de conversion à connaître
Modèles sûrs et raccourcis dangereux
Comment les types de données influencent la performance et le coût des requêtes
L'élagage et le clustering dépendent des types
Profilez la charge de travail réelle
Bonnes pratiques de design de schéma pour la production
Concevoir selon le rôle de la table
Rendre l'évolution du schéma délibérée
Erreurs fréquentes de typage et comment les corriger
Une acceptation silencieuse reste un échec
Relier les types de données à la qualité des données et à l'observabilité
Construire le monitoring autour du comportement des types
Référence rapide de tous les types de données Snowflake
Pourquoi le choix d'un type de données Snowflake dépasse la modélisation
Un type de données Snowflake fait partie de votre design d'exécution, pas seulement de votre dictionnaire de données. Le choix détermine si un filtre peut utiliser un prédicat simple et prévisible ou doit inspecter un contenu imbriqué, convertir des valeurs à l'exécution ou réconcilier des représentations incompatibles entre tables. Ces opérations pèsent sur le travail de scan et peuvent rendre un tableau de bord bien écrit plus lent que son SQL ne le laisse penser.
L'historique des versions de Snowflake rend cette vision plus large évidente. La prise en charge des booléens n'a été introduite que pour les comptes provisionnés après le 25 janvier 2016, un jalon utile dans l'histoire des types de la plateforme, tandis que le modèle actuel comprend des types temporels comme DATE, DATETIME et des types d'intervalle, aux côtés des familles scalaire, semi-structurée et structurée. La plateforme est passée d'un simple stockage de valeurs à un système de types pensé pour les charges analytiques modernes : les décisions de typage méritent donc un traitement architectural. La référence des types de données Snowflake documente cette évolution.
La précision peut créer des frictions opérationnelles
Le type le plus expressif n'est pas automatiquement le meilleur type de production. Dans les charges BI et d'observabilité à fort volume, une représentation plus simple facilite le filtrage, le clustering, les jointures et la validation. Cela ne signifie pas choisir un type moins précis quand l'exactitude est requise, mais séparer la sémantique métier d'une complexité de représentation inutile.
Par exemple, un identifiant d'événement toujours entier ne devrait pas devenir une valeur à virgule flottante simplement parce qu'un fichier en amont étiquette chaque champ comme numérique. À l'inverse, un montant financier ne devrait pas être converti en type approximatif par commodité. La bonne décision préserve le sens requis tout en évitant un travail dont les requêtes et les contrôles en aval n'ont pas besoin.
Règle pratique : traitez chaque revue de type à la fois comme une revue de modélisation et comme une revue d'exécution. Demandez ce que signifie la colonne, comment elle sera filtrée, comment elle sera jointe et comment sa qualité sera surveillée.
L'observabilité commence par des types stables
Les systèmes de monitoring ont besoin de distributions cohérentes, d'un comportement des valeurs nulles, de plages et de métadonnées structurelles. Si une valeur passe d'une représentation texte à numérique puis à timestamp d'un chargement à l'autre, une alerte qualité peut décrire le symptôme sans révéler la cause. Un type natif stable donne aux règles de validation et aux références d'anomalie un signal plus net.
Pour les équipes qui définissent un standard d'entrepôt plus large, les recommandations de digna sur les schémas Snowflake complètent utilement le travail de modélisation. Le principe est simple : choisissez des types qui restent fiables pour les consommateurs comme pour les systèmes qui surveillent ces consommateurs.
Les types numériques et texte expliqués
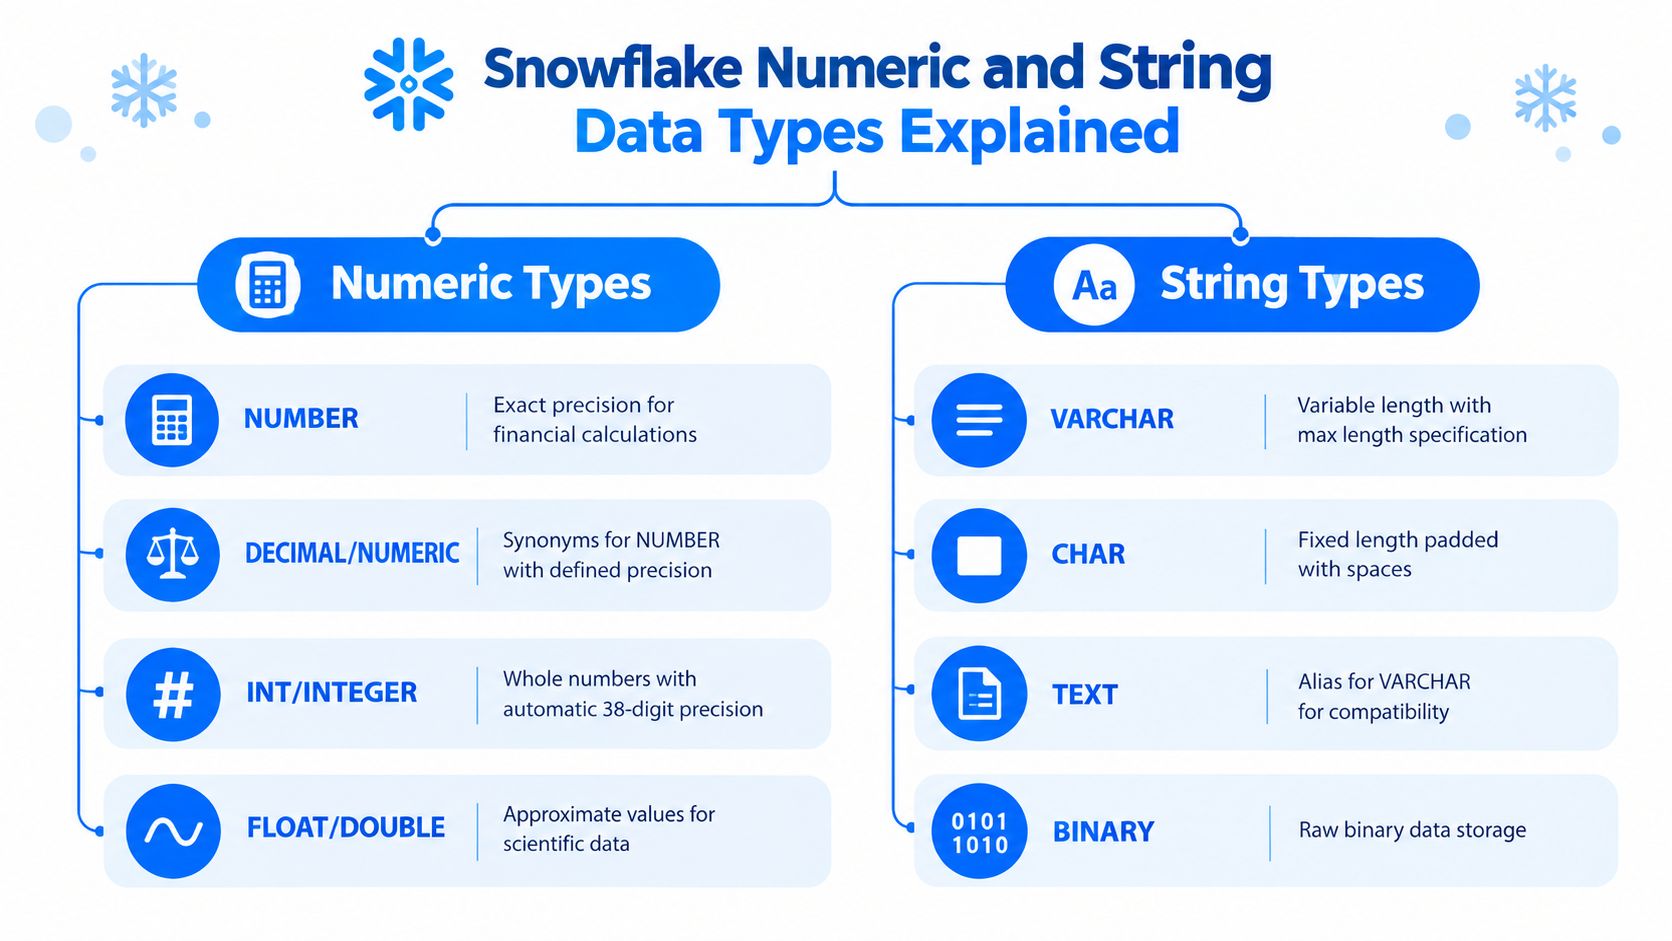
Les choix numériques et texte paraissent simples jusqu'à ce qu'une table devienne une dépendance partagée. Snowflake prend en charge les nombres à virgule fixe via NUMBER, DECIMAL et NUMERIC. Ces noms désignent la même famille à virgule fixe, la précision décrivant le nombre total de chiffres et l'échelle les chiffres après la virgule.
Utilisez les types à virgule fixe pour les valeurs où l'exactitude compte : prix, soldes, taux et quantités mesurées devant se réconcilier. Les alias entiers, dont INT, INTEGER, BIGINT, SMALLINT, TINYINT et BYTEINT, sont des noms pratiques pour les cas d'usage en nombres entiers. Snowflake propose aussi FLOAT, FLOAT4, FLOAT8, DOUBLE, DOUBLE PRECISION et REAL pour les valeurs approximatives à virgule flottante. Ils conviennent aux mesures et calculs scientifiques où l'approximation est acceptable, pas aux champs comptables qui doivent tomber juste.
Virgule fixe ou virgule flottante
Une revue de schéma pragmatique devrait répondre à trois questions :
La valeur doit-elle être comparée exactement ? Choisissez un type à virgule fixe lorsque l'égalité, la réconciliation ou l'auditabilité comptent.
La valeur représente-t-elle une approximation scientifique ? Un type à virgule flottante peut convenir si de petits écarts de représentation sont acceptables.
La valeur sera-t-elle souvent jointe ou filtrée ? Gardez les deux côtés de la relation dans des formes natives compatibles plutôt que de convertir un côté dans chaque requête.
Les alias améliorent la compatibilité avec les outils et les conventions SQL existantes, mais ils ne dispensent pas de documenter la plage et la précision attendues. Une colonne prévue pour des identifiants entiers doit avoir un contrat clair, même si l'alias Snowflake retenu accepte davantage de valeurs.
Les types texte sont souples, ce n'est pas une autorisation à la négligence
VARCHAR est le type texte de longueur variable de Snowflake. STRING et TEXT sont des alias de compatibilité, tandis que CHAR et CHARACTER portent une sémantique de longueur fixe. La longueur déclarée devrait refléter le contrat que vous souhaitez imposer, mais Snowflake stocke les chaînes efficacement quelle que soit la longueur maximale déclarée. Une déclaration large est donc commode, même si elle affaiblit ce que communique le schéma et rend le profilage moins utile.
Pour un code client, un statut ou une catégorie issue d'un système source, un contrat VARCHAR documenté se valide plus facilement qu'un champ sans contrainte. Pour des descriptions libres, la souplesse prime généralement sur une limite étroite. La distinction est opérationnelle : un typage strict intercepte tôt les mauvaises entrées, un typage souple réduit la friction d'ingestion et déplace la responsabilité vers la validation et le monitoring.
Un modèle courant en production consiste à charger les identifiants bruts en texte uniquement lorsque l'incohérence de la source l'exige, puis à les normaliser en colonnes natives numériques ou temporelles dans une couche curée. N'obligez pas chaque analyste en aval à répéter le même cast.
Types date, heure et timestamp pour les données temporelles
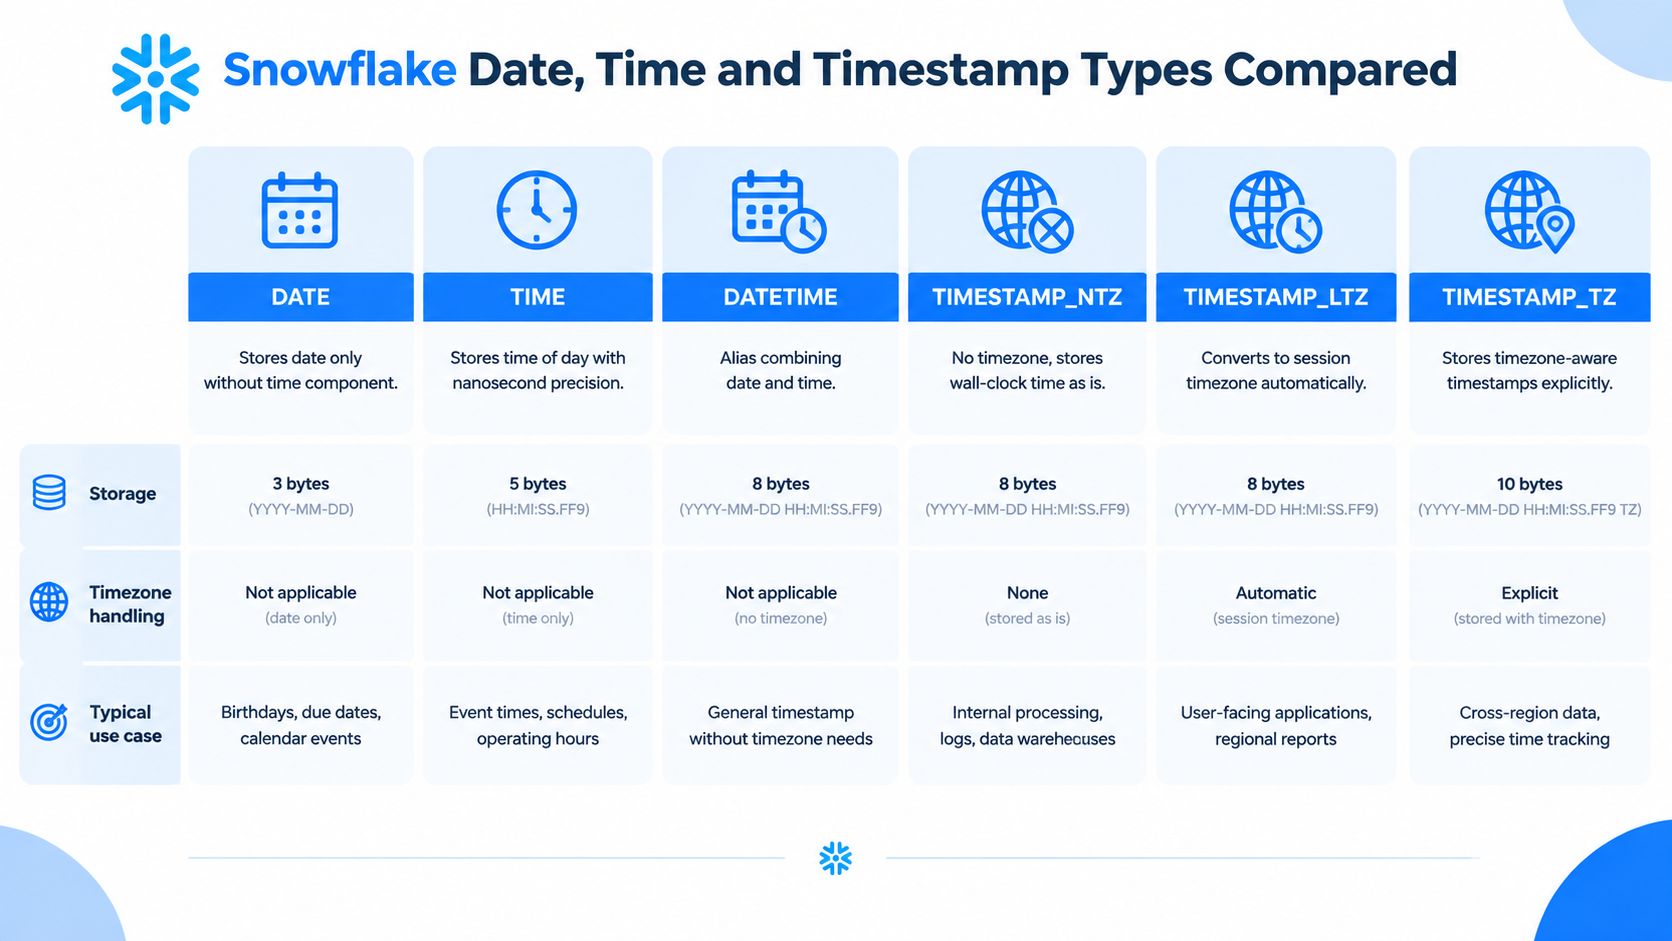
La modélisation temporelle échoue quand l'horloge d'une colonne n'est pas définie. Snowflake fournit DATE pour les dates calendaires, TIME pour les heures de la journée et DATETIME pour la combinaison des deux. Sa famille TIMESTAMP comprend TIMESTAMP_NTZ, TIMESTAMP_LTZ et TIMESTAMP_TZ. Le choix influence les jointures, les filtres, le clustering et la capacité des contrôles qualité à repérer un événement décalé.
TIMESTAMP_NTZ stocke un timestamp d'horloge murale sans sémantique de fuseau. Utilisez-le quand la source a déjà normalisé les valeurs et que l'absence de fuseau est intentionnelle. Il devient risqué lorsque des utilisateurs comparent des valeurs de régions différentes comme si elles désignaient le même instant. TIMESTAMP_LTZ affiche un timestamp dans le fuseau de la session, ce qui facilite l'affichage localisé mais peut produire des dates visibles différentes selon l'utilisateur. TIMESTAMP_TZ conserve un comportement conscient du fuseau et convient mieux lorsque le décalage ou le fuseau de la source porte un sens métier.
Aligner le type sur le contrat d'événement
Utilisez DATE pour les dates de facture, de reporting ou de prestation quand l'heure n'a pas d'importance. Utilisez TIME pour les horaires et les fenêtres d'exploitation quotidiennes. Utilisez un timestamp pour les événements, les enregistrements d'ingestion, les changements de statut et les bornes de validité des dimensions à évolution lente.
Les tables d'historique ont besoin d'une convention documentée pour les champs de début et de fin de validité. La documentation Snowflake sur l'historique point-in-time décrit des champs tels que _effective_start_timestamp et _effective_end_timestamp, les tables d'historique conservant les enregistrements de changement tandis que les tables snapshot gardent les meilleures valeurs connues. Ce design permet de reconstituer le moment où une valeur est devenue valide au lieu d'afficher seulement son état actuel. La documentation Snowflake sur les données historiques décrit un exemple ACS où les estimations sur 5 ans utilisent 60 mois de données collectées. Pour une explication plus complète de ce modèle, voir les pratiques relatives aux données historiques Snowflake.
Le comportement des fuseaux horaires influence aussi le filtrage
Un affichage dépendant de la session peut créer des décalages de date apparents pendant une investigation et amener des règles de monitoring à signaler de fausses anomalies. Standardisez l'ingestion, rendez explicite la conversion au moment de l'affichage et conservez le fuseau ou le décalage source lorsqu'il fait partie du contrat d'événement.
Le choix du type influence aussi le comportement physique. Une expression de timestamp enveloppée dans des casts répétés rend le filtrage et l'élagage plus difficiles à raisonner, alors que des colonnes d'événement cohérentes donnent au clustering et au diagnostic de requête un signal plus clair. Validez la représentation retenue avec des filtres représentatifs et inspectez le comportement des requêtes plutôt que de supposer qu'une variante de timestamp est toujours la plus performante. La leçon de production est directe : sémantique temporelle, élagage, clustering et observabilité relèvent de la même discussion de schéma.
Types de données semi-structurés et structurés
La famille semi-structurée de Snowflake s'organise autour de VARIANT, OBJECT et ARRAY. VARIANT peut contenir une valeur d'un autre type Snowflake, y compris un OBJECT ou un ARRAY. OBJECT représente des paires clé-valeur, ARRAY des collections ordonnées. Snowflake regroupe ces types car ils se combinent en structures hiérarchiques, tout en notant dans sa documentation qu'à proprement parler OBJECT est le type semi-structuré présentant les caractéristiques d'un véritable type semi-structuré. La documentation Snowflake sur les types semi-structurés explique cette distinction.
VARIANT est précieux aux frontières d'ingestion. Les API, les flux d'événements et les charges utiles des fournisseurs évoluent souvent plus vite que les contrats des tables curées. Préserver la forme brute permet aux ingénieurs d'inspecter de nouveaux attributs sans bloquer l'atterrissage. Le coût apparaît plus tard, quand les analystes extraient des chemins, convertissent des valeurs, aplatissent des tableaux ou joignent des champs imbriqués à répétition faute de projection relationnelle stable.

Les types structurés rendent les contrats visibles
Snowflake prend également en charge les types structurés ARRAY, OBJECT et MAP avec un typage fixe des éléments ou des paires clé-valeur. Ces types structurés sont devenus disponibles pour tous le 31 mai 2024, selon la documentation Snowflake sur les types de données structurés. Un tableau structuré déclare le type de ses éléments, tandis que les objects et maps structurés définissent les types qu'ils contiennent au lieu de laisser les valeurs en contenu VARIANT non contraint.
Cette distinction améliore la gouvernance. Les consommateurs peuvent savoir si un champ est numérique, textuel, temporel ou d'un autre type pris en charge sans le déduire ligne par ligne. Elle donne aussi à la logique de validation un contrat plus solide et peut simplifier des expressions de requête répétées.
Snowflake expose des métadonnées d'introspection. ELEMENT_TYPES dans INFORMATION_SCHEMA ou ACCOUNT_USAGE permet d'identifier le type des éléments d'un tableau structuré, tandis que FIELDS expose les types de clés et de valeurs des objects et maps structurés. Utilisez ces vues dans vos contrôles de schéma plutôt que de vous fier uniquement à la documentation applicative.
Un modèle hybride fonctionne bien
Conservez les charges utiles brutes et évolutives dans VARIANT, puis extrayez les attributs stables et fréquemment interrogés vers des colonnes natives ou des valeurs structurées. Utilisez FLATTEN lorsque des tableaux imbriqués doivent être analysés ligne par ligne. Snowflake documente FLATTEN comme une fonction de table produisant une vue latérale du contenu VARIANT, OBJECT ou ARRAY, ce qui la rend centrale dans les transformations de données imbriquées. Le guide d'interrogation des données semi-structurées traite de cette approche.
Les capacités récentes autour des formats ouverts renforcent aussi la nécessité de traiter le choix de type comme un design de gouvernance et de performance. La revue des fonctionnalités 2026 décrit la prise en charge GA de VARIANT pour les tables Delta Direct et les capacités d'Iceberg v3, dont VARIANT, le row lineage, les deletion vectors et les types géospatiaux. La souplesse s'étend : les équipes ont donc besoin de règles plus fermes sur le moment où la souplesse s'arrête et où commence un contrat curé.
Règles de cast et de conversion à connaître
Le cast est l'endroit où un design d'ingestion permissif rencontre un contrat analytique strict. Snowflake sait convertir entre de nombreuses familles de types, mais la conversion implicite ne remplace pas un contrat de données explicite. Une conversion peut échouer, modifier l'échelle, altérer le format ou produire une valeur d'apparence valide qui ne représente plus fidèlement la source.
Type source | Type cible | Type de conversion | Niveau de risque | Remarques |
|---|---|---|---|---|
Numérique | Texte | Conversion explicite ou contextuelle | Moyen | Le format et les comparaisons en aval doivent être revus |
Texte | Nombre | Conversion explicite | Élevé | Des caractères invalides ou une échelle inadaptée peuvent échouer |
Texte | Date ou timestamp | Conversion explicite | Élevé | Le format d'entrée et les hypothèses de fuseau doivent correspondre |
Chemin | Scalaire natif | Extraction et cast explicites | Élevé | Les chemins absents, nuls ou de types mixtes exigent un traitement |
Numérique | Numérique d'échelle réduite | Conversion explicite | Élevé | La précision ou les décimales peuvent être perdues |
Texte |
| Parsing ou conversion | Moyen | Traitez les charges utiles malformées comme des entrées rejetées ou mises en quarantaine |
Utilisez TRY_CAST ou la fonction TRY_ adaptée lorsque des enregistrements source défectueux ne doivent pas interrompre toute une transformation. Un résultat nul appelle malgré tout un contrôle. Comptez les conversions échouées, conservez la valeur d'origine là où l'auditabilité compte et orientez les enregistrements invalides vers une revue plutôt que de les accepter.
Modèles sûrs et raccourcis dangereux
Une extraction sûre rend la cible attendue visible : par exemple convertir un chemin numérique connu d'une valeur VARIANT en entier ou en nombre à virgule fixe seulement après avoir vérifié sa présence et sa forme. Un modèle dangereux convertit à l'intérieur d'un prédicat de jointure sans vérifier que les deux sources utilisent la même représentation. Cette approche peut masquer une dérive en amont et ajouter du travail répété à l'exécution.
Les conversions texte vers date méritent une prudence particulière. Définissez le format accepté à l'ingestion, rejetez les valeurs ambiguës et rendez explicite le traitement des fuseaux. La conversion de nombre vers texte exige elle aussi de la rigueur lorsque la valeur obtenue devient une clé, car des différences de format peuvent rompre l'égalité même si les nombres sous-jacents sont équivalents.
Les équipes qui reçoivent des fichiers plats Amazon peuvent appliquer le même principe : profiler les colonnes source avant le chargement, définir délibérément les types cibles et garder les échecs de conversion observables. L'ingestion par fichiers révèle souvent des représentations incohérentes qu'un schéma d'atterrissage trop souple peut dissimuler.
Comment les types de données influencent la performance et le coût des requêtes
Une sémantique correcte ne garantit pas des requêtes efficaces. Snowflake stocke les données de table en micro-partitions et conserve des métadonnées permettant d'exclure des partitions d'un scan. Les colonnes natives de date, de timestamp et numériques offrent généralement aux prédicats un accès plus direct à ces métadonnées que des expressions qui extraient des valeurs imbriquées et les convertissent ligne par ligne.
Un type large n'est pas automatiquement coûteux, ni un type étroit automatiquement rapide. La forme de la charge détermine l'arbitrage. Conservez la représentation source lorsqu'elle porte un contexte métier, puis exposez des colonnes dédiées et fortement typées pour les filtres, jointures et agrégations récurrents des tableaux de bord. Ce design réduit le travail de conversion répété sans écarter la preuve brute.
L'élagage et le clustering dépendent des types
Les clés de clustering doivent correspondre aux motifs de filtrage récurrents et maintenir un ordre utile sur toute la table. Des représentations de timestamp incohérentes affaiblissent ce bénéfice. Envelopper une clé de clustering dans une conversion peut aussi limiter l'élagage, tout comme joindre un identifiant stocké en texte dans une table à un identifiant numérique dans une autre.
Parmi les améliorations récentes de Snowflake figurent l'élagage à l'exécution pour certains filtres TIMESTAMP_TZ et une optimisation capable de reconnaître des formes de plan équivalentes plutôt qu'un texte de requête identique. Ces capacités améliorent l'exécution sur les charges concernées, mais elles ne compensent pas des types ambigus, des prédicats chargés de conversions ou des clés de jointure incohérentes.

Profilez la charge de travail réelle
Utilisez Query Profile pour examiner les octets scannés, les partitions scannées, le comportement des filtres, les jointures, les casts et les opérations de flatten. Exécutez la même requête métier contre une colonne native puis contre une expression imbriquée ou convertie à répétition. Séparez ensuite la cause : le type, la qualité du clustering, la forme du prédicat ou une projection inutile.
Les changements de type affectent aussi l'observabilité. Un cast peut augmenter le travail de scan tout en masquant une dérive de la source, et une colonne texte élargie peut laisser passer des formats invalides vers les modèles en aval. Associez l'analyse de Query Profile à la surveillance de l'usage, du coût et de la performance Snowflake par digna pour vérifier si un déploiement a modifié la consommation des warehouses, le comportement des requêtes ou les signaux de qualité. La décision d'ingénierie reste la vôtre, mais le monitoring doit en rendre l'effet opérationnel visible.
Bonnes pratiques de design de schéma pour la production
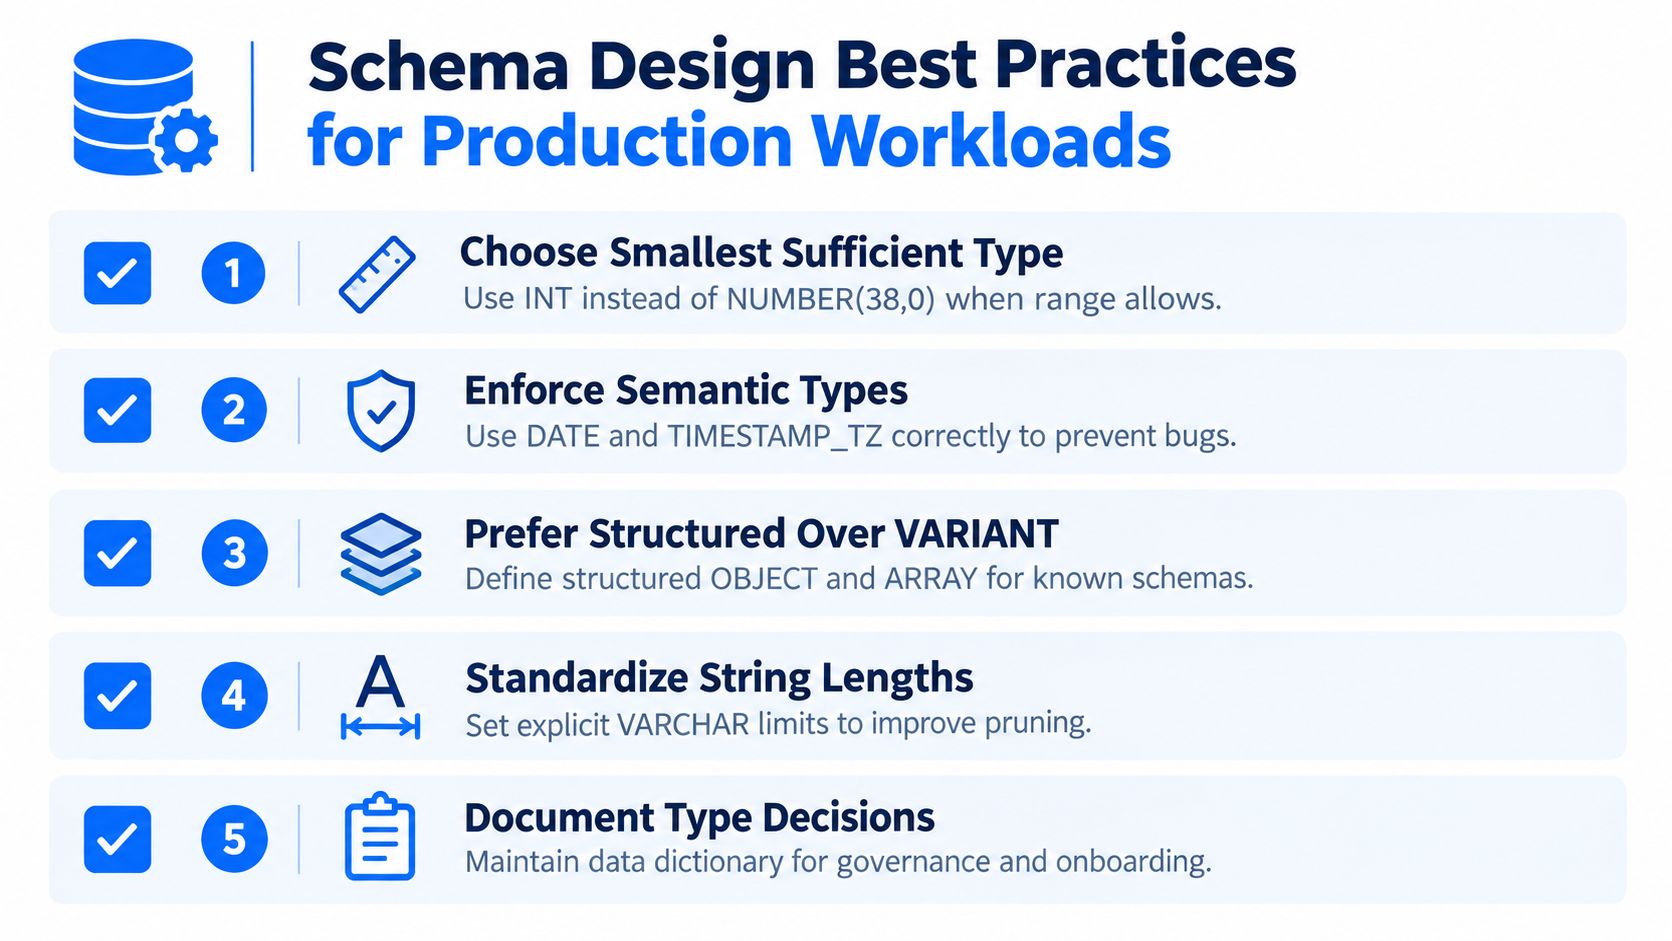
Un schéma de production doit indiquer aux utilisateurs ce que signifient les valeurs et aider la plateforme à les traiter efficacement. Partez du plus petit type natif suffisant, mais ne réduisez ni la plage ni la précision pour qu'une définition paraisse plus propre. Un identifiant entier, une mesure financière exacte, un timestamp d'événement et une charge utile brute exigent chacun un contrat différent.
Concevoir selon le rôle de la table
Les tables de faits gagnent à disposer de clés natives, de mesures exactes et de timestamps adaptés aux filtres par fenêtre temporelle. Les tables de dimensions ont besoin d'identifiants stables, de libellés descriptifs et de bornes de validité explicites quand l'historique compte. Les flux d'événements nécessitent souvent un timestamp d'ingestion, un timestamp d'événement, un identifiant de source et une charge utile brute, avec des différences soigneusement documentées entre ces horloges.
Utilisez VARIANT en périphérie lorsque la structure source évolue. Extrayez les champs vers des colonnes typées dès que les analystes les filtrent, les joignent, les agrègent ou les valident de façon répétée. Les types structurés OBJECT, ARRAY et MAP constituent une voie intermédiaire lorsque la hiérarchie compte mais que les types d'éléments et de clés-valeurs sont connus.
Rendre l'évolution du schéma délibérée
Une nouvelle colonne peut être rétrocompatible, alors que passer une colonne de texte à timestamp peut casser des vues, des tests, des extractions et des références de monitoring. Stockez les métadonnées de schéma, traitez les changements de type comme des migrations et testez des requêtes en aval représentatives avant la mise en production.
Une checklist de revue devrait inclure :
Contrat sémantique : que représente la valeur et que signifie une valeur nulle ?
Comportement des prédicats : quels filtres et quelles jointures utiliseront la colonne ?
Contrôles qualité : quelles vérifications de plage, de format, d'unicité ou de relation doivent s'exécuter ?
Trajectoire d'évolution : que se passe-t-il si la source ajoute, supprime ou modifie un champ ?
Impact sur les consommateurs : quels modèles, tableaux de bord, exports et alertes dépendent du type ?
Documentez la décision dans un dictionnaire de données, pas seulement dans le code de migration. Les ressources de digna sur le design de schéma complètent cette revue en gardant les enjeux structurels et opérationnels ensemble.
Erreurs fréquentes de typage et comment les corriger
Un échec classique commence avec un champ métier purement calendaire chargé comme timestamp. Un tableau de bord le convertit dans le fuseau de session de l'utilisateur et les enregistrements proches de minuit apparaissent au jour calendaire voisin. La correction consiste à modéliser une vraie date métier en DATE, ou à préserver un instant d'événement avec une convention de fuseau explicite quand l'heure compte vraiment.
Un autre échec apparaît dans les pipelines financiers qui utilisent des valeurs à virgule flottante pour des montants devant se réconcilier exactement. De petits écarts de représentation ressortent alors dans les regroupements, les égalités ou les contrôles de solde. Remplacez le type approximatif par une définition à virgule fixe adaptée, effectuez le backfill avec soin et comparez anciens et nouveaux résultats avant de basculer les consommateurs.
Une acceptation silencieuse reste un échec
Un champ VARCHAR trop large peut absorber des identifiants malformés, des casses mélangées et des formats inattendus jusqu'à ce qu'une jointure en aval cesse de correspondre. Définissez le contrat cible, normalisez à la frontière curée et surveillez les valeurs rejetées ou non analysables plutôt que de les laisser disparaître dans une colonne texte générique.
VARIANT produit une dégradation d'un autre ordre. La table se charge correctement, mais chaque requête importante extrait des chemins, convertit des valeurs ou aplatit des tableaux à répétition. Déplacez les chemins stables vers des colonnes typées, conservez la charge utile brute pour la traçabilité et vérifiez avec Query Profile que la transformation a bien réduit le scan inutile.
Ces problèmes se préviennent plus facilement qu'ils ne se réparent. Testez vos hypothèses de typage avec des valeurs nulles représentatives, des valeurs malformées, des bornes de fuseau, des formats numériques mixtes et des changements de schéma avant le premier chargement en production.
Relier les types de données à la qualité des données et à l'observabilité
Les systèmes d'observabilité ne peuvent surveiller que le contrat exposé par le schéma. Une colonne numérique native donne à une règle de monitoring une plage et une distribution signifiantes. Un timestamp doté d'une convention déclarée permet des contrôles de cohérence temporelle. Un object structuré expose les champs attendus plus clairement qu'une charge utile non contrainte dont la forme change d'une ligne à l'autre.
La dérive de type est particulièrement importante car elle peut ressembler à une anomalie métier. Une source qui fait passer un identifiant de numérique à texte peut créer un taux de valeurs nulles soudain dans un cast en aval. Un changement de format de timestamp peut décaler les métriques de fraîcheur ou faire sortir des enregistrements des fenêtres attendues. Un nouveau chemin imbriqué peut être une évolution utile de la source, ou signaler un changement de charge utile qu'aucun consommateur n'a testé.
Construire le monitoring autour du comportement des types
Parmi les contrôles utiles :
Suivi des échecs de conversion : compter les valeurs qui échouent aux casts sûrs et conserver des échantillons pour le diagnostic.
Cohérence temporelle : comparer l'heure d'événement à l'heure d'ingestion, aux bornes de validité et à l'ordre attendu.
Dérive structurelle : détecter les colonnes et champs imbriqués ajoutés, supprimés ou retypés.
Contrôles de distribution : surveiller les valeurs nulles, les plages, la cardinalité et les changements inattendus de catégories.
Comportement des requêtes : observer le volume scanné, la variation des durées et les changements de charge après les migrations de schéma.
Une plateforme de qualité des données doit relier ces signaux au lieu de les traiter comme des alertes isolées. digna fournit la validation in-database, la détection d'anomalies, le monitoring de la ponctualité et des capacités de Schema Tracker permettant d'identifier les changements structurels, y compris les modifications de type, tout en gardant l'exécution dans l'environnement du client. Pour les équipes qui formalisent leur couverture de règles, ce guide des règles de validation et de la qualité continue constitue un point de repère pratique.
L'objectif n'est pas d'alerter sur chaque différence de schéma. Il s'agit de distinguer une migration approuvée d'une rupture de contrat accidentelle, puis de montrer quelles tables, métriques et consommateurs sont exposés.
Référence rapide de tous les types de données Snowflake
Utilisez ce tableau lors de la revue d'une colonne ou de la rédaction d'un standard de schéma. Les alias ci-dessous sont utiles pour la compatibilité, mais le contrat sémantique visé doit rester explicite.
Famille | Types | Caractéristiques clés | Usage courant |
|---|---|---|---|
Numérique exact |
| Précision et échelle en virgule fixe | Valeurs financières, mesures exactes |
Numérique entier |
| Alias entiers pour les nombres entiers | Clés, comptages, valeurs de séquence |
Numérique approximatif |
| Valeurs approximatives à virgule flottante | Mesures scientifiques ou approximatives |
Texte |
| Sémantique de texte à longueur variable ou fixe | Codes, libellés, descriptions |
Binaire |
| Stockage binaire brut | Données encodées ou orientées octets |
Temporel |
| Valeurs de date, d'heure ou combinées | Dates métier et plannings |
Timestamp |
| Comportements différents de fuseau et d'affichage de session | Événements, ingestion, périodes de validité |
Logique |
| Valeurs vraies ou fausses | Indicateurs et drapeaux d'état |
Semi-structuré |
| Contenu hiérarchique souple | JSON brut et charges utiles évolutives |
Structuré |
| Typage fixe des éléments ou des paires clé-valeur | Données imbriquées gouvernées |
Géospatial |
| Modélisation de données spatiales | Analyse géographique et géométrique |
Le modèle de types natif de Snowflake sépare les types scalaires primitifs des types semi-structurés et structurés. La référence complète des types de données Snowflake documente également des surfaces de métadonnées comme ELEMENT_TYPES et FIELDS, utiles lorsque des contrôles automatisés doivent inspecter du contenu structuré.
Une bonne règle par défaut consiste à faire atterrir avec souplesse les données source incertaines, à curer en types natifs les chemins d'accès récurrents et à examiner chaque changement de type sous l'angle de l'élagage, de la compatibilité des consommateurs et de l'impact sur le monitoring. Cette approche préserve la justesse sémantique sans produire un schéma qui n'est propre que sur le papier.
digna aide les équipes data à relier les changements de schéma Snowflake à la validation, à la détection d'anomalies, à la ponctualité et au suivi structurel, dans leur propre environnement. Si vous standardisez vos types de données Snowflake et souhaitez détecter la dérive avant qu'elle ne casse des tableaux de bord ou des pipelines en aval, rendez-vous sur digna pour évaluer la plateforme dans votre flux d'observabilité.
Voici comment digna procède en pratique : surveiller la qualité des données au sein de Snowflake.
Questions fréquentes
Quel type de données Snowflake utiliser pour les nombres ?
Utilisez NUMBER à virgule fixe (ou ses alias DECIMAL et NUMERIC) pour les valeurs devant être exactes, comme les montants et les quantités. Réservez FLOAT et DOUBLE aux travaux scientifiques ou statistiques où l'approximation est acceptable, car la virgule flottante introduit des écarts d'arrondi qui apparaissent lors des agrégations et des comparaisons.
Quelle est la différence entre VARCHAR et STRING dans Snowflake ?
Ce sont des synonymes : STRING, TEXT et VARCHAR désignent le même type à longueur variable, et Snowflake ne stocke que les caractères réellement écrits, si bien qu'une longueur généreuse ne coûte rien en stockage. Déclarer une longueur réaliste reste utile pour des raisons opérationnelles : cela documente le contrat et rend visibles les valeurs inattendues au lieu de les accepter en silence.
Quand utiliser VARIANT plutôt que des types structurés ?
Utilisez VARIANT là où la charge utile évolue réellement et où vous ne maîtrisez pas le producteur, typiquement dans la couche d'atterrissage. Utilisez des colonnes typées explicites pour les contrats dont dépend le reporting. Le modèle hybride — atterrir en VARIANT, projeter des colonnes typées en aval — garde l'ingestion souple sans reporter le coût d'extraction et de conversion sur chaque requête.
Comment les types de données Snowflake influencent-ils la performance et le coût des requêtes ?
Les types déterminent l'efficacité de l'élagage des micro-partitions et du clustering, et la nécessité de convertir les prédicats avant comparaison. Convertir une colonne dans une clause WHERE empêche souvent l'élagage : Snowflake scanne alors bien plus de données que nécessaire et la requête consomme davantage de crédits pour le même résultat.
Comment les types de données influencent-ils le monitoring de la qualité des données ?
Des types stables et précis donnent du sens aux écarts : le monitoring peut comparer distributions, taux de valeurs nulles et plages à un contrat connu. Des types trop permissifs acceptent sans broncher des valeurs malformées, de sorte que les problèmes restent invisibles jusqu'à ce que quelqu'un conteste un chiffre dans un rapport.


