Le contrôle qualité automatique pour des données fiables
|
7
minute de lecture

Votre tableau de bord du matin est au vert, pourtant la tendance du chiffre d'affaires semble fausse. Un flux planifié est arrivé en retard, une colonne a changé de type ou un système source a modifié la distribution d'un champ. Le pipeline s'est terminé correctement, donc le contrôle d'état habituel est passé. Le temps que quelqu'un remarque l'impact métier, les analystes ont déjà diffusé des chiffres peu fiables et les ingénieurs remontent le problème à l'envers.
La revue manuelle ne peut pas suivre le volume et la variété des pipelines modernes. Le contrôle qualité automatique change le modèle opérationnel : il surveille les données en continu, repère les écarts significatifs, applique les règles essentielles et fournit aux bonnes personnes des éléments exploitables. Les conséquences de ces défaillances non détectées sont décrites dans cet aperçu des conséquences d'une mauvaise qualité des données.
Table des matières
Introduction : pourquoi la qualité des données se dégrade sans automatisation
De l'inspection à l'exploitation continue
La décision de conception centrale
Ce que signifie vraiment le contrôle qualité automatique
Le fondement statistique
Ce que le système surveille
Comment fonctionnent les contrôles automatisés, des règles à l'IA
Validation par règles
Seuils statistiques
Détection par IA et apprentissage automatique
Choisir le type de contrôle adapté à chaque signal
Faire passer l'automatisation en exploitation continue
Garder le calcul au plus près des données
Relier temps, structure et signification
Des bénéfices mesurables et perceptibles au quotidien
Ce qui change pour l'équipe
Où le contrôle qualité automatique apporte de la valeur en pratique
Finance
Santé
Télécommunications
Secteur public
Quand automatiser et comment démarrer avec digna
Checklist d'adoption
Introduction : pourquoi la qualité des données se dégrade sans automatisation
Une équipe data peut inspecter quelques tables critiques après une mise en production, vérifier qu'une transformation s'est exécutée, puis passer à la tâche suivante. Ce processus détecte les échecs évidents, comme une table vide ou un job cassé. Il ne détectera pas de façon fiable une dérive progressive de l'activité client, une source arrivée en retard ou une valeur d'apparence correcte qui n'a plus de sens métier.
Le problème n'est pas l'absence de tests. Les environnements modernes combinent entrepôts, lacs, systèmes de streaming, flux fournisseurs, outils de transformation et tableaux de bord. Chaque couche peut sembler saine pendant que le résultat perd en fiabilité. Un pipeline exécuté avec succès prouve que le code a tourné, pas que les données représentent encore l'activité.
De l'inspection à l'exploitation continue
L'industrie offre une analogie utile. Un contrôle final peut écarter les produits défectueux, mais des capteurs répartis le long de la ligne détectent la dérive du procédé avant que les défauts ne s'accumulent. Les équipes data ont besoin de la même boucle de rétroaction. Plutôt que de traiter la qualité comme un portail en fin de pipeline, elles peuvent surveiller les enregistrements, le comportement de livraison, la structure, les indicateurs métier et l'activité de la plateforme dans le cadre de l'exploitation quotidienne.
Ce changement clarifie aussi les responsabilités. Un ingénieur data devra peut-être enquêter sur un changement de schéma, un analyste expliquer un mouvement inhabituel de KPI et un responsable gouvernance prouver qu'un contrôle a bien tourné. Le contrôle qualité automatique doit relier ces tâches plutôt que produire un rapport isolé de plus.
La décision de conception centrale
Automatiser ne veut pas dire remplacer chaque règle par un modèle. Certains signaux doivent s'apprendre à partir du comportement historique, comme le volume normal ou le délai de livraison attendu. D'autres doivent rester déterministes : un champ obligatoire, un statut autorisé, une contrainte réglementaire.
La question pratique est donc précise : quelles conditions le système doit-il apprendre statistiquement, et lesquelles doit-il faire respecter à la lettre ? La réponse détermine si l'automatisation réduit le bruit ou génère davantage d'alertes.
Ce que signifie vraiment le contrôle qualité automatique
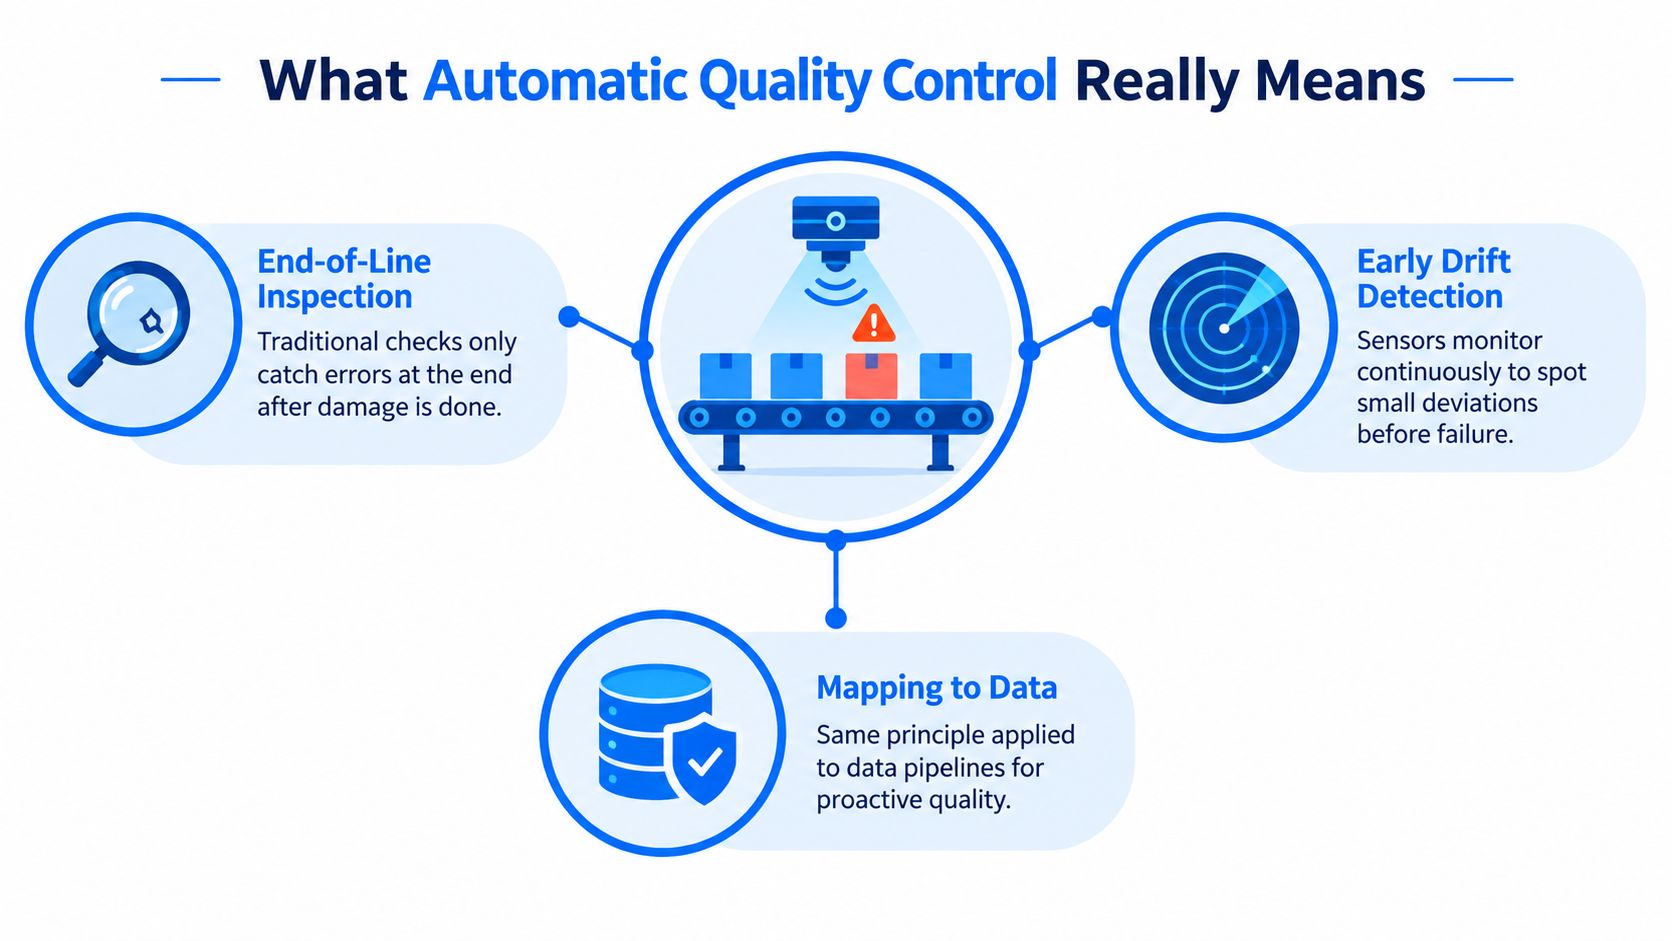
Imaginez un convoyeur transportant des pièces identiques. Un capteur suit la température, le poids et la position pendant qu'une caméra contrôle la surface. Le système n'attend pas la dernière boîte emballée pour découvrir un problème. Il compare les mesures actuelles au comportement attendu, signale les écarts et peut arrêter ou dérouter le processus avant que d'autres pièces défectueuses ne passent.
La qualité des données fonctionne de la même façon. Un système de monitoring observe tables et pipelines, établit à quoi ressemble un comportement normal et confronte les données entrantes à cette référence. Il peut aussi appliquer des validations explicites lorsque l'organisation a une règle qui doit toujours tenir.
Le contrôle qualité automatique consiste à utiliser en continu un logiciel pour observer le comportement des données, faire respecter des exigences de qualité définies, détecter les écarts significatifs et transmettre les preuves aux personnes ou systèmes chargés d'agir.
Le fondement statistique
La maîtrise statistique des procédés (SPC) fournit une base utile. Elle s'appuie sur des cartes de contrôle et des mesures pour distinguer la variation normale de la variation de cause spéciale, c'est-à-dire un changement suggérant que quelque chose d'inhabituel est entré dans le processus. Dans un processus normalement distribué, une limite de contrôle à 3 sigma situe la probabilité qu'une bonne pièce sorte de la bande autour de 1 sur 1 000, tandis qu'une limite à 6 sigma la ramène à environ 1 sur 1 000 000 (recherche SPC sur la détection automatisée).
La leçon n'est pas que chaque table a besoin d'une règle six sigma. La leçon est que les systèmes qualité doivent détecter la dérive tôt, au lieu de dépendre du seul contrôle final. Une référence donne du contexte au système. Sans contexte, un seuil peut signaler une saisonnalité ordinaire ou manquer un changement important.
Ce que le système surveille
Le contrôle qualité automatique couvre plusieurs couches de comportement :
Qualité des enregistrements : valeurs obligatoires, formats valides, plages, valeurs de référence, doublons et relations métier.
Ponctualité des pipelines : les données arrivent-elles quand les utilisateurs et les traitements en aval l'attendent.
Stabilité du schéma : des colonnes sont-elles ajoutées, supprimées, renommées ou changées de type.
Comportement métier : le chiffre d'affaires, les transactions, l'activité client ou un autre KPI sortent-ils des schémas attendus.
Comportement de la plateforme : les charges, la disponibilité, la consommation ou les métriques de performance évoluent-elles de façon inattendue.
Un test isolé ne peut pas couvrir tout cela. Le système opérationnel combine mesures, règles, historique, responsabilités, alertes et contexte de remédiation. C'est cette combinaison qui transforme le test en contrôle continu.
Comment fonctionnent les contrôles automatisés, des règles à l'IA
Trois familles de contrôles couvrent la plupart des dispositifs de contrôle qualité automatique. Elles ne s'opposent pas systématiquement : chacune répond à une question différente, et les meilleures implémentations affectent chaque signal à la méthode adaptée à son risque.
Validation par règles
Les contrôles déterministes sont explicites et reproductibles. Une règle peut exiger un identifiant client, rejeter une quantité négative, restreindre un statut à une liste de référence approuvée ou vérifier qu'un timestamp respecte un format requis. Si la condition échoue, le résultat est net : l'enregistrement ou le jeu de données viole une exigence formulée.
Les règles sont particulièrement précieuses pour la logique métier, les contrôles d'audit et les engagements contractuels. Elles fournissent aussi de bonnes preuves, car un responsable peut expliquer exactement ce qui a réussi, ce qui a échoué et pourquoi. Leur limite tient à la maintenance : une règle ne peut pas déduire une référence qui évolue si personne ne la met à jour, et une règle trop large crée du travail opérationnel inutile.
Seuils statistiques
Les contrôles statistiques demandent si une mesure s'est éloignée anormalement de son comportement établi. La mesure peut être le volume de lignes, la densité de valeurs nulles, la distribution des valeurs ou le délai de livraison. Les bandes de contrôle s'adaptent à des motifs qu'un seuil fixe traiterait mal.
Le système a malgré tout besoin d'une configuration réfléchie. Un indicateur métier peut varier selon le jour de la semaine, le cycle de livraison ou la période de reporting. Une référence qui ignore ces motifs déclenchera trop d'alertes ; une référence trop permissive manquera un vrai problème.
Détection par IA et apprentissage automatique
La détection par IA est utile lorsque les données présentent des relations complexes ou lorsque rédiger des règles à la main serait irréaliste. Un modèle peut apprendre les motifs d'un jeu de données et signaler des écarts de volume, de distribution ou de valeurs. Cela ne rend pas le résultat automatiquement juste : le modèle a besoin d'un historique suffisant, d'une surveillance adaptée et d'un processus de revue des faux positifs.
Un exercice de benchmark sur des profils océaniques montre pourquoi le choix des tests compte. Des chercheurs ont évalué 60 contrôles automatisés distincts et ont constaté qu'il fallait retenir un sous-ensemble optimal, car les différentes règles arbitrent entre sensibilité et sur-signalement (benchmark de contrôles qualité automatisés). Multiplier les tests n'améliore pas mécaniquement la qualité : cela peut créer une fatigue d'alerte si l'équipe ne distingue plus un signal utile d'une variation ordinaire.
Choisir le type de contrôle adapté à chaque signal
Famille de contrôle | Idéal pour | Points forts | Points de vigilance |
|---|---|---|---|
Validation par règles | Champs obligatoires, formats, plages, listes de référence et contraintes métier | Résultat binaire clair, logique explicable, preuve d'audit solide | Demande de la maintenance quand les exigences métier changent |
Seuils statistiques | Volume, distributions, valeurs nulles et rythmes de livraison | S'adapte au comportement observé et met la dérive en évidence | Peut sur-alerter si la saisonnalité ou la référence sont mal comprises |
Détection par IA | Motifs subtils, multivariés ou changeants entre jeux de données | Repère des comportements difficiles à exprimer sous forme de règles individuelles | Exige gouvernance, revue et garde-fous contre les décisions opaques |
La bonne stratégie n'est pas d'écrire moins de règles, mais de décider quels signaux méritent une application exacte, lesquels nécessitent des seuils adaptatifs et lesquels gagnent à une détection apprise. Pour une explication concrète de la détection d'anomalies dans les pipelines, voir comment l'IA détecte les anomalies de données.
Faire passer l'automatisation en exploitation continue
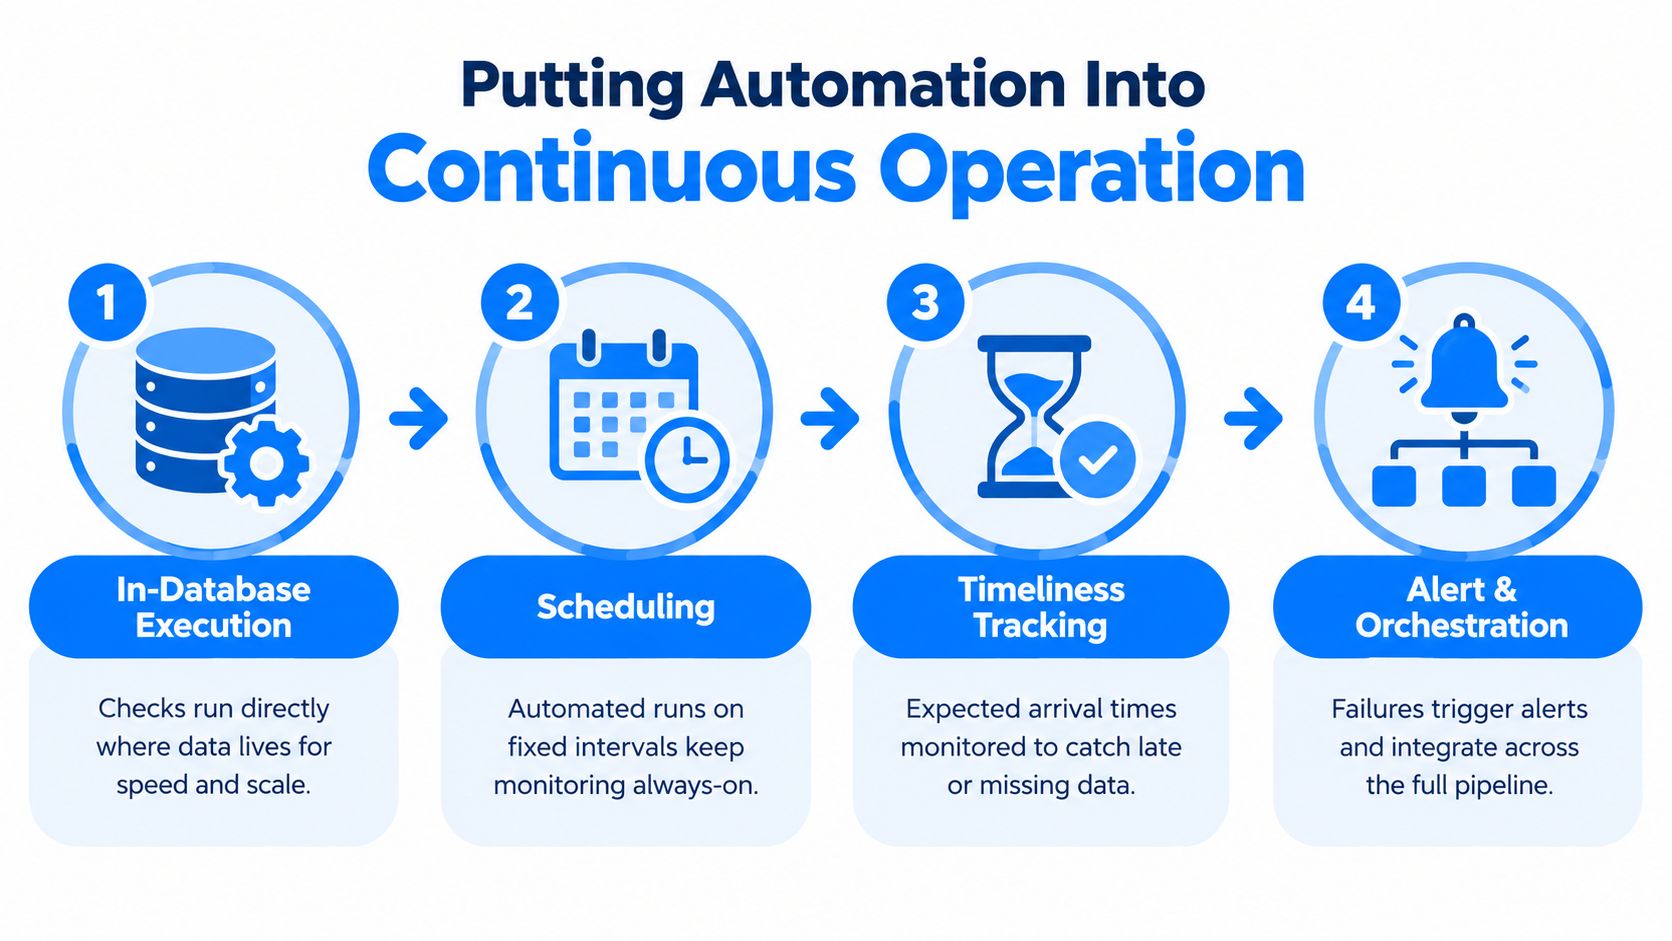
Un ensemble de contrôles ne devient utile que s'il tourne comme une boucle opérationnelle. Cette boucle doit observer les données là où elles se trouvent déjà, s'exécuter selon un rythme fiable, comparer le comportement réel au comportement attendu et acheminer les échecs vers un responsable disposant d'assez de contexte pour réagir.
Garder le calcul au plus près des données
L'exécution in-database permet de calculer les métriques et de mener l'analyse dans la base du client. Les données restent en place, ce qui réduit les mouvements inutiles et sert les exigences de confidentialité et de gouvernance. Cette approche est particulièrement pertinente quand les données de production ne peuvent pas être copiées vers un service de monitoring externe.
Le dispositif requiert toujours des contrôles d'accès, de la journalisation et une séparation nette entre métadonnées de monitoring et enregistrements sensibles. L'exécution locale ne remplace pas la gouvernance : elle lui donne une base plus solide, car l'organisation définit où le calcul a lieu et quelles preuves sortent de l'environnement.
Relier temps, structure et signification
Une boucle de monitoring fiable combine plusieurs formes de preuves :
Planifier l'observation. Des intervalles fixes ou des événements de pipeline garantissent que les contrôles s'exécutent sans que personne n'ait à y penser.
Suivre la livraison attendue. Le monitoring de ponctualité apprend le comportement d'arrivée et signale des données tardives, absentes ou en avance.
Détecter le changement structurel. Le suivi de schéma identifie les colonnes ajoutées ou supprimées et les changements de type avant que les consommateurs en aval n'échouent.
Surveiller les indicateurs métier. Le monitoring des KPI relie le comportement technique des données à des résultats que les responsables métier reconnaissent.
Router l'incident. Une alerte doit indiquer l'actif concerné, la condition en échec, le changement observé et la personne ou l'équipe responsable.
Les enquêtes révèlent un déficit de stratégie. SYNQ a identifié la « connaissance insuffisante des bonnes pratiques de test » comme premier défi de qualité des données, tandis que la grande majorité des équipes s'appuyait surtout sur les tests intégrés de leur outil de transformation et qu'environ 10 % seulement utilisaient souvent l'IA dans leurs flux qualité (enquête de référence SYNQ sur la qualité des données). Les équipes ont donc besoin de repères opérationnels, pas d'une bibliothèque de tests supplémentaire.
Un tableau de bord partagé, un catalogue de données, un ordonnanceur et un processus de collaboration transforment une alerte en incident géré. Les ingénieurs examinent les preuves techniques, les analystes voient l'impact métier et les parties prenantes suivent l'état sans sortir les données de production de l'environnement client. D'autres conseils pratiques sur la validation et les contrôles continus figurent dans les règles de validation et la qualité continue des données.
Des bénéfices mesurables et perceptibles au quotidien
Le bénéfice le plus utile du contrôle qualité automatique n'est pas le nombre de contrôles configurés, mais la réduction de l'incertitude dans le travail courant. Les équipes repèrent la dérive avant qu'un rafraîchissement de tableau de bord ne l'expose, voient si un flux tardif a créé un trou dans un rapport, et distinguent un pipeline cassé d'un vrai changement d'activité.
Les systèmes industriels de vision montrent l'intérêt d'inspecter en continu plutôt que d'échantillonner en fin de ligne. Les revues du contrôle qualité par vision intégré à des automates décrivent des systèmes qui capturent l'image de chaque produit, classent les défauts en temps réel et permettent une inspection à 100 % à la vitesse de la ligne. Une intégration rapportée atteignait environ 96,2 % d'exactitude, avec 95,4 % de précision, 96,8 % de rappel et un F1 de 96,1 % (revue du contrôle qualité industriel par vision).
Ce qui change pour l'équipe
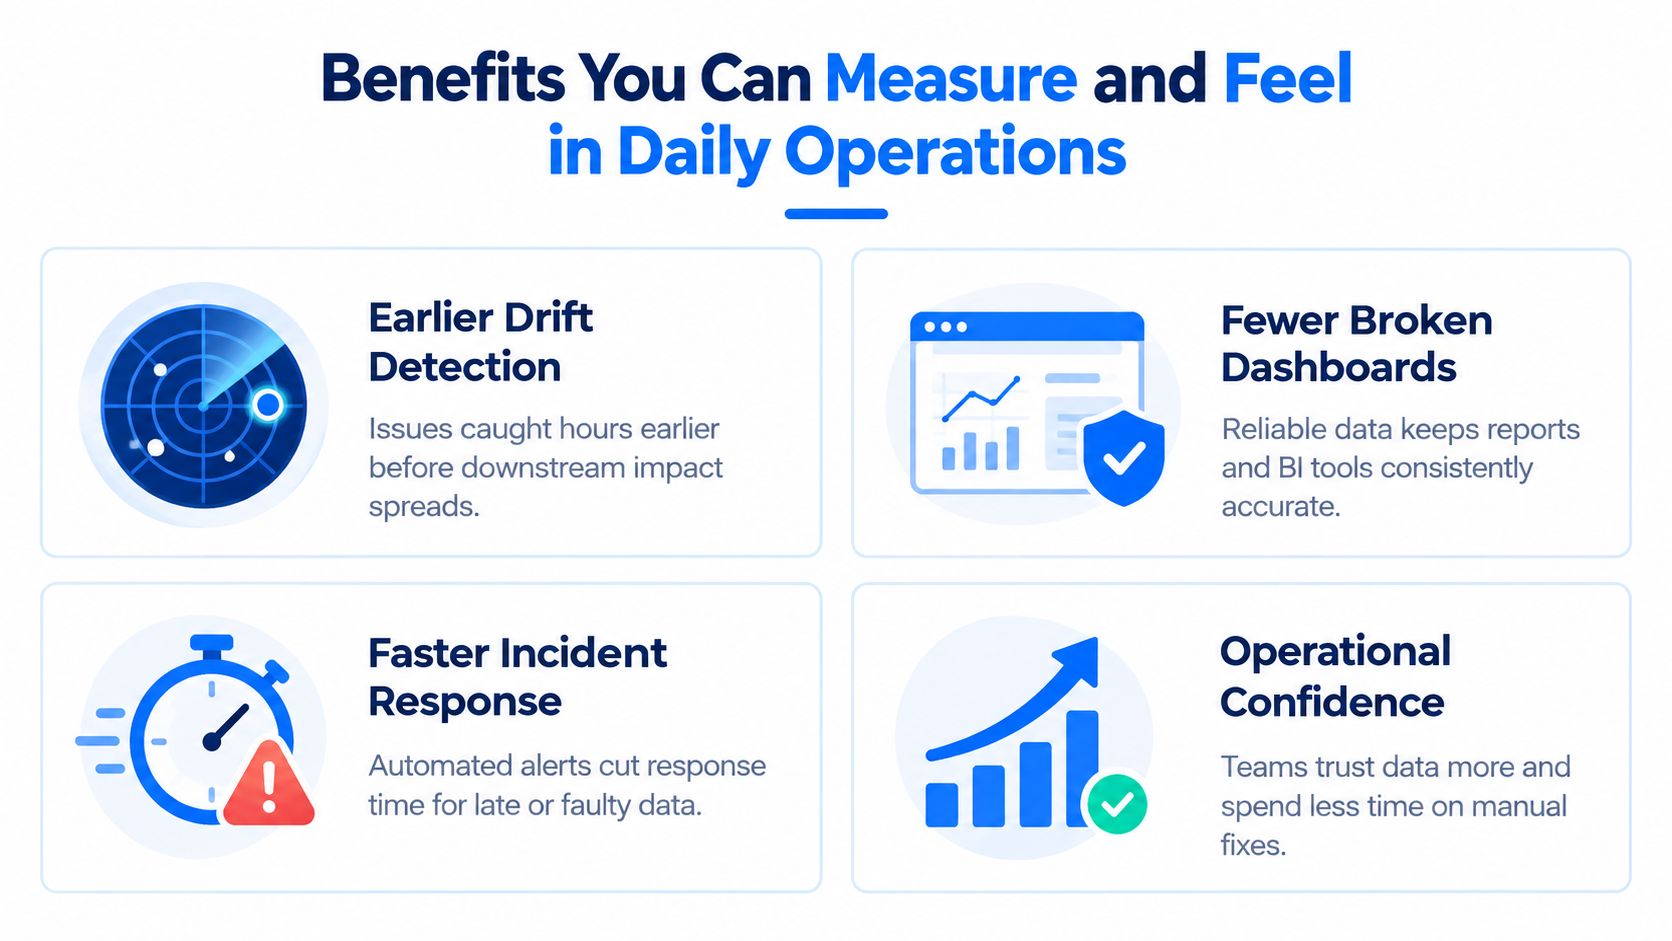
Une détection plus précoce de la dérive laisse aux ingénieurs le temps d'examiner une source ou une transformation avant que les consommateurs en aval n'amplifient l'impact. Un petit écart devient un événement visible au lieu d'une hypothèse cachée.
Moins de tableaux de bord faussés découle de la surveillance des données et de la structure. Un tableau de bord peut rester techniquement disponible tout en affichant des informations périmées ou déformées ; les signaux qualité aident à faire la différence.
Une réaction plus rapide aux chargements manquants vient du suivi des livraisons attendues. Au lieu d'attendre qu'un analyste remarque un rapport vide, le système constate qu'un jeu de données n'est pas arrivé dans son schéma habituel.
Des preuves de conformité plus solides proviennent de contrôles déterministes, d'un historique d'exécution, de responsabilités et de résultats documentés. Auditeurs et responsables métier ont besoin de plus qu'un statut vert : ils doivent savoir ce qui a tourné et ce qui s'est passé.
Pour qui s'intéresse au rôle des données prédictives en QA, le principe est comparable : le comportement historique aide à anticiper les risques qualité, mais les signaux prédictifs ont besoin de chemins d'action clairs. L'automatisation ne sert la maîtrise des coûts, la fiabilité des modèles et la confiance dans l'analytique que si les alertes sont compréhensibles et que quelqu'un porte la réponse.
Le résultat concret, c'est la confiance. Les équipes passent moins de temps à vérifier que les données existent et plus de temps à décider ce qu'elles signifient. Ce bénéfice disparaît si chaque alerte est bruyante, dupliquée ou sans équipe responsable : le réglage et la propriété restent donc partie intégrante du système qualité. Plus de contexte sur ces résultats opérationnels dans les bénéfices de la qualité des données.
Où le contrôle qualité automatique apporte de la valeur en pratique
La même architecture de contrôle se comporte différemment selon les secteurs, car les risques diffèrent. Une équipe finance se souciera du reporting réglementaire et de l'exhaustivité des transactions. Un établissement de santé privilégiera la fiabilité des données cliniques et la confidentialité. Un opérateur télécom surveillera des événements clients à très fort volume, tandis qu'une administration aura besoin d'enregistrements cohérents et traçables pour ses audits.
Finance
Un flux de risque arrive chaque matin et alimente des rapports utilisés par la finance et la conformité. Un job terminé ne garantit pas que le flux contient les enregistrements attendus, ni qu'un changement de source n'a pas modifié un champ critique. Le monitoring de ponctualité repère une arrivée tardive, la validation déterministe applique les règles de transaction et le suivi de schéma révèle un changement structurel avant que le reporting ne casse.
À retenir : commencez par les jeux de données qui soutiennent des décisions réglementaires, de risque ou financières, puis attribuez des responsables explicites à chaque contrôle.
Santé
Une équipe d'opérations cliniques combine des informations issues de plusieurs systèmes. Un champ manquant peut fausser l'interprétation, tandis qu'un changement structurel peut perturber une application en aval sans provoquer d'erreur évidente dans le pipeline. Validation continue et suivi de schéma permettent d'identifier ces situations tout en gardant le calcul dans l'environnement maîtrisé de l'organisation.
À retenir : séparez le traitement des données sensibles des preuves de monitoring et définissez quels contrôles exigent une preuve déterministe.
Télécommunications
Une plateforme télécom traite des événements clients et opérationnels à très fort volume. Les responsables métier doivent savoir si un mouvement inattendu reflète un comportement client réel ou un problème de pipeline. Surveiller les indicateurs métier en parallèle de la disponibilité des données et de la charge de la plateforme aide à enquêter au bon niveau.
À retenir : associez le monitoring des KPI à l'observabilité de la plateforme pour confronter un mouvement inhabituel aux preuves opérationnelles.
Secteur public
Les données publiques circulent souvent entre services et systèmes aux modèles de responsabilité différents. Un programme de contrôle doit garantir cohérence, traçabilité et preuves prêtes pour l'audit, plutôt que de reposer sur des vérifications informelles dans chaque équipe.
À retenir : documentez la règle, l'exécution, le résultat et le responsable de chaque jeu de données critique.
Dans les environnements régulés, l'architecture de déploiement compte autant que la détection. digna peut s'exécuter dans le cloud privé, le VPC ou le centre de données du client, avec un calcul in-database : les organisations limitent ainsi les mouvements de données tout en conservant une vue partagée des incidents, tendances et statuts.
Quand automatiser et comment démarrer avec digna
Partez du risque, pas du catalogue de fonctionnalités le plus fourni. Un jeu de données critique, livré fréquemment et consommé par plusieurs systèmes, mérite l'attention avant une table à faible impact que peu de gens utilisent.
Quatre questions aident à cadrer le premier périmètre :
Impact décisionnel : quelle décision métier, clinique, financière ou de service public dépend de ces données ?
Visibilité de la panne : les utilisateurs remarqueraient-ils immédiatement un échec, ou pourrait-il passer inaperçu ?
Complexité opérationnelle : les données traversent-elles plusieurs pipelines, responsables ou plateformes ?
Pression de gouvernance : la confidentialité, la conformité ou l'audit exigent-ils des preuves ?
Un premier projet raisonnable vise un problème à fort impact, comme la détection d'anomalies ou la ponctualité. Étendez ensuite, une fois que l'équipe maîtrise la qualité des alertes, la propriété et la remédiation. Gardez un déploiement modulaire : validation déterministe, suivi de schéma, monitoring métier ou observabilité de plateforme s'ajoutent là où le risque le justifie.
Checklist d'adoption
Exécuter localement : gardez le calcul dans le cloud, le VPC ou le centre de données de l'organisation lorsque déplacer les données crée un risque.
Utiliser la base : privilégiez le calcul des métriques in-database quand la sécurité et l'échelle l'imposent.
Séparer signaux appris et signaux fixes : laissez les références repérer les comportements inhabituels pendant que les règles déterministes font respecter les obligations.
Consigner les preuves : conservez le contrôle, le contexte d'exécution, le résultat, le responsable et l'historique de résolution.
Connecter le flux de travail : intégrez les alertes à l'ordonnanceur, au catalogue, aux tableaux de bord et au processus de collaboration.
Revoir les fausses alertes : traitez le réglage des alertes comme une responsabilité d'ingénierie continue.
Une démarche de mise en œuvre de la qualité des données bien ciblée aide à traduire ces décisions en modèle opérationnel. L'objectif n'est pas d'automatiser les tests pour eux-mêmes, mais de faire de la qualité un processus continu et transparent auquel ingénieurs et responsables métier peuvent se fier.
digna propose un monitoring modulaire des anomalies, de la validation, de la ponctualité, des changements de schéma, des indicateurs métier et du comportement de la plateforme, à l'intérieur de l'environnement client. Rendez-vous sur digna pour évaluer un point de départ ciblé et voir comment un contrôle qualité automatique continu s'intègre à votre patrimoine de données.
Voici comment digna procède en pratique : un monitoring automatisé de la qualité là où vivent vos données.
Questions fréquentes
Qu'est-ce que le contrôle qualité automatique appliqué aux données ?
Le contrôle qualité automatique est la vérification continue des jeux de données sans qu'une personne la déclenche. Il associe une validation par règles pour les exigences que l'on peut énoncer exactement, des seuils statistiques pour les tolérances mesurables et de l'apprentissage automatique qui signale les écarts par rapport au comportement appris de chaque jeu de données.
En quoi diffère-t-il des contrôles manuels ?
L'inspection manuelle échantillonne périodiquement et dépend de qui est disponible pour regarder. L'automatisation observe chaque chargement par rapport à une référence : la couverture ne varie pas selon l'équipe de garde et le délai de détection passe de jours à minutes, ce qui détermine l'ampleur des dégâts en aval.
Quand utiliser des règles et quand recourir à l'IA ?
Utilisez des règles quand l'exigence peut s'écrire : une colonne ne doit pas être NULL, une valeur doit respecter un format, une table doit arriver avant une échéance. Utilisez la détection statistique et l'IA pour tout ce qui ne peut pas être énuméré à l'avance : une chute de volume, un déplacement de distribution ou un chargement qui dérive un peu plus chaque nuit.
Le contrôle qualité automatique oblige-t-il à copier les données ailleurs ?
Il ne devrait pas. Garder le calcul près des données signifie que seules les métriques et les métadonnées quittent l'environnement, ce qui compte partout où la résidence des données, la confidentialité ou la réglementation sectorielle encadrent le traitement des données de production.
Comment commencer à automatiser le contrôle qualité des données ?
Commencez par les jeux de données dont la défaillance a de vraies conséquences, laissez le système apprendre leur comportement normal et automatisez les contrôles que votre équipe réalise déjà à la main. Élargissez la couverture une fois les alertes jugées fiables : l'adoption échoue plus souvent à cause du bruit que du manque de fonctionnalités.