L'analyse de la fiabilité des données expliquée pour les équipes de données modernes
|
8
minute de lecture

Une enquête de 2024 sur les perspectives de planification a révélé que 67 % des organisations ne faisaient pas entièrement confiance aux données utilisées pour la prise de décision, contre 55 % l'année précédente, soit une baisse de confiance de 12 points en un seul cycle annuel. L'analyse de l'enquête par Precisely cerne clairement le problème : on demande aux équipes d'analyse d'aller plus vite alors que leurs bases de données restent difficiles à vérifier.
Cet écart est le territoire pratique de l'analyse de la confiance des données. Elle relie la qualité des données, l'Observability, la détection des anomalies, le lignage et le contexte métier afin que les équipes puissent répondre à une question plus utile que « Le pipeline a-t-il fonctionné ? ». Elles peuvent demander : « Ce jeu de données est-il assez fiable pour étayer une décision ou un résultat d'IA dès maintenant ? »
Table des matières
Pourquoi la confiance des données est le nouveau goulot d'étranglement pour l'analytique et l'IA
Pourquoi la confiance dans le code n'est pas la confiance dans les données
Ce que signifie réellement l'analyse de la confiance des données
La confiance est un signal composite
Les cinq piliers qui produisent des signaux de confiance
La fraîcheur indique si les données sont à jour
La qualité teste les valeurs et les règles métier
Le volume détecte les échecs d'exhaustivité silencieux
Le schéma protège la compatibilité structurelle
Le lignage identifie qui et quoi est affecté
Comment les couches de détection combinent statistiques, ML et examen humain
Où l'apprentissage automatique apporte de la valeur
Pourquoi les humains font toujours partie du système
Des métriques qui transforment la confiance en quelque chose que vous pouvez mesurer
Lire les métriques ensemble
Ajouter le contexte de décision
De l'Observability à la préparation à la décision pour l'IA
Créer des tableaux de bord autour des résultats
Exploiter la confiance dans les limites de l'entreprise
Maintenir le plan de contrôle proportionnel
Attribuer la propriété avant d'ajouter des alertes
Construire un modèle opérationnel de confiance qui tient la route
Transformer les incidents en connaissances institutionnelles
Examiner la confiance comme une pratique transversale
Pourquoi la confiance des données est le nouveau goulot d'étranglement pour l'analytique et l'IA
Un responsable financier ouvre un tableau de bord des revenus avant une réunion de direction. Le graphique montre une baisse brutale des ventes régionales, de sorte que l'équipe reporte un plan de recrutement et révise ses prévisions. Plus tard, un ingénieur découvre qu'un changement en amont a provoqué l'arrivée tardive d'une partie des données clients. Le tableau de bord n'affichait pas une fabrication malveillante. Il affichait des données devenues incomplètes sans que la défaillance ne soit évidente.
Ce scénario est courant car les tableaux de bord, les modèles d'apprentissage automatique et les copilotes d'IA héritent des conditions de leurs données sources. Des lignes manquantes peuvent réduire une métrique. Une partition obsolète peut donner l'impression qu'une tendance est actuelle alors qu'elle ne l'est pas. Une jointure brisée peut supprimer des clients d'un segment. Une colonne renommée peut altérer une transformation. Sans lignage exploitable, personne ne peut rapidement établir quels rapports, fonctionnalités ou décisions sont affectés.
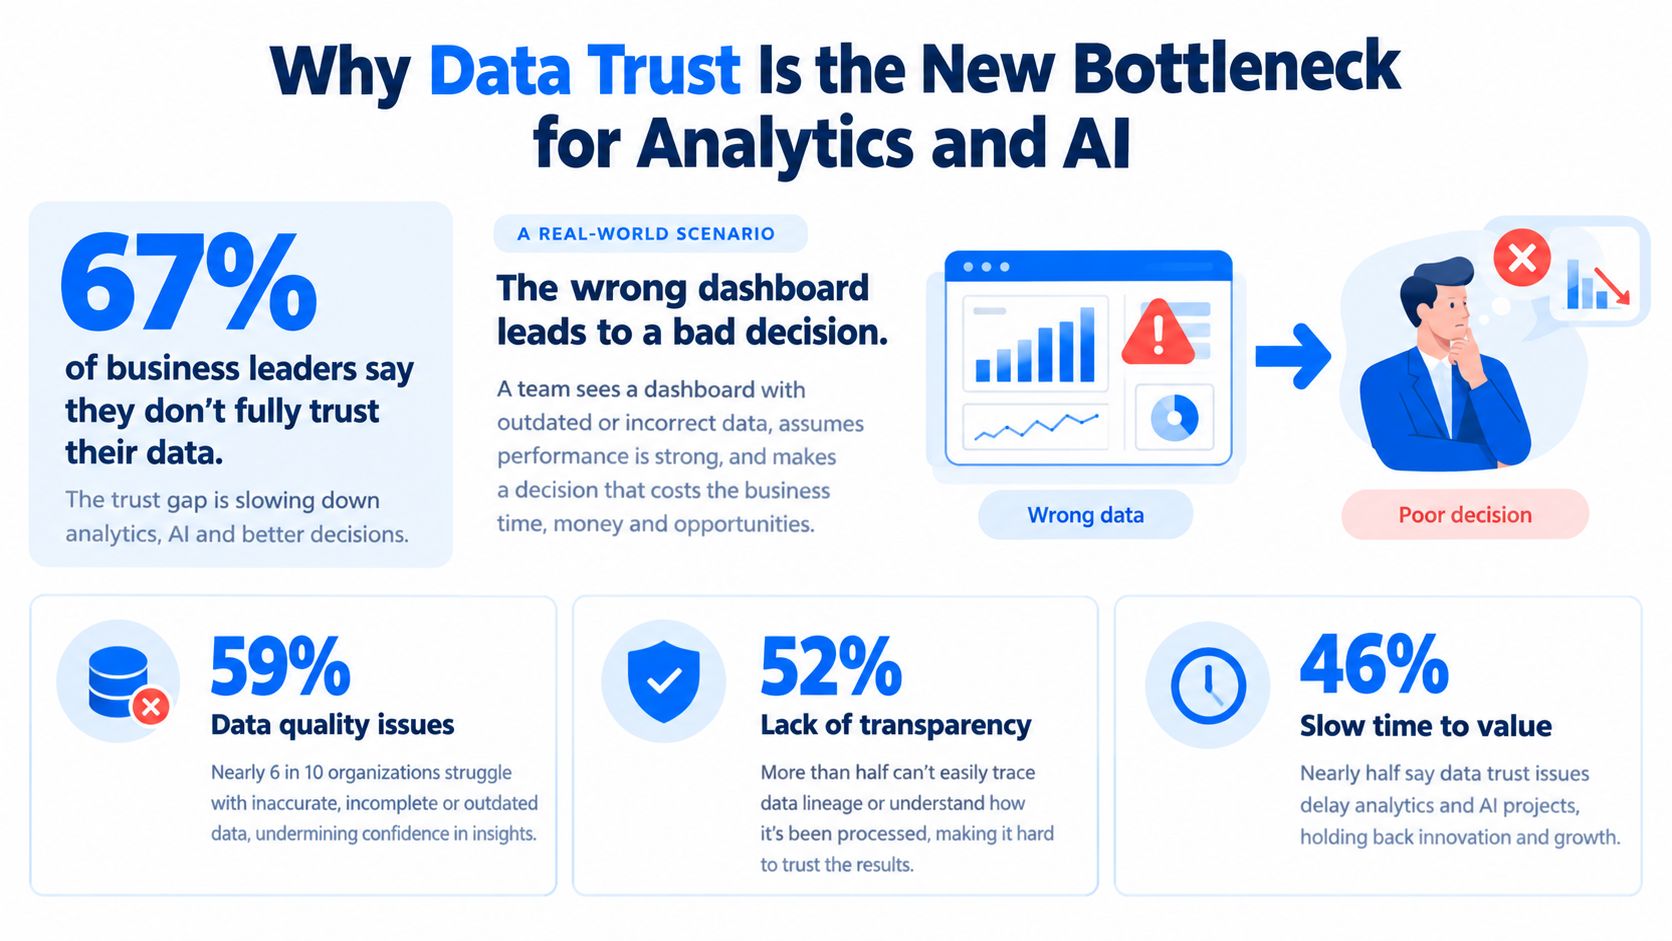
Le coût pour l'entreprise dépasse le cadre d'un simple graphique incorrect. Dans un rapport sectoriel connexe, 77 % des décideurs informatiques ont déclaré ne pas faire entièrement confiance aux données de leur organisation pour prendre des décisions critiques et opportunes, tandis que 82 % ont déclaré que les employés devaient retravailler des projets d'analyse terminés en raison d'une mauvaise qualité des données. Le même rapport de Precisely associe une faible confiance à des frictions opérationnelles, la qualité des données étant le principal obstacle pour 70 % des répondants dans les organisations ayant une faible confiance dans les données décisionnelles.
Pourquoi la confiance dans le code n'est pas la confiance dans les données
Un modèle peut passer ses tests de déploiement et continuer à produire des recommandations peu fiables si ses tables de caractéristiques ont dérivé. Une requête SQL peut être compilée avec succès tout en renvoyant moins de lignes parce qu'un processus en amont a cessé de charger une source. L'exactitude du logiciel vous indique que le code s'est exécuté comme prévu. Elle ne prouve pas que les entrées étaient complètes, opportunes, stables ou adaptées à la décision.
L'analyse de la confiance des données fournit ces preuves manquantes. Elle traite les signaux opérationnels comme faisant partie de la validité analytique, puis connecte les défaillances aux actifs affectés et aux propriétaires responsables. Les équipes qui étudient l'impact d'une mauvaise qualité des données sur les décisions commerciales peuvent utiliser cette distinction pour passer de la correction des erreurs visibles des tableaux de bord à la prévention de la transmission de résultats non fiables aux décideurs.
Ce que signifie réellement l'analyse de la confiance des données
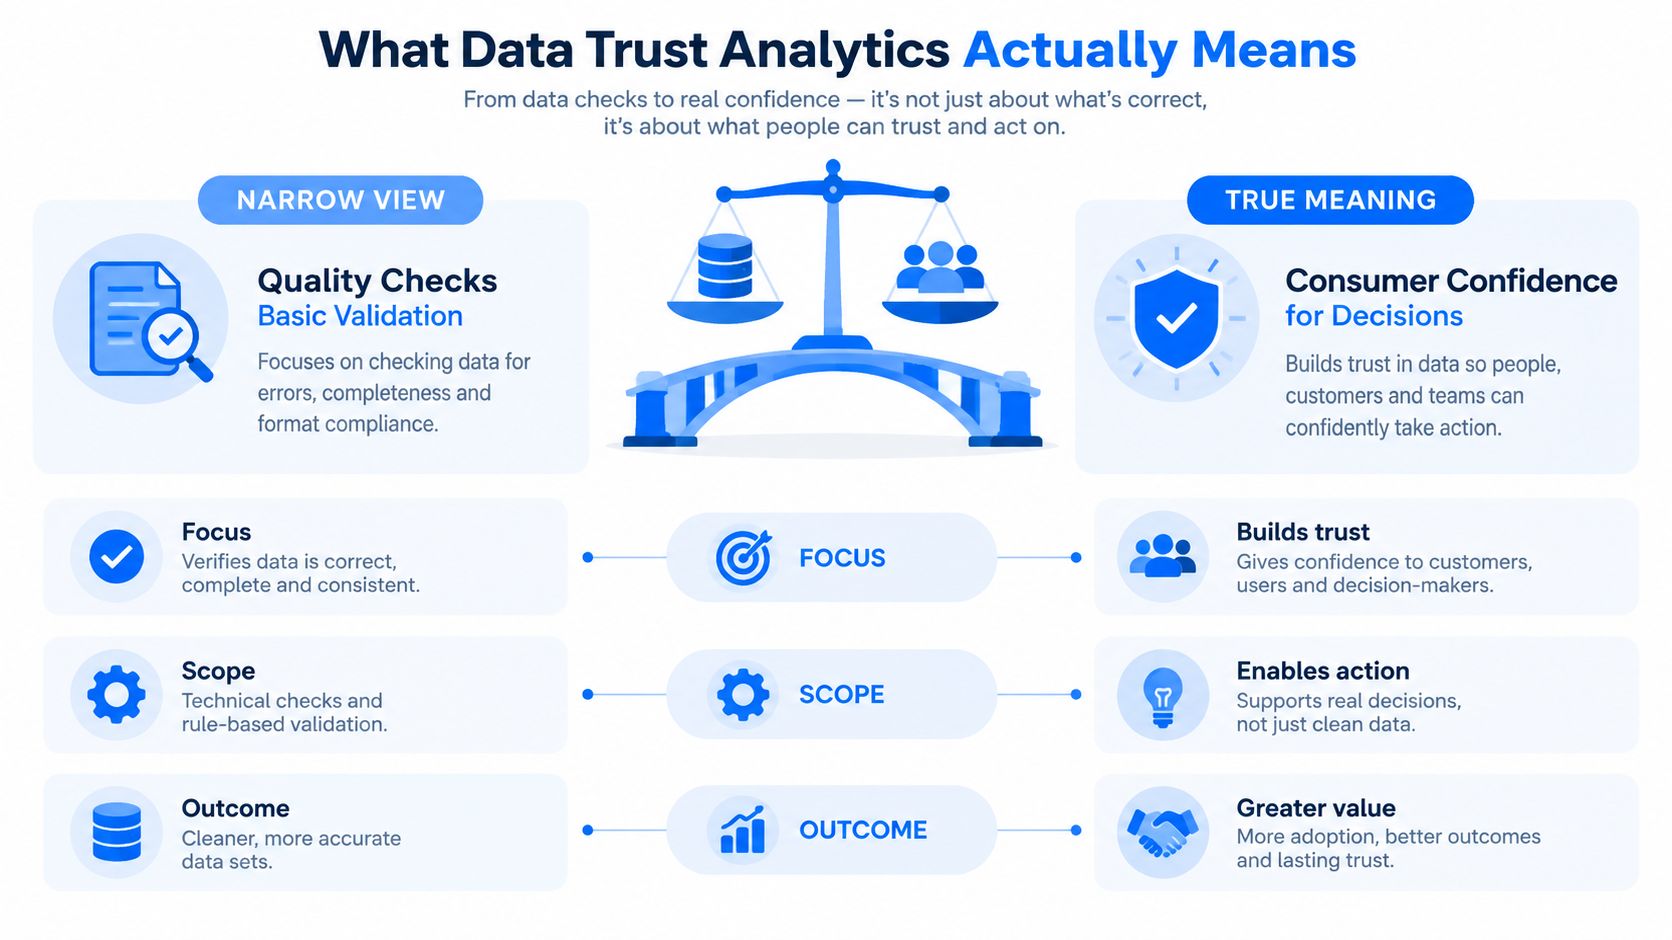
Commençons par la définition étroite. La qualité des données vérifie si les valeurs et les enregistrements satisfont à des conditions connues, comme le fait qu'un champ obligatoire soit renseigné, qu'une date se situe dans une plage autorisée ou qu'un identifiant client soit unique. Ces vérifications sont nécessaires, mais elles ne couvrent que ce que l'équipe a pensé à spécifier.
L'analyse de la confiance des données élargit la question. Elle combine les preuves de qualité avec la fraîcheur, le volume, la stabilité du schéma, le lignage, la propriété et la signification documentée. L'utilisateur des données doit non seulement savoir si une valeur semble valide, mais aussi si le jeu de données est à jour, compris, traçable et sûr pour un usage particulier.
Une distinction utile est la suivante :
La qualité des données demande : « Cette valeur est-elle conforme à la règle ? »
L'analyse de la confiance des données demande : « Un décideur baserait-il une recommandation sur ce jeu de données en ce moment même ? »
Cette deuxième question dépend du contexte. Un retard mineur peut être acceptable pour un rapport de planification mensuel, mais inacceptable pour une alerte opérationnelle. Une colonne peut être techniquement valide tout en étant sémantiquement ambiguë. Une caractéristique de modèle peut passer les contrôles de valeurs nulles tout en perdant sa connexion avec le système source qui explique sa signification.
La confiance est un signal composite
Considérez la confiance comme une conclusion tirée de plusieurs types de preuves :
Preuve opérationnelle : Les données sont-elles arrivées à l'heure prévue et le pipeline s'est-il terminé ?
Preuve statistique : Les comptages, les distributions, les moyennes et les modèles de valeurs manquantes ressemblent-ils à leur comportement habituel ?
Preuve structurelle : Les colonnes, les types de données et les relations sont-ils restés compatibles ?
Preuve contextuelle : Le but, le propriétaire, le lignage et la définition métier du jeu de données sont-ils documentés ?
Un cadre d'Observability des données rend ces signaux visibles, mais la visibilité seule n'est pas le résultat final. L'étape importante consiste à traduire les observations en un jugement de confiance pour un tableau de bord, un modèle, une métrique ou un workflow d'IA spécifique.
Les Five Pillars qui produisent des signaux de confiance
Une panne de pipeline silencieuse s'annonce rarement par une erreur rouge. Supposons qu'un processus de capture des données de changement en amont omette des lignes pendant deux jours, mais que la tâche indique toujours une réussite. Les tableaux de bord des revenus commencent à sous-déclarer, et un modèle de prévision reçoit un historique client incomplet. Chaque pilier d'observabilité révèle une partie différente de l'incident.
Les cinq piliers standards sont la fraîcheur, la qualité, le volume, le schéma et le lignage. Ils fonctionnent ensemble plutôt que comme des étiquettes interchangeables. Les dimensions de la qualité des données offrent un moyen utile de relier les vérifications individuelles à la question plus large de savoir si les données en aval restent adaptées à l'usage prévu.
La fraîcheur indique si les données sont à jour
La fraîcheur permet de savoir si un jeu de données est arrivé selon le calendrier prévu. Un chargement qui apparaît chaque matin mais rate sa fenêtre de livraison habituelle devrait réduire la confiance, même si les enregistrements déjà présents passent la validation. Le suivi de la Timeliness peut distinguer un chargement retardé d'un chargement manquant, et peut également identifier une livraison anticipée inattendue qui pourrait indiquer un problème de planification ou de partitionnement.
La qualité teste les valeurs et les règles métier
Les contrôles de qualité inspectent les taux de valeurs nulles, les doublons, les formats invalides, les relations référentielles et les contraintes métier. Dans l'exemple des lignes omises, les enregistrements restants pourraient tous avoir des ID clients valides, de sorte que la validation au niveau de l'enregistrement seule pourrait rater l'incident. La qualité devient plus informative lorsqu'elle est interprétée aux côtés du volume et du comportement historique.
Le volume détecte les échecs d'exhaustivité silencieux
Le suivi du volume compare le nombre de lignes ou d'autres indicateurs de taille avec les modèles attendus. Une réduction soudaine peut révéler un extrait partiel même lorsque le pipeline ne renvoie aucune erreur technique. Le volume n'explique pas la cause, mais il donne à l'équipe un signal précoce indiquant que l'exhaustivité du jeu de données mérite d'être étudiée.
Le schéma protège la compatibilité structurelle
Le suivi du schéma détecte les ajouts, les suppressions, les renommages et les changements de type. Une colonne renommée peut briser immédiatement une transformation en aval, ou être mappée de manière incorrecte et produire des résultats plausibles mais trompeurs. La compatibilité structurelle fait partie de la confiance car les utilisateurs dépendent à la fois des valeurs et de la forme des données.
Le lignage identifie qui et quoi est affecté
Le lignage relie la table source aux transformations, tableaux de bord, caractéristiques, modèles et métriques métier. Lorsque la perte de lignes est détectée, le lignage aide l'équipe à identifier les rapports de revenus et les prévisions qui doivent être examinés. La propriété transforme ensuite cette cartographie en action en acheminant l'incident vers les personnes responsables de la source et des produits concernés.
Aucun pilier ne peut à lui seul certifier la préparation à la décision. La confiance émerge lorsque les signaux sont corrélés, interprétés en contexte et transmis aux propriétaires responsables.
Comment les couches de détection combinent statistiques, ML et examen humain
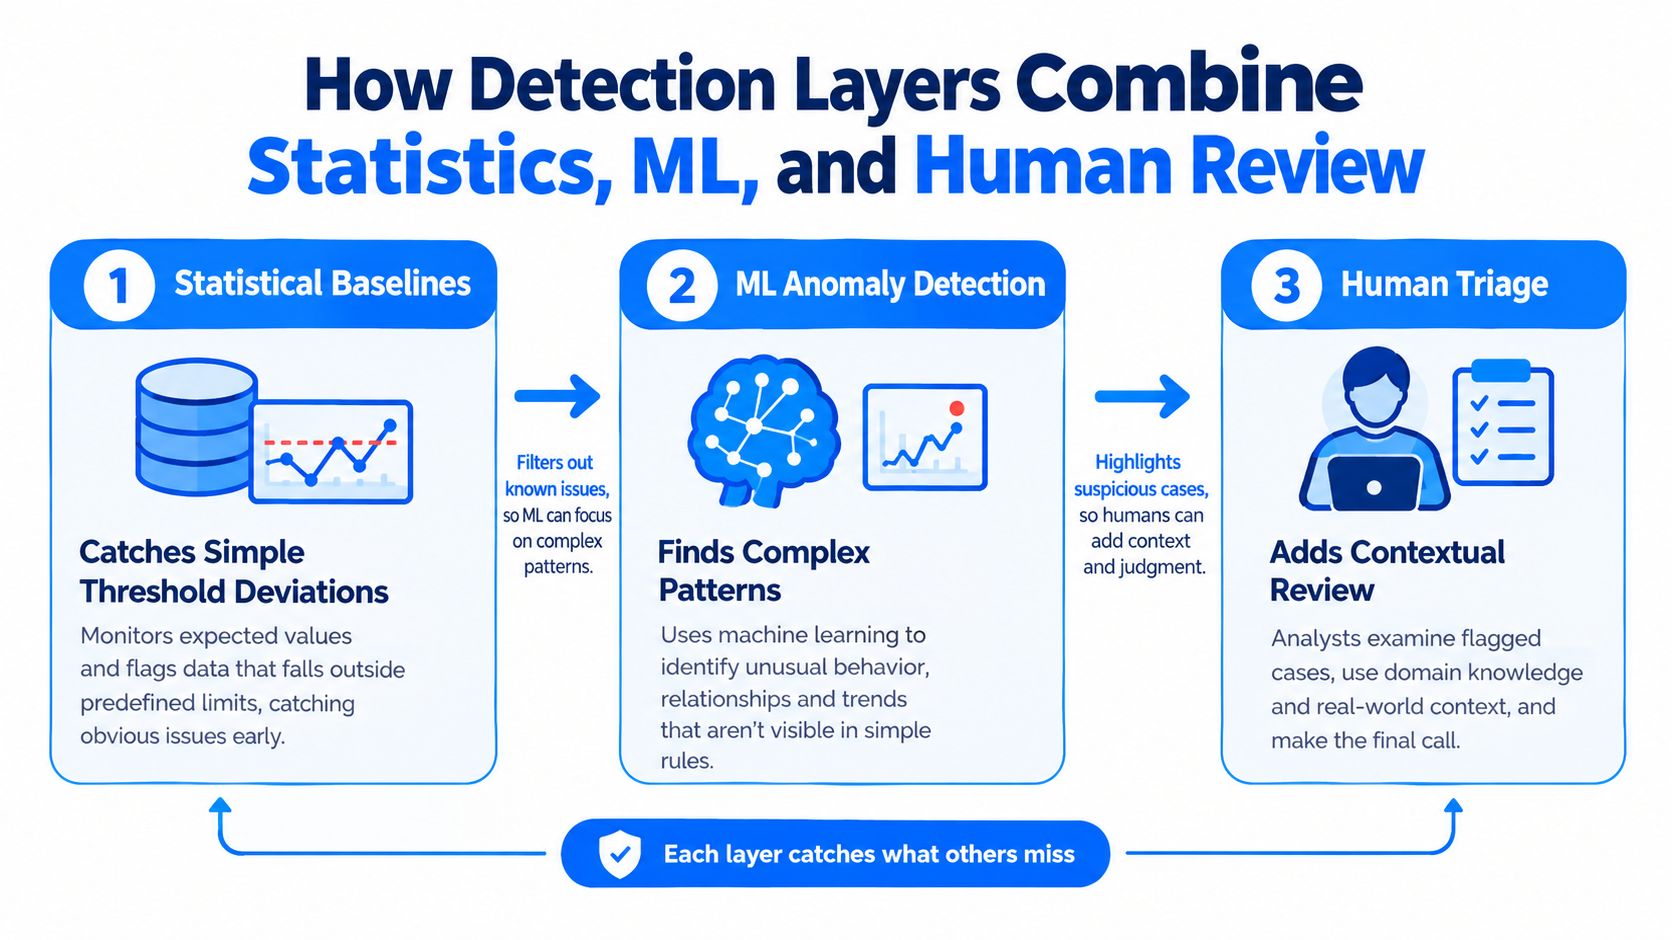
La détection fonctionne mieux sous forme de système multicouche, car chaque couche répond à une question différente. Les lignes de base statistiques détectent les défaillances évidentes à moindre coût et de manière explicable. L'apprentissage automatique identifie les comportements que les règles fixes pourraient manquer. L'examen humain fournit le contexte métier nécessaire pour décider si une alerte représente un incident, un changement planifié ou une variation inoffensive.
Commencez par des lignes de base pour la fraîcheur, le volume, les taux de valeurs nulles, les moyennes et d'autres mesures de base. Un seuil peut signaler une livraison manquante, tandis qu'une statistique mobile peut montrer un écart significatif par rapport au comportement récent. Ces contrôles sont faciles à expliquer lors de l'examen des incidents, ils restent donc utiles même après qu'une équipe a ajouté des fonctions de détection plus avancées.
Où l'apprentissage automatique apporte de la valeur
Les règles statiques deviennent moins fiables lorsque les données suivent des modèles saisonniers, hebdomadaires, de cycle de Release ou de segments de clientèle. Une distribution apprise ou un modèle saisonnier peut identifier un modèle inhabituel qui reste dans les limites d'un large seuil fixe, une approche basée sur la reconnaissance de formes statistiques. Un pipeline peut passer sa règle de nombre minimal de lignes tout en produisant une distribution qui diffère considérablement de son profil établi.
Pour les données opérationnelles à volume élevé, les recherches de l'Université d'Amsterdam décrivent une approche non supervisée basée sur le consensus qui combine plusieurs modèles, des règles empiriques, un réglage itératif des hyperparamètres et un expert du domaine dans la boucle. La méthode de l'étude soutient un principe de conception pratique : aucun détecteur unique ne doit être responsable de tous les types d'anomalies.
Pourquoi les humains font toujours partie du système
Un pipeline peut passer des contrôles fixes de fraîcheur et de volume tout en déclenchant un modèle appris parce qu'une métrique clé baisse d'une manière inhabituelle. Un analyste vérifie le calendrier de déploiement et confirme qu'une promotion planifiée a causé ce changement. Le fait de marquer l'événement comme prévu évite que des alertes similaires ne se transforment en bruit récurrent et donne un meilleur contexte au processus de détection.
Un autre cadre de qualité des données recommande de profiler chaque lot arrivant, de conserver les profils historiques et d'alimenter les modèles d'anomalies avec les séries temporelles qui en résultent. L'approche de profilage citée traite la dérive comme une séquence mesurable plutôt que comme une inspection ponctuelle.
Règle pratique : Utilisez des règles pour les modes de défaillance connus, des modèles pour les comportements changeants et des humains pour le contexte métier.
Des métriques qui transforment la confiance en quelque chose que vous pouvez mesurer
La confiance devient gérable lorsque les équipes l'expriment à travers des métriques qu'elles peuvent signaler, sur lesquelles elles peuvent alerter et qu'elles peuvent améliorer. Un tableau de bord qui indique « les données semblent saines » est difficile à défendre. Une fiche d'évaluation qui montre les performances de fraîcheur, les anomalies non résolues, le temps de récupération du schéma et la couverture du lignage donne aux ingénieurs et aux parties prenantes un langage opérationnel commun.
Les métriques ci-dessous sont des points de départ, pas des cibles universelles. Un jeu de données de paiement critique devrait avoir des exigences plus strictes qu'une table exploratoire. Définissez la référence avec les propriétaires et les utilisateurs qui comprennent les conséquences d'un échec.
Métrique | Définition | Indicateur de référence | Pilier source |
|---|---|---|---|
SLO de fraîcheur | Part des mises à jour attendues livrées dans le respect de la cadence convenue | Définie par l'utilisation décisionnelle du jeu de données et l'attente de livraison | Freshness |
Taux d'anomalie | Événements anormaux détectés par rapport à la population de tables surveillées et à la période d'observation | Assez bas pour maintenir l'attention, avec les incidents confirmés suivis séparément des événements acceptés | Qualité, volume, fraîcheur |
MTTR des changements de schéma | Temps moyen de résolution à partir d'un changement de schéma non autorisé ou incompatible | Assez court pour protéger la publication en aval et l'utilisation du modèle | Schema |
Couverture du lignage | Part des actifs en aval connectés à une source en amont détenue et surveillée | Couverture complète pour les rapports, fonctionnalités et modèles critiques | Lineage |
Lire les métriques ensemble
Un excellent résultat de fraîcheur ne compense pas un mauvais lignage. Un faible taux d'anomalies peut signifier des données stables, ou simplement que le détecteur est trop conservateur. Le MTTR des modifications de schéma peut sembler correct alors que les équipes restent incapables d'identifier tous les tableaux de bord affectés.
Pour cette raison, publiez le contexte de la métrique avec le chiffre lui-même. Enregistrez l'ensemble des actifs surveillés, l'utilisation décisionnelle, les exclusions, les anomalies acceptées et le statut de propriété. Un guide pour mesurer la fiabilité peut aider les équipes à transformer les observations opérationnelles en une discussion sur la fiabilité que les parties prenantes de l'entreprise comprennent.
Ajouter le contexte de décision
Chaque fiche d'évaluation doit répondre à trois questions :
Qu'est-ce qui a été mesuré ? Nommez la table, l'ensemble de caractéristiques, la métrique ou l'entrée du modèle.
Qu'est-ce qui a changé ? Afficher le signal actuel par rapport à sa ligne de base historique et à l'attente convenue.
Quelle action s'ensuit ? Identifier le propriétaire, le chemin d'escalade et la décision de publication ou d'inférence.
Cette structure évite que les équipes ne traitent la confiance comme une simple étiquette décorative sur un tableau de bord. Elle rend la confiance vérifiable.
De l'Observability à la préparation à la décision pour l'IA
L'Observability produit des preuves, mais elle n'indique pas automatiquement au propriétaire d'un modèle si un système d'IA doit fonctionner aujourd'hui. Une plateforme peut afficher une exécution de pipeline saine alors que les données de caractéristiques restent difficiles à tracer, inhabituellement distribuées ou affectées par des anomalies non résolues.
Cet écart est mesurable dans le sentiment des entreprises. 58 % des organisations ont déclaré avoir mis en œuvre ou optimisé des programmes de Data Observability, pourtant 42 % ne faisaient toujours pas confiance aux résultats de leurs modèles d'IA ou d'apprentissage automatique, selon des rapports récents sur la confiance dans l'IA en entreprise. L'Observability peut donc coexister avec la méfiance lorsque les équipes surveillent l'infrastructure sans prouver que les entrées en aval sont prêtes pour la décision.
Créer des tableaux de bord autour des résultats
Une fiche d'évaluation de la confiance doit lier les preuves à un utilisateur spécifique. Par exemple, une table de caractéristiques peut afficher une fraîcheur acceptable mais seulement 60 % de couverture de lignage et trois anomalies non résolues. Ces chiffres sont des valeurs de scénario, pas des références générales, mais ils illustrent pourquoi un statut de pipeline vert générique peut être trompeur.
Le processus de promotion du modèle peut appliquer des barrières explicites :
Barrière de fraîcheur : Les entrées requises sont arrivées dans les fenêtres attendues.
Barrière de qualité : Les règles de validation critiques ont été validées, les exceptions étant documentées.
Barrière de schéma : Aucun changement structurel incompatible ne reste non résolu.
Barrière de lignage : Le propriétaire du modèle peut tracer les caractéristiques critiques jusqu'aux sources surveillées.
Barrière d'incident : Les anomalies ouvertes ont un propriétaire désigné et une décision documentée.
Une fiche d'évaluation ne doit pas masquer l'incertitude derrière un chiffre composite unique. Elle doit présenter les preuves qui sous-tendent la décision, l'approbation du propriétaire des risques et les conditions dans lesquelles le résultat doit être retenu ou examiné.
Ces preuves peuvent également figurer dans la documentation du modèle. Les dirigeants, les régulateurs, les analystes et les ingénieurs ont besoin de plus qu'une simple métrique de modèle. Ils ont besoin d'une explication défendable indiquant si les données étayant le résultat étaient à jour, stables, validées et traçables au moment de l'utilisation.
Exploiter la confiance dans les limites de l'entreprise
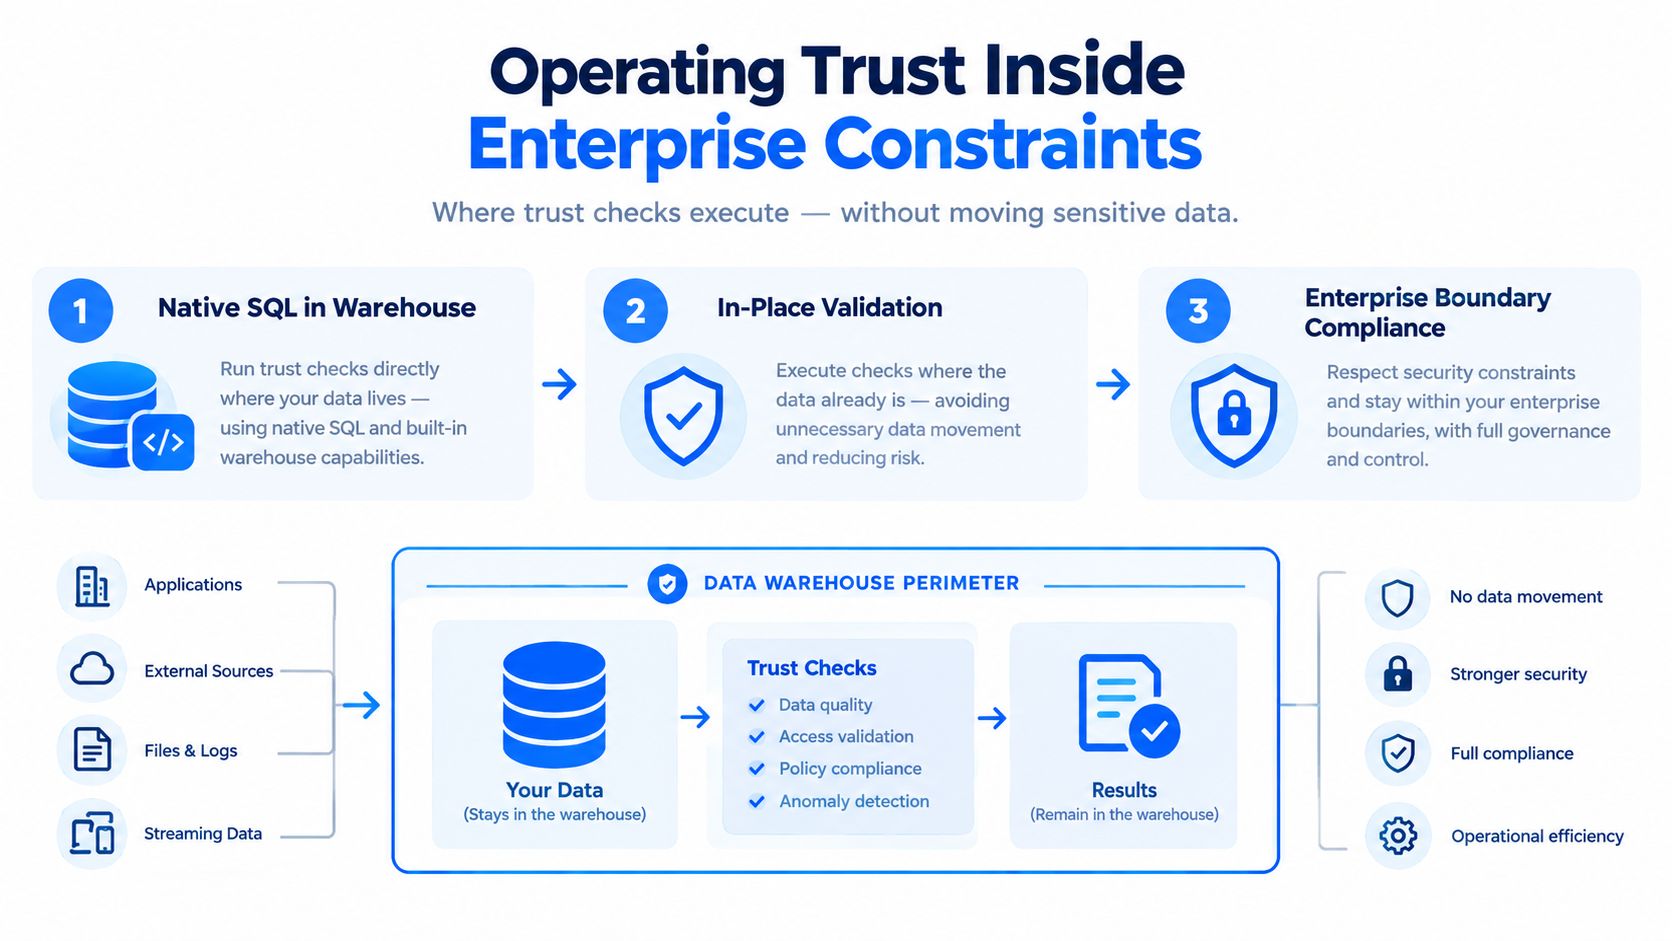
Les contrôles de confiance doivent s'intégrer dans l'environnement où résident déjà les données sensibles. Déplacer les enregistrements de production vers un service de surveillance distinct peut poser des problèmes de confidentialité, de résidence des données, de contrôle d'accès, de chiffrement et de réseau. Cela peut également compliquer le modèle de propriété en séparant les preuves du système qui contient les données.
Une architecture pratique sépare souvent l'exécution de la coordination. Des contrôles SQL natifs ou natifs de la base de données peuvent calculer le nombre de lignes, les contraintes, les indicateurs de fraîcheur et les résultats de validation là où résident les données. Un service centralisé peut ensuite gérer les politiques, les alertes, l'acheminement des incidents et les fiches d'évaluation à l'aide des métadonnées nécessaires plutôt que de copies des enregistrements sous-jacents.
Maintenir le plan de contrôle proportionnel
Le bon modèle de déploiement dépend des frontières de l'organisation. Une installation sur un cloud privé ou sur site peut convenir aux équipes qui ne peuvent pas déplacer les données de production en dehors de leur environnement. digna précise que sa plateforme s'exécute dans le cloud privé ou l'infrastructure sur site du client, les contrôles de qualité des données et la logique de détection des anomalies s'exécutant au sein du moteur de base de données du client. Sa documentation décrit ce modèle in situ.
La conception opérationnelle doit également tenir compte des frictions d'adoption. Des données d'enquête récentes ont révélé que 61 % des équipes s'appuyaient encore sur des contrôles manuels ou des validations basées sur SQL, 27 % utilisent une plateforme d'Observability dédiée et seulement 14 % appliquent des accords de niveau de service à l'échelle de l'organisation, tandis que 39 % les suivent. Le rapport d'Integrate.io montre pourquoi la mise en œuvre doit respecter les flux de travail existants plutôt que de supposer que chaque équipe peut remplacer ses pratiques de validation d'un seul coup.
Attribuer la propriété avant d'ajouter des alertes
Le même rapport a révélé que la propriété de la qualité des données était partagée entre plusieurs équipes pour 44 % des répondants, et que la visibilité limitée sur la santé du pipeline était le principal défi pour 31 % d'entre eux. La responsabilité partagée peut fonctionner, mais seulement si quelqu'un est propriétaire de la décision d'enquêter, de publier, de supprimer ou de restaurer un résultat.
Priorisez les contrôles par :
Impact sur les décisions : Surveillez d'abord les actifs qui influencent les décisions financières, réglementaires, cliniques, opérationnelles ou clients.
Sensibilité des données : Minimisez les métadonnées conservées et alignez l'accès sur les autorisations existantes.
Coût des défaillances : Acheminez les alertes à fortes conséquences via les canaux d'incidents établis.
Adéquation opérationnelle : Testez les contrôles lors d'ingestions retardées, de dépendances dégradées et de changements de schéma.
N'achetez pas une promesse à l'échelle de la plateforme avant d'avoir prouvé le workflow sur un domaine critique. L'adoption modulaire permet aux équipes de valider la qualité du signal, la propriété des alertes et le coût opérationnel avant d'étendre la couverture.
Construire un modèle opérationnel de confiance qui tient la route
Un programme de confiance durable est un système opérationnel en boucle fermée, et non une collection d'alertes de surveillance. Les équipes définissent des objectifs de niveau de service pour la fraîcheur, l'exhaustivité, la validité, la compatibilité des schémas et la couverture du lignage, puis connectent ces objectifs à des propriétaires désignés, des chemins d'escalade et des seuils d'impact commercial.
La politique de réponse importe tout autant que la détection. Un contrôle échoué peut bloquer la publication en aval ou l'inférence de l'IA, mais seulement lorsque des contrôles documentés justifient l'interruption. Dans d'autres cas, l'organisation peut conserver le dernier résultat fiable connu, marquer la sortie comme obsolète et accorder au propriétaire un délai défini pour résoudre le problème.
Transformer les incidents en connaissances institutionnelles
Pour chaque incident matériel, enregistrez :
La cause : Qu'est-ce qui a changé dans la source, la transformation, le calendrier, le schéma ou le chemin d'accès ?
L'impact : Quelles tables, métriques, tableaux de bord, caractéristiques, modèles et décisions ont été affectés ?
La réponse : Qui a enquêté, quelle action a été prise et à quelle vitesse le service a-t-il été rétabli ?
La preuve : Quels résultats de validation et de surveillance ont confirmé que les données pouvaient à nouveau être utilisées en toute sécurité ?
Après la récupération, réintégrez ces résultats dans les règles de validation, la configuration de base, les cartes de propriété, les politiques d'accès et les backlogs d'ingénierie. Un échec de ponctualité récurrent peut nécessiter une refonte du calendrier. Un problème de schéma répété peut exiger des contrats de compatibilité. Une ambiguïté répétée autour d'une métrique peut nécessiter une définition sémantique plus forte.
Examiner la confiance comme une pratique transversale
L'ingénierie des données, l'analytique, la governance, la sécurité et les parties prenantes de l'entreprise doivent examiner les fiches d'évaluation ensemble. Chaque groupe perçoit un mode de défaillance différent. Les ingénieurs comprennent le comportement des pipelines, les analystes comprennent l'interprétation, la sécurité comprend l'exposition, la governance comprend la responsabilité et les propriétaires d'entreprise comprennent les conséquences des décisions.
Cette discipline soutient les efforts plus larges visant à libérer de la valeur commerciale grâce aux données car des données fiables deviennent une capacité opérationnelle plutôt qu'un sous-produit non examiné. Le but n'est pas d'éliminer toutes les anomalies. Il s'agit de créer des preuves répétées que l'organisation connaît ses données, sait qui en est propriétaire, sait de quelles décisions elles dépendent et sait comment récupérer lorsque les conditions changent.
La confiance se gagne lorsque les mêmes preuves soutiennent la même décision, que ce soit un jour ordinaire ou un jour d'incident.
digna fournit des fonctionnalités in situ de qualité des données et d'Observability pour surveiller les anomalies, la ponctualité, la validation, les modifications de schéma et le comportement historique des données sans déplacer les données de production hors de l'environnement du client. Visitez digna pour voir comment son approche modulaire peut connecter les signaux opérationnels avec la préparation à la décision pour l'analytique et l'IA.


