La détection d'anomalies sur les données catégorielles expliquée
|
7
minute de lecture

Vous connaissez déjà ce scénario d'échec. Le tableau de bord est calme, les contrôles numériques sont satisfaisants, et le modèle qui fonctionnait parfaitement la semaine dernière commence à produire des résultats absurdes parce qu'un champ catégoriel a changé sans que personne ne le remarque. Un nouveau code de statut apparaît, une catégorie de produits est remappée, ou un fournisseur commence à envoyer un libellé de pays différent, et la défaillance n'apparaît qu'une fois que le système en aval a déjà pris de mauvaises décisions.
C'est pourquoi la détection d'anomalies sur les données catégorielles nécessite sa propre méthodologie. Dans les espaces catégoriels, le signal réside généralement dans les valeurs rares, les combinaisons inattendues et les variations de fréquences conjointes, et non dans l'écart par rapport à une moyenne ou dans un fort saut numérique. L'enjeu pratique consiste à détecter ces changements suffisamment tôt pour que les data engineers, les analystes et les responsables de modèles puissent agir avant que la confiance ne s'érode.
Table des matières
Pourquoi les algorithmes standard échouent sur les variables catégorielles
Gérer les variables à forte cardinalité et la dérive de schéma
Construire un processus de surveillance prêt pour la production
Les risques cachés des variations de données catégorielles
Les pires incidents commencent rarement par une défaillance bruyante. Un pipeline continue de tourner, le nombre de lignes semble normal, et la seule chose qui a changé est un libellé que personne n'avait pensé à surveiller. Puis un modèle commence à classer les clients de manière étrange, parce que la répartition des catégories qu'il a apprise ne correspond plus à la réalité de la production.
Les anomalies catégorielles diffèrent des valeurs aberrantes numériques. Une anomalie numérique peut être une valeur très éloignée de la moyenne, alors qu'une anomalie catégorielle est souvent une modalité, ou une combinaison de modalités sur plusieurs champs, qui apparaît avec une fréquence inhabituellement faible par rapport à la population de référence. C'est pourquoi la catégorie elle-même compte moins que la fréquence à laquelle elle apparaît et la manière dont elle co-occurre avec d'autres champs, ce qui constitue la logique centrale décrite dans la littérature sur la détection d'anomalies catégorielles consacrée aux tables de contingence creuses et à la rareté des valeurs conjointes chapitre Springer sur la détection d'anomalies catégorielles.
Une défaillance en production commence généralement par un petit changement de libellé
Une équipe financière peut constater le même volume de transactions alors qu'un code de statut de paiement change de forme, et que les règles en aval ne correspondent plus au processus sous-jacent. Une équipe du secteur de la santé peut continuer à recevoir des demandes de remboursement d'apparence valide, alors qu'un champ commence à contenir une nouvelle valeur codée que l'ancienne logique de validation n'a jamais apprise. Dans les deux cas, les chiffres restent stables suffisamment longtemps pour masquer le problème.
C'est pourquoi les équipes doivent considérer les changements catégoriels comme un signal de premier plan. Une distribution de catégories peut dériver sans qu'aucun champ ne paraisse extrême à lui seul, et un schéma conjoint peut être anormal même lorsque chaque champ pris individuellement semble normal. Le risque pratique est qu'un simple tableau de bord donne une fausse impression de stabilité.
Pour un exemple concret du problème de surveillance plus large, les schémas de dérive des données présentés dans la présentation de digna sur la détection de la dérive des données s'inscrivent directement dans cette approche des variations de catégories. La leçon opérationnelle est simple : si l'espace des libellés change, le monde du modèle change aussi.
Règle pratique : si un champ catégoriel peut changer de signification métier sans modifier le volume de lignes, il doit faire partie de vos contrôles d'anomalies.
Pourquoi les algorithmes standard échouent sur les variables catégorielles
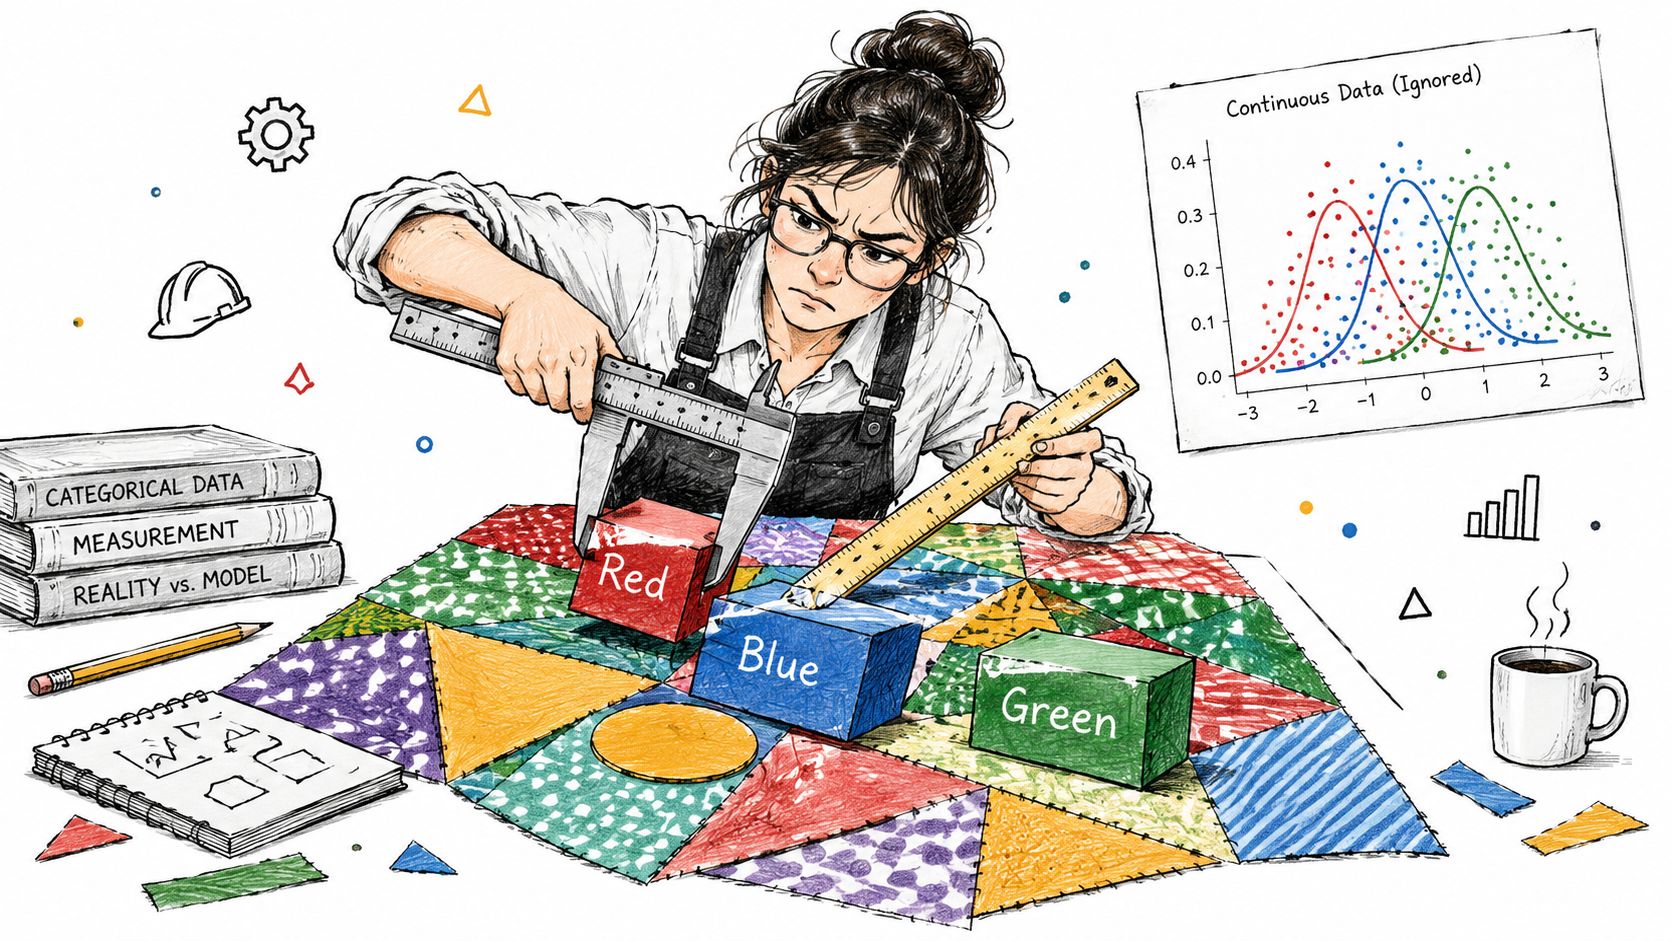
La plupart des outils de détection d'anomalies numériques supposent une géométrie que les données catégorielles ne possèdent pas. La distance euclidienne fonctionne pour des points dans un espace continu, mais un code pays, un type de transaction ou un statut de demande de remboursement n'est ni « proche » ni « éloigné » dans un sens ordinal pertinent. Traiter des libellés comme des coordonnées transforme un problème discret en un faux problème numérique.
Ce décalage pèse surtout lorsque la cardinalité est élevée. À mesure que les variables catégorielles gagnent en granularité, les tables de contingence deviennent creuses, et le signal utile se déplace vers des intersections rares plutôt que vers de grandes amplitudes. La littérature de référence souligne que les méthodes classiques de détection d'anomalies supposent souvent des données continues, c'est pourquoi les variables catégorielles sont fréquemment converties en attributs continus avant la détection, alors même que cette conversion peut effacer précisément la structure que vous devez examiner revue CEUR des méthodes de détection d'anomalies.
C'est dans les tables de contingence creuses que les anomalies passent inaperçues
Un code pays seul peut sembler ordinaire. Un type de paiement seul peut sembler ordinaire. Une catégorie d'appareil seule peut sembler ordinaire. Mais la combinaison de ces trois champs peut être suffisamment rare pour mériter l'attention, et les méthodes fondées sur la distance numérique passent souvent à côté, car elles se concentrent sur l'amplitude plutôt que sur la co-occurrence.
C'est pourquoi les variables catégorielles à forte cardinalité posent problème. L'encodage one-hot peut faire exploser la dimensionnalité, les seuils fondés sur l'écart type perdent leur sens, et les Z-scores ne vous disent pas si un nouveau code est inhabituel ou simplement nouveau. En pratique, les équipes ont besoin de méthodes qui évaluent la rareté, comparent les distributions et respectent la nature discrète des données.
Un meilleur modèle mental part de la fréquence, pas de la distance
Raisonnez en termes de support des catégories, de fréquence conditionnelle et d'effectifs observés par rapport aux effectifs attendus. Si une modalité est courante dans les données historiques mais disparaît soudainement, cela peut être significatif. Si une modalité rare devient soudainement dominante, cela peut l'être aussi. La méthode doit refléter cette logique au lieu d'imposer aux données une forme géométrique qu'elles n'ont jamais eue.
La reconnaissance de formes statistique appliquée aux champs catégoriels est la bonne grille de lecture, car elle traite les libellés comme des libellés, et non comme des nombres déguisés. C'est toute la différence entre un pipeline qui signale de véritables variations de catégories et un pipeline qui ne produit que du bruit mathématique.
Référentiels statistiques et scoring par fréquence
Commencez par un référentiel qui reflète ce à quoi ressemble la normalité pour chaque champ catégoriel. Pour une colonne stable, ce référentiel correspond généralement à la distribution historique des fréquences de chaque modalité, complétée par les fréquences conjointes importantes pour le processus métier. Si les données sont saisonnières ou dépendent des processus, comparez des éléments comparables au lieu de supposer qu'un référentiel global unique convient à tout.
Comparer les effectifs observés aux effectifs attendus
Le test du khi-deux est une méthode standard pour comparer les fréquences de catégories observées à une distribution de référence afin de détecter une dérive catégorielle, et le guide sur la dérive des données en streaming le présente comme adapté aux variations de champs tels que les codes de statut ou les catégories de produits guide de Conduktor sur la dérive des données. Le PSI est également utile pour traduire un changement de distribution en niveau de gravité opérationnel. Le même guide indique des seuils de PSI inférieurs à 0,1 pour une dérive minimale, de 0,1 à 0,25 pour une dérive modérée nécessitant une investigation, et supérieurs à 0,25 pour une dérive significative nécessitant une action immédiate.
Valeur du PSI | Gravité de la dérive | Action recommandée |
|---|---|---|
Inférieure à 0,1 | Dérive minimale | Surveiller et maintenir le référentiel actif |
De 0,1 à 0,25 | Dérive modérée | Examiner la source de la catégorie et l'impact en aval |
Supérieure à 0,25 | Dérive significative | Traiter comme une urgence et examiner les changements de pipeline ou métier |
Utiliser l'entropie pour évaluer rapidement l'imprévisibilité
L'entropie est utile, car elle indique dans quelle mesure une distribution de catégories est dispersée. Une entropie faible signifie que les données sont concentrées sur quelques modalités. Une entropie plus élevée signifie que la distribution est plus hétérogène, ce qui peut révéler une nouvelle source, un changement métier plus large ou une intégration en amont désordonnée.
L'entropie ne constitue pas pour autant un détecteur complet à elle seule. C'est un signal de profilage, pas un verdict. Utilisez-la pour repérer le moment où un champ catégoriel devient plus ou moins prévisible, puis confirmez avec des contrôles fondés sur les effectifs ou un scoring des fréquences conjointes.
Pour les équipes qui ont besoin d'une méthode structurée pour relier le profilage à la détection, les techniques de profilage des données fournissent le contexte adéquat. Et si vous recherchez une explication claire de la manière dont la significativité statistique vous aide à déterminer si une variation mérite une action, le guide sur la significativité destiné aux responsables de la croissance est une lecture complémentaire utile.
Garder un processus suffisamment simple pour être exploité
Profilez d'abord la colonne. Établissez les effectifs par catégorie, le taux de valeurs nulles et une vue top-k des modalités les plus fréquentes.
Comparez à un référentiel. Utilisez le khi-deux ou le PSI lorsque la question porte sur une variation de distribution.
Vérifiez les schémas conjoints. Si la distribution marginale semble correcte, examinez les combinaisons entre champs.
Escaladez selon la gravité. Une faible variation peut être surveillée, mais une variation importante nécessite un examen humain.
L'objectif n'est pas de remplacer le machine learning. L'objectif est d'éviter de se lancer d'emblée dans la complexité avant que les tests statistiques les plus simples n'aient fait leur travail.
Adaptations du machine learning aux distributions complexes
Certains problèmes catégoriels sont trop complexes pour de simples contrôles de fréquence. Ils impliquent de nombreux champs, des règles métier changeantes et des interactions qui apparaissent dans des combinaisons de catégories plutôt qu'au sein d'une seule colonne. Dans les pipelines de production, cela signifie généralement que vous avez besoin de modèles capables d'apprendre la structure de données creuses à forte cardinalité sans masquer les problèmes opérationnels sous-jacents.
Les embeddings aident lorsque la cardinalité devient ingérable
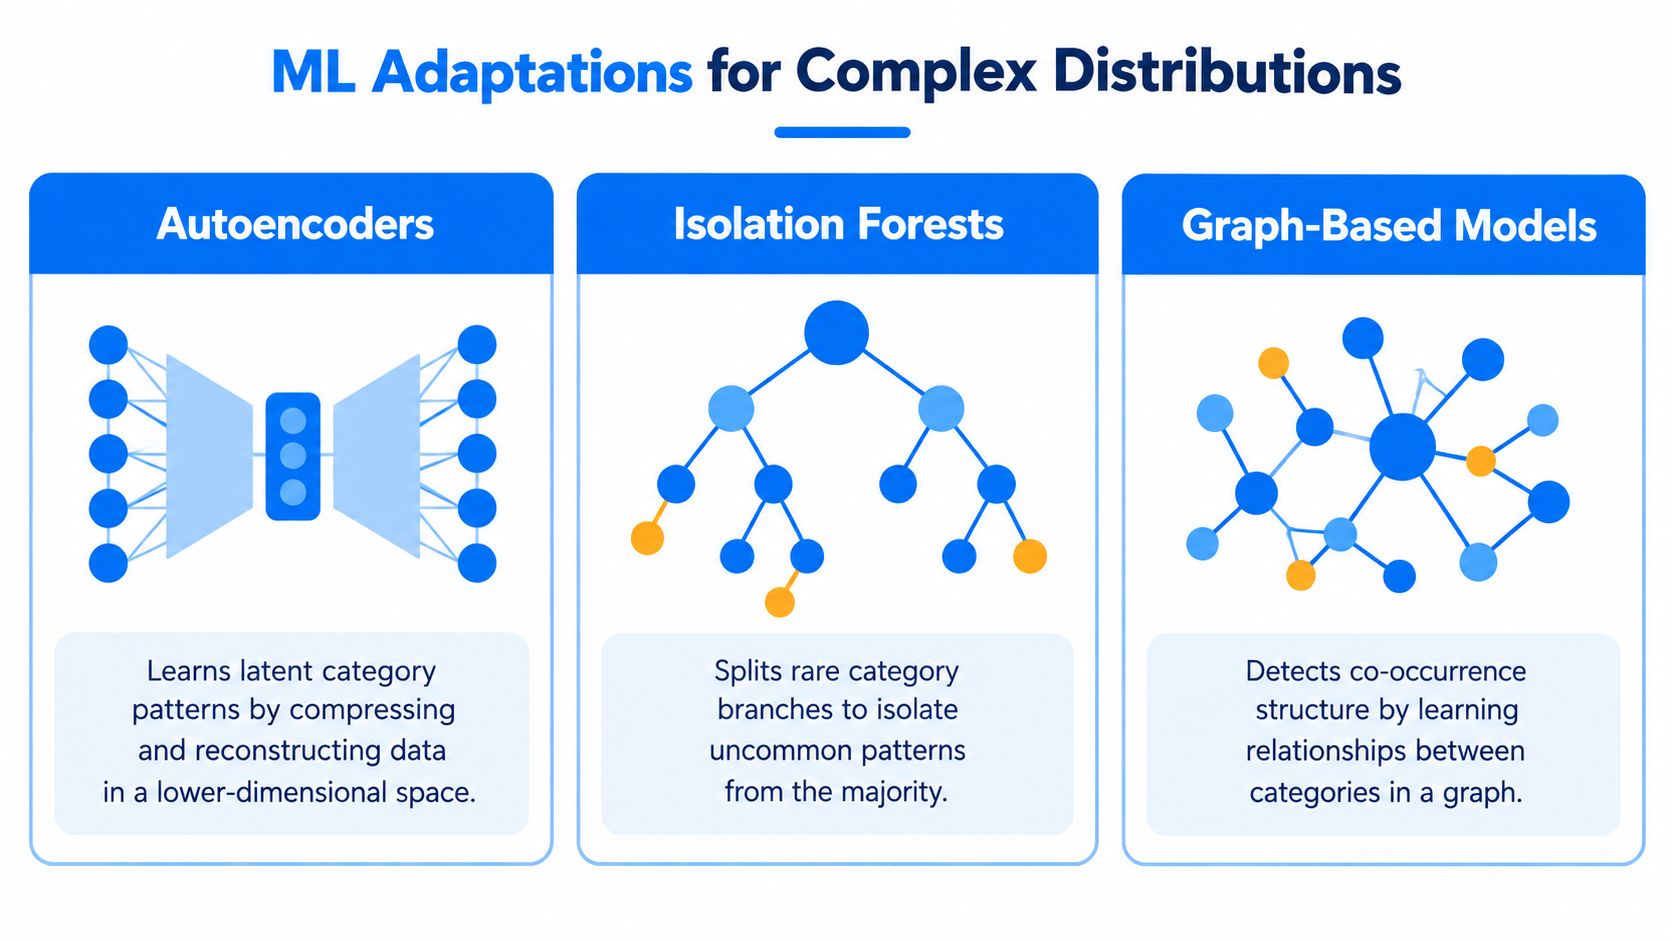
Les embeddings catégoriels projettent les modalités à forte cardinalité dans des représentations denses exploitables par d'autres détecteurs. Les équipes peuvent ainsi intégrer la structure des catégories dans des autoencodeurs, des isolation forests ou des modèles similaires, une fois les libellés bruts transformés en un espace latent appris. Une étude sur l'assurance santé citée dans la littérature récente a explicitement utilisé des embeddings catégoriels pour les variables à forte cardinalité, des détecteurs non supervisés et SHAP dans un processus jamais utilisé auparavant dans ce contexte, ce qui montre à quel point ce champ de conception reste actif étude PubMed sur les variables catégorielles à forte cardinalité.
La question pratique n'est pas de savoir si les embeddings sont élégants. Elle est de savoir s'ils préservent les signaux catégoriels que l'encodage one-hot perd dans les espaces de variables creux.
Comparer les familles de modèles courantes
Les autoencodeurs fonctionnent bien lorsque les catégories suivent des schémas latents stables et que vous souhaitez que l'erreur de reconstruction fasse ressortir les anomalies.
Les Isolation Forests sont utiles dès que les embeddings ou le feature hashing leur fournissent une surface numérique sur laquelle effectuer des partitions.
Les modèles à base de graphes prennent tout leur intérêt lorsque la structure de co-occurrence porte plus de signal qu'un champ isolé.
Les jeux de données catégorielles réels ne sont pas des exemples d'école. Le dépôt ADBenchmarks recense 14 jeux de données catégorielles largement utilisés, dont Census avec 299 285 lignes et CoverType avec 581 012 lignes, ce qui rappelle utilement que les méthodes doivent passer à l'échelle tant en dimensionnalité qu'en taille d'échantillon dépôt de jeux de données catégorielles ADBenchmarks. Ce benchmark montre également que les performances peuvent varier fortement d'un jeu de données complexe à l'autre.
Choisir le modèle en fonction du mode de défaillance
Si le problème se résume à quelques variations de catégories évidentes, commencez par des tests statistiques. Si l'enjeu est une structure subtile de valeurs conjointes, utilisez un modèle qui apprend les interactions. Si le champ est très vaste et creux, les embeddings peuvent faire le lien entre les catégories brutes et une détection exploitable. Pour un point de départ pratique, consultez ce guide sur la détection d'anomalies dans les données avec Python.
Gérer les variables à forte cardinalité et la dérive de schéma
Une table clients peut sembler stable pendant des mois, puis un nouveau code de région, un nouveau code produit ou un nouveau système source commence à remplir la même colonne avec des valeurs que votre référentiel n'a jamais vues. C'est là que la surveillance des variables à forte cardinalité se complique, car l'espace des catégories est creux et le schéma qui l'entoure change souvent en même temps.
Traiter la structure et la distribution comme des contrôles distincts
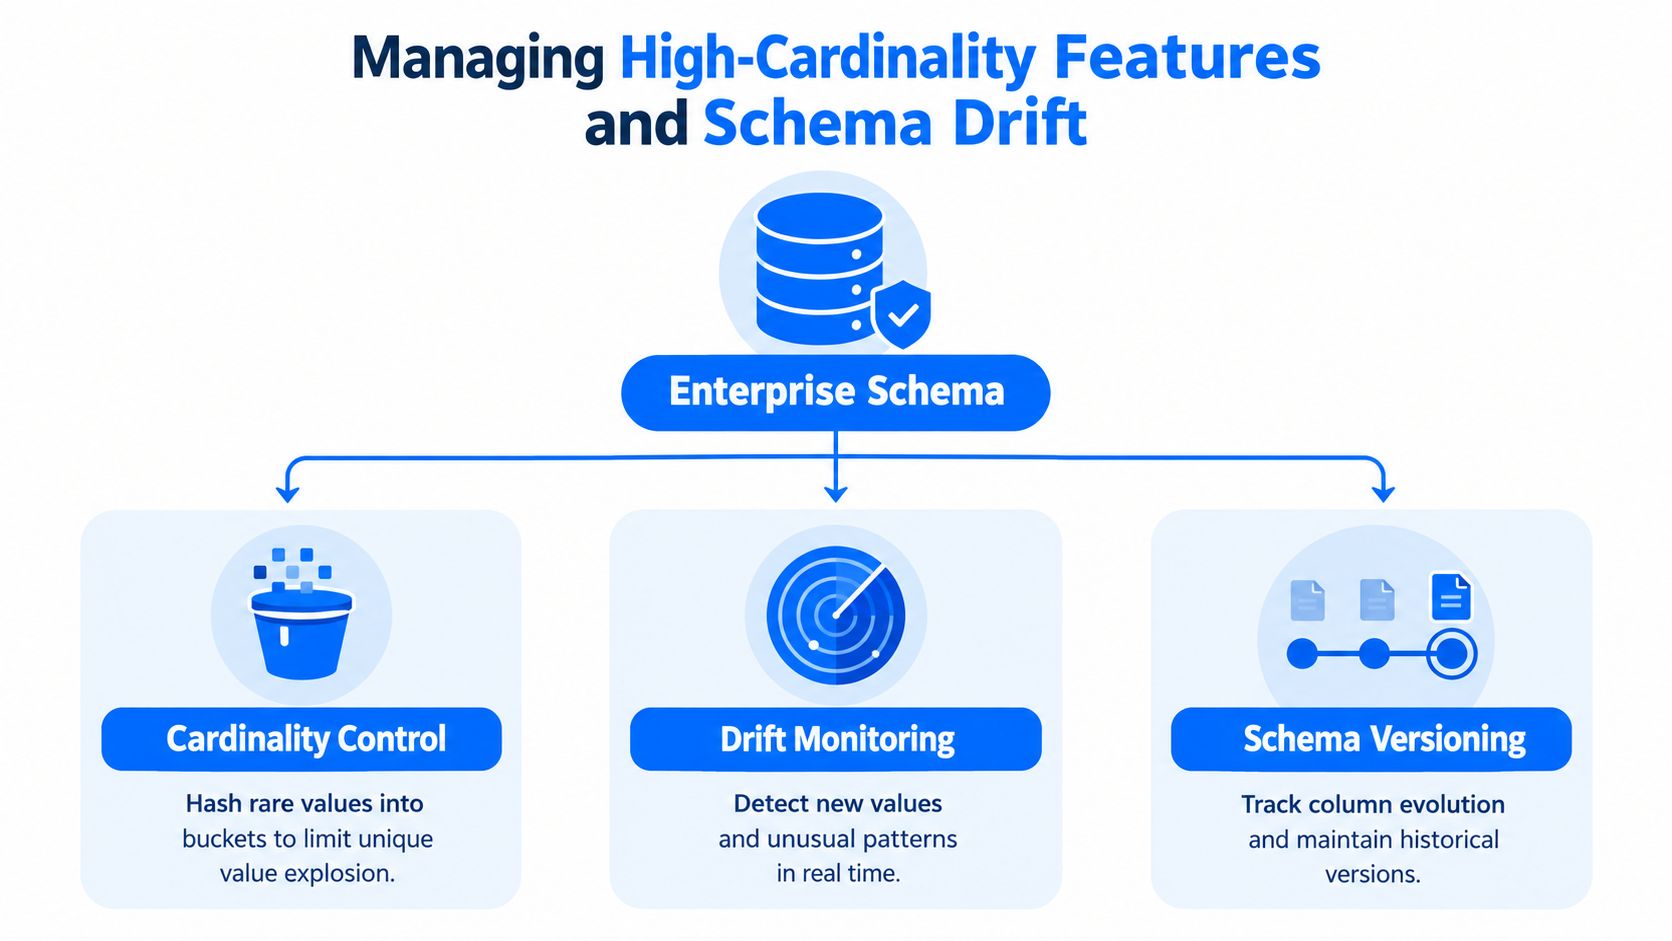
Une architecture de référence pour la détection de la dérive de schéma et d'attributs recommande deux référentiels pour chaque table surveillée : une empreinte structurelle et un profil statistique conception de la détection de la dérive de schéma et d'attributs. L'empreinte structurelle détecte les colonnes ajoutées ou supprimées et les changements de type. Le profil statistique capture, pour chaque colonne, le taux de valeurs nulles, le nombre de valeurs distinctes, les bornes numériques le cas échéant et un histogramme top-k des catégories pour les champs codés. Pour une analyse approfondie de ce qui se casse lorsque la structure change, consultez la dérive de schéma expliquée.
Cette séparation est importante en production. Une nouvelle valeur peut correspondre à un changement métier légitime, tandis qu'une colonne renommée ou un type modifié peut invalider le référentiel avant même qu'un contrôle de distribution ne soit utile.
Réduire le bruit sans masquer les valeurs rares
Les catégories rares portent du signal, mais elles génèrent aussi du bruit dans les alertes. Le hachage, le regroupement par classes et le regroupement contrôlé peuvent stabiliser la surface de surveillance, à condition de ne pas fusionner trop tôt des significations métier distinctes. Si un code produit rare apparaît, le pipeline doit d'abord l'enregistrer, puis décider s'il appartient à un groupe existant.
Surveillez d'abord le changement de schéma, puis déterminez si la variation de catégorie est une véritable anomalie ou une nouvelle normalité.
La traçabilité est l'enjeu central dans les systèmes réglementés. Les équipes doivent pouvoir montrer ce qui a changé, pourquoi cela a été signalé et quel référentiel a produit la décision. Reliez la dérive de schéma et la dérive catégorielle au sein du même processus, afin que les analystes ne se retrouvent pas avec des tickets distincts pour une seule et même rupture sous-jacente.
Garder un modèle opérationnel simple
Une configuration pratique comporte généralement trois étapes. Détecter les catégories nouvelles ou supprimées. Comparer la distribution actuelle au référentiel appris. Versionner le schéma afin que l'historique des changements reste explicable par la suite. Cela suffit à détecter la plupart des défaillances liées aux catégories sans submerger l'équipe de faux positifs.
Compromis de mise en œuvre et outils d'entreprise
Un pipeline Python sur mesure pour la détection d'anomalies catégorielles est tout à fait réalisable. Le plus difficile est de le maintenir fiable lorsque le nombre de tables augmente, que les schémas évoluent et que la logique d'alerte doit satisfaire simultanément aux exigences de gouvernance, de sécurité et d'audit.
Le code sur mesure offre la maîtrise, mais aussi du travail de maintenance
Une pile développée en interne peut utiliser pandas, scikit-learn ou un profilage SQL pour la couche statistique, ce qui convient pour un périmètre restreint. Le problème survient après les premières tables. Vous devez gérer vous-même les référentiels, les seuils, la planification, l'historique, les responsabilités, l'acheminement des incidents et l'explicabilité, et chacun de ces éléments peut devenir un point de défaillance distinct.
TensorFlow Data Validation est une option open source pragmatique lorsque vous souhaitez des contrôles de dérive d'un lot à l'autre et des mesures de distance catégorielles, car il détecte la dérive entre des plages de données consécutives et mesure la dérive des variables catégorielles à l'aide de la distance L-infini guide de TensorFlow Data Validation. Cela fonctionne bien lorsque votre pipeline est déjà standardisé et que votre équipe peut se permettre de prendre en charge l'orchestration qui l'entoure.
Le choix de la plateforme compte lorsque la sécurité et la gouvernance ne sont pas négociables
L'exécution en base de données est importante, car elle maintient les données en place et réduit les déplacements inutiles entre systèmes. C'est particulièrement important dans la finance, la santé, les télécommunications et le secteur public, où la souveraineté des données et les contrôles d'accès façonnent l'architecture. Les travaux de recherche d'IBM sur l'IA sémantique dans Db2 vont dans le même sens, puisqu'ils présentent le rapprochement de l'analyse et de la base de données comme un moyen de réduire les risques liés à la confidentialité, à la conformité et aux incohérences, tout en réunissant les enseignements tirés des données structurées et non structurées IBM Research sur SQL Data Insights Pro.
C'est là que des plateformes comme digna s'inscrivent dans le paysage opérationnel, parmi d'autres options. digna s'exécute dans l'environnement du client, effectue les contrôles en base de données et combine méthodes statistiques et machine learning pour la détection d'anomalies sur les champs catégoriels, ce qui la rend pertinente lorsque les équipes ont besoin d'une surveillance continue sans construire chaque composant de A à Z.
Choisir en fonction de la charge d'exploitation, et pas seulement de la qualité du détecteur
Le meilleur détecteur ne sert à rien si le pipeline qui l'entoure s'effondre. Si votre équipe a besoin d'un moyen fiable de surveiller des centaines de tables, de conserver l'historique des schémas et d'éviter de déplacer des données sensibles, le choix de l'outil dépend autant du modèle d'exécution que de l'algorithme. Une tarification transparente et stable selon l'usage compte également lorsque vous cherchez à prévoir comment un programme de surveillance évoluera en fonction du nombre de tables et de l'utilisation.
Construire un processus de surveillance prêt pour la production
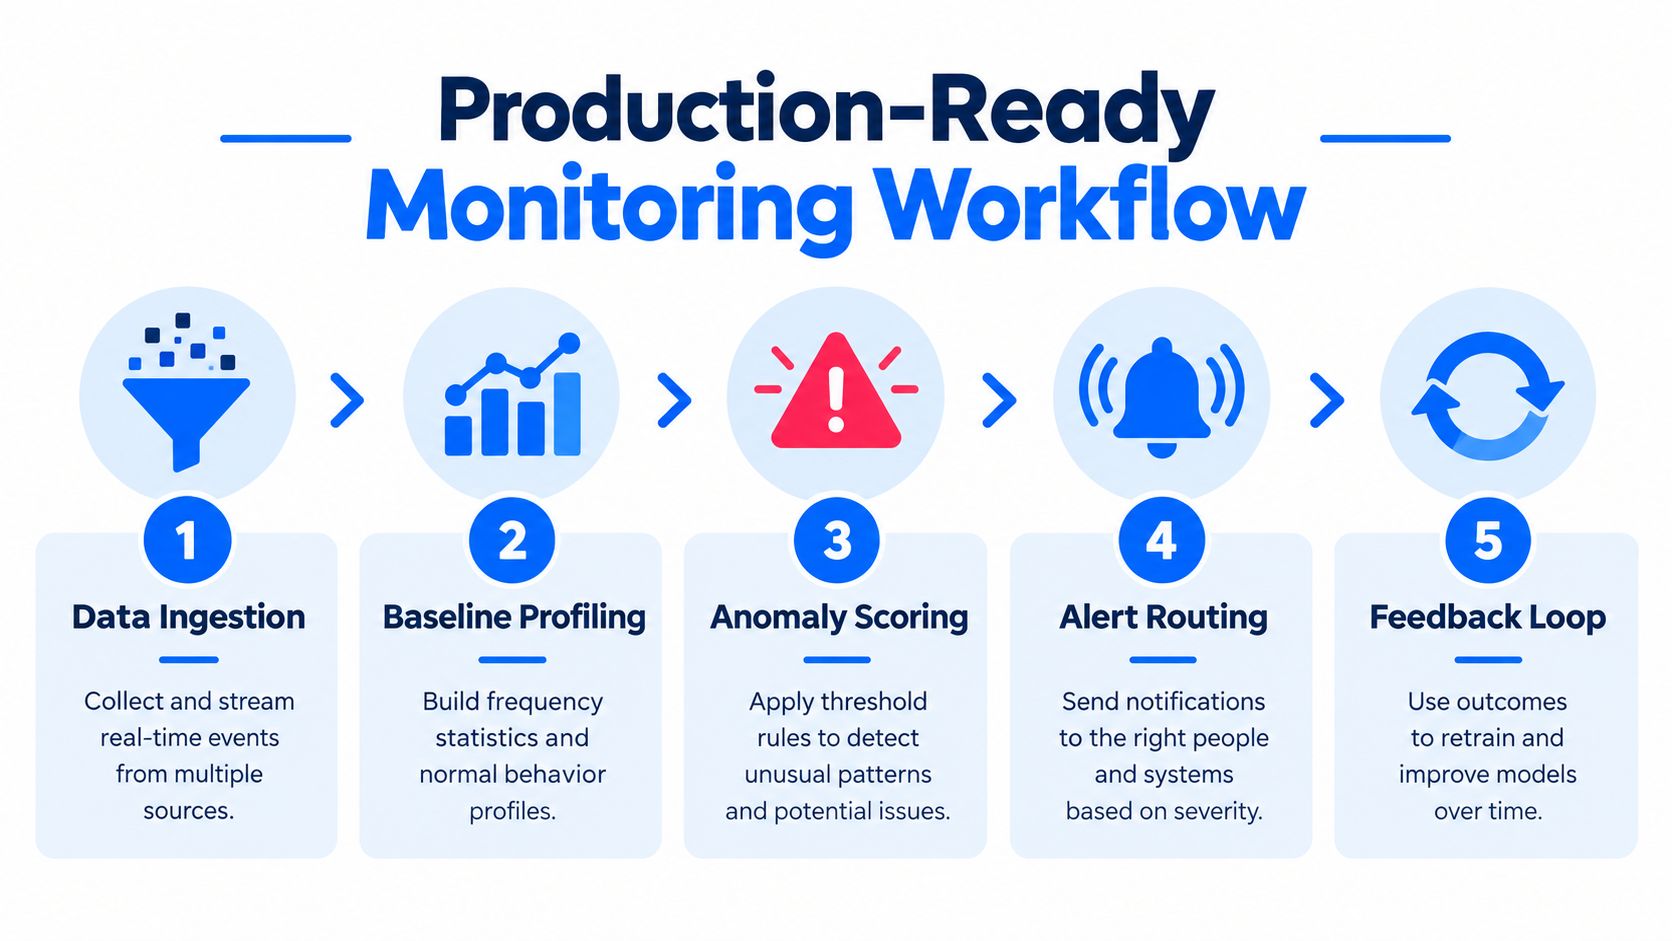
Un processus de production pour la détection d'anomalies catégorielles doit être ennuyeux, dans le meilleur sens du terme. Le pipeline ingère les données, profile les distributions de catégories, attribue un score aux anomalies, achemine les alertes vers le bon responsable et réinjecte le résultat dans le référentiel afin que le système continue d'apprendre. Si l'un de ces éléments manque, le détecteur devient un script ponctuel plutôt qu'un contrôle opérationnel.
Organiser le flux autour des responsabilités
Commencez par définir quelles tables et quels champs catégoriels sont critiques pour l'activité. Désignez ensuite des responsables capables d'interpréter un signalement dans son contexte, car la bonne réponse à une nouvelle catégorie n'est pas toujours la même que la bonne réponse à un schéma cassé. Sans responsables désignés, les alertes deviennent du bruit.
Une alerte utile indique précisément à quelqu'un ce qui a changé, où cela a changé et quel référentiel a été enfreint.
Ensuite, conservez un référentiel propre à chaque table et à chaque champ, plutôt qu'un référentiel global à l'ensemble de l'entrepôt. Le comportement catégoriel est souvent propre à un domaine, de sorte qu'un champ d'un système ne peut pas être évalué selon les mêmes attentes qu'un champ portant un nom similaire ailleurs. C'est particulièrement vrai lorsque les codes, les hiérarchies de produits et les valeurs de statut diffèrent selon le système source.
Intégrer la boucle de rétroaction au détecteur
Chaque revue doit faire évoluer le système d'une manière ou d'une autre, même si la conclusion est « c'était attendu ». Cela peut consister à ajuster les seuils, à ajouter une nouvelle catégorie autorisée ou à modifier la logique de regroupement des modalités rares. Si le référentiel n'apprend jamais, le même faux positif reviendra le lendemain.
La dernière étape est simple, mais facile à négliger. Intégrez les contrôles catégoriels au même circuit opérationnel que le reste de votre pile d'observabilité des données, afin qu'ils ne soient pas isolés du lignage en amont, des tableaux de bord en aval ou des entrées des modèles. C'est ainsi que la détection d'anomalies sur les données catégorielles devient un contrôle durable plutôt qu'une tâche de nettoyage ponctuelle.
Si vous avez besoin d'une détection d'anomalies catégorielles adaptée à de véritables pipelines d'entreprise, digna est conçu pour surveiller le comportement des données, détecter les changements de schéma et exécuter les contrôles dans votre propre environnement, sans en extraire les données. Rendez-vous sur digna pour découvrir comment cette approche s'applique à votre entrepôt, à votre lac de données ou à votre pile de pipelines, en particulier si vous êtes confronté à des catégories creuses, à des dérives et à des alertes de production qui doivent parvenir rapidement à la bonne équipe.
Si vous préférez ne pas construire vous-même la boucle de référentiel, de scoring et d'alerte décrite ci-dessus, digna Data Anomalies assure cette surveillance en base de données, au sein de votre propre environnement.
Questions fréquentes
Qu'est-ce qu'une anomalie catégorielle ?
Une anomalie catégorielle est une modalité, ou une combinaison de modalités sur plusieurs champs, qui apparaît avec une fréquence inhabituellement faible par rapport à la population de référence. Contrairement à une valeur aberrante numérique, elle concerne la fréquence d'apparition et de co-occurrence d'une catégorie : un pays, un type de paiement et une catégorie d'appareil peuvent ainsi être rares ensemble alors que chacun semble normal.
Pourquoi la distance euclidienne ne fonctionne-t-elle pas pour les données catégorielles ?
Des libellés tels que les codes pays ou les statuts de demandes de remboursement n'ont pas de géométrie pertinente, de sorte que l'écart à une moyenne ne dit rien à leur sujet. L'encodage one-hot des champs à forte cardinalité fait exploser la dimensionnalité et rend les tables de contingence creuses, tandis que les Z-scores ne permettent pas de savoir si un nouveau code est inhabituel ou simplement nouveau.
Comment détecter une dérive dans une colonne catégorielle ?
Comparez les fréquences de catégories observées à un référentiel historique à l'aide d'un test du khi-deux, ou quantifiez la variation avec le Population Stability Index. Un PSI inférieur à 0,1 indique une dérive minimale, une valeur de 0,1 à 0,25 justifie une investigation, et toute valeur supérieure à 0,25 correspond à une dérive significative nécessitant une action immédiate.
Comment gérer les variables catégorielles à forte cardinalité dans la détection d'anomalies ?
Les embeddings catégoriels projettent de nombreuses modalités dans des représentations denses exploitables par des autoencodeurs ou des isolation forests. Pour la surveillance, conservez deux référentiels par table : une empreinte structurelle pour les colonnes ajoutées, supprimées ou dont le type a changé, et un profil statistique comprenant le taux de valeurs nulles, le nombre de valeurs distinctes et un histogramme top-k des catégories.
Que doit inclure un processus de surveillance des anomalies catégorielles en production ?
Il doit ingérer les données, profiler les distributions de catégories, attribuer un score aux anomalies, acheminer les alertes vers des responsables désignés et réinjecter les conclusions des revues dans le référentiel. Conservez des référentiels propres à chaque table et à chaque champ, et faites en sorte que chaque revue ajuste les seuils ou les catégories autorisées afin que le même faux positif ne revienne pas.


