7 listes de mots vides pour la recherche et le NLP
|
7
minute de lecture

Supprimer les mots courants n'est pas systématiquement bénéfique. Un mot vide peut être du bruit dans un processus et un signal essentiel dans un autre ; le bon paramétrage de votre liste de mots vides dépend donc de ce que vous cherchez à améliorer : la pertinence de la recherche, les features NLP, le traitement natif en base de données ou le sens des textes métier. Les systèmes de recherche documentaire historiques traitaient les listes de mots vides comme un raccourci d'indexation, et non comme une règle générale, et les pipelines modernes font toujours face au même compromis, car supprimer les termes courants peut réduire la taille des index et accélérer le traitement tout en nuisant à la recherche d'expressions exactes et aux requêtes critiques pour l'activité (historique des mots vides et compromis en recherche documentaire). La règle pratique est simple : mesurez la pertinence, la qualité des modèles et les résultats en aval en matière de qualité des données avant et après le filtrage, puis documentez chaque ajout ou exclusion personnalisé.
Dans les textes en anglais, les mots vides représentent souvent une part importante du langage courant, ce qui fait de ce choix une décision opérationnelle et non cosmétique. Les recommandations de NVIDIA résument des études montrant qu'un texte anglais typique contient environ 30 à 40 % de mots vides, ce qui signifie que les choix de filtrage peuvent modifier sensiblement la taille des index, la vitesse de traitement et le comportement des modèles (recommandations de NVIDIA sur les mots vides). C'est pourquoi il vaut mieux aborder les sept ressources ci-dessous par cas d'usage plutôt que par marque. Certaines sont conçues pour le NLP généraliste, d'autres pour les moteurs de recherche, d'autres pour le machine learning, et d'autres encore pour le traitement de texte natif en base de données, lorsque les données doivent rester en place.
Table des matières
1. Mots vides anglais de NLTK
À utiliser lorsque le texte soutient un processus de surveillance
2. Mots vides natifs de Snowflake
Traiter le texte de l'entrepôt au plus près des données
3. Mots vides d'Apache Lucene
Choisir Lucene lorsque le comportement de la recherche compte davantage que le NLP généraliste
4. Mots vides par défaut de spaCy
Choisir spaCy lorsque le sens dépend de la grammaire et du contexte
5. Dictionnaires de mots vides personnalisés PostgreSQL et BigQuery
Concevoir les dictionnaires pour l'audit et la réutilisation
6. Listes de mots vides sectorielles
Intégrer le vocabulaire métier à la conception des contrôles
7. Mots vides anglais de scikit-learn
Une base de départ pour les features textuelles
Comparaison de 7 listes de mots vides
Choisir la liste qui préserve le sens
1. Mots vides anglais de NLTK
NLTK constitue un bon point de départ lorsqu'il s'agit de NLP généraliste en Python. Sa liste de mots vides anglais est largement utilisée en prétraitement, car elle permet aux équipes de supprimer rapidement les termes de remplissage avant la tokenisation, l'analyse de fréquence ou la classification de texte. Pour les équipes digna, elle est donc utile lorsque des descriptions de règles métier en langage naturel, des tags de métadonnées ou des notes d'incident doivent être nettoyés avant la validation ou l'analyse des anomalies. L'objectif n'est pas de se fier indéfiniment à la liste par défaut, mais d'obtenir rapidement une base lisible.
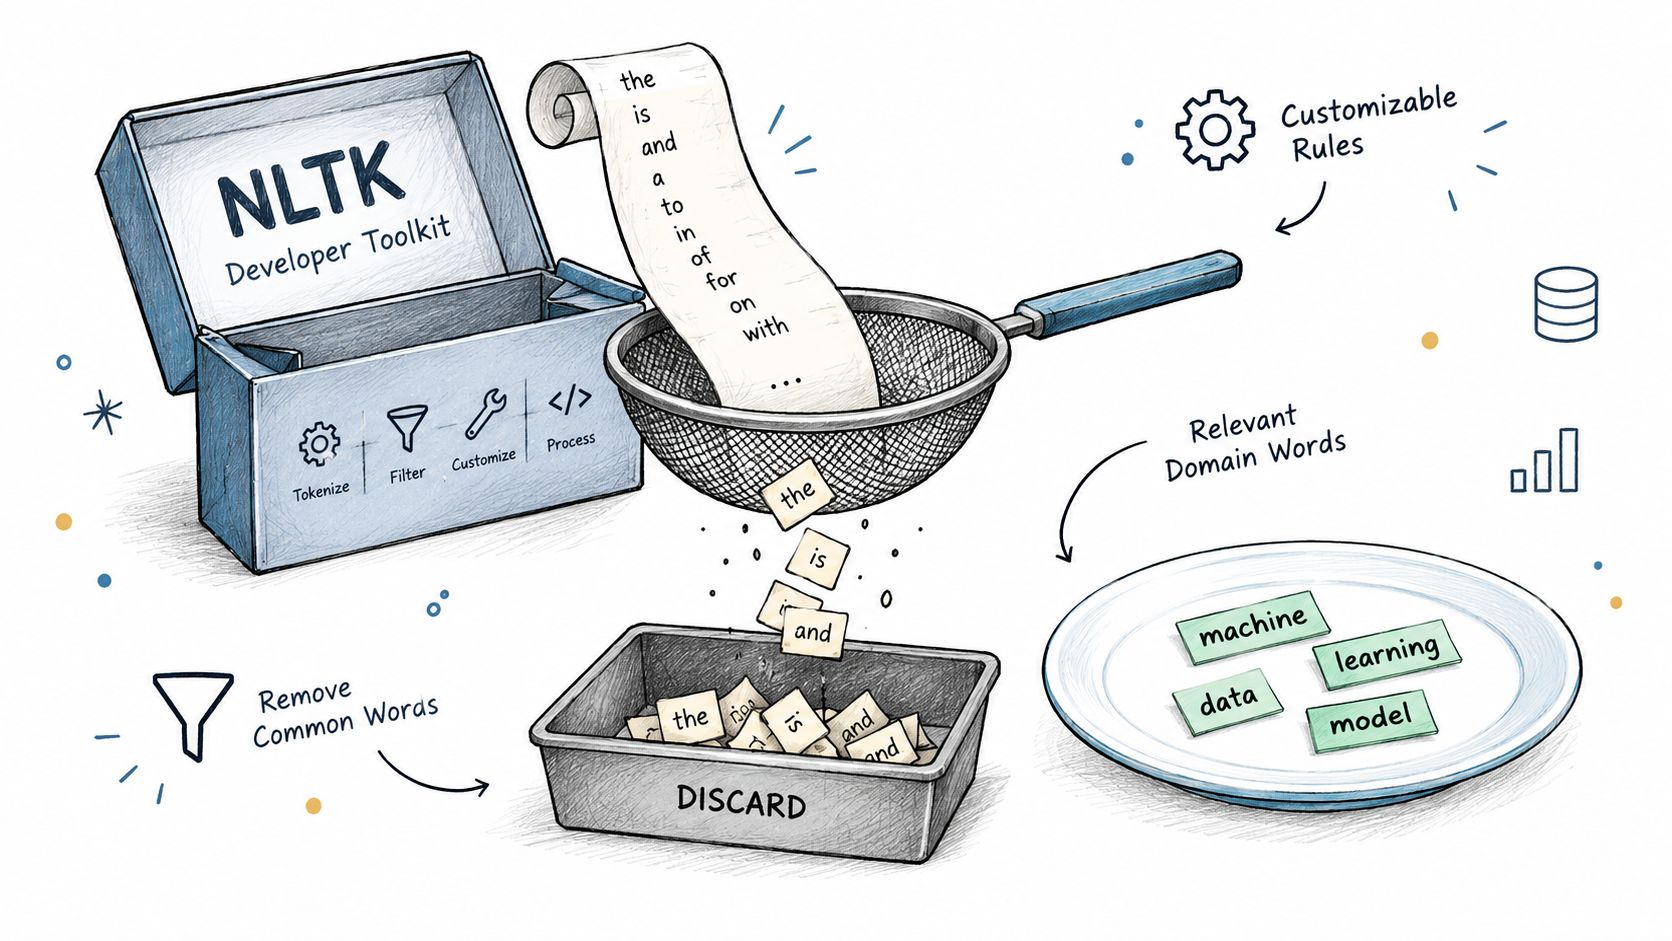
NLTK donne les meilleurs résultats lorsque vous la traitez comme une liste provisoire et non comme une politique définitive. Si votre équipe qualité des données rencontre des termes comme credit, patient ou subscriber de manière récurrente dans le texte des règles, ces mots peuvent avoir plus de sens que ne le suppose une liste générique de mots anglais. Une liste personnalisée est souvent le choix le plus sûr dans les services financiers, la santé ou les télécommunications, car le langage métier peut compter davantage que les mots de remplissage grammaticaux.
À utiliser lorsque le texte soutient un processus de surveillance
Un cas d'usage pertinent consiste à filtrer les descriptions de règles en langage naturel, comme dans les recommandations de digna sur le nettoyage des données, où l'objectif est de séparer la syntaxe du signal avant l'analyse. La même liste peut aider à nettoyer les notes de lignage ou les résumés d'incident avant qu'ils ne soient regroupés ou comptabilisés. Elle peut également réduire le bruit dans les champs de texte libre que les analystes utilisent pour trier les problèmes de données.
Règle pratique : commencez par la liste par défaut, puis n'ajoutez ou ne supprimez des termes qu'après les avoir testés sur votre propre vocabulaire de règles métier.
Préservez les termes métier : conservez les mots qui changent de sens dans votre secteur, même s'ils sont courants en anglais général.
Testez avant le déploiement : comparez le texte filtré et non filtré sur des échantillons réels d'incidents et de règles.
Documentez chaque modification : consignez chaque ajout personnalisé afin que la logique de validation reste cohérente d'une équipe à l'autre.
2. Mots vides natifs de Snowflake
Snowflake a toute sa place dans cette discussion lorsque le traitement du texte doit rester au sein de l'entrepôt. La gestion native des mots vides convient au travail sur les données dans le cloud, car elle évite de transférer le texte vers une pile NLP externe uniquement pour supprimer des termes courants. Pour les déploiements de digna sur Snowflake, cela s'inscrit dans l'exécution en base de données, puisque le texte reste à proximité des enregistrements, du lignage et des métadonnées de schéma inspectés.
C'est important dans les processus d'observabilité. Si la description d'un catalogue de données ou une note d'incident est traitée là où elle se trouve déjà, les équipes évitent une orchestration supplémentaire et simplifient la piste d'audit. En pratique, le cas d'usage le plus pertinent consiste à filtrer les métadonnées rédigées par des humains qui accompagnent les schémas, car le contexte environnant compte souvent autant que la liste brute de tokens.
Snowflake rappelle également que les mots vides ne sont pas qu'une question de NLP. Ils peuvent s'intégrer à la même logique d'entrepôt que celle qui prend en charge la recherche textuelle, le tri des incidents et l'examen des changements de schéma. Lorsque le même environnement assure à la fois le stockage et l'analyse, une liste native de mots vides devient partie intégrante du modèle opérationnel plutôt qu'une étape de prétraitement cachée dans un notebook.
Traiter le texte de l'entrepôt au plus près des données
Pour les équipes qui surveillent les changements de catalogue, cette conception rejoint les recommandations de digna pour Snowflake, en particulier lorsque le tableau de bord doit montrer ce qui a changé sans exporter de texte sensible. Une table de correspondance personnalisée constitue souvent le bon complément lorsque le texte de l'entrepôt contient des termes métier que les listes par défaut supprimeraient. Cette approche facilite également la gestion des versions entre les environnements.
Privilégiez d'abord le filtrage natif : conservez la transformation dans Snowflake lorsque les données s'y trouvent déjà.
Complétez avec les termes métier : ajoutez une couche spécifique au domaine pour le vocabulaire réglementé ou technique.
Vérifiez les changements de version : examinez les mises à jour des mots vides avant qu'elles n'affectent les règles existantes ou les recherches enregistrées.
3. Mots vides d'Apache Lucene
Lucene est le choix le plus pertinent lorsqu'il s'agit d'indexation pour la recherche. Sa liste de mots vides anglais est compacte et optimisée pour la recherche d'information, ce qui en fait un excellent choix pour la recherche dans les catalogues, la consultation du lignage et la recherche de métadonnées à grande échelle. Ce type de liste est généralement plus adapté lorsque l'objectif est une recherche rapide et ciblée plutôt qu'une analyse linguistique approfondie.
Le compromis passe facilement inaperçu. Une liste plus courte peut être excellente pour les performances, mais la pertinence de la recherche dépend de la façon dont les utilisateurs interrogent vos données. Un terme qui semble anodin dans un corpus générique peut compter dans un nom de table, une description de schéma ou le titre d'un incident. Si vos utilisateurs recherchent des expressions exactes, supprimer les mauvais termes peut donner l'impression d'un système moins précis, même si l'index devient plus petit.
Choisir Lucene lorsque le comportement de la recherche compte davantage que le NLP généraliste
Lucene convient aux situations où de nombreuses personnes interrogent la même surface de métadonnées, comme un catalogue de données comportant des milliers de tables. Dans les déploiements de digna, c'est particulièrement pertinent pour l'exploration des schémas et du lignage, où la rapidité de recherche et la qualité du classement font toutes deux partie de l'expérience utilisateur. Plus l'index est propre, plus il est facile de faire apparaître rapidement le bon objet.
Lucene donne toute sa mesure lorsque vous traitez les mots vides comme un outil de réglage de la recherche, et non comme une étape de nettoyage générique.
C'est pourquoi les recommandations de digna sur la recherche par caractères génériques s'inscrivent dans le même processus. La recherche par caractères génériques et le filtrage des mots vides agissent sur des aspects différents de la recherche, mais ils interagissent en pratique lorsque les utilisateurs saisissent des noms partiels, des expressions mixtes ou des libellés de métadonnées bruités. Si la surface de recherche est importante sur le plan opérationnel, testez-la sur de vrais journaux de requêtes avant de standardiser la liste.
4. Mots vides par défaut de spaCy
spaCy est plus adapté lorsque le pipeline nécessite une couverture linguistique plus large et un traitement linguistique plus fin. Son jeu de mots vides anglais par défaut est plus étendu que les listes orientées recherche, et il prend également en charge des ressources de mots vides dans de nombreuses langues. C'est important lorsque le texte est analysé syntaxiquement, lemmatisé et étudié, et pas seulement tokenisé.
Pour les utilisateurs de digna, le test pratique consiste à déterminer si le langage porte encore des signaux de risque dans les règles de qualité des données, les résumés d'incident et les descriptions de schéma. L'explication d'une règle peut dépendre d'une formulation précise, par exemple pour indiquer qu'un champ n'est obligatoire que sous certaines conditions. Dans ce contexte, supprimer trop agressivement les mots courants peut effacer la logique que les analystes doivent examiner.
Choisir spaCy lorsque le sens dépend de la grammaire et du contexte
spaCy est efficace pour extraire les concepts clés des descriptions d'incident et repérer les schémas récurrents dans le texte des règles. Il convient également aux équipes qui ont besoin d'un traitement cohérent entre plusieurs langues ou d'une configuration centralisée pour un cadre de qualité des données plus large. Dans les environnements réglementés, cette cohérence peut compter autant que la qualité brute du modèle.
La meilleure approche consiste à n'étendre la liste par défaut qu'après l'avoir testée sur du texte réel. Dans la finance, des termes comme credit et debit peuvent devoir être conservés. Dans la santé, patient et drug peuvent être trop importants pour être supprimés. Dans les télécommunications, subscriber peut constituer un signal essentiel plutôt qu'un simple mot de remplissage.
Bonne pratique : utilisez conjointement le pipeline linguistique et les mots vides de spaCy, puis déterminez si le vocabulaire métier nécessite une couche d'exclusion distincte.
Cette approche rejoint les recommandations de digna sur les données historiques lorsque le texte des règles métier doit rester compréhensible pour les analystes et les auditeurs.
5. Dictionnaires de mots vides personnalisés PostgreSQL et BigQuery
Les dictionnaires natifs en base de données sont le bon choix lorsque le traitement du texte doit rester au sein de la plateforme. La recherche plein texte de PostgreSQL et les fonctions de texte configurables de BigQuery permettent aux équipes de placer les règles de mots vides au plus près des données, ce qui réduit les déplacements et facilite la traçabilité de la gouvernance. Pour les équipes qui travaillent déjà dans ces systèmes, cet emplacement détermine souvent la conception.
Le compromis est simple : la gestion des mots vides passe d'un nettoyage linguistique général à un contrôle au niveau de la plateforme. Une équipe du secteur de la santé peut conserver les termes cliniques dans un dictionnaire et supprimer l'anglais générique dans un autre. Une équipe des services financiers peut documenter chaque modification à des fins de conformité. La valeur ne réside pas seulement dans le filtrage, mais dans l'alignement de la politique textuelle sur l'environnement dans lequel le texte est interrogé.
Concevoir les dictionnaires pour l'audit et la réutilisation
Pour les déploiements de digna, les listes natives en base de données s'accordent bien avec le modèle d'exécution en base de données. Elles prennent également en charge des processus reproductibles pour les descriptions de changements de schéma, le texte des règles métier et les métadonnées de catalogue qui, autrement, seraient copiés dans des outils distincts. Elles sont ainsi plus faciles à auditer et à maintenir alignées entre les environnements. Pour les processus propres à BigQuery, la page de digna consacrée à la qualité des données BigQuery constitue une référence utile, tandis que les équipes PostgreSQL peuvent s'appuyer sur la page de digna consacrée à la qualité des données PostgreSQL pour conserver le filtrage et la validation dans le même flux opérationnel.
Séparez par domaine : utilisez des dictionnaires distincts pour les textes opérationnels, réglementés et analytiques.
Suivez formellement les modifications : versionnez les modifications des dictionnaires afin de simplifier les revues et les retours arrière.
Testez avec des textes représentatifs : validez sur de vraies descriptions, et non sur des exemples simplistes.
Le principal avantage est la maîtrise. Les équipes savent quelles règles sont actives, où elles s'exécutent et comment elles influencent les résultats. C'est important, car supprimer le mauvais mot peut nuire à la pertinence de la recherche ou brouiller le sens métier, en particulier lorsqu'un même terme n'a pas le même poids dans les processus de base de données, d'analyse et de conformité.
6. Listes de mots vides sectorielles
Les listes génériques montrent le plus rapidement leurs limites dans les secteurs réglementés. Un mot qui semble sans importance en anglais courant peut être central pour le reporting financier, la sécurité des patients ou le suivi des KPI dans les télécommunications. C'est pourquoi les listes de mots vides sectorielles visent moins à supprimer davantage de mots qu'à préserver les termes porteurs de sens métier.
Les services financiers ont généralement besoin que des termes tels que debit, credit, transaction et settlement restent visibles. Les équipes du secteur de la santé ont souvent besoin que patient, diagnosis, treatment et medication survivent au filtrage. Les équipes des télécommunications peuvent s'appuyer sur des mots comme subscriber, churn, revenue et arpu pour une surveillance précise. Dans chaque cas, une mauvaise liste de mots vides peut brouiller le signal dont les opérateurs ont besoin.
Intégrer le vocabulaire métier à la conception des contrôles
La gouvernance joue ici un rôle important. Les équipes conformité doivent examiner la liste, car la décision de conserver ou de supprimer un terme peut affecter les pistes d'audit, l'interprétation des KPI et la détection d'anomalies. Si une règle métier ou un seuil de surveillance dépend d'une formulation métier, ce mot ne doit pas être écarté à la légère de l'analyse.
Si un mot courant modifie l'interprétation d'un indicateur réglementé, ce n'est pas un mot vide pour votre cas d'usage.
Ce principe s'accorde naturellement avec les recommandations de digna sur la gouvernance financière, car les équipes financières ont souvent besoin d'un contrôle rigoureux de la terminologie, de la validation et de la capacité de revue. La même logique s'applique aux données de santé et du secteur public, où la traçabilité peut compter autant que la commodité.
7. Mots vides anglais de scikit-learn
scikit-learn relève de la couche machine learning, et non de la couche recherche. Ses mots vides anglais sont conçus pour l'extraction de features, ce qui en fait une base pertinente pour la vectorisation, la classification et les features textuelles liées aux anomalies. Si l'objectif est de transformer des notes d'incident ou des descriptions de schéma en features, c'est la liste qui convient au pipeline.
Le grand avantage est la compatibilité. Les mots vides de scikit-learn s'intègrent parfaitement aux processus de ML en Python, en particulier lorsque les équipes construisent des features TF-IDF ou d'autres représentations creuses. Pour les utilisateurs de digna, ils sont donc utiles pour l'apprentissage de référentiels, l'analyse de schémas statistiques et le tri piloté par des modèles des textes qui accompagnent les événements de qualité des données.
Une base de départ pour les features textuelles
L'essentiel est de raisonner comme un concepteur de modèles, et non comme un ingénieur en recherche. Un pipeline de machine learning gagne souvent à supprimer les mots de remplissage à haute fréquence, mais la valeur dépend de la capacité des termes restants à améliorer la prédiction, le clustering ou la détection de dérive. Si le filtrage est trop agressif, le modèle peut perdre des distinctions utiles. S'il est trop permissif, les features restent bruitées.
C'est pourquoi la bonne pratique consiste à commencer par la liste de base, puis à n'ajouter des termes métier qu'après avoir vérifié le comportement du modèle sur des exemples réels issus de votre environnement. Une note de changement de schéma dans une entreprise peut employer un langage générique dans une autre, et la liste doit refléter cette différence.
Commencez par une base de référence : conservez la liste par défaut avant d'introduire des termes personnalisés.
Alignez-vous sur la vectorisation : associez-la à TF-IDF ou à des méthodes similaires d'extraction de features.
Examinez les résultats du modèle : vérifiez si les termes supprimés ont modifié les prédictions, et pas seulement le nombre de tokens.
Comparaison de 7 listes de mots vides
Ressource | Complexité de mise en œuvre 🔄 | Ressources nécessaires ⚡ | Résultats attendus 📊 & qualité ⭐ | Cas d'usage idéaux 💡 | Principaux avantages ⭐ |
|---|---|---|---|---|---|
Mots vides anglais de NLTK | Faible, liste simple ; facile à personnaliser | Faible, package Python léger | Impact modéré ; réduit le bruit mais nécessite un réglage, ⭐⭐⭐ | Prétraitement NLP généraliste, nettoyage des métadonnées | Open source, largement adopté, facile à personnaliser |
Mots vides natifs de Snowflake | Faible, configuration native, paramétrage minimal | Minimales, en base de données, sans dépendances externes, haut débit | Élevés pour le filtrage dans l'entrepôt ; rapide & compatible avec la gouvernance, ⭐⭐⭐⭐ | digna sur Snowflake ; filtrage et tokenisation du texte en base de données | Aucun déplacement de données, performances optimisées, données conservées en place |
Mots vides d'Apache Lucene | Faible, s'intègre facilement aux piles de recherche | Faibles, liste courte, surcharge minimale | Élevés pour la pertinence de la recherche et l'efficacité de l'indexation, ⭐⭐⭐⭐ | Recherche plein texte, optimisation d'index à grande échelle (ES/Solr) | Liste très compacte, améliore la vitesse de recherche et réduit la taille de l'index |
Mots vides par défaut de spaCy | Moyenne, nécessite l'installation de spaCy et de modèles | Moyennes, Python + modèles NLP ; plus de calcul | Élevés pour les tâches linguistiques et le filtrage tenant compte des entités, ⭐⭐⭐⭐ | NLP avancé, analyse de la complexité des règles métier, analyse sémantique | Liste soignée, intégrée au pipeline NLP, personnalisable à l'exécution |
Dictionnaires personnalisés PostgreSQL & BigQuery | Moyenne à élevée, configuration propre à chaque base et droits d'administration | Ressources en base de données ; nécessite des compétences de DBA | Élevés pour un traitement conforme et évolutif dans l'entrepôt, ⭐⭐⭐⭐ | Environnements réglementés, dictionnaires personnalisés par table/schéma | Entièrement personnalisable en base, sans dépendances externes, adapté à l'audit |
Listes de mots vides sectorielles (finance, santé, télécommunications) | Élevée, nécessite une expertise métier et une maintenance continue | Moyennes, équipes, coûts éventuels de fournisseur/licence | Très grande précision métier ; réduit les faux positifs, ⭐⭐⭐⭐⭐ | Détection d'anomalies dans les secteurs réglementés, validation des règles, suivi des KPI | Préserve les termes critiques, améliore la précision de détection et la conformité |
Mots vides anglais de scikit-learn | Moyenne, intégrée aux pipelines de ML | Moyennes, pile ML Python (TF-IDF, modèles) | Élevés pour l'extraction de features ML et la préparation des modèles, ⭐⭐⭐⭐ | Détection d'anomalies par ML, feature engineering, processus TF-IDF | Optimisé pour le ML, reproductible, compatible avec les outils scikit-learn |
Choisir la liste qui préserve le sens
Le meilleur choix de liste de mots vides dépend de la tâche à accomplir. Utilisez Lucene lorsque la priorité est une indexation de recherche ciblée. Utilisez NLTK ou spaCy pour le NLP généraliste en Python, en particulier lorsque vous nettoyez des métadonnées, des textes d'incident ou des descriptions de règles. Utilisez scikit-learn lorsque le texte alimente un modèle, et non une barre de recherche. Utilisez des dictionnaires natifs en base de données lorsque le traitement doit rester en place. Ajoutez des extensions sectorielles chaque fois que des termes métier sont porteurs de signal et que des listes génériques les effaceraient.
Le processus de sélection doit rester pragmatique. Testez la précision, le rappel, la pertinence de la recherche, le comportement des modèles et les résultats en aval en matière de qualité des données avant de standardiser quoi que ce soit. Versionnez ensuite la liste, examinez les modifications et excluez de la liste de mots vides les termes critiques pour le métier, sauf si vous avez démontré qu'ils n'ont pas d'importance dans vos données.
C'est précisément cette rigueur qui fait que la gestion des mots vides relève de la même réflexion que l'observabilité et la validation. Si un mot modifie le classement des résultats de recherche, la sortie d'un modèle ou l'interprétation d'un incident, il relève de la gouvernance, et non d'une liste par défaut. Confiez la politique aux personnes qui sont responsables des données, et mettez-la à jour lorsque le vocabulaire métier évolue.
digna aide les équipes à maintenir cette rigueur au sein même de l'environnement où se trouvent déjà les données. Ses modules de qualité des données, de suivi des schémas, de surveillance de la ponctualité et de détection d'anomalies permettent de tester plus facilement les règles textuelles sur des données opérationnelles réelles plutôt que de procéder par conjectures. Rendez-vous sur digna si vous souhaitez relier vos choix de mots vides à la surveillance, à la validation et à l'observabilité en base de données au sein d'une seule plateforme.
Si votre filtrage des mots vides s'exécute dans l'entrepôt, comme le recommande la section Snowflake ci-dessus, la surveillance de la qualité des données pour Snowflake peut s'exécuter au même endroit, de sorte que les règles textuelles et les tables qu'elles décrivent sont contrôlées sans exporter de données.
Questions fréquentes
À quoi sert une liste de mots vides ?
Une liste de mots vides indique à un moteur de recherche ou à un pipeline NLP quels mots courants supprimer avant l'indexation ou l'analyse. Un texte anglais typique se compose d'environ 30 à 40 % de mots vides ; la liste choisie peut donc modifier sensiblement la taille des index, la vitesse de traitement et le comportement des modèles.
Quelle liste de mots vides utiliser pour l'indexation de recherche ?
Apache Lucene est le meilleur choix lorsqu'il s'agit d'indexation pour la recherche. Sa liste anglaise est compacte et optimisée pour la recherche d'information, ce qui convient à la recherche dans les catalogues et à la consultation des métadonnées. Testez-la d'abord sur de vrais journaux de requêtes, car supprimer les mauvais termes peut nuire à la recherche d'expressions exactes.
Quelle est la différence entre les mots vides de NLTK, de spaCy et de scikit-learn ?
Chaque bibliothèque répond à un besoin différent. NLTK offre une base rapide pour le NLP généraliste en Python, spaCy propose un jeu par défaut plus étendu et de nombreuses langues pour les pipelines tenant compte de la grammaire, et la liste de scikit-learn est conçue pour l'extraction de features, comme la vectorisation TF-IDF, lorsque le texte alimente un modèle plutôt qu'une barre de recherche.
Faut-il supprimer des mots métier comme credit ou patient en tant que mots vides ?
Généralement non. Les listes génériques peuvent supprimer des termes porteurs de sens métier, comme debit, credit et settlement dans la finance, patient et diagnosis dans la santé, ou subscriber, churn et ARPU dans les télécommunications. Si un mot courant modifie l'interprétation d'un indicateur réglementé, ce n'est pas un mot vide pour vous.
Comment personnaliser une liste de mots vides en toute sécurité ?
Commencez par une liste par défaut, puis n'ajoutez ou ne supprimez des termes qu'après avoir testé le texte filtré et non filtré sur des échantillons réels. Mesurez la pertinence, la qualité des modèles et les résultats en aval, documentez chaque modification personnalisée et versionnez les dictionnaires, par exemple ceux de PostgreSQL ou BigQuery, afin que les revues et les retours arrière restent simples.


