8 cas d'usage de l'observabilité des données pour des données fiables
|
9
minute de lecture

La première défaillance dans un environnement de données est rarement un pipeline planté. C'est un tableau de bord qui s'actualise correctement avec des données incomplètes, un modèle qui reçoit des entrées structurellement valides mais dont le comportement a changé, ou un KPI qui sort de son motif habituel sans investigateur désigné. Une enquête largement citée a montré que les incidents mensuels liés aux données sont passés de 59 en 2022 à 67 en 2023, tandis que 68 % des répondants déclaraient qu'un incident mettait au moins quatre heures à être détecté en 2023, contre 62 % en 2022. La même enquête faisait état d'une hausse de 166 % du délai moyen de résolution, atteignant 15 heures par incident (couverture Business Wire de l'enquête Monte Carlo).
Ces données éclairent la finalité de l'observabilité des données. Les équipes doivent surveiller le comportement des données, la livraison, la structure, le sens métier et l'exploitation de la plateforme, puis relier chaque signal à un responsable nommé et à un chemin de réponse. Les huit cas d'usage d'observabilité des données qui suivent organisent le travail de fiabilité selon la défaillance qu'une équipe doit prévenir. Chacun identifie le rôle responsable, le signal, un incident représentatif, les modules digna concernés et l'action suivante. digna s'exécute dans l'environnement du client et combine détection d'anomalies, Timeliness, validation, suivi de schéma, monitoring métier et observabilité de plateforme sans déplacer les données de production.
Sommaire
2. Décalage de données non détecté et prévention de la dérive de modèle
3. Retards de livraison des pipelines et surveillance des SLA
4. Détection des changements de schéma et prévention des ruptures
6. Application des règles métier et validation de conformité
7. Observabilité de la plateforme de données et suivi de la consommation
8. Conformité réglementaire et gouvernance des données prête pour l'audit
1. Détection des tableaux de bord périmés et cassés
Un tableau de bord peut être disponible alors que ses décisions sont déjà risquées. La couche visuelle se charge, mais une table en amont contient peut-être une partition manquante, une livraison retardée ou une distribution de métriques qui ne reflète plus l'activité en cours. La détection des tableaux de bord périmés est donc l'un des cas d'usage les plus directs de l'observabilité des données pour les équipes analytiques et métier.
Le responsable principal est généralement l'analytics engineer ou la développeuse BI, le data engineer restant en charge du pipeline amont. Le signal combine fraîcheur, volume, complétude et distribution. Une alerte de tableau de bord doit préciser quel jeu de données est en retard ou incomplet, quelle métrique a changé et quels rapports en aval en dépendent.
Un établissement financier pourrait détecter qu'un tableau de bord de risque quotidien ne s'est pas actualisé parce qu'un traitement ETL amont a livré en retard. Une équipe d'exploitation hospitalière pourrait repérer des données manquantes sur le volume de patients avant que des décisions d'effectifs ne s'appuient sur une vue incomplète. Une équipe d'analytique retail pourrait attraper des données de ventes partielles avant que les dirigeants ne consultent les KPI du jour.

La détection doit mener au diagnostic
Les modules Data Anomalies et Timeliness de digna peuvent apprendre les motifs d'arrivée attendus et le comportement des métriques, puis signaler chargements manquants, livraisons retardées et valeurs inhabituelles. Son exécution in-database garde l'analyse dans les bases du client, tandis que le tableau de bord partagé offre aux ingénieurs et aux parties prenantes une vue commune de l'incident. Les équipes peuvent s'appuyer sur le guide digna de Data Timeliness pour définir les signaux de livraison les plus importants.
Commencez par les tableaux de bord qui pèsent sur le risque, l'exploitation des soins, le chiffre d'affaires ou les décisions de direction. Acheminez les alertes vers les responsables de pipeline plutôt que d'envoyer chaque notification à un large groupe data. Examinez le comportement de la ligne de base pendant le déploiement initial, car une alerte utile reflète la cadence réelle du jeu de données et non un calendrier arbitraire.
Règle pratique : une alerte de tableau de bord doit indiquer si la défaillance est une livraison tardive, un volume incomplet ou un changement de comportement de la métrique. Ces conditions appellent des investigations différentes.
2. Décalage de données non détecté et prévention de la dérive de modèle
Un pipeline peut s'exécuter sans erreur et livrer malgré tout des données qui ne représentent plus le comportement attendu par un modèle ou un processus de décision. Les changements de distribution sont particulièrement difficiles à attraper avec une surveillance de statut de job, car l'infrastructure signale un succès alors que le contenu a bougé.
Les rôles responsables sont le data scientist, l'ingénieur ML et le data engineer. Ils doivent surveiller les distributions de variables, les fréquences de catégories, le comportement des valeurs nulles, les motifs transactionnels et les autres signaux décrivant la population d'entrée. L'incident peut être une plateforme e-commerce constatant un changement de comportement d'achat qui affaiblit la prévision de demande, ou un opérateur télécom remarquant un décalage des motifs de churn avant qu'un modèle ne devienne peu fiable.
Les équipes de santé peuvent observer une évolution inattendue des taux d'admission qui appelle une investigation opérationnelle. Les équipes de services financiers peuvent détecter des motifs de transaction inhabituels traduisant un problème de pipeline, un véritable événement métier ou un signal de fraude. L'observabilité ne décide pas quelle explication est la bonne. Elle raccourcit le chemin entre un comportement inhabituel et la personne capable de tester l'explication.
Privilégier l'apprentissage de lignes de base aux seuils manuels
Le module Data Anomalies de digna applique un apprentissage continu de lignes de base au comportement des jeux de données, tandis que Data Analytics aide les équipes à examiner motifs historiques, volatilité et changements récurrents. La ressource digna sur la détection de dérive de modèle devient pertinente quand les équipes doivent relier les changements de données au monitoring des modèles plutôt que de les traiter comme des incidents séparés.
Une alerte utile doit contenir le jeu de données concerné, le modèle ou le processus de décision qui le consomme, le signal qui a changé et le responsable de l'escalade. Les ingénieurs peuvent ensuite comparer l'anomalie à la performance du modèle, à l'historique de déploiement, aux changements du système source ou au comportement saisonnier. Si les alertes partent vers une plateforme de monitoring ML, l'équipe peut examiner dérive d'entrée et dégradation de sortie par un seul chemin d'incident.
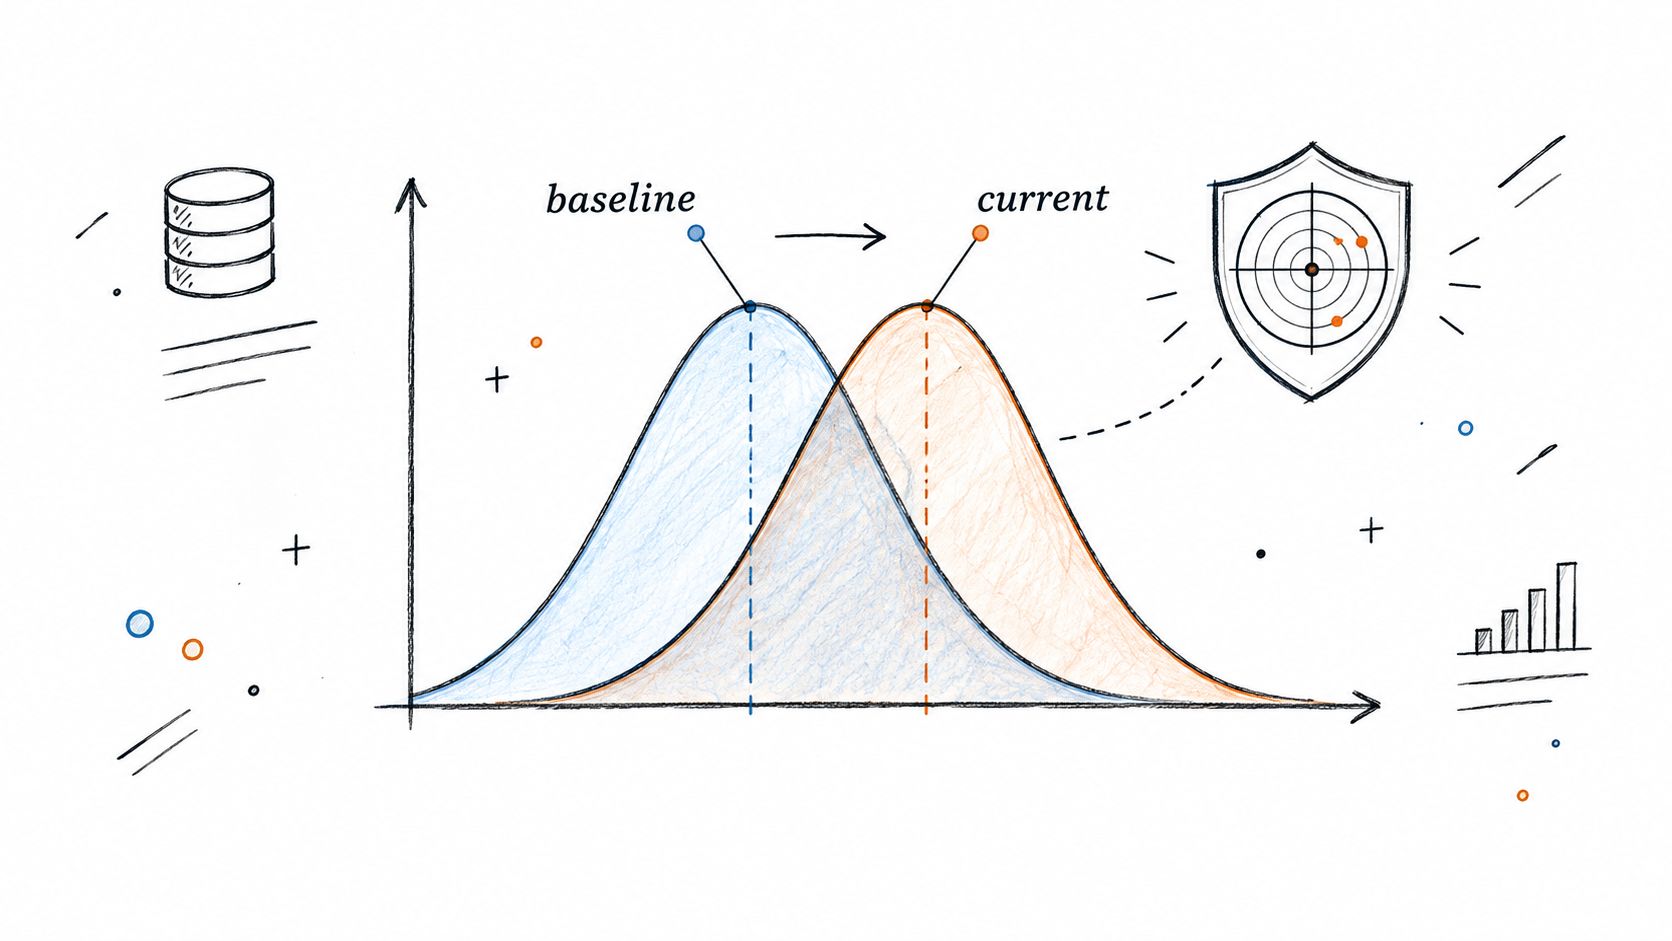
Le risque stratégique ne se limite pas à la précision du modèle. Une entrée modifiée peut changer prévisions, priorisation, revue de fraude, planification des soins ou traitement client bien avant que quiconque ne qualifie l'événement d'incident de modèle.
3. Retards de livraison des pipelines et surveillance des SLA
Des données tardives créent une défaillance différente de celle de données erronées. La transformation peut être correcte et la source disponible, mais la table arrive après que le processus métier en avait besoin. Timeliness devient ainsi un contrôle métier, et pas seulement une métrique d'ingénierie.
Le responsable est le data platform engineer ou le propriétaire du pipeline. Le signal est l'heure de livraison attendue comparée à l'arrivée réelle, appuyée par la présence du chargement, la durée d'exécution et la cadence historique. Par exemple, une table censée s'actualiser toutes les heures peut déclencher une alerte quand elle n'a pas bougé depuis plus de 2 heures, transformant une plainte vague sur des données tardives en un seuil d'incident défini (explication de l'observabilité des données par DataDriven).
Une banque peut avoir besoin des données de risque nocturnes avant une réunion du comité des risques. Un établissement de santé peut dépendre de données patients quotidiennes pour ses tableaux de bord opérationnels. Un opérateur télécom pourrait surveiller des chargements clients volumineux qui alimentent le provisionnement, tandis qu'un distributeur exige les données de ventes avant le reporting du matin.
Traiter la livraison comme un contrat opérationnel
Le module Timeliness de digna apprend les calendriers et les fenêtres de livraison attendues, puis signale retards, chargements manquants et livraisons anticipées. Les équipes peuvent s'appuyer sur la ressource digna sur la surveillance des pipelines de données AWS lorsqu'elles doivent aligner la surveillance Timeliness sur l'exploitation de pipelines cloud.
L'action suivante doit être explicite. Configurez l'escalade en cas de dépassement de l'heure de livraison attendue, envoyez l'incident au responsable du pipeline et intégrez l'alerte à la gestion des incidents. Suivez la tendance des heures de livraison attendues, pas seulement les manquements isolés. Une dégradation progressive peut révéler des problèmes de capacité ou de dépendances avant une panne complète.
Un SLA de livraison n'est utile que si quelqu'un porte le dépassement, comprend son impact en aval et sait quand l'escalader.
La détection identifie la fenêtre manquée. Le diagnostic examine l'orchestrateur, le système source, la chaîne de dépendances et l'état du chargement. La réponse peut consister à relancer un job, contacter le propriétaire de la source ou marquer les sorties en aval comme temporairement non fiables.
4. Détection des changements de schéma et prévention des ruptures
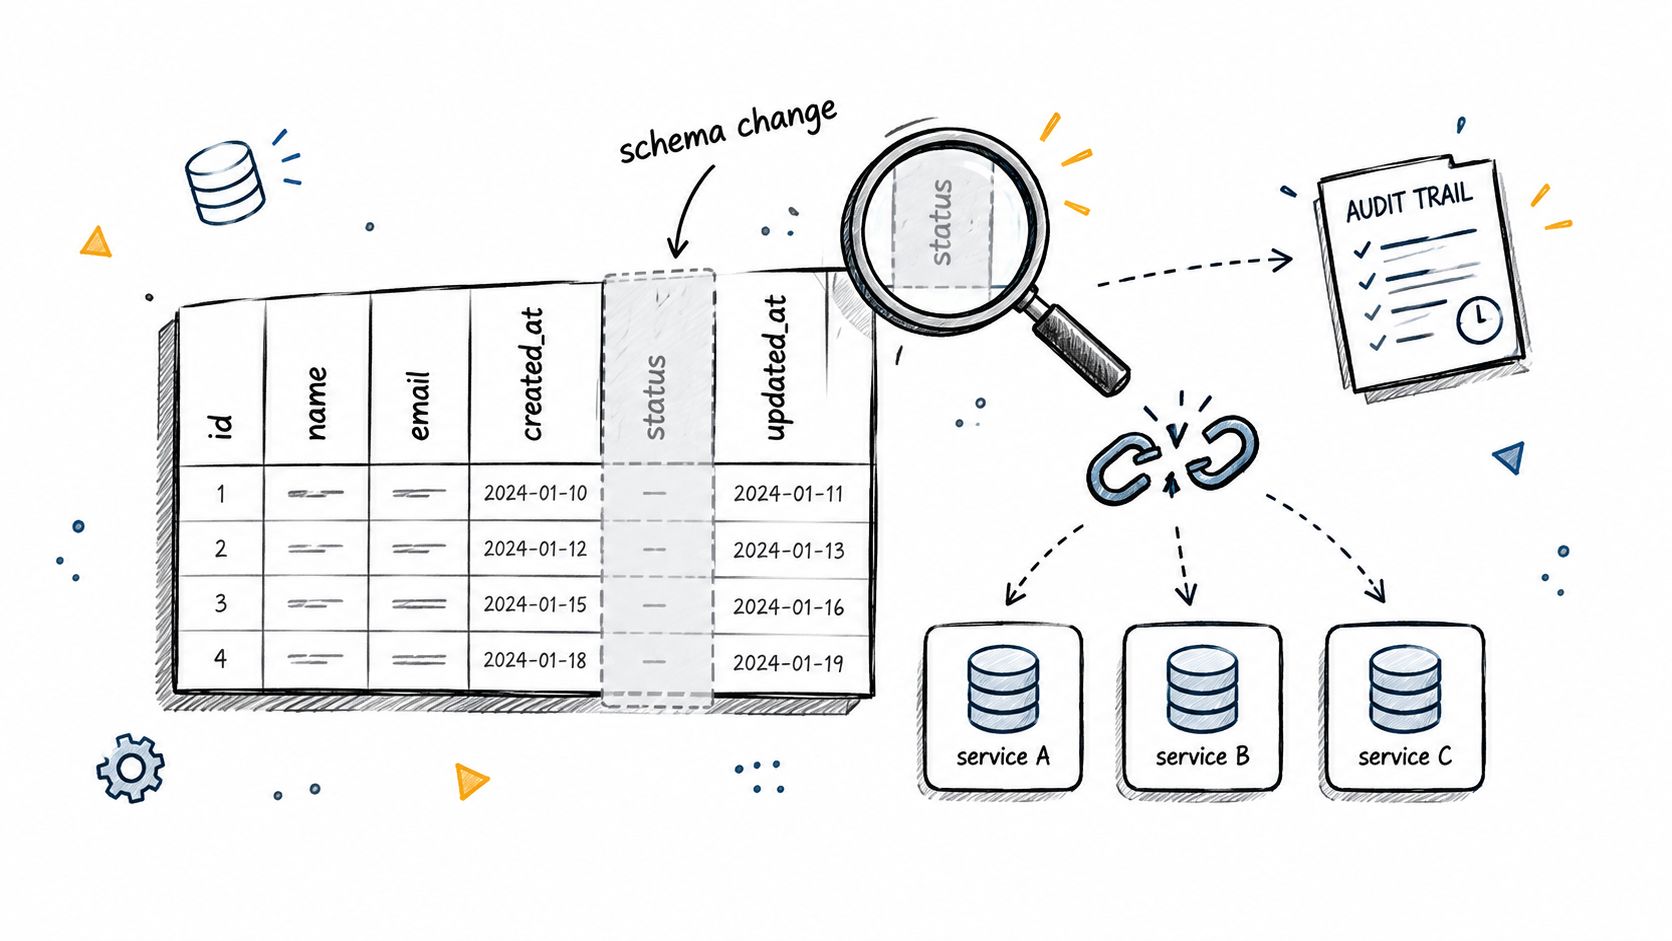
Les changements structurels sont dangereux parce qu'ils peuvent casser les consommateurs sans ressembler à des pannes d'exploitation. Colonnes ajoutées, colonnes supprimées, champs renommés, changements de type et bascules entre nullable et non nullable peuvent provoquer des valeurs manquantes, des conversions de type, des transformations en échec ou des jointures incorrectes, même lorsqu'un pipeline signale une exécution réussie (explication d'Ataccama sur le schéma et l'observabilité des données).
Le data engineer ou l'analytics engineer porte la réponse, tandis que les propriétaires des systèmes sources doivent approuver les changements intentionnels. Le signal est une comparaison entre le schéma actuel et la structure attendue. Un incident représentatif peut être une application source ajoutant une colonne non annoncée, faisant passer un identifiant client de chaîne à entier, ou supprimant un champ utilisé dans un calcul de risque.
Les équipes informatiques du secteur de la santé affrontent un problème de contrôle supplémentaire lorsque les structures de données cliniques évoluent sans communication claire. Le problème technique immédiat est peut-être une transformation en échec, mais le risque plus large est la perte de traçabilité sur la version des données ayant servi à un rapport.
Détecter le changement avant que les consommateurs ne le découvrent
Le Schema Tracker de digna surveille en continu les propriétés structurelles et alerte les équipes quand les schémas dérivent. Le module Schema Tracker de digna peut soutenir un flux où les équipes documentent les schémas attendus, acheminent les alertes vers les responsables en aval et vérifient si un changement était intentionnel.
Le diagnostic demande plus que la confirmation qu'une colonne a changé. Les ingénieurs doivent identifier les tables, transformations, tableaux de bord, modèles et sorties réglementaires concernés. L'action suivante peut être de mettre à jour un contrat, rétablir la compatibilité, revoir une transformation ou approuver formellement le changement. Reliez les alertes de schéma aux processus de catalogue et de gouvernance pour que les décisions structurelles ne restent pas dans des messages privés ou des tickets non documentés.
Une alerte de schéma est donc un signal de contrôle d'impact. Elle indique à l'équipe non seulement qu'une structure a changé, mais qu'une dépendance en aval peut désormais nécessiter une revue.
5. Surveillance des KPI métier et alertes d'anomalies
Les contrôles techniques peuvent passer alors que le résultat métier paraît faux. Un entrepôt peut recevoir les données à l'heure, conserver son schéma et achever chaque transformation, et pourtant le chiffre d'affaires, le panier moyen, le volume de clients, le churn ou les résultats de traitement peuvent sortir du comportement attendu.
Le responsable est l'analyste métier ou la partie prenante opérationnelle, avec l'appui de l'analytics engineering. Le signal est une métrique métier comparée à son comportement historique, à sa saisonnalité, à sa volatilité et aux conditions de données pertinentes. Une enseigne de distribution pourrait détecter une baisse inhabituelle du chiffre d'affaires et commencer à enquêter avant que le sujet n'atteigne une revue de performance formelle. Une équipe télécom pourrait remarquer un churn anormal, tandis qu'un groupe de services financiers examine une variation du volume de transactions pouvant traduire une fraude ou un problème système.
Placer le sens métier à côté du contexte technique
La solution Business Monitoring de digna applique la détection d'anomalies aux métriques stockées dans l'entrepôt ou le lac. Son module Data Analytics aide les équipes à comprendre les motifs historiques des KPI, les tendances et la volatilité, tandis que le système de monitoring métier de digna offre un chemin ciblé pour surveiller le comportement de l'activité.
Commencez par les KPI dotés d'un décideur clairement identifié. Définissez l'action qui suit une alerte : vérifier la complétude de la source, valider une promotion, revoir des contrôles de transactions ou contacter une équipe opérationnelle. Évitez de traiter chaque mouvement comme un incident. La sensibilité doit refléter la variation normale de la métrique et la conséquence d'une anomalie manquée.
Test de responsabilité : si personne ne peut nommer la décision qui change après une alerte KPI, la métrique n'est probablement pas prête pour une surveillance continue.
Le diagnostic relie le mouvement métier à la qualité des données, aux événements sources, aux changements produit ou à un comportement de marché réel. La réponse revient alors à l'équipe capable de corriger la condition sous-jacente, pas nécessairement à celle qui maintient le tableau de bord.
6. Application des règles métier et validation de conformité
La détection d'anomalies demande si les données se comportent différemment de leur ligne de base. La validation demande si chaque enregistrement satisfait une règle métier, logique ou de conformité connue. Les deux sont nécessaires, car un jeu de données peut paraître statistiquement normal tout en violant une condition exigée.
Le responsable est généralement la direction de la qualité des données, le data steward, l'équipe conformité ou l'expert métier du domaine. Les signaux incluent la présence des champs obligatoires, la validité des segments, les plages de valeurs, les séquences de dates, l'intégrité référentielle et d'autres contraintes déterministes. Une équipe de services financiers pourrait valider que les transactions contiennent les champs obligatoires et restent dans les seuils de conformité. Les équipes de santé peuvent vérifier que les enregistrements satisfont les exigences déclaratives avant envoi. Les opérateurs télécom peuvent valider les enregistrements de facturation au regard des règles tarifaires, tandis que les administrations testent les conditions d'audit et de traçabilité.
Rendre la preuve de validation opérationnelle
Le module Data Validation de digna effectue des contrôles au niveau enregistrement au regard de règles métier documentées. Les équipes devraient commencer par les domaines régulés ou à risque élevé, associer les experts métier à la conception des règles et consigner quels jeux de données ont réussi ou échoué. Le catalogue de données peut offrir une vue partagée du statut de validation et aider les analystes à distinguer les données aptes à l'usage de celles qui appellent une revue.
La détection identifie les enregistrements qui violent une règle. Le diagnostic détermine si la règle, la source, la transformation ou le processus métier est à l'origine de l'échec. La réponse peut consister à mettre en quarantaine les enregistrements concernés, corriger la source, approuver une exception ou documenter la remédiation pour la revue d'audit.
Des recommandations indépendantes sur l'observabilité des pipelines insistent sur le fait que la surveillance doit évaluer la qualité de la sortie, y compris les comptages d'enregistrements, les changements de distribution des champs et les changements de schéma, plutôt que de s'en remettre au seul succès du job (recommandations sur la surveillance et les contrôles des pipelines au niveau des données). Cette distinction compte dans les environnements sensibles à la conformité, où un job terminé ne prouve pas que la sortie est fiable ou auditable.
7. Observabilité de la plateforme de données et suivi de la consommation
Les équipes plateforme peuvent hériter de problèmes de fiabilité venant du comportement des ressources plutôt que du contenu des données. Un pic de charge, une requête inefficace, un pipeline emballé, une table inutilisée ou une tendance de stockage inattendue peuvent réduire la disponibilité et rendre la livraison en aval moins prévisible.
Le rôle responsable est le data platform engineer. Les signaux incluent les motifs de charge, le volume de requêtes, la capacité de traitement, le temps d'exécution des pipelines, la disponibilité, la croissance du stockage et l'évolution de la consommation. Une équipe d'entrepôt cloud pourrait trouver des tables inutilisées qui compliquent la gestion du stockage. Une analytics engineer pourrait repérer des requêtes consommant trop de ressources et optimiser le SQL. Une équipe plateforme pourrait détecter un profil de consommation anormal causé par un pipeline emballé.
Surveiller l'infrastructure derrière les données
La solution Data Platform Observability de digna se concentre sur la santé de la plateforme, son comportement, sa consommation et ses évolutions opérationnelles. Son module Data Analytics peut aider les équipes à suivre la tendance des métriques de plateforme et à distinguer un pic ponctuel d'un problème de capacité en formation. Partagez les tableaux de bord de plateforme avec les consommateurs de données pour que les ingénieurs ne soient pas les seuls à voir les conséquences d'un usage inefficace.
L'action suivante dépend du signal. Une anomalie de requête peut appeler une optimisation SQL. Une tendance de stockage peut appeler une gestion du cycle de vie ou une clarification des responsabilités. Un changement d'exécution de pipeline peut appeler une analyse de capacité, une investigation des dépendances ou un ajustement du calendrier. Établissez des lignes de base de charge normale, acheminez les alertes graves vers les responsables plateforme et utilisez les tendances de consommation pour alimenter la planification d'infrastructure.
Ce cas d'usage révèle aussi un problème de priorisation. Une enquête d'observabilité de 2025 a montré que seuls 13 % de la télémétrie collectée étaient activement utilisés pour la surveillance, les alertes ou le dépannage, tandis que 84 % des entreprises utilisaient moins d'un quart de ce qu'elles collectaient (rapport d'observabilité de Sawmills AI). Plus de télémétrie ne crée pas automatiquement plus de fiabilité. Les équipes doivent sélectionner les signaux qui mènent à une décision.
8. Conformité réglementaire et gouvernance des données prête pour l'audit
Les organisations régulées ont besoin de plus qu'un tableau de bord impeccable le jour où un auditeur demande des preuves. Elles ont besoin d'une supervision continue de la qualité des données critiques, de la validation, de Timeliness, des changements structurels, des responsabilités et de l'historique des contrôles.
Les rôles responsables sont le responsable de la gouvernance des données, le compliance officer, l'auditeur interne et le propriétaire des données du domaine. Les signaux combinent résultats de validation, statut de livraison, historique de schéma, anomalies de qualité et preuves que les contrôles ont fonctionné comme prévu. Une banque peut devoir montrer que les données de reporting réglementaire répondaient aux exigences définies et sont arrivées à l'heure. Un établissement de santé peut avoir besoin de traçabilité pour des données cliniques sensibles. Une administration peut devoir démontrer que des données critiques sont restées soumises à des contrôles documentés dans l'environnement exigé.
Relier la surveillance des contrôles à la preuve
digna combine à cette fin Data Validation, Schema Tracker, Timeliness et l'exécution in-database. Ses options de déploiement en cloud privé ou sur site gardent les données sensibles dans le cloud, le VPC ou le centre de données du client. Cette architecture répond aux exigences de gouvernance pour lesquelles déplacer des données de production vers un service de surveillance externe n'est pas acceptable.
Les équipes conformité devraient identifier les domaines de données nécessitant une supervision continue, documenter les règles dans la plateforme de gouvernance et instaurer des cycles de revue récurrents. L'action suivante pour chaque alerte doit préciser si le sujet appelle une remédiation, une approbation d'exception, une conservation de preuve ou une escalade. La trace obtenue devrait permettre à un auditeur de comprendre ce qui a été contrôlé, quand, ce qui a échoué, qui a enquêté et comment l'organisation a réagi.
Le contexte de marché montre pourquoi le sujet est devenu une affaire de plateforme plutôt qu'une tâche étroite de qualité. Les études estiment le marché de l'observabilité des données à 2,94 milliards USD en 2025 et projettent 6,02 milliards USD d'ici 2030, soit un TCAC de 15,4 %, l'Amérique du Nord étant couramment identifiée comme le premier marché et l'Asie-Pacifique comme la région à la croissance la plus rapide (rapport de marché de The Business Research Company). L'adoption progresse parce que gouvernance, fiabilité et responsabilité opérationnelle se recoupent de plus en plus.
Pour un éclairage supplémentaire sur la construction de contrôles de confidentialité et de conformité, voir les analyses de Nexus IT Group.
Observabilité des données : comparaison de 8 cas d'usage
Caractéristique | 🔄 Complexité de mise en œuvre | ⚡ Ressources & rapidité | ⭐ Efficacité attendue | 📊 Résultats clés / impact | 💡 Cas d'usage idéaux |
|---|---|---|---|---|---|
Détection des tableaux de bord périmés et cassés | Modérée, période de calibrage de la ligne de base IA nécessaire | Ressources modérées ; exécution in-database ; alertes en temps réel | ⭐⭐⭐⭐ | Moins d'indisponibilités de tableaux de bord ; résolution plus rapide des données périmées | Tableaux de bord critiques, rapports de direction, finance, retail, santé |
Décalage de données non détecté et prévention de la dérive de modèle | Élevée, exige des données historiques et un réglage de sensibilité | Calcul modéré à élevé pour l'analyse de distribution ; surveillance continue | ⭐⭐⭐⭐ | Détection précoce de la dérive ; protège la performance des modèles ML | Prévision, détection de fraude, modèles de churn, pipelines ML |
Retards de livraison des pipelines et surveillance des SLA | Modérée, apprend les calendriers et les heures de livraison attendues | Ressources faibles à modérées ; détection rapide ; réduit le MTTD ⚡ | ⭐⭐⭐⭐ | Faire respecter les SLA ; alertes de livraison à l'heure ; moins de chargements manqués | Jobs nocturnes, reporting sensible au temps, échéances réglementaires |
Détection des changements de schéma et prévention des ruptures | Faible à modérée, fixer le schéma de référence puis contrôler en continu | Peu de ressources ; détection immédiate des changements structurels | ⭐⭐⭐⭐⭐ | Éviter les défaillances silencieuses ; réduire le temps de débogage ; piste d'audit du schéma | Sources dynamiques, pipelines ETL, analytics engineering |
Surveillance des KPI métier et alertes d'anomalies | Modérée, exige de définir les KPI et des lignes de base de saisonnalité | Ressources modérées ; tableaux de bord destinés aux utilisateurs ; alertes rapides | ⭐⭐⭐⭐ | Détecter les anomalies à impact métier ; réduire la fatigue d'alerte | Suivi du chiffre d'affaires, métriques produit, KPI opérationnels |
Application des règles métier et validation de conformité | Élevée, définition initiale des règles et maintenance continue | Ressources modérées à élevées pour les contrôles au niveau enregistrement ; journalisation d'audit | ⭐⭐⭐⭐⭐ | Application continue des règles ; preuves prêtes pour l'audit ; moins d'erreurs en aval | Domaines régulés (finance, santé), facturation, reporting de conformité |
Observabilité de la plateforme de données et suivi de la consommation | Élevée, intègre métriques de plateforme et lignes de base de charge | Ressources modérées ; télémétrie continue ; permet l'optimisation des coûts | ⭐⭐⭐⭐ | Planification de capacité ; économies ; détection des goulots de performance | Entrepôts cloud, équipes plateforme, modèles de refacturation |
Conformité réglementaire & gouvernance des données prête pour l'audit | Très élevée, intégration inter-modules et alignement de gouvernance | Effort élevé en ressources et en processus ; déploiements in-database & privés | ⭐⭐⭐⭐⭐ | Preuves prêtes pour l'audit ; risque de conformité réduit ; souveraineté des données | Banques, santé, secteur public, flux de reporting régulé |
Transformer les alertes en modèle opérationnel de fiabilité
Les huit cas d'usage de l'observabilité des données deviennent utiles quand une équipe les adopte dans un ordre qui suit le risque métier. Commencez par les jeux de données critiques et les signaux de livraison. Si les équipes ignorent si les tables essentielles sont arrivées, ou si les tableaux de bord sont complets, la surveillance des anomalies et des KPI produira des symptômes confus au lieu d'incidents exploitables.
Ajoutez ensuite la détection d'anomalies comportementales et la surveillance de schéma. Ces contrôles couvrent les défaillances que les vérifications de statut de job manquent : décalages de distribution, valeurs manquantes et changements structurels. Pour les environnements dépendant de l'IA, ce socle devient de plus en plus important. En 2025, l'adoption du monitoring de l'IA est passée de 42 % à 54 % des organisations, tandis que 73 % n'avaient toujours pas d'observabilité full-stack et que le nombre moyen d'outils d'observabilité est tombé de 6 à 4,4 à mesure que les équipes consolidaient leurs plateformes (résultats de l'enquête d'observabilité de Databahn). L'implication pratique est claire. Les équipes ont besoin d'un seul flux d'investigation reliant la santé des jeux de données, le comportement des variables, les signaux de modèle et les résultats métier.
Étendez ensuite la couverture à la validation, aux KPI métier, à la consommation de plateforme et aux preuves réglementaires. La validation protège les règles connues. Le monitoring métier protège les décisions. L'observabilité de plateforme protège l'infrastructure qui livre et sert les données. Le monitoring de gouvernance transforme l'activité opérationnelle en preuves que les équipes conformité et audit peuvent examiner.
Chaque alerte devrait comporter cinq attributs :
Responsable nommé : identifiez la personne ou l'équipe chargée de l'investigation.
Sévérité : reliez la priorité à l'impact métier, pas seulement à l'écart technique.
Signal de détection : précisez si le déclencheur concerne la fraîcheur, le volume, la distribution, le schéma, la validation, le comportement d'un KPI ou la consommation de plateforme.
Chemin d'investigation : reliez l'alerte à la source, au pipeline, à la table, à la métrique, au modèle ou au consommateur en aval à examiner.
Voie d'escalade : définissez quand le responsable doit impliquer les équipes plateforme, métier, conformité ou réponse à incident.
digna soutient ce modèle opérationnel via une licence modulaire, qui permet aux organisations de démarrer avec un module et de s'étendre selon les tables actives et les besoins de surveillance. Son exécution in-database et ses options de déploiement en cloud privé ou sur site gardent les données de production dans l'environnement du client. La plateforme inclut dès la première sélection de module un planificateur, un catalogue de données, des intégrations et des fonctions de collaboration, offrant aux équipes d'ingénierie et de gouvernance un lieu commun pour examiner incidents et tendances.
Choisissez les premiers actifs en posant des questions concrètes. Quelles tables alimentent les tableaux de bord ou modèles les plus lourds de conséquences ? Quelles livraisons ont la dépendance temporelle la plus forte ? Quels schémas changent sans communication fiable ? Quels enregistrements portent un risque réglementaire ou financier ? Quels KPI déclenchent des décisions opérationnelles ? Quelles charges de plateforme menacent la disponibilité ou la maîtrise des ressources ?
Surveillez ces tables et métriques en premier. Désignez le responsable avant d'activer l'alerte. Définissez la réponse avant de mesurer la couverture. La fiabilité progresse quand les signaux d'observabilité deviennent un travail piloté et non un flux de télémétrie de plus que personne n'a le temps d'exploiter.
digna propose une observabilité des données dans votre propre environnement, via la détection d'anomalies, la surveillance Timeliness, le suivi de schéma, la validation au niveau enregistrement, le monitoring métier et l'observabilité de plateforme. Rendez-vous sur digna pour évaluer comment sa plateforme modulaire et in-database peut relier ces cas d'usage d'observabilité des données à des responsables nommés et à des chemins de réponse exploitables.
Pour la couche de mesure qui sous-tend ces cas d'usage — fraîcheur, complétude, stabilité du schéma, validité et dérive de distribution, ainsi que les seuils qui relèvent d'un contrat de livraison — consultez la fiabilité de la qualité des données.
Questions fréquentes
Quels sont les principaux cas d'usage de l'observabilité des données ?
Huit couvrent l'essentiel du travail de fiabilité : détection des tableaux de bord périmés, décalage de données et dérive de modèle, retards de livraison des pipelines, détection des changements de schéma, anomalies de KPI métier, validation des règles métier, surveillance de la plateforme et de la consommation, et gouvernance prête pour l'audit. Chacun associe un signal à un responsable nommé et à un chemin de réponse défini.
En quoi l'observabilité des données diffère-t-elle de la surveillance des pipelines ?
La surveillance de statut de job indique qu'un pipeline s'est exécuté ; l'observabilité demande ce qu'il a livré. Une transformation peut réussir avec trois partitions manquantes, et une colonne renommée peut passer par un chemin de compatibilité alors que son taux de valeurs nulles grimpe. Le tableau de bord s'actualise avec succès dans les deux cas.
Par quel cas d'usage d'observabilité des données une équipe doit-elle commencer ?
Commencez par les jeux de données critiques et les signaux de livraison. Si personne ne sait si les tables essentielles sont arrivées ni si les tableaux de bord sont complets, la surveillance des anomalies et des KPI produit des symptômes confus plutôt que des incidents exploitables. La détection d'anomalies comportementales et la surveillance de schéma viennent ensuite, puis la validation, les KPI, la consommation de plateforme et les preuves réglementaires.
Pourquoi les changements de schéma provoquent-ils des défaillances silencieuses ?
Les colonnes ajoutées, supprimées, renommées ou retypées arrêtent rarement un pipeline. Elles causent des valeurs manquantes, des conversions de type et des jointures incorrectes pendant que l'exécution signale toujours un succès. Une alerte de schéma est un signal de contrôle d'impact : elle doit donc nommer les tables, transformations, tableaux de bord, modèles et sorties réglementaires concernés, pas seulement la colonne.
Qu'est-ce qui rend une alerte d'observabilité des données exploitable ?
Cinq attributs : un responsable nommé, une sévérité liée à l'impact métier, le signal de détection, un chemin d'investigation vers la source ou le consommateur, et une voie d'escalade. Le volume seul n'aide pas. Une enquête de 2025 a montré que seuls 13 % de la télémétrie collectée étaient activement utilisés pour la surveillance ou le dépannage.


