Pourquoi la qualité des données est importante et comment de mauvaises données pénalisent le ROI
|
7
minute de lecture

Un tableau de bord peut être parfaitement mis en forme, s'actualiser à l'heure prévue et conduire malgré tout une équipe dirigeante vers la mauvaise décision. Un enregistrement client en double peut gonfler la demande, un chargement de transactions tardif peut fausser le reporting de trésorerie, et un changement de type de colonne peut casser un modèle. Le défaut technique peut sembler mineur. La conséquence métier l'est rarement.
Gartner estime que les données de mauvaise qualité coûtent aux organisations au moins 12,9 millions USD par an en moyenne, tandis que des travaux cités par la MIT Sloan Management Review situent la perte de chiffre d'affaires liée à la mauvaise qualité des données entre 15 % et 25 % pour de nombreuses entreprises (données probantes sur l'amélioration de la qualité des données). Ces chiffres expliquent pourquoi la qualité des données constitue une surface de contrôle économique et pas seulement une corvée d'ingénierie des données.
Sommaire
Introduction : pourquoi de mauvaises données cassent de bonnes décisions
Le coût dépasse le défaut
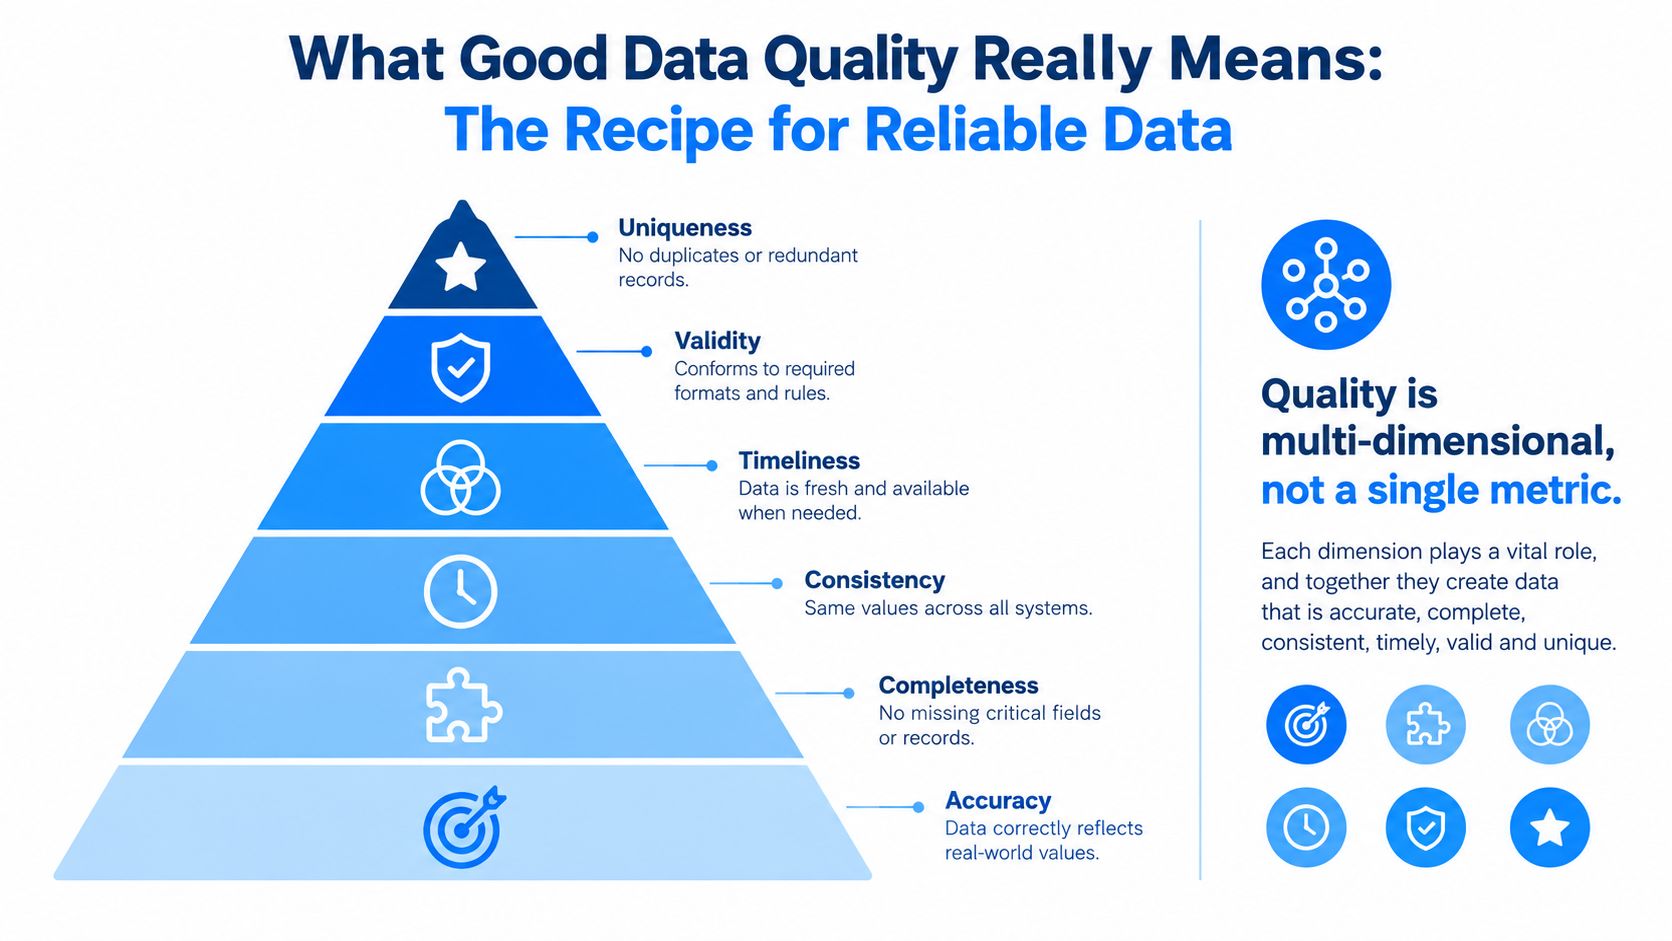
Ce que signifie vraiment une bonne qualité des données
L'exactitude ouvre la recette
Les autres dimensions définissent l'utilisabilité
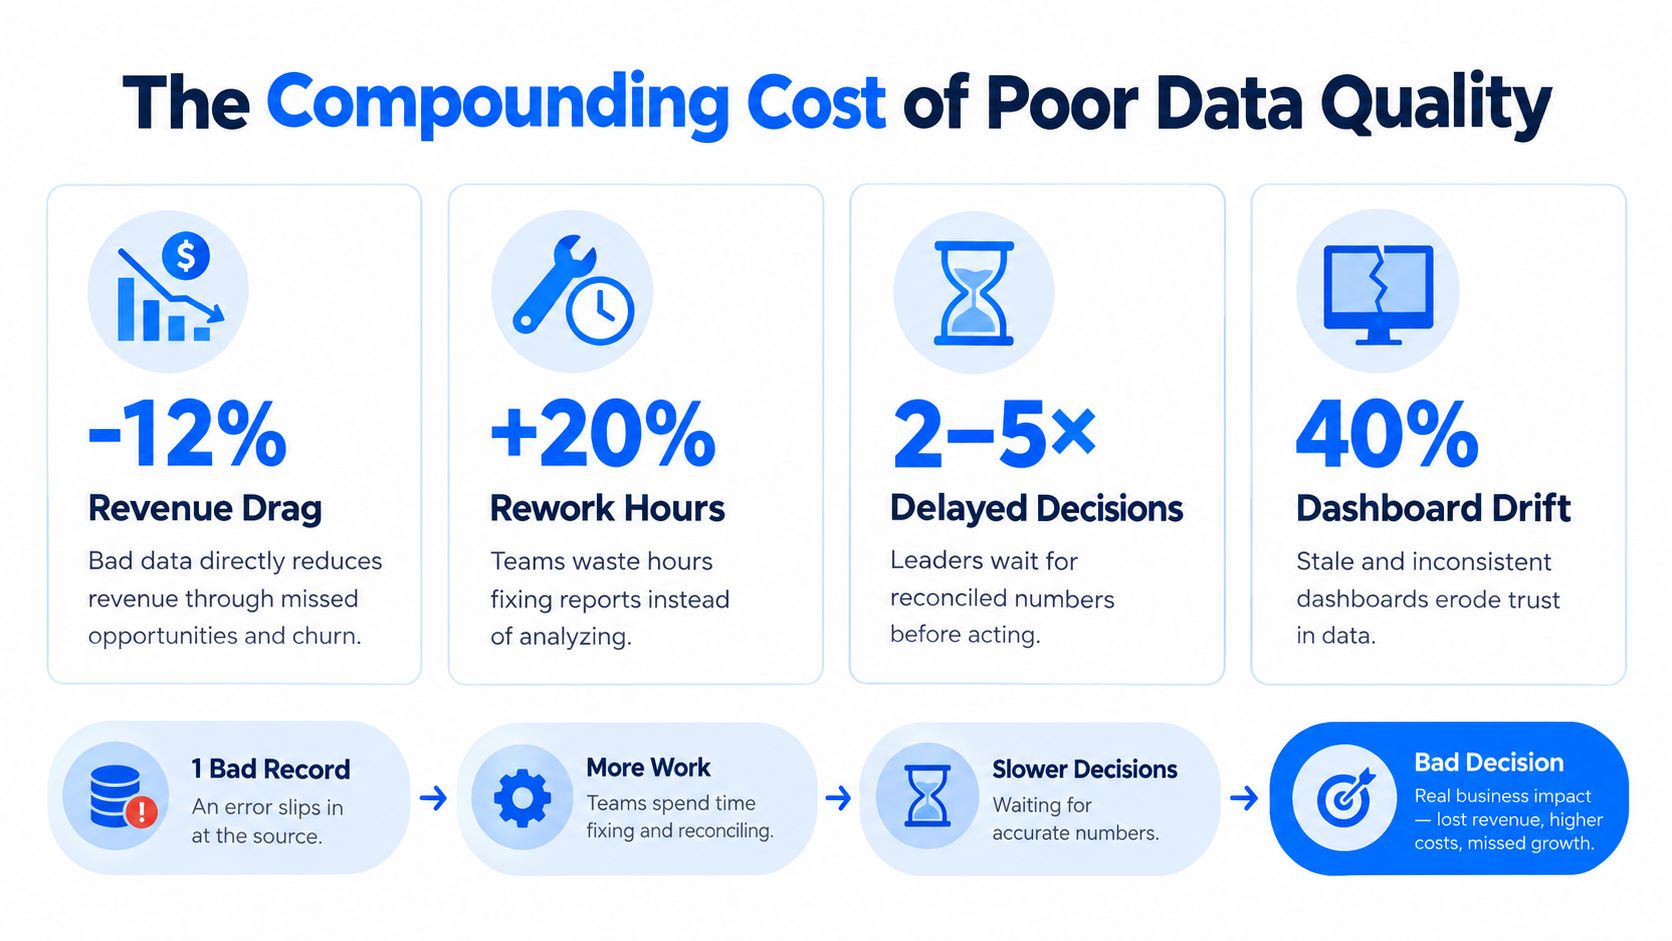
Comment la mauvaise qualité des données nuit au métier et à la technique
Où le dommage apparaît
Pourquoi la qualité des données compte encore plus pour l'IA et la gouvernance
L'IA amplifie les défauts dans les workflows
La maturité est une aptitude démontrable
Exemples réels de risque quand la qualité des données fait défaut
Réparation réactive contre contrôle précoce
Contrôler la qualité des données avec la validation, Timeliness et la surveillance
Commencer par des attentes explicites
Surveiller la livraison et la structure
Conclusion : bâtir la confiance dans les données pour l'analytique et l'IA
Introduction : pourquoi de mauvaises données cassent de bonnes décisions
Une directrice financière constate un ralentissement du chiffre d'affaires dans une région, retarde des recrutements, réduit les stocks et reporte une campagne. Plus tard, un analyste découvre qu'un système source a modifié sa classification des transactions. Le tableau de bord affichait des chiffres plausibles : l'erreur est passée inaperçue et a orienté de vraies décisions.
L'analytique et l'IA créent la même exposition sous d'autres formes. Un modèle de prévision peut produire une recommandation soignée à partir d'un historique incomplet. Un workflow de risque client peut utiliser des attributs périmés. Un rapport de direction peut se réconcilier techniquement tout en joignant des enregistrements construits sur des définitions différentes. Le résultat : reprises de travail, action retardée et confiance affaiblie dans la plateforme de données.
Le coût dépasse le défaut
La mauvaise qualité des données se comporte comme une avarie sur une ligne d'approvisionnement partagée. Les ingénieurs inspectent les pipelines, les analystes rapprochent des chiffres contradictoires, les responsables attendent confirmation et les équipes métier repoussent leurs décisions. Si le problème atteint plusieurs systèmes en aval, chaque copie devient un point supplémentaire à examiner et à corriger.
Les données sectorielles résumées dans l'explication de la qualité des données par TechTarget indiquent que le nombre mensuel moyen d'incidents de qualité est passé de 59 en 2022 à 67 en 2023, tandis que la part moyenne du chiffre d'affaires touché progressait de 26 % à 31 %. Une enquête financière distincte de 2022 a montré, selon cette même source, que 86 % des dirigeants ne pensaient pas que leurs données puissent soutenir la prise de décision.
La surface de contrôle économique porte donc autant sur le temps que sur l'exactitude. Un défaut détecté avant publication ne demande parfois qu'une seule correction. Le même défaut détecté après que des tableaux de bord, des workflows opérationnels et des modèles l'ont consommé impose une investigation sur chaque chemin touché. La prévention et la détection rapide réduisent ce travail de reprise, même lorsque des données parfaites restent hors d'atteinte.
La perte de confiance modifie aussi les façons de travailler. Les équipes ajoutent des vérifications manuelles, entretiennent des tableurs parallèles et multiplient les demandes de validation. L'organisation peut disposer d'entrepôts modernes, de tableaux de bord et de systèmes d'apprentissage automatique, et pourtant les décisions ralentissent parce que personne ne peut vérifier rapidement les entrées.
Un bon point de départ est la définition de la qualité des données : une donnée a de la valeur lorsqu'elle est apte à la décision, au processus ou au modèle qui l'utilise. Le critère est l'usage fiable, mesuré par la rapidité avec laquelle les problèmes sont évités ou détectés.
Ce que signifie vraiment une bonne qualité des données
Voyez un jeu de données comme les ingrédients d'une recette. Des ingrédients frais ne suffisent pas si les quantités sont fausses, s'il manque un élément indispensable, si deux emballages désignent le même produit différemment ou si les ingrédients arrivent une fois la cuisine fermée. Un résultat fiable dépend de plusieurs conditions qui fonctionnent ensemble.
La qualité des données, c'est l'aptitude à l'usage. Un jeu de données peut être présent, interrogeable et techniquement valide tout en restant inadapté à une question métier précise.
L'exactitude ouvre la recette
L'exactitude demande si une valeur reflète la réalité. Une adresse client, un solde de compte, un prix produit ou un code médical peut être stocké dans le bon champ et rester faux. L'exactitude suppose généralement une comparaison avec une source fiable, une règle transactionnelle ou une condition métier connue.
La complétude demande si les enregistrements et champs critiques existent. Un identifiant client manquant peut empêcher des jointures. Un horodatage manquant peut rendre la mesure de la fraîcheur impossible. Tout vide n'est pas une erreur, mais tout vide important appelle une interprétation définie.
La cohérence demande si les systèmes s'accordent. Si une application considère un client comme « actif » et qu'une autre applique une règle de statut différente, chaque table peut sembler cohérente isolément alors que la vue d'entreprise se contredit.
Les autres dimensions définissent l'utilisabilité
Timeliness mesure si les données arrivent assez fraîches pour leur usage. Un rapport de planification quotidien et un workflow antifraude en temps réel n'ont pas les mêmes attentes.
La validité vérifie si les valeurs respectent les formats et règles requis. Les dates doivent être interprétables comme des dates, les identifiants suivre des motifs acceptés et les valeurs de statut appartenir à un ensemble approuvé.
L'unicité empêche des enregistrements dupliqués ou redondants de modifier des comptages, des soldes ou des historiques clients.
Ces dimensions ne sont pas interchangeables. Un jeu de données peut être exact mais tardif, complet mais incohérent, ou à l'heure mais invalide. C'est pourquoi un score de qualité unique masque souvent le problème sous-jacent.
La tâche concrète consiste à définir la qualité par cas d'usage. Un rapport réglementaire privilégiera la complétude, la validité et l'auditabilité. Un modèle de recommandation aura peut-être besoin de représentativité, d'actualité et d'équilibre en plus de l'exactitude. Les dimensions de la qualité des données donnent aux équipes un vocabulaire pour transformer des inquiétudes vagues en attentes vérifiables.
Comment la mauvaise qualité des données nuit au métier et à la technique
Un enregistrement défectueux peut traverser une organisation plus vite que son propriétaire ne s'en aperçoit. Il entre dans un pipeline, modifie un agrégat, apparaît dans un tableau de bord, influence une décision et devient parfois, plus tard, une donnée d'entraînement. Chaque transmission ajoute un endroit de plus où le défaut initial peut être masqué, recopié ou confié à quelqu'un d'autre.
L'estimation largement citée de Gartner situe le coût moyen de la mauvaise qualité des données à 12,9 millions USD par an et par organisation (impact économique de la mauvaise qualité des données). La dépense apparaît sous forme de rapprochements manuels, de processus en échec, de rebut, de reprises, de décisions retardées et de chiffre d'affaires manqué. Les bénéfices métier de la qualité des données apparaissent plus clairement lorsque la qualité est traitée comme une surface de contrôle de ces coûts et pas seulement comme une opération de nettoyage.
Des travaux résumés dans un article évalué par les pairs rapportent que la mauvaise qualité des données peut absorber 8 % à 12 % du chiffre d'affaires dans certaines études propriétaires, tandis que d'autres estimations situent le coût entre 15 % et 25 % du chiffre d'affaires pour de nombreuses entreprises (discussion évaluée par les pairs sur les coûts de la qualité des données). Les méthodes et les organisations diffèrent, mais le mécanisme reste le même. Une information défectueuse affecte les marges et l'exécution, pas seulement l'apparence d'un rapport.
Où le dommage apparaît
Les équipes en observent généralement les effets sous des formes reconnaissables :
Fuite de revenus : des enregistrements dupliqués, manquants ou mal classés peuvent fausser l'activité client et masquer des opportunités.
Reprise opérationnelle : analystes et ingénieurs rapprochent des résultats contradictoires au lieu d'améliorer les systèmes sous-jacents.
Latence de décision : les dirigeants attendent la vérification des chiffres avant d'approuver une action.
Dérive des tableaux de bord : des sources périmées ou incohérentes font diverger les rapports et affaiblissent la confiance.
Distorsion des modèles : les workflows d'entraînement et de scoring utilisent des entrées qui ne représentent plus les conditions d'exploitation.
Le délai de détection change l'économie du problème. Un défaut trouvé à l'ingestion ne demande parfois qu'une correction. Le même défaut trouvé après le reporting, l'exécution des commandes ou le scoring d'un modèle peut imposer une investigation sur plusieurs systèmes et équipes.
Le terme technique pour cette interruption est souvent data downtime. Un cadre ETSI pour mesurer la qualité des données décrit un modèle actionnable fondé sur le nombre d'incidents multiplié par les temps de détection et de résolution. Une détection et une résolution plus rapides réduisent la charge et la perturbation, même quand des données parfaites ne sont pas immédiatement atteignables. Les règles de prévention ont la même valeur : elles arrêtent les défauts récurrents avant que chaque transmission en aval n'engendre de nouvelles reprises.
Une enquête portant sur 20 000 organisations d'au moins dix salariés a établi que la mauvaise qualité des seules données relationnelles engendrait environ 400 millions d'euros de surcoûts annuels aux Pays-Bas (recherche empirique sur l'impact métier de la qualité des données). Des défaillances locales répétées peuvent donc devenir des coûts à l'échelle de l'entreprise.
La question concrète est de savoir à quelle vitesse une équipe peut détecter un changement, en contenir les effets et confier la correction à quelqu'un avant que le défaut n'atteigne une décision.
Pourquoi la qualité des données compte encore plus pour l'IA et la gouvernance
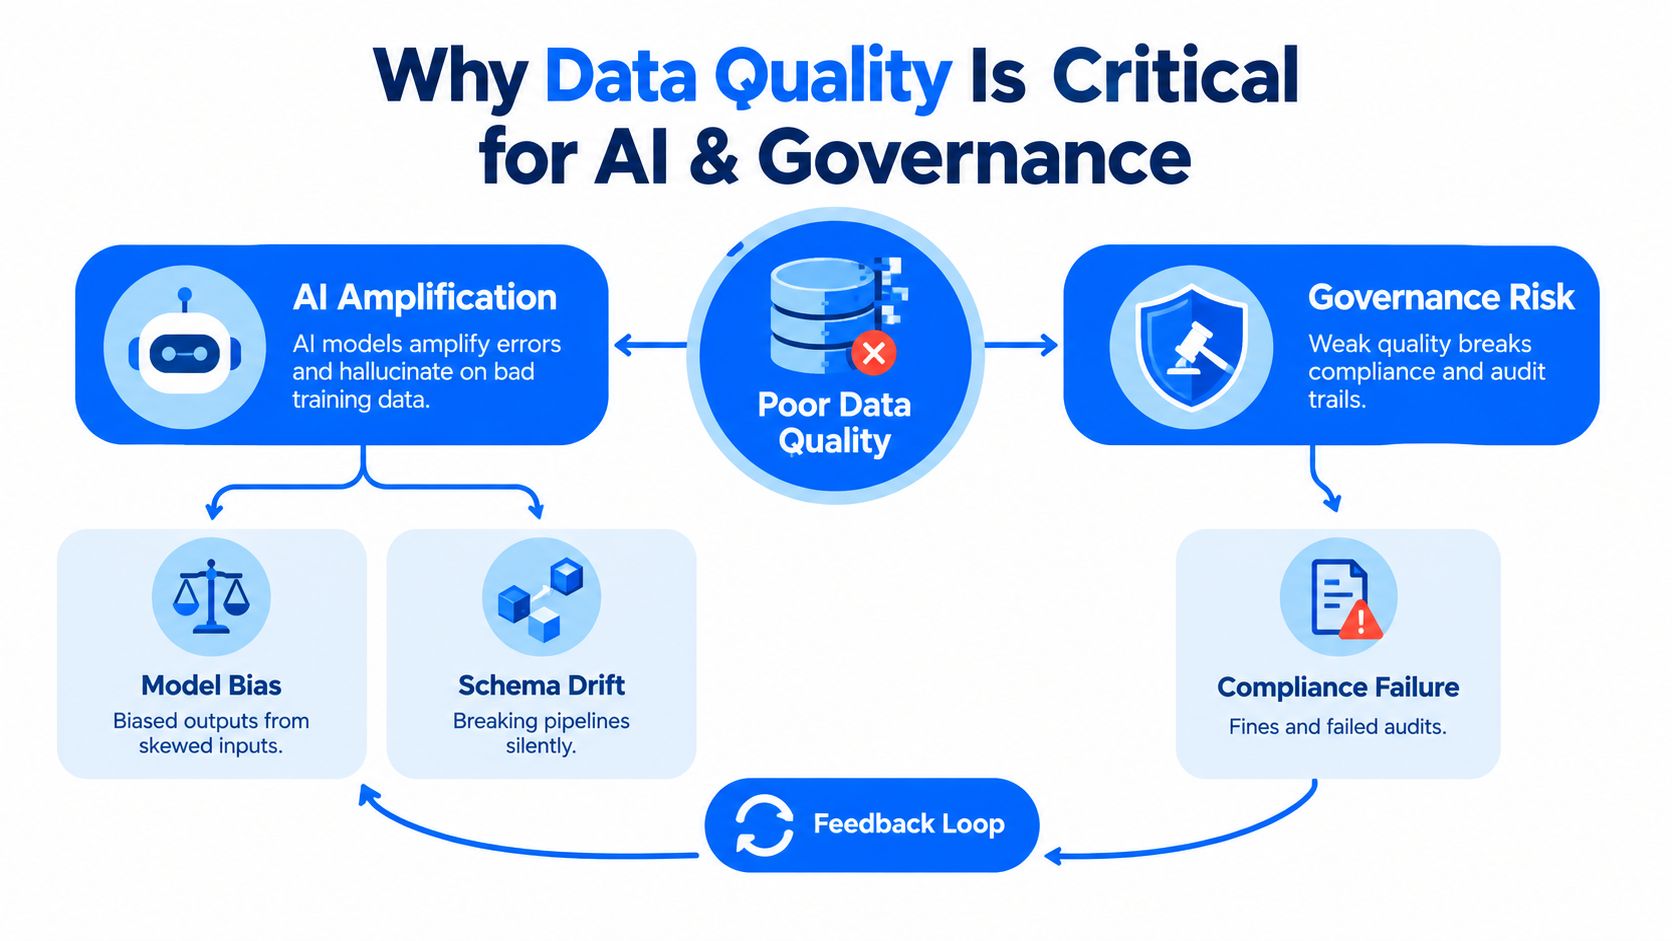
L'IA peut transformer un petit défaut de données en une action métier assurée. Le reporting classique expose parfois une erreur évidente quand un total ne se réconcilie pas ou qu'un tableau de bord est périmé. Un système d'IA peut au contraire convertir cette même entrée défectueuse en classification, recommandation, texte généré ou décision automatisée qui paraît raisonnable.
La maturité IA dépend de bien plus que de valeurs exactes. Les équipes doivent savoir si les données sont actuelles, équilibrées, représentatives, accessibles, auditables et traçables tout au long de leur cycle de vie. Un modèle peut bien se comporter sur un jeu de test étroit, puis échouer lorsque les données de production changent ou que des cas sous-représentés entrent dans le workflow. La qualité des données derrière un modèle d'IA détermine la confiance que mérite sa sortie.
L'IA amplifie les défauts dans les workflows
Un champ manquant n'affecte parfois qu'un seul rapport. Dans un workflow d'apprentissage automatique, la même omission peut influencer la création de variables, l'entraînement, l'évaluation et le scoring en production. Un changement de schéma peut arrêter un pipeline, ou passer sans bruit tout en modifiant le sens d'une variable.
La gouvernance ajoute une exigence de preuve. Les équipes doivent montrer quelles données un système a utilisées, quelles règles se sont appliquées, quand les données sont arrivées et comment un incident a été traité. Sans cette trace, expliquer une décision automatisée devient difficile même lorsque le résultat semble plausible.
ISO/IEC 5259-5:2025 définit un cadre de gouvernance de la qualité des données pour l'analytique et l'apprentissage automatique sur tout le cycle de vie de la donnée. Ses dimensions incluent l'accessibilité, l'auditabilité, l'actualité, l'exactitude, la fraîcheur, l'équilibre, la diversité et la représentativité (cadre ISO/IEC 5259-5:2025).
La maturité est une aptitude démontrable
Une étude de marché citée avec la norme a révélé que seules 12 % des organisations estimaient leurs données suffisamment qualitatives et accessibles pour une mise en œuvre efficace de l'IA, tandis que 64 % désignaient la qualité des données comme leur principal enjeu d'intégrité. Ces chiffres signalent un écart de maturité, pas une exigence de données irréprochables partout.
L'objectif concret est l'usage maîtrisé. Définissez les dimensions qui comptent pour chaque modèle, surveillez-les en continu, conservez les preuves et arrêtez ou mettez en quarantaine les données hors des limites convenues. La gouvernance fonctionne mieux lorsqu'elle est reliée aux pipelines qui créent et consomment les données : les équipes détectent alors les problèmes tôt et évitent des coûts récurrents en aval, au lieu de traiter la qualité comme une paperasse post-déploiement.
Exemples réels de risque quand la qualité des données fait défaut
Une défaillance de qualité peut rester invisible pendant que les systèmes continuent de fonctionner normalement. L'impact métier dépend moins de l'existence d'une erreur que de la durée pendant laquelle elle reste disponible pour les consommateurs en aval.
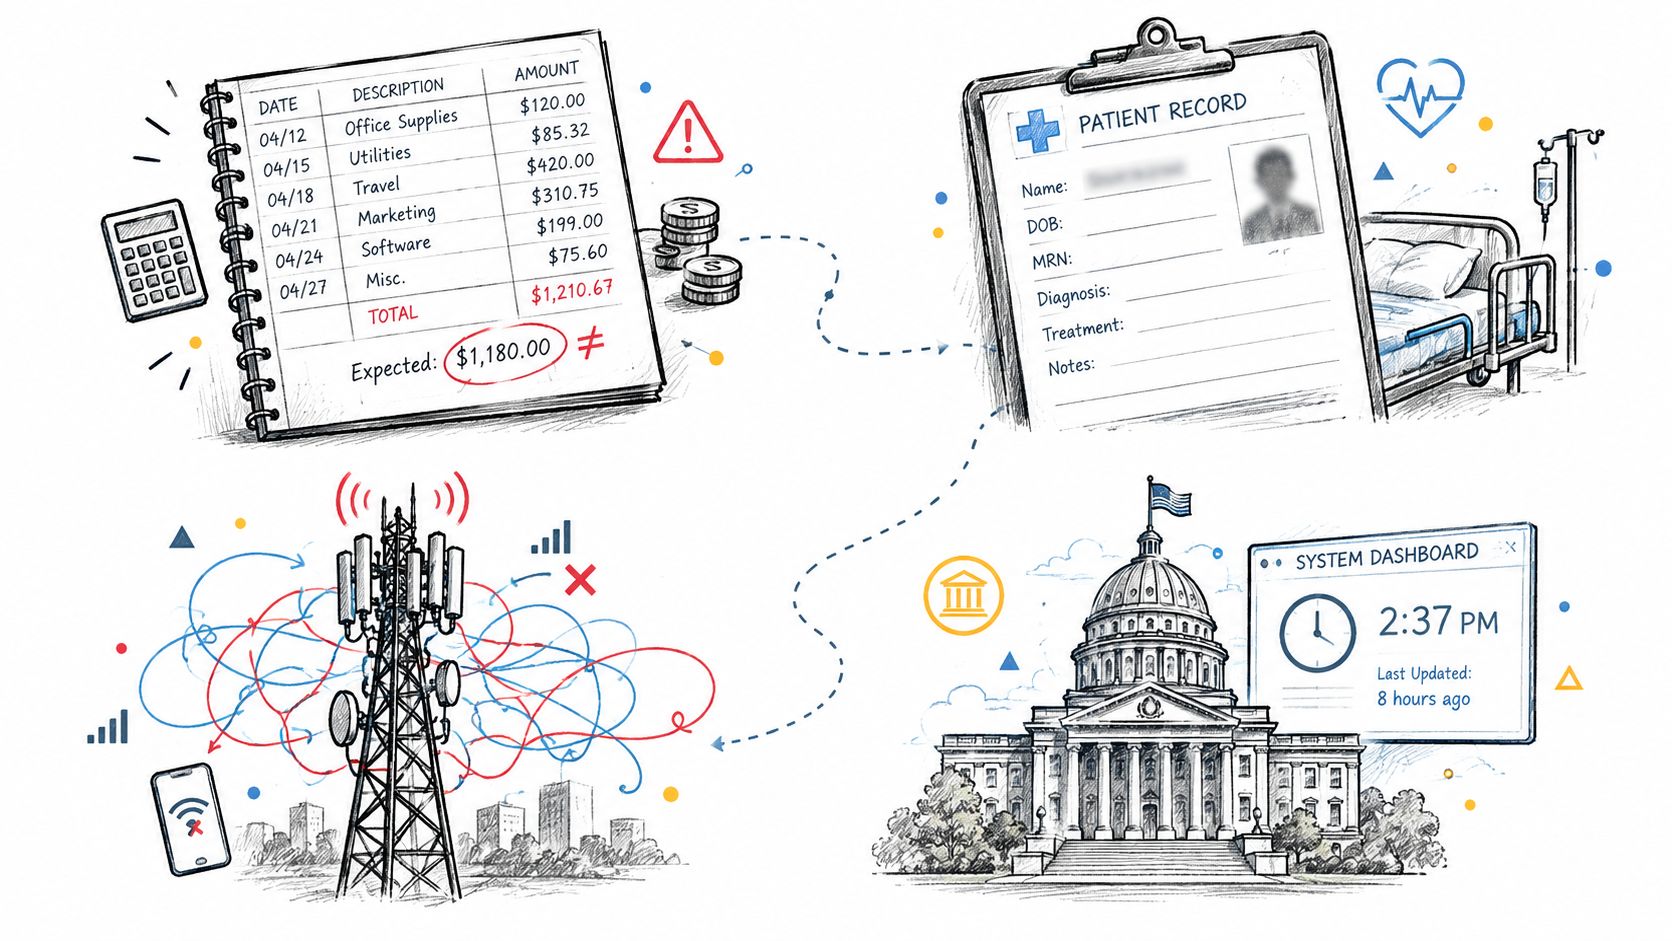
En finance, un chargement de transactions tardif peut rendre un tableau de bord de risque plus rassurant que le portefeuille sous-jacent. En santé, des attributs patients manquants ou incohérents peuvent compliquer le reporting clinique et les déclarations réglementaires. Dans les télécommunications, un changement de schéma dans les données d'usage peut modifier la logique d'agrégation et laisser les équipes analyser une activité client incomplète. Dans le secteur public, des identifiants incohérents peuvent empêcher un rapprochement fiable entre administrations.
Ces défaillances n'exigent aucune panne spectaculaire. Un rapport peut s'actualiser correctement en omettant une partition. Un pipeline peut accepter un nouveau type de donnée alors que la logique en aval l'interprète mal. Un modèle peut continuer à scorer après un décalage de sa distribution d'entrée, produisant des résultats d'apparence valide qui ne soutiennent plus la même décision.
Réparation réactive contre contrôle précoce
La règle 1-10-100 illustre l'effet économique du temps de détection. Il en coûte environ 1 USD pour prévenir une erreur de données, 10 USD pour la corriger une fois entrée dans le système et 100 USD pour la traiter si elle reste sans contrôle (modèle de coût 1-10-100 de la qualité des données).
Approche | Ce qui se passe | Conséquence habituelle |
|---|---|---|
Contrôle préventif | Une règle ou un contrat bloque une valeur invalide avant publication | Le problème reste proche de sa source |
Détection précoce | La surveillance repère une valeur inhabituelle, un retard ou un changement structurel | Une équipe plus restreinte peut enquêter avant l'usage en aval |
Remédiation réactive | Les utilisateurs découvrent le problème dans un rapport, un modèle ou un processus métier | Le rapprochement, la reprise et la reconquête de la confiance prennent plus de temps |
Des données parfaites ne sont pas l'exigence opérationnelle. L'objectif concret est de repérer les défauts tant qu'ils restent locaux, avant que rapports, modèles et processus métier n'en dépendent.
Les données sectorielles résumées par TechTarget indiquent que le nombre mensuel moyen d'incidents est passé de 59 à 67 entre 2022 et 2023, tandis que la part moyenne du chiffre d'affaires touché progressait de 26 % à 31 % (données sur les incidents et l'impact sur le chiffre d'affaires). Dans ce contexte, les chiffres posent une question de prévention : à quelle vitesse une équipe peut-elle détecter un défaut, identifier les consommateurs exposés et interrompre tout usage ultérieur ? Une détection plus rapide limite le nombre de systèmes à corriger et maintient la remédiation près de la source.
Contrôler la qualité des données avec la validation, Timeliness et la surveillance
Un programme de qualité praticable combine des contrôles à différents points du cycle de vie de la donnée. La validation prévient les violations de règles connues. La détection d'anomalies repère les comportements que les règles ne décrivent pas. La surveillance Timeliness identifie les défauts de livraison, tandis que le suivi de schéma détecte les changements structurels susceptibles de casser les consommateurs.
Commencer par des attentes explicites
La validation au niveau enregistrement est l'outil adapté aux conditions déterministes. Vérifiez les champs obligatoires, les valeurs acceptées, l'unicité, l'intégrité référentielle, les relations entre dates et les règles métier. Un enregistrement de paiement peut exiger une référence de compte valide. Une commande peut exiger une quantité non négative et une date de livraison postérieure à la date de commande.
La détection d'anomalies répond à une autre question : le comportement d'aujourd'hui diffère-t-il du motif établi ? Un seuil statique peut manquer une dérive progressive ou signaler une variation saisonnière normale. L'apprentissage de lignes de base aide à repérer des volumes, des distributions ou des mouvements de métriques inhabituels sans obliger les ingénieurs à écrire toutes les règles imaginables.
Surveiller la livraison et la structure
La surveillance Timeliness doit refléter l'usage que les consommateurs font des données. Suivez l'arrivée attendue, les chargements manquants, les partitions tardives et les livraisons anormalement précoces. Un jeu de données qui arrive après une décision matinale peut être techniquement complet et opérationnellement inutile.
Le suivi de schéma surveille les colonnes ajoutées ou supprimées, les champs renommés et les modifications de type. Il donne aux producteurs et aux consommateurs l'occasion de se coordonner avant qu'un changement structurel n'altère un tableau de bord ou un modèle.
Règle pratique : détectez la défaillance au plus près du point où elle entre dans le système, puis acheminez l'alerte vers la personne capable de la corriger.
Un tableau de bord partagé permet aux ingénieurs data, aux analystes et aux responsables métier de voir le même incident, le même historique et le même statut. L'exécution in-database peut maintenir le calcul des métriques dans l'environnement du client, réduisant les déplacements de données inutiles et alignant la surveillance sur les exigences de sécurité. Les équipes peuvent combiner ces pratiques avec l'approche des règles de validation des données et de la qualité continue.
Étape | Coût relatif | Impact métier |
|---|---|---|
Prévenir | Environ 1 USD | Arrête une erreur avant qu'elle ne se propage |
Détecter et corriger tôt | Environ 10 USD | Limite les systèmes touchés et réduit l'effort d'investigation |
Remédier après la défaillance | Environ 100 USD | Allonge les reprises, retarde les décisions et abîme la confiance |
L'ordre compte. La prévention protège le processus, la détection protège la décision, et la remédiation restaure le système une fois le dommage déjà propagé.
Conclusion : bâtir la confiance dans les données pour l'analytique et l'IA
Un programme de qualité fiable commence par un choix, pas par une liste de contrôle. Sélectionnez les trois jeux de données dont la défaillance toucherait le plus gravement le chiffre d'affaires, la conformité, les opérations ou un système d'IA. Ils deviennent le premier terrain d'essai de contrôles assez précis pour soutenir des décisions.
Pour chacun, notez la décision qu'il soutient, l'heure d'arrivée acceptable et les conditions qui rendent un enregistrement exploitable. Désignez un responsable capable d'agir quand ces conditions ne sont plus remplies. La validation vérifie alors l'aptitude des données à leur usage, tandis que les contrôles Timeliness confirment qu'elles sont disponibles au moment où la décision l'exige.
Posez le même petit ensemble de questions pour chaque jeu de données :
Aptitude : quels champs, valeurs et relations doivent être exacts, complets, valides, cohérents et uniques ?
Timeliness : quel retard les données peuvent-elles prendre avant d'affecter la décision qu'elles soutiennent ?
Responsabilité : qui enquête sur l'alerte, corrige la source et confirme le rétablissement ?
Preuve : quelle trace documente la défaillance, la réponse et le résultat ?
Cette approche évite un piège fréquent : consacrer le même effort à chaque table. Un jeu exploratoire à faible impact peut attendre, tandis qu'une métrique financière, un flux réglementaire ou un modèle en production passe en premier. L'objectif n'est pas d'avoir des données parfaites partout. C'est d'avoir des données fiables là où les erreurs portent à conséquence, avec des contrôles testables et perfectibles.
digna soutient ce modèle opérationnel comme plateforme de qualité des données et d'observabilité exécutée dans l'environnement du client. Ses modules apportent la détection d'anomalies, la validation au niveau enregistrement, la surveillance Timeliness, le suivi des changements de schéma, l'analyse historique et une visibilité partagée sur les entrepôts, les lacs et les pipelines, sans sortir les données de production de l'environnement du client.
Rendez-vous sur digna pour voir comment sa plateforme modulaire peut aider votre équipe à valider les enregistrements critiques, suivre la ponctualité des livraisons, détecter les anomalies et repérer les changements de schéma au sein de votre propre infrastructure. Commencez par documenter les trois jeux de données prioritaires, puis étendez la surveillance à mesure que l'équipe identifie les contrôles qui préviennent les défaillances les plus lourdes.
Timeliness est la dimension que les équipes laissent le plus souvent indéfinie, et c'est elle qui décide si un jeu de données correct reste utile au moment de la décision — pour les métriques et les schémas de surveillance qui la sous-tendent, consultez le guide digna de Data Timeliness.
Questions fréquentes
Pourquoi la qualité des données est-elle importante pour le ROI de l'entreprise ?
Parce que les défauts voyagent. Un enregistrement client en double peut gonfler la demande et un chargement de transactions tardif peut fausser le reporting de trésorerie. Gartner situe le coût moyen de la mauvaise qualité des données à 12,9 millions USD par an, et des travaux cités par MIT Sloan estiment la perte de chiffre d'affaires entre 15 % et 25 % pour de nombreuses entreprises.
Combien coûte la correction d'un problème de qualité des données une fois qu'il s'est propagé ?
La règle 1-10-100 sert de repère : environ 1 USD pour prévenir une erreur, 10 USD pour la corriger une fois entrée dans le système et 100 USD pour la traiter si elle reste sans contrôle. C'est le délai de détection, et non la taille du défaut, qui explique l'essentiel de ce coût.
Quelles sont les dimensions de la qualité des données ?
L'exactitude, la complétude, la cohérence, Timeliness, la validité et l'unicité. Elles ne sont pas interchangeables : un jeu de données peut être exact mais tardif, complet mais incohérent, ou à l'heure mais invalide. C'est pourquoi un score de qualité unique masque le plus souvent le problème qu'il faudrait corriger.
Pourquoi la qualité des données compte-t-elle davantage pour l'IA que pour le reporting ?
Le reporting expose souvent une erreur quand un total ne se réconcilie pas ou qu'un tableau de bord se périme. Un système d'IA transforme au contraire la même entrée défectueuse en une classification ou une recommandation énoncée avec assurance. Seules 12 % des organisations jugent leurs données suffisamment qualitatives et accessibles pour une mise en œuvre efficace de l'IA.
Comment lancer un programme de qualité des données ?
Choisissez les trois jeux de données dont la défaillance toucherait le plus le chiffre d'affaires, la conformité ou un modèle en production. Pour chacun, notez la décision qu'il soutient, le retard admissible et les conditions qui rendent un enregistrement exploitable, puis désignez un responsable qui agit lorsque ces conditions ne sont plus remplies.


