Fiabilité de la qualité des données : comment les équipes la mesurent vraiment
|
8
minute de lecture

Le lundi matin commence par un succès familier. Le tableau de bord du chiffre d'affaires se charge, les totaux se réconcilient avec la finance et tous les graphiques sont au vert avant la revue de direction. Personne ne voit que des transactions mobiles tardives sont encore en cours de rattrapage, qu'un job de sessionisation a perdu des partitions et qu'un champ renommé produit bien plus de valeurs nulles que sa ligne de base. Le tableau de bord paraît fiable parce que la sortie visible s'est affichée, non parce que la chaîne de livraison est restée fiable.
Cette distinction compte dès lors que l'analytique, les opérations et les systèmes d'IA consomment les mêmes pipelines. La fiabilité de la qualité des données n'est pas une liste de contrôle appliquée après coup à une table. C'est une propriété opérationnelle de toute la chaîne : fraîcheur, complétude, comportement du schéma, validité, lineage et gouvernance. Ce guide traite la fiabilité comme un sujet de production et montre comment la mesurer sans transformer chaque livraison en goulot d'étranglement de tests manuels.
Sommaire
La défaillance cachée derrière des tableaux de bord d'apparence fiable
Pourquoi qualité et fiabilité ne sont pas la même chose
L'erreur d'investissement
Les métriques qui mesurent réellement la fiabilité
Contrôles par règles, contrôles statistiques et détection d'anomalies par IA
Empilez-les par degré de certitude
Observabilité, contrôles in-database et validation qui travaillent ensemble
Garde-fous opérationnels qui empêchent les programmes de fiabilité de s'enliser
Acheminez les alertes vers le produit de données
Séparez les niveaux de service
Gardez les contrôles dans le chemin de livraison
Ce qu'exige vraiment une fiabilité des données prête pour l'IA
Suivez toute la chaîne d'entrées de l'IA
Tout assembler et les prochaines étapes
La défaillance cachée derrière des tableaux de bord d'apparence fiable
Le premier problème apparaît dans le flux d'événements. Une version mobile modifie la façon d'émettre les transactions : certains enregistrements arrivent en retard plutôt que dans la fenêtre de traitement attendue. Le job d'ingestion réussit parce qu'il a reçu des données, mais celles-ci ne sont pas complètes au moment où les consommateurs en aval les lisent.
Ensuite, la sessionisation traite les partitions disponibles. Trois manquent, et pourtant la transformation produit une table. Les comptages quotidiens de lignes restent dans une large plage historique parce que le trafic desktop masque le trou côté mobile. L'actualisation du tableau de bord aboutit, et ses totaux peuvent encore se réconcilier avec la finance si celle-ci reçoit un rattrapage ultérieur ou utilise une autre date de coupure.
La troisième défaillance est structurelle. Un champ en amont est renommé et la transformation conserve la colonne via un chemin de compatibilité. Le taux de valeurs nulles du champ augmente, mais aucune alerte ne compare ce changement à une ligne de base connue. Les variables d'attribution contiennent désormais moins d'information exploitable, tandis que le modèle de churn continue de s'entraîner comme si la variable avait gardé son sens initial.
Un tableau de bord au vert prouve qu'une requête s'est exécutée et a renvoyé un résultat. Il ne prouve pas que les bonnes données sont arrivées, que chaque transformation s'est comportée correctement, ni que les consommateurs les ont reçues dans la fenêtre requise.
C'est pourquoi des équipes peuvent faire confiance à la surface visuelle et prendre malgré tout des décisions peu fiables. Un rapport peut être numériquement cohérent avec un système de référence tout en restant incomplet, périmé ou sémantiquement abîmé pour un autre cas d'usage. Un modèle peut aussi absorber la dégradation bien avant que quiconque ne remarque une erreur visible de reporting.
La réponse concrète consiste à surveiller la chaîne de livraison, pas seulement la table finale. Un tableau de bord a besoin de preuves de fraîcheur, de complétude des partitions, d'un historique de schéma, d'un contexte de lineage et d'une responsabilité attribuée pour chaque actif critique en amont. Les équipes qui ne regardent que les symptômes du tableau de bord trouveront des compléments sur les tableaux de bord de qualité des données, mais le vrai correctif consiste à identifier quel contrôle a échoué avant que le tableau de bord ne devienne trompeur.
Pourquoi qualité et fiabilité ne sont pas la même chose
La qualité des données décrit si les données respectent les conditions attendues. Une valeur peut être valide, non nulle, correctement typée, comprise dans une plage autorisée et reliée à un enregistrement de référence existant. Ces contrôles examinent le contenu et la structure des enregistrements.
La fiabilité des données demande si les consommateurs peuvent s'appuyer sur les données dans la durée et tout au long du processus de livraison. Elle inclut la qualité, mais demande aussi si les données attendues sont arrivées, si le pipeline les a rendues disponibles dans sa fenêtre de service, si leur lineage est connu et si les changements ont été communiqués et maîtrisés.
L'analogie de la brique rend la différence concrète. La qualité demande si chaque brique est solide et correctement formée. La fiabilité demande si le mur arrive à l'heure, comporte toutes ses assises, possède une origine connue et tient encore quand les conditions changent.
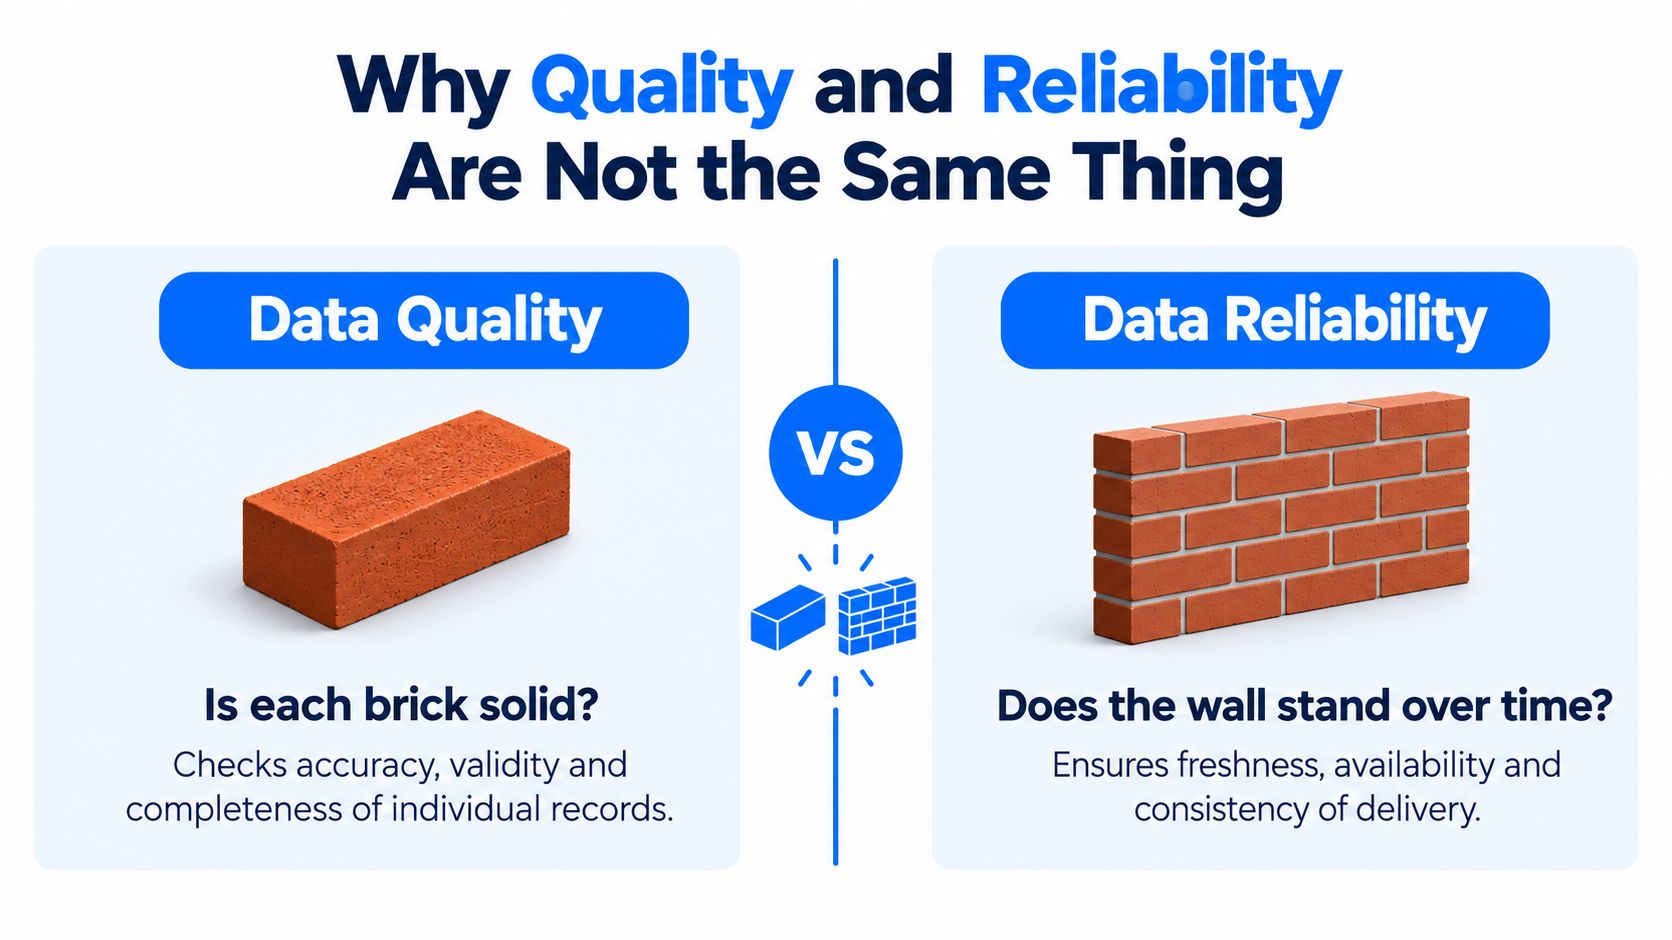
Une table peut passer la validation au niveau ligne et échouer en tant que produit fiable. Chaque enregistrement arrivé peut porter un identifiant client valide, alors qu'une partition entière manque. Un validateur de schéma peut confirmer qu'une colonne existe, alors que le lineage est rompu et que personne ne sait quelle source l'a produite. Un jeu de données peut être exact au repos et rester trop périmé pour une décision opérationnelle.
L'erreur d'investissement
Quand les équipes traitent qualité et fiabilité comme des synonymes, elles achètent ou construisent souvent les mauvais contrôles. Elles ajoutent des contrôles de nullité, des assertions de type et des règles métier tout en laissant les attentes de fraîcheur indéfinies. Elles inspectent les valeurs dans l'entrepôt mais ne surveillent ni les partitions tardives, ni la durée d'exécution, ni les dépendances amont, ni l'impact aval.
Il en résulte un système de contrôle déséquilibré. Les contrôles déterministes protègent la brique, tandis que personne ne vérifie si le mur est complet ni s'il est arrivé quand le consommateur en avait besoin. Le résultat : une grande collection de tests réussis attachée à un produit peu fiable.
La fiabilité a donc besoin de définitions de service de bout en bout. Producteur et consommateur doivent s'accorder sur ce qui doit arriver, à quelle échéance, sous quelle forme, avec quelles contraintes métier et avec quelles preuves de lineage. La qualité au niveau ligne reste essentielle, mais devient un élément d'un contrat de livraison plutôt que la définition entière de la confiance.
Les métriques qui mesurent réellement la fiabilité
La fiabilité en production devient gérable lorsque les équipes traduisent leurs attentes en signaux observables. Cinq métriques couvrent les principaux modes de défaillance : fraîcheur, complétude, stabilité du schéma, validité et dérive de distribution. Elles ne doivent pas être traitées comme des valeurs universelles de réussite ou d'échec. Chaque seuil relève d'un contrat qui reflète la tolérance du consommateur et le rôle de l'actif.
La fraîcheur mesure l'écart entre la disponibilité attendue d'un événement et son arrivée réelle. Une implémentation utile compare des horodatages de haute eau à une fenêtre de niveau de service, puis alerte quand une partition est en retard ou manquante. Les guides techniques sur la surveillance de la fraîcheur décrivent cette approche fondée sur les SLA, plutôt que de traiter un horodatage comme une preuve suffisante de bonne santé.
La complétude compare ce qui aurait dû arriver à ce qui est arrivé. Le contrôle doit opérer au niveau de la partition ou de l'unité de livraison, car un ensemble complet de lignes à l'intérieur d'une journée incomplète peut tout de même produire un résultat trompeur. Une alerte peut se déclencher quand une partition attendue est absente ou quand le volume livré sort de la bande d'exploitation convenue.
La stabilité du schéma suit les ajouts, suppressions, renommages et changements de type par rapport à une ligne de base ou à un contrat explicite. Ces changements peuvent casser des transformations, modifier un sens ou augmenter les taux de valeurs nulles sans provoquer d'échec immédiat du pipeline. Azure Databricks expose des champs de dérive tels que count_delta, avg_delta, percent_null_delta, percent_zeros_delta, percent_distinct_delta et non_null_columns_delta, montrant comment quantifier les changements structurels et de distribution dans une table de comparaison. La documentation Azure Databricks sur les métriques de dérive explique ce modèle de sortie.
La validité confronte les valeurs aux contraintes et aux règles métier. Elle couvre la nullité, les plages, les catégories autorisées, les formats, les attentes d'unicité et l'intégrité référentielle. Une condition d'alerte réaliste peut être toute violation d'une contrainte clé, tandis que des règles plus souples peuvent alerter lorsque le taux d'échec dépasse la tolérance convenue avec le consommateur.
La dérive de distribution mesure les mouvements du comportement des valeurs numériques, catégorielles et nulles. Elle attrape des changements qui passent les règles statiques, par exemple une catégorie légitime devenant anormalement dominante ou un champ habituellement rempli devenant clairsemé. Les incidents de dérive de schéma dépassant 5 % des champs ont été associés à une hausse de 30 % des problèmes de qualité signalés par les utilisateurs finaux, selon l'analyse des incidents de dérive de schéma d'Integrate.io. À utiliser comme signal de risque, pas comme seuil universel de production.
Métrique | Ce qu'elle mesure | Seuil habituel | Mode de défaillance détecté |
|---|---|---|---|
Fraîcheur | Latence d'arrivée attendue par rapport à la latence réelle | Une fenêtre de SLA définie, souvent avec un avertissement avant le dépassement ferme | Chargements tardifs, tableaux de bord périmés, variables retardées |
Complétude | Enregistrements ou partitions attendus par rapport aux livrés | Partitions requises présentes et volume livré dans une bande convenue | Tranches manquantes, chargements partiels, événements perdus |
Stabilité du schéma | Écart structurel par rapport à une ligne de base ou à un contrat | Aucun changement cassant non approuvé, avec revue des changements additifs | Renommages, suppressions, changements de type, casse en aval |
Validité | Conformité aux contraintes et aux règles métier | Les règles critiques doivent passer, avec des taux tolérés pour les règles non critiques | Clés invalides, valeurs impossibles, références erronées |
Dérive de distribution | Mouvement statistique dans le temps | Alerter quand le mouvement dépasse une ligne de base calibrée | Déplacements de population, pics de valeurs nulles, changements de catégorie |
Ces métriques forment un contrat entre producteurs et consommateurs. La question utile n'est pas de savoir si un jeu de données est de « bonne qualité ». C'est de savoir si la chaîne de livraison a rempli les conditions exigées par une décision, un modèle ou un rapport précis. Les équipes peuvent s'appuyer sur un cadre pratique pour mesurer la fiabilité afin de relier ces conditions à une surveillance au niveau des actifs.
Contrôles par règles, contrôles statistiques et détection d'anomalies par IA
Aucune méthode de détection isolée ne voit toutes les défaillances. Les contrôles par règles sont les plus efficaces quand le comportement attendu est explicite. Une clé non nulle, une valeur de statut approuvée, une référence valide ou un motif requis s'exprime clairement et s'évalue à faible coût aux frontières d'ingestion ou de transformation.
Les contrôles statistiques résolvent un autre problème. Ils établissent une ligne de base pour des comportements irréductibles à une règle déterministe : volume de lignes, valeur moyenne, variance, cardinalité, proportion de valeurs nulles ou moment d'arrivée. Une règle peut interdire les valeurs nulles dans une colonne, tandis qu'un contrôle statistique remarque que les valeurs nulles sont soudain devenues fréquentes alors que la colonne reste techniquement remplie.
La détection d'anomalies apprise par IA ajoute une troisième couche. Les modèles peuvent combiner plusieurs signaux et repérer des comportements corrélés que l'auteur des règles n'avait pas anticipés. Un décalage simultané du volume, de la fraîcheur, de la distribution et de la consommation aval peut signaler un problème de livraison même si aucun signal pris isolément ne franchit une limite fixée à la main.
Approche | Idéale pour | Limites | Couche |
|---|---|---|---|
Validation par règles | Garanties contractuelles et contraintes métier | Charge de maintenance quand la logique change, couverture limitée des comportements inconnus | Frontières d'ingestion et de transformation |
Contrôles statistiques | Dérive, saisonnalité, volume, latence et changements de distribution | Exige une ligne de base utile et un calibrage soigneux des faux positifs | Surveillance des jeux de données et des pipelines |
Détection d'anomalies par IA | Risque corrélé et émergent sur plusieurs signaux | Moins immédiatement explicable et dépendante d'un historique représentatif | Observabilité inter-signaux et priorisation |
Empilez-les par degré de certitude
Commencez par des règles pour les conditions qui ne doivent jamais être violées. Ces contrôles doivent échouer bruyamment quand une clé cassée ou une référence invalide rendrait la sortie dangereuse. Placez une surveillance statistique autour des métriques qui varient naturellement, puis réglez la sensibilité sur l'historique des incidents plutôt que sur une limite arbitraire.
La détection par IA mérite sa place quand l'environnement offre assez de contexte comportemental pour apprendre. Elle doit faire remonter des candidats à investigation, pas bloquer automatiquement chaque pipeline. La revue humaine reste de mise là où l'anomalie a un impact métier matériel, où la ligne de base évolue ou lorsque le système ne peut pas dire quel consommateur sera touché.
La bonne approche de détection d'anomalies pour les séries temporelles dépend du comportement du signal et de l'action attachée à l'alerte. Un avertissement bruyant sans responsable n'est pas de l'observabilité. C'est une file d'attente de plus que les ingénieurs vont ignorer.
Observabilité, contrôles in-database et validation qui travaillent ensemble
Imaginez un pipeline qui ingère des événements depuis Kafka, les transforme avec dbt et sert des tables curées depuis Snowflake. La fiabilité progresse quand l'équipe traite l'observabilité, les contrôles in-database et la validation métier comme une seule couche de contrôle répartie sur cette chronologie.
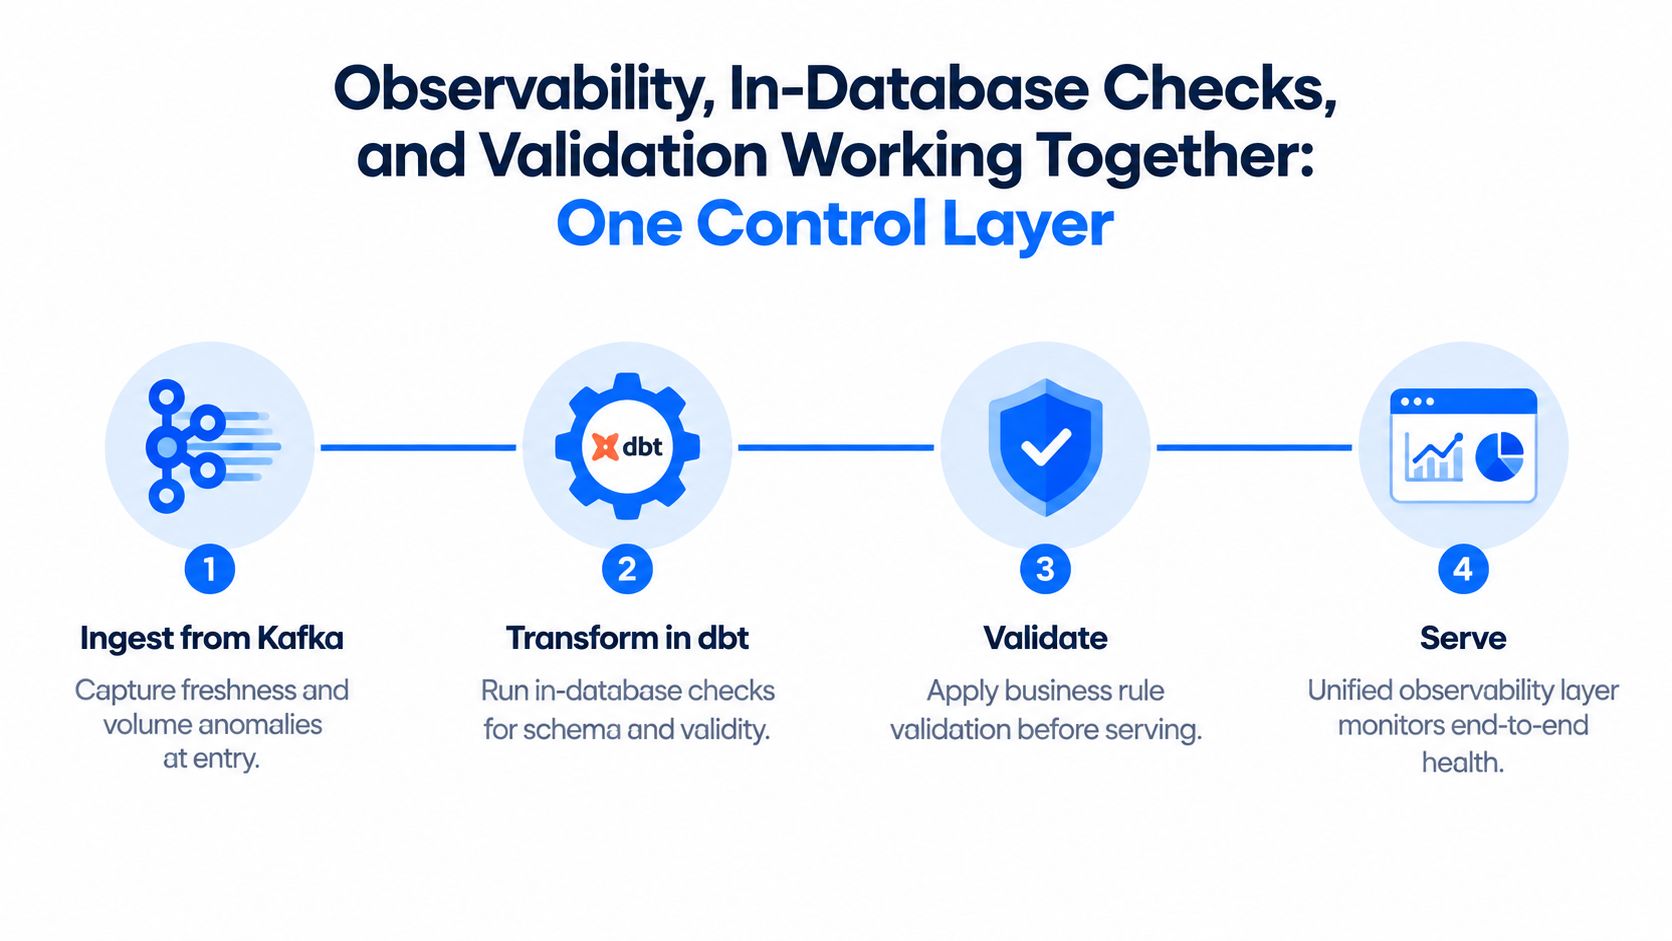
À l'ingestion, des contrôles légers comparent le moment d'arrivée et le volume au motif attendu. Les contraintes natives de l'entrepôt et les requêtes planifiées peuvent repérer des champs manquants, des types inattendus ou des comptages anormaux au plus près du stockage. Ces contrôles n'expliqueront pas tous les symptômes en aval, mais ils peuvent empêcher un problème structurel évident de se propager.
Pendant la transformation, les tests dbt font respecter les contrats de colonnes et les hypothèses métier. En parallèle, une couche d'observabilité surveille la durée d'exécution, les comptages de lignes, la santé des partitions, le lineage et le comportement des dépendances. Si un modèle se termine correctement mais produit une relation étonnamment petite, la télémétrie du pipeline apporte un contexte qu'une assertion de colonne ne peut pas fournir à elle seule.
Après la mise à disposition, l'équipe compare la consommation aval aux attentes amont. Un tableau de bord peut interroger avec succès tout en recevant une partition périmée : la chronologie de l'incident doit donc relier l'arrivée Kafka retardée, l'exécution dbt, l'état de la table Snowflake et le tableau de bord touché.
Les contrôles in-database voient les violations là où vivent les données. La validation voit si les données respectent le sens métier. L'observabilité voit comment le système environnant s'est comporté.
Le point d'intégration est un ensemble partagé d'indicateurs de niveau de service et un enregistrement d'incident commun. Chaque alerte devrait identifier l'actif, le producteur, le consommateur, la condition enfreinte, l'heure de première observation et le lineage connu. Les recommandations sur les règles de validation des données et la qualité continue aident à définir la couche de règles, mais la valeur opérationnelle apparaît quand cette couche partage son contexte avec la surveillance des pipelines.
Sans contexte partagé, les équipes échangent des captures d'écran entre outils et débattent pour savoir si la défaillance relève de Kafka, de dbt, de Snowflake ou du tableau de bord. Avec une chronologie unique, elles peuvent distinguer le déclencheur du symptôme et confier la remédiation à l'équipe qui maîtrise le contrat concerné.
Garde-fous opérationnels qui empêchent les programmes de fiabilité de s'enliser
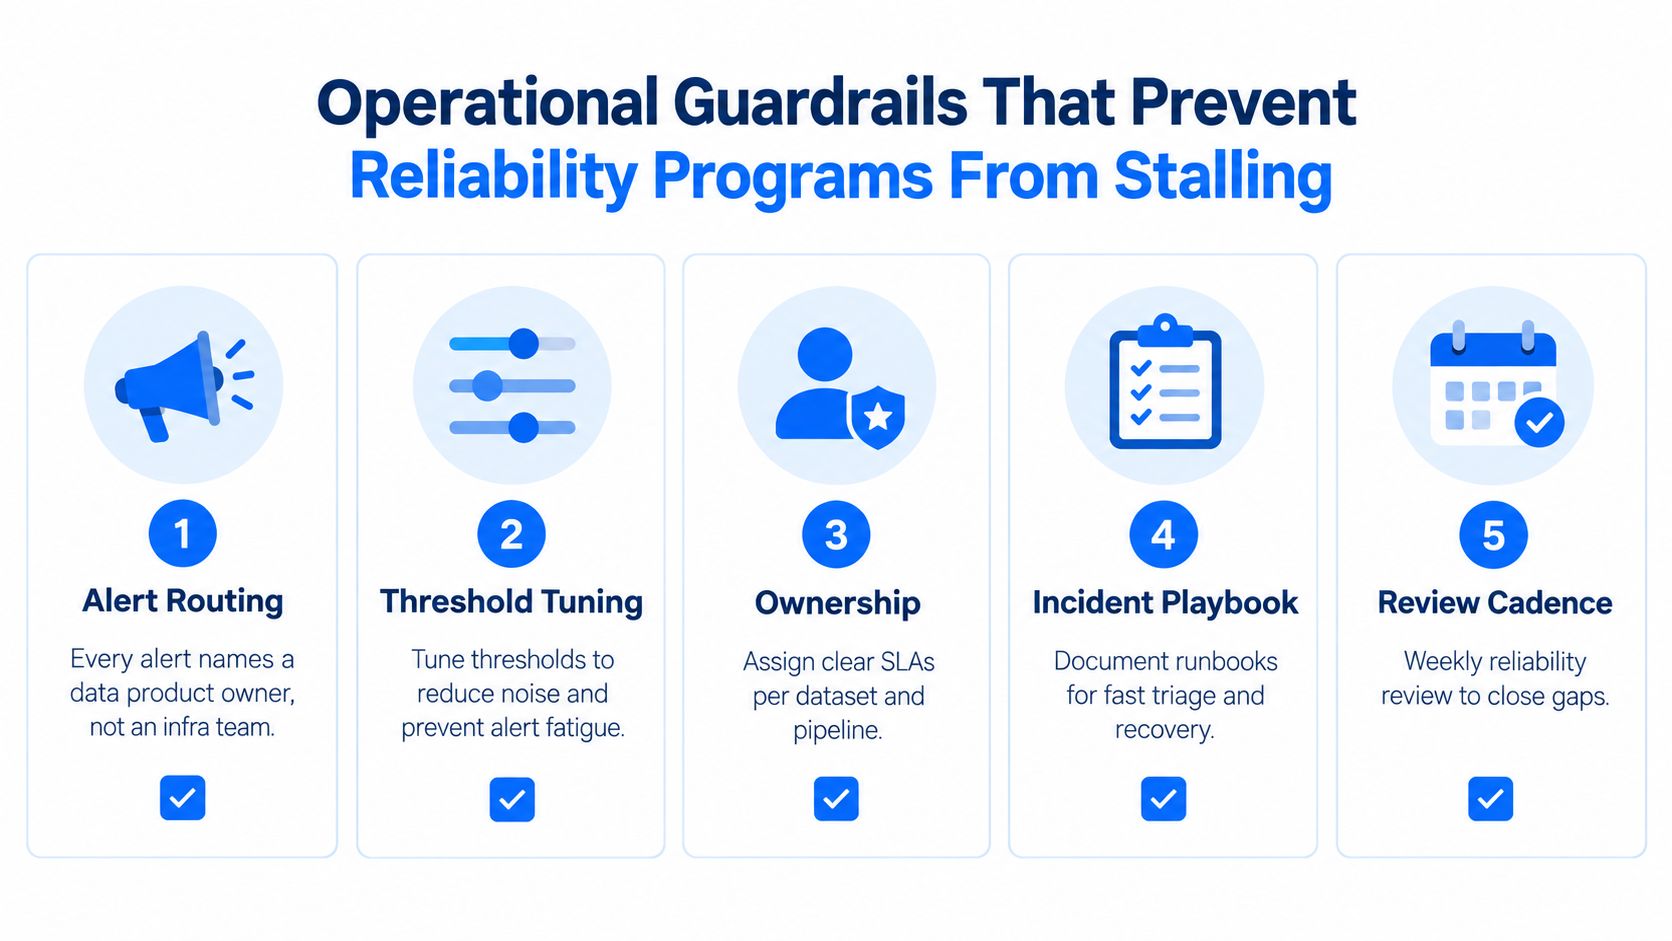
Les programmes de fiabilité s'enlisent généralement pour des raisons organisationnelles avant d'échouer techniquement. Les alertes partent dans une file d'infrastructure, les responsables des jeux de données ne sont pas nommés et chaque équipe définit « sain » à sa façon. Les garde-fous rendent le modèle opérationnel explicite.
Acheminez les alertes vers le produit de données
Une alerte doit nommer le produit de données concerné, son responsable et son consommateur aval. Les équipes d'infrastructure peuvent porter les capacités partagées d'exécution et de surveillance, tandis que les équipes analytiques intégrées ou métier portent les jeux de données dont elles maîtrisent le sens. Une responsabilité partagée sans répondant principal signifie généralement que personne n'agit vite.
Séparez les niveaux de service
Ne réduisez pas toutes les conditions à un score unique ni à un seul « SLA de qualité des données ». Définissez des attentes distinctes pour :
Fraîcheur : le retard d'ingestion admis, avec une fenêtre d'avertissement avant le dépassement ferme.
Exactitude : la part requise d'enregistrements passant les règles de validation critiques.
Disponibilité : l'achèvement attendu des exécutions planifiées du pipeline.
Impact : les consommateurs et processus métier touchés lors d'un dépassement.
Cette séparation aide les équipes à choisir la bonne réponse. Une table tardive mais par ailleurs correcte demandera un rattrapage, tandis qu'une table d'apparence valide avec une intégrité référentielle rompue demandera une quarantaine.
Gardez les contrôles dans le chemin de livraison
Les contrôles natifs de l'entrepôt, les tests dbt, les portes de changement de schéma et les tests de contrat évitent que la fiabilité devienne une phase de QA manuelle distincte. Le workflow de surveillance documenté d'AWS SageMaker sépare la capture des données, la création de la ligne de base et les jobs de surveillance planifiés, et sa ligne de base utilise Deequ pour calculer contraintes de schéma et statistiques. La documentation AWS sur la surveillance de la qualité des données du modèle donne un exemple concret de transformation des attentes en contrôles de production planifiés.
Surveillez trois anti-modèles :
Tableaux de bord sans responsable : une page d'état visuelle sans répondant crée de la prise de conscience sans action.
Érosion des seuils : les équipes élargissent progressivement les seuils jusqu'à ce que les alertes cessent de se déclencher, au lieu de corriger la ligne de base ou la source.
Théâtre de la fiabilité : des cases cochées satisfont un audit pendant que données tardives, lineage rompu et changements de schéma non revus continuent de toucher les consommateurs.
Passez en revue la qualité des alertes après chaque incident. Si une alerte n'a pas mené à une décision, changez son acheminement, son contexte, son seuil ou son action. L'objectif n'est pas la couverture maximale de surveillance. C'est une détection fiable reliée au rétablissement.
Ce qu'exige vraiment une fiabilité des données prête pour l'IA
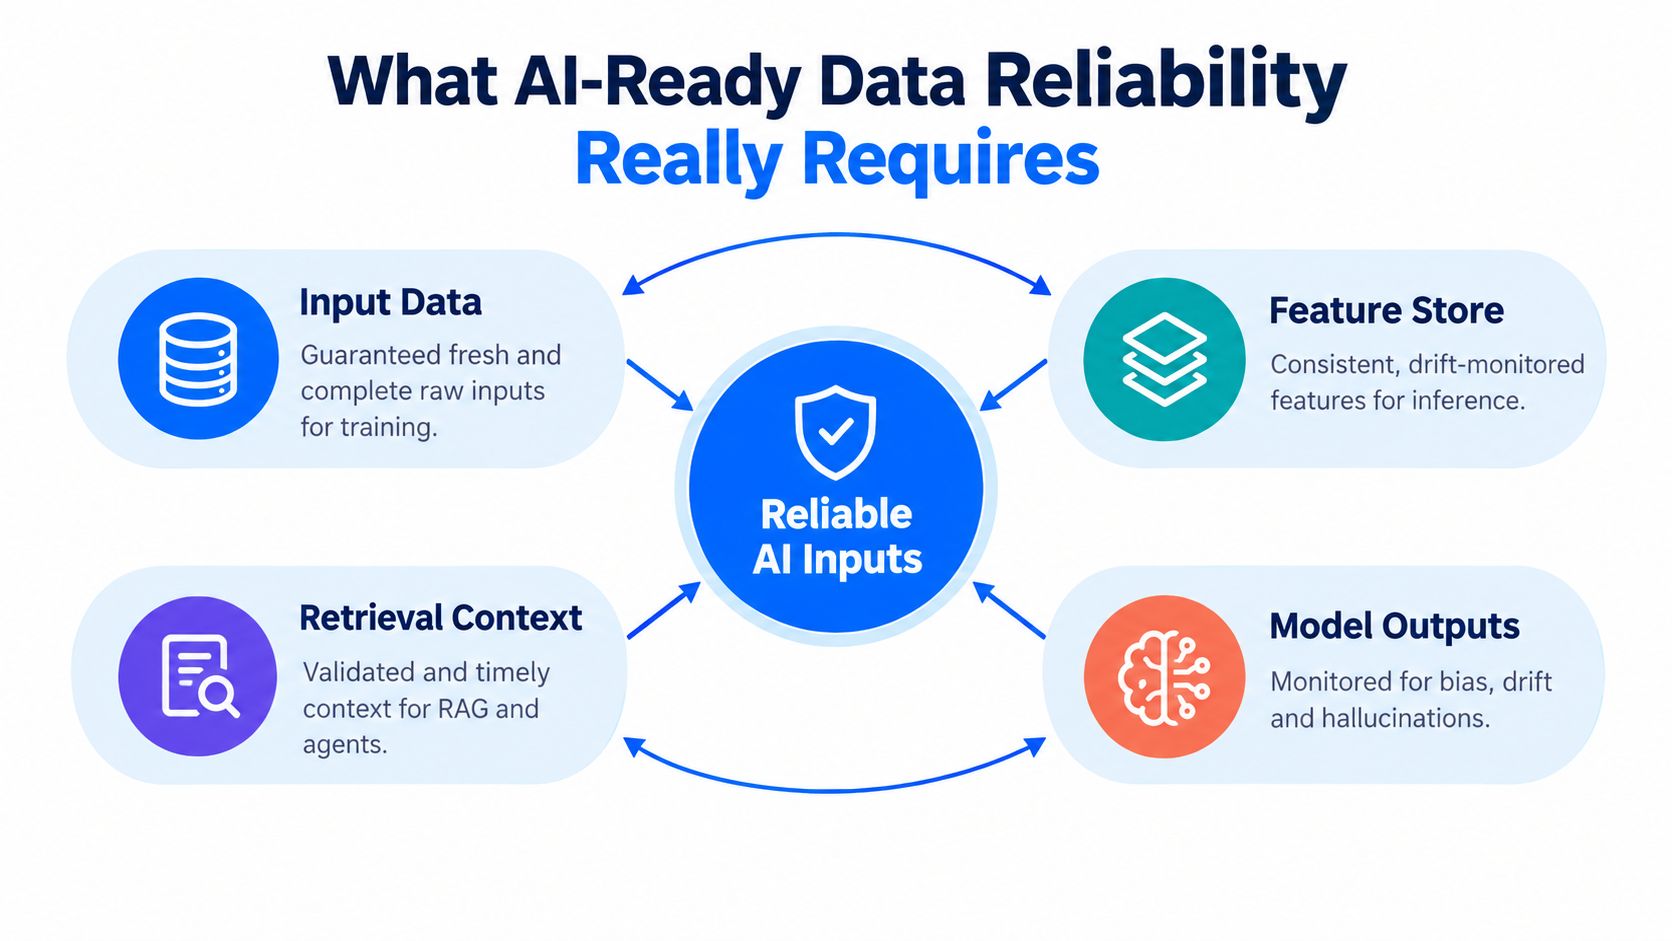
La maturité IA ne commence pas au déploiement d'un modèle. Elle commence avec la preuve que les entrées, les variables, le contexte de recherche et les sorties restent fiables en conditions de production.
Les publications récentes cernent l'écart avec netteté. 71 % des professionnels de la donnée citent les sorties erronées ou hallucinées parvenant aux parties prenantes parmi leurs premières préoccupations, tandis que PwC a constaté que seuls 51 % des répondants établissent une base de données propre et structurée avant de passer à l'échelle sur leurs initiatives numériques, comme le résume cet article sur l'accélération de l'IA et la confiance. Ces chiffres désignent un problème opérationnel, et pas seulement un problème d'évaluation de modèles.
Suivez toute la chaîne d'entrées de l'IA
Les entrées brutes ont besoin de garanties de fraîcheur et de complétude. Les feature stores ont besoin de définitions cohérentes et d'une surveillance de dérive alignée sur les fenêtres d'inférence. Les systèmes à génération augmentée par recherche et les agents ont besoin d'un contexte validé et à l'heure, y compris de la preuve que les documents n'ont pas été supprimés, modifiés ni tirés d'un emplacement non surveillé.
Le lineage doit relier les variables et le contenu récupéré à leurs sources et transformations. Sans cette traçabilité, une régression de la qualité d'un modèle peut se transformer en investigation sans fin. Les ingénieurs doivent savoir si le changement vient des données sources, de la logique des variables, de l'indexation, de la recherche ou du modèle lui-même.
Les sorties du modèle ont besoin de leur propre boucle de retour. Surveillez les signaux de biais, de dérive et d'hallucination là où ils sont évaluables, puis reliez les défaillances aux conditions des données amont. Les portes de promotion devraient bloquer ou suspendre une mise en production quand des SLA d'entrée critiques dérapent, plutôt que de laisser un modèle consommer des variables connues comme périmées.
Le cadre de l'ETSI reflète cette vision élargie en définissant 18 métriques mesurables de qualité des données incluant fiabilité, couverture, lineage, traçabilité et fraîcheur, selon la source citée. La maturité IA découle donc du programme de fiabilité qui protège déjà l'analytique et les opérations. Ce n'est ni un exercice de conformité à part ni une case finale d'exactitude. Le principe derrière la relation entre les modèles d'IA et la qualité des données est opérationnel : des entrées peu fiables produisent un comportement aval peu fiable, même lorsque le modèle lui-même n'a pas changé.
Tout assembler et les prochaines étapes
Un premier sprint de fiabilité doit être assez étroit pour être achevé et assez important pour compter. Choisissez un jeu de données critique pour le chiffre d'affaires, cartographiez ses dépendances amont et aval, et définissez les conditions qui le rendent sûr pour son consommateur principal.
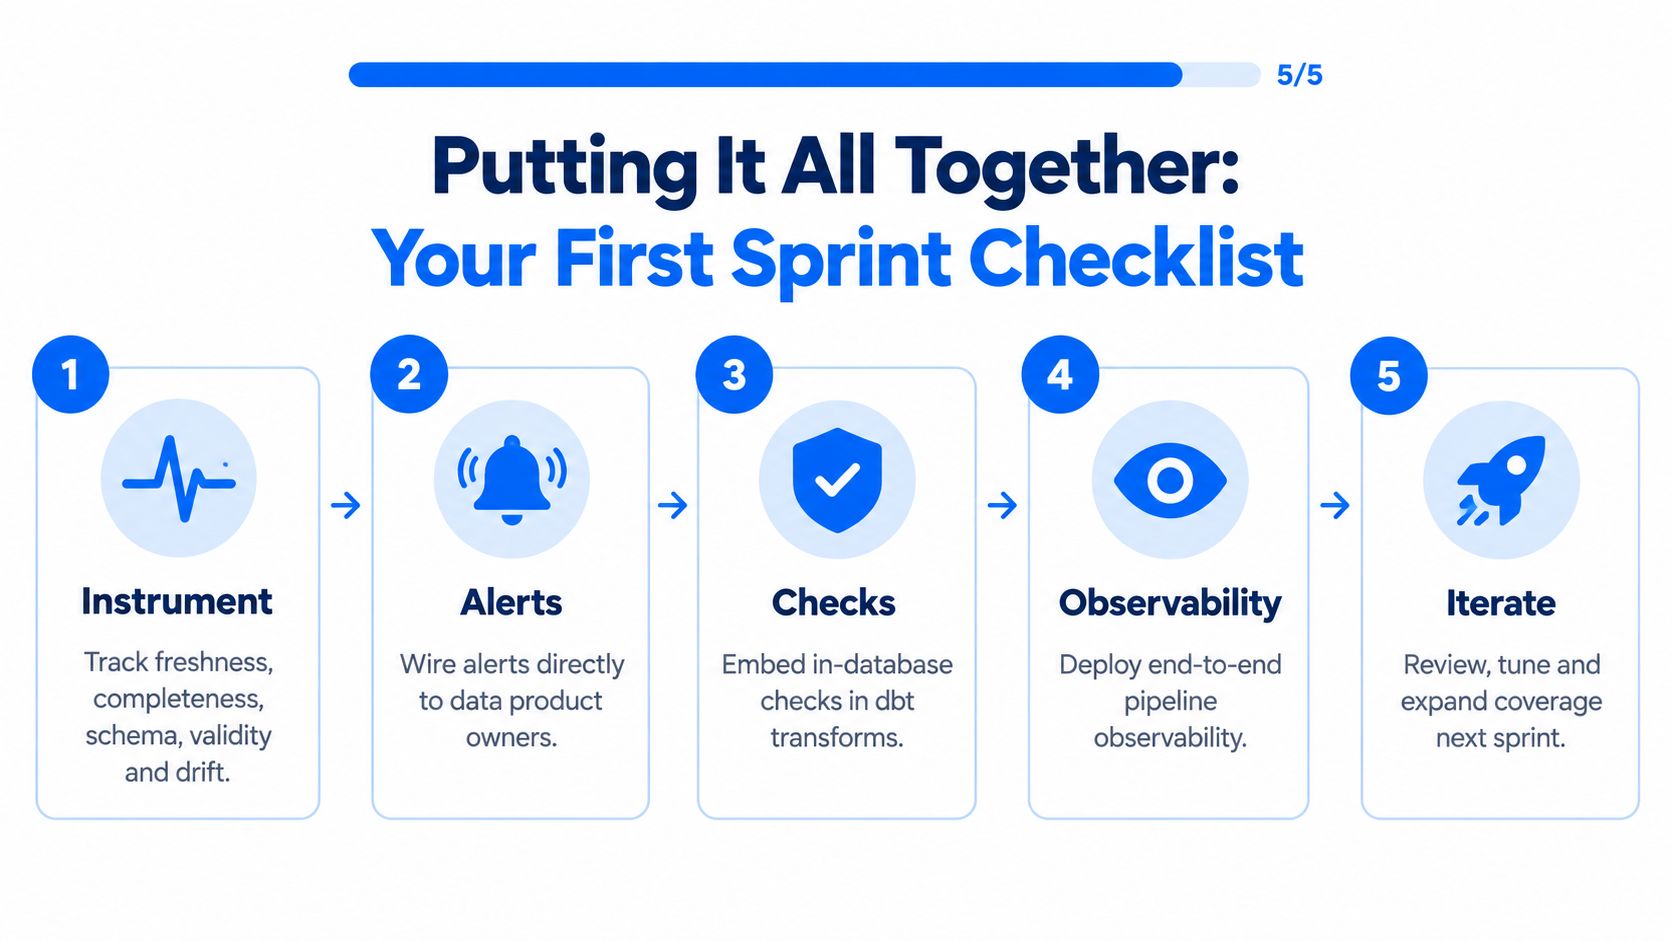
Suivez cette séquence :
Instrumentez la chaîne : suivez fraîcheur, complétude, stabilité du schéma, validité et dérive de distribution.
Attribuez la réponse : acheminez chaque alerte vers un responsable nommé du produit de données et identifiez le consommateur touché.
Codifiez le contrat : documentez les attentes de fraîcheur, d'exactitude et de disponibilité de l'actif.
Placez les contrôles à dessein : règles déterministes pour les garanties fermes, contrôles statistiques pour la dérive, détection apprise pour les anomalies corrélées.
Étendez la protection aux entrées d'IA : appliquez les mêmes contrôles aux données de variables, au contexte de recherche et aux jeux de données destinés aux modèles.
Le marché s'oriente vers une assurance quantifiée plutôt que vers un vocabulaire vague de confiance. Le défi opérationnel consiste à rendre ces mesures exploitables entre équipes, pipelines, entrepôts et métriques métier. Des tableaux de bord de fiabilité partagés et des SLO inter-équipes sont plus utiles que des tableaux de bord isolés par outil, parce qu'ils relient la santé technique aux décisions qui en dépendent.
Les équipes affrontent toujours un goulot d'étranglement de tests manuels. Les enquêtes indiquent que 61 % s'appuient sur des contrôles manuels ou une validation en SQL, tandis que seuls 27 % utilisent une plateforme d'observabilité dédiée et 14 % appliquent des SLA à l'échelle de l'organisation, selon le rapport de tendances 2025 d'Integrate.io sur la qualité des données et l'observabilité. La réponse concrète n'est pas de tout tester à la main. C'est d'automatiser la preuve au moment de la livraison, de donner un responsable à chaque contrôle et de traiter un dépassement sur un actif critique comme un incident de production.
Choisissez ce jeu de données cette semaine. Définissez trois métriques de fiabilité, désignez un responsable et traitez le premier dépassement comme un incident avec chronologie et plan de remédiation, pas comme un ticket de données ordinaire.
digna propose une plateforme d'entreprise de qualité des données et d'observabilité qui s'exécute dans votre environnement, en combinant validation in-database, surveillance Timeliness, suivi de schéma et détection d'anomalies sur les entrepôts, les lacs et les pipelines. Pour relier ces contrôles en un programme de fiabilité concret pour l'analytique et l'IA, rendez-vous sur digna et explorez la plateforme.
Pour retrouver ces mêmes contrôles organisés par la défaillance que chacun prévient, plutôt que par la métrique qui la mesure, consultez les huit cas d'usage de l'observabilité des données ainsi que le responsable et le chemin de réponse associés à chacun.
Questions fréquentes
Quelle est la différence entre qualité des données et fiabilité des données ?
La qualité demande si chaque enregistrement est conforme : valide, non nul, correctement typé, dans la plage. La fiabilité demande si les consommateurs peuvent s'appuyer sur le jeu de données dans la durée, y compris si les partitions attendues sont arrivées dans la fenêtre de service avec un lineage connu. La brique peut être solide alors qu'il manque des assises au mur.
Quelles métriques mesurent réellement la fiabilité des données ?
Cinq couvrent les principaux modes de défaillance : fraîcheur, complétude, stabilité du schéma, validité et dérive de distribution. Aucune ne doit servir de valeur universelle de réussite ou d'échec. Chaque seuil relève d'un contrat reflétant la tolérance du consommateur, et la complétude se vérifie par partition plutôt que par ligne.
Quand utiliser la détection d'anomalies plutôt que des contrôles par règles ?
Les règles conviennent aux conditions qui ne doivent jamais être violées, comme une clé non nulle ou une référence valide. Les contrôles statistiques traitent les signaux qui varient naturellement : volume, cardinalité, proportion de valeurs nulles, moment d'arrivée. La détection par IA mérite sa place sur les décalages corrélés entre plusieurs signaux qu'aucun auteur de règles n'avait anticipés.
Pourquoi les programmes de fiabilité des données s'enlisent-ils ?
Le plus souvent pour des raisons organisationnelles avant des raisons techniques. Les alertes atterrissent dans une file d'infrastructure sans répondant nommé, chaque équipe définit « sain » à sa façon, et les seuils s'élargissent jusqu'à ce que plus rien ne se déclenche. Surveillez les tableaux de bord sans responsable, l'érosion des seuils et les cases cochées qui satisfont un audit pendant que les consommateurs reçoivent toujours des données tardives.
Qu'exige une fiabilité des données prête pour l'IA ?
Des preuves sur toute la chaîne d'entrée plutôt qu'un contrôle final d'exactitude. Les entrées brutes ont besoin de garanties de fraîcheur et de complétude, les feature stores d'une surveillance de dérive alignée sur les fenêtres d'inférence, et le lineage doit relier les variables à leurs sources pour qu'une régression de modèle ne devienne pas une investigation sans fin.


