Qué es un plan de remediación
|
6
minuto de lectura

Tiene delante un dashboard que no cuadra, y el momento no podría ser peor. Quizá una tabla de ingresos se ha desviado tras un cambio en la fuente, un feed regulatorio llegó tarde o la puntuación de un modelo se ha desviado lo suficiente como para que el responsable de negocio pierda la confianza. En ese momento, la pregunta no es solo qué se ha roto, sino qué tipo de respuesta resistirá cuando alguien pregunte si el problema está resuelto, contenido y con pocas probabilidades de volver.
Una reejecución o un parche rápido pueden acallar el ruido por hoy. Un plan de remediación es lo que convierte esa reacción en un proceso controlado, con un responsable, evidencias y un criterio claro de cierre. Si alguna vez ha visto un ticket marcado como resuelto mientras el informe posterior seguía pareciendo sospechoso, este tema probablemente ya esté sobre su mesa.
Índice
Cuando un incidente de datos exige un plan de verdad
El lunes empieza con un mensaje en Slack, no con un informe de incidente ordenado. El dashboard financiero vuelve a estar mal, la carga del data warehouse ha terminado y aun así las cifras no cuadran con el sistema de origen. Alguien propone volver a ejecutar la pipeline, otra persona quiere parchear la transformación y el responsable de negocio solo quiere que el informe deje de cambiar cada hora.
Ahí es donde suelen fallar los flujos de tickets informales. Una reejecución puede ser el primer paso correcto, pero solo contiene el síntoma. No indica si la causa raíz fue un cambio de esquema, un mapeo erróneo, una dependencia que faltaba o una regla de validación que nunca existió.
Un plan de verdad empieza separando la respuesta temporal de la corrección permanente. Trata el incidente como un flujo de trabajo con evidencias, no como una tarea puntual con un campo de estado. Para los equipos que ya mantienen páginas de incidencias como digna data quality issues, el cambio es sencillo en teoría y difícil en la práctica: el registro tiene que pasar de “algo ha fallado” a “este fallo se entiende, está asignado, corregido y verificado”.
Un ticket puede registrar actividad. Un plan de remediación tiene que demostrar que el riesgo se ha reducido.
Esa distinción importa porque la confianza se construye sobre un cierre que se pueda defender. Si se repara la pipeline pero nadie comprueba la actualización posterior, el plan no está completo, solo hace menos ruido. El resto del artículo aplica un criterio más exigente, acorde con la forma de trabajar de los equipos de datos experimentados cuando la presión es real.
La definición esencial de todo plan de remediación
Un plan de remediación es un conjunto controlado de acciones basadas en evidencias que elimina la causa raíz de una no conformidad detectada, restaura el proceso o los datos afectados, evita que se repita y demuestra que la corrección funcionó. Esta definición importa porque obliga a plantear cuatro preguntas distintas, no una. ¿Qué pasó, qué lo causó, qué cambiamos y cómo sabemos que sigue resuelto?
Piense en una tubería con una fuga. Puede secar el suelo, apretar la junta, revisar la tubería y vigilar durante un tiempo si sale más agua. Secar el suelo es la contención, apretar la junta es la corrección, la revisión es la verificación y la vigilancia es el cierre con garantías. En el trabajo con datos se aplica la misma secuencia cuando una carga mal formada, una partición desactualizada o un esquema roto empiezan a afectar a los informes.

Las cuatro fases que mantienen el trabajo honesto
La contención limita daños adicionales. Puede consistir en congelar una tabla corrupta, detener la publicación hacia los consumidores de BI o redirigir a los usuarios a la última instantánea válida conocida mientras el equipo investiga.
La corrección permanente elimina la causa subyacente. En una plataforma de datos puede ser un ajuste de SQL, un cambio en el mapeo de la fuente, una actualización del contrato de esquema o una dependencia de orquestación que faltaba.
La verificación demuestra que la corrección se mantiene. Aquí se revisan recuentos de filas, reglas de negocio, compatibilidad de esquema y actualizaciones posteriores, en lugar de confiar en que el cambio por sí solo haya bastado.
El cierre solo llega cuando existen las evidencias y el responsable da su aprobación. Cualquier cierre anterior es pura conveniencia administrativa.
Esta separación clara importa porque la remediación no es lo mismo que la respuesta a incidentes ni que el mantenimiento rutinario. La respuesta a incidentes detiene la hemorragia. El mantenimiento mantiene los sistemas sanos. La remediación está en medio: algo ya ha fallado y el equipo tiene que demostrar que el fallo se ha resuelto.
Para modelos operativos de calidad de datos más amplios, digna data quality management encaja de forma natural con esta idea, porque la gestión de la calidad aporta el contexto de detección y control, mientras que el plan de remediación se ocupa del flujo correctivo.
Elementos clave para que un plan funcione
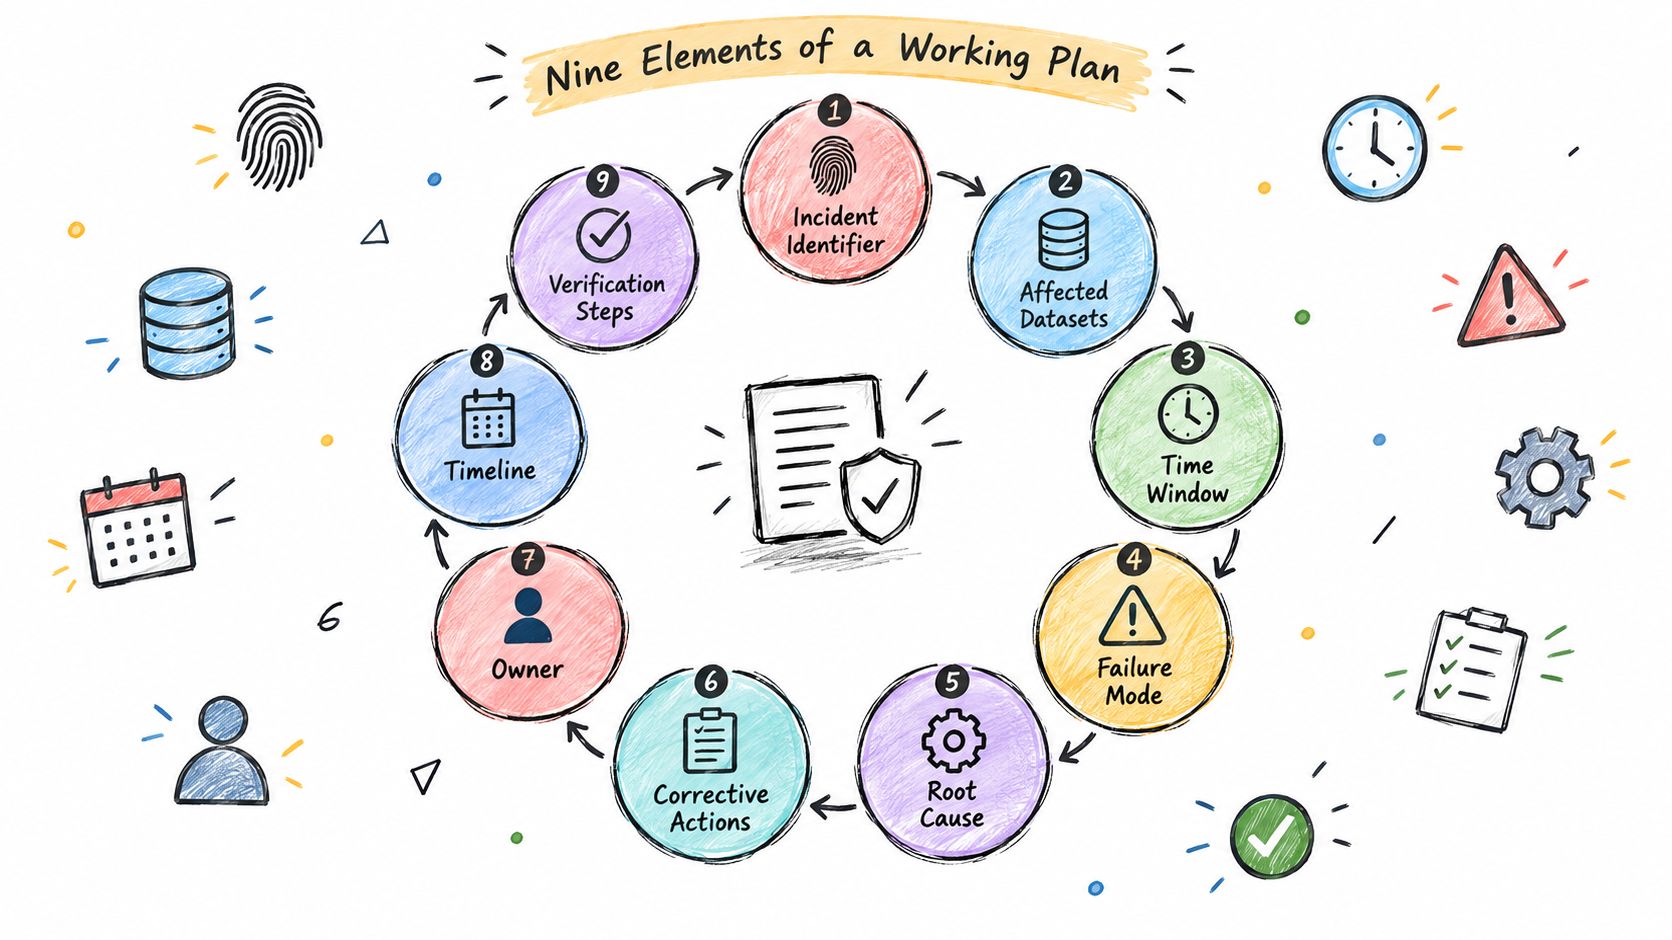
Un plan se desmorona enseguida cuando es demasiado vago para ejecutarse. “Arreglar la tabla” suena a acción, pero nadie sabe quién es el responsable, qué ha cambiado ni cuándo debe darse por terminada la corrección. Un plan que funciona necesita el contexto suficiente para que otro ingeniero pueda retomarlo sin hacer conjeturas.
Los campos que evitan la ambigüedad
Identificador del incidente. Da al problema una referencia estable, para que logs, hilos de chat y tickets apunten al mismo evento.
Conjuntos de datos y ventana temporal afectados. Sin esto, se corrige la partición equivocada, se pasa por alto una dependencia posterior o se sobrecorrigen datos históricos que no se vieron afectados.
Modo de fallo. Describa la forma del problema, como una llegada con retraso, un esquema roto, valores no válidos o una deriva silenciosa de una métrica.
Impacto en el negocio. Indique a qué afectó el fallo, porque una métrica interna errónea y un feed regulatorio retrasado no tienen la misma urgencia.
Hipótesis de causa raíz. Recoja lo que el equipo cree que causó el fallo, aunque esa hipótesis aún se esté comprobando.
Responsable. Una persona que rinde cuentas, no una cola de equipos.
Prioridad. Determina el orden cuando hay varios planes abiertos.
Dependencias. Señale lo que tiene que ocurrir antes, como correcciones en sistemas de origen, aprobaciones de acceso o la coordinación de un backfill.
Método de rollback. Si la corrección empeora las cosas, el equipo necesita una vuelta atrás segura.
Fecha objetivo de finalización. Los plazos sacan a la luz las concesiones necesarias.
Criterios de aceptación. Esta es la puerta. Si no se pueden definir, no se puede demostrar el cierre.
Regla práctica: si un plan no dice cómo se verificará el éxito, todavía no es un plan de remediación, es una lista de tareas.
En la práctica suelen faltar dos elementos, y ambos salen caros. La falta de un responsable genera deriva, porque todos suponen que otro se está ocupando. La falta de un criterio de aceptación genera cierres falsos, porque el ticket puede cerrarse aunque el problema siga presente en los datos.
Para la higiene del flujo de trabajo, digna's data quality issue management process es relevante porque el plan tiene que sobrevivir a los traspasos, no solo al triaje inicial.
Priorizar y escalonar varios planes abiertos
Los equipos rara vez tienen una sola remediación abierta. Tienen varias, y algunas compiten por las mismas personas, la misma ventana de despliegue y la misma atención de la dirección. Ordenar por antigüedad del ticket es fácil, pero es una forma pobre de decidir qué se corrige primero.
Criterios de priorización para planes de remediación que compiten entre sí | Por qué importa | Señal clara de urgencia |
|---|---|---|
Impacto en el negocio | Afecta a ingresos, informes, confianza del cliente o calidad de las decisiones | Los informes clave para la dirección son erróneos o no están disponibles |
Exposición regulatoria | Genera riesgo de auditoría, cumplimiento normativo o presentación de informes | Un feed o control obligatorio llega tarde o no es fiable |
Criticidad de los datos | Algunos conjuntos de datos alimentan a muchos consumidores posteriores | Se ven afectados datos de origen muy reutilizados |
Probabilidad de recurrencia | Una corrección que no se mantiene genera incidentes repetidos | El mismo defecto reaparece una y otra vez |
Número de dependencias | Más dependencias suelen implicar un mayor radio de impacto | Varias pipelines o equipos dependen del problema |
Tiempo hasta el daño | Algunos problemas empeoran rápido | Los datos dejarán de ser utilizables en el próximo ciclo |
Por qué importan las fases cuando la solución rápida no basta
Un parche temporal puede restablecer el servicio hoy y dejar intacta la causa raíz. Por eso la contención, la corrección permanente y la verificación necesitan un tratamiento separado. Si un feed retrasado se redirige manualmente, puede que el equipo haya mantenido el negocio en marcha, pero la carencia de fondo sigue ahí hasta que se repare la automatización o la fuente de origen.
La decisión más difícil llega cuando la contención inmediata choca con la corrección duradera. Quizá se puedan reproducir los eventos rápidamente, pero hacerlo antes de corregir el contrato de esquema puede provocar un segundo fallo. En ese caso, un buen plan dice no a la solución provisional más rápida y sí a la secuencia que reduce el riesgo.
Un cierre administrativo no demuestra la remediación. Solo lo hacen las evidencias validadas.
Esa distinción importa en las plataformas de datos porque el trabajo puede parecer terminado mucho antes de que el riesgo desaparezca. Un dashboard puede actualizarse, una pipeline puede dejar de fallar y un ticket puede cerrarse. Si los resultados no se han conciliado, en la práctica el plan sigue abierto.
Cuando los stakeholders pregunten por qué un problema va por delante de otro, explique la decisión en términos de negocio, no en número de tickets. Priorice el hallazgo que puede hacer daño antes, extenderse más o incumplir un control, antes de ocuparse del problema estético que solo parece desordenado.
Dos playbooks para fallos habituales de calidad de datos
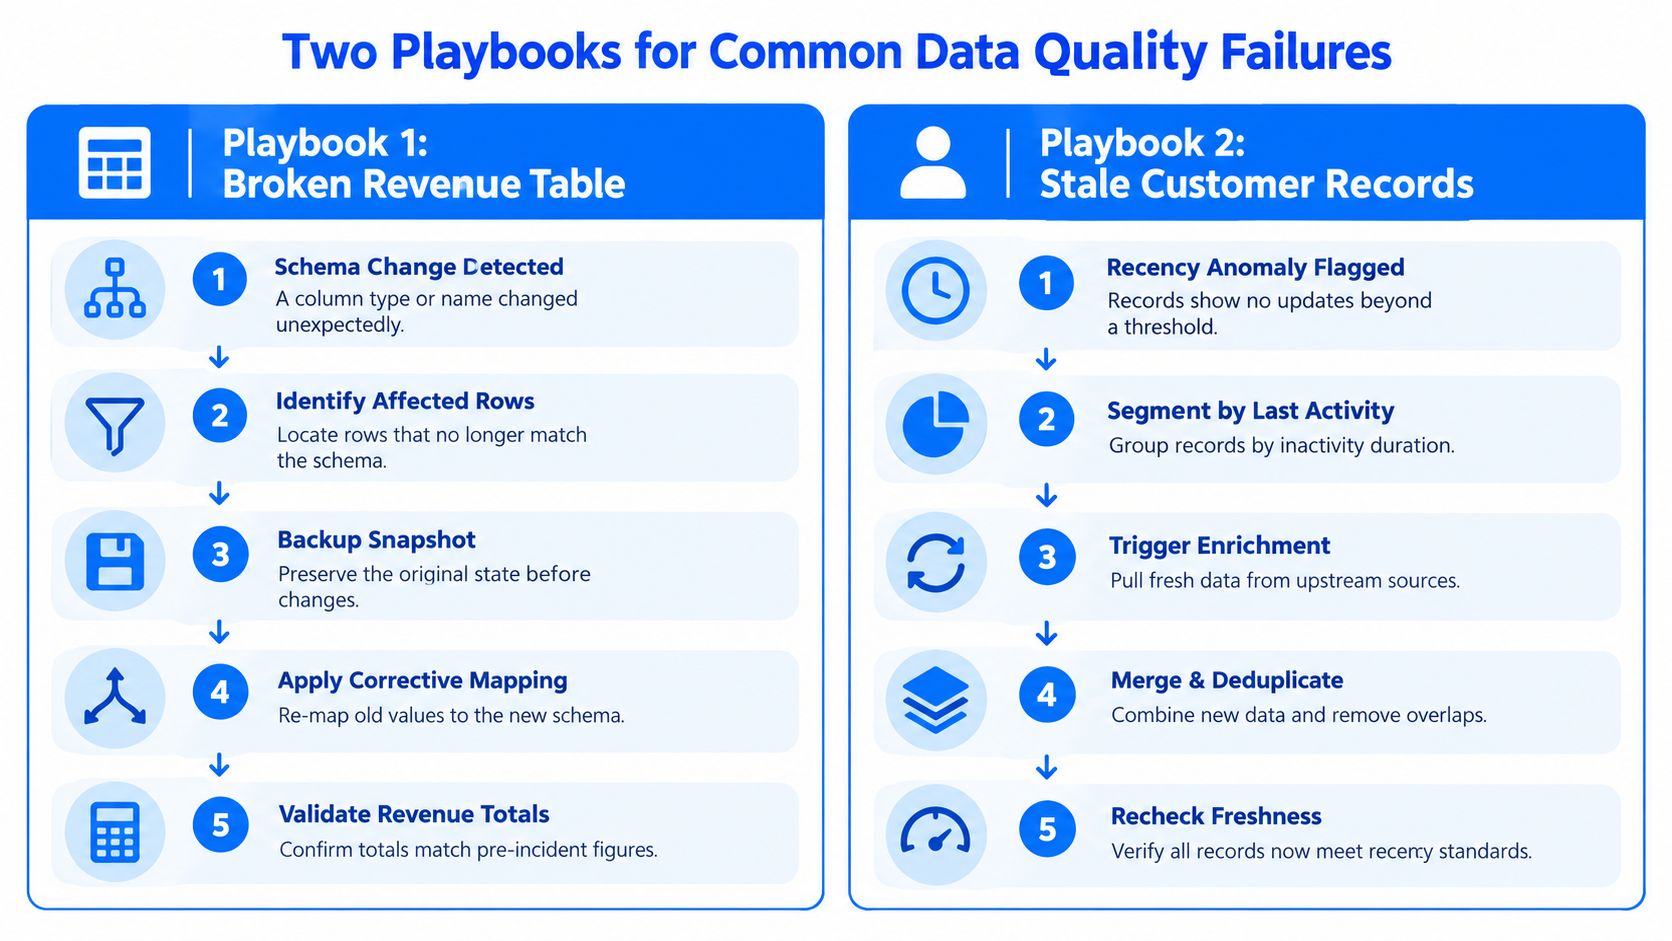
Un buen plan se vuelve real en cuanto puede aplicarse a un fallo concreto. Los detalles cambian, pero la secuencia es la misma: detectar, contener, corregir, validar y después demostrar que la corrección se ha mantenido el tiempo suficiente como para confiar en ella.
Playbook 1: tabla de ingresos rota
Un sistema de origen cambia de un día para otro el tipo de una columna y la tabla de ingresos empieza a cargar valores incompletos o no válidos. Primero, el equipo contiene el radio de impacto deteniendo la publicación posterior o congelando la partición defectuosa. Después aísla las filas afectadas, conserva el estado original y corrige el mapeo para que el nuevo esquema se procese correctamente.
A continuación llega la validación. El equipo comprueba si los totales de ingresos cuadran con la fuente de referencia, si los registros reparados se cargan sin errores y si las actualizaciones posteriores se completan sin intervención manual. El cierre solo llega cuando esas comprobaciones se superan y el responsable da su aprobación.
digna data completeness checks son relevantes aquí porque una llegada incompleta o un backfill parcial pueden hacer que una tabla parezca reparada cuando todavía le faltan registros.
Playbook 2: registros de clientes desactualizados
Una pérdida silenciosa de actualidad en los datos de clientes no siempre provoca un fallo evidente. El modelo sigue ejecutándose, pero los datos de entrada envejecen y pierden fiabilidad. En ese caso, el primer paso es marcar la anomalía de actualidad y después segmentar los registros afectados por duración de la inactividad, para que el equipo vea hasta dónde llega el problema.
Después, el responsable lanza el enriquecimiento desde las fuentes de origen, fusiona la nueva información y elimina duplicados. El último paso no es simplemente “el job ha terminado”, sino una nueva comprobación que confirma que los registros cumplen ahora el estándar de actualidad y que el modelo posterior recibe las entradas corregidas.
Cómo deben ser las evidencias de cierre
Tabla de ingresos rota: totales conciliados, backfills limpios, ningún fallo de validación crítico y actualizaciones posteriores correctas.
Registros de clientes desactualizados: actualidad restablecida, deduplicación completada y ejecuciones monitorizadas que muestran que el problema no volvió en el siguiente ciclo.
La diferencia entre un ticket cerrado y un plan cerrado es sencilla. Un ticket dice que alguien trabajó en ello. Un plan dice que los resultados vuelven a ser fiables.
Cómo digna aporta evidencias a un plan de remediación
Un plan de remediación se vuelve mucho más sólido cuando la señal del incidente ya incluye evidencias estructuradas. Eso no significa que la plataforma cierre el problema por usted, sino que el plan parte de mejores datos de entrada y con menos conjeturas. El responsable dedica menos tiempo a reconstruir lo ocurrido y más a decidir qué hacer al respecto.
Qué entrada va en cada lugar
Data Anomalies y Timeliness alimentan los primeros campos del plan. Ayudan a identificar qué cambió, cuándo cambió y si el problema es un retraso, una carga que falta o un patrón inusual que hay que investigar.
Schema Tracker respalda la hipótesis de causa raíz. Si se añadió, eliminó o cambió de tipo una columna, el plan puede señalar el cambio estructural exacto en lugar de adivinarlo a partir de los síntomas posteriores.
Data Validation ayuda a definir los criterios de aceptación. Si una regla de negocio a nivel de registro debe cumplirse antes del cierre, el plan puede remitir explícitamente a esa regla en lugar de depender de que alguien revise un dashboard a ojo.
Business Monitoring y Data Platform Observability hacen visible la señal en primer lugar. Muestran si la métrica de negocio, el comportamiento de la carga de trabajo o el estado de la plataforma se salieron del rango esperado, lo que da al responsable un punto de partida más limpio para el registro del incidente.
Para los equipos que utilizan digna data quality observability, el valor práctico está en el rastro de evidencias. El plan puede incluir los conjuntos de datos afectados, las ventanas de llegada previstas, los cambios de esquema, los resultados de validación y el contexto histórico sin tener que reconstruir ese contexto a mano a partir de logs dispersos.
Qué cambia cuando hay evidencias
Los responsables deciden más rápido porque el modo de fallo está más claro.
Los criterios de aceptación son más precisos porque se vinculan a la validación y al comportamiento observado.
La escalada es más limpia porque el plan muestra si el problema es local, sistémico o recurrente.
La revisión de auditoría es más sencilla porque el registro incluye las evidencias que respaldan la corrección, no solo la acción realizada.
La remediación deja de ser un flujo informal y pasa a ser auditable. Las evidencias no sustituyen al criterio profesional, pero lo hacen defendible.
Cerrar un plan correctamente y errores de concepto habituales
Un ticket cerrado no es lo mismo que una remediación cerrada. Los equipos se meten en problemas cuando toman la acción como prueba, porque la acción es solo el principio. La pregunta clave es si los datos, el proceso y los consumidores posteriores son estables después de la corrección.
Qué exige un cierre real
Un plan solo debería cerrarse cuando se han cumplido los criterios de aceptación, se han conservado las evidencias y el responsable ha registrado su aprobación. Si el incidente fue lo bastante grave como para requerir contención, también debería haber monitorización posterior al cierre. Esa monitorización es la red de seguridad que indica si el defecto sigue sin aparecer.
Los errores de concepto habituales suelen presentarse de tres formas. Primero, las reejecuciones se tratan como correcciones cuando en realidad solo son un paso de contención. Segundo, los parches de esquema se consideran correcciones permanentes aunque nadie haya verificado la compatibilidad posterior. Tercero, los equipos omiten la monitorización de la eficacia y dan por hecho que la ausencia de alertas significa que el problema ha desaparecido.
Si no puede explicar cómo se verificó la corrección, no tiene un cierre, tiene optimismo.
Una revisión mejor plantea unas pocas preguntas antes de que nadie marque el plan como terminado. ¿La corrección atacó la causa raíz y no solo el síntoma? ¿Se recuperaron los datos en la ventana afectada? ¿Los consumidores posteriores validaron correctamente? ¿El problema se ha mantenido tranquilo en las ejecuciones siguientes, no solo en la primera tras el cambio?
Ese criterio protege al equipo de los cierres prematuros y da a la dirección una respuesta mejor cuando pregunta si el trabajo redujo el riesgo. También facilita el traspaso al siguiente problema, porque el patrón de evidencias pasa a formar parte de cómo aprende la organización. El siguiente tema útil son los criterios de aceptación para incidentes de calidad de datos, porque ahí es donde muchos planes aún fallan en el último paso.
digna ayuda a los equipos de datos a convertir los incidentes en un trabajo de remediación basado en evidencias, con monitorización, validación, Timeliness y seguimiento de esquemas que alimentan planes más claros y cierres más limpios. Si quiere pasar de una gestión informal de tickets a un flujo de trabajo controlado, visite digna y descubra cómo la plataforma respalda ese proceso en su propio entorno.
Los criterios de aceptación solo sirven de filtro para el cierre cuando existen como comprobaciones ejecutables. Para convertirlos en reglas que se cumplen o fallan sobre registros reales, consulte cómo diseñar reglas de validación de datos.
Preguntas frecuentes
¿Qué es un plan de remediación en calidad de datos?
Un plan de remediación es un conjunto controlado de acciones basadas en evidencias que elimina la causa raíz de una no conformidad detectada, restaura los datos o el proceso afectados, evita que se repita y demuestra que la corrección funcionó. A diferencia de un ticket, que solo registra actividad, debe probar que el riesgo realmente se redujo.
¿Cuáles son las fases de un plan de remediación?
Son cuatro: contención, corrección permanente, verificación y cierre. La contención limita el daño, por ejemplo congelando una tabla corrupta. La corrección elimina la causa, como un ajuste de SQL o de mapeo. La verificación revisa recuentos de filas, reglas y actualizaciones posteriores, y el cierre solo llega con evidencias y la aprobación del responsable.
¿Qué debe incluir un plan de remediación?
Como mínimo, un identificador de incidente, los conjuntos de datos y la ventana temporal afectados, el modo de fallo, el impacto en el negocio, una hipótesis de causa raíz, un único responsable, prioridad, dependencias, un método de rollback, una fecha objetivo y criterios de aceptación. Responsable y criterios de aceptación son los campos que más faltan.
¿Cómo se priorizan varios planes de remediación abiertos?
Por riesgo, no por antigüedad del ticket. Conviene sopesar impacto en el negocio, exposición regulatoria, criticidad de los datos, probabilidad de recurrencia, número de dependencias y tiempo hasta el daño, y resolver primero lo que puede perjudicar antes, extenderse más o incumplir un control, antes que un problema que solo parece desordenado.
¿Cuándo se puede cerrar un plan de remediación?
Solo cuando se cumplen los criterios de aceptación, se conservan las evidencias y el responsable ha registrado su aprobación. Volver a ejecutar un proceso es contención, no una corrección, y la ausencia de alertas no prueba nada por sí sola, así que los incidentes graves necesitan además monitorización posterior al cierre durante las ejecuciones siguientes.


