Reglas de validación de datos: Una guía práctica de diseño
|
5
minuto de lectura

Se puede notar que una canalización de datos está en problemas cuando el panel de control está técnicamente activo, los números están técnicamente presentes y, aun así, el negocio no puede confiar en una sola fila de la pantalla. Un valor de referencia incorrecto, un campo faltante o un registro que se filtra tras una verificación laxa es suficiente para que una revisión de viernes se convierta en una sesión de arqueología. Ese suele ser el momento en que las personas se dan cuenta de que el problema no es el informe, sino la ausencia de reglas de validación de datos diseñadas, probadas y gobernadas como código de producción real.
La validación funciona mejor cuando se deja de tratar como una tarea administrativa y se empieza a tratar como un contrato. El enfoque de Eurostat es contundente: si una combinación de valores no está en el conjunto aceptado, falla, y la regla debe definirse y documentarse de manera inequívoca para que los productores y consumidores compartan el mismo entendimiento de la verificación aplicada, lo cual es una base mucho más limpia para la auditabilidad y el Data Governance que un vago filtro de mejor esfuerzo (Guía de validación de datos de Eurostat). Si desea la misma idea en un contexto de producto práctico, este resumen de validación de datos hace que el ciclo de vida sea más concreto sin suavizar la realidad operativa.
Por qué sus datos le están mintiendo silenciosamente
Los peores fallos de datos rara vez se anuncian. Un informe sigue cargándose, el gráfico sigue mostrándose y todos asumen que los números están "lo suficientemente cerca" hasta que surge una excepción durante una reunión y alguien tiene que explicar por qué las cifras de ayer no coinciden con la extracción de hoy. Las comprobaciones puntuales manuales no escalan para ese tipo de problema, porque las filas incorrectas suelen ocultarse dentro de las que parecen normales.
La validación es un pacto, no un filtro
Por eso es importante la validación a nivel de registro. Convierte una expectativa difusa en una regla compartida y les da a los equipos de ingeniería y de negocio el mismo lenguaje para los fallos. Eurostat define la validación de datos como la comprobación de si una combinación de valores pertenece a un conjunto aceptado, y su guía indica que las reglas deben estar claras y definidas de forma inequívoca, documentadas y ser adecuadas para su propósito para que todos puedan interpretar el resultado de la misma manera (Guía de validación de datos de Eurostat).
Una validación fallida debería indicarle qué regla de negocio se rompió, no solo que la fila molestó a la base de datos.
Esa distinción cambia la forma en que trabajan los equipos. Un registro incorrecto ya no es solo "datos sucios", es evidencia de que se ha violado una restricción comercial, una suposición de esquema o una obligación de informes. Este es el valor central de las reglas de validación de datos: crean puntos de control medibles en lugar de convertir la calidad en una promesa vaga.
El beneficio operativo es la previsibilidad. Cuando las reglas se documentan y aplican de manera constante, los productores de datos saben lo que deben enviar y los consumidores saben en qué tipo de datos pueden confiar. Si alguna vez ha visto que una canalización "funciona en su mayoría" durante meses antes de que un caso extremo oculto detone un panel de control, ya sabe por qué esta disciplina se paga por sí sola.
La anatomía de las reglas de validación de nivel de registro
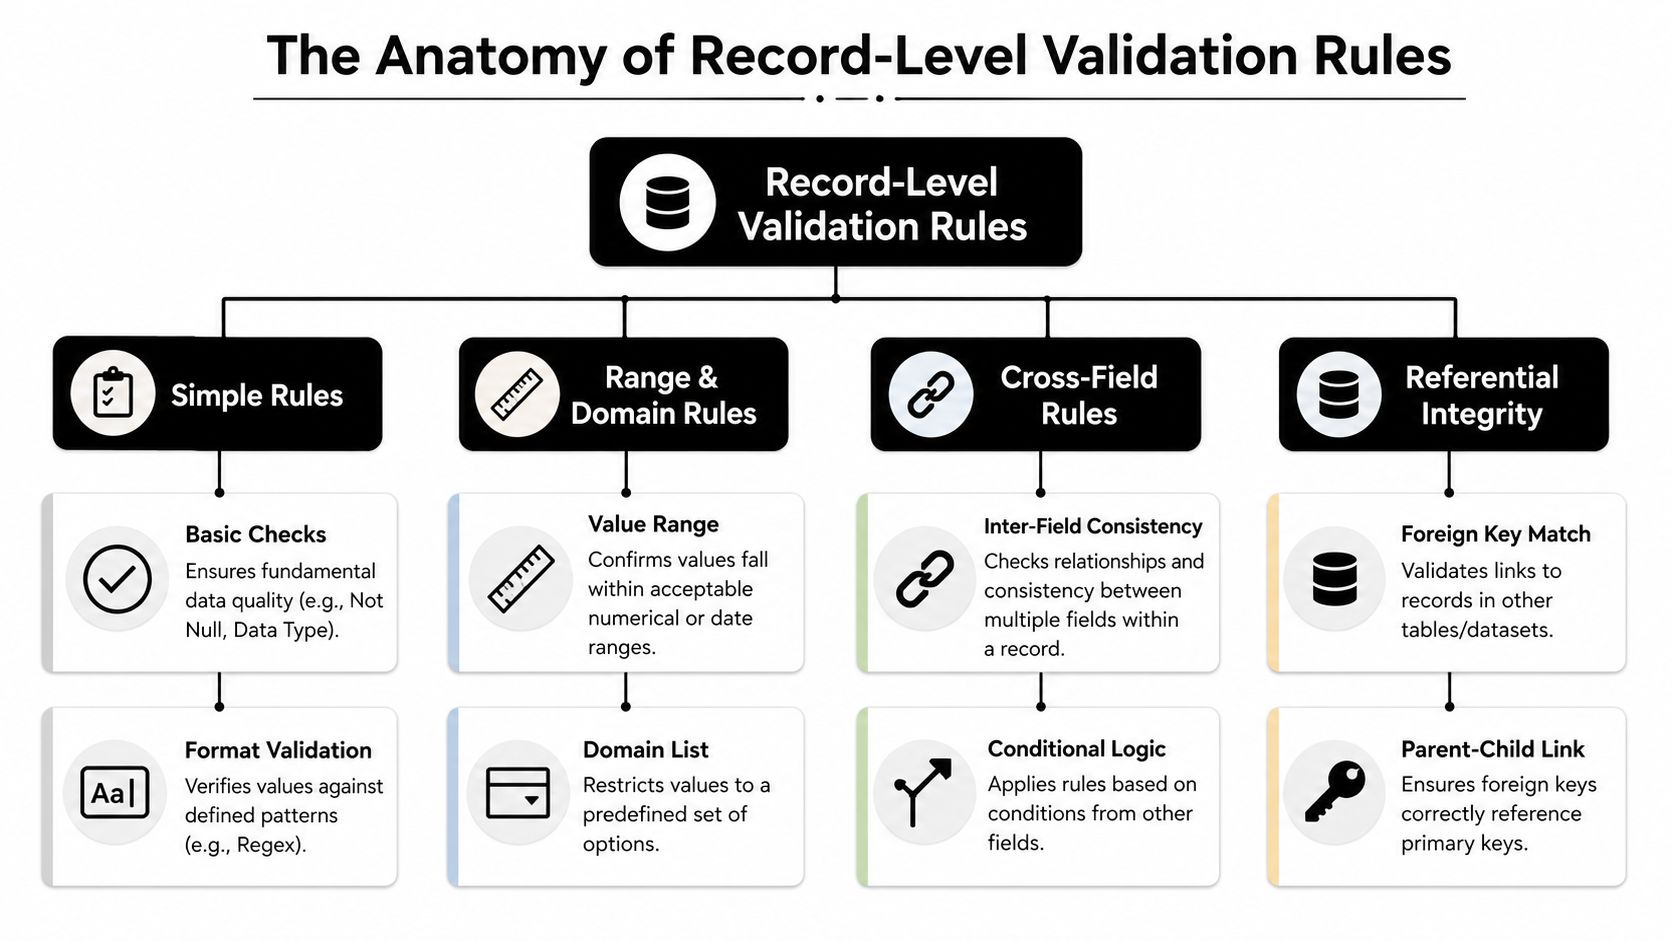
Antes de escribir código, necesita un mapa de las familias de reglas que utilizará. El flujo de trabajo estándar agrupa las comprobaciones en validación de formato, comprobaciones de rango, validación de esquemas y validación de campos cruzados, lo cual es un punto de partida útil porque obliga a separar los problemas de sintaxis de los problemas de lógica de negocio (Flujo de trabajo de validación de datos de Atlan). Esa separación mantiene su marco comprensible, lo cual importa más que sonar avanzado.
Comience con las comprobaciones sencillas
Las reglas más fáciles suelen ser las primeras que se deben implementar. La presencia de nulos, el tipo de datos y la validación de formato detectan el tipo de errores que son económicos de rechazar y dolorosos de limpiar más tarde. Si un correo electrónico no coincide con el patrón esperado o una fecha llega con la forma incorrecta, no tiene sentido dejar que ese registro avance hacia abajo en el flujo solo porque el resto de la fila se ve bien.
Agregue restricciones numéricas y de dominio a continuación
Las comprobaciones de rango son el punto donde la validación comienza a sentirse como una política de negocio en lugar de higiene de campos. Un precio debe ser positivo, un descuento no debe exceder el precio y un campo de edad debe estar dentro de un rango aceptable si el dominio comercial lo requiere. Para los flujos de trabajo de cuidado de mascotas, esa misma lógica es útil cuando se está garantizando registros de salud de mascotas conformes, porque un campo faltante o mal formado puede romper la cadena de responsabilidad incluso cuando el registro "se carga".
No olvide las relaciones entre campos
La validación de campos cruzados es donde la gente suele quemarse. Un país de envío no puede tratarse de forma aislada si se supone que otro campo lleva un identificador específico del país, y una etiqueta de estado solo puede tener sentido si se empareja con una fecha o código correspondiente. Estas reglas son más difíciles de escribir que las comprobaciones de un solo campo, pero también son las que detectan las contradicciones sutiles que, de otro modo, harían que los informes parecieran internamente consistentes mientras siguen estando incorrectos.
Regla práctica: si un campo solo tiene sentido en contexto, valídelo en contexto.
La integridad referencial se sitúa junto a la lógica de campos cruzados, incluso si se siente más nativa de la base de datos que del negocio. Una clave externa que no apunta a una fila principal real sigue siendo una falla de negocio, no solo un problema de almacenamiento. Es por eso que los conjuntos de reglas de validación específicos de dominio a menudo incluyen comprobaciones explícitas como precios positivos, ausencia de observaciones negativas y observaciones únicas, todo escrito como condiciones verificables por máquina que mantienen el control de calidad automatizado interpretable para los ingenieros (Reglas de validación de dominio de SNStatComp).
También puede utilizar una visión orientada a la plataforma de esta anatomía si necesita un patrón empresarial más amplio. El modelo a nivel de registro en el enfoque de validación empresarial de digna es útil precisamente porque mapea estas familias de reglas a la ejecución dentro de la base de datos en lugar de dejarlas como notas de política abstractas.
De la lógica al código
La teoría solo importa una vez que la regla puede rechazar un pedido incorrecto sin hacer que los pedidos correctos sean más difíciles de procesar. Suponga que está validando un registro de orders entrante con order_id, customer_id, price, discount, shipping_country y nif. Desea que el código sea lo suficientemente legible para que el próximo ingeniero no tenga que realizar ingeniería inversa de las reglas de negocio a partir de un montón de efectos secundarios.
Haga que la regla sea obvia en SQL
Una restricción CHECK limpia sigue siendo la mejor primera línea para la lógica de campos simples.
Eso le brinda un modo de falla nítido para los casos obvios. También mantiene la regla cerca del modelo de datos, lo cual es importante porque una regla de validación oculta descuidada en el código de la aplicación es fácil de olvidar y difícil de auditar.
Use lógica de campos cruzados cuando una columna depende de otra
Algunas reglas no pertenecen a un simple CHECK porque necesitan un comportamiento condicional. En ese caso, una expresión CASE o lógica de tipo disparador es más clara que intentar exprimir toda la regla de negocio en un solo predicado.
Ese patrón hace que la regla sea explícita. Si el país de envío es España, el registro necesita el identificador esperado, y si no lo tiene, obtiene una señal de falla directa en lugar de una excepción críptica aguas abajo.
Pruebe la unicidad y la integridad referencial con consultas
Las comprobaciones de unicidad son más fáciles de mantener cuando se escriben como diagnósticos directos en lugar de código procedimental inteligente.
Y la integridad referencial es igual de directa.
Esas consultas son aburridas en el mejor sentido posible. Le indican exactamente qué falló, razón por la cual las reglas de validación específicas de dominio a menudo se implementan como comprobaciones explícitas a nivel de registro, como precios positivos, ausencia de observaciones negativas e indicaciones únicas, todo lo cual se puede ejecutar a volumen y al mismo tiempo seguir siendo interpretable para los ingenieros (Reglas de validación de dominio de SNStatComp).
Si desea un ejemplo de plataforma de este estilo, vale la pena leer la discusión sobre mantenimiento manual de reglas de digna junto con sus propios patrones SQL, porque la pregunta útil no es si la regla existe, sino con qué seguridad se puede mantener a lo largo del tiempo.
Mantenga el mensaje de error útil
Una regla mala con un mensaje vago solo genera trabajo adicional. "Fallo de validación" no ayuda a nadie, mientras que "shipping_country=ES requiere nif" ofrece al analista y al ingeniero el mismo punto de partida para el triaje. En la práctica, el mensaje es parte de la regla, no un adorno.
Más allá de que funcione: estrategias de prueba más inteligentes
Una regla de validación que no ha sido probada es solo una teoría con un presupuesto de producción. Trátela como si fuera código de aplicación, porque eso es lo que es una vez que puede bloquear datos, alertar sobre fallos o alimentar flujos de trabajo de Compliance. El costo de equivocarse aquí es feo, ya que una regla de validación rota puede rechazar datos correctos o, peor aún, permitir que pasen datos erróneos con un certificado de buena salud.
Pruebe la regla en capas
Un enfoque práctico comienza con algo pequeño. Las pruebas unitarias utilizan un conjunto reducido de registros seleccionados, algunos válidos y otros no válidos, de modo que cada regla se pueda comprobar de forma aislada. Ahí es donde se detectan los errores obvios, el umbral desplazado por uno, la comprobación nula invertida o la regla que accidentalmente marca casos límite legítimos.
Las pruebas de integración pertenecen a la propia canalización. Le muestran cómo se comportan las reglas cuando la preparación, la transformación y la carga están en juego, que es donde mucha lógica ordenada comienza a actuar de forma caótica. Las pruebas de regresión protegen el comportamiento existente cada vez que cambia una regla, evitando que al "corregir" una validación se rompan inadvertidamente otras tres.
Separe los fallos a nivel de archivo de los fallos a nivel de registro
El patrón operativo más útil que he visto es el que se utiliza para la notificación de transacciones de la UE, donde las reglas de sintaxis a nivel de esquema rechazan todo el archivo y las reglas de contenido rechazan solo las transacciones no válidas. Esa división mantiene el radio del impacto más reducido y reduce los reenvíos innecesarios (reglas de validación para la notificación de transacciones ESMA MiFIR).
No haga sufrir a todo un lote por una sola fila incorrecta a menos que la estructura misma esté rota.
Ese principio es fácil de enunciar y sorprendentemente fácil de ignorar. Si el archivo está mal formado, deténgase de inmediato. Si solo una transacción infringe la lógica empresarial, aísle o marque el registro y deje que el resto continúe, asumiendo que su proceso y los requisitos de Compliance lo permitan.
Para el trabajo de causa raíz, esta guía para analizar problemas de datos con IA puede ayudar a los equipos a pasar de "algo falló" a "este patrón específico lo causó" sin convertir cada incidente en una investigación manual.
Una matriz de prueba simple
Camino feliz válido: el pedido debería pasar todas las reglas.
Registro incorrecto conocido: el pedido debería fallar exactamente en una regla designada.
Caso límite: la regla debería comportarse correctamente en el valor límite.
Muestra de regresión: un registro aceptado anteriormente debería seguir aceptado después de editar una regla.
Eso es suficiente para mantener la regla sincera sin complicar demasiado el entorno de pruebas. Si no puede explicar por qué existe una prueba, probablemente no la necesite.
Despliegue y gestión de reglas sin dolores de cabeza
Escribir reglas es la parte fácil. Convivir con ellas es donde comienza el trabajo de diseño central, porque cada cambio en la política empresarial corre el riesgo de romper suposiciones antiguas. Un marco de validación que no se puede versionar, explicar y volver a ejecutar de forma segura tarde o temprano se convertirá en lo que todos evitan tocar.
Elija su patrón de despliegue deliberadamente
El guardián estricto bloquea los registros incorrectos antes de que entren en los sistemas de destino. Esa es la opción correcta para canalizaciones de alta confianza, informes regulados y cualquier cosa que crearía estragos si los datos no válidos se propagaran más.
El monitor observador deja pasar los datos, pero marca, aísla o dirige los fallos para su revisión. Eso es útil cuando la disponibilidad importa más que el rechazo inmediato, o cuando necesita observar la forma del problema antes de endurecer el control.
Ninguno de los dos patrones es universalmente correcto. El rol de guardián le brinda un control más estricto, mientras que el monitoreo le aporta resiliencia y visibilidad. La mayoría de los equipos maduros terminan utilizando ambos, porque no todos los conjuntos de datos merecen el mismo nivel de fricción.
Haga explícito el ciclo de vida de la regla
Una regla debe tener una versión, una nota de cambio y un propietario claro. También necesita registros que muestren cuándo se ejecutó, qué evaluó y cómo falló o pasó, porque esa es la única manera de respaldar las auditorías sin convertir cada incidente en una historia de detectives. Las directrices de Eurostat también son útiles aquí, porque mencionan que las reglas e incluso sus mensajes de error deben estar documentados para que todos interpreten los fallos de la misma manera (Principios de Eurostat).
El gran problema del mantenimiento es la desviación de las reglas. Las políticas de negocio cambian, los sistemas de origen evolucionan y lo que antes era un umbral sensato puede convertirse en una molestia o en un punto ciego. El flujo de trabajo de validación de ArcGIS es un buen recordatorio de que la validación es operativa, no estática, porque las reglas a menudo necesitan evaluación, inspección y reevaluación después de las ediciones, especialmente cuando los esquemas y las condiciones de presentación de informes cambian con el tiempo (Reglas de atributos de validación de ArcGIS).
Dónde una plataforma puede reducir la dificultad
Una plataforma puede ayudar cuando el volumen de reglas, sistemas y excepciones comienza a superar la capacidad de las hojas de cálculo y los scripts ad hoc. Una opción es digna, que utiliza una lógica de validación técnica y de negocio determinista con ejecución de reglas en la base de datos e historiales de auditoría completos, de modo que las comprobaciones se ejecutan donde residen los datos y la evidencia se conserva para revisiones regulatorias y de Compliance (Introducción a la plataforma digna).
Eso importa porque la validación solo es útil si las personas pueden confiar tanto en el resultado como en el proceso. Una interfaz de usuario atractiva es práctica, pero la ganancia más profunda es la trazabilidad: la capacidad de responder quién cambió qué, qué falló y por qué se manejó el registro de la forma en que se hizo.
Si también está comparando opciones de Observability y aplicación de reglas, proteger sus datos de investigación es una lectura adyacente útil porque mantiene la atención en la integridad en lugar de centrarse únicamente en las alertas.
El final del juego: la validación como pilar de la confianza de los datos
Una buena regla comienza como una necesidad del negocio, se convierte en código, se prueba y finalmente vive como un activo de producción monitoreado con un propietario y un historial de auditoría. Ese ciclo de vida es la diferencia entre comprobaciones aleatorias y una postura de gobernanza real. Una vez que la organización ve la validación como un sistema, no como un parche, la confianza resulta más fácil de ganar y más fácil de defender.
Los equipos más saludables dejan de preguntarse si deberían validar los datos y comienzan a preguntarse a dónde pertenece cada regla, cómo se versiona y qué sucede cuando falla. Ese cambio es lo que convierte a los ingenieros de datos en guardianes de la integridad en lugar de equipos de limpieza. Si necesita un enfoque cultural más amplio, esta guía para desarrollar hábitos de calidad de datos conecta los controles técnicos con la responsabilidad diaria de una manera útil.
El objetivo final no son datos perfectos, porque eso no existe. El objetivo final son datos previsibles, excepciones visibles y un proceso que diga la verdad con la suficiente rapidez para que los analistas, auditores y operadores actúen en consecuencia. Una vez que esas partes están en su lugar, la validación deja de ser una carga y comienza a convertirse en una de las razones silenciosas por las que sus análisis, el Compliance y la automatización se sostienen.
Llamada a la acción para digna.
Para ejecutar estas reglas a nivel de registro dentro de la base de datos, con un registro de auditoría de qué falló y por qué, consulte digna Data Validation.
Preguntas frecuentes
¿Cuáles son los principales tipos de reglas de validación de datos?
El artículo agrupa las reglas en validación de formato, comprobaciones de rango, validación de esquema y validación entre campos, junto con la integridad referencial. Empiece con comprobaciones sencillas de nulos, tipo y formato, añada restricciones numéricas y de dominio como precios positivos y después escriba reglas entre campos para los que solo tienen sentido en contexto.
¿Cómo se escribe una regla de validación de datos en SQL?
Para la lógica de un solo campo, use una restricción CHECK en la definición de la tabla, como CHECK (price > 0) o CHECK (discount <= price). Las reglas condicionales encajan mejor en una expresión CASE, por ejemplo marcando como fallido un pedido cuando shipping_country = 'ES' y nif IS NULL, lo que mantiene explícita la regla de negocio.
¿Cómo se prueban las reglas de validación de datos?
Pruébelas como código de aplicación, por capas: pruebas unitarias con pequeños conjuntos seleccionados de registros válidos e inválidos, pruebas de integración dentro del pipeline y pruebas de regresión cada vez que cambie una regla. Una matriz sencilla cubre el caso correcto, un registro erróneo conocido, un caso límite y una muestra de regresión.
¿Debe un fallo de validación rechazar el archivo completo?
Solo cuando la propia estructura está rota. Siguiendo la práctica de la UE para la notificación de operaciones MiFIR, los errores de sintaxis a nivel de esquema rechazan el archivo completo, mientras que los fallos de reglas de contenido rechazan solo las operaciones inválidas. Esa separación reduce el radio de impacto y evita reenvíos innecesarios.
¿Qué diferencia hay entre la validación tipo gatekeeper y la de monitorización?
El Strict Gatekeeper bloquea los registros erróneos antes de que lleguen a los sistemas posteriores, lo que conviene a los informes regulados y a pipelines de alta confianza. El Observant Monitor deja pasar los datos pero marca, pone en cuarentena o deriva los fallos para su revisión. La mayoría de los equipos maduros combinan ambos patrones.



