Definir datos agregados: métodos, ejemplos y precauciones
|
7
minuto de lectura

Los datos agregados son información que se obtiene al agrupar registros individuales en categorías y combinar sus valores en medidas de resumen como recuentos, sumas, promedios o tasas. Parece sencillo, pero el consejo de «basta con crear un dashboard» es el que más problemas causa, porque la agregación cambia tanto el significado como el perfil de riesgo de los registros subyacentes.
Índice
Dónde se produce la agregación en los sistemas de datos modernos
Por qué los datos agregados importan para la analítica y la observabilidad
Riesgo de privacidad y de divulgación en los resultados agregados
Un ejemplo práctico: de los registros en bruto a un agregado fiable
Qué significan realmente los datos agregados
Los datos agregados son información de resumen derivada de registros de nivel inferior, no un tipo de dato independiente que surja por sí solo. El modelo mental tiene dos lados: en uno están los eventos, transacciones u observaciones individuales, y en el otro los totales, promedios o tasas a nivel de grupo que condensan muchas filas en menos resultados.
Un ejemplo claro es una base de datos con 1 millón de transacciones individuales de clientes que se resume en 12 totales mensuales por mercado. Ya no se ve cada compra, pero se pueden comparar mercados, seguir la estacionalidad y detectar patrones generales mucho más rápido. La Oficina Australiana de Estadística describe la agregación como agrupar información en categorías y combinar los valores dentro de ellas, a menudo en forma de tablas, y por eso también se habla de datos tabulares o macrodatos ABS glossary.

La definición de trabajo que resiste en la práctica
Conviene pensar en la agregación como una transformación aplicada a observaciones en bruto. Una transacción de cliente se convierte en un total de ingresos mensual, un flujo de eventos de telemetría en un recuento de errores por hora y un censo de hogares en una tabulación de características de la población. Ese es el movimiento básico: reducir muchos registros a menos resúmenes.
Regla práctica: si el resultado puede responder a una pregunta sobre un grupo pero no sobre una persona, está agregado. Si aún es posible rastrear el resultado hasta un único registro sin contexto adicional, debe tratarse como un riesgo de privacidad y divulgación.
Esta distinción importa porque un mismo resultado puede ser útil para los informes y, aun así, lo bastante sensible como para necesitar controles. Si busca una segunda fuente de terminología mientras analiza cómo describen este ámbito los proveedores, la colección pricing data research de Wine Labs es una referencia cercana útil sobre cómo se presentan los resúmenes estructurados en la investigación de mercado.
Los principales métodos de agregación
La agregación resulta más fácil en cuanto se deja de tratar como una sola cosa. En la práctica, los equipos recurren a un pequeño conjunto de funciones, y cada una responde a una pregunta distinta sobre las mismas filas subyacentes.
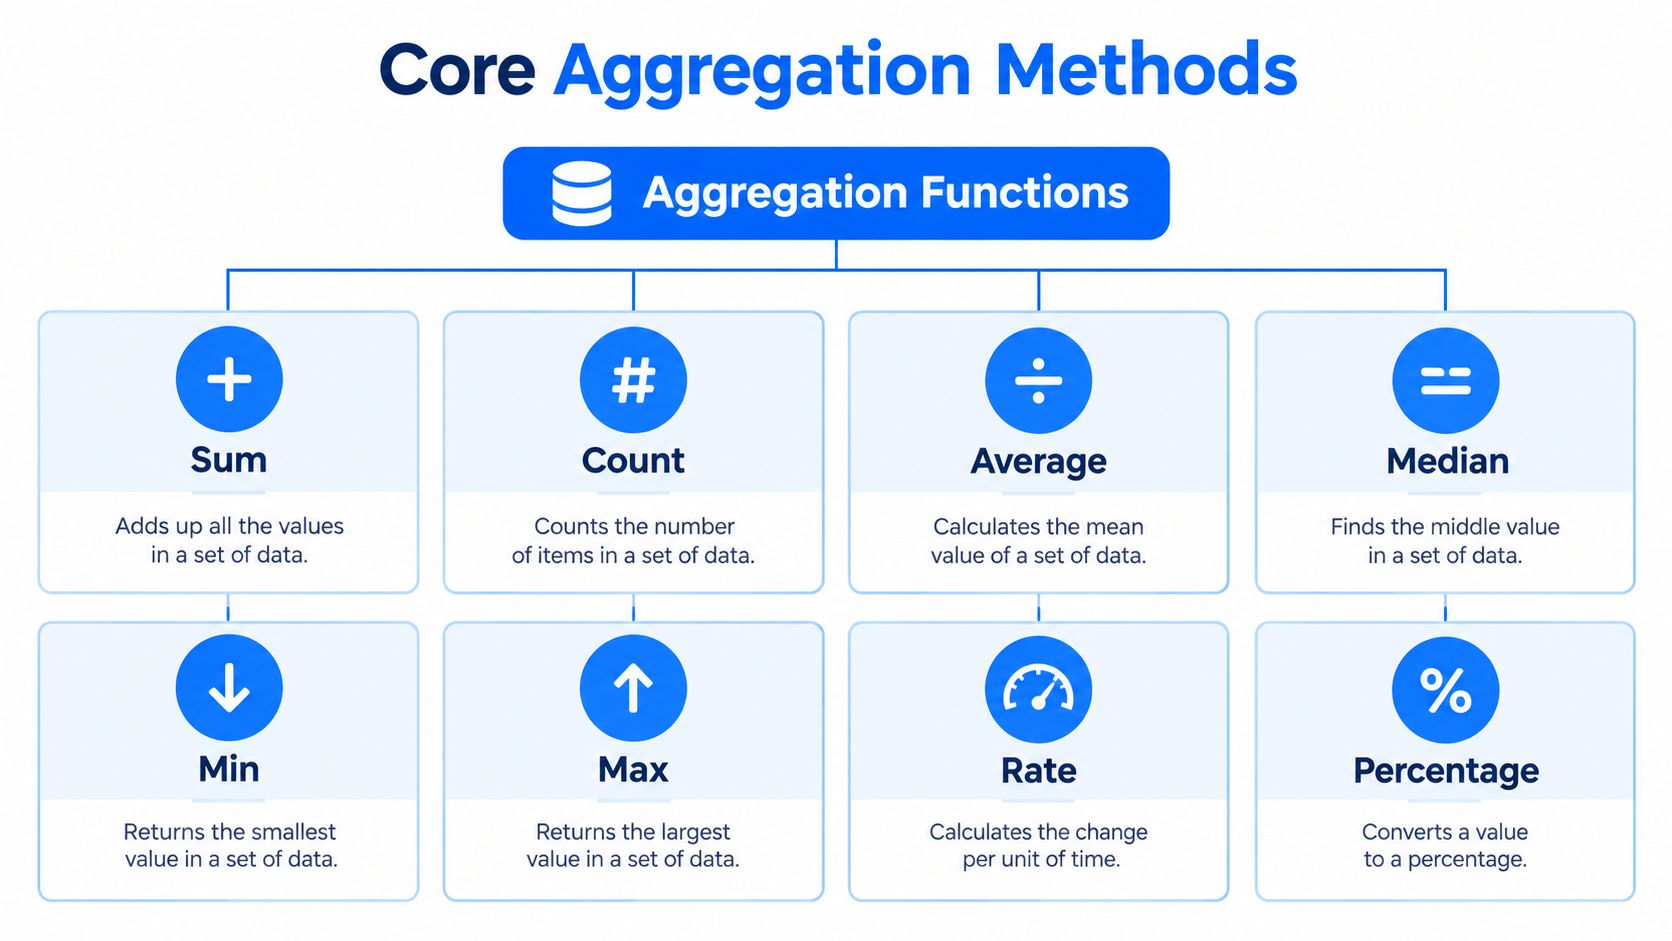
Las funciones principales y lo que conservan
La suma agrega valores. Si cinco pedidos valen 20, 30, 10, 40 y 50, la suma es 150. Es la opción adecuada cuando interesan el volumen, los ingresos, las unidades vendidas o el tiempo total invertido.
El recuento indica cuántos registros hay en el grupo. Conserva el volumen de actividad, pero no el tamaño de los valores, por lo que sirve para transacciones, tickets, usuarios o eventos cuando la pregunta es «¿cuántos?».
El promedio da la media aritmética. Ayuda cuando se busca un valor típico, pero puede inducir a error si unos pocos valores atípicos grandes alejan el resultado de lo que muestran la mayoría de las filas.
La mediana da el valor central tras ordenar los datos. Conviene usarla cuando la distribución es asimétrica, porque resiste los valores extremos mejor que el promedio.
El mínimo y el máximo conservan el valor más pequeño y el más grande. Son útiles para comprobaciones de rango, pero descartan todo lo que queda en medio.
Las tasas y los porcentajes exigen disciplina con el denominador
Una tasa es una razón, como las conversiones divididas entre los visitantes. Un porcentaje es la misma idea expresada en una escala de 100. Ambos solo tienen sentido si el denominador es estable y está claramente definido.
Un error habitual es promediar porcentajes de grupos con denominadores desiguales. Así, un grupo pequeño cuenta lo mismo que uno grande, lo que distorsiona el resultado. Si la pregunta es «¿qué proporción de todo el tráfico convirtió?», el denominador debe ser todo el tráfico, no un promedio de las tasas de conversión mensuales.
Regla general: use la función más sencilla que preserve la decisión que hay que tomar, y nada más. Si la pregunta de negocio es de escala, recurra a la suma o al recuento. Si se trata del comportamiento típico, anteponga la mediana al promedio cuando los datos sean asimétricos.
Rollups, ventanas y agregaciones temporales
El tiempo convierte la agregación en una decisión gobernada, no en un simple cálculo. La misma tabla de compras puede generar ingresos diarios, totales semanales, cifras de cierre mensual o una línea de tendencia móvil, y cada versión responde a una pregunta operativa diferente.
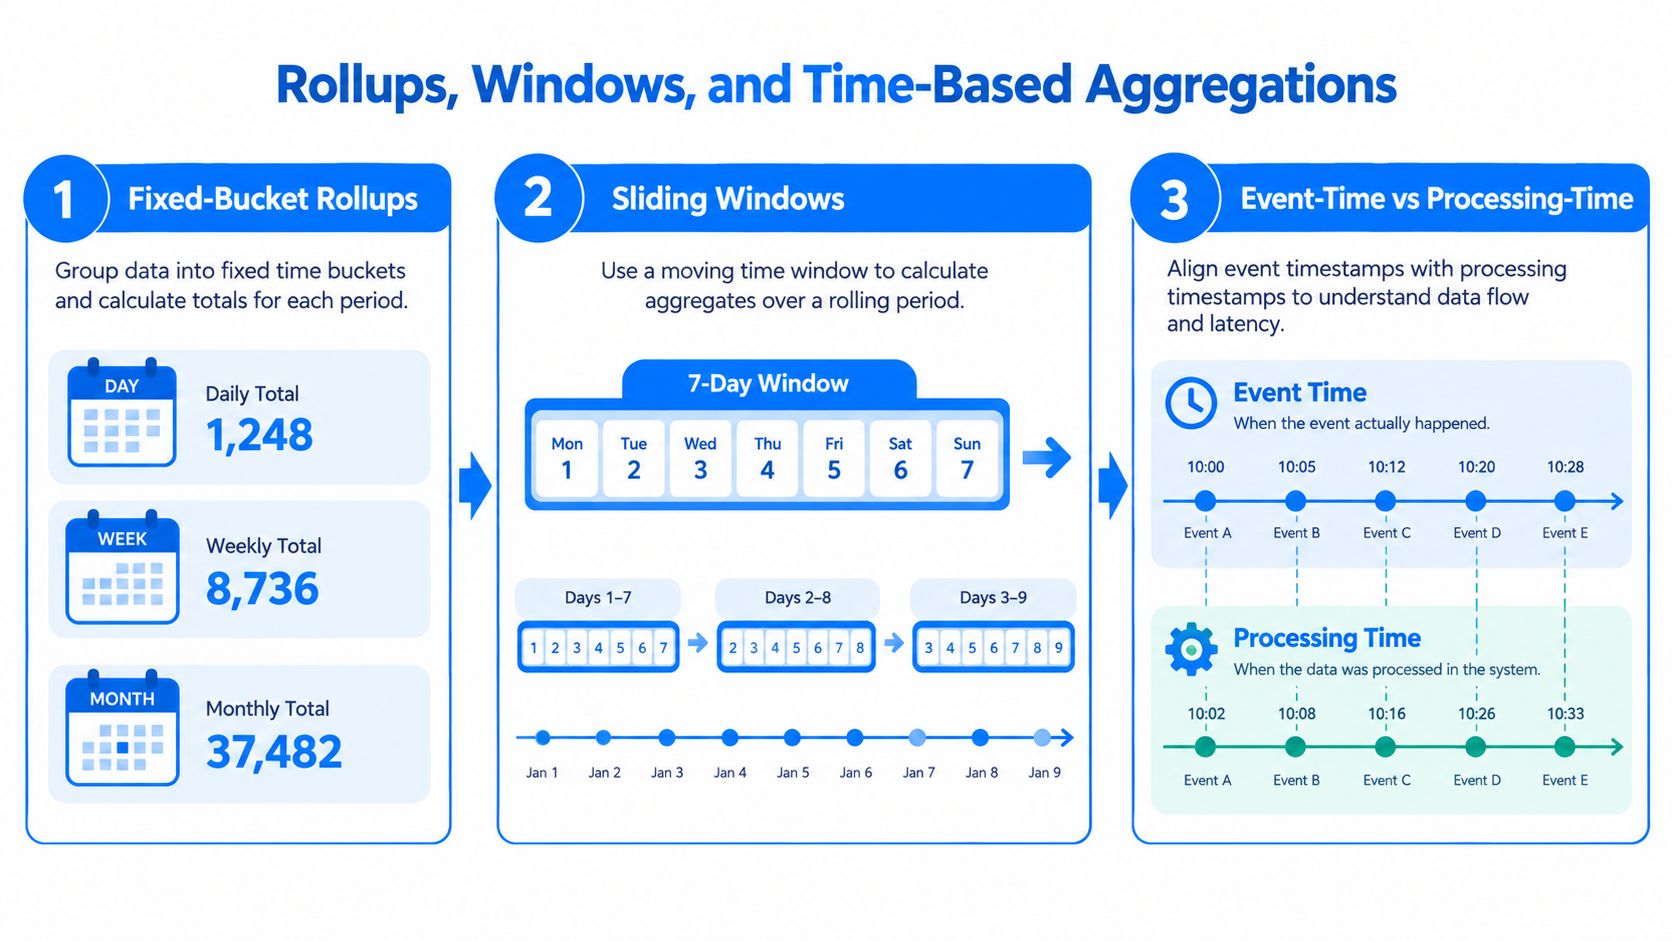
Intervalos fijos y vistas móviles
Un rollup de intervalos fijos agrupa los registros en periodos de calendario como el día, la semana o el mes. Si un equipo comercial quiere los ingresos mensuales por región, el límite del intervalo es el mes, y cada pedido cae en un intervalo u otro según su fecha. Eso facilita comparar los informes recurrentes, pero también obliga a que la regla de corte sea explícita.
Una ventana deslizante mantiene el intervalo en movimiento. Un promedio móvil de 7 días suaviza el ruido diario y muestra la tendencia que un único total diario ocultaría. La contrapartida es que cada nuevo día cambia el resultado, de modo que la cifra de ayer puede variar cuando llegan registros con retraso.
El tiempo del evento y el tiempo de procesamiento no son lo mismo
El tiempo del evento es el momento en que ocurrió la venta, el clic o la lectura del sensor. El tiempo de procesamiento es el momento en que el sistema lo recibió. Si los envíos llegan tarde, un dashboard basado en el tiempo del evento se mantiene fiel a la realidad, mientras que uno basado en el tiempo de procesamiento puede parecer completo demasiado pronto y cambiar después.
Por eso los datos que llegan tarde rompen los dashboards ingenuos, y por eso los equipos combinan los rollups con types of anomaly detection para detectar agregados que se desvían de su línea base. Los registros en bruto pueden ser correctos y el agregado, aun así, ser erróneo para la ventana del informe elegida.
Para los equipos de ingeniería que gestionan estos rollups dentro de motores SQL y trabajos de pipeline, el in-database processing mantiene la lógica cerca de los datos y reduce movimientos innecesarios.
Dónde se produce la agregación en los sistemas de datos modernos
La agregación aparece allí donde un usuario posterior necesita respuestas más rápidas o sencillas de las que pueden ofrecer los registros en bruto. La capa de almacenamiento cambia, pero el patrón es el mismo: agrupar registros, resumirlos y servirlos de una forma que la gente pueda usar.

Los lugares habituales de los rollups
Las bases de datos operativas suelen alimentar dashboards en tiempo real, sobre todo cuando un equipo quiere visibilidad de los niveles de servicio a partir de transacciones en vivo. El punto débil es la presión por la actualidad de los datos, porque los rollups pesados pueden ralentizar el mismo sistema que intenta atender el tráfico de la aplicación.
Los data warehouses suelen albergar modelos dimensionales y tablas de hechos precalculadas. Ahí viven a menudo los informes de finanzas, ventas y dirección, pero los rollups del warehouse pueden desincronizarse de las tablas de origen si la lógica de actualización está incompleta o el particionado es incoherente.
Los data lakes y lakehouses admiten pipelines por lotes y en streaming, lo que los hace flexibles para cargas de trabajo mixtas. El precio es la complejidad, porque las ventanas de streaming pueden perder eventos tardíos y los trabajos por lotes pueden ocultar problemas hasta la siguiente ejecución.
Elegir el lugar según la pregunta
Las plataformas de observabilidad usan rollups de métricas para las alertas y el análisis de tendencias, porque las alertas necesitan resúmenes rápidos en lugar de logs en bruto. Si necesita orientación arquitectónica para diseñar un stack moderno, la panorámica modern data architecture approaches de Ekipa es una referencia útil sobre cómo encajan normalmente estas capas.
Cuando la agregación se ejecuta cerca de los sistemas de producción, la forma de la consulta importa tanto como las matemáticas. Un dashboard rápido construido sobre una agrupación equivocada puede ser más peligroso que uno lento que es claramente incompleto.
Por qué los datos agregados importan para la analítica y la observabilidad
Los dashboards, los informes para la dirección, las presentaciones regulatorias y las features de machine learning dependen de vistas agregadas. Eso significa que un solo agregado débil puede propagar errores a todos los sistemas posteriores, aunque los datos de origen sigan intactos.
La perspectiva de la observabilidad es igual de importante. Un total o una tasa inusual suele ser la primera pista de que algo cambió aguas arriba, ya sea un join roto, una partición omitida, un feed retrasado o un cambio de esquema. Las métricas agregadas hacen visibles esas señales rápidamente, y por eso los equipos las supervisan primero.
Lo que oculta la agregación si no se conserva el contexto
Un total puede ocultar una población que se reduce. Un promedio puede esconder una cola larga. Una tasa puede parecer estable mientras cambia el denominador. Por eso los buenos agregados llevan metadatos junto al número, como el recuento de registros, la cobertura y las dimensiones de agrupación que dieron forma al resultado.
Para los equipos que construyen vistas de monitorización, la pregunta no es solo «¿cuál es la métrica?», sino también «¿qué registros la alimentaron, qué se excluyó y qué cambió desde la última vez?». La respuesta determina si el número es fiable o simplemente ordenado.
Si ya trabaja con stacks de monitorización, la página what is data observability es un complemento práctico de esta idea, porque presenta las métricas como algo que se inspecciona, no solo como algo que se muestra.
Riesgo de privacidad y de divulgación en los resultados agregados
La agregación mejora la privacidad en muchos casos, pero no es sinónimo de anonimato. El NIST define la información agregada como datos recopilados de múltiples personas para hacer comparaciones o identificar patrones, y advierte además de que recopilar datos puede generar riesgos adicionales, porque la totalidad de los datos puede revelar una imagen más completa o permitir la desanonimización NIST aggregated information.
Por qué los grupos pequeños siguen generando exposición
Las reglas de control de divulgación existen porque las celdas pequeñas pueden seguir apuntando a personas u organizaciones. Las directrices de la estadística oficial turca consideran confidencial una celda de una tabla agregada cuando contiene menos de 3 unidades estadísticas, y también señalan los casos de dominancia en los que una unidad aporta más del 80 % del valor de la celda o dos unidades más del 90 % NIST data aggregation. La Care Quality Commission del Reino Unido cita además como regla general evitar los grupos de 10 o menos, y usar grupos de 5 o menos solo en situaciones de riesgo especialmente bajo CQC anonymisation guidance.
No son puertos seguros universales. El riesgo sigue dependiendo de la geografía, la granularidad temporal, el conocimiento externo y lo que un observador decidido pueda deducir combinando vistas.
Los controles que deben formar parte del proceso de publicación
La generalización amplía una categoría estrecha a otra más amplia, como la provincia en lugar del municipio. La supresión oculta el valor por completo cuando una celda es demasiado pequeña. La perturbación modifica el valor publicado para reducir el riesgo de divulgación sin descartar toda la métrica. En la práctica, estos controles funcionan juntos, no de forma aislada.
Un error habitual es suponer que un dashboard es seguro porque ya no muestra nombres. Los filtros estrechos pueden recrear muy rápido el riesgo de identificación, sobre todo por geografía, rango de fechas o segmento de clientes. Si se permite a los usuarios profundizar demasiado, el agregado puede dejar de comportarse como un grupo y empezar a comportarse como una sola fila disfrazada.
La Customer data protection guidance es relevante aquí, porque los controles de privacidad solo funcionan cuando se evalúan frente al contexto exacto de publicación, no solo frente a la etiqueta «agregado».
Validación y calidad de los datos
Un agregado puede ser matemáticamente correcto y, aun así, engañoso. Por eso los resultados agregados necesitan sus propios controles de calidad, no solo un aprobado o suspenso de las filas de origen.
Los controles que detectan los fallos más comunes
Los promedios pueden ocultar la paradoja de Simpson, en la que una tendencia se invierte al desglosar por una dimensión relevante. Un KPI puede parecer sano en el rollup mientras una región o un segmento se deteriora por debajo. No es un error matemático, es un error de agrupación.
Las salvaguardas prácticas son sencillas:
Tamaño mínimo del grupo: confirme que cada grupo publicado es lo bastante grande para reducir tanto el riesgo de divulgación como las conclusiones ruidosas.
Estabilidad del denominador: compruebe si la población que hay detrás de una tasa ha cambiado de forma que las comparaciones queden desequilibradas.
Tratamiento de nulos: decida si los valores ausentes se excluyen, se imputan o se tratan como cero antes de ejecutar el rollup.
Tratamiento de duplicados: elimine o marque los registros repetidos antes de que inflen los totales.
Datos que llegan tarde: concilie el tiempo del evento con el tiempo de procesamiento para que el dashboard no aparente ser definitivo demasiado pronto.
Linaje: conserve el camino desde el agregado hasta los registros de origen y la lógica de agrupación.
Señales que deberían desencadenar una investigación
Si la población agregada se reduce de repente, se concentra mucho o cambia de dimensiones de un modo que aumenta el riesgo de divulgación, alguien debería revisar el pipeline de inmediato. No son cambios cosméticos. Suelen significar que la definición, el feed de origen o el contexto de publicación han cambiado.
Para el trabajo de calidad y aplicación de reglas, data validation rules, checks, and continuous data quality es un tema complementario relevante, porque el objetivo de la validación es que el agregado sea fiable, no solo que esté calculado.
Regla práctica: no se pregunte si la métrica es «correcta» hasta haber comprobado que el grupo, el denominador y el linaje siguen significando lo que usted cree.
Un ejemplo práctico: de los registros en bruto a un agregado fiable
Partamos de un flujo de eventos de compra de clientes. Cada registro tiene una marca de tiempo, una región, un valor de pedido y un estado de envío. El primer agregado es sencillo: sumar los valores de los pedidos y contar los pedidos por día y región para obtener los ingresos diarios y el volumen de pedidos.
Construir la tendencia sin perder el contexto de decisión
A continuación, se añade un promedio móvil de 7 días sobre los totales diarios. Eso suaviza las oscilaciones del fin de semana y da al equipo una línea de tendencia más estable para la revisión operativa. Si un envío tardío llega después del cierre diario, la versión del agregado por tiempo del evento debe recalcularse, mientras que la vista por tiempo de procesamiento puede mantenerse como pista de auditoría de cuándo se enteró el sistema.
Después llega la decisión de privacidad. Si una región tiene muy pocos pedidos, o si un solo comercio aporta casi todo en esa región, el equipo debería agrupar la geografía o suprimir la celda en lugar de publicar una cifra frágil. Así el dashboard sigue siendo útil sin facilitar la identificación de una persona o un proveedor.
Tratar el agregado como un activo supervisado
Una vez que la métrica está en producción, pasa a formar parte de la observabilidad. Si el total de ingresos diarios cae bruscamente pero el número de pedidos no, es una señal para revisar precios, devoluciones o valores ausentes. Si la población que hay detrás de la métrica cambia de repente, el equipo debería examinar la lógica de los filtros antes de que nadie confíe en el gráfico.
La idea del ejemplo es sencilla. La agregación no es el paso final. Es el punto en el que confluyen la corrección, la privacidad y la confianza operativa.
Referencia rápida para trabajar con datos agregados
Definición: los datos agregados son información a nivel de grupo creada al combinar registros individuales en resúmenes como recuentos, totales, promedios, tasas o distribuciones.
Funciones habituales:
Suma para el volumen. Recuento para la frecuencia de registros. Promedio para el valor típico. Mediana para distribuciones asimétricas. Mínimo y máximo para comprobaciones de rango. Tasa y porcentaje para razones, con un denominador cuidadosamente definido.
Umbrales de privacidad que conviene recordar:
Los grupos pequeños pueden seguir revelando información. Al evaluar el riesgo de publicación, preste atención a menos de 3 unidades, a patrones de dominancia por encima del 80 % o del 90 % y a grupos con pocos casos, en torno a 10 o menos.
Controles de validación que deben mantenerse:
Tamaño mínimo del grupo, estabilidad del denominador, tratamiento de nulos, tratamiento de duplicados, gestión de los datos que llegan tarde y linaje hasta los registros de origen.
Mentalidad operativa:
La agregación es una transformación gobernada, no una garantía de privacidad ni una garantía de calidad.
digna ayuda a los equipos a supervisar los datos que hay detrás de estos agregados, no solo el dashboard que se apoya en ellos. Si necesita detección de anomalías, validación, seguimiento de la puntualidad de los datos, monitorización de esquemas y ejecución in-database dentro de su propio entorno, visite digna y descubra cómo encaja en su stack de datos.
Para un catálogo de las métricas de volumen, actualidad y distribución que mantienen fiables este tipo de agregados a lo largo del tiempo, consulte métricas de data observability.
Preguntas frecuentes
¿Qué son los datos agregados?
Los datos agregados son información de resumen a nivel de grupo que se crea al combinar registros individuales en recuentos, sumas, promedios, tasas o distribuciones. Por ejemplo, 1 millón de transacciones de clientes puede resumirse en 12 totales mensuales por mercado, lo que permite comparar mercados y detectar la estacionalidad sin revisar cada compra.
¿Cuáles son las funciones de agregación más comunes?
Suma, recuento, promedio, mediana, mínimo, máximo, tasa y porcentaje cubren la mayor parte de los informes. Cada una conserva algo distinto: la suma mantiene el volumen, el recuento la actividad, la mediana resiste los valores atípicos en datos asimétricos y el mínimo y el máximo sirven para comprobar rangos. Tasas y porcentajes solo tienen sentido con un denominador estable y bien definido.
¿Los datos agregados son anónimos?
No de forma automática. La agregación reduce el riesgo para la privacidad, pero los grupos pequeños o dominados por pocos miembros pueden seguir apuntando a personas u organizaciones. Algunas directrices de estadística oficial consideran confidencial una celda con menos de 3 unidades o en la que una unidad aporta más del 80 % de su valor, por lo que puede hacer falta suprimir o generalizar.
¿Por qué no conviene promediar porcentajes entre grupos?
Promediar porcentajes de grupos de distinto tamaño hace que un grupo pequeño cuente tanto como uno grande, lo que distorsiona el resultado. Si la pregunta es qué proporción de todo el tráfico convirtió, hay que dividir el total de conversiones entre el tráfico total en lugar de promediar las tasas de conversión mensuales.
¿Cómo se validan los datos agregados?
Revisando el propio agregado y no solo las filas de origen: tamaño mínimo del grupo, estabilidad del denominador, tratamiento de nulos y duplicados, datos que llegan tarde y linaje hasta los registros de origen. Después hay que seguir supervisándolo. Si los ingresos diarios caen bruscamente mientras el número de pedidos se mantiene, conviene revisar precios, devoluciones o valores ausentes.


