10 problemas comunes con los datos y cómo detectarlos en 2026
|
9
minuto de lectura

Tiene delante un dashboard que parece tranquilo, los logs de los jobs están en verde y no hay nada visiblemente roto en el data warehouse. Es justo entonces cuando los problemas con los datos causan más daño. Las cifras pueden desviarse, las definiciones pueden cambiar y un modelo puede seguir puntuando mientras el negocio toma decisiones con datos desactualizados, incompletos o incoherentes.
La mayoría de los fallos de datos no se anuncian. Se esconden en estados de éxito, columnas vacías, filas duplicadas, feeds retrasados y lógica de métricas que nadie documentó lo suficiente. El problema de fondo rara vez es “el pipeline está caído”. Es que el pipeline dice que todo va bien mientras el informe, el modelo o la presentación regulatoria pierden fiabilidad poco a poco.
La siguiente lista clasifica diez problemas de datos habituales según lo silenciosamente que fallan, no según la frecuencia con la que se habla de ellos. Cada uno incluye cómo se manifiesta en la práctica, cómo detectarlo a tiempo y qué módulos de digna encajan en el trabajo de detección o mitigación.
Índice
7. Incumplimientos de reglas de negocio y fallos de integridad referencial
8. Deriva silenciosa de los datos y cambios en la distribución
10. Cargas de trabajo sin control y picos de consumo de la plataforma
Convertir estas diez comprobaciones en una rutina permanente de calidad de datos
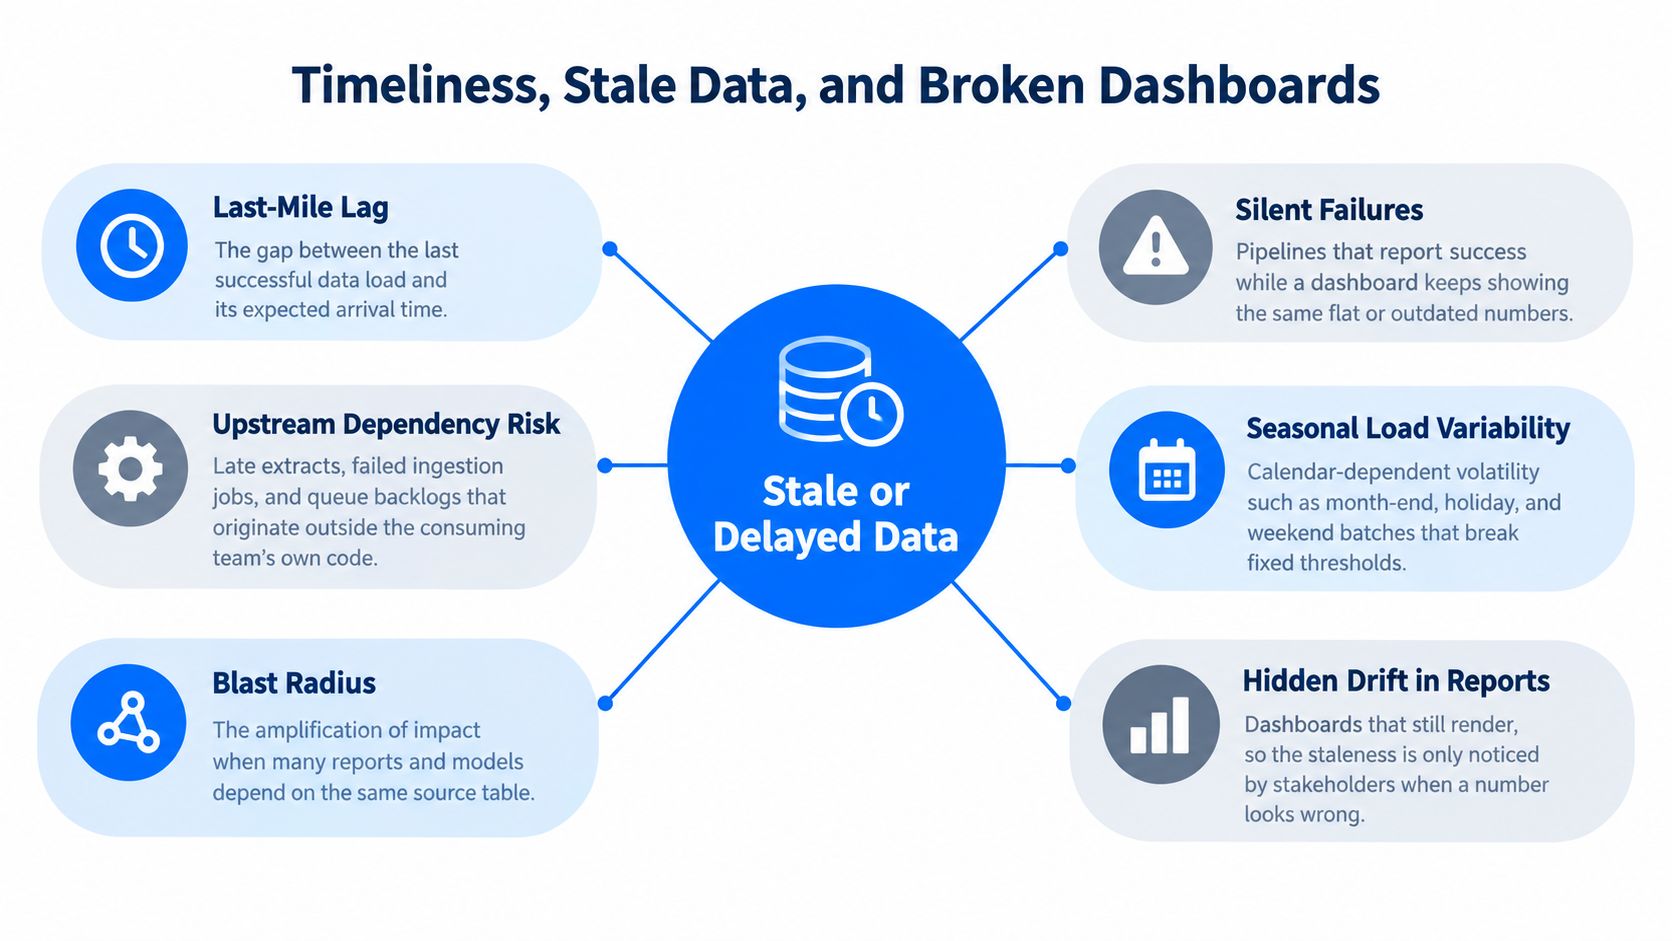
1. Puntualidad, datos obsoletos y dashboards rotos
Un dashboard puede cargarse sin problemas mientras las cifras que contiene ya están desfasadas. Finanzas ve un informe, ventas ve un informe, la dirección ve un informe, y la cifra obsoleta sigue oculta hasta que alguien con conocimiento del dominio detecta la discrepancia.
Así es como se cuelan los fallos de puntualidad. Un feed de origen puede detenerse tras una extracción tardía o una cola acumulada, mientras una tabla de dimensiones se actualiza puntualmente con un mapeo de categorías erróneo. El dashboard sigue mostrándose, pero el significado de las cifras se desvía. Descubrir tarde un problema sale caro en la práctica, y el estudio de IBM sobre brechas de seguridad muestra cuánto tiempo puede pasar hasta que un incidente se identifica y se contiene: la identificación y contención de una brecha lleva de media 241 días, y la detección y escalado cuestan de media 1,47 millones de USD (estudio Cost of a Data Breach de IBM).
Regla práctica: un informe solo está tan actualizado como las tablas que lo alimentan.
Qué vigilar
Ventanas de llegada esperadas: aprenda los horarios normales de entrega a partir del histórico y alerte sobre cargas tardías, ausentes o inesperadamente tempranas.
Mapa de dependencias: registre qué dashboards dependen de qué tablas para que los fallos aguas arriba salgan a la luz antes de que empiece la reunión.
Esquema y tiempos a la vez: un feed que llega a tiempo pero cambia de estructura sigue siendo un fallo.
Use digna Timeliness para aprender los patrones de entrega y calcular los horarios de llegada esperados. Combínelo con digna Data Quality Management para la detección de anomalías, la validación y el seguimiento del esquema en las tablas que alimentan los dashboards clave. Para ver más de cerca el modelo operativo, consulte la guía de digna sobre la monitorización de la puntualidad de los datos.
2. Cargas ausentes o incompletas
Una carga puede terminar sin errores y aun así ser incorrecta. Los ficheros llegan, el esquema coincide y el recuento de filas parece lo bastante cercano como para superar una comprobación rápida. Lo que falta es la región, el sistema de origen o el intervalo de tiempo que nunca llegó a pasar.
Así es como los totales se desvían sin una alarma evidente. El episodio de los informes de COVID-19 de Public Health England es un ejemplo claro: durante varios días se omitieron unos 16.000 resultados positivos porque una hoja de cálculo superó el límite de filas del antiguo formato de Excel utilizado para consolidar los datos (Cómo falló la recogida de datos de COVID-19 de Public Health England). El fallo parecía una variación normal hasta que alguien revisó el origen.
La detección tiene que hacerse a nivel de segmento. Los recuentos totales de filas no bastan, porque una interrupción parcial en una región o una línea de producto puede dejar la cifra global con un aspecto normal. Para la parte de medición, consulte la guía de digna sobre cómo medir la completitud de los datos. Use digna Anomalies para aprender los patrones de volumen normales de cada tabla y señalar las cargas parciales incluso cuando el job del pipeline informa de éxito.
La mitigación es un trabajo repetitivo, y precisamente de eso se trata. Compare los recuentos de origen y destino en cada etapa, registre las filas esperadas frente a las reales y mantenga la pista de auditoría donde alguien pueda revisarla más tarde. Si un feed debe contener todas las tiendas cada día, la ausencia de una tienda en una fecha debería destacar antes de llegar a un dashboard o a una previsión.
3. Deriva del esquema
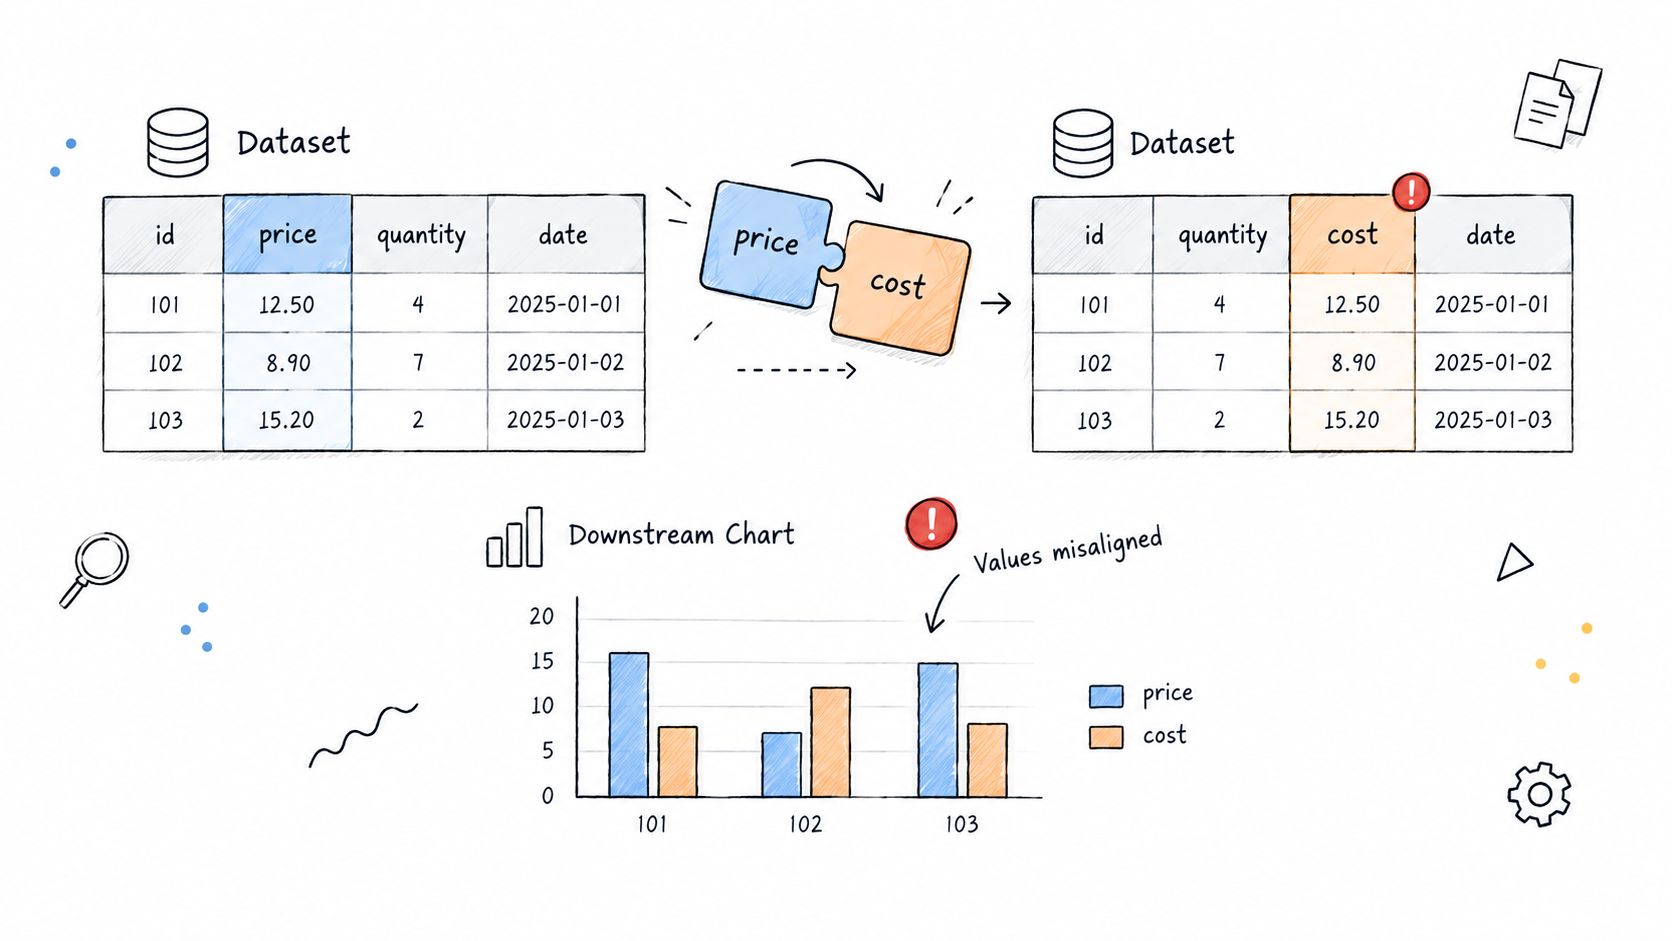
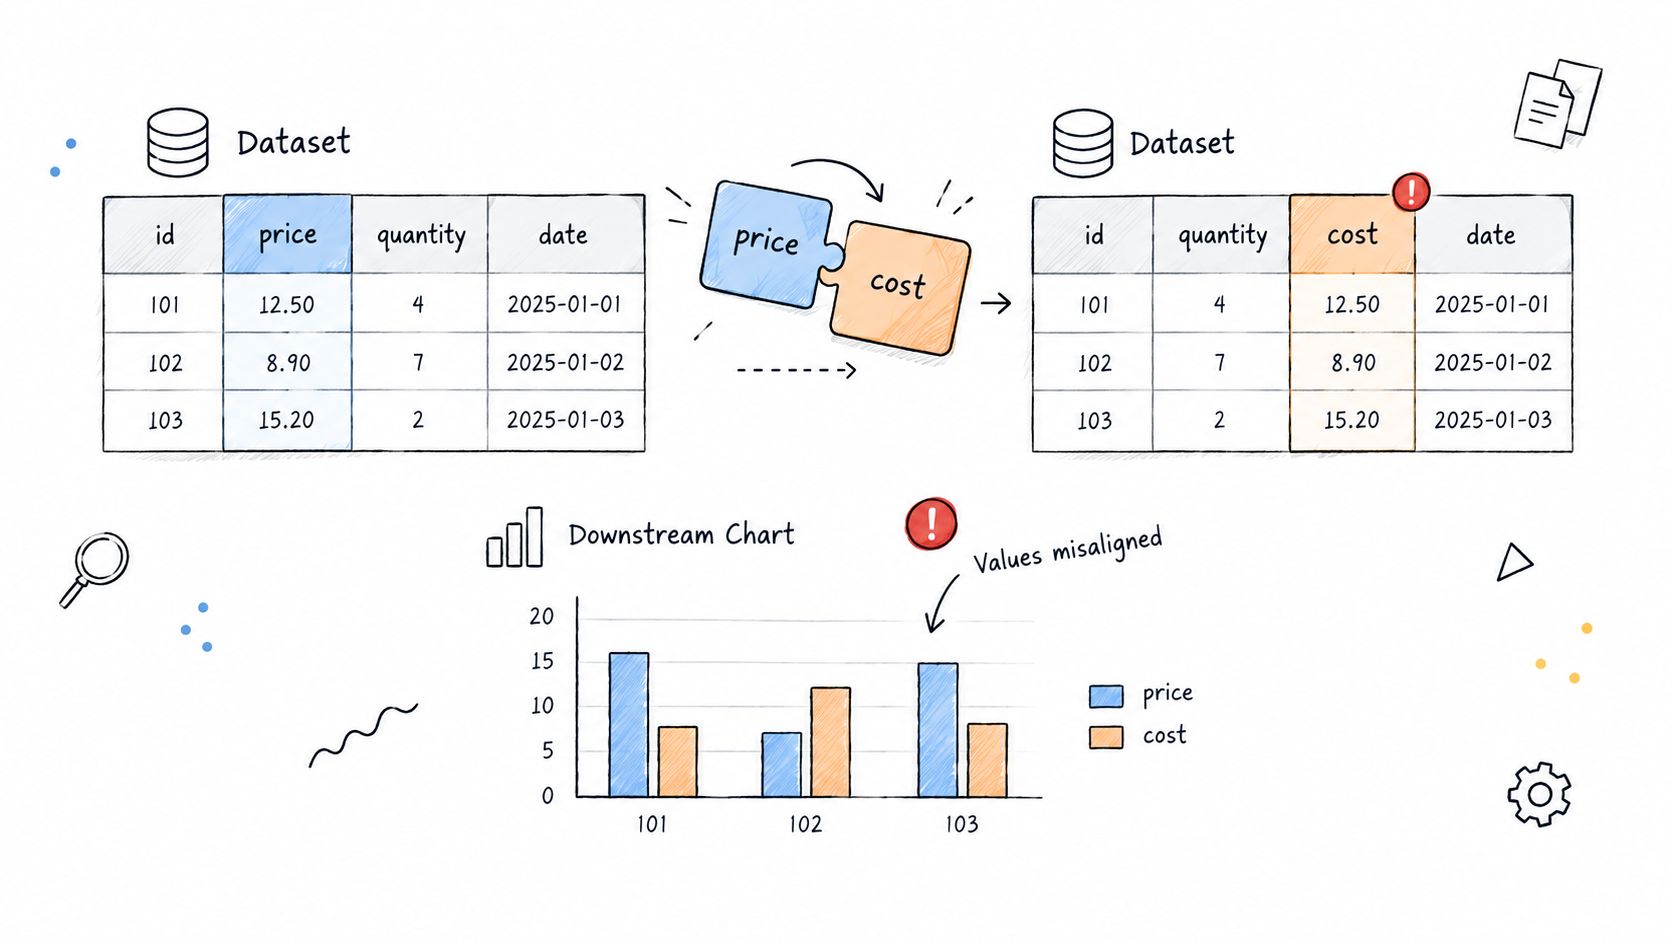
Un campo puede cambiar de estructura mientras el pipeline sigue informando de éxito. Se renombra una columna, cambia un tipo o un origen elimina un campo tras una release, y la lógica aguas abajo sigue ejecutándose con supuestos erróneos. Normalmente esto aparece más tarde en forma de nulos, valores desplazados, cálculos rotos o un modelo que puntúa con entradas que ya no entiende.
Los peores fallos son los silenciosos. Un campo monetario que pasa de decimal a texto puede romper la agregación en la capa de BI mientras el job aguas arriba sigue pareciendo sano. Una columna eliminada también puede sustituirse por un valor por defecto, lo que mantiene vivo el feed y hace que las cifras sean menos fiables sin generar un error evidente.
Cómo detectarlo a tiempo
Vigile de forma continua las columnas añadidas, eliminadas y con tipo cambiado, no solo durante los despliegues.
Clasifique los cambios por impacto para que los cambios disruptivos no esperen en la misma cola que las adiciones inofensivas.
Vincule cada cambio con el origen aguas arriba y con todos los activos aguas abajo que dependen de él.
Use digna Schema Tracker para detectar los cambios estructurales en cuanto se producen y relacionarlos con los activos afectados. La visión general de digna sobre los tipos de esquema ofrece una forma práctica de agrupar esos cambios antes de que se extiendan por la lógica de informes o de scoring. Un contrato de esquema no detendrá todos los cambios, pero sí evita la versión de la deriva del esquema que solo aflora cuando un informe ya ha salido mal.
Un ejemplo visual claro ayuda a los equipos a ver cómo un campo puede reetiquetarse sin que nadie se dé cuenta. Diagrama que ilustra desalineaciones de datos en las que el precio se reetiqueta por error como coste, lo que genera gráficos incorrectos aguas abajo.
4. Registros duplicados
Los duplicados son traicioneros porque cada fila, por separado, parece legítima. El mismo cliente, transacción o póliza aparece dos veces, a veces por reintentos, a veces por sistemas de origen solapados y a veces por una lógica de fusión que no encontró la coincidencia de clave. Nada falla, pero los totales ya son incorrectos.
El daño operativo resulta evidente en cuanto se rastrea. La facturación se infla, el número de clientes exagera la realidad y los informes de cumplimiento empiezan a describir una organización que nunca existió. En una migración, las cuentas duplicadas pueden hacer que los informes de gestión parezcan más sanos o más grandes de lo que son. En los sistemas de streaming, la lógica de reintentos puede escribir la misma transacción varias veces durante un problema de red, y el resultado son ingresos, volúmenes o actividad inflados.
Un buen patrón de control empieza con claves de negocio explícitas. Si no se define la unicidad de la entidad, la regla de deduplicación queda al azar. Use digna Data Validation para imponer la unicidad de las claves y detectar incumplimientos a nivel de registro, y haga que la ingesta sea idempotente para que los reintentos no creen más filas. Para los solapamientos difusos en los que la coincidencia exacta no basta, la guía de digna sobre fuzzy matching ofrece a los equipos un camino práctico para identificar registros lo bastante parecidos como para merecer una revisión.
El número absoluto de duplicados importa menos que la tendencia. Un aumento repentino suele decir más que una línea base estable.
5. Valores nulos y ausentes
Es fácil restar importancia a los nulos porque no todo valor ausente es malo. El problema empieza cuando las tasas de nulos cambian sin explicación, o cuando un campo que debería estar informado empieza a llegar vacío en una parte significativa de los registros. Eso suele apuntar a un fallo en un join, un problema de parseo o un cambio en el origen que nadie advirtió.
Una discrepancia de formato en una clave de join puede hacer que los registros dejen de coincidir, y entonces un atributo clave del cliente desaparece aguas abajo. Una nueva versión de una app móvil puede dejar de capturar un campo por completo, lo que dispara las tasas de nulos mientras el pipeline sigue pareciendo sano. El riesgo no es solo analítico: la falta de campos críticos puede sesgar los modelos y distorsionar las decisiones operativas.
El control adecuado aquí se basa en tasas, no en valores absolutos. Una regla general de “cero nulos” genera ruido, mientras que una línea base medida detecta los cambios significativos. Haga un seguimiento separado de los campos opcionales y obligatorios, y compruebe los valores ausentes disfrazados, como cadenas centinela o números de relleno. Use digna Anomalies para aprender el comportamiento normal de la tasa de nulos por columna y alertar ante desviaciones significativas en lugar de discutir umbrales manuales. La nota de digna sobre la completitud como dimensión de la calidad de datos resulta útil cuando los equipos necesitan separar la completitud real de las suposiciones.
6. Formatos no válidos y valores fuera de rango
Los valores no válidos suelen superar la validación técnica porque el tipo es correcto, pero el contenido no. Una fecha puede parsearse sin problemas y aun así ser imposible. Un precio puede ser numérico y estar en la unidad equivocada. Un código postal puede tener la longitud esperada y no cumplir ninguna de las restricciones reales de las que depende el negocio.
Muchos equipos confunden una ingesta correcta con datos correctos. Un historial sanitario con una fecha de nacimiento en el futuro puede deberse a un intercambio de día y mes entre sistemas. Un minorista puede ingerir precios en céntimos desde un origen y en unidades monetarias desde otro, lo que hace que el mismo producto parezca 100 veces más caro o más barato. El pipeline no se rompió; se rompió la lógica de negocio.
La respuesta es un control explícito del dominio. Documente los rangos permitidos y las listas de códigos de los campos críticos, valídelos a nivel de registro y conserve las filas fallidas con sus motivos. Use digna Data Validation para aplicar esas reglas en las columnas más importantes y combine las comprobaciones basadas en reglas con la detección estadística cuando los valores erróneos solo resultan evidentes frente al histórico. Las directrices de calidad del NIST también son útiles aquí, porque enmarcan la calidad de la información en torno a la utilidad, la integridad y la objetividad, con un error aceptable que depende del caso de uso (estándares de calidad de la información del NIST).
7. Incumplimientos de reglas de negocio y fallos de integridad referencial
Un envío anterior a la fecha del pedido, un préstamo sin registro de aprobación o una póliza que apunta a un cliente inexistente rara vez rompen el pipeline. Lo que rompen es la confianza en las cifras. Estos fallos superan la validación básica porque los campos están presentes, pero la lógica de negocio es incorrecta.
Los fallos más silenciosos suelen estar en las relaciones. Una contraparte cerrada puede seguir apareciendo en los informes de exposición si las actualizaciones de estado no llegan a todas las tablas aguas abajo. Los siniestros pueden seguir haciendo referencia a números de póliza que ya no existen en el registro maestro. Finanzas lo detecta tarde, a menudo cuando alguien ya ha dado el visto bueno a un informe.
Clasifíquelos según cómo fallan. Una clave foránea ausente es ruidosa. Un indicador de estado obsoleto, no.
1. Registros padre ausentes Un registro hijo no apunta a nada, pero la fila sigue llegando a los informes. Detéctelo comprobando cada clave foránea contra la tabla maestra y revise los rechazos a diario. Con digna Data Validation, conserve las filas fallidas junto con el motivo para que operaciones y auditoría puedan rastrear la ruptura.
2. Fechas de negocio que incumplen el orden Llega un evento con fechas que no tienen sentido en secuencia. Detéctelo con reglas de secuencia explícitas, como la aprobación antes del desembolso o el inicio de la póliza antes de la fecha del siniestro.
3. Estados que no coinciden entre sistemas Una tabla dice cerrado y otra sigue diciendo activo. Compare los campos de ciclo de vida entre orígenes y señale los registros que discrepan sobre el estado actual.
4. Referencias operativas huérfanas Una factura, un siniestro o una exposición siguen vinculados a un registro maestro eliminado. Ejecute las comprobaciones referenciales donde se almacenan los datos, no solo después de la agregación.
5. Reglas que solo existen en la cabeza de alguien Documente la regla, nombre a un responsable y haga que la condición de prueba sea legible. Una regla que nadie sabe explicar no superará una revisión.
Mantenga las comprobaciones cerca de los datos, conserve las evidencias y dirija los fallos a las personas que pueden corregir el origen.
8. Deriva silenciosa de los datos y cambios en la distribución
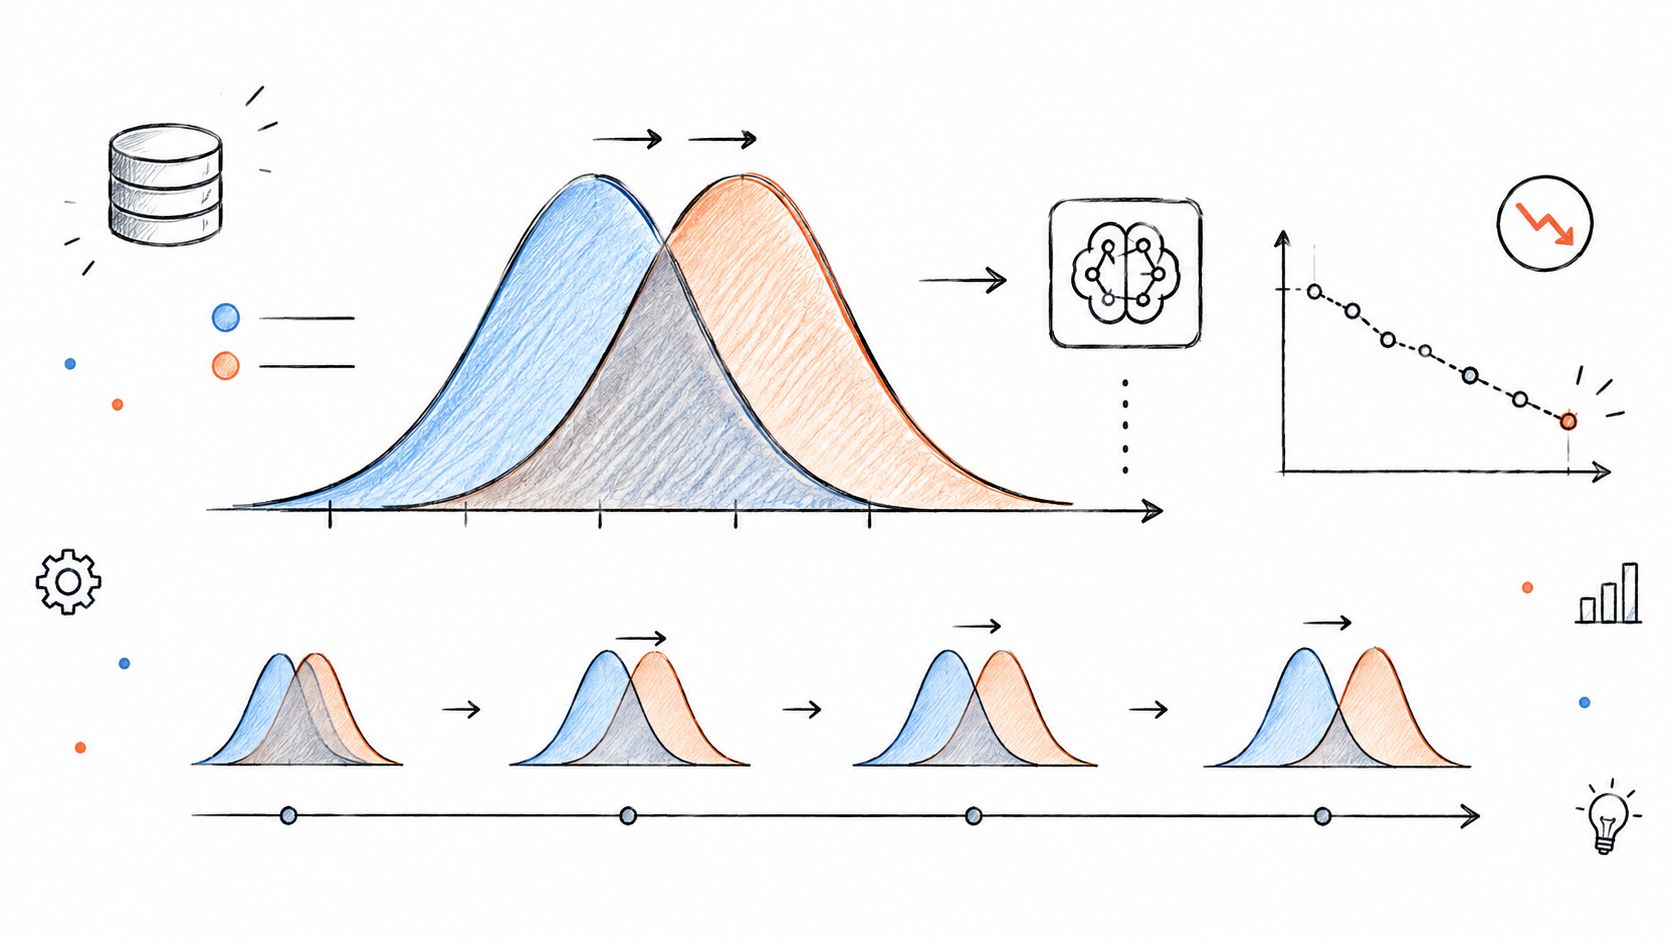
Un pipeline puede seguir sano mientras los datos dejan poco a poco de significar lo mismo. Las medias se mueven, la composición cambia, las correlaciones se debilitan y los informes o modelos pierden fiabilidad sin que falle ningún job ni se rompa el esquema. Por eso la deriva es fácil de pasar por alto y difícil de descartar.
Clasifique estos problemas según lo silenciosamente que fallan. Una caída ruidosa llama la atención. Un cambio de comportamiento silencioso, normalmente no.
1. Deriva en la distribución de las variables Un scorecard sigue funcionando, pero una de sus entradas procede ahora de un segmento de clientes distinto. Compare las distribuciones móviles con una línea base conocida y después con las releases recientes del origen y los cambios de mapeo aguas arriba. Con digna Anomalies, defina rangos esperados por conjunto de datos y use digna Data Analytics para analizar si el movimiento es aislado o forma parte de una tendencia más amplia.
2. Deriva de etiquetas o resultados El propio objetivo cambia tras modificaciones de políticas, productos o enrutamiento. El modelo puede parecer peor aunque el pipeline esté intacto. Haga un seguimiento de las tasas de resultados a lo largo del tiempo y contrástelas con los eventos de negocio antes de tratar el cambio como un deterioro del modelo.
3. Cambios silenciosos de unidades o codificación Una moneda, un código de estado o un mapeo de categorías cambia aguas arriba, pero el feed sigue validándose. El dashboard sigue en verde mientras las cifras dejan de ser comparables. Compare los despliegues del origen y los logs de transformación, y confirme que los valores siguen teniendo el significado que esperan los usuarios aguas abajo.
4. Cambios en la composición de los segmentos Un informe pasa a estar dominado por una nueva región, canal o grupo de dispositivos, y la media global se mueve con ello. Desglose las métricas por segmento antes de hablar de tendencia. Si un segmento explica la mayor parte del cambio, el problema es de composición, no de rendimiento.
5. Pérdida gradual de correlación Dos campos que antes se movían juntos ya no lo hacen. Esto suele aparecer tras un cambio de proveedor de datos, un feed retrasado o una nueva regla de negocio. Vigile las relaciones entre pares de campos y alerte ante desviaciones sostenidas, no solo ante picos puntuales.
El hábito útil es sencillo. Monitorice las distribuciones, vincule las alertas a los eventos del origen y mantenga visibles las filas fallidas y su contexto para que los analistas puedan distinguir la deriva de un cambio real.
9. Definiciones, unidades y lógica de métricas incoherentes
Dos dashboards pueden ser “correctos” y aun así no coincidir, y por eso esta categoría daña tanto la confianza. Un equipo cuenta cuentas, otro cuenta clientes únicos, un tercero informa de los ingresos en miles y un cuarto convierte las zonas horarias de otra manera. Las cifras son coherentes internamente, pero inútiles al compararlas.
Este tipo de discrepancia permanece oculta hasta que la dirección pregunta por qué el mismo trimestre se ve distinto en dos sistemas. El fallo del Mars Climate Orbiter es el ejemplo clásico de incompatibilidad de unidades, y sigue siendo relevante porque la analítica moderna tiene la misma debilidad a mayor velocidad. Si finanzas, operaciones y producto definen “cliente activo” cada uno a su manera, cada reunión se convierte en un ejercicio de conciliación.
Un glosario ayuda, pero solo si cada métrica tiene asignados un responsable, una lógica de cálculo y unas unidades. Estandarice las conversiones lo antes posible, concilie periódicamente las métricas críticas e investigue las diferencias que superen las tolerancias acordadas. Use digna Business Monitoring para hacer el seguimiento de los KPI sobre los datos subyacentes, de modo que los cambios inesperados afloren incluso antes de que las definiciones estén totalmente armonizadas. Para los equipos a los que les gusta mirar el comportamiento de las métricas con un enfoque de fiabilidad, las métricas MTBF, MTTR y OEE explicadas es una referencia complementaria útil.
Si dos equipos usan la misma etiqueta para lógicas distintas, el problema es la etiqueta.
10. Cargas de trabajo sin control y picos de consumo de la plataforma
El lanzamiento de un dashboard, un backfill o un nuevo flujo de autoservicio pueden llevar una plataforma por encima de su carga normal antes de que nadie lo note. El data warehouse sigue respondiendo, pero la latencia de las consultas aumenta, los costes suben y los jobs programados empiezan a salirse de sus ventanas.
Los equipos suelen clasificar estos picos como un tema de infraestructura, pero el volumen de consultas, el crecimiento del almacenamiento y el aumento de los tiempos de ejecución también son problemas de fiabilidad de los datos. Suelen fallar sin previo aviso. El primer síntoma rara vez es una caída. Es una actualización del modelo más lenta, un informe retrasado o una factura que nadie había presupuestado. Los estudios sobre el uso de la nube apuntan una y otra vez al mismo patrón: la capacidad sin usar o mal gestionada se convierte en despilfarro y en lastre operativo, y por eso el crecimiento de las cargas de trabajo debe formar parte de las comprobaciones de datos tanto como de las revisiones de infraestructura.
Mantener visible el comportamiento de la plataforma
Seguimiento por responsable de la carga de trabajo: atribuya los picos a un equipo, pipeline o dashboard antes de que el patrón se extienda.
Línea base por patrón temporal: compare el comportamiento entre semana, en fin de semana y en las ventanas de release antes de alertar.
Revisión con finanzas: el control de costes funciona mejor cuando ingeniería y finanzas leen las mismas tendencias.
Use digna Data Platform Observability para monitorizar cargas de trabajo, consumo, disponibilidad y métricas de rendimiento en un solo lugar. Así resulta más fácil detectar el modo de fallo silencioso, en el que el sistema sigue en marcha mientras el coste y la latencia se salen de la tolerancia. Para los equipos de plataforma, esa visibilidad suele marcar la diferencia entre un aumento controlado y una sorpresa costosa.
Comparativa de los 10 principales problemas de datos
Problema | 🔄 Complejidad de implantación | 💡 Recursos necesarios | ⚡ Velocidad de detección esperada | 📊 Resultados / impacto esperados | ⭐ Casos de uso ideales / ventaja clave |
|---|---|---|---|---|---|
Puntualidad, datos obsoletos y dashboards rotos | Media-alta; requiere ventanas de SLA & mapa de dependencias | Moderados: monitorización, linaje, alertas | Lenta si solo se revisan dashboards; ⚡ rápida con aprendizaje de ventanas de llegada | Alto impacto en muchos informes; erosiona la confianza de los stakeholders | Dashboards críticos & cumplimiento de SLA; comunicación rápida aguas arriba |
Cargas ausentes o incompletas | Media; necesita líneas base de volumen por segmento y conciliación | Moderados: logs de recuento de filas, comprobaciones por partición | Media; las cargas parciales pueden pasar desapercibidas sin comprobaciones por segmento | Gran riesgo para agregados y tendencias; puede falsear los volúmenes | Pipelines batch/ETL y métricas agregadas; detectar segmentos ausentes |
Deriva del esquema | Media; requiere seguimiento continuo de esquemas/contratos | Bajos-moderados: registro de esquemas o trackers | Media-rápida con comparación automática de esquemas | Rompe transformaciones, genera nulos o errores aguas abajo | Sistemas con muchos productores; aplicar contratos de esquema |
Registros duplicados | Media; requiere diseño de claves de negocio e idempotencia | Bajos-moderados: lógica de deduplicación, herramientas de matching | Media; a menudo visible tras la agregación si no se monitoriza | Recuentos/sumas inflados y errores en facturación o analítica de clientes | Pipelines de ingesta, resolución de identidad de clientes, facturación |
Valores nulos y ausentes | Baja-media; monitorización por columna y líneas base de nulos esperados | Bajos: comprobaciones y alertas por columna | Rápida con monitorización de la tasa de nulos | Sesgo en analítica/ML y atributos ausentes para los joins | Variables de ML y campos obligatorios; detectar picos repentinos de nulos |
Formatos no válidos y valores fuera de rango | Baja-media; definir reglas de sintaxis/semántica/rango | Bajos: reglas de validación y listas de referencia | Rápida mediante comprobaciones deterministas | Valores inverosímiles o no conformes que distorsionan las métricas | Campos con dominios conocidos (fechas, códigos, precios); comprobaciones regulatorias |
Incumplimientos de reglas de negocio & fallos referenciales | Alta; requiere lógica entre tablas y responsables definidos | Altos: comprobaciones de integridad, responsables, pistas de auditoría | Media; puede ser costosa, por lo que a menudo se hace por muestreo | Incumplimientos normativos, problemas de conciliación, riesgo de auditoría | Finanzas reguladas, riesgos y procesos de conciliación |
Deriva silenciosa de los datos & cambios en la distribución | Media-alta; líneas base estadísticas y monitorización de relaciones | Moderados-altos: herramientas de detección de deriva, líneas base a largo plazo | Lenta por naturaleza; ⚡ más rápida con detectores de deriva continuos | Degradación gradual de los modelos y tendencias engañosas | Modelos de ML en producción y líneas base analíticas de largo recorrido |
Definiciones, unidades & lógica de métricas incoherentes | Alta; gobierno, glosario y alineación entre equipos | Altos: documentación, conciliación, capas de conversión | Lenta; a menudo se detecta en revisiones o auditorías | Dashboards contradictorios y pérdida de confianza en los KPI | KPI transversales, reporting ejecutivo, métricas consolidadas |
Cargas de trabajo sin control & picos de consumo de la plataforma | Media; líneas base por carga de trabajo y atribución | Altos: telemetría de la plataforma, control de costes, playbooks de remediación | Media-rápida mediante métricas y alertas de la plataforma | Sobrecostes, jobs retrasados, degradación del rendimiento | Data warehouses compartidos, FinOps, planificación de producción y backfills |
Convertir estas diez comprobaciones en una rutina permanente de calidad de datos
Empiece por los problemas que afectan a sus dashboards más utilizados y a sus informes regulados. Asigne a cada uno un responsable, un método de detección y una ruta de alerta, porque “alguien debería revisarlo” no es un control. Si los datos sustentan finanzas, sanidad, informes públicos, operaciones con clientes o pipelines de IA, la primera tarea es hacer visible el fallo antes de que llegue a una reunión, a una presentación regulatoria o a un modelo.
Revise esta lista cada trimestre. Aparecen nuevos orígenes, los esquemas cambian, los equipos crean nuevos dashboards y el uso de la plataforma crece de formas que exigen controles que hace seis meses no hacían falta. Los sistemas que envejecen bien son aquellos en los que la puntualidad, la completitud, los cambios de esquema, la validación y la detección de anomalías se monitorizan como una rutina, no como respuesta a una crisis.
El punto de partida más práctico son los tres problemas con más probabilidades de afectar a sus informes críticos este mes. Defina primero sus líneas base y amplíe después a los modos de fallo relacionados una vez que las alertas sean fiables. Ahí es donde digna encaja bien, porque sus módulos cubren la puntualidad, los cambios de volumen, los nulos, los cambios de esquema, las reglas a nivel de registro, la monitorización de KPI de negocio y la observabilidad de la plataforma en un único modelo operativo.
Lo que más importa es la constancia. Si puede detectar a tiempo los datos obsoletos, las cargas ausentes y los cambios estructurales, ya habrá eliminado una gran parte de los fallos silenciosos que hacen que los equipos de datos pierdan la confianza en sus propios resultados. Si puede demostrar la regla de negocio, la ventana de actualización y el origen del cambio, el resto se vuelve manejable.
digna ofrece a los equipos una forma práctica de monitorizar los datos que impulsan los informes, las operaciones y la IA. Si se enfrenta a feeds obsoletos, deriva, registros ausentes o cambios de esquema, visite digna para ver cómo sus módulos dan soporte a la puntualidad, la validación, la detección de anomalías, el seguimiento del esquema y la observabilidad de la plataforma dentro de su propio entorno.
Cuando salta una alerta, la siguiente pregunta es quién la clasifica y con qué rapidez se corrige, y el proceso de gestión de incidencias de calidad de datos describe esos pasos desde la detección hasta la corrección cerrada.
Preguntas frecuentes
¿Cuáles son los problemas más comunes con los datos?
Los diez más comunes son los datos obsoletos, las cargas incompletas, la deriva del esquema, los duplicados, los valores nulos, los formatos no válidos, los incumplimientos de reglas de negocio, la deriva silenciosa de la distribución, las métricas definidas de forma incoherente y los picos de consumo de la plataforma. La lista los ordena por lo silenciosamente que fallan.
¿Cómo se detecta una carga parcial de datos cuando el job informa de éxito?
Compruebe el volumen por segmento y no como un único total. La falta de una región o una línea de producto puede dejar el recuento global con un aspecto normal, así que compare los recuentos de origen y destino por etapa y por segmento, y alerte cuando desaparezca una tienda o una fecha.
¿Por qué es peligrosa la deriva del esquema si el pipeline sigue funcionando?
Porque la lógica aguas abajo sigue trabajando con supuestos erróneos. Una columna renombrada, un decimal convertido en texto o un campo sustituido por un valor por defecto pueden generar nulos, agregaciones rotas y cifras engañosas sin ningún error visible. Vigilar continuamente las columnas añadidas, eliminadas y con tipo cambiado lo detecta a tiempo.
¿Deben las reglas de calidad de datos prohibir por completo los valores nulos?
No. Una regla general de cero nulos genera ruido, porque algunos campos son opcionales de forma legítima. Es mejor monitorizar las tasas de nulos frente a una línea base aprendida por columna, separar los campos opcionales de los obligatorios y vigilar los valores ausentes disfrazados, como cadenas centinela o números de relleno.
¿Por dónde debe empezar un equipo al crear una rutina de calidad de datos?
Por los tres problemas con más probabilidades de afectar a sus informes críticos este mes. Asigne a cada uno un responsable, un método de detección y una ruta de alerta, defina líneas base y amplíe a los modos de fallo relacionados cuando las alertas sean fiables. Revise la lista cada trimestre.