Gestión de problemas de calidad de datos: arréglalos antes
|
10
minuto de lectura

El panel dice que los ingresos han caído. El CFO pregunta si bajó la demanda, cambiaron los precios o finanzas volvió a cargar la tabla equivocada. En Slack, una analista ya ha publicado una captura con tres cifras distintas para el mismo KPI. Alguien parchea un modelo SQL, relanza una pipeline y lo da por arreglado.
Dos días después el mismo problema vuelve desde otro origen aguas arriba.
Ese es el patrón con el que conviven muchos equipos de datos. No un campo roto aislado, sino un bucle recurrente de cargas rancias, deriva silenciosa de esquema, alertas duplicadas y propiedad difusa. Los arreglos improvisados parecen rápidos en el momento, pero suelen quedarse en el alivio del síntoma. No definen quién responde del defecto, qué tiempo de respuesta es aceptable ni cómo evita el equipo que la misma clase de problema se reabra.
Tabla de contenidos
Por qué los problemas de calidad de datos necesitan un proceso gestionado
El flujo de gestión de problemas de calidad de datos, de la detección a la prevención
Incrustar el proceso en herramientas, roles y operación diaria
Evitar problemas recurrentes y demostrar que el proceso funciona
Por qué los problemas de calidad de datos necesitan un proceso gestionado
Una carga defectuosa aterriza a las 6:10. A las 8:00, finanzas cuestiona los ingresos, una analista ha silenciado tres alertas ruidosas y un ingeniero relanza un trabajo sin saber si el defecto empezó en la ingesta del origen, en un cambio de transformación o en una tabla de referencia rota. Los equipos suelen llamar a eso triaje. En la práctica es trabajo de cola sin modelo operativo.
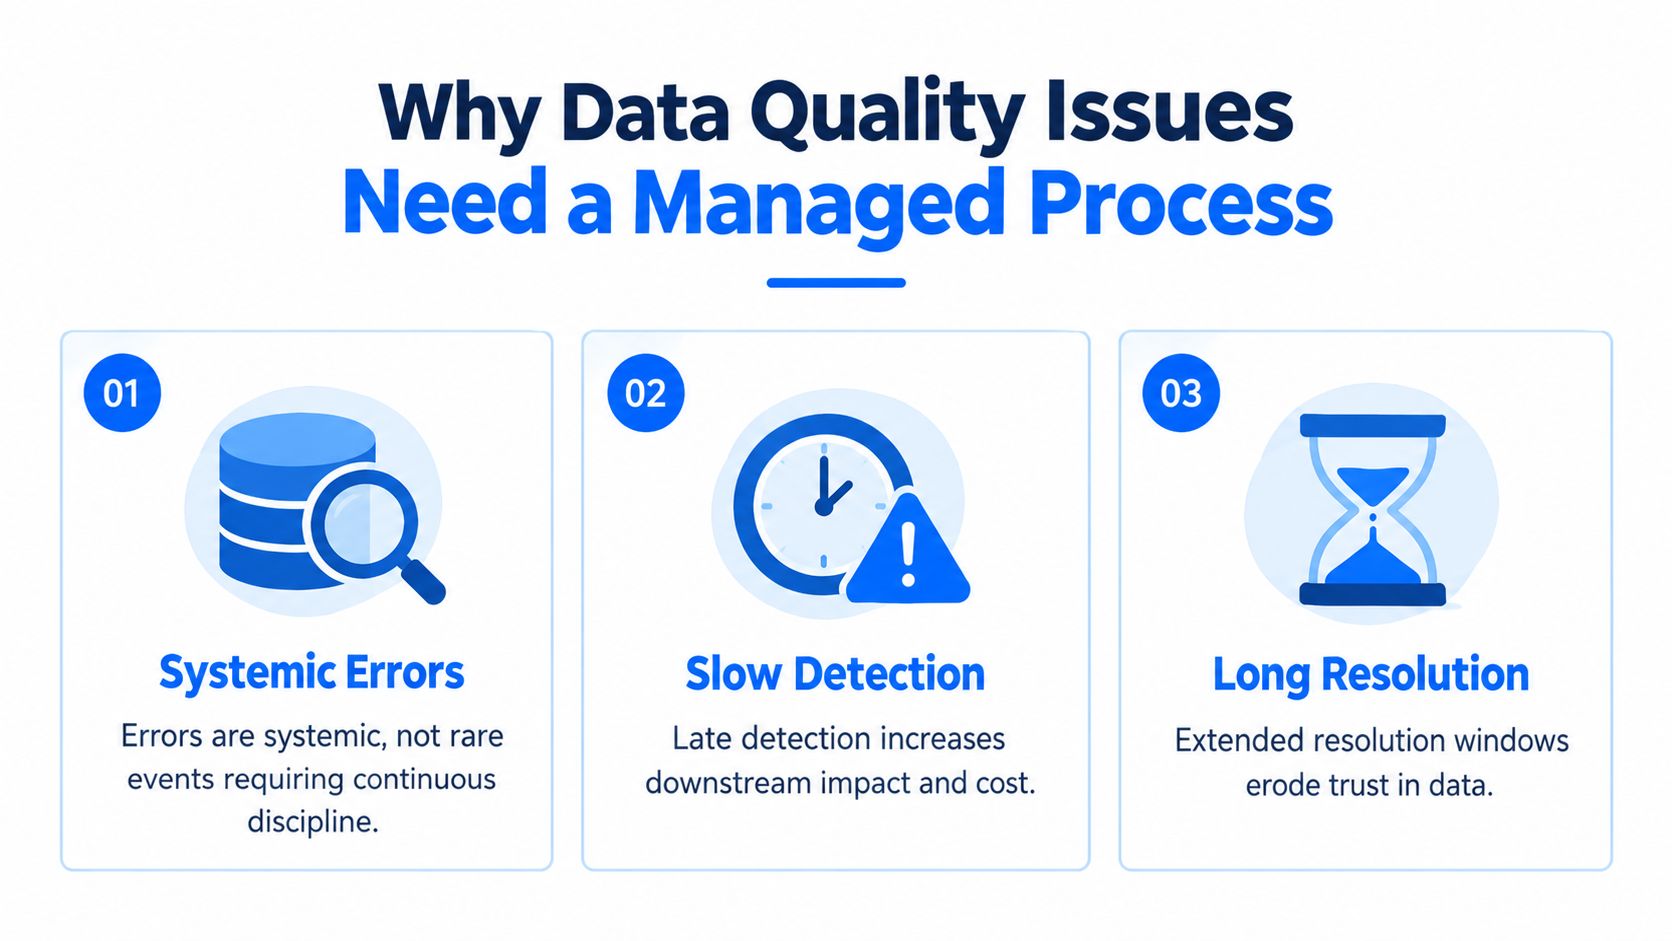
Esa distinción importa. Un proceso gestionado de problemas de calidad de datos no es solo una forma de atrapar antes registros malos. Fija propiedad, severidad, SLA, rutas de escalada y trabajo preventivo para que la misma clase de defecto no vuelva con otro número de ticket.
La investigación sobre el impacto empresarial muestra por qué la gestión improvisada falla a escala. La mala calidad de datos se ha cifrado en un coste anual medio de 12,9 millones de dólares por organización, y una investigación de MIT Sloan ha informado de una reducción de ingresos anual del 15 % al 25 % por mala calidad de datos en algunos contextos, según resumen estas estadísticas de mejora de calidad de datos. El mismo resumen recoge un hallazgo muy citado de Harvard Business Review según el cual solo el 3 % de los datos de empresa cumplía estándares básicos de calidad, y que MIT Sloan y Thomas Redman informaron de que el 47 % de los registros recién creados contenía al menos un error crítico.
Los arreglos improvisados fallan en la frontera de la propiedad
El primer arreglo suele ser la parte fácil. Lo difícil es decidir quién responde de la causa raíz, quién responde de la comunicación hacia abajo, qué tiempo de respuesta debe esperar el negocio y qué cambio evita la repetición.
Sin esas reglas, los equipos optimizan el cierre en vez de la resolución. Una persona parchea un modelo. Otra silencia la alerta. Nadie actualiza el umbral, añade una prueba de contrato ni asigna un responsable permanente del sistema de origen. El problema desaparece de la cola y se queda en el sistema.
Regla práctica: si un defecto puede repetirse, asigna un responsable, define un objetivo de respuesta y decide qué control lo habría cazado antes.
Por eso la gestión de problemas debería tratarse como un modelo operativo. La detección es una parte. El resto es disciplina de proceso: un registro por defecto subyacente, criterios claros de severidad, relojes de SLA, traspasos que no se atascan en Slack y un bucle de prevención que produzca cambios en código, pruebas, metadatos o comportamiento del sistema de origen.
He visto equipos dedicar más tiempo a debatir si un problema es «realmente calidad de datos» que a decidir quién tiene que arreglarlo. Eso suele significar que al proceso le falta una unidad de trabajo común y una expectativa de servicio. El resultado es conocido. Sube la fatiga de alertas, la propiedad se difumina y los usuarios de negocio empiezan a mantener hojas de cálculo paralelas porque confían más en sus comprobaciones manuales que en la plataforma.
Proceso gestionado significa proceso medible
Un equipo no puede mejorar lo que no cuenta de forma coherente. Si cada comprobación fallida se convierte en un incidente aparte, la cola parece peor de lo que es. Si solo se registran los problemas visibles para la dirección, parece más sana que la realidad. Ambas cosas distorsionan la priorización.
La vista útil es operativa. Mide la tasa de problemas contra una unidad definida y luego sigue el rendimiento de SLA por severidad, dominio de origen y clase de problema recurrente. Eso muestra si el problema es la cobertura de detección, la disciplina de triaje, una propiedad débil o defectos repetidos aguas arriba. También da a los responsables de datos mejores argumentos de inversión que decir que la calidad de datos «se siente mal».
Ese argumento suele empezar por una explicación más amplia de por qué la calidad de datos importa a una organización, pero la victoria diaria es más simple. Menos tickets duplicados. Menos tiempo hasta el acuse. Enrutado más rápido al responsable. Más arreglos que eliminan el modo de fallo en vez de limpiar sus síntomas.
Lo que funciona rara vez es vistoso. Umbrales claros. Responsables nombrados. Objetivos de respuesta respaldados por SLA. Reglas de escalada que se disparan antes de que la dirección lo note. Acciones tras el incidente que cambian el sistema.
Qué cuenta como problema de calidad de datos y cómo medirlo
Los equipos empiezan demasiado tarde. Se lanzan al triaje antes de acordar qué es un problema.
Es un error, porque tus métricas se desmoronan en cuanto equipos distintos cuentan cosas distintas. Un grupo trata cada comprobación fallida como un problema. Otro registra solo incidentes visibles para el negocio. Un tercero abre cinco tickets por un defecto aguas arriba porque fallaron cinco modelos posteriores. Esa cola no se gestiona bien porque no estás midiendo la misma unidad de fallo.
Define el problema antes de definir el flujo
Una metodología práctica cuenta un problema de calidad de datos como una de tres cosas: una comprobación de calidad fallida por encima del umbral, un incumplimiento de frescura o SLA, o un incidente confirmado. Debe excluir falsos positivos y fallos de trabajos ajenos a la calidad de datos, según esta metodología de tasa de problemas.
La parte del umbral importa. Una guía nacional de gestión de calidad de datos dice que cada métrica debería tener un umbral de aceptación expresado como porcentaje o número de registros, y plantea la gestión de problemas como un proceso continuo de identificación, seguimiento y resolución en toda la entidad. En la práctica, eso significa que «hay correos nulos» es descriptivo, pero «los correos nulos superaron el umbral aceptado» es operativo.
Elige el denominador que encaje con tu madurez
El denominador es donde los equipos crean un KPI útil o una métrica de escaparate. Si monitorizas muchas comprobaciones, «comprobaciones fallidas sobre comprobaciones ejecutadas» puede servir. Si solo vigilas un conjunto de activos críticos, «problemas por conjunto monitorizado» suele ser más limpio. Si tu entorno es muy orientado a lotes y de alto volumen, la densidad de problemas por registros procesados puede tener más sentido.
Base de medición | Cuándo usarla | KPI de ejemplo |
|---|---|---|
Basada en comprobaciones | Ejecutas muchas comprobaciones automáticas en pipelines y tablas | Tasa de comprobaciones fallidas |
Basada en conjuntos | Monitorizas una lista curada de conjuntos críticos | Problemas por conjunto crítico monitorizado |
Basada en volumen | Procesas grandes volúmenes de registros y quieres seguir la densidad | Problemas por millón de registros procesados |
No se trata de encontrar el denominador universalmente mejor. Se trata de elegir uno que refleje cómo funciona tu plataforma y mantenerlo estable el tiempo suficiente para comparar tendencias.
Limpia las entradas antes de fiarte de los resultados
Antes de calcular KPI de problemas, reúne los datos operativos que prueban qué ocurrió. Eso suele incluir:
Resultados de comprobaciones: fallos de validación, salidas de anomalías, incumplimientos de frescura.
Registros de pipeline: estado de ejecución, reintentos, fallos de dependencias aguas arriba.
Datos de tickets: abierto, acusado, mitigado, resuelto, reabierto.
Metadatos de linaje: qué se rompió aguas arriba y qué consumidores lo heredaron.
Luego el trabajo poco lucido:
Deduplica alertas relacionadas para que cinco fallos posteriores ligados a un defecto de origen sean un problema.
Estandariza las categorías de causa raíz para que «deriva de esquema», «extracto de origen tardío» y «mapeo de referencia erróneo» signifiquen siempre lo mismo.
Separa la creación del problema de su confirmación si tu capa de alertas es ruidosa.
Sigue los resultados de SLA solo cuando la taxonomía de problemas esté estable.
Una métrica que no puedes comparar mes a mes no es una métrica de gestión. Es una foto fija.
A los equipos que afinan dimensiones y umbrales les ayuda alinear las definiciones de problema con las dimensiones de la calidad de datos y colgar de cada una criterios de aceptación claros. Eso da a ingeniería, analítica y negocio el mismo idioma antes de que la cola de incidentes se ponga en marcha.
El flujo de gestión de problemas de calidad de datos, de la detección a la prevención
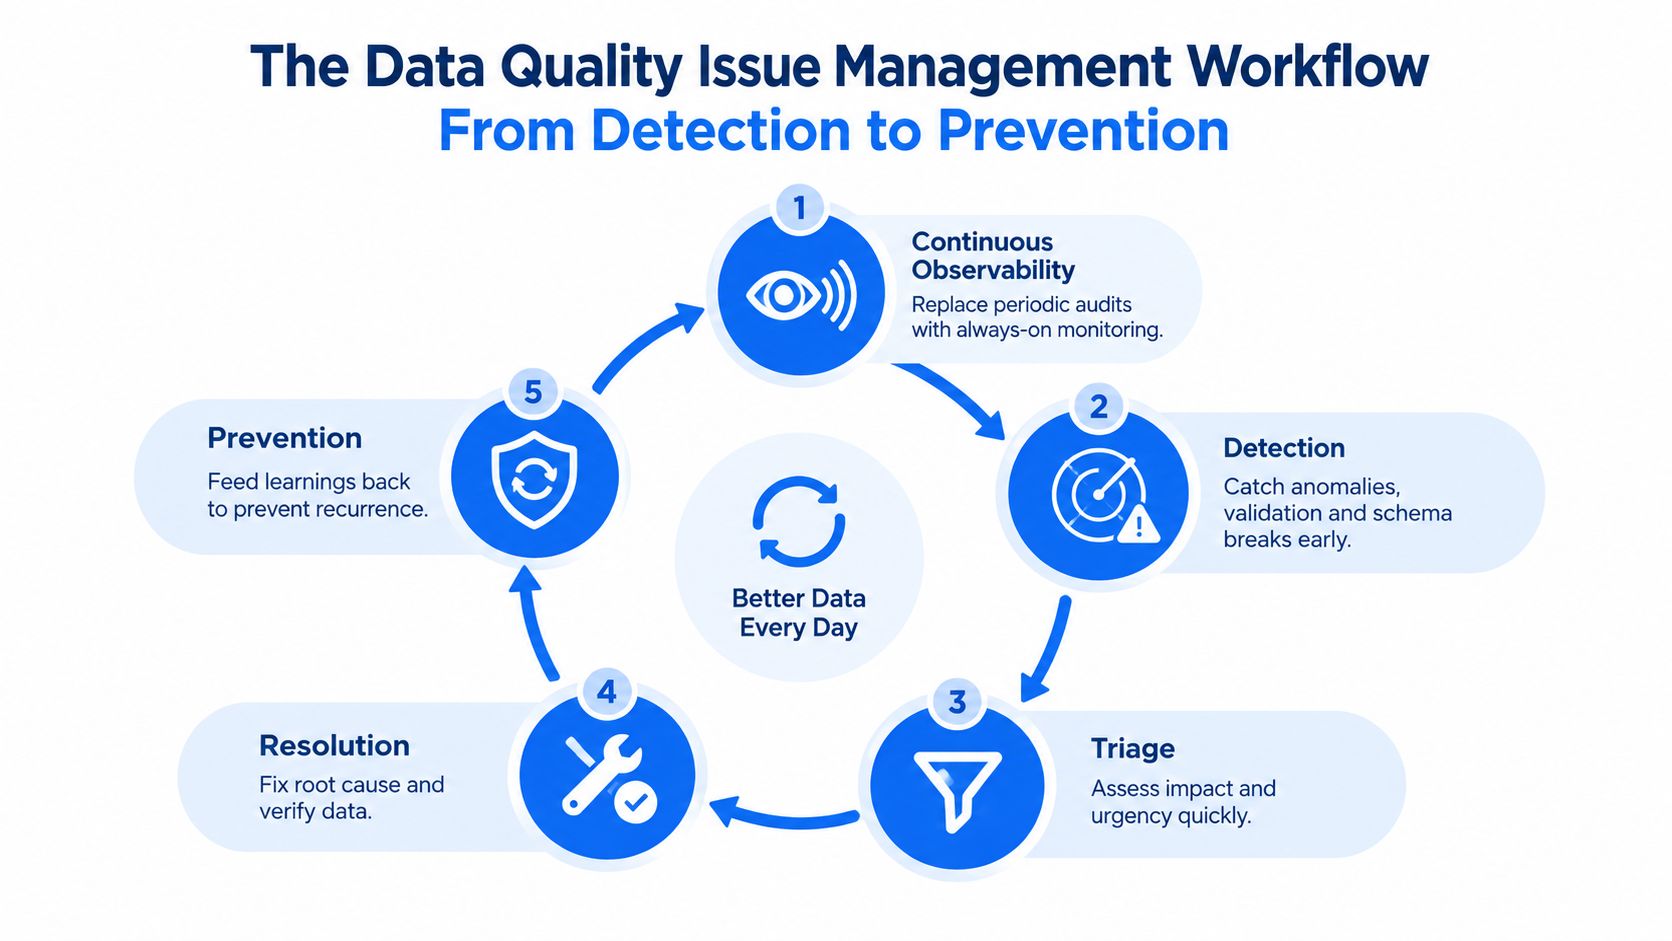
A las 8:15, finanzas abre un panel antes del cierre de mes y faltan los números de ayer. El trabajo de ingesta terminó técnicamente bien. El almacén está arriba. La capa de BI sirve datos rancios porque un extracto aguas arriba llegó tres horas tarde y nadie era responsable de la comprobación de frescura. Así se ve un flujo débil en producción. El fallo no es solo la detección. Es la falta de un modelo operativo que conecte monitorización, propiedad, objetivos de respuesta y prevención.
Empieza por una observabilidad que genere problemas accionables
La gestión de problemas empieza antes de que exista un ticket. Los equipos necesitan señales que digan qué falló, cuándo, qué cambió y quién está expuesto.
Las revisiones periódicas no pueden hacer ese trabajo. Los defectos de producción aparecen entre ciclos de revisión y, cuando alguien lo nota, tablas, paneles o modelos posteriores ya han consumido los datos malos. Un buen monitorización y reporte para operaciones de calidad de datos acorta la distancia entre la aparición del defecto y la respuesta humana.
Las señales útiles suelen caer en cuatro grupos:
Frescura y Timeliness: cargas ausentes, entregas tardías, llegada parcial del lote
Fallos de validación: campos obligatorios, valores aceptados, unicidad, reglas de conciliación
Cambios estructurales: columnas añadidas, columnas eliminadas, cambios de tipo, violaciones de contrato
Desplazamientos de comportamiento: picos de volumen, cambios en la tasa de nulos, deriva de distribución, movimiento inesperado de métricas
La contrapartida es simple. Más comprobaciones atrapan más defectos, pero también crean más ruido. Los equipos que monitorizan todo con la misma sensibilidad suelen entrenar a quien responde para ignorar alertas. El objetivo es crear problemas que merezcan atención, no una cola llena de falsos positivos.
Separa la detección de la validación
Una comprobación fallida es un evento. Un problema es un evento validado con alcance, impacto y responsable.
Esa distinción importa porque los flujos de alerta son ruidosos. Un cambio de esquema en una tabla de pruebas no debería competir con un flujo de ingresos roto. Si el proceso crea un ticket por cada anomalía sin validación, el equipo pasa el día cerrando ruido y se pierde el incidente que afecta a plazos de reporte o a productos de cara al cliente.
GitLab documenta una secuencia práctica en su manual del programa de calidad de datos: Detección → Triaje y validación → Investigación → Resolución → Prevención → Cerrado. El valor de ese flujo es la puerta de decisión. Antes de que un problema entre en la cola principal, alguien confirma que es real, comprueba si hay consumidores afectados y decide si va por la vía de incidentes o al backlog estándar.
Ese paso también mejora la medición. El volumen de detección te dice cuán ruidoso es el sistema. El volumen de problemas confirmados te dice qué tienen que atender quienes operan. Seguir ambos es como los equipos detectan umbrales débiles y tasas infladas.
La investigación debe rastrear el defecto hasta el punto de control
La resolución se frena cuando los equipos persiguen el síntoma visible en vez del origen. Lo veo a menudo con roturas posteriores. Un panel falla, así que empiezan a parchear lógica de BI, aunque la falla real esté en un extracto aguas arriba, un cambio de código del sistema de origen o una dependencia del planificador.
Se repiten unos cuantos patrones:
Datos tardíos: el panel rancio es el síntoma. La causa raíz suele ser un retraso aguas arriba, una tormenta de reintentos o un fallo de dependencia.
Deriva de esquema: el modelo del almacén se rompe después de que un origen cambie un tipo o elimine un campo.
Fallo de regla de negocio: una tabla de mapeo o un feed de referencia acepta un valor nuevo que ninguna regla posterior espera.
La Oficina Australiana de Estadística plantea un proceso por etapas en su manual de gestión y reporte de incidentes de calidad: monitorizar la calidad, identificar el problema, evaluarlo, iniciar la vía de reporte adecuada y después evaluar e implantar la acción correctiva. Esa secuencia aguanta en la práctica porque la evaluación es explícita. Los equipos que se la saltan tienden a sobreescalar anomalías inocuas o a subestimar defectos que se extienden por varios consumidores.
La resolución no se completa hasta restaurar la confianza
Cerrar la falla técnica es solo parte del trabajo. La pregunta es si los consumidores pueden volver a fiarse de los datos.
Un flujo de resolución viable suele incluir cuatro acciones:
Contención. Pausar un consumidor, silenciar un panel roto, revertir una transformación o aislar registros defectuosos.
Corrección. Arreglar el fallo en la capa que introdujo el defecto.
Verificación. Reejecutar comprobaciones, conciliar resultados clave y confirmar que los datos posteriores se han recuperado.
Comunicación. Decir a los afectados qué estaba mal, qué se corrigió y desde qué marca temporal los datos son seguros.
El manual de gestión de incidentes de GitLab es útil aquí porque trata los incidentes de datos como eventos operativos que exigen asignación estructurada, documentación y comunicación. Es mejor patrón que confiar en un hilo largo de Slack que después nadie puede auditar.
La prevención cierra el bucle y demuestra que el proceso funciona
La prevención va dentro del flujo, no después. Si la misma clase de defecto reaparece una y otra vez, el equipo no tiene un problema de detección. Tiene un problema de diseño de controles.
La solución puede ser una regla de validación más estricta en la ingesta, un contrato de datos para un origen volátil, un SLO de frescura con responsable explícito o una actualización de runbook que elimine ambigüedad en el traspaso. La elección correcta depende de por dónde entró el problema y de lo caro que sea cazarlo antes.
Aquí también la gestión de problemas se vuelve modelo operativo. Mide la tasa de repetición por categoría de causa raíz. Mide cuántos problemas cumplen el SLA de acuse, mitigación y resolución. Mide la tasa de reapertura tras el cierre. Esas cifras dicen dónde invertir. Una cola con cierres rápidos pero alta recurrencia suele necesitar controles preventivos más fuertes. Una cola con poca recurrencia pero mal rendimiento de SLA suele tener problemas de propiedad o enrutado.
Cómo triar, priorizar y asignar propiedad bajo SLA
A las 9:07, finanzas informa de que el panel de ingresos de ayer cayó un 18 por ciento. Quien gestiona el panel ve el síntoma, pero el defecto está tres saltos aguas arriba, en un extracto de origen que llegó tarde, y la regla para excluir transacciones de prueba sigue sin documentar. Sin un modelo de triaje, tres equipos empiezan a investigar, nadie es dueño del reloj y el negocio recibe actualizaciones sin tiempo de recuperación.
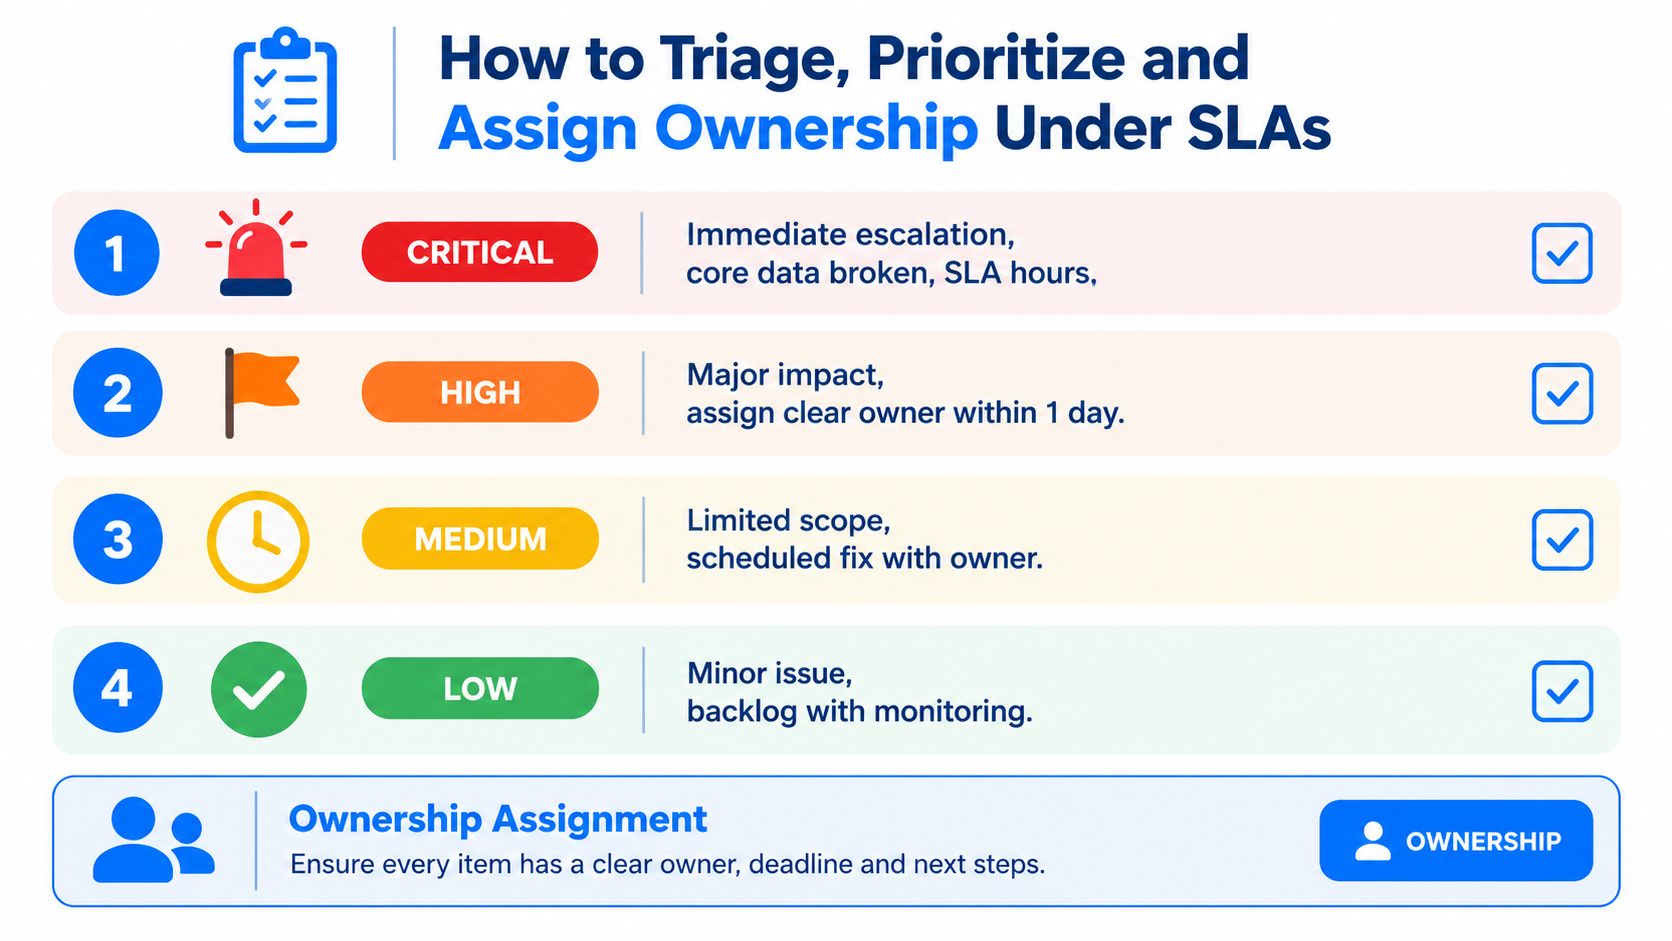
Ese es el trabajo de esta etapa. Fija la severidad rápido, asigna un responsable directo y pon objetivos de respuesta y resolución sobre el problema para que no quede a la deriva en una cola compartida.
Usa la severidad para hacer explícitas las contrapartidas
La severidad debería responder a una pregunta: ¿cuánto riesgo de negocio estamos dispuestos a asumir antes de arreglar esto?
Un modelo práctico usa objetivos separados para acuse, mitigación y resolución final. Los equipos suelen manejar ventanas de respuesta en horas para incidentes de mayor severidad, mitigación en días y resolución completa en un reloj más largo cuando el arreglo duradero exige cambios de código, coordinación con el equipo de origen o recargas. Los objetivos exactos importan menos que la coherencia. Si «alta prioridad» significa el mismo día para un equipo y el próximo sprint para otro, el SLA es ruido.
Fija la severidad a partir de tres factores:
Impacto de negocio: ¿qué decisiones, informes, modelos o flujos de cliente se ven afectados?
Radio de propagación: ¿hasta dónde se ha extendido por tablas y paneles posteriores?
Riesgo de control: ¿toca resultados regulados, reporte a dirección, facturación o métricas visibles fuera?
Mantén el modelo pequeño. Cuatro niveles suelen bastar. Más genera debate sin mejorar el enrutado.
Asigna la propiedad al dominio que arregla
El primer equipo que nota el problema rara vez es el responsable correcto. El correcto es el que puede cambiar el control, la ruta de código o el comportamiento del origen que falla.
Usa un modelo de enrutado como este:
Nivel de severidad | Condición típica | Responsable principal | Ruta de escalada |
|---|---|---|---|
Crítica | Producto de datos central roto o impacto de negocio inmediato | Plataforma de datos o persona responsable de ingeniería de dominio | Canal de incidentes y aviso a dirección |
Alta | Gran impacto posterior pero radio de propagación limitado | Responsable del conjunto con apoyo de ingeniería | Revisión formal de incidente si la mitigación se estanca |
Media | Problema contenido con solución temporal disponible | Ingeniería analítica o steward | Remediación programada con seguimiento |
Baja | Defecto cosmético, de bajo impacto o aislado | Responsable del backlog | Vigilar la tendencia y revisar si se repite |
Esto despeja una brecha común de propiedad. Los equipos de plataforma responden de pipelines y controles. Los equipos de aplicación responden del comportamiento del sistema de origen. Los responsables de negocio responden de la intención de las reglas y de los criterios de aceptación. Los tres pueden implicarse, pero una sola persona debe ser dueña del reloj del SLA, de las actualizaciones de estado y del siguiente paso.
Si la intención de la regla no tiene dueño, los ingenieros se inventarán uno bajo presión.
Prioriza pensando en la capacidad
Las colas de incidentes fracasan cuando cada alerta roja se trata como igual de urgente. La capacidad es limitada. Algunos defectos merecen interrupción inmediata. Otros salen más baratos si se contienen, se documentan y se arreglan en trabajo planificado.
La investigación sobre práctica de calidad de datos ha señalado la responsabilidad fragmentada y la gestión incoherente como causas recurrentes de malos resultados en este estudio sobre problemas sistémicos. La investigación en sanidad también ha identificado planes de acción poco claros, recursos limitados y formación débil como barreras en la discusión de la encuesta publicada. Esos hallazgos coinciden con lo que aparece en las colas de producción. A los equipos no suelen faltarles alertas. Les falta una forma coherente de decidir qué interrumpe el trabajo en curso.
Usa cuatro preguntas de triaje:
¿Qué se rompe si esto espera a mañana o a la semana que viene?
¿Quién consume los datos afectados a continuación y qué decisión tomará con ellos?
¿Podemos contenerlo con una reversión, una cuarentena, una anotación o un filtro temporal?
¿La recurrencia es tan alta que el trabajo preventivo debería ganar a otro arreglo puntual?
Esa última pregunta importa. Un problema de severidad media que se repite cada semana suele merecer más atención que un defecto único muy visible que probablemente no vuelva.
Gestiona la cola contra SLA medibles
Una única vía de entrada ayuda, pero la higiene de la cola es solo parte del modelo operativo. Sigue si el equipo cumple objetivos de acuse, mitigación y resolución por severidad. Sigue la tasa de reapertura. Sigue la tasa de problemas por conjunto, dominio y categoría de causa raíz. Esas métricas muestran si el problema es un mal enrutado, controles débiles o infrainversión crónica en un área de origen.
Usa esos números para ajustar prioridades. Una cola con tiempos de resolución decentes pero mal acuse suele tener problemas de alertado o de cobertura de guardia. Una cola que cumple los SLA de respuesta pero incumple los de resolución final suele tener fricción de propiedad entre equipos. Los equipos que quieran fijar y revisar mejor estos objetivos de servicio deberían definirlos junto a prácticas de medición de la fiabilidad, para revisar tasa de problemas y rendimiento de SLA a la vez y no en paneles separados.
Una cola. Una decisión de severidad. Una persona responsable con el reloj. Eso convierte la gestión de problemas de calidad de datos en un modelo operativo en vez de triaje reactivo.
Incrustar el proceso en herramientas, roles y operación diaria
Un flujo documentado no sobrevive al contacto con producción salvo que esté incrustado en las herramientas que la gente ya usa.
Eso significa que tu proceso de calidad tiene que vivir donde corren los trabajos del almacén, donde los analistas validan resultados y donde la gobernanza puede ver tendencia e historial de incidentes. Si atornillas un silo de calidad aparte con sus propios paneles, taxonomías y lista de usuarios, la propiedad suele fragmentarse en un trimestre.
Construye alrededor de una única vista operativa
El patrón práctico es directo. Ejecuta detección de anomalías, validación, monitorización de Timeliness y seguimiento de esquema contra los mismos conjuntos críticos. Lleva esas señales a un panel compartido. Conecta el panel con el contexto de planificación, los metadatos, el linaje y el ticketing para que quien responde pase de la alerta a la acción sin coser evidencias a mano.
La decisión clave de diseño es el modelo de ejecución. Las comprobaciones dentro de la base de datos reducen el movimiento de datos y facilitan la revisión de seguridad, sobre todo en entornos regulados. Además mantienen la lógica de monitorización más cerca de las tablas y transformaciones que hay que verificar.
Los roles necesitan contexto compartido, no herramientas separadas
Cada rol se fija en señales de fallo distintas:
Los ingenieros de datos quieren estado de pipeline, frescura, reintentos y roturas de esquema.
Los ingenieros analíticos y desarrolladores de BI se fijan en fallos de reglas de negocio, síntomas de deriva de modelo y salidas semánticas rotas.
Los responsables de gobernanza y calidad necesitan umbrales, tendencias, estado de aceptación y evidencia lista para auditoría.
Si cada grupo trabaja desde un sistema distinto, el triaje se ralentiza porque cada problema empieza con una conciliación. Un patrón mejor es visibilidad compartida con vistas por rol. La plataforma puede exponer el mismo incidente mediante registros técnicos para ingeniería y resúmenes de impacto de negocio para responsables no técnicos.
La adopción modular gana a los despliegues de golpe
La mayoría de organizaciones no necesita desplegar todas las capacidades de monitorización el primer día. Suelen necesitar empezar por el modo de fallo que más duele y luego añadir cobertura alrededor.
Ahí importan las decisiones de herramienta. Algunos equipos empiezan por frescura y esquema porque esos defectos son los más fáciles de detectar y enrutar. Otros arrancan con validación determinista porque cumplimiento o finanzas necesitan evidencia explícita de control. En entornos mixtos, una opción modular ayuda. Por ejemplo, los patrones de implementación de calidad de datos suelen funcionar mejor cuando el stack puede crecer de un dominio monitorizado a varios sin forzar un nuevo modelo operativo.
Una opción de esta categoría es digna, que se ejecuta dentro del entorno del cliente y combina detección de anomalías, validación, monitorización de Timeliness, seguimiento de esquema, soporte de planificador, capacidades de catálogo, integraciones y un panel compartido. Ese montaje resulta útil cuando los equipos quieren ejecución dentro de la base de datos y no quieren mover datos de producción fuera de su propia infraestructura.
Lo que se sostiene en operación rara vez es el detector más vistoso. Es el montaje que mantiene el proceso visible, la propiedad adherida y encaja con el entorno que los equipos ya tienen.
Evitar problemas recurrentes y demostrar que el proceso funciona
Una cola que cierra tickets pero sigue reabriendo los mismos patrones de fallo no es madura. Está ocupada.
La prueba de que tu proceso funciona es simple. La detección se acelera. La resolución se vuelve más limpia. Los defectos repetidos bajan. Los interesados dejan de discutir si pueden fiarse de un informe porque el historial de incidentes, el registro de remediación y los umbrales de aceptación están a la vista.
La prevención necesita cambios tras el incidente
Todo incidente relevante debería dejar una mejora duradera. Quizá un umbral nuevo, una regla de validación que faltaba, un contrato de esquema o un traspaso de propiedad más ajustado. Si el cierre solo registra qué se rompió, el sistema no ha aprendido nada.
Las revisiones posteriores más útiles se centran en identificar causas raíz con precisión suficiente para cambiar controles, no solo describir síntomas. Si tu equipo necesita una referencia práctica para esa disciplina, esta colección sobre identificar causas raíz merece quedarse en el runbook.
La pregunta correcta tras la resolución no es «¿quién lo arregló?». Es «¿qué ha cambiado para que no nos encontremos este problema la semana que viene?».
Sigue las métricas que cambian el comportamiento
Las métricas que vale la pena tener delante de los equipos son las que afectan a la calidad de la respuesta:
Tiempo de detección: cuánto existió el defecto antes de que el equipo lo supiera.
Tiempo de resolución: cuánto tiempo estuvo expuesto el negocio.
Cumplimiento de SLA: si respuesta, mitigación y cierre alcanzaron el objetivo.
Tasa de problemas repetidos: si la misma categoría de causa raíz sigue volviendo.
Exposición de negocio: qué informes, procesos o decisiones críticas se vieron afectados.
No necesitas un cuadro de mando enorme. Necesitas uno estable. Si los equipos ven que un dominio incumple una y otra vez los objetivos de frescura o que una clase de cambios de esquema se reabre a menudo, el trabajo preventivo se justifica solo.
Una comprobación rápida de madurez
Usa esto como autotest sin rodeos:
Existe definición de problema: los equipos coinciden en qué cuenta como problema y qué no.
Los umbrales están documentados: las métricas se vuelven accionables solo cuando rebasan límites aceptados.
La severidad está estandarizada: la prioridad no depende de quién esté de guardia.
La propiedad es explícita: cada problema tiene responsable y ruta de escalada.
El cierre incluye prevención: los arreglos actualizan reglas, líneas base, contratos o runbooks.
Se conserva la evidencia: puedes mostrar qué pasó, quién respondió, qué cambió y si se cumplieron los SLA.
Si incluso dos de esos puntos flojean, el proceso sigue siendo frágil. Es normal. Los equipos no necesitan una filosofía nueva. Necesitan menos traspasos ambiguos y mejor disciplina operativa alrededor de los defectos que ya conocen.
Si tu equipo intenta convertir comprobaciones dispersas en un modelo operativo de verdad, digna está pensada para ese tipo de trabajo. Ayuda a los equipos a monitorizar anomalías, Timeliness, validación y cambios de esquema dentro de su propio entorno para que detección, propiedad y prevención funcionen como un proceso en vez de cuatro herramientas desconectadas.
Un proceso solo es tan medible como los números que lo sostienen: acompaña este flujo con un conjunto operativo de métricas de calidad de datos para que cerrar signifique algo.
Preguntas frecuentes
¿Por qué fallan los arreglos improvisados?
Fallan en la frontera de la propiedad. Alguien parchea un modelo SQL, relanza una pipeline y lo da por arreglado, pero nadie responde de si se restauró la confianza ni de si el mismo defecto vuelve. Un proceso gestionado se puede medir; uno improvisado no.
¿Qué cuenta como problema de calidad de datos?
Define el problema antes del flujo. No toda comprobación fallida es un problema, y no todo problema empieza como comprobación fallida: un movimiento inexplicado de un KPI también cuenta. Elige un denominador acorde a tu madurez y limpia las entradas antes de fiarte de cualquier tasa que calcules con ellas.
¿Cómo es el flujo de principio a fin?
Detección, validación, investigación, resolución y prevención. Detección y validación se mantienen separadas a propósito, porque una alerta todavía no es un incidente. La investigación rastrea el defecto hasta su punto de control, y la resolución no está completa hasta restaurar la confianza, no solo hasta que cambian los datos.
¿Cómo deberían triarse y asignarse los problemas?
Usa la severidad para hacer explícitas las contrapartidas en vez de tratar todo como urgente. Asigna la propiedad al dominio que arregla, el equipo que puede cambiar de verdad el control, no a quien lo notó. Después prioriza pensando en la capacidad y gestiona la cola contra SLA medibles.
¿Cómo se evita que los mismos problemas se repitan?
La prevención exige cambios en los controles tras el incidente, no solo un ticket cerrado. Sigue métricas que cambien el comportamiento, como la tasa de recurrencia y el tiempo hasta restaurar la confianza, en vez de recuentos brutos, que bajan en cuanto la gente deja de reportar.