Monitorización de la integridad de los datos: guía práctica para 2026
|
7
minuto de lectura

Sus dashboards rara vez fallan con un colapso espectacular. Lo más habitual es que alguien de finanzas abra el lunes una vista de ingresos, vea las cifras de ayer y dé por hecho que el negocio va bien. Por debajo, una tabla de origen dejó de actualizarse, un proceso del fin de semana no completó una carga y un modelo de IA ya entrenado con los datos de la semana anterior está tomando decisiones con total seguridad a partir de entradas desactualizadas.
Por eso la monitorización de la integridad de los datos importa ahora. No es una tarea de limpieza en segundo plano ni equivale a realizar pruebas ocasionales. Es una capa de control continua que vigila las rupturas en actualidad, volumen, distribución, esquema y linaje, de modo que los equipos detecten los fallos silenciosos antes que las partes interesadas. Una revisión académica presenta esos cinco pilares como el marco central para entender si los datos llegan a tiempo, conservan las propiedades estadísticas esperadas, siguen completos, mantienen su estructura y conservan una procedencia trazable, que es exactamente el tipo de visibilidad que necesitan los pipelines modernos revisión académica.
Un modelo mental útil es tratar la monitorización de la integridad como la red de seguridad entre pruebas. Las pruebas le indican si una regla conocida sigue cumpliéndose. La monitorización le indica si el sistema ha derivado hacia un estado que más adelante romperá informes, modelos o automatizaciones posteriores. Si ya piensa en la detección de anomalías, una lectura complementaria práctica es la guía de ELECTE para descubrir patrones ocultos en los datos, porque los mismos instintos se aplican cuando el patrón que le interesa es el deterioro silencioso del pipeline.
Si está trasladando esto a su propio stack, la capa de dashboards también importa. Una vista compartida de incidentes, tendencias y estado resulta mucho más útil cuando está respaldada por comprobaciones continuas y no solo por auditorías puntuales. Una implementación de referencia para ese tipo de visibilidad son los dashboards de calidad de datos de digna, que reflejan la misma idea operativa desde otro ángulo.
Índice
El momento en que un dashboard se rompe sin que nadie lo note
Las cinco perspectivas de la monitorización de la integridad de los datos
Por qué la monitorización de la integridad es ahora una capa estratégica
Comparación de enfoques de monitorización que realmente funcionan
El momento en que un dashboard se rompe sin que nadie lo note
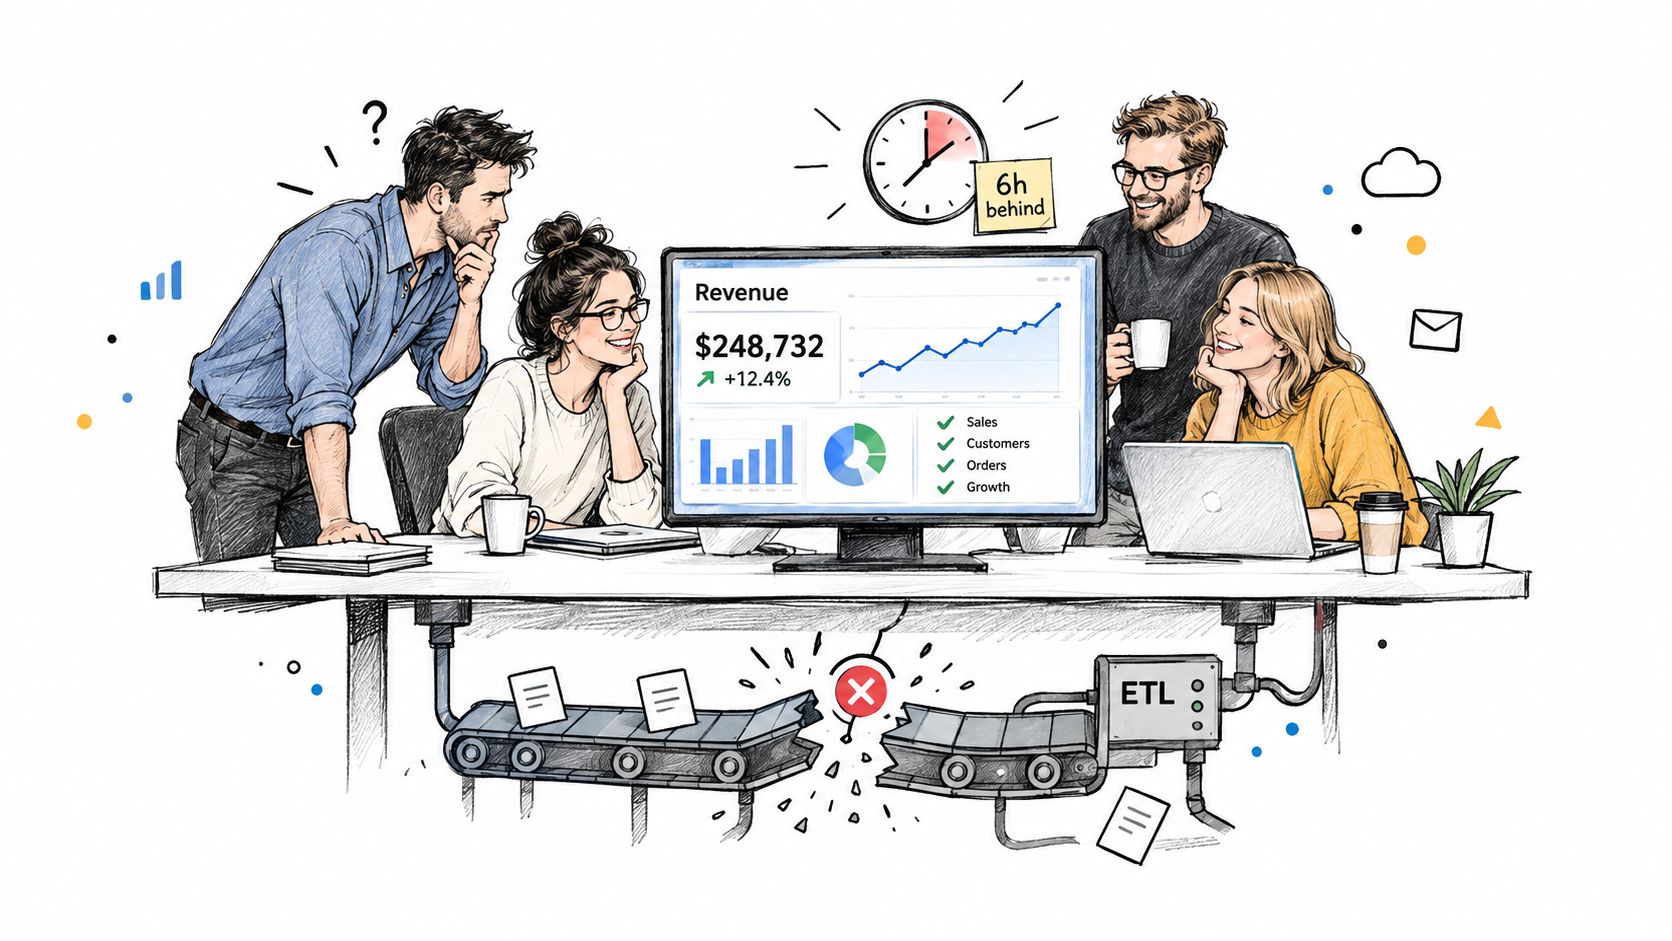
El lunes empieza con un mensaje que no le gusta a nadie. La carga del data warehouse que debería haberse completado durante la noche no terminó correctamente, la tabla de origen lleva seis horas desactualizada y el dashboard ejecutivo sigue mostrando los ingresos de ayer sin ningún aviso de error. El equipo de producto tampoco lo detecta, porque el modelo de recomendación que lanzó la semana pasada sigue funcionando con la cohorte antigua.
Ese es el modo de fallo para el que está pensada la monitorización de la integridad de los datos. Se trata de vigilar los propios datos, de forma continua, para que las cargas desactualizadas, los registros que faltan, los cambios de esquema y las cadenas de dependencias rotas salgan a la luz cuando todavía hay tiempo para actuar.
Un fallo ruidoso es fácil de detectar. El pipeline se rompe, salta una alerta y alguien recibe el aviso. Un fallo silencioso es más difícil, porque las cifras siguen pareciendo creíbles mientras los datos subyacentes se han desviado lo suficiente como para distorsionar una decisión.
Regla práctica: si una comprobación solo se activa después de que una parte interesada se queje, ya es demasiado tarde para llamarlo monitorización.
Por eso esta capa también es distinta de las pruebas puntuales. Las pruebas suelen realizarse en torno a los despliegues o a puntos de validación. La monitorización de la integridad de los datos se sitúa en mitad del ciclo de vida y vigila el estado en vivo del pipeline a medida que cambia, como una sala de control que sigue revisando los indicadores mientras la máquina ya está en marcha.
La distinción importa a los equipos que gestionan tanto analítica como ML. Un modelo puede seguir generando predicciones aunque la tabla de entrada esté desactualizada, el esquema haya cambiado o una fuente haya dejado de enviar filas. Nada se bloquea, pero la lógica de negocio se degrada igualmente. Por eso la capa de monitorización tiene que comprobar tanto si el proceso se ejecutó como si los datos siguen siendo fiables.
Las configuraciones más sólidas también correlacionan varias señales a la vez. La actualidad por sí sola puede pasar por alto duplicados. El volumen por sí solo puede pasar por alto un cambio de esquema que elimina una columna sin alterar el número de filas. Las comprobaciones de esquema por sí solas pueden pasar por alto un archivo tardío que llega intacto, pero demasiado tarde para servir a los informes. Una implementación de referencia para ese tipo de visibilidad son los dashboards de calidad de datos de digna, que muestran cómo las vistas de incidentes pueden convivir con las comprobaciones continuas. Para ver con más detalle cómo encajan la observabilidad y las vistas de incidentes, un dashboard de incidentes compartido resulta útil porque refleja el tipo de visibilidad operativa que necesitan los equipos cuando van más allá de las comprobaciones manuales puntuales.
Las cinco perspectivas de la monitorización de la integridad de los datos
Piense en el servicio de triaje de un hospital. Un médico no diagnostica a un paciente a partir de una sola señal. Toma el pulso, hace preguntas, revisa los análisis de sangre, examina las pruebas de imagen y compara el estado actual con el historial y los antecedentes familiares. Los pipelines de datos merecen la misma disciplina.

Actualidad, volumen, distribución, esquema y linaje
La actualidad responde a si los datos llegaron a tiempo. Si su fuente de ventas suele cargarse antes de las 6 de la mañana y a las 8 aún no ha llegado, no es un problema teórico: son informes desactualizados. Lo mismo ocurre con los procesos batch tardíos, las cargas incrementales fallidas y las fuentes de socios retrasadas. Una guía de data observability agrupa la actualidad con la disponibilidad, el volumen y los cambios de esquema como comprobaciones básicas para la monitorización de conjuntos de datos guía de dasca.
El volumen analiza el número de filas, el tamaño de los archivos y otras señales basadas en recuentos. Una caída repentina puede indicar que ha fallado un extractor anterior. Un pico repentino puede indicar duplicados o un reprocesamiento accidental. La cifra por sí sola no explica la causa, pero le indica que algo ha cambiado.
La distribución abarca rangos, tasas de nulos, cardinalidad y patrones de valores. Aquí aparecen los picos repentinos de nulos, los equilibrios entre categorías rotos y los valores fuera de lo habitual. Es la diferencia entre “la tabla se cargó” y “los datos siguen pareciendo el mismo tipo de datos”.
El esquema detecta columnas añadidas, eliminadas, renombradas o con cambios de tipo. Esos cambios suelen ser el motivo por el que el SQL posterior se rompe o los modelos de dbt empiezan a devolver resultados incompletos. Un cambio estructural es fácil de pasar por alto si solo se comprueba que el proceso terminó con éxito.
El linaje traza de dónde proceden los datos y qué depende de ellos. Esto importa cuando hay que saber si un defecto se originó en una extracción de origen, en una transformación o en un consumidor posterior. También es lo que ayuda a los equipos a entender por qué un solo campo roto puede afectar a varios dashboards a la vez.
Las señales aisladas pueden apuntar a un síntoma. Las señales correlacionadas apuntan a la causa.
Esa es la lección fundamental. Una monitorización madura no se limita a reaccionar ante una única anomalía. Correlaciona varias perspectivas para que los equipos puedan distinguir entre una tabla desactualizada, una oscilación por estacionalidad del negocio y una rotura real del pipeline. Si quiere un ejemplo práctico de cómo encajan esas señales en una vista de monitorización, la página de data observability de digna se corresponde estrechamente con este modelo de cinco perspectivas.
Por qué la monitorización de la integridad es ahora una capa estratégica
Hace unos años, muchos equipos trataban la calidad de los datos como un trabajo de limpieza. Corregir las filas erróneas, parchear el dashboard y seguir adelante. Esa mentalidad deja de funcionar cuando la analítica y la IA empiezan a impulsar decisiones a escala.
El cambio en el sector se refleja en los datos de adopción. Una encuesta de 2026 reveló que solo entre el 35 y el 36 por ciento de las organizaciones monitoriza u optimiza activamente sus programas de integridad de datos, mientras que aproximadamente entre el 15 y el 16 por ciento aún se encuentra en fases previas a la planificación encuesta. Eso significa que la práctica ya forma parte de las operaciones habituales, pero aún dista mucho de ser universal.
Por qué la IA eleva lo que está en juego
Los sistemas de IA no solo consumen datos, los amplifican. Si la entrada está desactualizada, incompleta o ha cambiado de estructura, el modelo puede seguir produciendo un resultado de apariencia impecable. Ese resultado puede ser erróneo, pero a menudo parecerá seguro, y eso es precisamente lo que hace peligroso el problema.
Por eso la monitorización de la integridad ya no es solo una cuestión de higiene técnica. Actúa como plano de control para la preparación para la IA, porque los equipos necesitan pruebas de que los datos que alimentan la analítica y los modelos están al día, completos y son trazables. También contribuye a la gobernanza y la auditabilidad, porque el linaje y los cambios estructurales se vuelven visibles en lugar de quedar ocultos en registros improvisados.
A quién le importa y por qué
Motivo | Parte interesada | Qué se rompe sin monitorización |
|---|---|---|
Preparación para la IA | Equipos de datos y de ML | Los modelos se entrenan o puntúan con datos desactualizados, incompletos o con cambios estructurales |
Gobernanza | Equipos de riesgos y cumplimiento | Los equipos no pueden demostrar qué cambió, cuándo cambió ni a qué afectó |
Fiabilidad operativa | Equipos de plataforma y de analítica | Los dashboards, las transformaciones y los consumidores posteriores se desvían antes de que nadie lo note |
La conclusión estratégica es sencilla. Si falta la monitorización de la integridad de los datos, el coste no es solo un dashboard erróneo. Es una cadena de malas decisiones que la automatización acelera. Para los equipos que evalúan controles operativos, el planteamiento de la monitorización de la calidad de datos de digna resulta útil porque trata la integridad como un control permanente y no como una limpieza puntual.
Comparación de enfoques de monitorización que realmente funcionan
No todos los enfoques de monitorización sirven en todas partes. El diseño adecuado depende de dónde residen los datos, de la rapidez con que cambian y de cuánto ruido puede asumir su equipo. Los mejores programas suelen combinar métodos en lugar de apostarlo todo a uno.
Dónde destaca y dónde flaquea cada enfoque
La ejecución dentro de la base de datos mantiene las comprobaciones cerca de los datos. Eso reduce el movimiento de datos, algo importante en entornos seguros o de gran volumen, y encaja con los equipos que quieren que la lógica de validación se ejecute donde ya se encuentra el data warehouse o el data lake. Sin embargo, la contrapartida es evidente. Se heredan las limitaciones de la plataforma en la que se ejecuta, por lo que la portabilidad puede ser más limitada que con herramientas externas.
Los escáneres externos son más flexibles entre sistemas. Pueden inspeccionar archivos, API, data warehouses y aplicaciones posteriores desde fuera de los límites de la base de datos. Esa flexibilidad conlleva una sobrecarga, sobre todo cuando los entornos crecen o cuando se intenta mantener una latencia baja.
Los umbrales basados en reglas son fáciles de entender. Detectan roturas evidentes, como una tabla que nunca debería bajar de un recuento mínimo o una fuente que debería llegar a una hora fija. Tienen dificultades cuando el negocio es estacional, porque un límite estático puede marcar como problema un cambio normal.
Las líneas base aprendidas por IA se adaptan mejor a ese tipo de variación. Son útiles cuando un conjunto de datos tiene ciclos semanales, una deriva gradual o un historial irregular. Sin embargo, necesitan un periodo de aprendizaje, y el equipo debe aceptar que al principio la confianza será menor que con una regla fija.
Utilice reglas estáticas para las invariantes conocidas, líneas base aprendidas para el comportamiento cambiante y la correlación de múltiples señales cuando un único síntoma no basta.
Este último punto es el más importante. Una sola alerta de actualidad puede ser ruido. Actualidad más volumen más deriva de esquema cuentan una historia más creíble. Un equipo que quiera mantener las comprobaciones cerca del data warehouse sin renunciar a una cobertura amplia puede fijarse en el verificador de integridad de datos de digna como ejemplo de cómo combinar esas piezas sin tratar todas las señales por igual.
Enfoque | Fortaleza | Limitación | Uso más adecuado |
|---|---|---|---|
Ejecución dentro de la base de datos | Poco movimiento de datos, muy adecuada para entornos gobernados | Menos portable entre plataformas | Comprobaciones de data warehouse de gran volumen |
Escáneres externos | Amplia cobertura entre sistemas | Mayor sobrecarga a escala | Entornos con varios sistemas y varias herramientas |
Umbrales basados en reglas | Claros y fáciles de explicar | Frágiles ante oscilaciones estacionales | Reglas de negocio fijas y límites estrictos |
Líneas base aprendidas por IA | Se adaptan a la variación normal | Requieren un periodo de aprendizaje y ajuste | Conjuntos de datos volátiles o cambiantes |
Correlación de múltiples señales | Reduce el ruido falso y mejora el diagnóstico | Más trabajo de diseño al principio | Programas de monitorización maduros |
Patrones de implementación y buenas prácticas
La mayoría de los programas de monitorización fracasan porque intentan abarcar demasiado demasiado pronto. Un despliegue mejor empieza por aprender la forma normal del pipeline y solo después añade alertas por capas, una vez que el equipo entiende cómo es realmente lo “normal”.
La referencia que conviene tener presente es la escala. Un conjunto de datos de monitorización citado encontró una media de 42 métricas distintas por pipeline, entre ellas actualidad, variación de volumen, deriva de esquema y latencia de procesamiento querysurge. Eso no significa que todos los equipos deban generar alertas sobre las 42 a la vez. Significa que los programas maduros vigilan múltiples señales y las utilizan de forma conjunta.

Un despliegue que no desborde al equipo
Aprenda primero la línea base. Ejecute las comprobaciones en modo de observación antes de avisar a nadie. Los equipos necesitan conocer el ritmo diario habitual antes de poder saber si un cambio es real.
Priorice según el impacto en el negocio. Empiece por la actualidad, el volumen, el esquema y las comprobaciones de distribución que protegen los conjuntos de datos más visibles. No disperse al equipo por todas las tablas solo porque las herramientas lo pongan fácil.
Utilice umbrales dinámicos. Establezca límites por activo, no un único corte global. Una fuente de ventas, una fuente clínica y una fuente de uso de telecomunicaciones no comparten el mismo patrón normal.
Ajuste a partir de la experiencia. Cada incidente resuelto debería mejorar la siguiente alerta. Si una notificación generó ruido, ajústela. Si detectó a tiempo una rotura real, conserve el patrón y quizá amplíelo.
La responsabilidad importa tanto como la lógica de las alertas. Cada activo monitorizado debería tener un responsable designado, porque las alertas sin responsable se convierten en tickets abandonados. Una revisión trimestral de la cobertura también ayuda, ya que los pipelines cambian más rápido que los mapas de monitorización estáticos.
La versión operativa de este planteamiento se aprecia con claridad en la implementación de calidad de datos de digna, donde la disciplina en el despliegue importa tanto como las propias comprobaciones.
Errores comunes que minan la confianza en la monitorización
La monitorización pierde credibilidad rápidamente cuando se comporta como un sistema de alarmas ruidoso. Los equipos no dejan de confiar en ella porque la idea sea errónea, sino porque la implementación resulta molesta, frágil o ciega ante los modos de fallo reales.
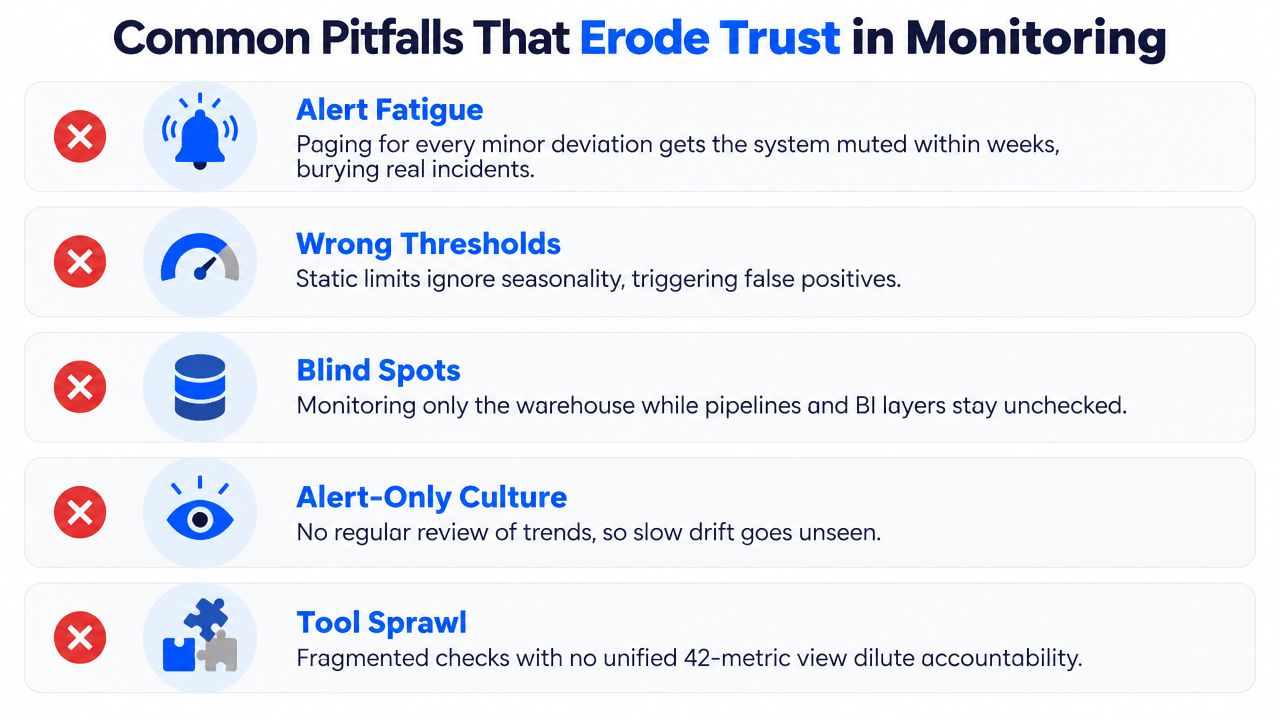
Los fallos que aparecen en programas reales
La fatiga de alertas es la forma más rápida de perder la atención del equipo. Si el sistema avisa por cada desviación menor, la gente lo silencia y entonces la interrupción real pasa desapercibida.
Los umbrales incorrectos generan otro tipo de desconfianza. Los límites estáticos ignoran la estacionalidad, las promociones, los picos de fin de mes y otros ritmos del negocio, por lo que cambios perfectamente normales parecen incidentes.
Los puntos ciegos aparecen cuando los equipos solo vigilan el data warehouse e ignoran las etapas del pipeline y la capa de BI que lo consumen. El resultado es una falsa sensación de cobertura.
La cultura de solo alertas es otro fallo silencioso. Si nadie revisa las tendencias, el sistema pasa por alto la deriva lenta que nunca cruza el umbral estricto hasta que ya resulta visible para los usuarios.
La proliferación de herramientas difumina la responsabilidad. Las comprobaciones fragmentadas y repartidas entre varios sistemas rara vez conforman una imagen operativa única, y por eso importa disponer de una vista unificada.
La confianza surge de menos alertas y mejores, no de más ruido.
Las contramedidas son sencillas, pero no opcionales. Utilice niveles de gravedad, vincule los umbrales al comportamiento de referencia, añada suscripciones a cambios de esquema y mantenga una cadencia de revisión en el calendario. Sobre todo, trate la monitorización como un control vivo y no como un proyecto que se da por terminado tras el lanzamiento.
Lo que está en juego en cada sector con datos regulados
La misma lógica de monitorización se aplica de forma distinta según el sector. Un equipo de finanzas, un grupo de analítica hospitalaria, un operador de telecomunicaciones y una administración pública se preocupan por la integridad, pero no temen los mismos puntos de rotura.
Cuatro ejemplos, cuatro patrones de fallo distintos
En los servicios financieros, el fallo más peligroso suele ser una fuente de riesgo desactualizada o desviada. Un modelo puede seguir puntuando transacciones mientras la señal de fraude subyacente es antigua, lo que puede distorsionar tanto las decisiones como las pistas de auditoría.
En el sector sanitario, el punto crítico es el cambio estructural. Una columna de diagnóstico renombrada puede desplazar silenciosamente casos de alta gravedad a la categoría equivocada, lo que significa que el problema aparece en los informes clínicos mucho antes de que nadie note el problema de esquema.
En las telecomunicaciones, el problema suele ser la escala y la volatilidad. Un dashboard de abandono de clientes puede pasar por alto una caída regional si las tablas de ingresos o de uso siguen cargándose con normalidad mientras otra fuente se retrasa.
En el sector público, las roturas de dependencias suelen aparecer en los flujos de trabajo de elegibilidad o de prestaciones. Un cambio de esquema de un proveedor puede impedir que un join relacione correctamente los registros, lo que genera problemas en los servicios posteriores que son difíciles de desenredar a posteriori.
Sector | Principal riesgo para la integridad | Señal más valiosa | Implicaciones regulatorias |
|---|---|---|---|
Servicios financieros | Entradas de riesgo desactualizadas o desviadas | Actualidad y linaje | Auditabilidad y controles de reporting |
Sector sanitario | Cambio estructural silencioso | Esquema y distribución | Fiabilidad clínica y trazabilidad |
Telecomunicaciones | Deriva de pipelines de gran volumen | Volumen y actualidad | Continuidad operativa y precisión del servicio |
Sector público | Joins rotos tras cambios de proveedor | Esquema y linaje | Elegibilidad para servicios, rendición de cuentas e integridad de los registros |
El error es suponer que una única configuración sirve para todo. El marco es el mismo, pero cambia la ponderación. Un entorno regulado necesita que las señales estén ajustadas al fallo que menos puede permitirse pasar por alto, no una lista de verificación genérica copiada del stack de otro equipo.
Cómo integrarlo todo con digna
El fallo del dashboard del principio, el marco de las cinco perspectivas, la referencia de las 42 métricas y los ejemplos por sector apuntan a la misma conclusión. La monitorización de la integridad de los datos funciona cuando se convierte en una capa de control continua y no en una tarea de inspección ocasional.

Un punto de referencia práctico
digna es una forma de implementar ese modelo dentro del propio entorno del cliente, con comprobaciones que se ejecutan dentro de la base de datos y cubren actualidad, volumen, distribución, esquema y linaje en una configuración modular. También se ajusta al patrón de despliegue descrito anteriormente, en el que primero se establecen las líneas base y las alertas solo se endurecen cuando el sistema entiende el comportamiento normal.
Aquí importan especialmente algunos puntos:
Las cinco perspectivas aplicadas. El mismo conjunto de herramientas puede vigilar a la vez la puntualidad, los cambios estructurales, el contexto de dependencias y las desviaciones respecto a la línea base.
Pensar en 42 métricas. Una monitorización madura no es una comprobación por tabla, sino un conjunto de señales dimensionado según el conjunto de datos y el riesgo.
Despliegue por fases. La observación precede a los avisos, lo que mantiene el programa útil en lugar de ruidoso.
Preservar la confianza. Los umbrales ajustados ayudan a garantizar que el equipo solo reciba avisos cuando algo requiere realmente una acción.
El siguiente paso práctico es sencillo. Elija un pipeline crítico, configure las cinco perspectivas, aprenda la línea base y deje que las anomalías salgan a la luz antes de que las detecten los usuarios. Si quiere una referencia concreta para ese tipo de configuración, visite digna y evalúe cómo encaja su enfoque de monitorización con ese pipeline en el que no puede permitirse errores.
Para las líneas base aprendidas por IA descritas anteriormente, que se adaptan a los ciclos semanales y a la deriva gradual en lugar de depender de umbrales estáticos, descubra cómo digna Data Anomalies aprende el comportamiento normal de cada conjunto de datos.
Preguntas frecuentes
¿Qué es la monitorización de la integridad de los datos?
La monitorización de la integridad de los datos es una capa de control continua que vigila los datos en vivo para detectar rupturas en actualidad, volumen, distribución, esquema y linaje. A diferencia de las pruebas puntuales ejecutadas en el despliegue, se sitúa en mitad del ciclo de vida del pipeline para que las cargas desactualizadas, los registros que faltan y los cambios de esquema salgan a la luz antes de que los noten las partes interesadas.
¿Cuáles son los cinco pilares de la monitorización de la integridad de los datos?
Las cinco perspectivas son actualidad, volumen, distribución, esquema y linaje. La actualidad indica si los datos llegaron a tiempo, el volumen controla el número de filas y el tamaño de los archivos, la distribución abarca las tasas de nulos y los patrones de valores, el esquema detecta columnas añadidas o renombradas y el linaje muestra dónde se originó un defecto y qué depende de él.
¿En qué se diferencia la monitorización de la integridad de los datos de las pruebas de datos?
Las pruebas comprueban si una regla conocida sigue cumpliéndose, normalmente en torno a los despliegues o a puntos de validación. La monitorización vigila el estado en vivo del pipeline y detecta la deriva que más adelante romperá informes o modelos. La regla práctica del artículo: si una comprobación solo se activa después de que una parte interesada se queje, no es monitorización.
¿Cuántas métricas conviene monitorizar por pipeline de datos?
Un conjunto de datos de monitorización citado encontró una media de 42 métricas distintas por pipeline, que abarcan actualidad, variación de volumen, deriva de esquema y latencia de procesamiento. Eso no significa generar alertas sobre las 42 a la vez; los programas maduros vigilan muchas señales y las correlacionan, empezando por los conjuntos de datos con mayor impacto en el negocio.
¿Cómo se despliega la monitorización de la integridad de los datos sin provocar fatiga de alertas?
Empiece en modo de observación para aprender la línea base antes de avisar a nadie y, después, priorice los conjuntos de datos más visibles. Establezca umbrales dinámicos por activo en lugar de un único corte global, ajuste cada alerta ruidosa tras un incidente, asigne a cada activo monitorizado un responsable designado y revise la cobertura cada trimestre.


