Procesamiento dentro de la base de datos
|
7
minuto de lectura

El procesamiento dentro de la base de datos ejecuta la analítica y la monitorización directamente en el motor de base de datos del cliente, de modo que los datos permanecen en su sitio y desaparece la sobrecarga de transferencia. Esto importa sobre todo cuando su data warehouse es grande, sensible o ambas cosas, porque la elección no se reduce a la velocidad, sino a si la comprobación se realiza donde ya residen los datos.
El lunes por la mañana suele ser cuando primero se pone de manifiesto la debilidad. Un dashboard deja de actualizarse, un informe financiero pierde filas o una alerta de actualidad salta cuando los usuarios de negocio ya han detectado el problema, y la causa raíz suele ser la misma: los datos tuvieron que salir de un sistema antes de poder analizarse en otro.
Índice
Cómo ha evolucionado y cómo funciona el procesamiento dentro de la base de datos
Ejecución dentro de la base de datos frente a flujos de extracción y análisis
Cómo ejecuta digna la observabilidad dentro de su data warehouse
Cuándo el procesamiento dentro de la base de datos no es la opción adecuada
Casos de uso sectoriales que exigen fiabilidad dentro de la base de datos
Cómo decidir si el procesamiento dentro de la base de datos encaja en su stack
Cuando el movimiento de datos rompe sus dashboards
El fallo suele empezar sin previo aviso. Una fuente del data warehouse llega a tiempo, el proceso de extracción se ejecuta y el motor externo recibe lo que parece una copia limpia. Después, un retraso en origen, una columna mal formada o un lote demasiado grande hacen que las cifras se desvíen lo justo para que el dashboard deje de coincidir con lo que espera el negocio.
Ese es el principal atractivo del procesamiento dentro de la base de datos. El motor de base de datos hace el trabajo donde ya están los datos, de modo que los equipos evitan el paso de extracción, que añade latencia, crea copias adicionales y amplía la superficie de seguridad. Los argumentos históricos a favor de este modelo se mantienen desde mediados de los años noventa, pero su adopción generalizada no llegó hasta mediados de la década de 2000, cuando la analítica pasó de las estaciones de trabajo externas a los data warehouses empresariales y las bases de datos orientadas a columnas hicieron viable el escaneo y la agregación en el propio data warehouse. La panorámica histórica del procesamiento dentro de la base de datos muestra claramente esa evolución.

Un buen ejemplo de dashboard ayuda a enmarcar el problema. Si la métrica que vigila ya se deriva de tablas del data warehouse, extraer esas tablas a otro motor solo para comprobar la actualidad o la deriva de esquema crea un segundo punto de fallo. Para hacerse una idea rápida de cómo suelen configurarse las superficies de reporting, consulte los ejemplos de dashboards GTM de Yalc y compare cómo las métricas operativas dependen de datos de origen limpios y actualizados.
Regla práctica: si una comprobación puede fallar porque los datos tuvieron que moverse, la arquitectura ya está haciendo más trabajo del que pidió el usuario.
Por eso las plataformas de observabilidad modernas tratan cada vez más el propio data warehouse como el lugar de ejecución. Un motor independiente puede seguir siendo útil, pero el coste de mover datos regulados y de gran volumen suele superar la comodidad de un flujo de trabajo externo. Los equipos que mantienen el cálculo cerca de los datos suelen tener un mejor control de la gobernanza y evitan la incómoda brecha entre “el origen está bien” y “la copia de reporting es errónea”.
Si ya observa tablas duplicadas, dashboards con retraso o trabajo de conciliación que se repite cada mañana, probablemente el problema no sea la definición de sus métricas. Es el salto adicional.
Para un modo de fallo relacionado, consulte cómo la redundancia de datos genera anomalías en los sistemas de analítica y reporting, porque las copias duplicadas a menudo explican por qué un equipo confía en las cifras y otro no.
Cómo ha evolucionado y cómo funciona el procesamiento dentro de la base de datos
La arquitectura no apareció de golpe. Los sistemas de analítica dentro de la base de datos adquirieron relevancia comercial a mediados de los años noventa y ganaron una adopción más amplia a mediados de la década de 2000, cuando los equipos de data warehouse dejaron de tratar la analítica como algo que debía realizarse en una estación de trabajo independiente. La idea clave era sencilla: mantener los datos en su sitio, reducir el movimiento y ejecutar el trabajo estadístico donde ya residían los datos.
Un hito citado a menudo en ese cambio tuvo lugar en la conferencia Teradata Partners celebrada en Orlando del 18 al 22 de septiembre de 2005, cuando Thomas Tileston presentó la idea de acelerar la minería de datos combinando SAS y Teradata dentro del data warehouse. Ese momento fue importante porque convirtió una optimización de nicho en un patrón empresarial. Las bases de datos orientadas a columnas, diseñadas para analítica, data warehousing y reporting, hicieron viable el enfoque al mejorar la forma en que los sistemas escanean y agregan grandes conjuntos de datos.

De la aceleración del data warehouse a la analítica nativa en la base de datos
Los sistemas modernos ejecutan ahora directamente dentro del motor de base de datos en lugar de extraer los datos a la memoria de trabajo. La documentación de IBM indica que operar con los datos dentro de la base de datos evita los problemas de seguridad asociados a su extracción, y el proyecto MADlib se describe como una biblioteca basada en SQL de machine learning, minería de datos y estadística que funciona a escala dentro del motor de base de datos sin importar ni exportar a otras herramientas. La clave arquitectónica es que la analítica pasa a ser una responsabilidad de la base de datos, no de un componente auxiliar.
Las funciones analíticas dentro de la base de datos de Teradata llevaron este enfoque más lejos hacia un modelo de biblioteca amplia, y una fuente citada menciona más de 200 funciones analíticas en una arquitectura shared-nothing, entre ellas perfilado, estadística descriptiva y muestreo. Esa amplitud explica por qué el modelo sobrevivió más allá de los primeros ajustes de data warehouse y resultó útil para operaciones con un fuerte peso de la gobernanza.
La contrapartida práctica sigue existiendo. A medida que la base de datos asume más lógica, el rendimiento depende de la planificación de consultas, la indexación, la localidad de memoria y la ejecución vectorizada. Un motor bien ajustado puede convertir esto en una ventaja, pero uno mal ajustado convierte el trabajo dentro de la base de datos en un cuello de botella.
La historia importa porque explica por qué esto ya no es experimental. Los equipos no están adoptando un truco ingenioso, sino un patrón de ejecución maduro que ya ha sido moldeado por las limitaciones a escala de data warehouse.
Si está comparando patrones modernos de almacenamiento y ejecución, qué es un formato de tabla abierto es una lectura complementaria útil, porque el debate sobre el almacenamiento abierto a menudo se solapa con la cuestión de dónde debe ejecutarse la analítica.
Ejecución dentro de la base de datos frente a flujos de extracción y análisis
La pregunta esencial es dónde debe realizarse el trabajo y qué efecto tiene esa elección sobre la seguridad, la latencia y la complejidad operativa.
Dimensión | Procesamiento dentro de la base de datos | Flujo de extracción y análisis |
|---|---|---|
Movimiento de datos | El cálculo se mantiene donde residen los datos, por lo que el movimiento se minimiza | Los datos se copian o exportan antes del análisis, lo que añade sobrecarga de transferencia |
Postura de seguridad | Los datos pueden permanecer dentro del entorno del cliente, lo que ayuda con los conjuntos de datos regulados | Más copias y transferencias externas generan una superficie de exposición más amplia |
Perfil de rendimiento | Depende de la planificación de consultas, la indexación, la localidad de memoria y el comportamiento de pushdown | Depende de la velocidad de transferencia, el staging y el perfil de cómputo del motor externo |
Uso más adecuado | Cargas de trabajo de data warehouse grandes, sensibles o sensibles a la latencia | Análisis ligeros, exploración ad hoc o sistemas que ya cuentan con exportaciones |
Riesgo operativo | Puede sobrecargar la producción si se fuerza demasiado el motor | Puede desviarse del origen y generar una verdad desactualizada o duplicada |
La ejecución dentro de la base de datos mantiene los conjuntos de datos grandes o sensibles dentro del sistema de registro, por lo que otro motor no necesita leerlos a través de la red. Esto importa en entornos empresariales en los que el data warehouse de origen ya conlleva requisitos de gobernanza, control de accesos y auditoría. La contrapartida no es teórica. El motor de base de datos tiene ahora más trabajo, por lo que los planes deficientes, una indexación débil o una carga concurrente elevada pueden ralentizar a la vez los procesos de producción y las comprobaciones de observabilidad.
Las recomendaciones de IBM sobre analítica dentro de la base de datos dejan claro que mantener los datos en la base de datos evita los problemas de seguridad asociados a su extracción, y por eso este modelo aparece a menudo en entornos regulados. Para una comparación práctica entre la ejecución más segura dentro de la base de datos y los pipelines externos, consulte la comparación entre la ejecución dentro de la base de datos y los pipelines externos.
La deriva de esquema acentúa la diferencia. Cómo la redundancia genera anomalías en los sistemas de analítica y reporting explica por qué las copias adicionales suelen crear versiones contradictorias del mismo hecho. Cuando la observabilidad, los controles de calidad o la detección de anomalías se ejecutan fuera del data warehouse, los equipos a menudo dedican más tiempo a conciliar copias que a solucionar el problema de fondo.
Dónde suele imponerse cada enfoque
El procesamiento dentro de la base de datos se impone cuando los datos son demasiado sensibles para moverlos, demasiado grandes para copiarlos con frecuencia o demasiado importantes para no inspeccionarlos cerca de su momento de llegada.
La extracción y el análisis se imponen cuando el conjunto de datos es pequeño, la lógica es experimental o el data warehouse no debería asumir carga analítica adicional.
Los patrones híbridos se imponen cuando la gobernanza debe mantenerse cerca del data warehouse, pero el trabajo exploratorio necesita un entorno independiente.
La investigación de tipo benchmark sobre cargas de trabajo de data warehouse mide el tiempo de respuesta, el rendimiento y el coste total. Los benchmarks en tiempo real comprueban si un sistema puede absorber flujos entrantes sin retrasos. Esto importa porque las comprobaciones de observabilidad se comportan como cargas de trabajo de data warehouse sensibles a la latencia, no como procesos de reporting offline.
Cómo ejecuta digna la observabilidad dentro de su data warehouse
digna mantiene el cálculo de métricas dentro de las propias bases de datos del cliente, de modo que los datos no se mueven mientras la plataforma los evalúa. Es el planteamiento adecuado para los equipos que dan prioridad a la gobernanza, porque la capa de observabilidad no necesita copiar los datos de producción a otro lugar antes de poder inspeccionar su actualidad, su esquema o su comportamiento.
El modelo operativo se centra en cinco dimensiones: actualidad, volumen, esquema, distribución y linaje. Son los mecanismos prácticos para monitorizar el comportamiento de los datos, no solo para comprobar si una única regla se cumplió en un momento dado. Un data warehouse puede parecer sano en un lote y estar desviándose en otro, por lo que las comprobaciones deben seguir a los datos a lo largo del tiempo.
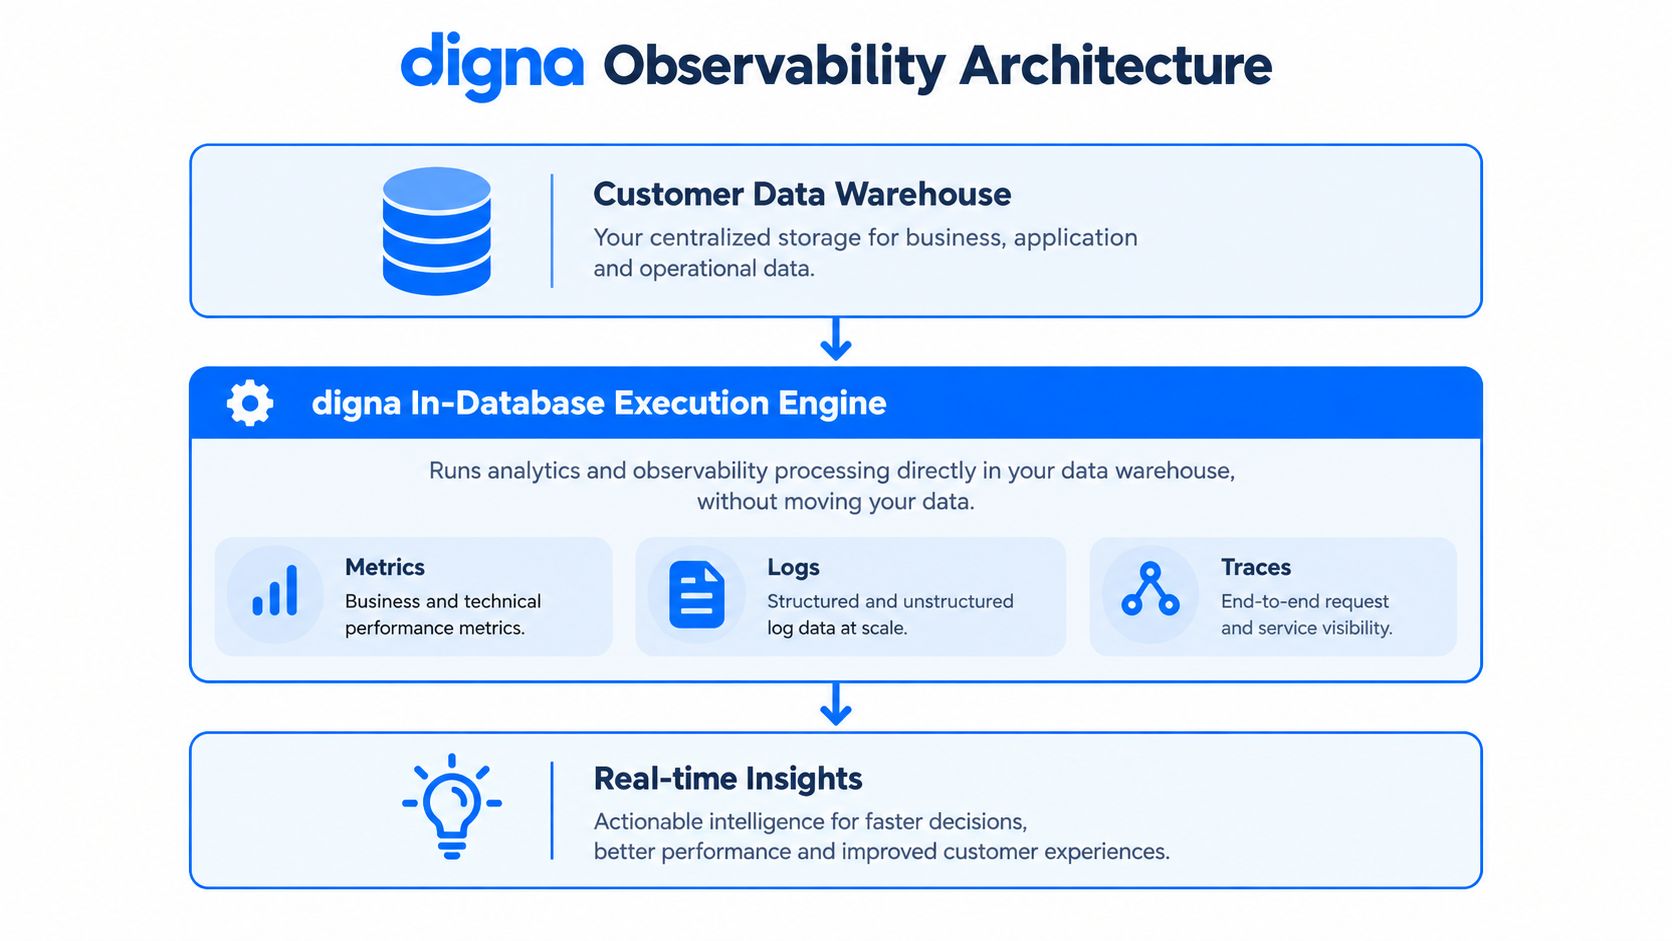
Qué ocurre dentro del data warehouse
La monitorización de la deriva de esquema compara el esquema entrante o inferido con una línea base esperada o un esquema contractual y, después, clasifica las adiciones, eliminaciones, cambios de nombre y cambios de tipo de datos para gestionarlos según su gravedad. Ese detalle importa porque una columna que falta y una columna renombrada no suelen merecer la misma respuesta. Una alerta estricta ante cada cambio genera ruido, mientras que no alertar en absoluto deja expuestos los sistemas posteriores.
La monitorización de la puntualidad comprueba si los datos llegaron según lo previsto, antes o tarde, y la detección de anomalías aprende el comportamiento del conjunto de datos sin necesidad de configurar reglas manuales para cada caso. Ese paso de las reglas rígidas al aprendizaje de líneas base es lo que hace que el sistema sea práctico a escala empresarial, sobre todo cuando las fuentes varían según el día, el origen o el ciclo de negocio.
La ejecución dentro de la base de datos de la plataforma también responde bien a una pregunta habitual en las empresas: ¿cómo monitorizar la actualidad y las infracciones de reglas de negocio sin convertir cada incidente en un proyecto de mantenimiento artesanal? La respuesta suele ser dejar que el data warehouse haga el cálculo y que la capa de observabilidad interprete el patrón.
Regla operativa: si un monitor necesita ajustes manuales constantes solo para no generar ruido, no es observabilidad, es fatiga de alertas con pasos adicionales.
La documentación de digna también describe un modelo de licencias modular, con una tarifa base más un importe por tabla activa y por módulo. Este tipo de estructura importa desde el punto de vista operativo, porque los equipos rara vez necesitan todas las capacidades desde el primer día: normalmente empiezan con un problema y amplían cuando el patrón demuestra su valor.
Para los equipos que comparan estilos de implementación, las comprobaciones sobre la eliminación de OpenDatabase son un ejemplo complementario útil de cómo la inspección en el propio data warehouse puede plantearse como una actividad de auditoría controlada en lugar de como una exportación de datos externa.
La ventaja práctica es sencilla. Mantiene los datos en el entorno del cliente, calcula las métricas donde ya residen los datos y reduce el número de lugares en los que una copia obsoleta puede convertirse en “la verdad”.
Cuándo el procesamiento dentro de la base de datos no es la opción adecuada
Incluso la configuración dentro de la base de datos más sólida tiene límites. Si el motor no puede planificar bien la consulta, no puede aprovechar la localidad de memoria o no puede beneficiarse de la ejecución vectorizada, el trabajo de observabilidad se convierte en una sobrecarga para la producción en lugar de una salvaguarda.
Los modos de fallo son prácticos, no teóricos
La compatibilidad es el primero. No todas las bases de datos ofrecen las mismas funciones analíticas, y no todos los entornos permiten el mismo nivel de pushdown. Si la plataforma no puede ejecutar las comprobaciones necesarias dentro del motor, los equipos suelen acabar reintroduciendo las exportaciones por la puerta trasera.
La contención de cargas de trabajo es el segundo. Un data warehouse que ya da servicio a BI y a análisis ad hoc puede verse limitado si los procesos de observabilidad están mal programados o resultan demasiado costosos para ejecutarse en línea. La planificación de consultas y la indexación importan aquí, y “mantenerlo en la base de datos” nunca significa “ejecutarlo todo de inmediato”.
El exceso de alcance es el tercero. La analítica ligera, las investigaciones de corta duración o los conjuntos de datos de bajo riesgo a menudo no justifican el coste de configuración. En esos casos, un flujo de trabajo externo más sencillo puede ser más fácil de mantener y de retirar más adelante, sobre todo cuando los equipos ya disponen de un pipeline de datos ETL que soporta la carga operativa.
Mantenga las comprobaciones donde residen los datos solo cuando el motor pueda absorber el trabajo sin convertirse en el problema.
La contrapartida empresarial está clara. La ejecución dentro de la base de datos puede reducir el movimiento de datos y ayudar a que los datos regulados permanezcan dentro del entorno del cliente, pero también exige más del stack de base de datos. Si el equipo no puede controlar la forma de las consultas, el diseño de índices o el aislamiento de cargas de trabajo, el modelo puede seguir fallando a escala.
La elección no es ideológica. Se reduce a si el data warehouse puede absorber la carga de monitorización sin crear nuevos cuellos de botella, nuevo trabajo de ajuste o nueva presión sobre los costes. Como se ha indicado antes, algunas cargas de trabajo se gestionan mejor dentro del data warehouse, mientras que otras quedan más limpias fuera de él.
Casos de uso sectoriales que exigen fiabilidad dentro de la base de datos
Los sectores regulados se interesan por este patrón por la misma razón: no pueden permitirse una segunda copia de la verdad que se vaya desviando. Los equipos de servicios financieros, sanidad, telecomunicaciones y sector público trabajan con datos sensibles, trazables o críticos en cuanto a plazos operativos, por lo que la comprobación debe realizarse sin movimientos innecesarios.
Los equipos financieros suelen necesitar inspeccionar in situ los datos transaccionales, de riesgo y regulatorios. Si el proceso de monitorización exporta los datos a otro entorno, puede entrar en conflicto con la residencia de datos, las expectativas de auditoría o los controles internos. Los equipos sanitarios se enfrentan a una presión distinta: las cargas retrasadas o los cambios de esquema pueden distorsionar los informes clínicos y operativos, y no es un problema que convenga descubrir a posteriori.
Los equipos de telecomunicaciones gestionan flujos constantes de gran volumen, por lo que la detección continua de anomalías debe funcionar sin un pesado cuello de botella de exportación. Los equipos del sector público necesitan pruebas de que los propios controles son auditables, lo que hace atractiva la ejecución dentro de la base de datos, porque el rastro de monitorización se mantiene cerca del entorno gobernado.
La limitación común a estos sectores
El hilo común no es el sector, sino la forma operativa de los datos. Cada uno de estos entornos necesita una monitorización lo bastante rápida para ser relevante, lo bastante estricta para satisfacer la gobernanza y lo bastante contenida para no crear nuevas copias que se alejen del origen.
Por eso la cuestión de seguridad frente a complejidad importa más que la definición. Si la carga de trabajo es sensible, de gran volumen y está estrechamente ligada al cumplimiento, la ejecución dentro de la base de datos suele convertirse en la opción práctica más que en una preferencia arquitectónica. Si la carga de trabajo es ocasional o exploratoria, el mismo enfoque puede dar más problemas de los que resuelve.
La tendencia reciente en observabilidad avanza en la misma dirección y trata la calidad de los datos y la observabilidad como un único problema de analítica centrado en la base de datos, en lugar de como dos tareas separadas. Esto resulta útil porque la pregunta clave en las empresas rara vez es “¿Podemos detectar un problema?”. Es “¿Podemos detectarlo sin romper el sistema que intentamos proteger?”.
Cómo decidir si el procesamiento dentro de la base de datos encaja en su stack
Empiece por los datos, no por la herramienta. Si el conjunto de datos es demasiado sensible para salir del entorno, demasiado grande para moverlo de forma eficiente o está demasiado cerca de la fuente de verdad como para tolerar retrasos, el procesamiento dentro de la base de datos merece un análisis serio.
Después, revise la carga de trabajo. La detección de anomalías en tiempo real, las comprobaciones de actualidad, la monitorización de la deriva de esquema y la validación de reglas de negocio se benefician de ejecutarse cerca del origen de los datos. Si esas mismas comprobaciones solo se ejecutan de vez en cuando, o si son exploratorias en lugar de operativas, la sencillez de un motor externo puede ser suficiente.
A continuación, ponga a prueba el propio motor. ¿Admite las funciones analíticas que necesita? ¿Puede ejecutar el pushdown de forma limpia? ¿Puede gestionar la observabilidad sin dejar sin recursos a las consultas de producción? Estas preguntas importan más que la etiqueta comercial, porque una base de datos que no planifica bien le penalizará antes que un proceso externo lento.
Una breve lista de verificación para decidir
Elija el procesamiento dentro de la base de datos cuando los datos estén regulados, el volumen sea elevado o la latencia importe.
Prefiera el análisis externo cuando la carga de trabajo sea ligera, temporal o todavía esté cambiando de forma.
Valide el comportamiento del motor antes del despliegue, sobre todo los planes de consulta, la indexación y el aislamiento de cargas de trabajo.
Conserve las herramientas de BI existentes donde ya funcionan, porque la ejecución dentro de la base de datos no obliga a desechar el resto del stack.
El mayor malentendido es pensar que la ejecución dentro de la base de datos lo sustituye todo. No es así. Cambia dónde se realizan las comprobaciones, no si siguen existiendo los analistas, los dashboards o las aplicaciones posteriores. En la práctica, los mejores despliegues mantienen el data warehouse como fuente de verdad, utilizan el motor de base de datos para la inspección con un fuerte peso de la gobernanza y evitan reconstruir todo un stack analítico solo para resolver un problema de actualidad.
Si su configuración actual dedica más tiempo a copiar datos que a comprobarlos, probablemente la arquitectura esté jugando en su contra. Si busca una plataforma que calcule la calidad y la observabilidad dentro del entorno del cliente, mantenga los datos en su sitio y permita una monitorización modular de anomalías, puntualidad, validación, cambios de esquema y métricas de negocio, visite digna y descubra cómo encaja el modelo dentro de la base de datos con su data warehouse y sus requisitos de gobernanza.
Dado que la compatibilidad del motor determina si las comprobaciones pueden permanecer dentro de la base de datos, la lista de bases de datos y data warehouses con los que se integra digna es lo primero que debe confirmar para su stack.
Preguntas frecuentes
¿Qué es el procesamiento dentro de la base de datos?
El procesamiento dentro de la base de datos ejecuta la analítica y la monitorización directamente en el motor de base de datos, de modo que los datos permanecen en su sitio en lugar de extraerse a una herramienta externa. Esto elimina la sobrecarga de transferencia, evita copias adicionales y reduce la superficie de seguridad, algo que importa sobre todo cuando un data warehouse es grande, sensible o ambas cosas.
¿Cuándo se generalizó el procesamiento dentro de la base de datos?
La analítica dentro de la base de datos adquirió relevancia comercial a mediados de los años noventa y logró una amplia adopción a mediados de la década de 2000. Un hito citado con frecuencia es la conferencia Teradata Partners de septiembre de 2005, en la que se presentó la combinación de SAS y Teradata dentro del data warehouse, mientras que las bases de datos orientadas a columnas hicieron viable el escaneo y la agregación en el propio data warehouse.
¿Cuál es la diferencia entre el procesamiento dentro de la base de datos y los flujos de extracción y análisis?
El procesamiento dentro de la base de datos calcula donde residen los datos, mientras que los flujos de extracción y análisis copian o exportan primero los datos a otro motor. El primero es adecuado para cargas de trabajo grandes, sensibles o sensibles a la latencia, pero puede sobrecargar la producción; el segundo es adecuado para análisis ligeros o ad hoc, pero puede desviarse del origen y generar una verdad duplicada.
¿Cuándo no es el procesamiento dentro de la base de datos la opción adecuada?
Tiene dificultades en tres situaciones que menciona el artículo: carencias de compatibilidad, cuando la base de datos no dispone de las funciones analíticas o del pushdown necesarios; contención de cargas de trabajo, cuando los procesos de observabilidad limitan las consultas de BI; y exceso de alcance, cuando un análisis ligero, de corta duración o de bajo riesgo no justifica el coste de configurarlo dentro del motor.
¿Cómo utiliza digna el procesamiento dentro de la base de datos para la data observability?
digna mantiene el cálculo de métricas dentro de las propias bases de datos del cliente y monitoriza allí la actualidad, el volumen, el esquema, la distribución y el linaje. Sus comprobaciones de deriva de esquema comparan la estructura entrante con una línea base esperada y clasifican por gravedad las adiciones, eliminaciones, cambios de nombre y cambios de tipo, mientras que la detección de anomalías aprende el comportamiento del conjunto de datos sin reglas manuales.


