Cómo crear un archivo de configuración que funcione
|
5
minuto de lectura

Para aprender a crear un archivo de configuración, defina los ajustes que necesita su aplicación, elija un formato legible, guárdelo con la extensión correcta y valídelo antes de pasar nada a producción. El objetivo es mantener el comportamiento en tiempo de ejecución separado del código de la aplicación para que los equipos puedan ajustar los entornos sin modificar el código base.
Índice
Comprender los archivos de configuración y la configuración rápida
Comprender los archivos de configuración y la configuración rápida
Un archivo de configuración tiende un puente entre su código y el entorno en ejecución. En lugar de codificar directamente en el código fuente las cadenas de conexión a bases de datos, los endpoints de API, los niveles de registro o los feature flags, se almacenan externamente para que los miembros autorizados del equipo puedan actualizarlos de forma independiente.
Esa separación es importante en los sistemas financieros, sanitarios y del sector público, donde los cambios deben estar controlados, tener el acceso restringido y ser auditables. También reduce los errores de despliegue, porque desarrollo, staging y producción pueden usar valores distintos y compartir el mismo código de aplicación.
Empiece por enumerar los ajustes sin los que la aplicación no puede funcionar:
Datos de conexión, como nombres de bases de datos y referencias a servicios
Feature flags que activan o desactivan comportamientos opcionales
Ajustes de registro, incluidos el nivel de detalle y el destino de salida
Etiquetas de entorno para que la aplicación cargue el perfil correcto al iniciarse
Elija el formato que mejor se adapte a sus herramientas. YAML es legible y gestiona bien la jerarquía. JSON es estricto y funciona sin problemas con las API. INI es adecuado para pares clave-valor sencillos. TOML ofrece una estructura explícita sin demasiadas formalidades.
El gráfico siguiente compara estos cuatro formatos en cuanto a legibilidad, jerarquía, compatibilidad con comentarios y casos de uso habituales.
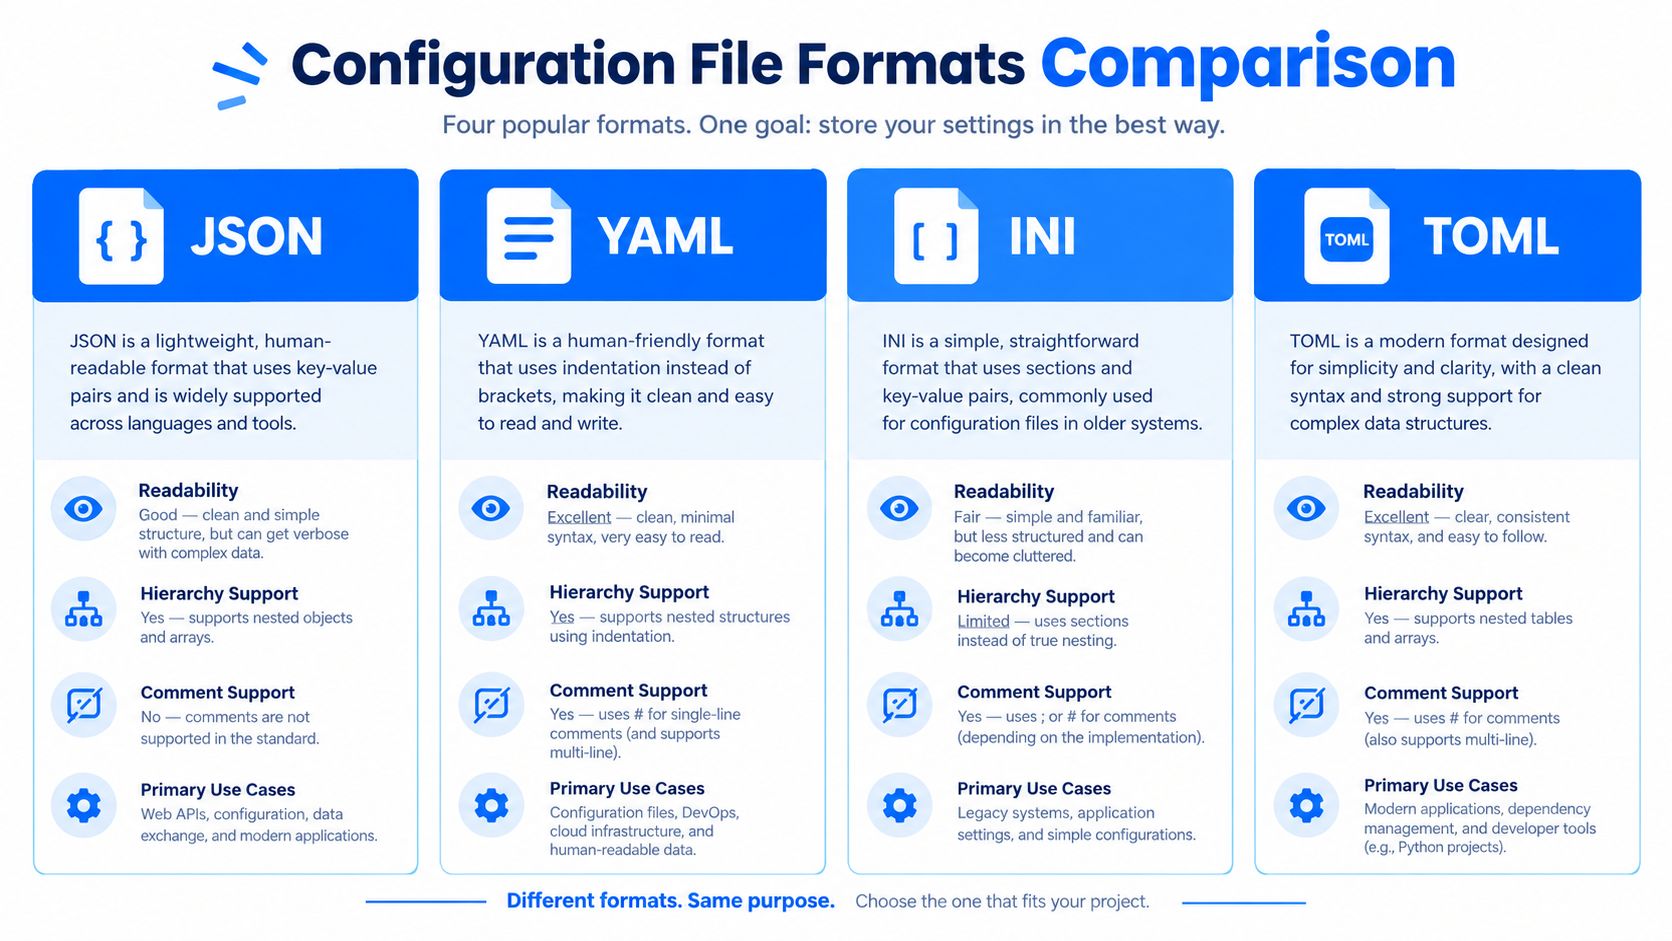
Observará que YAML y TOML favorecen la edición manual, mientras que JSON está diseñado para un análisis estricto por máquina e INI sigue siendo útil para ajustes más planos y sencillos.
Consejo: Trate cada archivo de configuración como una entrada que puede fallar. Analícelo y valídelo siempre antes de que se inicie la aplicación; nunca dé por sentado que se cargará correctamente.
Si trabaja con Python y necesita conectar los flujos de monitorización con el código de la aplicación, consulte la documentación del SDK de Python de digna para ver un ejemplo práctico de cómo la configuración respalda la observabilidad en casos reales.
El formato de configuración adecuado depende de tres factores: lo que espera su aplicación, lo que ya ejecuta su pipeline de despliegue y quién mantendrá el archivo dentro de seis meses. No elija únicamente por preferencia personal. Elija el formato que sus herramientas admiten de forma fiable.

Adaptar el formato al flujo de trabajo
YAML es popular por buenas razones. Aparece en manifiestos de Kubernetes, configuraciones de Docker Compose y definiciones de pipelines de CI/CD porque su estructura basada en la sangría es fácil de leer. Sin embargo, un solo espacio mal colocado puede romper todo el archivo. Una tabulación de más puede impedir que se inicie un contenedor. La coherencia del editor y el linting son esenciales.
JSON funciona bien cuando son las máquinas las que generan el archivo. Los contratos de API, las cargas útiles serializadas y los ajustes generados automáticamente se benefician de su sintaxis estricta. La desventaja es que editar a mano un archivo JSON grande resulta tedioso, y una coma que falte puede producir un error críptico del parser.
INI se sitúa en el extremo opuesto del espectro. Utiliza secciones planas con pares clave-valor sencillos. Para una pequeña utilidad de escritorio o una herramienta de desarrollo ligera, esa simplicidad es una ventaja más que una limitación.
TOML aborda la legibilidad sin depender de la sangría. Los encabezados de sección, los valores tipados y una estructura predecible lo hacen atractivo para las herramientas modernas. La contrapartida es su adopción: no todos los lenguajes o plataformas ofrecen compatibilidad completa con TOML.
Formato | Uso más adecuado | Principal consideración |
|---|---|---|
YAML | Infraestructura y pipelines | Errores de sangría |
JSON | API y datos generados | Edición prolija |
INI | Ajustes de aplicación planos | Anidamiento limitado |
TOML | Herramientas modernas explícitas | Compatibilidad menos universal |
Regla práctica: Elija el formato que ya entienden su parser, su plataforma de despliegue y su equipo de mantenimiento.
En los entornos de analítica empresarial, YAML y JSON son opciones habituales. Equilibran la legibilidad para las personas con una automatización fiable. Ambos formatos son competencias valiosas para los ingenieros de datos y de plataforma. Si sus pipelines también utilizan formatos de almacenamiento columnar, obtenga más información sobre los archivos Parquet y su estructura antes de conectar esos conjuntos de datos a su stack de monitorización o procesamiento.
Valide siempre su configuración con el parser real antes de enviarla a un entorno real. Un archivo que a usted le parece correcto puede fallar igualmente cuando la aplicación se encuentra con un caso límite no admitido.
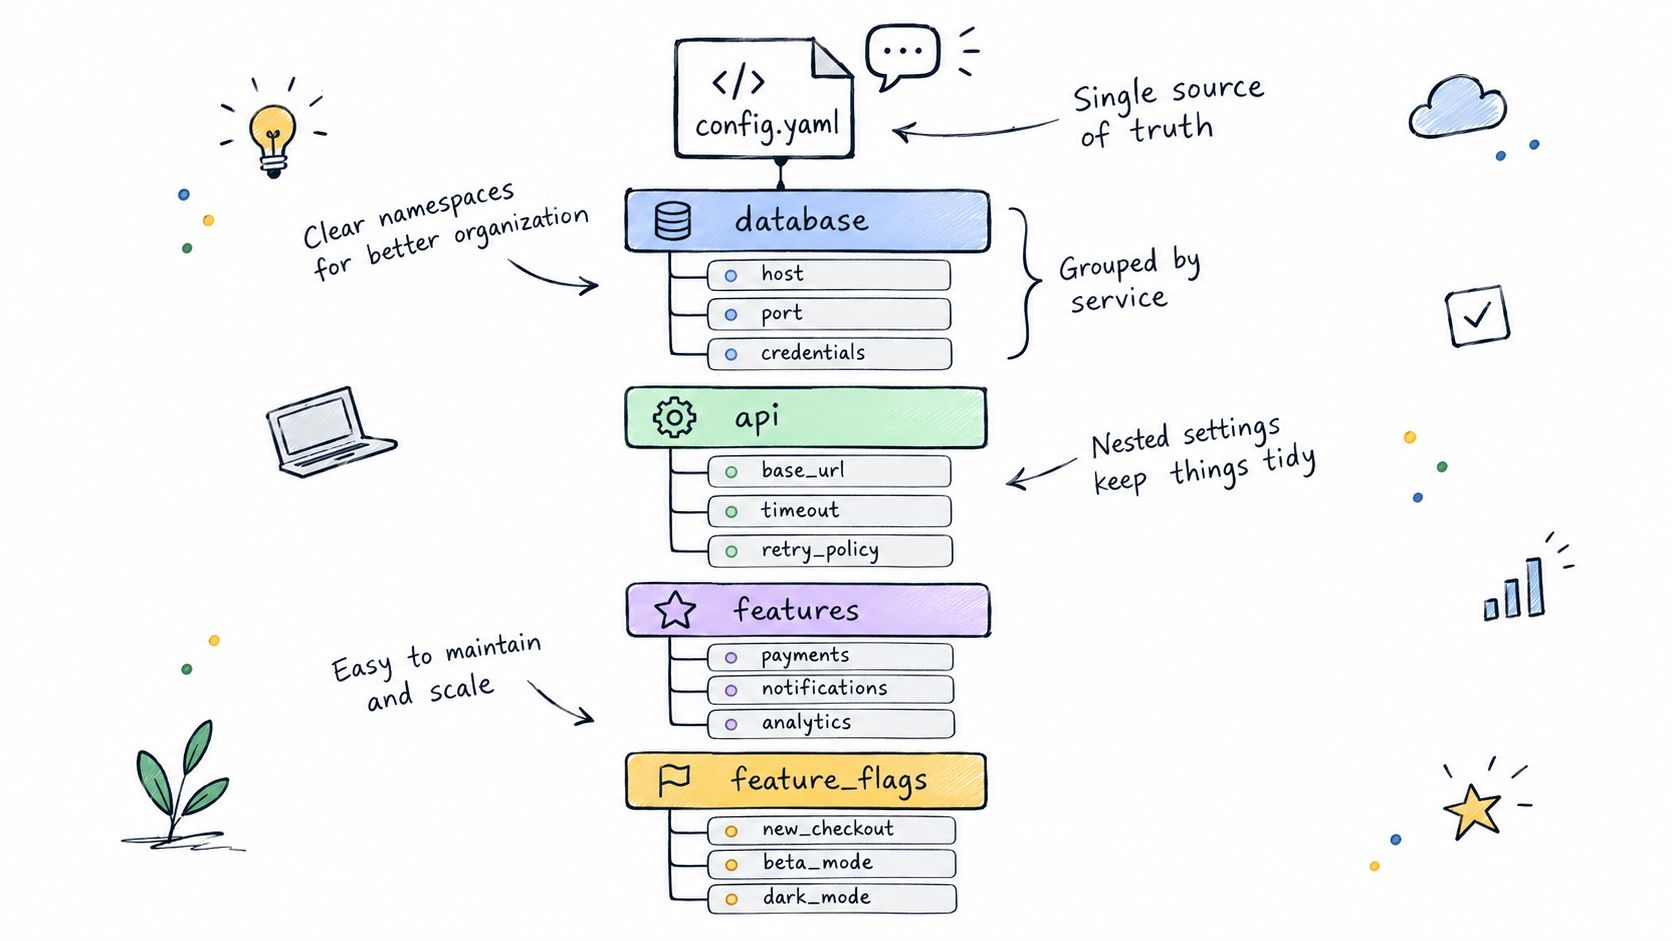
Todo archivo de configuración fiable comienza con un inventario honesto. Incluya solo lo que la aplicación necesita realmente para funcionar: referencias a bases de datos, endpoints de servicios, niveles de registro, feature flags y ajustes similares. Después, agrupe los valores relacionados bajo espacios de nombres significativos en lugar de dispersarlos por todo el archivo.

Organizar los ajustes en torno a los aspectos de la aplicación
Supongamos que está configurando un servicio de informes en YAML. El archivo podría tener este aspecto:
Cuando se produce un incidente a las 2 de la madrugada, esta estructura demuestra su valor. Cualquier persona de guardia puede encontrar rápidamente el ajuste pertinente en lugar de buscar entre una maraña de claves. JSON funciona de forma similar: anide los objetos correspondientes y utilice una sangría coherente de dos espacios. INI es diferente, así que mantenga un diseño plano y utilice secciones con nombres claros, como [database] y [logging].
Utilice los comentarios de forma selectiva. Añádalos para explicar un tiempo de espera inusual, un interruptor de funcionalidad temporal o un valor que debe mantenerse sincronizado con otro sistema. Un comentario que se limita a repetir el nombre del parámetro solo añade ruido. Los lectores necesitan el razonamiento que hay detrás de una decisión, no un eco de ella.
Idea clave: Un archivo de configuración debe explicar las decisiones operativas de la aplicación, no obligar a los lectores a deducirlas mediante ingeniería inversa.
Antes de guardar el archivo, realice tres comprobaciones rápidas:
Utilice la extensión esperada, como
.yaml,.jsono.ini, para que las herramientas reconozcan el archivo.Mantenga nombres coherentes: elija una convención, como
timeout_seconds, y úsela en todas partes.Separe los entornos para que desarrollo y producción puedan usar valores distintos sin cambiar la lógica de la aplicación.
Si sus ajustes describen conjuntos de datos o metadatos, obtenga más información sobre las descripciones de esquemas de bases de datos para mantener la terminología de la configuración alineada con los datos que controla.
Pruebe el archivo inmediatamente con el parser real de la aplicación. Un archivo puede parecer válido y contener una clave no admitida, un tipo incorrecto o un valor obligatorio ausente. Detectar estos problemas antes del despliegue hace que los cambios de configuración sean predecibles y reduce el trabajo de recuperación.
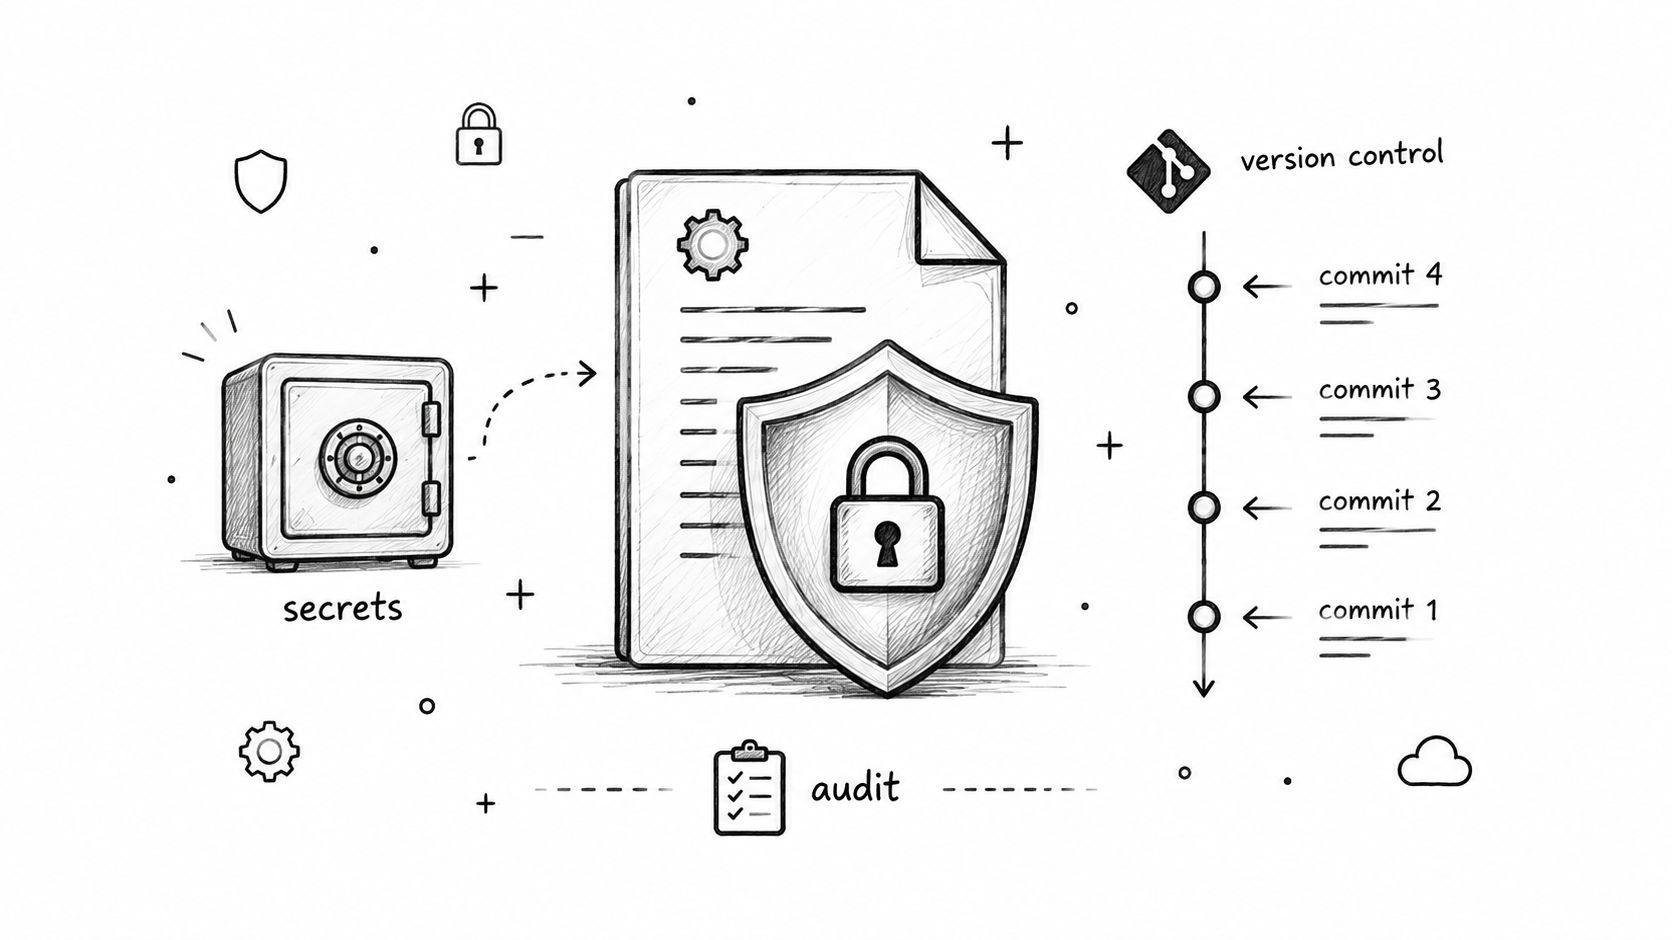
Gestionar la configuración a escala va más allá de elegir el formato adecuado. Todo archivo de configuración que no contenga secretos debe estar en Git. El control de versiones da a los equipos visibilidad sobre los cambios, una vía sencilla para revertirlos y un registro de auditoría para el cumplimiento normativo.
La disciplina en los commits es importante. Los commits pequeños y específicos con mensajes como Increase reporting timeout son más útiles que un gran commit de miscellaneous fixes. Para los cambios en producción, la revisión mediante pull request debe ser obligatoria. Cuando despliegue una actualización de configuración en varios servicios, etiquete la versión para poder localizarla más adelante.
Proteger los secretos y validar los cambios
Las contraseñas, los tokens, las claves privadas y las cadenas de conexión no deben estar en archivos confirmados en el repositorio. En su lugar, haga referencia a variables de entorno u obtenga los secretos de un sistema de gestión dedicado que ofrezca control de acceso y rotación sin necesidad de modificar el código de la aplicación.
Antes de fusionar cualquier cambio de configuración, combine las comprobaciones automatizadas con la revisión humana:
Analice el archivo con la misma biblioteca que utiliza su aplicación para detectar pronto los problemas de análisis en tiempo de ejecución.
Valide el esquema para identificar claves ausentes, tipos incorrectos o valores inesperados.
Ejecute un linter para detectar incoherencias de formato y errores de sintaxis.
Analice los commits en busca de secretos antes de que lleguen al repositorio compartido; eliminar filtraciones del historial es mucho más difícil que evitarlas.
Pruebe las sobrescrituras por entorno para que staging y producción se resuelvan con los valores esperados y no con valores predeterminados olvidados.
Idea clave: Trate la configuración como código de producción y los secretos como un límite de seguridad independiente.
Las convenciones de nomenclatura causan problemas a más equipos de lo que cabría esperar. Elija un estilo, como timeout_seconds o TIMEOUT_SECONDS, y utilícelo de forma coherente en todos los servicios. Documente las variables obligatorias y mantenga predecibles las sobrescrituras por entorno. Funciona bien un archivo base con valores predeterminados razonables, en el que los archivos de staging y producción sobrescriben solo los valores que realmente difieren.
Crear controles de despliegue fiables
Configure un control en el pipeline que impida que una configuración no válida llegue al despliegue. En los servicios críticos, implante los cambios de forma gradual, supervise de cerca las métricas de arranque y de estado, y mantenga una vía de reversión probada.
Si necesita un recordatorio de por qué esto es importante, merece la pena leer el análisis posterior de Cloudflare sobre su interrupción de noviembre de 2025. Muestra por qué la configuración generada necesita su propia validación, límites de tamaño, una propagación controlada y una versión de recuperación que se sepa que funciona.
Para los equipos que gestionan datos de clientes, digna ofrece orientación sobre la protección de los datos de clientes en entornos empresariales. El principio es sencillo: mantenga las configuraciones revisables, auditables y recuperables a medida que crecen sus servicios y su equipo.
Incluso una configuración bien estructurada puede fallar durante el análisis, la carga o la ejecución. La clave es determinar si se trata de un problema de sintaxis o de un fallo real en tiempo de ejecución, y probar primero la capa correspondiente.
Detectar primero los problemas de análisis sintáctico
YAML suele romperse por una sangría incoherente, sobre todo cuando se mezclan tabulaciones y espacios en el mismo archivo. JSON suele fallar por comillas ausentes, una coma suelta antes de una llave de cierre o un corchete sin cerrar.
Pase la configuración por el mismo parser que utiliza su aplicación. Después, añada un linter o un validador de esquemas a su flujo de trabajo de desarrollo para que estas comprobaciones se realicen automáticamente. Una estructura no válida debe detectarse mucho antes de que llegue a producción.
Confirme la sangría y el anidamiento en los archivos YAML.
Revise las comillas, las comas y los corchetes en JSON.
Verifique que estén presentes las claves obligatorias y los tipos de valor esperados.
Asegúrese de que la extensión del archivo coincida con lo que espera su cargador.
Idea clave: Un archivo que parece perfecto en su editor sigue necesitando un análisis automatizado y una validación de esquema para ser fiable.
Investigar los fallos en tiempo de ejecución
A veces, una configuración se analiza sin errores, pero falla cuando la aplicación utiliza sus valores. Un número de puerto no válido, una opción no admitida, una variable de entorno ausente o un endpoint inaccesible pueden bloquear el arranque o provocar errores que aparecen horas después.
Empiece por comparar el archivo que falla con una configuración que se sepa que funciona, cambiando un valor cada vez hasta que aparezca el problema. Después, revise los registros de la aplicación; el mensaje de error suele identificar la clave o el valor que causó el fallo.
Antes de pasar a producción, compruebe lo siguiente:
Los servicios referenciados están disponibles en el entorno de destino.
Las sobrescrituras de variables de entorno se resuelven con los valores esperados.
No hay credenciales ni tokens codificados en texto sin cifrar.
Los límites de recursos aceptan los valores configurados sin recortarlos.
Hay disponible una versión anterior probada para revertir.
El informe de Cloudflare sobre la interrupción del 18 de noviembre de 2025 confirma que la configuración generada necesita límites de tamaño, una propagación controlada y una versión de recuperación que se sepa que funciona. Abordar estos detalles antes de la implantación hace que los despliegues sean más predecibles y ayuda a proteger la disponibilidad cuando surgen problemas.
Los archivos de configuración proporcionan a las herramientas de calidad de datos un plan de funcionamiento claro y coherente. Al configurar digna, defina las referencias de conexión a bases de datos, los calendarios de monitorización, las reglas de validación y los umbrales de alerta en una capa de configuración dedicada, en lugar de dispersarlos en varios scripts.
Por ejemplo, un equipo financiero podría revisar las tablas de transacciones a medida que llegan nuevas cargas, señalar cambios inusuales de volumen y verificar que los conjuntos de datos regulatorios se entregan a tiempo. En el ámbito sanitario, la misma estructura puede servir para la validación de registros, la detección de cambios de esquema y las alertas cuando la entrega de datos clínicos se retrasa.
Una configuración práctica hace que cada decisión de monitorización sea fácil de encontrar:
Los ajustes de conexión apuntan a la fuente de datos aprobada sin exponer credenciales.
Los calendarios especifican cuándo deben ejecutarse las comprobaciones de puntualidad y otras tareas de monitorización.
Los umbrales definen cuándo las desviaciones, los retrasos o los fallos de validación requieren atención.
Los ajustes de módulos activan o desactivan la detección de anomalías, la validación, la puntualidad o el seguimiento de esquemas.
Idea clave: Su configuración debe describir qué supervisa digna y cómo responde. Guarde los secretos en variables de entorno o en un gestor de secretos aprobado, no en archivos de configuración.
Mantener los ajustes de monitorización seguros y comprobables
digna se ejecuta dentro de su propia nube, VPC o centro de datos y calcula las métricas directamente en sus bases de datos. Esta configuración permite a los equipos dejar los datos donde están y aplicar controles coherentes en almacenes de datos, data lakes y pipelines.
Separe los archivos de configuración por entorno: desarrollo, staging y producción. Antes de implantar un nuevo calendario o umbral de alerta, pruébelo con datos representativos y revise los incidentes resultantes. Someta cada cambio al control de versiones para que los ingenieros de datos puedan saber quién modificó una regla y volver a una versión que se sepa que funciona sin prisas.
Para ver más de cerca cómo esto respalda una estrategia de monitorización más amplia, descubra las capacidades de integración de calidad de datos de digna. Este enfoque ayuda a los equipos de finanzas, sanidad y telecomunicaciones a mantener la fiabilidad de sus sistemas de analítica e IA sin comprometer la seguridad ni los requisitos de auditoría.
Resolver las dudas sobre formato y seguridad
A la hora de decidir cómo crear un archivo de configuración, utilice JSON para ajustes estrictos generados por máquina y YAML para archivos de infraestructura legibles. En la práctica, la mejor opción suele ser el formato que ya admiten su parser y sus herramientas de despliegue.
Para rotar secretos sin provocar tiempo de inactividad, guárdelos en un gestor de secretos, publique una nueva versión y deje que las aplicaciones recarguen las credenciales antes de revocar las antiguas.
Idea clave: Nunca confirme credenciales en el repositorio. Si se produce una exposición, revoque el secreto de inmediato, elimínelo de los archivos activos y dé por hecho que su historial de Git está comprometido.
Mantener la validación y los entornos predecibles
Ejecute parsers de formato, comprobaciones de esquema y linters en CI/CD. Herramientas como yamllint, los validadores de JSON Schema y las comprobaciones nativas de cada plataforma pueden bloquear los cambios no válidos antes de que lleguen a producción.
Documente claramente la precedencia: los valores de la línea de comandos suelen sobrescribir las variables de entorno, que a su vez sobrescriben los valores predeterminados del archivo. En los microservicios, detecte las desviaciones comparando las configuraciones resueltas con una línea base versionada.
Conserve siempre una configuración que se sepa que funciona para poder revertir. digna ayuda a los equipos a supervisar el comportamiento de los datos y los cambios de esquema directamente en su propio entorno.
Descubra digna en digna.ai para respaldar unas operaciones de datos fiables.
Preguntas frecuentes
¿Para qué se utiliza un archivo de configuración?
Un archivo de configuración almacena los ajustes de tiempo de ejecución fuera del código fuente, de modo que los miembros autorizados del equipo pueden cambiarlos sin tocar el código base. Su contenido habitual son los datos de conexión a bases de datos, los feature flags, el nivel de detalle y el destino de salida de los registros, y las etiquetas de entorno que indican a la aplicación qué perfil cargar al iniciarse.
¿Debo usar YAML, JSON, INI o TOML para un archivo de configuración?
Elija el formato que ya entienden su parser, su plataforma de despliegue y su equipo de mantenimiento. YAML es adecuado para manifiestos de Kubernetes y pipelines de CI/CD, pero se rompe con un espacio mal colocado; JSON encaja con las API y los datos generados; INI gestiona ajustes planos de clave-valor, y TOML ofrece una estructura explícita, aunque con una compatibilidad menos universal entre lenguajes.
¿Cómo valido un archivo de configuración antes del despliegue?
Páselo por el mismo parser que utiliza su aplicación y, después, añada validación de esquema y un linter, como yamllint o un validador de JSON Schema, en CI/CD. El artículo también recomienda analizar los commits en busca de secretos y probar las sobrescrituras por entorno para que staging y producción se resuelvan con los valores esperados, no con valores predeterminados olvidados.
¿Deben incluirse las contraseñas y las claves de API en un archivo de configuración?
No. Las contraseñas, los tokens, las claves privadas y las cadenas de conexión deben estar en variables de entorno o en un gestor de secretos dedicado, nunca en archivos confirmados en el repositorio. Para rotar un secreto sin tiempo de inactividad, publique una nueva versión, deje que las aplicaciones la recarguen y, después, revoque la antigua. Si un secreto se filtra, revóquelo de inmediato y considere comprometido el historial de Git.
¿Por qué mi archivo de configuración se analiza correctamente pero la aplicación sigue fallando?
Los fallos en tiempo de ejecución se deben a los valores, no a la sintaxis: un número de puerto no válido, una opción no admitida, una variable de entorno ausente o un endpoint inaccesible. Compare el archivo que falla con una configuración que se sepa que funciona, cambie un valor cada vez hasta que aparezca el error y revise los registros de la aplicación, que a menudo indican la clave responsable.


