Monitorización del data warehouse: guía completa para 2026
|
7
minuto de lectura

El lunes por la mañana se hace cuesta arriba cuando el dashboard ejecutivo se abre con cifras desactualizadas, una tabla de ingresos con retraso y un hilo de Slack preguntando por qué el total del KPI no cuadra con el de finanzas. Esa es la realidad operativa detrás de la monitorización del data warehouse, el trabajo que evita que los equipos descubran los problemas solo cuando los usuarios de negocio ya han tomado decisiones con datos erróneos.
La distancia entre expectativa y realidad sigue siendo grande. Un resumen de investigación conjunto de 2023 señalaba que solo el 7% de los equipos de datos resuelve las incidencias antes de que los usuarios noten el impacto, el 39% dedica entre el 20% y el 40% de su tiempo a reparar pipelines, el 51% necesita varias horas para resolver un solo incidente y el 36% necesita varios días o más estudio de referencia sobre operaciones de observabilidad de datos. Estas cifras explican por qué la monitorización ya no es una capa opcional sobre el warehouse, sino parte de lo que mantiene el negocio en marcha.
El cambio también se aprecia en el mercado. Una encuesta del sector de 2026 reveló que solo el 22% de las organizaciones considera la observabilidad de datos crítica, otro 32% la califica de muy importante y poco más de un tercio afirma haberla adoptado realmente encuesta del sector sobre la madurez de la observabilidad. Esa brecha lo dice todo: la mayoría de las empresas todavía necesita más visibilidad sobre la frescura, la calidad y los patrones de fallo antes de poder confiar en la analítica y la IA.
Índice de contenidos
Patrones de implementación para la monitorización empresarial
Construir una cultura de monitorización para el éxito a largo plazo
Por qué la monitorización del data warehouse importa ahora
Un warehouse puede parecer sano desde fuera y, aun así, fallar de formas que afectan al negocio. Finanzas ve un dashboard limpio, ventas ve una línea de tendencia normal y, de pronto, alguien se da cuenta de que la actualización de ayer nunca llegó o de que un cambio de esquema rompió un modelo downstream. Cuando estos problemas salen a la luz, los equipos ya están dedicando la mañana a conciliar sistemas en lugar de usar los datos.
El coste de esperar a que los usuarios se den cuenta
Los peores incidentes de un warehouse no suelen fallar de forma ruidosa. Una tabla puede actualizarse tarde, una columna puede cambiar de tipo o un pipeline puede completarse solo parcialmente y dejar a los usuarios de negocio mirando resultados desactualizados. La monitorización importa porque detecta estas situaciones antes de que se conviertan en problemas de confianza en toda la organización.
Los modelos operativos antiguos dependían de comprobaciones manuales y del conocimiento tácito de unos pocos. Ese enfoque se viene abajo en cuanto decenas de dominios, stakeholders y pipelines dependen del mismo warehouse.
Regla práctica: si alguien tiene que abrir un dashboard para saber si el warehouse está sano, el warehouse ya es demasiado difícil de gestionar.
Por qué la observabilidad se ha convertido en una disciplina operativa
El resumen de investigación de 2023 deja claro el dilema. Los equipos siguen reaccionando después del impacto en lugar de prevenirlo. Cuando los ingenieros dedican gran parte de su tiempo a reparar pipelines y aun así necesitan horas o días para resolver incidentes, el problema ya no es un bug aislado. Es el patrón operativo.
Por eso los programas de monitorización maduros se centran en la detección temprana, la responsabilidad clara y el enrutamiento rápido. No se limitan a preguntar si un job se ha ejecutado. Preguntan si han llegado los datos correctos a tiempo, si ha cambiado la estructura, si se ha degradado la calidad y si los KPI de negocio siguen teniendo sentido.
Para los equipos que quieren cerrar ese ciclo, un buen punto de partida son las buenas prácticas de data warehouse de digna. Ayudan a distinguir entre “tenemos alertas” y “sabemos qué hacer cuando el warehouse se desvía”.
Un programa de monitorización útil también tiene que encajar con los compromisos operativos reales. Con demasiadas alertas, los equipos las ignoran. Con demasiado pocas comprobaciones, la primera señal de problemas llega de un analista frustrado o de una mala decisión ya en marcha. El equilibrio adecuado combina la validación tradicional con la detección de anomalías, incluidos enfoques in-database que mantienen las comprobaciones cerca de los datos y reducen el desfase entre el fallo y su detección.
La recompensa es la confianza. Cuando el warehouse se monitoriza con intención, los ingenieros de datos dedican menos tiempo a apagar fuegos inesperados, los analistas pasan menos tiempo validando extracciones a mano y los directivos dejan de preguntar qué versión de la cifra es la correcta. Eso es lo que hace que el warehouse sea utilizable a escala empresarial.
Componentes clave de la monitorización del data warehouse
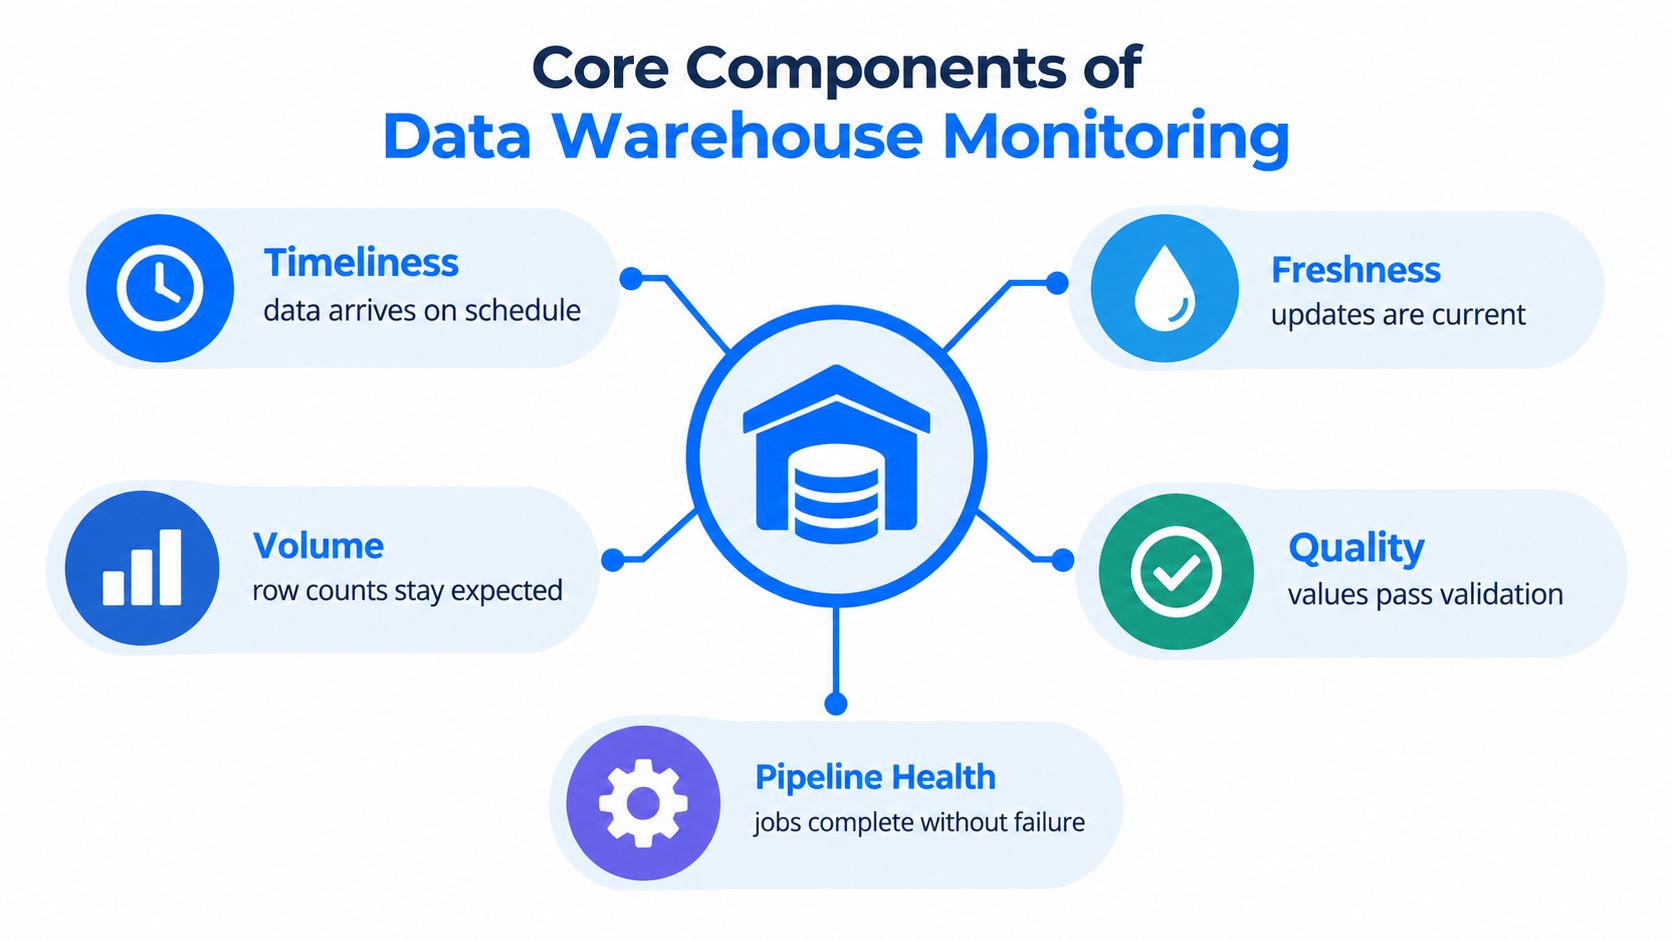
La monitorización solo funciona cuando cubre las capas de riesgo adecuadas. Un warehouse puede cargarse a tiempo y aun así contener registros erróneos. También puede parecer actualizado mientras un cambio en un campo rompe silenciosamente los modelos downstream. Una monitorización sólida conecta estos modos de fallo en lugar de tratarlos como herramientas separadas.
Puntualidad y frescura están relacionadas, pero no son lo mismo
La monitorización de la puntualidad comprueba si las actualizaciones llegan cuando se espera. La prueba práctica es sencilla: comparar el momento real de la actualización con una planificación o un SLA y alertar cuando la diferencia es demasiado grande. Un ejemplo habitual es una tabla horaria que genera una alerta cuando el intervalo entre actualizaciones supera aproximadamente las 2 horas guía sobre monitorización de la puntualidad.
La frescura es la antigüedad del registro más reciente. La puntualidad pregunta si la carga se produjo a tiempo. La frescura pregunta cuán actuales son los datos en este momento. Los equipos suelen confundir ambos conceptos, y eso genera una falsa sensación de seguridad. Un job puede ejecutarse según lo previsto y aun así cargar registros antiguos. Un job retrasado puede seguir produciendo datos actuales una vez que llega.
La monitorización de esquema y calidad detecta los fallos más silenciosos
El schema drift es una de las formas más fáciles de romper a los consumidores downstream sin un incidente evidente. Los cambios estructurales, como columnas añadidas o eliminadas, cambios de tipo, campos renombrados y cambios en restricciones, pueden romper dashboards, data marts y modelos sin previo aviso si no se detectan y comunican. Para los equipos que necesitan una referencia práctica, las buenas prácticas de data warehouse de digna son un buen punto de partida para pensar en el control de cambios de la estructura del warehouse. El objetivo no es solo detectar el cambio, sino asegurarse de que los responsables downstream sepan qué ha cambiado antes de desplegar supuestos rotos.
La monitorización de la calidad opera a nivel de registro. Debe validar los datos frente a las reglas de negocio e incluir comprobaciones de completitud, exactitud, coherencia y puntualidad guía sobre incidentes de calidad de datos. Las recomendaciones independientes también aconsejan umbrales medibles, como valores nulos por debajo del 0,1% y IDs de cliente duplicados iguales a 0 al mes, para que la calidad no quede en algo subjetivo.
Cuando la monitorización es vaga, los equipos discuten sobre la gravedad. Cuando es medible, pueden actuar.
El rendimiento y la salud de los pipelines mantienen el sistema utilizable
La monitorización del rendimiento es la parte que muchos equipos posponen hasta que los usuarios se quejan. Vigila el consumo de recursos, la latencia de las consultas y el throughput para que el warehouse no se vuelva tan lento que, en la práctica, deje de funcionar. Esto importa porque un warehouse que técnicamente funciona pero responde demasiado despacio sigue fallándole al negocio.
La salud de los pipelines conecta todas las demás señales. Si los jobs fallan, se reintentan sin fin o empiezan a tardar más sin que nadie lo note, todas las demás capas se vuelven más ruidosas. Los equipos que monitorizan la salud de los pipelines junto con la calidad y la frescura de los datos reciben avisos antes y se echan menos culpas entre los equipos de plataforma y de analítica.
Para los equipos que necesitan un modelo operativo práctico y no una teoría, el enfoque de integración con data warehouses de digna muestra cómo la monitorización puede situarse junto al warehouse en lugar de añadirse como un sistema aparte.
Reglas tradicionales frente a observabilidad basada en IA
Las reglas estáticas siguen siendo importantes, pero por sí solas no bastan. Los umbrales codificados de forma fija son buenos para detectar modos de fallo conocidos, sobre todo cuando la regla de negocio es clara y la tolerancia es fija. Tienen dificultades cuando los datos cambian de forma, los patrones se desvían o las anomalías aparecen de maneras que nadie había previsto.
Qué hacen bien las reglas estáticas y dónde fallan
La monitorización basada en reglas es sencilla. Si un job se ejecuta tarde, si los nulos superan un umbral o si desaparece una columna crítica, se dispara la alerta. Eso la hace fácil de explicar, fácil de auditar y útil para las comprobaciones exigidas por el cumplimiento normativo.
El inconveniente es el mantenimiento. Cada nuevo conjunto de datos, caso límite o regla de negocio añade otro umbral que ajustar. En entornos grandes, el volumen de alertas se convierte en un problema en sí mismo, porque la gente deja de confiar en las notificaciones cuando demasiadas son rutinarias o de poco valor.
Cómo cambia la carga de trabajo la observabilidad basada en IA
La observabilidad basada en IA sigue otro camino. En lugar de pedir a los ingenieros que definan cada umbral de antemano, aprende el comportamiento de referencia de cada conjunto de datos y señala las desviaciones respecto a ese patrón esperado. Eso la hace útil para detectar derivas, anomalías sutiles y situaciones que no encajan en una regla limpia.
El compromiso es la madurez. Los métodos basados en IA necesitan suficiente histórico para aprender y siguen requiriendo ajustes cuando cambian los patrones de uso. Rinden mejor cuando se combinan con reglas específicas para la lógica de negocio conocida, mientras la capa de IA se encarga de la detección amplia de anomalías y de la priorización.
Una forma útil de verlo es la siguiente.
Ámbito | Reglas estáticas | Observabilidad basada en IA |
|---|---|---|
Detección | Modos de fallo conocidos | Derivas y anomalías inesperadas |
Ruido | Pueden ser precisas, pero generan ruido a escala | Puede reducir la proliferación de umbrales manuales, pero sigue necesitando ajustes |
Mantenimiento | Mantenimiento continuo de reglas | Gestión de referencias y ajuste de modelos |
Para un contexto operativo más amplio, las tendencias en monitorización del rendimiento de TI ofrecen un paralelismo útil sobre cómo los equipos de monitorización reducen el ruido sin perder de vista las señales relevantes.
Las mejores configuraciones en producción suelen combinar ambos enfoques. Use reglas deterministas para los controles que nunca pueden ser ambiguos y añada encima la detección basada en IA allí donde el warehouse se comporta más como un sistema vivo que como una lista de comprobación fija. Para los equipos que evalúan métodos, la comparativa de digna entre las comprobaciones de calidad basadas en IA y los métodos tradicionales es una referencia práctica.
Métricas clave que todo equipo debería monitorizar
Un programa de monitorización se vuelve real cuando mide métricas sobre las que se puede actuar. No se trata de medirlo todo. Se trata de medir lo que indica si el warehouse está alimentando correctamente al negocio.
Empiece por la puntualidad, la calidad y el rendimiento
Las métricas de puntualidad comparan el momento real de actualización con la planificación o el SLA esperados. Si un proceso batch debe ejecutarse a diario, necesita un umbral claro de qué retraso justifica una alerta. El umbral exacto depende del negocio, pero lo importante es que el equipo lo acuerde de antemano, no después de un incidente.
Las métricas de calidad convierten las reglas de negocio en comprobaciones. Úselas para validar la completitud, la exactitud, la coherencia y la puntualidad a nivel de fila guía sobre monitorización de la calidad. Cuando los umbrales son medibles, los equipos pueden decidir si una degradación es aceptable, temporal o un incidente real que requiere triaje.
Las métricas de rendimiento deben incluir el tiempo de respuesta de las consultas, el throughput de los pipelines y el uso de recursos. Las consultas lentas y los pipelines sobrecargados suelen ser la primera señal de que el warehouse está bajo presión, sobre todo en periodos de reporting intenso o tras el lanzamiento de un nuevo modelo.
No se quede en la salud técnica
Las métricas de negocio importan porque revelan problemas que las comprobaciones técnicas pasan por alto. Los ingresos, el número de transacciones, la actividad de los clientes y otros KPI operativos pueden poner de manifiesto un problema del warehouse más rápido que una página de estado de jobs. Si una métrica de negocio clave cambia de repente sin que haya cambiado nada fuera, el warehouse merece un examen.
Por eso también la frescura y la puntualidad deben tratarse por separado. Una tabla puede actualizarse según lo previsto y aun así contener valores de origen desactualizados, o puede contener valores frescos tras un retraso que los usuarios no pueden tolerar. Ambas situaciones son señales útiles, pero apuntan a causas raíz distintas.
Una buena monitorización no solo pregunta si los datos existen. Pregunta si el negocio puede confiar en ellos.
Para los equipos que quieren definir estas señales de forma más estructurada, la guía de digna sobre métricas de puntualidad de los datos es una referencia práctica. Ayuda a conectar las expectativas basadas en la planificación con la realidad operativa de la entrega de datos en el warehouse.
Un conjunto de métricas limpio también mantiene honesta la revisión de incidentes. Si el equipo puede ver juntos la puntualidad, la calidad y el impacto en el negocio, resulta mucho más fácil distinguir un problema de carga de un problema de modelado o de un cambio real en el negocio.
Patrones de implementación para la monitorización empresarial
La monitorización empresarial fracasa cuando crea más sistemas que gestionar que problemas evita. El patrón de despliegue más sólido mantiene las comprobaciones cerca de los datos, conserva la información sensible dentro del entorno del cliente y hace que las alertas sean comprensibles para los equipos que deben actuar.
La ejecución in-database es la opción operativa más segura por defecto
Ejecutar las comprobaciones dentro de las propias bases de datos del cliente reduce el movimiento de datos y se ajusta mejor a los requisitos de seguridad y gobierno que exportarlo todo a sistemas externos. Esto importa en entornos regulados, pero también en empresas corrientes que no quieren mover datos sensibles del warehouse para monitorizarlos.
Aquí importa más el diseño que la marca. Un modelo in-database permite que la capa de monitorización inspeccione los datos donde residen y, al mismo tiempo, genere alertas, tendencias y actualizaciones de estado visibles para las personas adecuadas. En la práctica, eso suele significar menos fricción con los equipos de seguridad y menos sorpresas durante las revisiones.
Las alertas centralizadas necesitan contexto, no solo rapidez
Las alertas unificadas solo funcionan si cada notificación está vinculada al responsable adecuado y a la vía de respuesta correcta. Un flujo de incidentes ruidoso no ayuda si el mismo mensaje llega a cinco canales y nadie sabe quién debe arreglarlo. El sistema de monitorización tiene que enrutar por conjunto de datos, dominio o tipo de fallo para que la persona adecuada vea la señal adecuada.
Un patrón empresarial pragmático tiene este aspecto.
Comprobaciones in-database: mantener los cálculos junto al warehouse para reducir el movimiento de datos y simplificar el gobierno.
Acceso basado en roles: limitar quién puede ver los detalles sensibles de los incidentes.
Encaje operativo: integrarse con las herramientas de orquestación y comunicación que el equipo ya utiliza.
Visibilidad compartida: mostrar la misma señal a ingenieros, analistas y usuarios de negocio sin obligarlos a manejar versiones distintas de la verdad.
Para los equipos que evalúan herramientas compatibles con este modelo, la visión general de monitorización y reporting de digna resulta relevante porque muestra cómo las alertas y el reporting pueden funcionar sobre comprobaciones nativas del warehouse sin convertirse en un problema de copias de datos separadas.
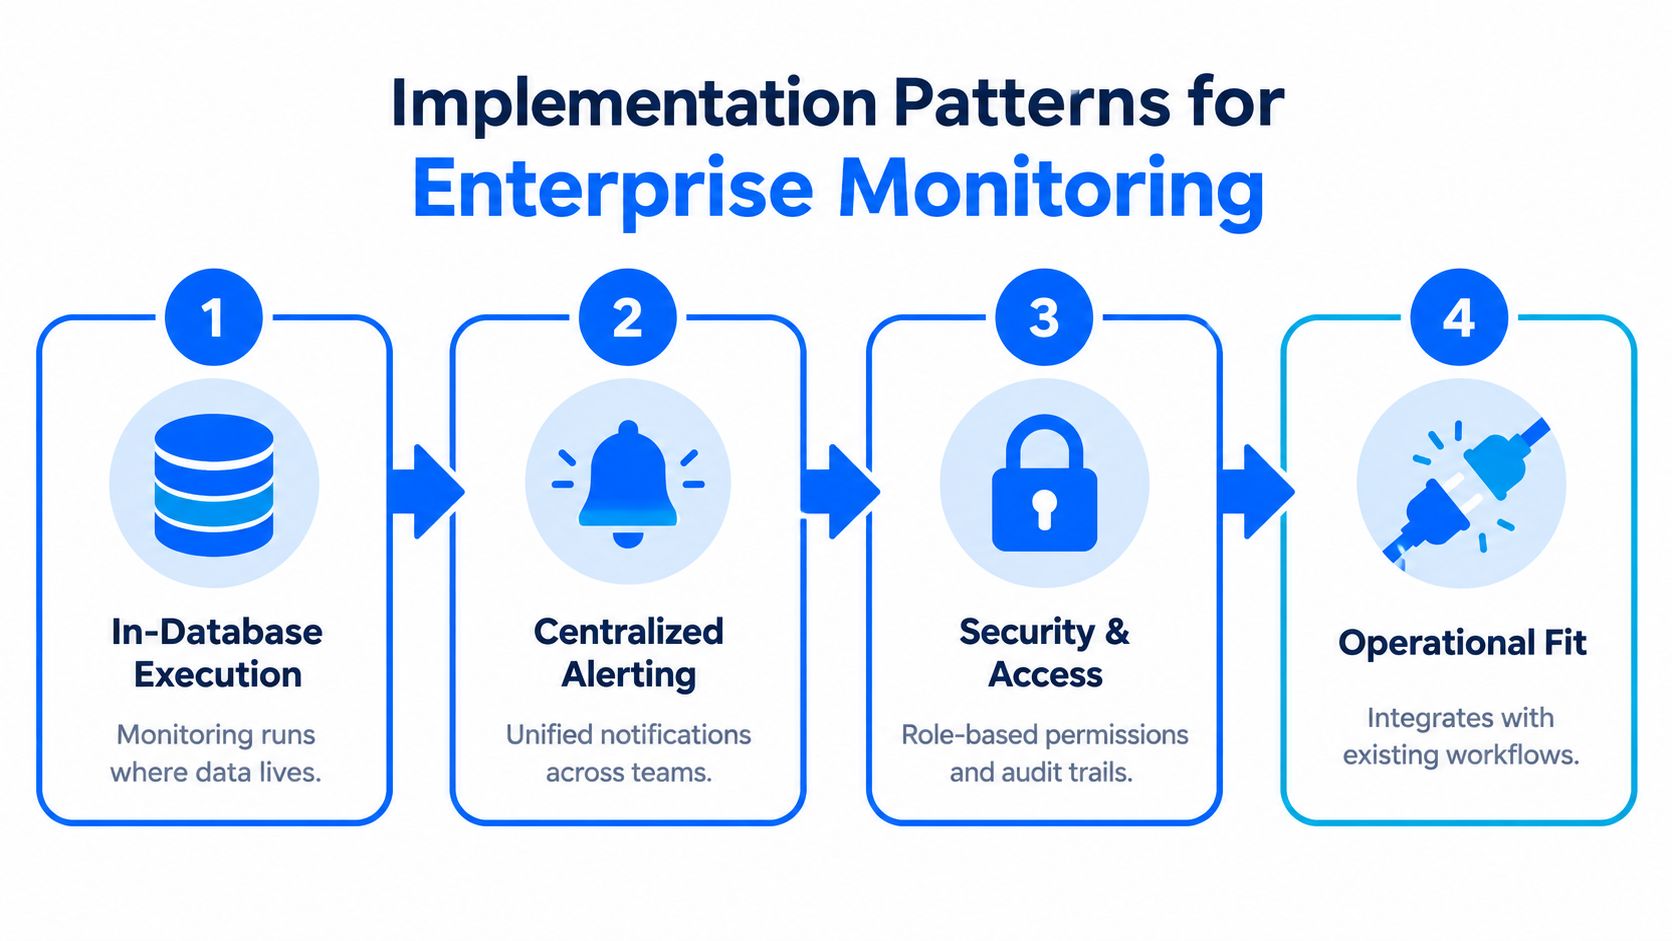
El objetivo es el encaje operativo. Si la capa de monitorización interrumpe todos los flujos de trabajo, no sobrevivirá al contacto con producción. Si se adapta a la forma en que ya trabaja el equipo del warehouse, pasa a formar parte del plano de control en lugar de ser otro dashboard que nadie revisa.
Construir una cultura de monitorización para el éxito a largo plazo
Las herramientas de monitorización no generan fiabilidad por sí solas. La generan los equipos. Las organizaciones que lo hacen bien tratan la observabilidad como parte de las operaciones de datos, no como una tarea de configuración puntual que se encarga a ingeniería después de un incidente.
La responsabilidad y la respuesta deben ser explícitas
Cada dominio de datos necesita un responsable claro y cada tipo de alerta necesita una vía de respuesta conocida. Si llega un cambio de esquema, el analytics engineer debe saber si tiene que actualizar un modelo, avisar al responsable de un dashboard o escalar al equipo de plataforma. Si falla una regla de calidad, alguien tiene que decidir si el problema está en los datos de origen, en una transformación defectuosa o en una regla de negocio que hay que revisar.
Los ciclos de retroalimentación importan igual. Cada incidente debería dejar algo útil: un umbral mejor, una regla más limpia o una referencia más precisa. Sin ese ciclo, los equipos simplemente repiten el mismo incendio con síntomas ligeramente distintos.
Revisar el ruido, formar a los usuarios y mantener vivo el programa
La revisión periódica es lo que mantiene sanos los buenos programas de monitorización. Los equipos deberían repasar qué alertas se dispararon, cuáles fueron útiles y cuáles conviene retirar o ajustar. Si nadie revisa nunca el conjunto de señales, la fatiga de alertas irá minando la confianza con el tiempo.
La formación es la otra mitad del trabajo. Ingenieros, analistas y usuarios de negocio necesitan entender qué significan las alertas y qué acción deben tomar. Una plataforma de monitorización solo funciona cuando las personas pueden interpretarla sin necesidad de una reunión cada vez que algo cambia.
Un warehouse es fiable cuando el equipo puede explicar sus fallos con rapidez e impedir que el mismo fallo se repita.
Por eso la observabilidad se ha convertido en un requisito previo para una analítica y una IA fiables. Un modelo solo es tan fiable como los datos que lo alimentan, y un dashboard solo es tan útil como el pipeline que lo respalda. Las organizaciones que construyen una cultura de monitorización no solo reducen las caídas, sino que toman decisiones más rápido porque menos de esas decisiones requieren antes una comprobación manual de los datos.
Para los equipos que quieren reforzar la calidad de los datos, la frescura, el seguimiento de esquemas y la monitorización del negocio en un único modelo operativo, digna ofrece una plataforma de observabilidad in-database que se integra en el propio entorno del cliente. Visítela si busca una forma práctica de monitorizar el comportamiento del warehouse sin exportar datos sensibles fuera de su stack.
Para ver cómo funcionan las comprobaciones de puntualidad descritas aquí sin planificaciones configuradas a mano para cada tabla, el módulo Timeliness de digna aprende el patrón de llegada habitual de cada tabla y alerta cuando una carga se retrasa o falta.
Preguntas frecuentes
¿Qué es la monitorización del data warehouse?
Es la comprobación continua de un warehouse para detectar cargas tardías, datos desactualizados, cambios de esquema, degradación de la calidad y rendimiento lento, de modo que los problemas se identifiquen antes de que los usuarios de negocio actúen con cifras erróneas. Los programas maduros también vigilan los KPI de negocio, porque un cambio repentino en una métrica suele ser lo primero que delata un problema en un pipeline.
¿Cuál es la diferencia entre la puntualidad y la frescura de los datos?
La puntualidad pregunta si una carga llegó cuando se esperaba según su planificación o SLA. La frescura pregunta qué antigüedad tiene ahora mismo el registro más reciente. Un job puede ejecutarse a tiempo y aun así cargar registros antiguos, y un job retrasado puede entregar datos actuales, por lo que cada una necesita su propia comprobación.
¿Qué métricas debería seguir un programa de monitorización del data warehouse?
Empiece por la puntualidad frente a la planificación esperada, la calidad a nivel de registro en cuanto a completitud, exactitud y coherencia, y el rendimiento, como el tiempo de respuesta de las consultas, el throughput de los pipelines y el uso de recursos. Añada métricas de negocio como los ingresos o el número de transacciones, ya que revelan problemas que las comprobaciones técnicas pasan por alto.
¿Son mejores las comprobaciones de anomalías basadas en IA que las reglas estáticas?
Ninguna basta por sí sola. Las reglas estáticas son adecuadas para modos de fallo conocidos y comprobaciones de cumplimiento porque son fáciles de explicar y auditar, pero su mantenimiento se encarece a escala. Las comprobaciones basadas en IA aprenden la referencia de cada conjunto de datos y detectan derivas inesperadas, por lo que las configuraciones en producción suelen combinar ambas.
¿Por qué ejecutar la monitorización del data warehouse dentro de la base de datos?
La ejecución in-database mantiene las comprobaciones junto a los datos, de modo que los registros sensibles nunca tienen que exportarse a un sistema de monitorización externo. Esto reduce el movimiento de datos, se ajusta a los requisitos de seguridad y gobierno de los sectores regulados y suele implicar menos fricción en las revisiones de seguridad, sin dejar de generar alertas y tendencias.



