10 métodos de control de calidad de datos que funcionan
|
9
minuto de lectura

Un único conjunto de reglas no protege un entorno de datos moderno. Los controles deterministas detectan registros no válidos, pero no necesariamente una caída de volumen que parece legítima. Un umbral estático puede marcar un pico estacional como incidente, mientras que un monitor de entregas puede identificar una carga ausente sin explicar si los registros que sí llegaron son válidos. Los controles estructurales, las señales de comportamiento, las métricas de negocio, la telemetría de la plataforma y la colaboración humana ponen al descubierto, cada uno, un modo de fallo distinto.
La respuesta práctica no consiste en elegir entre testing y observabilidad. Los equipos necesitan capas de control complementarias que trabajen juntas en la ingesta, la transformación, el almacenamiento y el consumo. Ese principio sigue la evolución general del control de calidad, desde los gráficos de control de Walter A. Shewhart de 1924, que separaban la variación normal de la variación por causas especiales, hasta los métodos modernos que miden dimensiones como la completitud, la puntualidad y la consistencia. La historia del control estadístico de calidad muestra por qué un comportamiento anómalo merece una investigación, mientras que las dimensiones de calidad de datos ofrecen un lenguaje para describir qué significa “bueno”.
Los 10 métodos de control de calidad de datos que siguen están organizados como un stack de controles. Empiece con reglas explícitas, añada señales aprendidas y estadísticas, supervise la entrega y la estructura, proteja los datos sensibles con la arquitectura adecuada y, después, conecte los incidentes técnicos con el impacto en el negocio y los flujos de trabajo del equipo. Para una aplicación práctica, consulte esta guía para validar datos de pipelines de redes sociales.
Índice
2. Validación de datos a nivel de registro frente a reglas de negocio
3. Monitorización de Timeliness y llegada de datos con cálculo del tiempo de entrega esperado
4. Detección de cambios de schema y monitorización estructural
5. Análisis estadístico y de tendencias de las métricas de datos
6. Cálculo y análisis de métricas dentro de la base de datos
8. Observabilidad de la plataforma de datos y de las cargas de trabajo
9. Dashboards completos de observabilidad de datos y monitorización colaborativa
10. Arquitectura modular de control de calidad con despliegue rápido
Comparativa en 10 puntos: métodos de control de calidad de datos
1. Detección de anomalías con IA y aprendizaje de baseline
La detección de anomalías con IA busca comportamientos que se apartan del patrón normal de un conjunto de datos. En lugar de obligar a los ingenieros a escribir un umbral para cada tabla, el sistema aprende una baseline a partir del volumen histórico, las distribuciones, las categorías u otras métricas de observabilidad. Esto la hace útil para conjuntos de datos con estacionalidad, crecimiento, demanda irregular o relaciones demasiado complejas para una regla fija.
El módulo Data Anomalies de digna está diseñado para este tipo de monitorización. En un entorno financiero, una caída inesperada del volumen de transacciones puede aparecer antes de que falle una conciliación. En el sector sanitario, un patrón inusual de ingresos de pacientes o una distribución anómala de resultados de laboratorio puede justificar una investigación. En telecomunicaciones, un cambio en el tráfico de red puede indicar una degradación del servicio o un uso inusual. Son señales de detección, no una prueba automática de un problema de negocio, por lo que un responsable sigue teniendo que validar la causa.
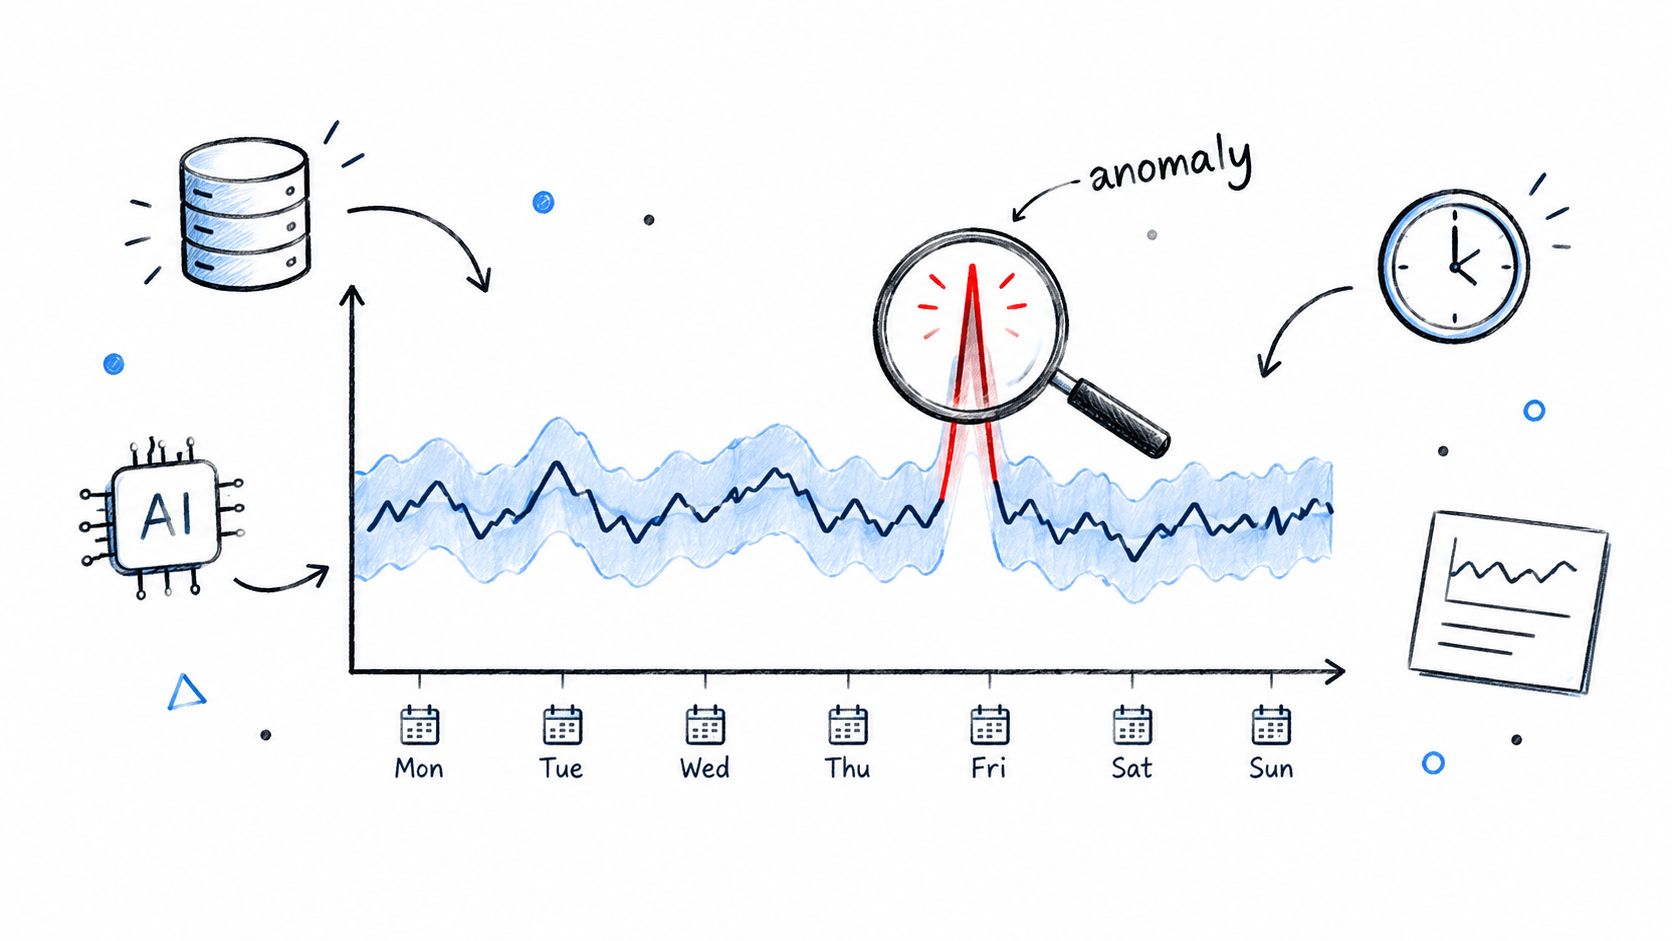
Haga que la baseline sea explicable
Reúna suficiente histórico representativo antes de tratar las alertas como accionables. Un nuevo conjunto de datos, una adquisición, el lanzamiento de un producto o la migración de una fuente pueden hacer que una baseline antigua resulte engañosa. Añada contexto de negocio, como eventos del calendario, campañas planificadas y responsables de cada fuente, y revise las primeras alertas con expertos del dominio para ajustar la sensibilidad.
Regla práctica: use la detección de anomalías para encontrar lo que ninguna regla preveía y, después, use la validación determinista para demostrar qué ha fallado.
La detección de anomalías para datos categóricos de digna es especialmente relevante cuando un cambio en la mezcla de categorías importa más que un simple recuento de filas. Los equipos pueden combinar este enfoque con Wisely AI solutions cuando necesitan un apoyo más amplio en la implantación de IA.
2. Validación de datos a nivel de registro frente a reglas de negocio
La validación a nivel de registro responde a una pregunta precisa: ¿cumple esta fila las reglas que la hacen utilizable? Comprueba cada registro frente a campos obligatorios, valores aceptados, rangos, formatos, relaciones y lógica de negocio. A diferencia de una señal de anomalía agregada, puede identificar exactamente el registro, la regla y el resultado que requieren corrección.
Entre los tipos de reglas habituales están los controles de no nulo, unicidad, tipo de dato, rango, formato, integridad referencial y lógica de negocio. Las guías de validación de datos describen cómo los equipos aplican estos controles mediante restricciones de base de datos, validación de schema y pruebas automatizadas. Una entidad financiera puede validar límites de transacción y requisitos de contraparte. Un sistema sanitario puede comprobar identificadores de pacientes y códigos de diagnóstico. Un organismo público puede verificar datos de licencias o campos de elegibilidad para prestaciones.
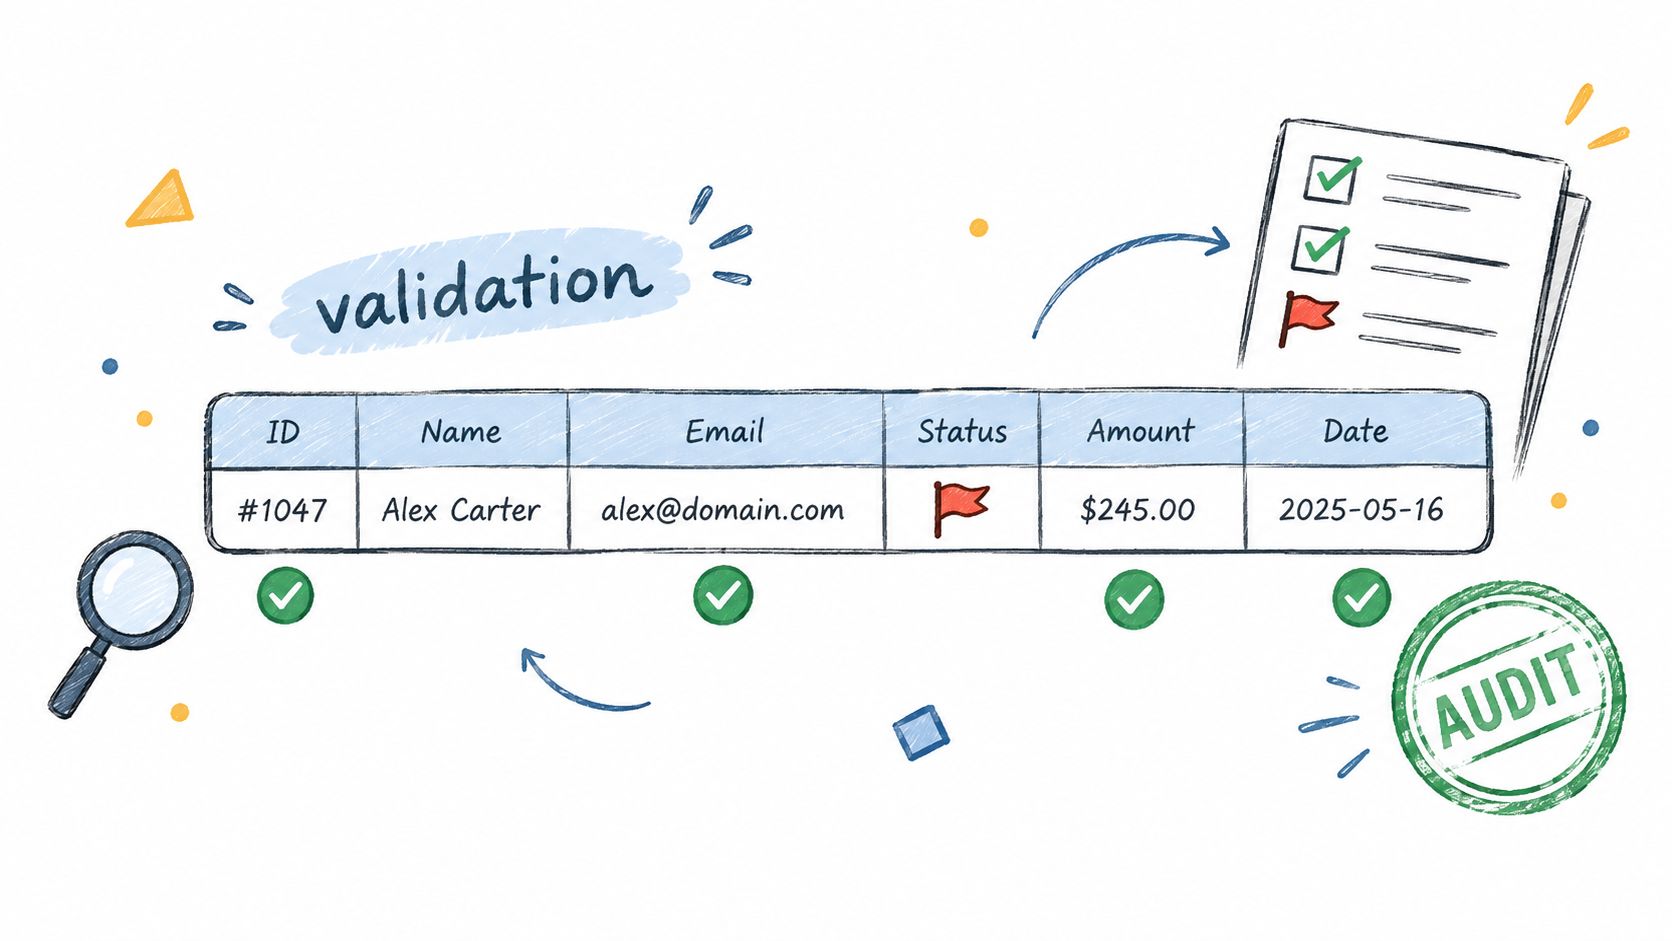
Haga que los fallos sean trazables
No empiece validando todos los campos por igual. Priorice los registros que afectan a los informes regulatorios, los pagos, las decisiones clínicas, la identidad del cliente o los KPI de dirección. Los responsables de negocio deben definir qué significa “válido”, porque un valor técnicamente aceptable puede seguir incumpliendo una política operativa.
Versione las reglas y conserve las evidencias de cada resultado, correcto o fallido. Así los ingenieros pueden distinguir un defecto de origen de un cambio de política deliberado, y los equipos de gobierno disponen de una pista de auditoría.
Las reglas de validación de datos y la calidad de datos continua de digna admiten lógica de validación personalizada con ejecución dentro de la base de datos y resultados de reglas trazables. La contrapartida es el mantenimiento. Las reglas son fiables para condiciones conocidas, pero no detectarán un cambio desconocido a menos que alguien lo exprese como regla o combine la validación con la detección de anomalías.
3. Monitorización de Timeliness y llegada de datos con cálculo del tiempo de entrega esperado
Un conjunto de datos puede ser completo y válido y, aun así, resultar inservible porque llegó demasiado tarde. La monitorización de la puntualidad compara las llegadas reales con el comportamiento de entrega esperado e identifica cargas retrasadas, ficheros ausentes, llegadas anticipadas y el deterioro gradual del rendimiento de las fuentes. Protege los dashboards, los modelos downstream, las conciliaciones y los flujos operativos que dependen de que los datos estén disponibles en un momento concreto.
Un equipo bancario puede usar un monitor de puntualidad para detectar un batch nocturno ausente antes de los informes de la mañana. Una organización sanitaria puede investigar información de pacientes que llega con retraso antes de que afecte a la coordinación. Un operador de telecomunicaciones puede comprobar si los datos de uso o facturación llegan a su destino dentro de la ventana prevista. El módulo Timeliness de digna calcula el tiempo de entrega esperado a partir de patrones observados, en lugar de tratar todas las fuentes como si siguieran el mismo calendario.
Distinga el retraso de la ausencia
Un único monitor no debería cubrir fuentes con ritmos de entrega distintos. Defina expectativas por fuente, tabla o carga de trabajo y conecte las alertas con el proceso de gestión de incidentes y de guardias. Una alerta que se queda en un dashboard sin responsable no es más que un mecanismo de descubrimiento tardío.
Combine la monitorización de llegadas con la monitorización de volumen. Un fichero que llega a tiempo pero sin registros es un fallo distinto de uno que contiene el volumen esperado pero llega tarde. Siga también el patrón de entrega a lo largo del tiempo, porque un pipeline que se retrasa poco a poco puede necesitar atención antes de incumplir un plazo formal.
La definición de puntualidad de los datos y la guía para monitorizarla ofrecen un marco útil para distinguir frescura, expectativas de entrega y respuesta operativa. La principal contrapartida es el rigor de las alertas. Las ventanas fijas son fáciles de explicar, mientras que las expectativas aprendidas se adaptan mejor a la operación real, pero hay que revisarlas cuando cambian los calendarios.
4. Detección de cambios de schema y monitorización estructural
El schema drift provoca fallos que los controles a nivel de fila quizá nunca vean. Un proveedor puede añadir un campo, eliminar una columna, cambiar un tipo de dato o modificar una restricción y seguir enviando registros que, uno por uno, parecen plausibles. Las transformaciones, los informes y los modelos downstream pueden entonces fallar de forma visible o, peor aún, seguir funcionando con una interpretación distinta.
La monitorización de schema compara la estructura entrante con una baseline contractual aprobada. Puede cuantificar el cambio mediante medidas como la tasa de discrepancia de columnas o una puntuación compuesta de similitud de schema, lo que permite usar los cambios estructurales para alertas automatizadas. Las métricas de schema drift describen este enfoque, que mide la desviación estructural en lugar de tratar todos los cambios como igual de graves.
Respalde la alerta con su impacto
Una columna opcional añadida puede suponer un riesgo bajo. Un identificador eliminado o un cambio de tipo en un feed regulatorio puede exigir una parada inmediata. Documente las dependencias entre tablas para que la alerta identifique los jobs ETL, modelos semánticos, dashboards y productos de datos afectados, en lugar de mandar a los ingenieros a investigar a ciegas.
La explicación del schema drift de digna describe el riesgo operativo de los cambios estructurales no anunciados. Su Schema Tracker detecta columnas añadidas o eliminadas y modificaciones de tipos de datos. Combine la detección con un proceso de aprobación de cambios y pruebas de compatibilidad automatizadas. La monitorización por sí sola le dice que la estructura ha cambiado. El gobierno del dato determina si el cambio se permite, se pone en cuarentena o se escala.
5. Análisis estadístico y de tendencias de las métricas de datos
El análisis estadístico examina cómo se comportan las métricas de calidad y de negocio a lo largo del tiempo. Puede revelar derivas graduales, cambios en la volatilidad, distribuciones inusuales y patrones que una única regla de aprobado o suspenso pasa por alto. Las medias móviles, el análisis de desviación estándar y la descomposición de tendencias son opciones útiles, pero el método debe ajustarse a la métrica. Una medida continua, una distribución categórica y un recuento de eventos no tienen el mismo comportamiento estadístico.
Un equipo de finanzas puede analizar la volatilidad de los ingresos, mientras que una organización sanitaria estudia las tasas de ingreso, los volúmenes de tratamiento o los indicadores de resultados. Un equipo de telecomunicaciones puede vigilar un aumento gradual de las llamadas abandonadas o un cambio en el patrón de churn. El módulo Data Analytics de digna está pensado para el análisis histórico de métricas de observabilidad y del comportamiento del negocio, y ayuda a los equipos a averiguar si un cambio es aislado o forma parte de una tendencia.
Use un histórico representativo
Una baseline construida a partir de un periodo anómalo puede llevar a conclusiones erróneas. Excluya caídas conocidas, migraciones y eventos excepcionales cuando no representen el funcionamiento normal, o anótelos para que los analistas puedan interpretar correctamente el resultado. El conocimiento del dominio sigue siendo imprescindible, porque lo estadísticamente inusual no equivale a lo incorrecto desde el punto de vista del negocio.
Para las alertas de anomalías, los intervalos de confianza y las reglas de desviación móvil pueden ofrecer límites más defendibles que unos límites fijos arbitrarios. Un enfoque documentado genera una alerta cuando una métrica sale del intervalo de confianza del 99 % para el mismo día del año anterior, o cuando supera las 3 desviaciones estándar respecto a una media móvil. Los ejemplos de detección estadística de anomalías ilustran estas técnicas.
La contrapartida es la interpretabilidad. Los métodos estadísticos detectan patrones con eficiencia, pero los equipos necesitan explicaciones claras y contexto de los eventos antes de bloquear un pipeline o escalar a la dirección. Consulte el análisis de tendencias de datos de digna para un enfoque analítico relacionado.
6. Cálculo y análisis de métricas dentro de la base de datos
La monitorización de la calidad no exige exportar datos de producción a un servicio externo. La ejecución dentro de la base de datos calcula métricas, ejecuta controles y realiza análisis en el propio data warehouse, data lake o base de datos del cliente. Esta arquitectura reduce el movimiento de datos y facilita cumplir los requisitos de gobierno que obligan a mantener los registros sensibles dentro de la infraestructura de la organización.
Una entidad financiera puede ejecutar validaciones de cumplimiento sobre datos regulados sin copiarlos a otro lugar. Una organización sanitaria puede evaluar la calidad de los datos de pacientes manteniendo la información protegida en su entorno controlado. digna ejecuta controles de anomalías, validación, puntualidad y otros relacionados dentro de las bases de datos del cliente, de modo que la capa de monitorización puede inspeccionar los datos sin apropiarse de los registros subyacentes.
Proteja tanto el rendimiento como la privacidad
La ejecución dentro de la base de datos traslada responsabilidad al entorno de base de datos. Las consultas de monitorización necesitan permisos adecuados, preferiblemente de solo lectura, y deben diseñarse para que los controles de calidad no compitan con las cargas de trabajo de producción. Programe el profiling costoso o el análisis histórico en periodos de menor demanda y mida el tiempo de ejecución de las consultas y el uso de recursos como parte del diseño de la monitorización.
Mantener los datos donde están reduce la exposición, pero no elimina la necesidad de control de acceso, gobierno de consultas y pruebas de rendimiento.
La contrapartida es la portabilidad y la complejidad operativa. Un control que funciona bien en un data warehouse puede necesitar optimización en otro, sobre todo cuando difieren el tamaño de las tablas, el particionado o los patrones de carga. Los equipos deben probar los planes de consulta, usar cálculo incremental cuando proceda y monitorizar la propia carga de la monitorización.
7. Monitorización de KPI de negocio y métricas operativas
Las señales técnicas de calidad importan porque afectan a las decisiones y a las operaciones. La monitorización de negocio conecta los datos subyacentes con métricas como ingresos, volumen de transacciones, actividad de clientes, conversión, resultados de tratamientos, churn o disponibilidad de la red. Un cambio inesperado en un KPI puede revelar un problema de datos antes de que un responsable técnico detecte una prueba fallida, mientras que un pipeline técnicamente sano puede producir un resultado de negocio que requiera investigación.
Un equipo financiero puede observar un cambio inesperado en los ingresos o en el volumen de transacciones. Un proveedor sanitario puede monitorizar los volúmenes de ingresos hospitalarios y los resultados operativos. Un operador de telecomunicaciones puede seguir el churn, el ingreso medio por usuario o la disponibilidad de la red. Esto no son automáticamente defectos de datos. Un evento real del mercado puede producir un movimiento real del KPI, por eso la monitorización de negocio debe iniciar una investigación, no declarar una causa.
Acuerde la escalada antes de la alerta
Elija las métricas más críticas para la toma de decisiones y defina con sus responsables el comportamiento esperado. Deje constancia de quién recibe una alerta, qué evidencias necesita y cuándo el problema pasa a ser un incidente de negocio. Si el KPI se mueve, rastréelo hacia atrás a través de las señales de frescura, volumen, schema, validación, fuente y plataforma.
Las métricas de negocio también sirven para priorizar. Un control fallido en una tabla de desarrollo sin uso no debería competir con un defecto menor que afecta a un informe regulatorio. La configuración más sólida vincula las anomalías de KPI con el linaje y el contexto técnico, de modo que analistas e ingenieros puedan investigar el mismo incidente desde perspectivas distintas.
Business Monitoring de digna combina el análisis de métricas de negocio y operativas con las señales de calidad más amplias que se necesitan para el análisis de causa raíz. La contrapartida práctica es la responsabilidad. Los equipos de negocio deben ayudar a definir el significado y la materialidad, o los ingenieros tendrán que adivinar qué cambios importan.
8. Observabilidad de la plataforma de datos y de las cargas de trabajo
Los controles sobre conjuntos de datos pueden mostrar que los datos son incorrectos. La observabilidad de la plataforma ayuda a explicar por qué. Vigila el comportamiento de las cargas de trabajo, el consumo de recursos, la disponibilidad, el rendimiento de las consultas, la duración de los jobs y los cambios en la infraestructura que mueve y almacena los datos. Esta visión a nivel de sistema detecta fallos que no son visibles en una tabla concreta.
Un job ETL puede tardar más porque un data warehouse está bajo presión. Un pico repentino de carga puede revelar pipelines duplicados o una transformación ineficiente. Un cambio en la plataforma puede afectar a muchos conjuntos de datos a la vez, aunque la última validación de cada tabla haya sido correcta. Estas señales ayudan a los equipos a distinguir un defecto de origen de un problema de capacidad, un cambio de configuración o un desequilibrio de cargas.
Correlacione las señales, no las mezcle
Establezca el comportamiento normal de la plataforma y, después, correlacione las desviaciones con los incidentes de calidad de datos. Si empiezan a saltar varias alertas de frescura tras un aumento del consumo de recursos, la telemetría de la plataforma puede orientar la investigación hacia la infraestructura. Si una fuente cambia mientras la salud de la plataforma se mantiene estable, la fuente o la transformación merecen más atención.
Mantenga separados los incidentes de plataforma y los defectos de datos. Una consulta lenta no implica automáticamente datos erróneos, y una tabla válida no demuestra que la plataforma esté sana. Separar las responsabilidades puede mejorar la respuesta, siempre que el sistema de incidentes conserve las relaciones entre carga de trabajo, pipeline, conjunto de datos e impacto en el negocio.
Data Platform Observability de digna monitoriza la salud de la plataforma, el comportamiento de las cargas de trabajo, el consumo, la disponibilidad y las señales relacionadas con el rendimiento. La contrapartida es la amplitud. Más telemetría puede generar más ruido, así que los equipos deben definir qué cambios de plataforma requieren acción inmediata y cuáles corresponden a la planificación de capacidad o a una revisión de ingeniería.
9. Dashboards completos de observabilidad de datos y monitorización colaborativa
Un control que solo un especialista sabe interpretar no escala en una organización de datos. La monitorización colaborativa reúne resultados de validación, señales de anomalías, puntualidad, cambios de schema, KPI, salud de la plataforma, responsables e historial de incidentes en vistas operativas compartidas. Los data engineers necesitan detalles técnicos, los analistas necesitan contexto de las métricas, los equipos de gobierno necesitan evidencias y la dirección necesita una visión concisa de la fiabilidad y del impacto.
El dashboard debe adaptarse a esas decisiones en lugar de mostrar por defecto todas las métricas disponibles. Un ingeniero puede necesitar la regla fallida, la partición de origen, la consulta y el linaje. Un analista puede necesitar el KPI afectado, el estado de frescura y la definición de negocio. Un responsable de gobierno puede necesitar el owner, el historial de resolución y la evidencia de que un control se ejecutó como se esperaba.
Reduzca la fatiga de alertas de forma deliberada
Agrupe las alertas relacionadas en incidentes, suprima los duplicados y muestre primero la señal de mayor valor. Añada vistas de detalle para la investigación, pero mantenga la pantalla principal centrada en lo que requiere acción. El feedback de los usuarios es en sí mismo un control operativo. Si los equipos descartan sistemáticamente una categoría de alertas, cambie el umbral, el enrutamiento o el diseño del control.
Integre el dashboard con las herramientas de comunicación y de gestión de incidentes del equipo. Asigne responsables a los conjuntos de datos y a las reglas, registre los pasos de corrección y conserve el rastro de decisiones. Así una capa de visualización se convierte en un sistema de colaboración.
digna ofrece un dashboard centrado en el usuario para ingenieros, analistas y stakeholders, con visibilidad compartida de incidentes, tendencias y estado. La contrapartida es el gobierno del propio dashboard. Sin definiciones y responsables claros, una vista centralizada puede convertirse en un catálogo saturado de señales sin resolver en lugar de una herramienta de decisión.
10. Arquitectura modular de control de calidad con despliegue rápido
El programa de calidad de datos más eficaz suele crecer por capas, en lugar de llegar como una gran implantación única. Una arquitectura modular permite a un equipo empezar por el modo de fallo que más daño causa, demostrar que el control funciona y añadir cobertura adyacente sin sustituir el modelo operativo. Una organización financiera podría empezar con validación y detección de anomalías y añadir después la monitorización de puntualidad y de schema. Un equipo sanitario podría comenzar con la gestión de la calidad y conectar más tarde las métricas de resultados clínicos. Un operador de telecomunicaciones podría implantar primero la observabilidad de la plataforma antes de ampliar a controles a nivel de registro.
Ordene los controles según el riesgo
Empiece con una evaluación de la calidad de los datos que identifique los conjuntos de datos críticos, sus consumidores, sus responsables y los incidentes conocidos. Elija el primer módulo en función de la evidencia, no de la funcionalidad más fácil de demostrar. Un problema de cargas ausentes requiere monitorización de puntualidad. Un feed de proveedor roto requiere seguimiento del schema. Un campo de elegibilidad incorrecto requiere validación a nivel de registro.
Planifique una hoja de ruta de ampliación a 6 a 12 meses, con hitos ligados a la cobertura y a la corrección, no solo a la instalación. Asegure el patrocinio del gobierno del dato, asigne capacidad interna de integración y use las plantillas sectoriales solo como punto de partida. Los primeros éxitos deben financiar una adopción más amplia, no quedarse en demostraciones aisladas.
Construya para la cobertura: añada controles que pongan al descubierto modos de fallo distintos, no tres versiones de la misma prueba.
La plataforma modular de digna incluye un scheduler, un catálogo de datos, integraciones y funciones de colaboración desde la selección del primer módulo. Entre sus opciones de despliegue están la nube privada y la instalación on-premises dentro de la nube, la VPC o el centro de datos del cliente. La contrapartida es la disciplina. Las licencias y el despliegue modulares pueden reducir la barrera de entrada, pero los equipos siguen necesitando un modelo de control compartido, responsables coherentes y una regla clara sobre cuándo una alerta se convierte en una tarea de corrección.
Comparativa en 10 puntos: métodos de control de calidad de datos
Método | Complejidad de implantación 🔄 | Recursos necesarios ⚡ | Resultados esperados 📊 | Casos de uso ideales 💡 | Ventajas clave ⭐ |
|---|---|---|---|---|---|
Detección de anomalías con IA y aprendizaje de baseline | Media a alta; requiere pipelines de ML y model ops | Media a alta; necesita datos históricos y capacidad de cómputo | Alto ⭐⭐⭐; detecta pronto desviaciones nuevas y sutiles | Series temporales complejas, métricas de negocio estacionales | Baselines adaptativas; menos falsos positivos |
Validación de datos a nivel de registro frente a reglas de negocio | Baja a media; redacción y mantenimiento de reglas | Bajos a medios; motor de reglas y aportación del negocio | Alto ⭐⭐⭐; aprobado/suspenso determinista con pistas de auditoría | Cumplimiento normativo, integridad transaccional | Incumplimientos trazables; objetivos de corrección precisos |
Monitorización de Timeliness y llegada de datos con cálculo del tiempo de entrega esperado | Baja a media; programación + aprendizaje de patrones | Medios; registros históricos de llegada e integración | Alto ⭐⭐⭐; detección rápida de cargas retrasadas/ausentes | Pipelines ETL, entregas de datos críticas para SLA | Alertas predictivas ante fallos de pipelines |
Detección de cambios de schema y monitorización estructural | Baja; seguimiento continuo del schema y mapeo | Bajos a medios; catálogo de metadatos y dependencias | Alto ⭐⭐⭐; evita fallos que rompen los sistemas downstream | Feeds de proveedores, jobs ETL, sistemas sensibles al schema | Alertas estructurales en tiempo real e historial de versiones |
Análisis estadístico y de tendencias de las métricas de datos | Media; modelos estadísticos e interpretación | Medios; métricas históricas y tiempo de analistas | Alto ⭐⭐⭐; información sobre tendencias y señales de alerta temprana | Métricas de negocio agregadas, detección de volatilidad | Visión estadística con contexto; detecta cambios graduales |
Cálculo y análisis de métricas dentro de la base de datos | Media; consultas y optimizaciones específicas de cada base de datos | Bajos a medios; aprovecha los recursos existentes de la base de datos | Alto ⭐⭐⭐; controles seguros en tiempo real con poco movimiento de datos | Entornos con datos sensibles, organizaciones centradas en el cumplimiento | Se preserva la residencia de los datos; menos movimiento de datos |
Monitorización de KPI de negocio y métricas operativas | Media; definición de KPI, mapeo y dashboards | Medios; aportación de stakeholders y herramientas de BI | Alto ⭐⭐⭐; vincula los problemas de datos con el impacto en el negocio | Dashboards de dirección, seguimiento de OKR, monitorización operativa | Conecta la calidad de datos con los resultados de negocio |
Observabilidad de la plataforma de datos y de las cargas de trabajo | Alta; integra telemetría de múltiples componentes | Altos; telemetría de plataforma, logs y herramientas | Alto ⭐⭐⭐; visión global de la salud y los costes de la plataforma | Operaciones de plataforma, planificación de capacidad, optimización de costes | Detecta problemas de infraestructura que afectan a muchos conjuntos de datos |
Dashboards completos de observabilidad de datos y monitorización colaborativa | Media a alta; UX, vistas por rol e integraciones | Medios; adopción entre equipos y herramientas | Alto ⭐⭐⭐; respuesta más rápida a incidentes y mejor alineación | Equipos multifuncionales que necesitan un contexto compartido | Vista centralizada; reduce silos; información por rol |
Arquitectura modular de control de calidad con despliegue rápido | Baja a media al inicio; planificación de la ampliación modular | Bajos al inicio; escalan con los módulos (pago por tabla) | Alto ⭐⭐⭐; time-to-value rápido y despliegue iterativo | Adopción por fases, plantillas sectoriales, pilotos rápidos | Despliegue rápido; ampliación incremental; menor riesgo inicial |
Construya un stack de controles, no una checklist
Los métodos de control de calidad de datos adecuados dependen del fallo que necesite detectar. La validación de registros es la primera respuesta más sólida cuando el requisito es explícito, como un identificador no nulo, un valor permitido, un rango válido, una referencia coincidente o una regla de negocio que debe cumplirse en cada registro. Produce evidencias concretas y facilita una corrección dirigida, pero no puede reconocer todos los patrones desconocidos.
La detección de anomalías y el análisis estadístico cubren los cambios de comportamiento. El aprendizaje de baseline es útil cuando el comportamiento normal varía con la estacionalidad, el crecimiento o la mezcla de categorías. El análisis estadístico ayuda a los equipos a entender tendencias, volatilidad y cambios de distribución a lo largo del tiempo. Ninguno de los dos enfoques debería bloquear datos automáticamente sin contexto. Una campaña legítima, una adquisición, una migración o un evento operativo pueden parecer anómalos, por lo que los responsables necesitan una forma de explicar y aprobar los cambios esperados.
La monitorización de Timeliness aborda la fiabilidad de las entregas. Indica a los equipos que una fuente llegó tarde, llegó antes de tiempo o no llegó cuando se esperaba. Combínela con controles de volumen para distinguir una carga ausente de una carga vacía o parcial. El seguimiento del schema se ocupa de la deriva estructural, incluidas las columnas añadidas o eliminadas y los cambios de tipo de dato. La gravedad debería depender de las dependencias downstream. Una ampliación inofensiva y un cambio que rompe un identificador no deberían recibir la misma respuesta.
La arquitectura importa cuando el gobierno, la privacidad o las restricciones de residencia limitan el movimiento de datos. La ejecución dentro de la base de datos permite a los equipos calcular métricas y ejecutar controles donde ya residen los datos, aunque sigue exigiendo control de acceso, optimización de consultas y monitorización de las cargas de trabajo. El stack de controles también necesita contexto. La monitorización de negocio muestra si un cambio técnico afecta a los ingresos, las transacciones, las operaciones, los resultados clínicos u otra métrica de decisión. La observabilidad de la plataforma ayuda a identificar condiciones de recursos, carga, disponibilidad y rendimiento que pueden explicar el incidente.
La capa operativa determina si la detección se traduce en mejora. Asigne responsables a los conjuntos de datos críticos, documente las definiciones de negocio, conecte las alertas con la gestión de incidentes y conserve las evidencias de cada resultado junto con la versión de la regla que lo generó. Use controles de fallo duro para los incumplimientos que hacen inseguro el uso downstream, y alertas de anomalía suaves cuando sea necesario investigar antes de actuar. Fije umbrales de conformidad para los controles explícitos y use intervalos de confianza o baselines aprendidas cuando el comportamiento cambie con el tiempo.
Un despliegue sensato empieza por los conjuntos de datos críticos y no por todo el patrimonio de datos. Mapee sus consumidores y su historial de fallos, elija el primer control para la brecha de mayor riesgo y acuerde un responsable y una vía de respuesta antes de activar las alertas. Después, añada métodos complementarios, como validación con puntualidad, detección de anomalías con monitorización de schema y métricas de negocio con telemetría de la plataforma. digna puede respaldar ese enfoque modular con detección de anomalías, validación, Timeliness, seguimiento del schema, ejecución dentro de la base de datos, monitorización de negocio y observabilidad de la plataforma.
El programa debería ampliarse cuando los equipos puedan demostrar que los controles se ejecutan de forma constante, que los incidentes llegan al responsable adecuado y que la corrección mejora el proceso upstream. Así es como la calidad de datos se convierte en infraestructura operativa y no en una auditoría periódica o una larga checklist que nadie vuelve a revisar.
digna ofrece una plataforma empresarial de calidad y observabilidad de datos que se ejecuta dentro del entorno del cliente y combina validación, detección de anomalías, Timeliness y monitorización de schema, negocio y plataforma. Úsela para construir capas de control complementarias en torno a los conjuntos de datos críticos, explore la plataforma modular a través de digna y planifique su primer despliegue en torno al modo de fallo que más importa.
Si está decidiendo qué capa implantar primero, la solución de gestión de la calidad de datos de digna muestra cómo la validación, la detección de anomalías, Timeliness y el seguimiento del schema funcionan como módulos independientes dentro de su propia base de datos, de modo que puede empezar con un control y añadir el resto a medida que crece la cobertura.
Preguntas frecuentes
¿Cuáles son los principales métodos de control de calidad de datos?
Los principales métodos son la detección de anomalías, la validación a nivel de registro, la monitorización de la puntualidad, la detección de cambios de schema, el análisis estadístico de tendencias, el cálculo dentro de la base de datos, la monitorización de KPI, la observabilidad de la plataforma, los dashboards compartidos y un despliegue modular. Cada uno detecta un modo de fallo distinto, por eso el artículo recomienda combinarlos como capas complementarias en lugar de depender de un único conjunto de reglas.
¿Cuál es la diferencia entre la validación de datos y la detección de anomalías?
La validación demuestra que una fila concreta incumplió una regla conocida, mientras que la detección de anomalías señala comportamientos que se apartan de una baseline aprendida. Las reglas le dan el registro exacto y una pista de auditoría, pero no detectan cambios desconocidos, como una caída de volumen que parece legítima. El patrón práctico es encontrar lo inesperado con la detección de anomalías y después demostrar los fallos con la validación.
¿Cómo se fijan los umbrales para las alertas estadísticas de calidad de datos?
Use intervalos de confianza o reglas de desviación móvil en lugar de límites fijos arbitrarios. Un enfoque documentado genera una alerta cuando una métrica queda fuera del intervalo de confianza del 99 % para el mismo día del año anterior, o se aleja más de 3 desviaciones estándar de una media móvil. Antes, excluya del histórico de la baseline las caídas del sistema y las migraciones.
¿Por qué monitorizar la puntualidad de los datos si ya están validados?
Porque un conjunto de datos puede ser completo y válido y, aun así, inútil si llega después de que se genere el informe de la mañana. La monitorización de la puntualidad compara las llegadas reales con los tiempos de entrega esperados por fuente, y combinarla con controles de volumen permite distinguir un fichero que llega tarde de uno que llegó a tiempo pero vacío.
¿Por dónde debe empezar un equipo al implantar controles de calidad de datos?
Empiece con una evaluación de la calidad de los conjuntos de datos críticos y elija después el primer control para la brecha de mayor riesgo: Timeliness para cargas ausentes, seguimiento del schema para feeds de proveedores rotos y validación para campos incorrectos. El artículo propone planificar la ampliación a lo largo de 6 a 12 meses, con hitos ligados a la cobertura y la corrección.


