Cumplimiento de la calidad de datos: guía de auditoría 2026
|
7
minuto de lectura

La mala calidad de los datos cuesta a las organizaciones una media de 12,9 millones de USD al año según el benchmark citado en estudios de mercado, y eso antes de llegar al hallazgo de auditoría, al ticket de remediación o al informe en el que nadie confía. En entornos regulados, ese coste deja de ser un problema de eficiencia y se convierte en un problema de control, porque los mismos registros deficientes que frenan a los analistas también debilitan la evidencia regulatoria, financiera y de auditoría.
He visto repetirse el mismo patrón en data warehouses y pipelines de datos que parecían estar bien en la superficie. Los informes cuadraban con las cifras del mes anterior, las alertas eran ruidosas pero conocidas, y entonces una revisión de cumplimiento dejó al descubierto el problema de fondo: nadie podía demostrar cómo se habían validado, trazado o defendido los datos. Esa es la brecha en la que se centra esta guía: convertir los controles continuos de calidad de datos en evidencia de auditoría que resista un examen riguroso.
Índice
Por qué el cumplimiento de la calidad de datos es un asunto del consejo
Cómo la mala calidad de datos provoca fallos de cumplimiento
De las auditorías periódicas a los controles de cumplimiento continuos
Cómo relacionar las dimensiones de calidad de datos con los estándares regulatorios
Por qué la validación basada en reglas se queda corta para el cumplimiento moderno
Evidencia lista para auditoría mediante monitorización continua
Caso práctico: sustituir 9000 reglas manuales por observabilidad basada en IA
Cómo poner en práctica el cumplimiento de la calidad de datos entre equipos
Por qué el cumplimiento de la calidad de datos es un asunto del consejo
Un stack de control de datos débil genera un riesgo a nivel de consejo mucho antes de convertirse en un hallazgo de auditoría. Un benchmark muy citado sitúa el coste medio de la mala calidad de datos en 12,9 millones de USD al año, y el mismo estudio estima pérdidas de hasta 3,1 billones de USD anuales para la economía estadounidense resumen del estudio de mercado. Estas cifras importan porque muestran lo rápido que las brechas de validación se convierten en exposición financiera, y no solo en trabajo de limpieza para el equipo de datos.
El coste operativo aparece primero en la sala de control. Cuando los informes de ingresos dependen de conjuntos de datos incoherentes, cuando los registros de auditoría están incompletos o cuando los equipos no saben explicar cómo se obtuvo una cifra, el problema deja de ser de herramientas y pasa a ser de responsabilidad. El mismo estudio relaciona la mala calidad de datos con un impacto negativo en el 31 % de los ingresos empresariales y señala que los equipos de datos pueden dedicar hasta el 80 % de su tiempo a limpiar y preparar datos en lugar de analizarlos resumen del estudio de mercado. Es un golpe directo tanto a la supervisión como a la ejecución.
Regla práctica: si un conjunto de datos no se puede validar, trazar y defender, el dashboard es puramente cosmético.
La medición es la siguiente línea de fractura. Una encuesta del sector reveló que el 59 % de las organizaciones no mide en absoluto la calidad de sus datos resumen del estudio de mercado. En sectores regulados como los servicios financieros, la sanidad, las telecomunicaciones y la administración pública, esa brecha genera fricción en las auditorías, porque los datos que no se miden no se pueden defender de forma coherente cuando alguien pide evidencias.
Para los equipos que están definiendo su punto de partida, qué significa el cumplimiento de datos en la práctica ofrece una base útil. Los responsables legales y operativos también dependen de procedimientos de gobernanza y cumplimiento, porque el fallo real no suele ser un campo erróneo aislado. Es la ausencia de un sistema de control capaz de demostrar cómo se comprobaron, corrigieron y conservaron los datos.
Cómo la mala calidad de datos provoca fallos de cumplimiento
Los fallos de cumplimiento rara vez parecen una caída limpia del sistema. Normalmente aparecen como informes incoherentes, un plazo de presentación incumplido o una pista de auditoría que no puede demostrar que las cifras se comprobaron. Por eso son tan difíciles de detectar a tiempo. Los equipos suelen darse cuenta del problema solo cuando alguien pregunta cómo se obtuvo una cifra, mucho después de que empezara la deriva en el pipeline.
La presión regulatoria ya es real. El resumen sobre regulación digital señala que la Ley de Gobernanza de Datos de la UE se aplica desde el 24 de septiembre de 2023, y que las empresas que ya prestaban servicios de intermediación de datos el 23 de junio de 2022 tenían hasta el 24 de septiembre de 2025 para cumplir las disposiciones aplicables a los intermediarios. La gobernanza ya no es una preferencia interna. Se está plasmando en la ley, y los controles de datos débiles se convierten en exposición legal.
Dónde suelen empezar los fallos
El punto de fallo suele ser operativo, no técnico. Un control se rompe en el traspaso entre sistemas de origen, un equipo usa definiciones distintas o la validación manual se da por suficiente porque la revisión mensual suele salir bien. En el mismo resumen regulatorio, una encuesta recogía que el 58 % de las organizaciones afirmaba que la mala calidad de datos había causado problemas de cumplimiento importantes, y el 45 % reportaba marcos de gobernanza de datos deficientes o incoherentes.
La calidad de datos se convierte en un problema de cumplimiento cuando nadie puede demostrar que el control se ejecutó en el momento adecuado, sobre los datos adecuados y con el resultado adecuado.
El impacto en el negocio sigue el mismo patrón. el impacto de la mala calidad de datos en el negocio muestra cómo los datos deficientes van más allá de la analítica y llegan a las decisiones operativas, donde los errores son más difíciles de defender y de revertir. Otro estudio de mercado citado en el mismo resumen regulatorio indica que el 78 % de las grandes empresas sufrió problemas significativos de calidad de datos en los últimos 12 meses, y el 54 % afirmó que esos problemas afectaron directamente a los ingresos, al cumplimiento normativo o a la eficiencia operativa. Si los datos de entrada son inestables, la evidencia de cumplimiento también lo es.
De las auditorías periódicas a los controles de cumplimiento continuos
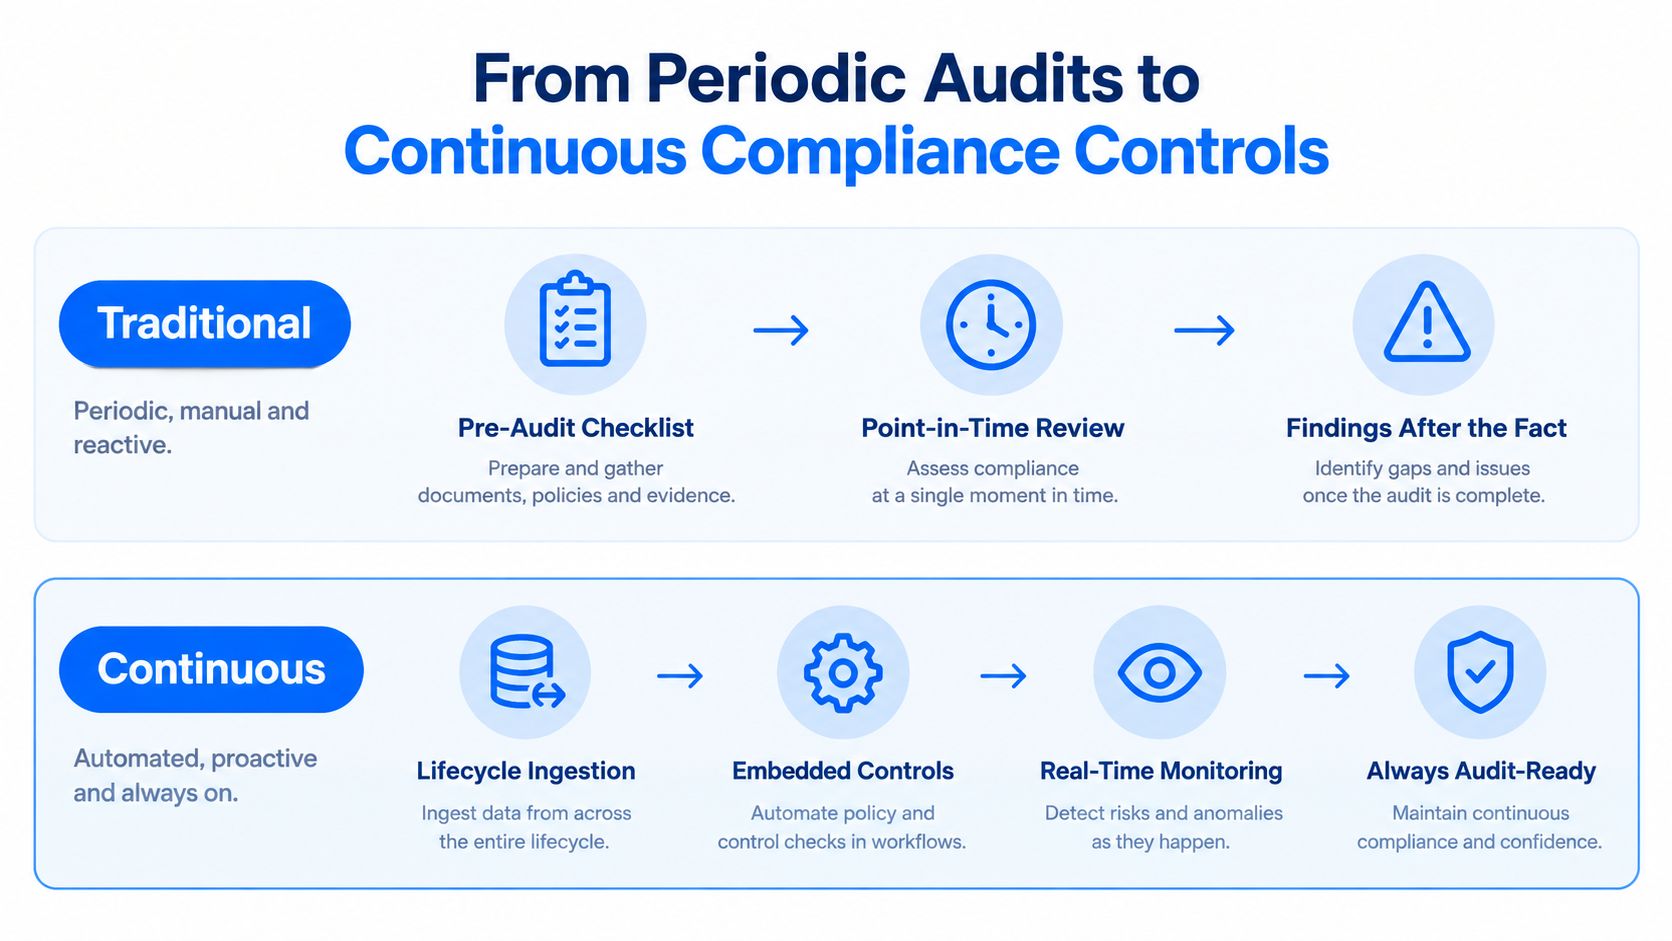
Las auditorías periódicas siguen siendo importantes, pero son demasiado lentas para ser la única línea de defensa. Cuando una auditoría encuentra un control roto, los datos erróneos ya han pasado por la ingesta, la transformación y el reporting. Por eso el cumplimiento de la calidad de datos moderno depende de controles continuos integrados en todo el ciclo de vida, y no de una revisión trimestral.

El cambio suena abstracto hasta que se traslada al trabajo que su equipo ya hace. La monitorización continua vigila la frescura, la completitud y los cambios estructurales mientras los datos fluyen. La validación automatizada aplica la misma lógica cada vez, algo importante porque a los auditores les importa menos si existe una regla que si se aplicó de forma coherente. La documentación del linaje cierra el círculo al mostrar de dónde vinieron los datos, cómo cambiaron y qué controles pasaron.
Qué cambia a nivel operativo
En un modelo periódico, la gobernanza es algo para lo que uno se prepara. En un modelo continuo, la gobernanza es algo que la plataforma produce cada día. Esa diferencia reduce la distancia entre el diseño del control y su funcionamiento, porque la evidencia se genera como parte del procesamiento normal en lugar de reconstruirse a posteriori.
Regla práctica: si un control solo existe durante la preparación de la auditoría, no es un control, es un recordatorio.
Lo mejor de este modelo es que encaja con el comportamiento real de los pipelines regulados. Los datos llegan tarde, los esquemas derivan y los sistemas de origen cambian sin apenas aviso. Cuando los controles están integrados en el flujo de trabajo, el equipo detecta esos fallos con tiempo suficiente para corregirlos antes de que se conviertan en defectos de reporting.
Un patrón de implementación útil es enviar esos controles automáticamente al reporting de cumplimiento, y ahí es donde la automatización del reporting de cumplimiento cobra relevancia operativa. Elimina el empaquetado manual que suele ralentizar la respuesta a las auditorías.
Cómo relacionar las dimensiones de calidad de datos con los estándares regulatorios
Los marcos de cumplimiento y los equipos de ingeniería de datos suelen usar vocabularios distintos para el mismo problema. Un regulador pregunta si el registro es apto para su uso, mientras que un ingeniero pregunta si la columna superó la validación. La brecha se cierra cuando se relacionan las dimensiones de calidad con estándares reconocidos en lugar de tratarlas como conversaciones separadas.
La guía de calidad de datos del Gobierno de Canadá define nueve dimensiones: accesibilidad, exactitud, coherencia, completitud, consistencia, interpretabilidad, relevancia, fiabilidad y oportunidad guía del Gobierno de Canadá. El Archivo Nacional de Australia identifica la norma ISO 8000-110:2021 como estándar global para la calidad de datos y los datos maestros empresariales, y enumera dimensiones habituales como exactitud, completitud, consistencia, integridad, oportunidad, unicidad/deduplicación y validez guía del Archivo Nacional de Australia.
Con qué pueden trabajar realmente los auditores
Estos marcos importan porque dan a los equipos un lenguaje que se traduce directamente en controles. Si una política exige que los datos de clientes sean exactos y oportunos, el equipo técnico puede traducirlo en reglas de validación, controles de latencia y lógica de conciliación. Si la política exige que los datos sean fiables, la evidencia debe mostrar cómo y cuándo se comprobaron.
El Data Governance Primer de la U.S. Administration for Community Living establece que los datos empresariales deben comprobarse periódicamente frente a estándares de calidad definidos y señala como temas de gobernanza el acceso a los datos, la definición de datos, las políticas de privacidad, los estándares de seguridad y los estándares de calidad de datos guía de la ACL. El Gobierno de Nueva Gales del Sur añade un detalle operativo útil: la gestión de la calidad de datos es un proceso continuo a lo largo de todo el ciclo de vida de los datos, y los organismos deben definir requisitos vinculados a las necesidades del negocio, incluidos estándares de disponibilidad, métricas y objetivos módulo de calidad de datos de NSW.
Esa combinación es el modelo práctico. Los estándares definen las dimensiones, la gobernanza define la responsabilidad y las operaciones definen cómo se produce la evidencia.
Para los equipos que convierten esas categorías en un mapa de controles operativo, dimensiones de la calidad de datos es una referencia útil. Lo más fácil de auditar es lo que se puede nombrar con claridad.
Por qué la validación basada en reglas se queda corta para el cumplimiento moderno
La validación basada en reglas sigue teniendo su lugar, pero se queda corta rápidamente en cuanto los pipelines se vuelven más grandes, más rápidos y más interdependientes. Los controles codificados a mano funcionan cuando el modelo de datos es estable y las excepciones son raras. No funcionan bien cuando cambia el esquema, evolucionan los sistemas de origen o hay que mantener la misma regla en media docena de sitios.
El verdadero problema es el mantenimiento
Una regla puede decirle que algo ha fallado. No puede decirle si el fallo importa en su contexto, si los datos han cambiado de forma o si el mismo comportamiento es normal para una fuente y sospechoso para otra. Por eso los equipos acaban con fatiga de alertas, scripts SQL frágiles y controles que se alejan de la realidad. El coste operativo no es solo la sobrecarga de ejecución, sino la pérdida de conocimiento cuando un ingeniero se marcha y la lógica de las reglas se va con él.
La brecha de cumplimiento va más allá de la exactitud, la completitud y la oportunidad. Los cambios regulatorios recientes exigen evidencia, no solo reglas. Eso significa linaje demostrable, trazabilidad, fuentes de datos de entrenamiento documentadas y métricas de calidad medibles. Los requisitos para sistemas de alto riesgo de la Ley de IA de la UE hacen hincapié en documentar las fuentes, las transformaciones y el uso de los datos de entrenamiento, mientras que el marco de ETSI de 2026 formaliza 18 métricas de calidad de datos, entre ellas usabilidad, linaje, trazabilidad y oportunidad resumen de regulación y estándares.
Un conjunto de reglas estático puede demostrar que se comprobó una condición. No puede demostrar que el entorno de control en su conjunto siguió siendo fiable.
Ahí es donde entra la observabilidad. La monitorización continua detecta la deriva, vigila los cambios de contexto y conserva el registro operativo que necesitan los auditores. También ayuda a los equipos a evitar la trampa habitual de tratar el cumplimiento como una lista de verificación en lugar de como un sistema de control vivo.
Para los data warehouses que todavía dependen de validaciones hechas a mano, hay una comparación directa en reglas técnicas de calidad de datos definidas manualmente. En la práctica, la pregunta no es si deben existir reglas, sino si bastan por sí solas. Normalmente no bastan.
Evidencia lista para auditoría mediante monitorización continua
La diferencia entre superar una auditoría y suspenderla suele reducirse a la prueba. Si se ejecutó un control de validación, pero no hay un registro duradero del conjunto de datos, la configuración de la regla, la marca de tiempo y el resultado, el control es difícil de defender. Por eso trato la evidencia lista para auditoría como un objetivo de diseño prioritario y no como un efecto secundario.
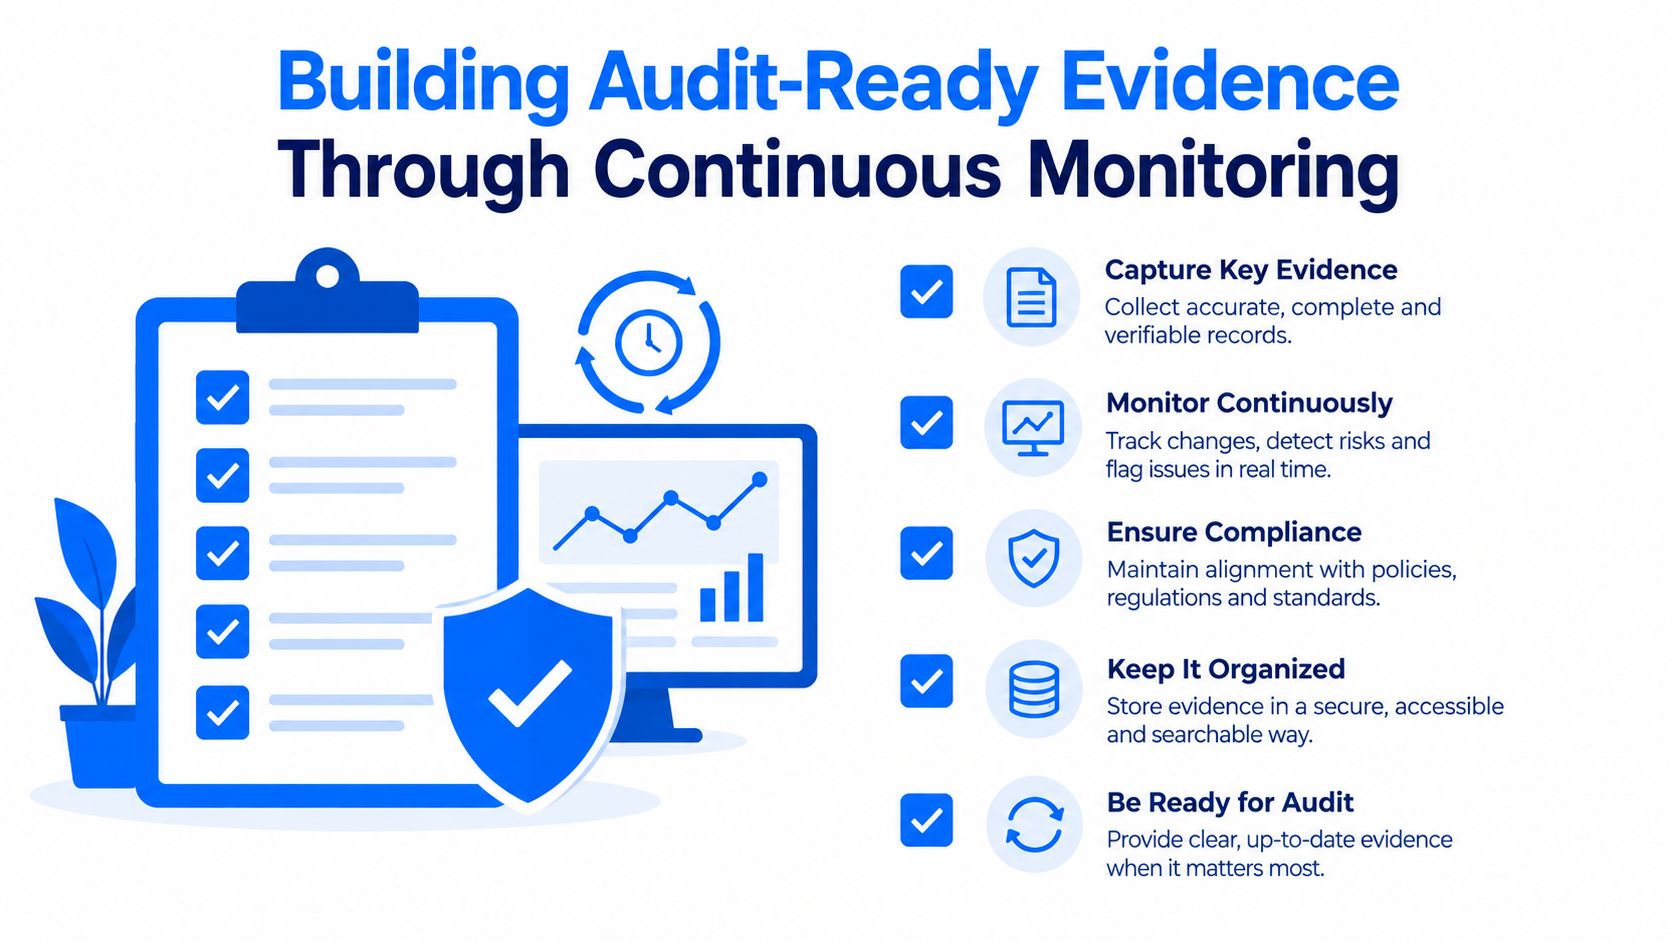
El patrón práctico es sencillo. Registre cada evento de validación de forma inmutable y haga que el log sea lo bastante granular para responder a las preguntas que los auditores realmente hacen. Eso significa identidad del conjunto de datos, identidad de la columna, parámetros de la regla, marcas de tiempo, resultado de aprobado/fallido, número de errores e historial de resolución guía sobre pistas de auditoría. Una vez que existe, los equipos pueden reconstruir qué se comprobó, cuándo se ejecutó y cómo se comportó el control antes y después de los cambios en las reglas.
Qué le aporta esa evidencia
Acorta las investigaciones cuando la deriva del esquema o los datos que llegan tarde afectan al reporting posterior. También conserva los umbrales históricos, algo importante cuando una regla cambia pero el equipo de auditoría sigue necesitando saber qué ocurrió con la configuración anterior. En pipelines regulados, esa es la diferencia entre «creemos que estaba bien» y «este es el estado exacto del control en ese momento».
El beneficio técnico es igual de importante. Cuando los resultados de validación se registran de forma coherente, los equipos pueden cuantificar la calidad en el momento de la validación en lugar de hacerlo cuando los datos ya han avanzado. Eso acelera mucho el análisis de causa raíz, porque la evidencia apunta al evento de control concreto y no a un síntoma difuso del pipeline.
El flujo de trabajo de soporte no tiene por qué ralentizar la entrega. Bien hecho, se ejecuta dentro del pipeline, almacena el registro del control junto al evento y lo exporta bajo demanda cuando cumplimiento lo necesita. Ese es el modelo en el que confío, porque resiste tanto la presión operativa como la revisión de auditoría.
También hay un vídeo de demostración práctica para los equipos que quieran ver cómo funciona esto en acción.
Caso práctico: sustituir 9000 reglas manuales por observabilidad basada en IA
ITSV, la columna vertebral de TI de la seguridad social austriaca, es un buen ejemplo porque la escala obligó a tomar una decisión real. El equipo gestionaba la calidad de datos con 9000 reglas escritas a mano en su data warehouse, y ese modelo ya no se ajustaba ni al volumen ni a la carga de mantenimiento. Su entorno procesaba 50 GB al día procedentes de más de 30 fuentes en más de 500 estructuras, lo que hacía insostenible el ajuste constante de reglas detalles del caso práctico.
La configuración anterior presentaba los síntomas habituales. Se perdía conocimiento cuando las personas se marchaban, la documentación iba por detrás de las reglas y ningún equipo era realmente responsable del framework de principio a fin. Más de 140 alertas diarias llenaban las bandejas de entrada, la mayoría ignoradas porque su significado no estaba claro, y solo se cubría el 25 % de los casos relevantes de calidad de datos detalles del caso práctico.
Qué cambió al trasladar los controles
Ya en septiembre de 2021, ITSV empezó a sustituir el framework basado en reglas por digna Data Anomalies y digna Data Timeliness. El análisis se mantuvo dentro de la propia infraestructura de ITSV, en línea con sus requisitos de privacidad, y el equipo no tuvo que ajustar umbrales ni mantener reglas manualmente. Data Timeliness aprendió los patrones de llegada y señaló los datos retrasados o ausentes, mientras que Data Anomalies aprendió el comportamiento normal en todo el data warehouse y señaló las desviaciones detalles del caso práctico.
Esto importa porque el caso no trata realmente de cambiar una herramienta por otra. Trata de sustituir un trabajo de mantenimiento frágil por una observabilidad que produce evidencia. Los controles se volvieron más fáciles de defender porque eran continuos y trazables, y el equipo recuperó el tiempo que antes dedicaba a filtrar ruido.
He visto funcionar migraciones similares por una razón: trasladan la responsabilidad de la memoria humana al comportamiento del sistema. Los controles no dependen de que alguien recuerde qué regla debía actualizarse el trimestre pasado. Se ejecutan, registran y escalan por sí solos.
Cómo poner en práctica el cumplimiento de la calidad de datos entre equipos
Ni siquiera una observabilidad sólida resuelve una brecha de gobernanza. La parte más difícil del cumplimiento de la calidad de datos suele ser la responsabilidad, porque los fallos suelen estar entre equipos y no dentro de un único sistema. Datos recientes de encuestas muestran que el 44 % de los encuestados afirma que la responsabilidad está repartida entre varios equipos, el 61 % sigue dependiendo de controles manuales o validación basada en SQL y solo el 14 % aplica SLA en toda la organización, aunque el 39 % hace seguimiento de SLA en pipelines clave informe de la encuesta.
Eso indica dónde está el trabajo. El problema no es que a los equipos no les importe la calidad. Es que han repartido la responsabilidad sin repartir la capacidad de hacerla cumplir. Si nadie es dueño del control de principio a fin, las alertas se filtran de manera informal, los incidentes se derivan por costumbre y la evidencia de auditoría se reúne demasiado tarde.
Un modelo operativo práctico
Empiece por asignar un responsable con nombre a cada conjunto de datos crítico y, después, defina qué se mide, con qué frecuencia se comprueba y adónde van los incidentes cuando el control falla. Haga que el registro sea inmutable, mantenga el linaje vinculado al registro y asegúrese de que la ruta de escalado sea explícita. Si un fallo de control no puede asignarse a una persona, todavía no es operativo.
Un segundo requisito es la coherencia entre equipos. Ingeniería, analítica y gobernanza deben usar las mismas definiciones de frescura, completitud y cambio de esquema. Si un grupo informa sobre una métrica mientras otro valida una interpretación distinta del mismo campo, la pista de auditoría solo parecerá coherente hasta que alguien empiece a hacer preguntas.
Regla práctica: el cumplimiento solo se vuelve continuo cuando la responsabilidad, la monitorización y el escalado están lo bastante automatizados como para sobrevivir a una semana ajetreada.
Una opción para los equipos que construyen ese modelo operativo es digna, que monitoriza el comportamiento de los datos dentro del propio entorno del cliente y da soporte a la validación, la monitorización de Timeliness, el seguimiento de esquemas y la evidencia lista para auditoría. Si su objetivo es que los controles sean más fáciles de defender sin convertir a su equipo en una fábrica de reglas manuales, merece la pena ver cómo encaja la plataforma en su data warehouse y su stack de pipelines.
Si quiere ver cómo funciona el enfoque de líneas base aprendidas del caso de ITSV sin escribir ni ajustar umbrales, digna Data Anomalies muestra cómo modela el comportamiento normal en todas las tablas y señala las desviaciones automáticamente.
Preguntas frecuentes
¿Qué es el cumplimiento de la calidad de datos?
El cumplimiento de la calidad de datos consiste en poder demostrar que los datos regulados se validaron, trazaron y defendieron, no solo que se comprobaron. El artículo sostiene que un control solo cuenta si la evidencia muestra que se ejecutó en el momento adecuado, sobre los datos adecuados y con el resultado adecuado, en lugar de reconstruirse durante la preparación de la auditoría.
¿Por qué los controles de calidad de datos basados en reglas no bastan para el cumplimiento?
Las reglas codificadas a mano demuestran que se comprobó una condición, pero no pueden mostrar que el entorno de control en su conjunto siguió siendo fiable. Se rompen cuando los esquemas derivan y las fuentes cambian, generan fatiga de alertas y pierden conocimiento cuando los ingenieros se marchan. Normativas como la Ley de IA de la UE y las 18 métricas de calidad de datos de ETSI exigen ahora también linaje y trazabilidad.
¿Qué debe incluir una pista de auditoría para la validación de datos?
Cada evento de validación debe registrarse de forma inmutable con la identidad del conjunto de datos, la identidad de la columna, los parámetros de la regla, la marca de tiempo, el resultado de aprobado o fallido, el número de errores y el historial de resolución. Con ese registro, los equipos pueden reconstruir exactamente qué se ejecutó y cómo se comportó un control antes y después de cambiar un umbral o una regla.
¿Qué dimensiones de calidad de datos se corresponden con los estándares regulatorios?
La guía de calidad de datos de Canadá define nueve dimensiones, entre ellas exactitud, completitud, coherencia, fiabilidad y oportunidad. La norma ISO 8000-110:2021, citada por el Archivo Nacional de Australia, añade integridad, unicidad y validez. Relacionarlas con reglas de validación, controles de latencia y lógica de conciliación da a auditores e ingenieros un vocabulario común.
¿Cómo sustituyó ITSV 9000 reglas manuales de calidad de datos?
A partir de septiembre de 2021, ITSV sustituyó su framework de reglas escritas a mano por digna Data Anomalies y Data Timeliness, que se ejecutan dentro de su propia infraestructura. El data warehouse ingiere 50 GB al día de más de 30 fuentes, y la configuración anterior generaba más de 140 alertas diarias y cubría solo el 25 % de los casos relevantes.


