Ingestión de datos en Apache Kafka: una guía práctica de construcción
|
6
minuto de lectura

A las 3:00 a.m., la alerta no suele decir “su arquitectura de ingesta es incorrecta”. Dice que el retraso del consumidor está aumentando, que una tarea de sumidero está reintentando o que una tabla aguas abajo ha dejado de actualizarse. Para cuando alguien rastrea el problema desde el productor a través de Kafka y hacia el lakehouse, el fallo original puede estar enterrado bajo rebalanceos, reintentos, desajustes de esquemas y registros duplicados.
Por eso, la ingesta de datos de Apache Kafka debe diseñarse como un ciclo de vida completo. Kafka puede proporcionar un esqueleto de eventos duradero y de alto rendimiento, pero la confiabilidad de producción depende de lo que suceda antes de que los registros lleguen a un broker y después de que los consumidores los lean. El diseño de temas, la partición, la semántica de entrega, la aplicación de esquemas, el comportamiento del sumidero y la Observability determinan si la canalización sigue siendo correcta bajo presión.
Tabla de Contenidos
El verdadero desafío detrás de la ingesta de Kafka
Cada decisión temprana crea trabajo aguas abajo
La confiabilidad incluye la cola
Patrones de arquitectura central para canalizaciones de ingesta
Productor directo al broker
Gateway o proxy REST
Kafka Connect para la integración de origen y sumidero
ETL de streaming con Kafka Streams o Flink
Construyendo productores y consumidores que realmente funcionen
La configuración del productor debe expresar el contrato
La configuración del consumidor protege el progreso
Estrategias de manejo de esquemas y recuperación de errores
La evolución del esquema necesita un límite impuesto
Separar fallos reintentables y terminales
Semántica de entrega frente a carga de trabajo
Sintonización de particiones y procesamiento por lotes para el rendimiento
Realizar pruebas de rendimiento antes de cambiar la topología de producción
Sintonizar para la carga de trabajo, no para una lista de verificación
El problema aguas abajo del que nadie habla
La salud del broker puede ocultar el fallo del sumidero
La gobernanza pertenece a la capa de exposición
Hábitos operativos y una lista de verificación previa al lanzamiento
Hábitos que evitan localizaciones nocturnas
La semana antes del lanzamiento
El verdadero desafío detrás de la ingesta de Kafka
El primer fallo serio de producción que vi en una canalización de pagos no comenzó con una interrupción del broker. Un despliegue de evolución de esquemas activó un rebalanceo de consumidores en el momento equivocado. Un consumidor dejó de avanzar de manera útil, el retraso acumulado creció y el sumidero del lakehouse aguas abajo comenzó a registrar filas duplicadas a medida que la lógica de recuperación reintentaba un trabajo que ya había llegado al almacenamiento.
El broker estaba sano. Las tasas de error del productor parecían normales. El incidente aún así se convirtió en una alerta a las 3:00 a.m. porque el equipo había tratado la ingesta como una conexión entre una aplicación y Kafka, en lugar de como una cadena de contratos con estado. La definición práctica de la ingesta de datos es más amplia que el transporte por sí solo, como aclara la guía de significado de ingesta de datos. Los registros deben llegar, seguir siendo interpretables, procesarse dentro de un intervalo aceptable y llegar a su destino sin degradarse.
Cada decisión temprana crea trabajo aguas abajo
La clave de partición de un tema determina el orden y la distribución de la carga. Su recuento de particiones limita el paralelismo de los consumidores y afecta a los rebalanceos. Las confirmaciones del productor y la idempotencia influyen en el comportamiento de los duplicados. El tamaño del grupo de consumidores afecta al tiempo de recuperación, mientras que el modelo de confirmación y reintento del sumidero determina si la entrega de al menos una vez se hace visible como filas duplicadas.
Estas elecciones también crean dependencias fuera de Kafka:
Diseño de temas: Los temas compartidos necesitan reglas claras de propiedad, nomenclatura, retención y esquema.
Clave de partición: Una clave deficiente crea particiones calientes o rompe la garantía de orden de la que depende un proceso de negocio.
Semántica de entrega: Un evento de libro mayor y una telemetría desechable no deberían tener el mismo contrato de procesamiento.
Tamaño del consumidor: Añadir consumidores más allá de las particiones disponibles no crea un paralelismo más útil.
Escrituras en el lakehouse: Las transmisiones continuas pueden crear muchos archivos pequeños, lo que aumenta el trabajo de compactación y degrada la eficiencia de las consultas, un equilibrio que se destaca en la guía sobre la entrega de datos de Kafka a tablas de streaming de Iceberg.
Regla práctica: Una canalización de Kafka no está sana simplemente porque los productores estén recibiendo confirmaciones. Está sana cuando los datos aguas abajo siguen estando completos, oportunos, correctamente estructurados y recuperables.
La confiabilidad incluye la cola
En finanzas y atención médica, un registro que llega tarde o con un campo modificado puede ser tan perjudicial como un registro perdido. Un evento de pago puede estar presente pero duplicado. Un evento clínico puede entregarse pero fallar en la validación después de un cambio de esquema. Un flujo operativo puede mostrar un bajo retraso del broker mientras su sumidero acumula archivos no confirmados.
Las secciones que siguen se centran en esos modos de fallo. El objetivo no es mover bytes hacia Kafka. Es prevenir la próxima alerta diseñando todo el camino, desde el comportamiento de origen y la asignación de particiones hasta la gobernanza de esquemas, las confirmaciones de sumideros y las evidencias que necesitan los operadores durante la recuperación.
Patrones de arquitectura central para canalizaciones de ingesta
Elija la topología de acuerdo con las capacidades del origen y el contrato aguas abajo. Un servicio que ya habla con Kafka no debería verse obligado a pasar por una pasarela HTTP, mientras que un mainframe heredado no debería recibir un proyecto de integración de cliente de Kafka que no pueda soportar.
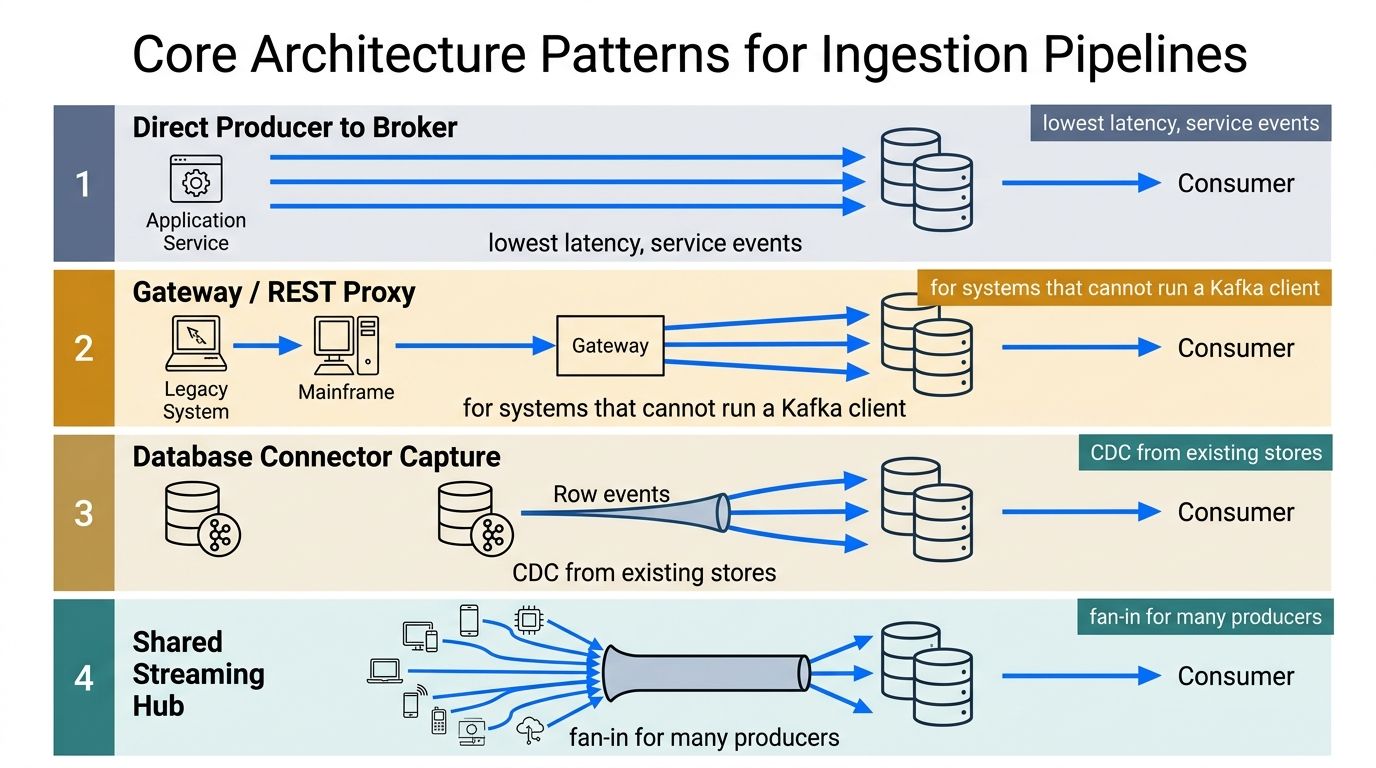
Productor directo al broker
Un servicio de Java, Go o Python puede publicar directamente en Kafka utilizando un cliente nativo. Esta es la opción adecuada para eventos de servicio, actividad de aplicaciones, cambios de estado de pagos y telemetría donde el productor controla las claves de los mensajes, el procesamiento por lotes, los reintentos y la serialización de esquemas.
La ventaja es una baja latencia y un control preciso. El costo es el acoplamiento. Cada equipo productor debe comprender las devoluciones de llamada de entrega, el comportamiento de las claves de partición, la autenticación, la compatibilidad de esquemas y la contrapresión. Un productor directo también puede exponer un diseño deficiente de claves de inmediato, lo que es útil durante las pruebas pero doloroso si el tema ya transporta tráfico de producción.
Gateway o proxy REST
Una pasarela proporciona a los sistemas que no pueden ejecutar un cliente de Kafka una interfaz HTTP más sencilla. Las aplicaciones heredadas, los mainframes, las integraciones de socios y las pequeñas utilidades pueden enviar registros sin tener que gestionar los detalles del protocolo de Kafka.
La pasarela centraliza la autenticación, la validación y la limitación de velocidad, pero puede ocultar errores en las claves de partición. Si la pasarela asigna claves o adopta por defecto una estrategia de distribución inadecuada, es posible que el equipo de origen no note que los eventos relacionados están llegando de manera desigual. También añade otro límite de fallo, por lo que los operadores necesitan métricas para las solicitudes aceptadas, las solicitudes rechazadas, los registros en cola, las confirmaciones del broker y la entrega aguas abajo.
Kafka Connect para la integración de origen y sumidero
Kafka Connect es práctico para la captura de bases de datos, sistemas SaaS, archivos y entregas a almacenes de datos o lakehouses. Los conectores de origen pueden publicar cambios en Kafka, mientras que los conectores de sumidero pueden mover registros a sistemas externos sin necesidad de una aplicación de consumo personalizada.
El modelo de compensación de Connect simplifica el reinicio y la recuperación porque las tareas del conector persisten en su progreso. Esa comodidad no proporciona automáticamente un comportamiento de exactamente una vez. Los reintentos del conector, la idempotencia en el lado del sumidero, las confirmaciones externas y los reinicios de tareas aún deben evaluarse como un solo sistema. Los despliegues de conectores también conllevan gastos operativos, que incluyen la compatibilidad de plugins, la configuración personalizada, las tareas fallidas y el mantenimiento, temas discutidos en la comparación de Kafka Connect, Flink y Spark.
ETL de streaming con Kafka Streams o Flink
Utilice Kafka Streams o Flink cuando los registros necesiten enriquecimiento, uniones, deduplicación, ventanas, procesamiento con estado o manejo de tiempo de eventos antes de llegar a un sumidero. Esta topología mantiene la lógica de transformación en una capa de streaming controlada en lugar de dispersar las reglas de negocio entre productores y conectores.
El equilibrio es la complejidad operativa. Los trabajos con estado introducen puntos de control, comportamiento de restauración, crecimiento del estado, compatibilidad de despliegue y pruebas más complejas. Una heurística de decisión útil es sencilla: use productores directos para contratos de servicio estables, pasarelas para orígenes limitados, Connect para movimientos mayormente mecánicos y un motor de procesamiento cuando la corrección dependa del estado de transformación o de la lógica entre transmisiones.
Para obtener una visión más amplia de cómo encajan los productores, brokers, consumidores y destinos, use esta referencia de arquitectura de canalización de datos.
Construyendo productores y consumidores que realmente funcionen
Un productor en producción debería hacer poco probable la publicación duplicada, exponer los fallos de entrega y dejar de reintentar indefinidamente. Un consumidor debería procesar los registros de forma deliberada, confirmar solo después de un trabajo exitoso y aislar los registros corruptos antes de que bloqueen una partición completa.
La configuración del productor debe expresar el contrato
Una configuración de productor de Java podría verse así:
acks=all hace que el productor espere la confirmación de broker configurada más sólida. enable.idempotence=true evita que los reintentos del productor creen registros duplicados dentro del modelo de entrega idempotente de Kafka. Un valor acotado de linger.ms da tiempo a los registros para formar lotes útiles sin convertir la latencia en una cola descontrolada.
Un particionador personalizado debería reflejar el requisito de ordenamiento del negocio. Los eventos de pago comúnmente necesitan que todos los registros de una cuenta o agregado de transacción permanezcan ordenados, mientras que las cuentas no relacionadas deben distribuirse entre las particiones. No llame a un particionador personalizado "ordenamiento adhesivo" a menos que la clave realmente defina el límite de ordenamiento.
Use devoluciones de llamada de entrega e inspeccione la excepción. Un tiempo de espera, una elección de líder o un fallo temporal de la red corresponden a un comportamiento controlado de reintento del cliente. Configure delivery.timeout.ms para que el cliente tenga un límite superior definido en lugar de construir un bucle de reintento ciego alrededor de send().
La configuración del consumidor protege el progreso
Un consumidor de Python que use confluent-kafka puede hacer explícito el comportamiento de asignación y confirmación:
El asignador cooperative-sticky reduce el movimiento innecesario durante los cambios de grupo. Las confirmaciones manuales garantizan que la compensación avance después de que el sumidero haya aceptado el registro, no simplemente después de que el consumidor lo haya obtenido. Un tema de carta muerta evita que un solo registro malformado mantenga como rehén a una partición.
El bucle de sondeo debe seguir respondiendo incluso cuando el sistema aguas abajo es lento. Si las escrituras en el lakehouse pueden bloquearse durante mucho tiempo, separe el sondeo del procesamiento, limite la cola de trabajo y sintonice max.poll.interval.ms según el contrato de procesamiento real. De lo contrario, Kafka puede interpretar que un consumidor lento pero que funciona está muerto e iniciar otro rebalanceo.
El cliente nativo también importa. Los ajustes de librdkafka, como los límites de cola, el tamaño de recuperación, la compresión, el comportamiento de los sockets y los intervalos de estadísticas, pueden cambiar el rendimiento y la latencia de cola. Revise esos valores predeterminados en lugar de asumir que el contenedor del lenguaje ha tomado la decisión correcta. La pregunta relevante no es si un ajuste es popular, sino qué fallo previene y qué recurso consume.
Una descripción general útil del software de ingesta de datos puede ayudar a separar los componentes de transporte de las capacidades de validación y monitoreo que deben acompañarlos.
Estrategias de manejo de esquemas y recuperación de errores
La semántica de entrega es una decisión comercial disfrazada de configuración de cliente. El procesamiento de a lo sumo una vez puede ser aceptable para la telemetría desechable. Al menos una vez suele ser la base de referencia práctica para los flujos de análisis. Los eventos del libro mayor financiero generalmente necesitan un manejo idempotente y un límite de exactamente una vez cuidadosamente diseñado.
Kafka distingue entre el procesamiento de al menos una vez y el de exactamente una vez. El soporte de exactamente una vez comenzó con la versión 0.11.0.0, utilizando productores y consumidores transaccionales para evitar la duplicación y la pérdida en todos los temas de Kafka, como se documenta en la documentación de semántica de entrega de Confluent. Esa capacidad no hace que un sumidero externo arbitrario sea transaccional. El lakehouse, la base de datos o la API deben participar en el diseño de la corrección.
La evolución del esquema necesita un límite impuesto
Avro, JSON Schema y Protobuf pueden funcionar. El formato importa menos que el hecho de que los productores compartan un registro, una política de compatibilidad y un proceso de Release. Para los temas compartidos, el Registro de Esquemas con compatibilidad retroactiva y retroactiva-transitiva es la opción predeterminada más segura porque los consumidores necesitan una forma predecible de leer nuevos registros mientras los consumidores más antiguos siguen desplegados.
La desviación del esquema es más peligrosa que un bloqueo visible. Un cambio de tipo incompatible puede detener una carga, mientras que un cambio de campo no validado puede distorsionar los valores de forma silenciosa. Un registro proporciona comprobaciones de compatibilidad, pero los operadores aún necesitan alertas cuando un productor intenta una versión rechazada, cuando los consumidores se retrasan después de un despliegue y cuando un tema de carta muerta comienza a crecer.
Separar fallos reintentables y terminales
Los tiempos de espera de la red, las elecciones temporales de líderes y los brokers no disponibles suelen ser reintentables. Los fallos de deserialización, los valores comerciales no válidos y las píldoras venenosas no se solucionan repitiendo la misma operación. Dirija los fallos terminales a un tema de carta muerta con la carga útil original, el tema, la partición, la compensación, el identificador del esquema, la clase de error y la marca de tiempo de procesamiento.
Para una ruta de procesamiento transaccional, los ajustes importantes incluyen:
El transactional.id debe ser estable por identidad de procesamiento y gestionarse con cuidado durante el despliegue. Los consumidores que usan read_committed evitan exponer registros transaccionales abortados, pero exactamente una vez aún requiere una coordinación atómica entre la lectura, el procesamiento y la escritura. Los productores idempotentes son un seguro barato. El verdadero exactamente una vez es una elección arquitectónica deliberada, no una opción predeterminada.
Semántica de entrega frente a carga de trabajo
Carga de trabajo | Semántica de entrega | Estrategia de esquema | Enrutamiento de errores | Configuración clave |
|---|---|---|---|---|
Telemetría de disparar y olvidar | A lo sumo una vez donde la pérdida es aceptable | JSON o Protobuf con versión y validación | Descartar o muestrear registros no válidos solo cuando el propietario del negocio acepte la pérdida | Tiempo de espera de entrega acotado |
Análisis operativo | Al menos una vez con deduplicación en el sumidero | Avro, JSON Schema o Protobuf gestionados por registro | Tema de carta muerta para fallos terminales |
|
Eventos del libro mayor financiero | Exactamente una vez en todo el límite de procesamiento definido | Esquema gestionado por registro con compatibilidad estricta | Reintentar fallos transitorios, poner en cuarentena registros corruptos | Transacciones, |
Eventos clínicos de atención médica | Al menos una vez o exactamente una vez según el contrato de origen y sumidero | Política de compatibilidad explícita y validación de campos | Tema de carta muerta con metadatos de auditoría | Confirmaciones manuales después de la persistencia validada |
Use una taxonomía de esquemas clara antes de crear temas. Los tipos de esquema y sus ventajas y desventajas son un contexto útil, pero la regla operativa sigue siendo la misma: cada tema compartido necesita un propietario, una política de compatibilidad y una ruta de reproducción.
Sintonización de particiones y procesamiento por lotes para el rendimiento
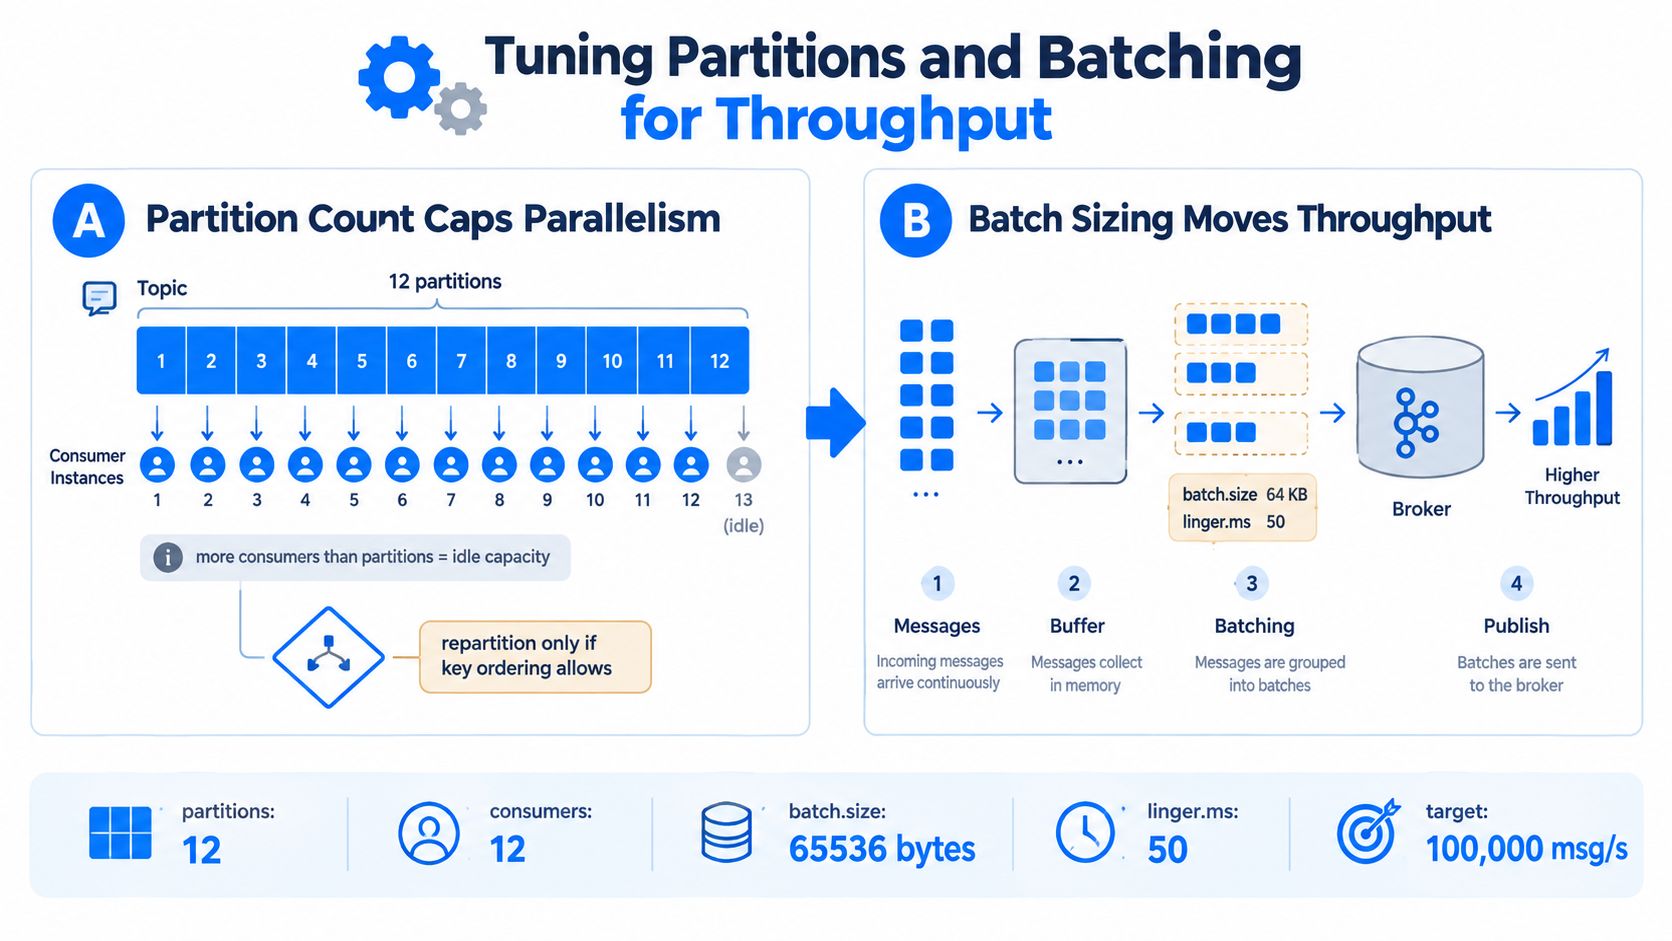
Dos controles suelen mover el rendimiento de ingesta de Kafka más que el código de aplicación inteligente: el recuento de particiones y el tamaño del lote. Las particiones proporcionan paralelismo, pero también crean archivos, metadatos, trabajo de replicación y gastos de asignación. Una vez que un tema está en producción, reducir su recuento de particiones no es una operación rutinaria segura, así que deje espacio para el crecimiento sin crear una huella de clúster innecesariamente grande.
Un modelo de dimensionamiento práctico comienza con el rendimiento máximo esperado dividido por el rendimiento sostenible de una partición bajo la distribución de claves prevista. Una referencia de sintonización ofrece un rango sostenido aproximado de 10 a 30 MB/s por partición, pero trate eso como una hipótesis inicial, no como una garantía. Realice pruebas de rendimiento con tamaños de carga útil reales, compresión, replicación, hardware de broker y claves sesgadas.
Realizar pruebas de rendimiento antes de cambiar la topología de producción
Las pruebas de rendimiento publicadas por Kafka y los proveedores muestran por qué la configuración es importante. Una prueba de rendimiento empírica registró aproximadamente 420,000 mensajes por segundo en hardware comercial con una partición y un factor de replicación de uno, mientras que otro estudio informó de aproximadamente 800,000 mensajes por second en un solo broker configurado correctamente. Un estudio de caso de ingeniería de Azure citó alrededor de 2 GBps con 10 brokers y 16 discos por broker. Estas cifras provienen de diferentes entornos y no son intercambiables, así que utilícelas para establecer la escala, no para prometer un resultado. Consulte la referencia de rendimiento e historia de Kafka para obtener el contexto histórico y de las pruebas de rendimiento.
El procesamiento por lotes puede tener un efecto dramático. Una prueba de rendimiento informó que pasar de un tamaño de lote de 16 KB a 100 KB aumentó el rendimiento del productor en aproximadamente un 300%, mientras que otra midió 605 MB/s con un batch.size de 1 MB, linger.ms=10 ms, 100 particiones y replicación de 3x, como se resume en la prueba de rendimiento de Kafka.
Sintonizar para la carga de trabajo, no para una lista de verificación
Comience las pruebas de productores aumentando el recuento de productores hasta que la latencia p99 se acerque al objetivo del nivel de servicio. Luego aumente las particiones para que coincidan con el paralelismo deseado y verifique que las claves se distribuyan de manera uniforme. Los recuentos de particiones sobredimensionados crean gastos de metadatos y coordinación, mientras que muy pocas particiones producen particiones calientes y picos de retraso durante las ráfagas.
Para los productores, pruebe un valor acotado de linger.ms en el rango de 5 a 20 ms y un batch.size de entre 64 KB y 256 KB antes de considerar lotes más grandes. zstd o lz4 pueden reducir la presión de la red y del almacenamiento para cargas útiles con forma de registro, pero la compresión consume CPU. Configure buffer.memory por encima de la tasa de ráfaga esperada para que las ralentizaciones breves del sumidero o del broker no se conviertan inmediatamente en fallos del productor.
Para los consumidores, limite max.poll.records para que el procesamiento se ajuste al intervalo de sondeo. Sintonice fetch.min.bytes para amortizar los viajes de ida y vuelta del broker cuando la latencia lo permita, y use la membresía estática cuando los despliegues causarían de otro modo una rotación de grupo evitable. Recuerde que el rendimiento del consumidor generalmente se estabiliza una vez que el recuento de consumidores supera al recuento de particiones. Más procesos no crearán un trabajo que el tema no pueda asignar.
El problema aguas abajo del que nadie habla
La ingesta de Kafka continúa después de que el broker acepta un registro. Los fallos graves suelen aparecer cuando un sumidero convierte un flujo de eventos ilimitado en tablas de lakehouse, filas de almacenes de datos o llamadas de servicio. Una canalización puede cumplir con los objetivos del productor y del broker mientras los datos aguas abajo siguen llegando tarde, fragmentados, malformados o invisibles para los usuarios.
Las escrituras de alto rendimiento en Iceberg pueden crear muchos archivos pequeños. Esos archivos aumentan el trabajo de metadatos y compactación, y las consultas se ralentizan a medida que el diseño de la tabla se fragmenta. Los equipos deben elegir cuánta frescura aceptar antes de la compactación y cómo agrupar las escrituras sin crear un retraso acumulado inmanejable. Trate el sumidero del lakehouse como parte del diseño de la ingesta, monitoreando juntos el tamaño del archivo, el comportamiento de confirmación, la capacidad de compactación y la frescura visible para las consultas.
La salud del broker puede ocultar el fallo del sumidero
El retraso del consumidor de Kafka es la diferencia entre la última compensación producida de una partición, la compensación final del registro y la última compensación confirmada por un grupo de consumidores. Es una señal por partición, no una medida completa de la frescura de extremo a extremo, como se explica en esta referencia de retraso del consumidor.
Un sumidero puede confirmar compensaciones mientras las escrituras siguen retrasadas, almacenadas en búfer, duplicadas o no disponibles para las consultas. Monitoree toda la ruta:
En el lado del broker: Compensación del final del registro, compensación confirmada, retraso por partición, latencia de solicitud, particiones subreplicadas, utilización del disco y sesgo de partición.
En el lado del consumidor: Duración del procesamiento, registros persistidos, recuento de reintentos, eventos de rebalanceo, fallos de deserialización y volumen de cartas muertas.
En el lado del sumidero: Latencia de confirmación, tasa de creación de archivos, acumulación de archivos pequeños, retraso acumulado de compactación, escrituras rechazadas, conflictos de transacciones y frescura visible para las consultas.
En el lado de los datos: Oportunidad de llegada, recuentos de filas, patrones nulos, unicidad de claves, fallos de reglas de negocio y cambios de esquema.
La desviación de esquemas crea otra ruta de fallo silenciosa. Un campo en desuso puede continuar a través del productor y del broker mientras una tabla aguas abajo lo ignora o le asigna un significado incorrecto. Imponga la compatibilidad en el límite del tema, registre la versión del esquema con cada evento y asigne un propietario para los cambios y las notificaciones de fallos.
La gobernanza pertenece a la capa de exposición
Los nuevos consumidores deben tener identidades definidas, límites de velocidad, temas permitidos, acceso a esquemas, expectativas de retención e historiales de auditoría vinculados a un equipo propietario o propósito comercial. Las aprobaciones informales y los proxies personalizados dificultan la revisión y revocación del acceso.
Esto es importante en los sistemas de finanzas, atención médica, telecomunicaciones y del sector público. Los operadores deben demostrar que los registros llegaron con la estructura esperada, dentro del intervalo requerido y con una ruta de recuperación rastreable. Por lo tanto, la gobernanza del consumidor incluye el acceso, el uso, la autoridad de reproducción y la calidad de los datos aguas abajo.
Una canalización es tan confiable como su salto más lento y menos monitoreado.
Hábitos operativos y una lista de verificación previa al lanzamiento
Los equipos confiables no esperan al día del lanzamiento para descubrir que su distribución de claves es desigual o que su sumidero no puede mantener el ritmo. Realizan pruebas de carga con registros realistas, revisan los paneles semanalmente y tratan la reproducción como un procedimiento operativo normal en lugar de un truco de emergencia.
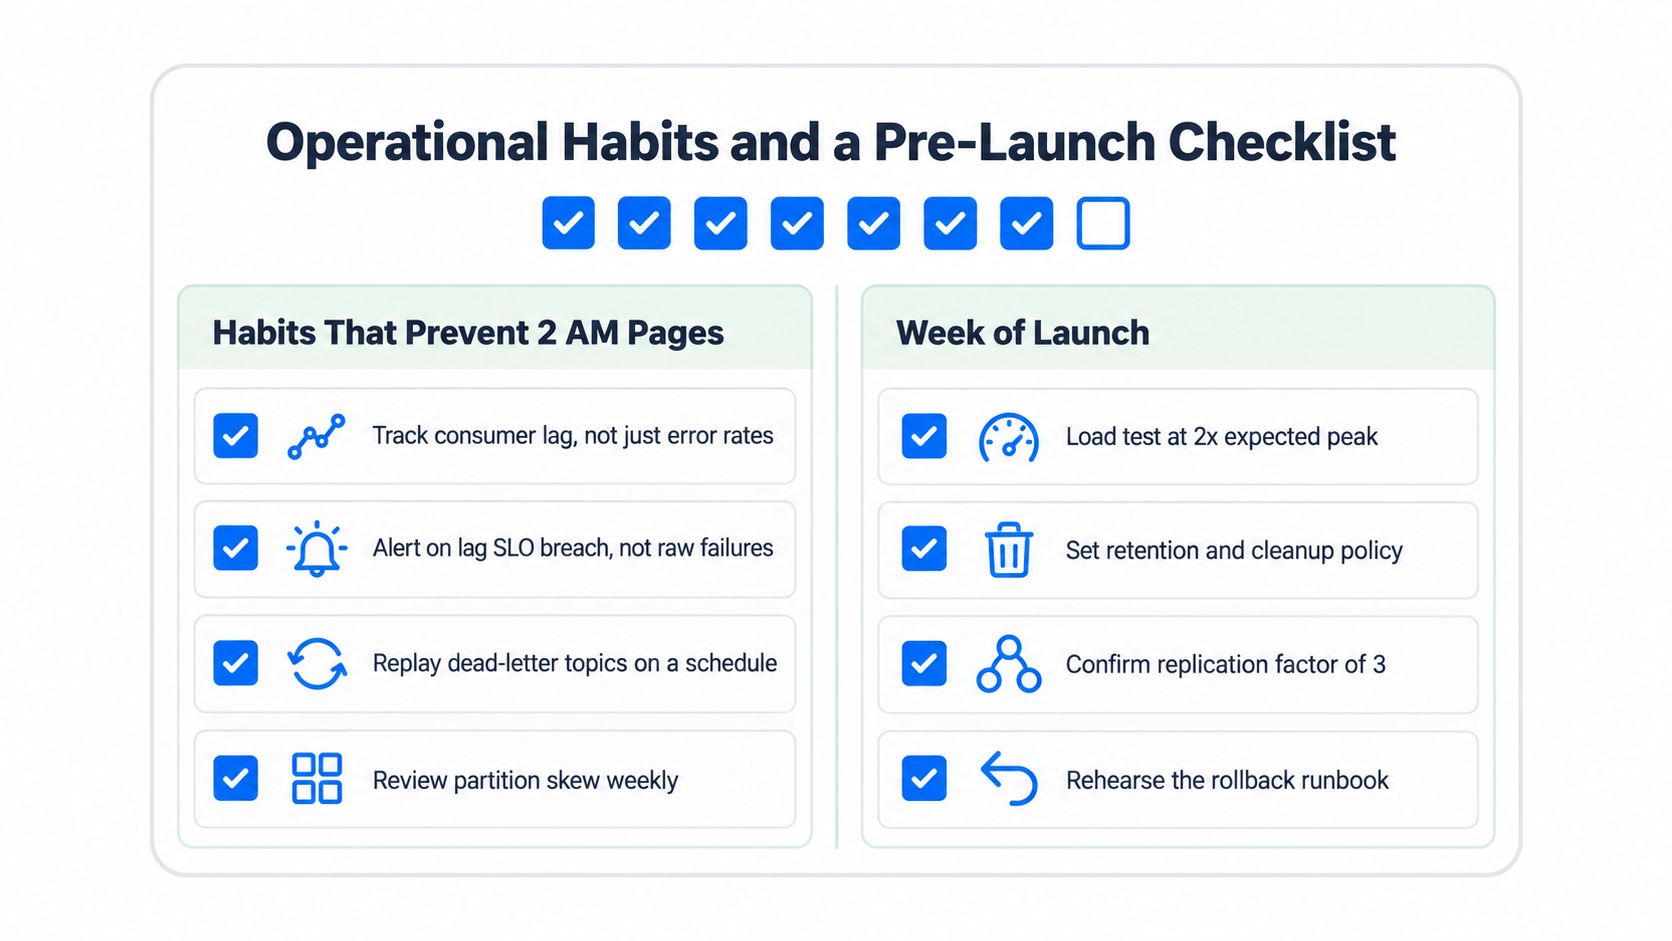
Hábitos que evitan localizaciones nocturnas
Realice un seguimiento del retraso del consumidor frente a un SLO, no solo de las tasas de error brutas. Un consumidor puede no informar excepciones mientras procesa demasiado lento para la fecha límite de negocio. Alerte sobre infracciones de retraso, sesgo de partición, presión en el disco del broker, rebalanceos frecuentes y crecimiento de cartas muertas.
Revise los paneles de Grafana y las métricas JMX semanalmente, incluida la latencia de solicitud del productor, el tamaño del lote de registros, la tasa de recuperación del consumidor, la latencia de confirmación, los bytes entrantes y salientes, las particiones subreplicadas y la actividad de rebalanceo de grupo. La revisión debería identificar tendencias antes de que los paneles aguas abajo las expongan.
Los temas de cartas muertas necesitan propiedad y un calendario de reproducción. Una DLQ que crece indefinidamente no es una recuperación. Es una cuarentena indocumentada.
La semana antes del lanzamiento
Ejecute las siguientes comprobaciones en un entorno de pruebas que se asemeje al de producción:
Distribución de carga: Pruebe con distribuciones de claves realistas, incluidos escenarios de claves calientes y tráfico con ráfagas.
Compatibilidad de esquemas: Registre versiones representativas y verifique el comportamiento retroactivo y retroactivo-transitivo con Confluent Schema Registry.
Fallo del broker: Desactive un broker durante la ingesta y confirme la recuperación del productor, la recuperación del consumidor y la corrección del sumidero.
Recuperación de compensaciones: Confirme que la retención de compensaciones supere el peor escenario de la ventana de recuperación. Kafka retiene las compensaciones de los consumidores durante un período configurable después de que un grupo se vuelve inactivo, controlado por
offsets.retention.minutes; Red Hat también documentaauto.offset.reset=earliestcomo una forma de evitar la pérdida de datos cuando una compensación confirmada ya no es válida, como se describe en la guía de configuración del consumidor de Red Hat.Libros de ruta: Documente los tres principales modos de fallo, el propietario de cada uno, el procedimiento de reversión y el comando o flujo de trabajo de reproducción.
Use la guía de orquestación de canalizaciones para aclarar qué sistema programa la recuperación, qué sistema valida el resultado y qué equipo cierra el incidente. La confiabilidad de la ingesta se gana a través de revisiones operativas repetidas, no mediante un ajuste de configuración final.
digna proporciona Observability de datos en el entorno para canalizaciones alimentadas por Kafka, incluyendo el monitoreo de la Timeliness, la validación de registros, la detección de anomalías y el seguimiento continuo de cambios de esquema en los activos de datos aguas abajo. Visite digna para ver cómo su plataforma modular puede ayudar a conectar la actividad del broker con las señales de calidad y frescura de datos que necesitan sus libros de ruta de ingesta.


