Gestión de la calidad de las bases de datos explicada de forma sencilla
|
7
minuto de lectura

Un cuadro de mando de confianza falla cinco minutos antes de una revisión ejecutiva. Los ingresos parecen inusualmente bajos, un segmento de clientes parece haber desaparecido y el equipo empieza a comprobar SQL, cuadros de mando y registros de pipelines al mismo tiempo. Nadie puede saber de inmediato si el sistema de origen envió registros incompletos, si una transformación cambió el significado de un campo, si una carga llegó tarde o si el cuadro de mando consultó la tabla incorrecta.
Esa incertidumbre es el problema de la calidad de la base de datos. Una base de datos puede aceptar cada fila sin errores y, aun así, respaldar una decisión engañosa. La mala calidad de los datos afecta a los informes, los análisis, los procesos operativos y los sistemas de IA, mientras que el coste de limpiar y preparar los datos puede consumir hasta el 80% del tiempo de los profesionales de datos, según las estadísticas de calidad de datos del sector resumidas por Integrate.io.
La gestión de la calidad de las bases de datos ofrece a los equipos una forma de pasar de la investigación de emergencias al control continuo. El camino práctico comienza con la diferencia entre el almacenamiento válido y el significado confiable, luego avanza a través de las dimensiones de calidad, los traspasos de pipelines, la Timeliness, los cambios de esquema, las reglas de negocio, la propiedad y el despliegue empresarial.
Tabla de contenidos
Introducción Por qué la calidad de las bases de datos sigue quebrando decisiones
Qué significa realmente la gestión de la calidad de las bases de datos
Corrección estructural
Corrección empresarial
Las dimensiones clave que definen los datos de confianza
Calidad intrínseca
Calidad contextual
Calidad de representación
Calidad de accesibilidad
Cómo falla la calidad en los pipelines y entornos
La decisión del patrón de control
Monitoreo de Timeliness, esquema y reglas de negocio en la práctica
Comience con las expectativas de llegada
Trate los esquemas como contratos
Valide el significado a nivel de registro
Creación de un programa empresarial de gestión de la calidad de las bases de datos
Puesta en acción de la gestión de la calidad de las bases de datos
Introducción Por qué la calidad de las bases de datos sigue quebrando decisiones
Un analista abre un cuadro de mando antes de una revisión ejecutiva y ve unos ingresos muy inferiores a lo previsto. La investigación se extiende a SQL, registros de pipelines, código de transformación y extractos de origen. El administrador de una base de datos puede confirmar que las tablas están disponibles, pero el equipo sigue sin poder explicar si los datos llegaron tarde, cambiaron de significado durante un Release o procedían de una fuente obsoleta.
Una comprobación a nivel de campo puede verificar que cada valor es una fecha válida. No puede confirmar que esas fechas representen eventos de compra en lugar de tiempos de ingesta. Un pipeline también puede terminar sin errores mientras carga un extracto antiguo, aplica una combinación modificada o asigna dos estados de origen a un único valor del almacén de datos. La finalización técnica y la corrección empresarial son resultados distintos.
Por lo tanto, la gestión de la calidad de las bases de datos controla todo el camino desde el origen hasta el consumidor. Abarca comprobaciones dentro de las bases de datos, comparaciones entre entornos y observaciones a lo largo de las ejecuciones y lanzamientos de los pipelines. La Observability en la base de datos cierra la brecha registrando qué cambió, cuándo cambió y qué regla o traspaso introdujo la diferencia. Esto hace visible la degradación de la calidad antes de que llegue a un informe o a una decisión operativa.
La exposición comercial es amplia. La mala calidad de los datos puede afectar a los informes, las operaciones, los análisis y las decisiones, en lugar de limitarse a producir tablas rotas. Una guía para las decisiones empresariales y la calidad de los datos explica cómo la información poco confiable puede distorsionar las elecciones y aumentar el trabajo de corrección.
Regla práctica: Si un equipo no puede identificar dónde cambió un valor, cuándo cambió y quién es el propietario de la corrección, tiene una inspección periódica, no una gestión de la calidad.
Utilice tres preguntas para enmarcar el trabajo: ¿Es el valor estructuralmente aceptable? ¿Tiene sentido para el negocio? ¿Es confiable el movimiento del origen al consumidor? Las respuestas conectan las comprobaciones de tablas con los controles de pipelines, la validación de Release, la propiedad y la evidencia de que una decisión se basa en datos actuales y correctamente interpretados.
Qué significa realmente la gestión de la calidad de las bases de datos
Un Release puede finalizar con éxito mientras un informe sigue conteniendo un significado empresarial incorrecto. Por ejemplo, un trabajo de ingesta puede almacenar una marca de tiempo válida, una transformación puede aplicar una combinación modificada o una asignación puede colapsar dos estados de origen en un único valor del almacén de datos. La gestión de la calidad de las bases de datos aborda esa brecha entre la finalización técnica y los datos que las personas pueden utilizar de forma segura.
La disciplina es la práctica continua de mantener los datos aptos para su uso previsto. Un informe financiero, un flujo de trabajo clínico, un modelo de cliente y una presentación regulatoria pueden depender de la misma base de datos, pero cada uno espera diferentes niveles de precisión, frescura, integridad e interpretación. Por lo tanto, el control de calidad sigue a los datos a través de pipelines y lanzamientos, no solo mediante comprobaciones en tablas individuales.
Corrección estructural
La corrección sintáctica se pregunta si un valor se ajusta a la estructura permitida de la base de datos. Un customer_id debe existir, una fecha debe coincidir con su tipo de datos, un campo numérico debe contener un número y una relación puede requerir un registro principal coincidente. Las restricciones, las reglas de nulabilidad, las comprobaciones de tipos y los controles de integridad referencial imponen estas condiciones.
Evitan que valores claramente no válidos entren o progresen en un sistema. No establecen que un valor almacenado de forma válida describa la realidad.
Corrección empresarial
La corrección semántica se pregunta si un valor almacenado significa lo que la organización dice que significa. Un pedido puede contener una marca de tiempo válida que registre la ingesta en lugar de la hora de compra. Un cliente puede tener un estado permitido que entre en conflicto con el estado real de su ciclo de vida. Una transacción puede superar una comprobación numérica perteneciendo a la cuenta equivocada.
La distinción es fundamental en la literatura técnica sobre gestión de la calidad de datos, que trata la calidad como algo más que el formato y separa la corrección sintáctica de la semántica.
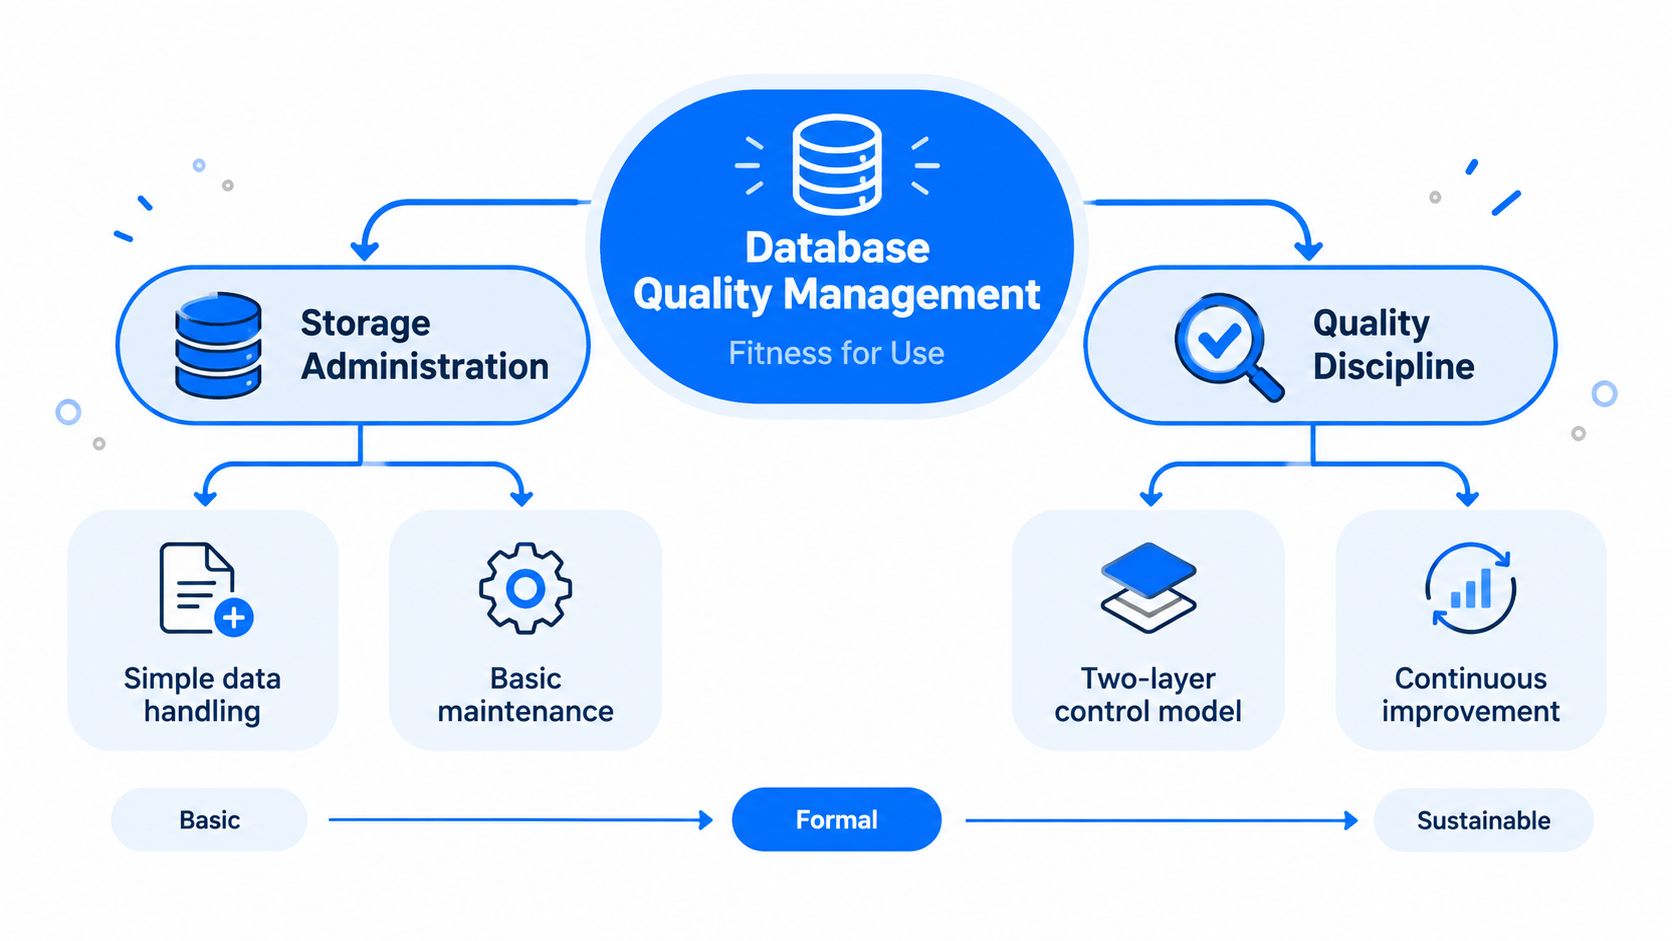
Una biblioteca aclara la diferencia. La administración del almacenamiento mantiene estanterías, números de catálogo y registros de préstamos. La disciplina de calidad también comprueba si el catálogo describe cada libro con precisión, identifica la edición actual, evita entradas duplicadas y permite a los lectores autorizados encontrar el material que necesitan.
Sigue un ciclo de control práctico:
Restringir los datos entrantes con tipos, claves, campos obligatorios y comprobaciones de relaciones.
Validar el significado empresarial mediante reglas para rangos, estados, secuencias, datos de referencia y relaciones.
Registrar las excepciones en lugar de descartar los fallos.
Asignar la propiedad para que un equipo pueda rastrear el origen, la transformación o el Release que introdujo un problema.
Medir el comportamiento recurrente para separar un registro defectuoso aislado de un pipeline en degradación.
Por tanto, la gestión de la calidad abarca la ingesta, la transformación, el almacenamiento, la entrega y el consumo. La Observability en la base de datos conecta esas etapas registrando los cambios, los tiempos, los fallos de las reglas y los traspasos entre entornos. Los equipos pueden utilizar esta explicación sobre la calidad de los datos para conectar los controles técnicos con la adecuación empresarial.
Las dimensiones clave que definen los datos de confianza
Una decisión puede fallar incluso cuando una tabla supera una comprobación básica. Los registros pueden estar presentes pero obsoletos, un campo puede ser preciso mientras que otro sistema no está de acuerdo, o una estructura válida puede contener entidades duplicadas. Por lo tanto, unos datos confiables requieren varios enfoques de calidad, aplicados en pipelines, lanzamientos y entornos, y no solo en la tabla final.
Las seis dimensiones principales proporcionan un punto de partida práctico:
Precisión: ¿Reflejan los datos correctamente la entidad o el evento del mundo real?
Integridad: ¿Están presentes los registros y campos obligatorios?
Consistencia: ¿Están de acuerdo los sistemas y conjuntos de datos relacionados?
Timeliness: ¿Están los datos disponibles y actualizados cuando los usuarios los necesitan?
Validez: ¿Siguen los tipos, formatos, rangos y reglas definidos?
Unicidad: ¿Están ausentes los registros duplicados no deseados?
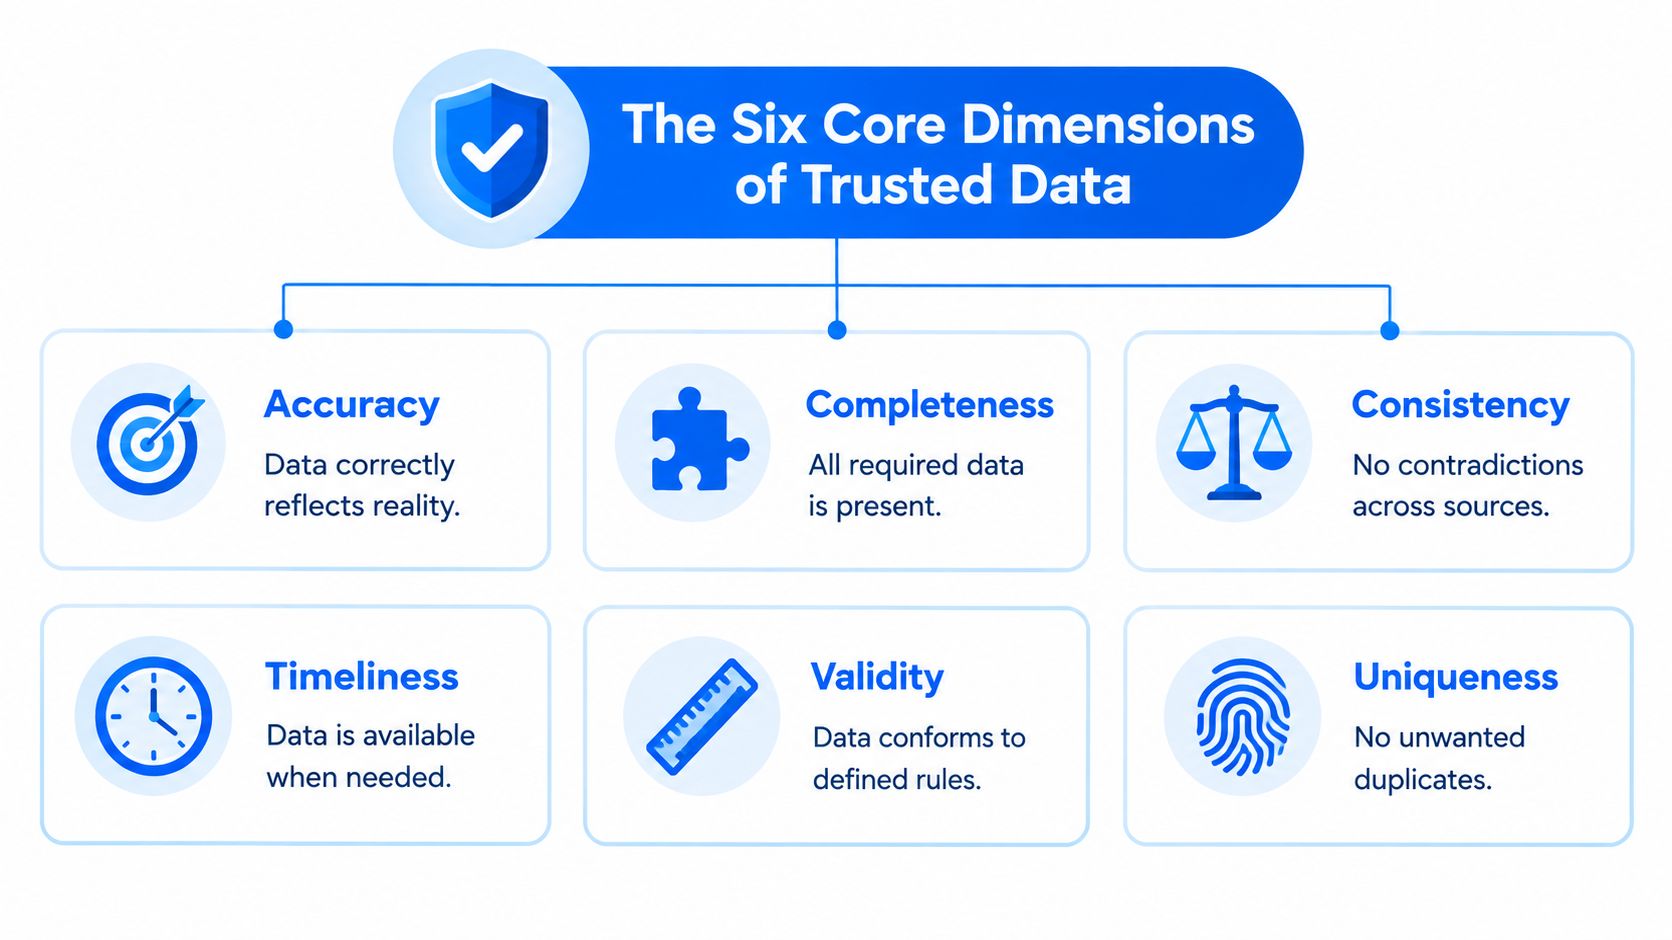
Estas dimensiones también pueden organizarse en cuatro familias operativas analizadas en la literatura sobre la gestión de la calidad total de los datos.
Calidad intrínseca
La calidad intrínseca describe las propiedades de los propios datos, especialmente la precisión y la credibilidad. Un valor puede estar presente y correctamente tipado, pero aun así fallar si no representa al cliente, la cuenta, el evento o la medición subyacentes.
Calidad contextual
La calidad contextual se pregunta si los datos son relevantes, completos, oportunos y apropiados en cantidad para un uso específico. Los datos adecuados para una tendencia mensual pueden no serlo para una decisión operativa en tiempo real. La idoneidad depende de la decisión y de su oportunidad, no solo de la tabla.
Calidad de representación
La calidad de representación abarca la interpretabilidad y la coherencia de la representación. Definiciones claras, nombres estables, formatos compatibles y transformaciones documentadas ayudan a los consumidores a comprender un campo y a compararlo de forma segura entre conjuntos de datos. Un Release que cambia un significado sin cambiar un tipo puede seguir reduciendo la calidad.
Calidad de accesibilidad
La calidad de accesibilidad se refiere a si los usuarios autorizados pueden acceder a los datos y utilizarlos mientras se mantiene la seguridad de acceso. Unos datos precisos que un flujo de trabajo aprobado no puede recuperar no cumplen su propósito.
El monitoreo operativo convierte estas categorías en señales que los equipos pueden observar en todos los entornos. La frescura expone problemas de Timeliness. El seguimiento de esquemas revela cambios estructurales entre lanzamientos. El volumen y la distribución destacan variaciones inusuales en el recuento de registros o en los patrones de valores. El linaje conecta un fallo con un origen, transformación o despliegue ascendente. La descripción general de digna sobre las dimensiones de la calidad de los datos vincula estas expectativas con señales de monitoreo prácticas.
Controles separados aceleran el diagnóstico. Una alerta de frescura apunta hacia la programación o la entrega. Una anomalía de distribución sugiere un comportamiento de origen o una lógica de transformación modificados. Una alerta de esquema puede indicar un Release o una ruptura de contrato. Un fallo de acceso dirige la atención a los permisos o a la configuración de la plataforma. Una puntuación puede resumir el estado, mientras que señales distintas muestran dónde se degradó la calidad y qué equipo debe investigar.
Cómo falla la calidad en los pipelines y entornos
Un informe puede superar todas las comprobaciones en su tabla final y, aun así, contener valores incorrectos. El extracto de origen puede cambiar antes de la ingesta, una transformación puede alterar el significado entre entornos o un Release puede añadir una columna que rompa un consumidor descendente sin violar las restricciones de la tabla de destino. Por lo tanto, la calidad se degrada en los traspasos, no solo en el almacenamiento.
Una encuesta global de 2026 reveló que el 47% de los encuestados vinculaba los problemas de calidad de los datos directamente con la transformación, mientras que el 77% de las empresas carecía de procesos formales de governance y calidad de bases de datos y el 39% dependía de métodos manuales de prueba y despliegue, según el informe de Redgate sobre el estado de las bases de datos en 2026. Estos hallazgos señalan a los puntos de traspaso como un problema de control central. Los equipos necesitan visibilidad en el desarrollo, las pruebas, la producción, los almacenes, los lagos y los pipelines, en lugar de confiar en las comprobaciones dentro de una tabla de destino.
La decisión del patrón de control
Patrón de control | Ideal para | Compromiso |
|---|---|---|
Reglas manuales | Comprobaciones conocidas y de alto valor propiedad de un especialista | Escalabilidad lenta, fáciles de pasar por alto durante los lanzamientos y dependientes del seguimiento humano |
Validación determinista | Contratos estables, campos obligatorios, rangos, relaciones y condiciones de Compliance | Clara y reproducible, pero no detectará todos los cambios de comportamiento inesperados |
Observability automatizada | Frescura, volumen, distribución, desviación del esquema y patrones difíciles de enumerar | Una cobertura amplia requiere una gestión de referencia y un flujo de trabajo para investigar las alertas |
Las comprobaciones manuales siguen siendo adecuadas para una norma reguladora o una conciliación financiera que requiera una condición explícita y revisable. La validación determinista se adapta a los casos en los que el resultado esperado es inequívoco. La Observability automatizada cubre cambios que los equipos no pueden describir razonablemente con una sola regla para cada comportamiento posible.
Proteja cada transición en secuencia. Compruebe la llegada del origen, valide el resultado de la transformación, compare los esquemas en todos los entornos y supervise el conjunto de datos final utilizado por los informes o modelos. La ejecución en la base de datos puede reducir el movimiento innecesario al calcular las métricas donde ya residen los datos. El linaje y los metadatos del Release conectan entonces un incidente con el cambio que lo precedió.
Un pipeline es tan confiable como su transición menos observada. La guía de calidad de pipelines de datos ETL enmarca las comprobaciones en torno al movimiento y la transformación, mientras que la Observability en la base de datos cierra la brecha entre lo que produjo un pipeline y lo que contiene cada entorno.
Monitoreo de Timeliness, esquema y reglas de negocio en la práctica
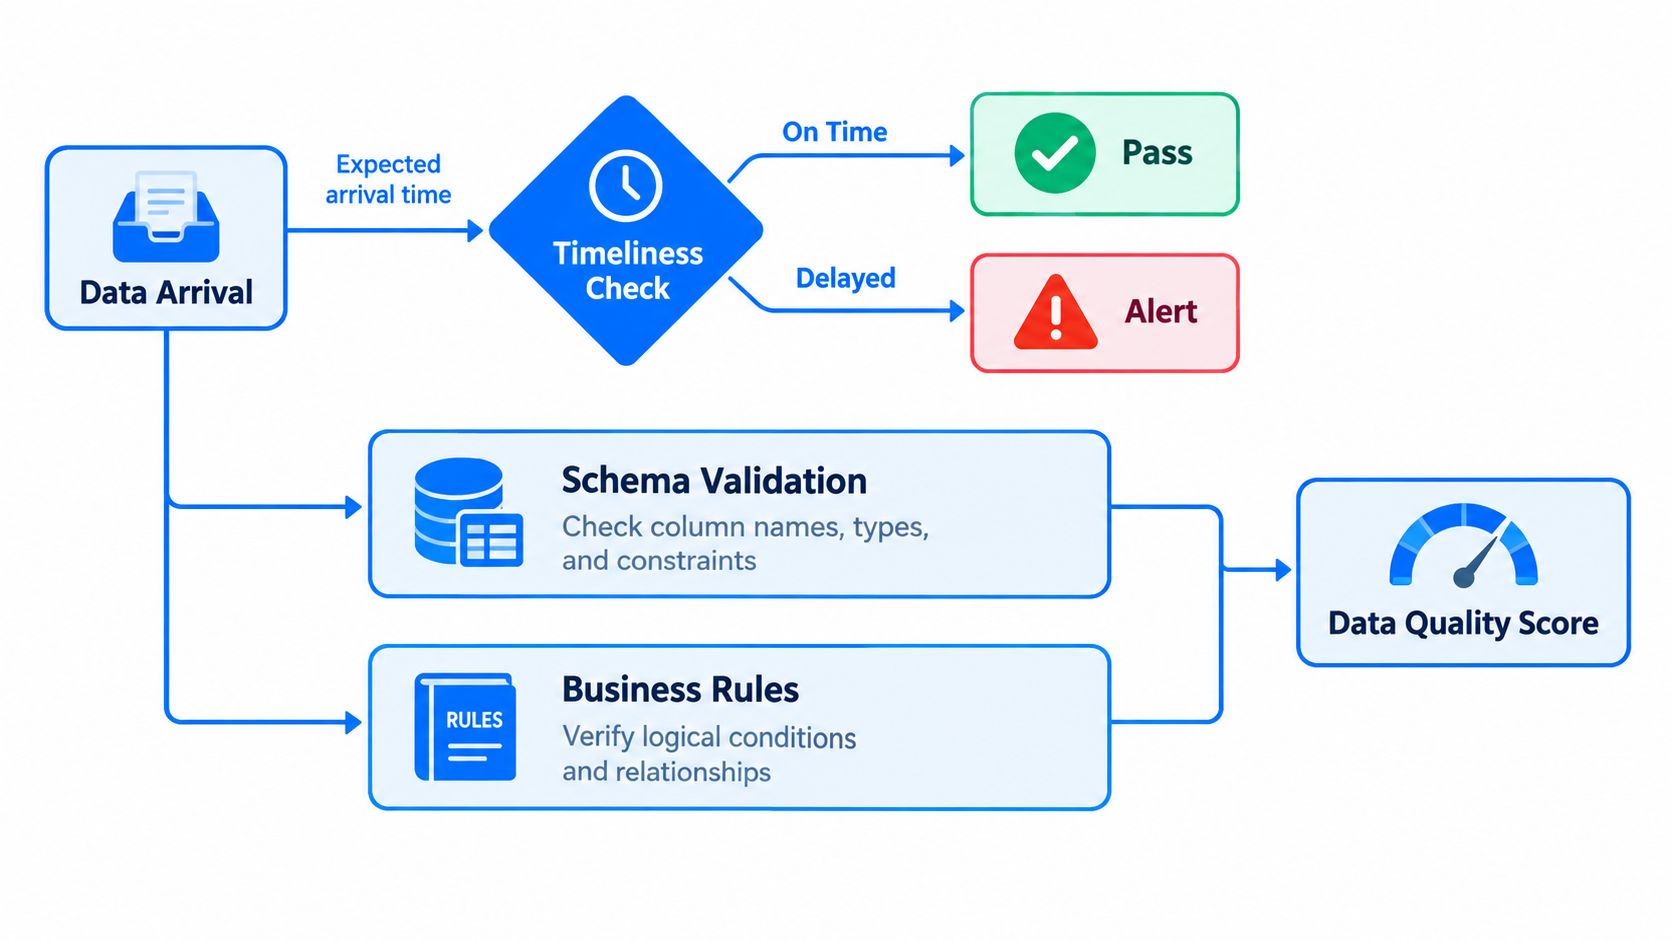
Un despliegue puede superar las comprobaciones de tablas y, aun así, fallar en su uso. El origen puede llegar tarde, un Release puede alterar un tipo de campo o una transformación puede producir registros que violen la lógica del dominio. El monitoreo operativo se vuelve manejable cuando cada señal tiene una pregunta y una respuesta claras. La Timeliness pregunta si los datos llegaron cuando se esperaba. El monitoreo de esquemas pregunta si la estructura cambió. La validación de reglas de negocio pregunta si los registros siguen apoyando su uso previsto.
Comience con las expectativas de llegada
El monitoreo de la Timeliness compara el tiempo real de llegada o actualización con un horario esperado o ventana de SLA. La Timeliness a nivel de registro mide si un evento individual llegó dentro de un período aceptable. La frescura del conjunto de datos mide qué tan recientemente se actualizó una tabla o partición.
Un equipo puede definir una ventana de entrega para un origen diario y alertar cuando la última actualización de la tabla supere el umbral permitido. Ese umbral depende del dominio y del caso de uso. Un proceso de riesgo, un flujo de trabajo de cara al cliente y un informe exploratorio tendrán diferentes tolerancias. Para el sistema de alertas basado en umbrales, consulte esta guía sobre métricas y monitoreo de Timeliness de datos. La Observability en la base de datos puede calcular estas comprobaciones junto a los datos, haciendo visibles las llegadas tardías en desarrollo, staging y producción en lugar de limitarse al límite del pipeline.
Trate los esquemas como contratos
Las comprobaciones de esquemas comparan la estructura observada con el contrato esperado. Supervise nuevas columnas, columnas eliminadas, campos renombrados, tipos de datos modificados, cambios de nulabilidad y cambios de restricciones. Una nueva columna puede ser inofensiva, mientras que un identificador eliminado o una conversión de numérico a texto pueden romper combinaciones, cálculos o modelos descendentes.
Ejecute comprobaciones de esquemas antes de que un Release llegue a producción y, a continuación, siga monitoreando después del despliegue. Comparar el mismo contrato entre entornos ayuda a distinguir una migración aprobada de una desviación introducida por un sistema de origen o un Release incompleto.
Valide el significado a nivel de registro
Las reglas de negocio expresan condiciones que debe cumplir una fila válida. Algunos ejemplos son que una fecha de finalización no preceda a una fecha de inicio, un pago vinculado a una cuenta existente, una cantidad positiva para una venta completada o una transición de estado permitida por el modelo de dominio.
Mantenga los registros fallidos disponibles para su investigación. Un registro de excepción útil incluye el conjunto de datos, la regla, el valor, el tiempo de ingesta o actualización, el entorno, la versión del pipeline y el propietario. Ese contexto ayuda a los ingenieros a separar los datos de origen erróneos de una transformación defectuosa y a conectar el fallo con el Release o entorno donde apareció.
Consejo operativo: Alerte sobre una condición solo cuando el equipo receptor sepa qué decisión debe tomar a continuación. De lo contrario, el monitoreo produce ruido en lugar de control.
Una vista de calidad combinada puede mostrar el estado de la Timeliness, el estado del esquema, los resultados de las reglas de negocio y los activos descendentes afectados. La puntuación resume entonces las evidencias de cada entorno y transición en lugar de presentar una calificación inexplicable.
Creación de un programa empresarial de gestión de la calidad de las bases de datos
Un programa empresarial conecta a las personas, los procesos y la plataforma a través de pipelines, entornos y lanzamientos. Cada parte responde a una pregunta diferente: ¿quién es el propietario de los datos?, ¿cómo deben responder los equipos? y ¿dónde se ejecutan los controles? Este modelo trata la calidad como un problema de control a través de los traspasos, no solo como un conjunto de comprobaciones de tablas.
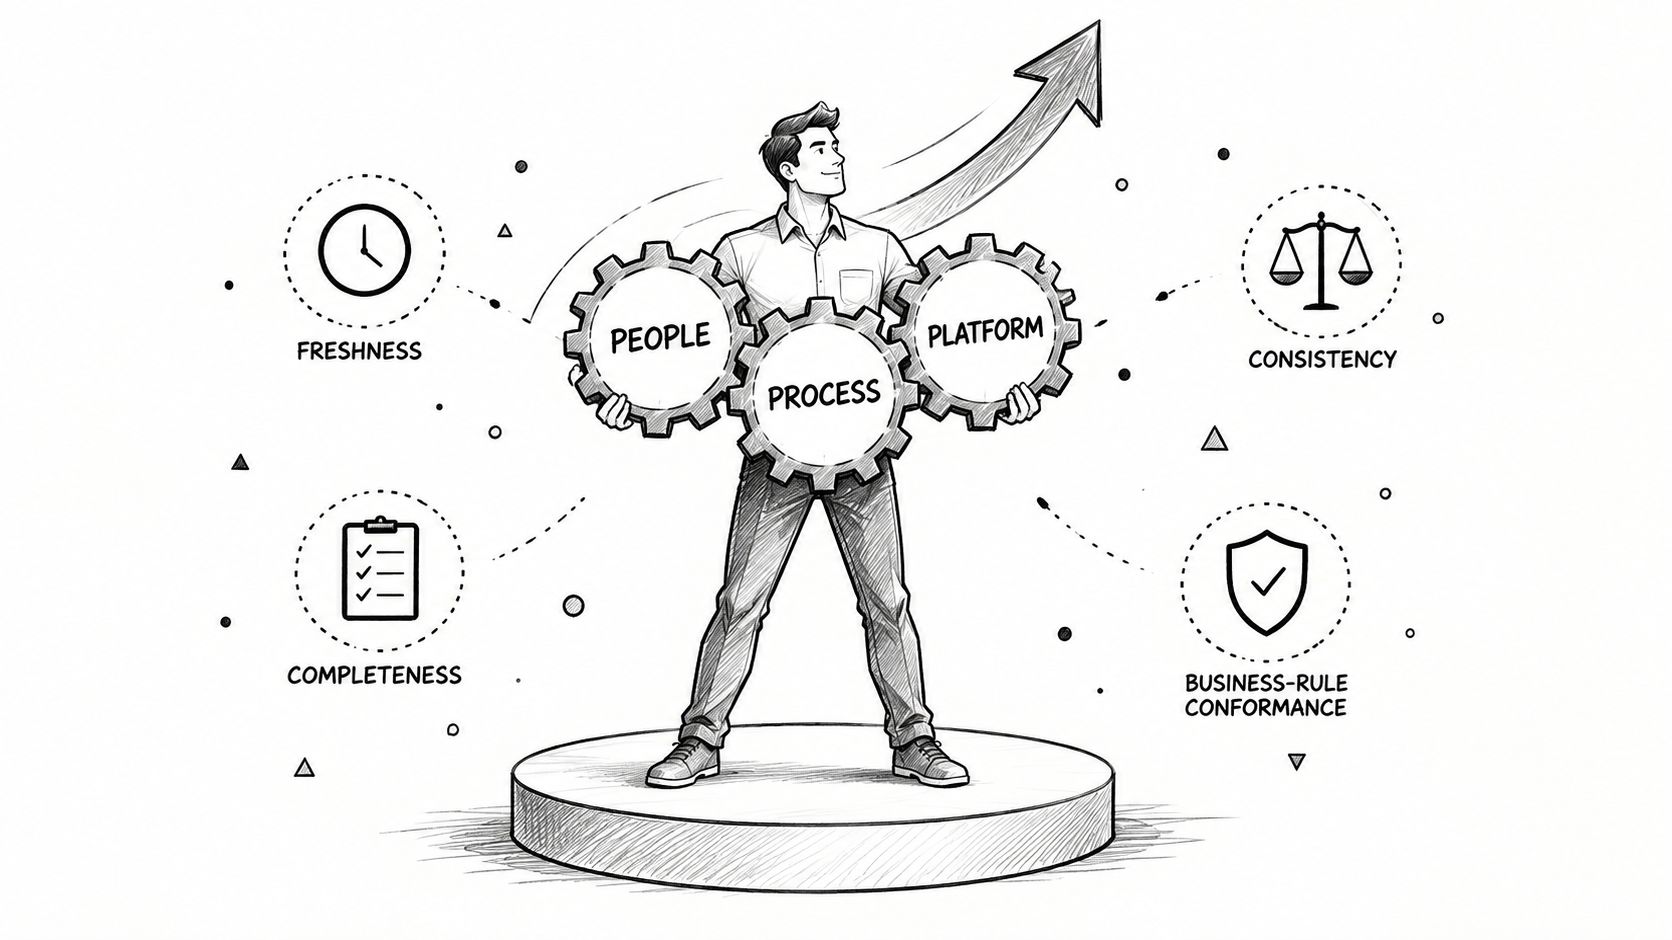
Comience con medidas vinculadas al uso empresarial. Realice un seguimiento de la frescura para la confiabilidad de la entrega, la integridad para los campos obligatorios, la consistencia entre las fuentes autorizadas y la conformidad de las reglas de negocio para los registros críticos. Ejecute los mismos controles en desarrollo, pruebas y producción siempre que sea posible. Comparar los resultados entre entornos puede revelar si un Release cambió el comportamiento antes de que el problema llegue a los consumidores. Añada dimensiones solo cuando respalden una decisión, una vía de escalada o una obligación de governance.
La propiedad debe ser explícita. Data Engineering suele ser propietaria del comportamiento del pipeline y de la corrección técnica. Analytics Engineering y los equipos de BI son propietarios de las transformaciones confiables y de la lógica de consumo. Los administradores de dominio definen el significado y las excepciones aceptables. Los equipos de governance establecen las normas, los requisitos de evidencia y la política de escalamiento. Un cuadro de mando compartido permite a estos grupos inspeccionar el mismo incidente manteniendo separados sus flujos de trabajo técnicos.
El caso de negocio debe conectar la inversión con resultados que los líderes reconozcan:
Reducción de incidentes: Detecte cargas faltantes, desviaciones de esquemas y distribuciones anormales antes de que los consumidores las reporten.
Preparación para el governance: Preserve pruebas de comprobaciones, fallos, propiedad y remediación.
Eficiencia de la plataforma: Reduzca la investigación manual repetida y enfoque el tiempo de ingeniería en las causas raíz.
Confiabilidad de la IA: Ofrezca a los modelos y sistemas de recuperación datos con frescura, estructura y significado observables.
Un estudio empresarial de 2025 reveló que el 84% de las organizaciones lucha con datos inexactos o duplicados. También identificó la presión presupuestaria en un 27%, la falta de recursos internos en un 24% y los entornos de sistemas complejos en un 19% como barreras principales, según la encuesta sobre calidad de datos empresariales de Melissa. Estas limitaciones favorecen un despliegue modular frente a una gran sustitución en toda la organización.
El diseño puede adaptarse según el sector. Las finanzas pueden priorizar la conciliación, los datos de riesgo y los registros de auditoría. La atención sanitaria puede destacar la integridad clínica, la validez y los controles de acceso. Los equipos de telecomunicaciones pueden necesitar monitoreo de entrega y anomalías de gran volumen. Los programas del sector público pueden priorizar la trazabilidad, la coherencia y las evidencias. El patrón de control sigue siendo modular mientras cambian las reglas.
La Observability en la base de datos cierra la brecha entre una comprobación de pipeline superada y los datos que los consumidores consultan. Puede conectar los resultados de las pruebas, las versiones de los lanzamientos, los cambios de entorno y el impacto descendente, proporcionando a los propietarios de incidentes evidencias para la siguiente acción en lugar de otra alerta aislada.
Este vídeo proporciona un contexto adicional para conectar las operaciones de calidad de datos con la confiabilidad más amplia de la plataforma:
Puesta en acción de la gestión de la calidad de las bases de datos
Un despliegue práctico comienza con el conjunto de datos que genera el mayor riesgo comercial o retrabajo operativo. Documente su uso previsto, el propietario, la expectativa de entrega, los campos clave, las reglas de negocio, los consumidores descendentes y las excepciones aceptables. Establezca una línea de base antes de añadir más controles, de modo que las mejoras posteriores tengan un punto de comparación.
Utilice esta lista de comprobación de decisiones:
Trace la ruta del fallo: Siga los datos desde el origen a través de la transformación, el entorno, el Release, el destino y el consumidor.
Separe las capas de corrección: Empareje las restricciones estructurales con la validación semántica.
Seleccione las señales por riesgo: Supervise la frescura, el esquema, el volumen, la distribución, el linaje y las reglas de negocio según los modos de fallo probables.
Haga que los incidentes sean accionables: Registre la propiedad, la gravedad, las evidencias y la siguiente respuesta.
Expándase según el riesgo: Aplique controles al siguiente conjunto de datos crítico después de que el primer flujo de trabajo produzca comentarios operativos útiles.
La calidad puede cambiar cuando varían el comportamiento del origen, los lanzamientos de código, los calendarios o las definiciones de negocio. Investigaciones independientes reportaron un promedio de un problema de calidad de datos por cada diez tablas al año en su actualización de 2026, en comparación con aproximadamente un problema por cada quince tablas en mediciones anteriores, según lo documentado por las estadísticas de calidad de datos de Monte Carlo. Por lo tanto, la observación persistente es más confiable que la limpieza ocasional.
Elija una plataforma modular que ejecute comprobaciones dentro del entorno del cliente. Los equipos pueden empezar con una capacidad y ampliarla a almacenes, lagos y pipelines. Las comprobaciones en la base de datos mantienen los datos en su sitio, mientras que la validación, la Timeliness, la detección de anomalías y el seguimiento de esquemas cubren diferentes puntos del ciclo de vida de la calidad. El monitoreo también debe conectar los resultados de los pipelines con las versiones de los lanzamientos, los cambios de entorno y los datos que consultan los consumidores. Esa conexión ayuda a los propietarios de incidentes a distinguir una prueba fallida de un defecto introducido posteriormente en la entrega.
digna proporciona capacidades de Observability y calidad de datos en la base de datos para monitorear el comportamiento de los datos, validar registros, realizar un seguimiento de la Timeliness, detectar cambios en el esquema y respaldar análisis fiables e IA en almacenes, lagos y pipelines. Visite digna para evaluar un enfoque modular adaptado a sus entornos, modelo de propiedad y prioridades de calidad.


