Gestión de riesgos de la calidad de los datos: una guía práctica
|
8
minuto de lectura
Un cuadro de mando está desactualizado, pero la canalización está en verde. Un modelo produce resultados desconocidos, aunque no se haya modificado ninguna implementación. Un informe reglamentario contiene totales incoherentes, y la investigación comienza con una búsqueda frenética en los registros de ingesta, el código de transformación y las hojas de cálculo. En cada caso, el fallo visible aparece al final del proceso, mientras que el problema de calidad subyacente puede haber entrado mucho antes.
Ese patrón es familiar para los ingenieros de datos porque el trabajo tradicional de calidad de datos suele empezar después de que alguien note un daño empresarial. Los equipos reparan los registros, actualizan una regla, vuelven a ejecutar una tarea y siguen adelante. La misma debilidad vuelve a aparecer cuando una fuente ascendente cambia su esquema, una entrega llega tarde o una métrica se desvía de su comportamiento habitual.
La gestión de riesgos de calidad de datos trata esos sucesos como fallos de control, no como tickets de limpieza aislados. El objetivo práctico consiste en detectar comportamientos anormales, validar registros críticos, realizar un seguimiento de las expectativas de entrega y dirigir las incidencias antes de que afecten a las decisiones, a la Compliance o a los sistemas de cara al cliente. Esto es importante a escala empresarial porque la estimación de IBM, ampliamente citada, situaba el coste anual de la mala calidad de los datos en Estados Unidos en unos 3,1 billones de dólares en 2016 (Debate en la comunidad SAP sobre la estimación de IBM).
Índice de contenidos
Por qué es importante ahora la gestión de riesgos de calidad de datos
El coste de la limpieza reactiva
Entender las dimensiones del riesgo de calidad de datos
Hacer coincidir las dimensiones con los modos de fallo
Priorizar por consecuencias
Creación de un registro de riesgos de calidad de datos
Utilizar campos operativos
Ejemplos de entradas en el registro de riesgos de calidad de datos
Estrategias de supervisión que detectan los riesgos a tiempo
Detección de anomalías
Supervisión de la Timeliness
Supervisión de cambios de esquema
Diseño de controles y flujos de trabajo de escalado
Colocar la validación cerca de los datos
Dirigir las alertas por impacto
Validar supuestos estadísticos
Medir la eficacia del programa e iterar
Medir la calidad de la señal, no el volumen de alertas
Revisar el registro como un artefacto de control
Primeros pasos con su programa de riesgo de calidad de datos
Ampliar en incrementos controlados
Por qué es importante ahora la gestión de riesgos de calidad de datos
Un equipo de datos puede tener una orquestación fiable, estados de tarea correctos y pruebas unitarias exhaustivas y, aun así, ofrecer datos inutilizables. Una fuente puede enviar un archivo válido con una población empresarial incompleta. Una tabla puede cargarse correctamente con una columna renombrada. Un informe puede actualizarse según lo programado utilizando registros que ya no coinciden con las suposiciones que sustentan sus cálculos.
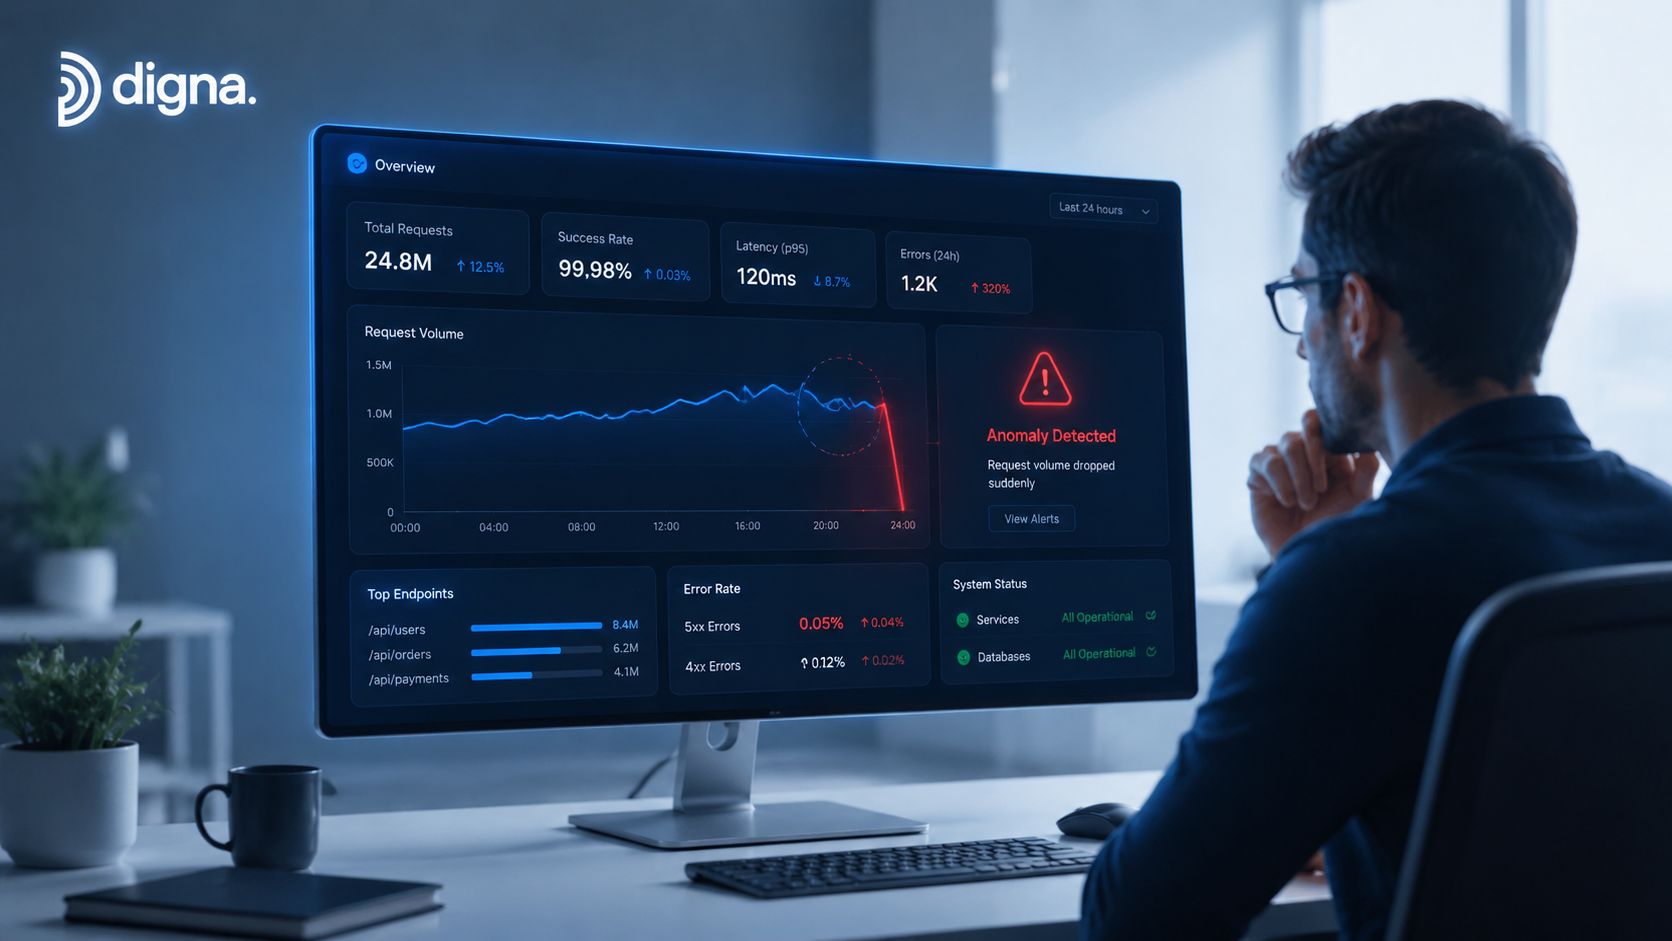
El síntoma de producción suele determinar a quién se avisa. Los analistas ven un cuadro de mando desactualizado. Los equipos de Compliance detectan una incoherencia. Los científicos de datos cuestionan el resultado de un modelo. A continuación, los ingenieros rastrean el problema a través de sistemas que informaron de un resultado correcto. Esa investigación resulta costosa porque la salud técnica de una canalización y la aptitud de sus datos para el uso son cuestiones de control diferentes.
El coste de la limpieza reactiva
El mantenimiento manual de reglas funciona mientras el número de fuentes, tablas y casos de uso sea manejable. Deja de funcionar cuando los equipos deben codificar a mano cada valor esperado, patrón de entrega y variación estructural. Las auditorías periódicas presentan una limitación similar. Pueden identificar defectos históricos, pero no detectarán de forma fiable un fallo silencioso entre ciclos de revisión.
Un programa continuo vigila el comportamiento en lugar de esperar a que se produzca una queja. Compara el volumen y las distribuciones actuales con las líneas de base establecidas, evalúa si los datos llegaron cuando los consumidores los necesitaban e identifica los cambios estructurales antes de que falle la lógica descendente. La validación a nivel de registro añade una capa independiente para las reglas de negocio que la supervisión agregada no puede detectar.
Regla operativa: El estado verde de una canalización solo demuestra que el flujo de trabajo se ha completado. No demuestra que los datos resultantes sean precisos, oportunos, coherentes o aptos para tomar una decisión.
El cambio también es organizativo. La calidad de los datos se convierte en una disciplina de riesgo compartido, con propietarios, niveles de gravedad, rutas de respuesta y evidencias. En la explicación de digna sobre los beneficios de la calidad de datos se ofrece una visión general muy útil del valor empresarial que encierra este enfoque, pero la cuestión de la implementación sigue siendo operativa: qué fallos importan más, cómo los detectará el equipo y qué ocurre tras una alerta.
Los equipos deben empezar por los productos de datos que influyen en los informes regulados, las decisiones financieras, las operaciones con clientes o el aprendizaje automático. No necesitan supervisarlo todo inmediatamente. Necesitan controles en los puntos en los que un defecto no detectado alteraría un resultado.
Entender las dimensiones del riesgo de calidad de datos
Una canalización puede finalizar con éxito mientras su salida sigue sin ser segura. Una tabla numéricamente exacta que llega después de la fecha límite de presentación de informes es inutilizable desde el punto de vista operativo. Una tabla completa con definiciones contradictorias entre sistemas puede distorsionar la visión de la empresa. Un conjunto de datos nuevo con un cambio de tipo inesperado puede perjudicar a los consumidores descendentes sin cambiar ningún valor.
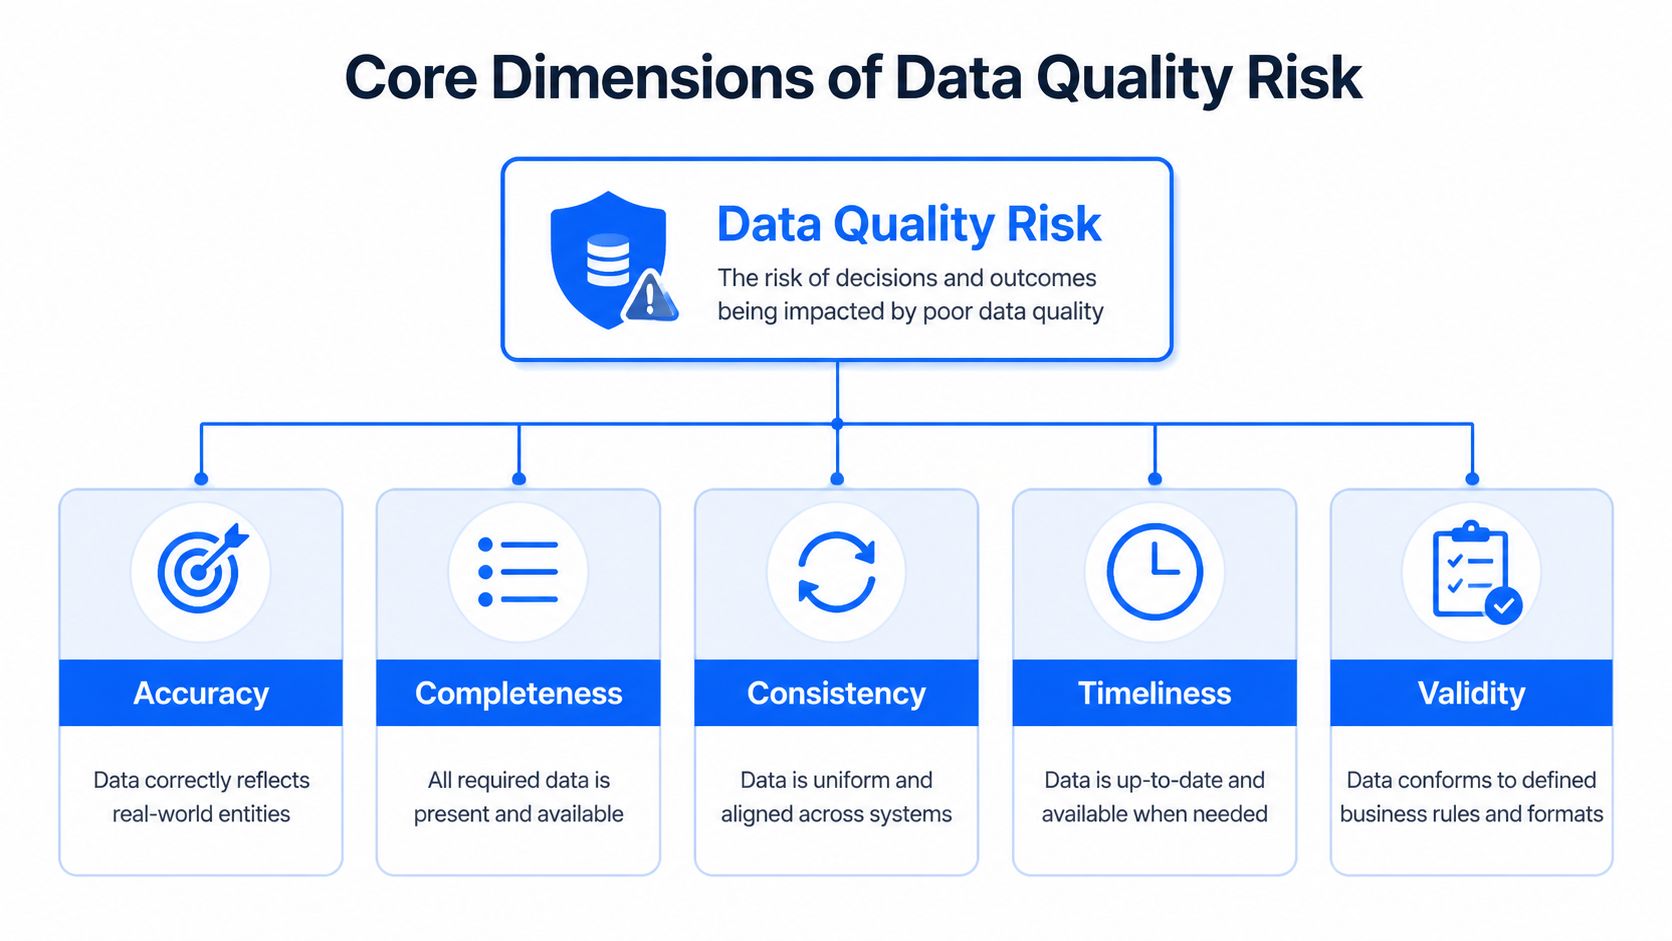
Por tanto, el riesgo de calidad necesita dimensiones que se correspondan con modos de fallo observables. La norma ISO 8000-61:2016 define los procesos para la gestión de la calidad de los datos, mientras que el Marco de Evaluación de la Calidad de los Datos del FMI organiza la calidad en torno a la integridad, la solidez metodológica, la precisión y fiabilidad, la utilidad y la accesibilidad (Referencia ISO 8000-61, Marco de Evaluación de la Calidad de los Datos del FMI). Estas referencias respaldan la evaluación periódica en lugar de la limpieza puntual. Los equipos también pueden consultar esta guía práctica sobre las dimensiones de la calidad de los datos a la hora de definir su vocabulario de control.
Hacer coincidir las dimensiones con los modos de fallo
La precisión plantea si los registros representan el mundo o los acontecimientos que describen. Un estado de cuenta, un importe o un identificador de cliente incorrectos pueden distorsionar una decisión incluso cuando están presentes todas las filas esperadas.
La exhaustividad abarca los registros y campos obligatorios. La falta de atributos opcionales puede ser tolerable, mientras que la falta de identificadores o de campos normativos puede detener un proceso.
La coherencia comprueba si las definiciones y los valores coinciden entre los distintos sistemas. Las diferentes representaciones de un mismo cliente, producto o transacción crean tareas de conciliación y pueden perjudicar a los informes.
La Timeliness mide si los datos están disponibles cuando el consumidor los necesita. Un conjunto de datos de planificación diaria y una fuente de riesgos operativos tienen expectativas de entrega diferentes, por lo que la supervisión debe utilizar umbrales específicos de cada producto.
La validez comprueba formatos, dominios, relaciones y reglas de negocio. Un valor puede tener el tipo de datos correcto y, aun así, infringir un estado o relación permitidos.
Priorizar por consecuencias
Supervisar todas las columnas por igual desperdicia esfuerzos de ingeniería y produce un ruido de alertas innecesario. Clasifique los productos de datos según su nivel de criticidad, identifique las dimensiones que podrían alterar una decisión y conecte cada riesgo con un control. Utilice la detección de anomalías para cambios inesperados de volumen o distribución, controles de Timeliness para cargas tardías o ausentes y seguimiento de esquemas para cambios estructurales antes de que fallen los consumidores. La orientación del FMI también reconoce la relevancia, precisión, Timeliness, coherencia, interpretabilidad y accesibilidad, por lo que la precisión no debe convertirse en la única dimensión supervisada.
Una evaluación práctica plantea tres preguntas:
¿Qué podría cambiar? Identifique la decisión, el informe, el modelo o el proceso afectado.
¿Cómo se manifestaría el fallo? Defina la señal, como una carga ausente, un cambio de distribución, un registro no válido o una modificación del esquema.
¿Qué respuesta es proporcionada? Elija un bloqueo, una advertencia, un ticket o una revisión de tendencias en función del impacto y la confianza.
Este mapeo evita que los equipos supervisen lo que es meramente fácil de medir. Una dimensión de calidad resulta útil desde el punto de vista operativo cuando se conecta con un consumidor designado, una señal observable y una respuesta definida.
Creación de un registro de riesgos de calidad de datos
Un registro de riesgos debería ayudar a un ingeniero a decidir qué comprobar a las dos de la mañana. Las entradas genéricas como «los datos de los clientes pueden ser inexactos» no proporcionan ninguna acción clara, requisito de evidencia o ruta de escalado.
Empiece por los activos de datos que sustentan las decisiones, los informes, los modelos o los flujos de trabajo operativos. Para cada activo, registre su propietario, los consumidores, las expectativas de entrega, los campos confidenciales, las dependencias ascendentes y los modos de fallo conocidos. A continuación, describa cada riesgo como una causa, un suceso y una consecuencia. «Un equipo ascendente elimina un campo obligatorio, lo que provoca que la canalización de elegibilidad de clientes genere decisiones incompletas» ofrece a los responsables de la respuesta mucha más orientación que «desviación de esquema».
Utilizar campos operativos
Cada entrada necesita detalles suficientes para priorizar el trabajo y respaldar una respuesta:
Descripción del riesgo: Indique el fallo y su consecuencia empresarial.
Gravedad: Describa el impacto si el suceso llega a un consumidor. Utilice los niveles crítico, alto, medio o bajo, con definiciones acordadas internamente.
Probabilidad: Basarse en el historial observado, el comportamiento de la fuente, la frecuencia de los cambios y la complejidad del proceso, más que en la intuición.
Propietario: Asigne a la persona o al equipo capaz de investigar y coordinar la solución.
Mitigación: Indique la acción de comprobación, puerta de control, alternativa, conciliación o escalado.
Evidencia: Almacene el historial de alertas, los resultados de validación, el linaje y las notas de resolución.
Estado de revisión: Registre si el control está activo, genera ruido, falta o está en fase de reevaluación.
El registro debe distinguir un problema de origen de un problema de detección. Si una entrega se retrasa, el equipo de origen puede ser el responsable de la solución, mientras que el equipo de la plataforma se encarga de la supervisión de la Timeliness. Esta división mantiene la rendición de cuentas precisa y evita que una alerta se convierta en un sustituto de una solución.
Para los campos de alta prioridad, un catálogo de elementos de datos críticos puede ayudar a los equipos a centrar los controles en los registros y atributos que tienen más probabilidades de afectar a las decisiones.
Ejemplos de entradas en el registro de riesgos de calidad de datos
Descripción del riesgo | Gravedad | Probabilidad | Propietario | Estrategia de mitigación |
|---|---|---|---|---|
Se elimina o renombra una columna ascendente obligatoria, lo que interrumpe las transformaciones descendentes | Alto | Medio | Equipo de la plataforma de datos | Realizar un seguimiento de los cambios de esquema, probar la compatibilidad y detener las tareas dependientes cuando el cambio infrinja el contrato |
La canalización crítica llega después de la ventana de informes de su consumidor | Alto | Medio | Propietario del sistema de origen | Supervisar los patrones de llegada, calcular el tiempo estimado de entrega y escalar las cargas omitidas |
La regla de negocio difiere entre los sistemas operativos y los analíticos | Alto | Medio | Propietario del dominio de datos | Ejecutar la validación a nivel de registro y conciliar los resultados entre sistemas |
La frescura disminuye sin que falle la tarea | Medio | Medio | Equipo de ingeniería de análisis | Supervisar la entrega y actualizar los umbrales cuando cambie el comportamiento de la fuente |
Los campos opcionales pasan a ser inesperadamente nulos en una población de origen | Medio | Bajo | Administrador de datos | Realizar un seguimiento de las distribuciones, investigar el cambio de origen y documentar las excepciones aceptadas |
Trate el registro como un documento de control activo, no como un documento de governance único. Revíselo cuando cambie una fuente, un método de integración, un modelo o un proceso empresarial. Los productos de datos integrados pueden introducir riesgos a través de la vinculación, la armonización o el modelado, no solo a través de la fuente original. Un cambio de esquema, una carga tardía o un cambio de distribución deben actualizar la entrada de riesgo correspondiente, su evidencia o su propietario.
El registro se gana su lugar cuando impulsa la configuración de la supervisión, los debates sobre la propiedad y las revisiones de incidencias. Debe mostrar qué riesgos tienen controles activos, qué alertas crean ruido y qué lagunas requieren aún trabajo de ingeniería. Esa conexión hace que el equipo pase de la extinción reactiva de incendios al control continuo.
Estrategias de supervisión que detectan los riesgos a tiempo
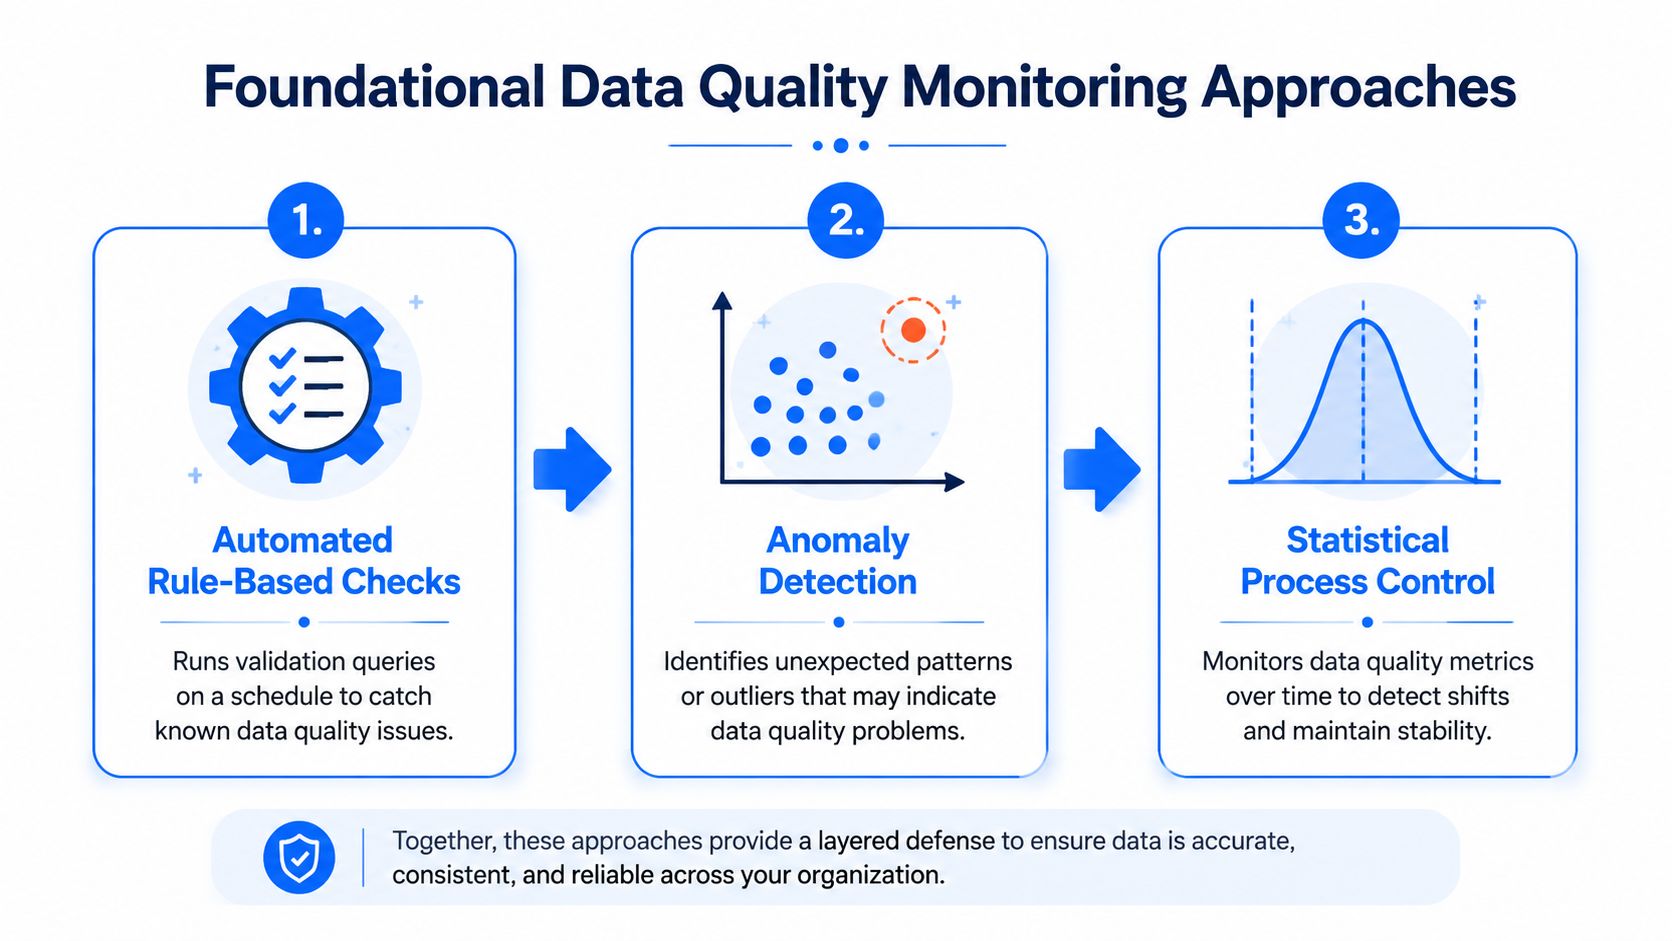
Una canalización puede estar en verde mientras los consumidores reciben datos inutilizables. La supervisión de la producción necesita varias capas: reglas deterministas para las infracciones conocidas, detección de anomalías para el comportamiento desconocido, comprobaciones de Timeliness para el riesgo de entrega y seguimiento de esquemas para los contratos estructurales.
Detección de anomalías
El aprendizaje de referencia resulta útil cuando los ingenieros no pueden redactar una regla para cada patrón válido. Los monitores pueden examinar el volumen, el comportamiento nulo, las distribuciones y las métricas de negocio y, a continuación, marcar las desviaciones significativas del comportamiento establecido del conjunto de datos.
Un valor inusual no es automáticamente una incidencia. La estacionalidad, los Release planificados, las adquisiciones y los sucesos legítimos de negocio pueden desviar una línea de base. Separe las métricas técnicas de las de negocio, adjunte el contexto operativo a las alertas y deje que los propietarios etiqueten los sucesos como previstos o imprevistos. Esas decisiones mejoran las investigaciones posteriores sin convertir cada excepción en una regla manual permanente.
Supervisión de la Timeliness
Una carga puede realizarse correctamente pero llegar demasiado tarde para los consumidores. Realice un seguimiento del patrón de llegada de cada conjunto de datos crítico, incluidas las entregas que falten, las tardías y las inesperadamente tempranas. Calcule una ventana de entrega estimada a partir del comportamiento observado y, a continuación, establezca la respuesta de acuerdo con el plazo del consumidor.
Un canal de información tardío puede justificar una advertencia cuando un cuadro de mando descendente tiene una alternativa. Ese mismo retraso puede requerir un escalado cuando afecte a la presentación de informes regulados o al cálculo de riesgos. Los mensajes de alerta deben incluir la última llegada con éxito, la ventana prevista, los productos afectados y el propietario que puede confirmar el estado de la fuente.
Los equipos que estén formalizando el diseño de notificaciones pueden utilizar esta guía de alertas en tiempo real para estructurar las alertas en torno al encargado de responder adecuado y reducir el ruido evitable.
Supervisión de cambios de esquema
La desviación del esquema crea incidencias confusas porque una fuente puede seguir estando disponible mientras los consumidores interpretan su salida de forma incorrecta. Realice un seguimiento de las columnas añadidas y eliminadas, los campos renombrados, las modificaciones de tipos de datos y los cambios que infrinjan un contrato documentado.
Una adición compatible puede necesitar revisión sin requerir una interrupción del servicio. La eliminación de un campo obligatorio o el cambio de un tipo deberían pausar, por lo general, el procesamiento dependiente hasta que el propietario confirme el impacto. Guarde el esquema antes y después con la alerta para que los ingenieros no tengan que reconstruir el cambio a partir de los registros de implementación.
Estas señales son más útiles en una única vista operativa. Un enfoque de supervisión y reporte de datos debe mostrar la anomalía, el historial de entregas, el suceso de esquema, el activo afectado y el estado actual de la incidencia de forma conjunta. La herramienta importa menos que mantener el contexto desde la detección hasta la resolución, de modo que los equipos puedan sustituir la extinción reactiva de incendios por un control continuo.
Diseño de controles y flujos de trabajo de escalado
Una alerta se convierte en control únicamente después de que el equipo defina la respuesta, la disposición de los datos, el propietario responsable y la evidencia requerida para el cierre. Sin esas decisiones, la supervisión produce notificaciones pero no limita la exposición descendente.
Utilice controles estrictos cuando los datos no válidos no deban propagarse. Una canalización puede rechazar un registro con una relación imposible, pausar una publicación descendente cuando desaparece un campo de esquema obligatorio o poner en cuarentena un lote que infringe un contrato crítico. Utilice controles flexibles para actividades inusuales pero potencialmente legítimas, como un cambio inesperado en el volumen de negocio que requiera una revisión humana en lugar de un bloqueo automático.

Colocar la validación cerca de los datos
Las comprobaciones a nivel de registro imponen reglas que las métricas agregadas no pueden probar. Valide los campos obligatorios, los valores permitidos, las relaciones entre entidades, las fechas de entrada en vigor, las condiciones duplicadas y los requisitos normativos o contractuales. Realice estas comprobaciones en la base de datos cuando sea práctico. Mantener el cálculo cerca de los datos reduce el movimiento, respeta los límites de seguridad y evita cargar tablas grandes en la memoria de la aplicación.
Un patrón de ingeniería práctico combina un marco estandarizado para las expectativas de esquema con SQL directo para comprobaciones de reglas de negocio de gran tamaño. SecurityScorecard describe el uso de Great Expectations para la validación de esquemas, DataHub para la visibilidad centralizada y Apache Airflow para la orquestación. Su equipo colocó las comprobaciones de las reglas de negocio en SQL del lado de la base de datos en lugar de recuperar tablas muy grandes en Python (cuenta de validación de canalización).
Principio de diseño de control: Detenga la canalización cuando el daño comercial previsto de la propagación supere el coste operativo de bloquearla.
Dirigir las alertas por impacto
Una ruta de escalado útil registra cuatro decisiones:
Incidencia detectada: Capture la comprobación exacta, el valor observado, el comportamiento esperado, la marca de tiempo y el activo afectado.
Alerta al equipo: Notifique al propietario que puede investigar, en lugar de a un canal general sin un responsable que responda de forma directa.
Análisis de impacto: Identifique los informes descendentes, los modelos, los consumidores y los procesos normativos.
Ticket de resolución: Registre la solución, la disposición de los datos, la causa raíz y la evidencia que respalda el cierre.
Avise al ingeniero de guardia o al propietario de los datos sobre sucesos que puedan corromper productos críticos. Envíe las desviaciones de menor impacto a una cola de revisión. La misma urgencia para todo enseña a quienes deben responder a ignorar el sistema.
Los equipos que estén formalizando la propiedad y las rutas de respuesta pueden utilizar esta guía de soporte para el escalado para definir rutas y responsabilidades. Una vista compartida de las incidencias debe conservar las cuestiones abiertas, los activos afectados, el historial de recurrencia y el estado actual, ofreciendo a los ingenieros, analistas y partes interesadas las mismas evidencias operativas.
Validar supuestos estadísticos
La detección de anomalías requiere criterio. Un flujo de trabajo de calidad estadística debe aclarar los objetivos del proyecto y el diseño del muestreo, revisar los datos, seleccionar un método adecuado, verificar sus supuestos y, a continuación, extraer conclusiones (flujo de trabajo de calidad estadística).
Esta secuencia limita los falsos positivos y los falsos negativos provocados por una mala interpretación de los datos. Los valores atípicos, las omisiones no aleatorias, la estacionalidad o un marco de muestreo inadecuado pueden parecer fallos de calidad cuando en realidad reflejan el proceso de medición. Elija el método válido más sencillo, documente sus supuestos y exija una revisión cuando estos dejen de cumplirse.
Medir la eficacia del programa e iterar
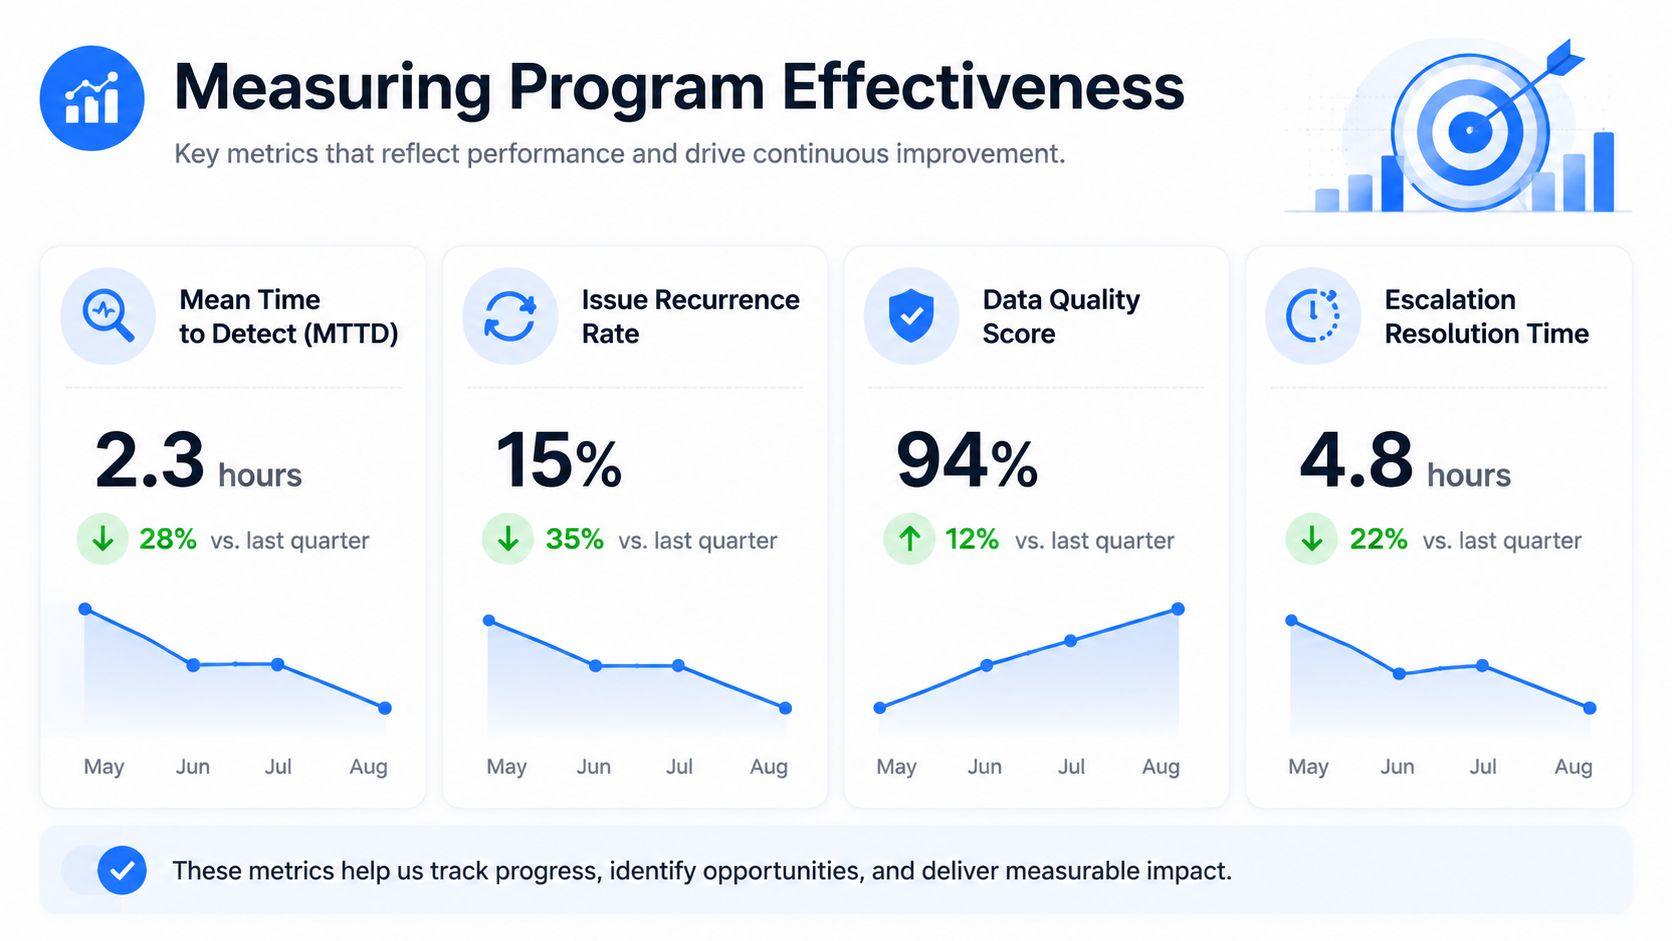
Un programa de calidad se gana su lugar en la producción reduciendo la exposición, acortando la respuesta o haciendo visible la incertidumbre. Una puntuación alta en el cuadro de mando por sí sola demuestra poco. Las medidas deben conectar la detección, la investigación, el comportamiento de control y el impacto empresarial.
Realice un seguimiento del tiempo medio de detección, el tiempo medio de resolución, la recurrencia, la tasa de falsos positivos, la cobertura de activos críticos y la proporción de incidencias con un propietario identificado. Segmente los resultados por gravedad y producto de datos. De lo contrario, muchas comprobaciones de bajo impacto pueden enmascarar un flujo crítico con controles deficientes. Un marco práctico de métricas de calidad de datos puede ayudar a estandarizar estas medidas en todos los productos.
Medir la calidad de la señal, no el volumen de alertas
Una alerta rápida sigue creando trabajo de investigación si carece de contexto. Compruebe si cada notificación identifica la tabla afectada, el comportamiento modificado, la línea de base esperada, el propietario probable y la ruta de solución disponible. Las alertas repetidas para un patrón estacional aceptado suelen indicar un problema de umbral o de línea de base.
Revise los datos históricos de Observability para detectar la volatilidad, los fallos recurrentes y el deterioro gradual. Utilice esos patrones para ajustar el alcance de la supervisión y la fuerza del control. No amplíe los umbrales simplemente para suprimir el ruido. Registre el riesgo que acepta el umbral más amplio y, a continuación, verifique que la compensación sigue siendo razonable.
El problema de la confianza puede persistir después de implementar la Observability. Un informe BARC de 2025 reveló que el 42% de las organizaciones seguían sin confiar en los resultados de IA/ML, mientras que el 58% había implementado u optimizado programas de Observability de datos (debate de la encuesta BARC). Por lo tanto, la supervisión es necesaria pero insuficiente. Los equipos necesitan señales de anomalías junto con la supervisión de la Timeliness, el seguimiento de esquemas y la validación a nivel de registro para explicar por qué se debe confiar en un modelo o cuadro de mando.
Revisar el registro como un artefacto de control
Las revisiones de incidencias deben actualizar la probabilidad, la gravedad, la propiedad y el estado de mitigación. Añada un riesgo cuando una fuente introduzca un nuevo método de integración o cambie un proceso empresarial. Retire un control únicamente después de que se haya eliminado el riesgo subyacente, no solo porque las alertas hayan cesado.
La encuesta de KPMG Global Third-Party Risk Management Survey de 2026 informó de que solo el 17% de las organizaciones describían la calidad de sus datos en el nivel más alto. También reveló que el 52% de los encuestados con datos de alta calidad tenían mucha confianza en las decisiones de gestión de riesgos, en comparación con el 40% de los encuestados con una calidad de datos deficiente que no tenían confianza (encuesta de KPMG). La implicación operativa es directa: una calidad de datos deficiente reduce la confianza en las decisiones, incluidos los flujos de trabajo de riesgo automatizados.
Cada incidencia es una evidencia sobre el sistema de control. El objetivo es una detección más rápida y precisa de los fallos consecuentes, con un registro claro de cómo respondió la organización.
Primeros pasos con su programa de riesgo de calidad de datos
Comience con un producto de datos crítico, no con un ejercicio de inventario para toda la empresa. Nombre a sus consumidores, documente las decisiones que respalda, enumere sus dependencias ascendentes y registre los modos de fallo que los ingenieros ya conocen. A continuación, seleccione un pequeño conjunto de controles que cubra diferentes riesgos, como la detección de anomalías para el comportamiento, la supervisión de la Timeliness para la entrega, el seguimiento de esquemas para la estructura y la validación a nivel de registro para la lógica de negocio.
La primera línea de base debe ser observable y revisable. Capture el comportamiento normal de llegada, el volumen previsto, las distribuciones importantes, los campos obligatorios y el esquema actual. Defina quién recibe las alertas y cuándo un fallo bloquea la publicación. Si el equipo no puede explicar la respuesta, la comprobación no está lista para producción.
Ampliar en incrementos controlados
Un despliegue modular permite a los equipos aprender sin crear una superficie de alerta inmanejable:
Comience con el activo de mayor consecuencia: Elija el conjunto de datos donde el fallo afectaría a las decisiones, a la Compliance o a las operaciones con los clientes.
Añada una capacidad de supervisión: Empiece por la Timeliness o la detección de anomalías si el problema principal es el cambio silencioso de comportamiento. Añada controles de esquema y validación a medida que el mapa de fallos sea más claro.
Realice comprobaciones cerca de la fuente: La ejecución en la base de datos limita el movimiento innecesario y mantiene los datos confidenciales dentro del entorno del cliente.
Revise cada alerta: Etiquete los cambios previstos, ajuste los umbrales y convierta los hallazgos recurrentes en controles documentados.
Amplíe la cobertura de forma deliberada: Añada activos cuando una nueva fuente, modelo, informe o proceso regulador cree un riesgo material.
Los requisitos de implementación importan en entornos regulados. Una plataforma que se ejecuta dentro de una nube privada, VPC o centro de datos puede admitir el control local de los datos de producción. Las comprobaciones en la base de datos pueden alinearse con los requisitos de seguridad, mientras que los métodos estadísticos combinados con el aprendizaje automático pueden adaptar la detección de anomalías a la línea de base de cada conjunto de datos. Un modelo de precios que evite los cargos por llamadas a la API o volumen de alertas también puede facilitar la previsión de la expansión, aunque los equipos deben definir el alcance de las tablas activas y la propiedad antes de incorporar más datos.
La gestión de riesgos de calidad de datos tiene éxito cuando pasa a formar parte de las rutinas de Release, incidencias y gestión de cambios. Trate la calidad como un sistema de control continuo, y los equipos podrán detectar canales de información desactualizados, esquemas inestables, comportamientos inusuales y registros no válidos antes de que esos fallos se conviertan en incidencias de negocio.
digna proporciona una plataforma empresarial de calidad y Observability de datos que se ejecuta dentro de su entorno, combinando la detección de anomalías, la supervisión de la Timeliness, el seguimiento de esquemas, la validación a nivel de registro y el análisis histórico. Visite digna para evaluar un punto de partida modular para convertir los riesgos críticos de calidad de datos en controles continuos y procesables.


