Fiabilidad de la calidad de datos: cómo la miden los equipos en realidad
|
8
minuto de lectura

El lunes por la mañana empieza con un éxito familiar. El panel de ingresos carga, los totales cuadran con finanzas y todos los gráficos están en verde antes de la reunión de dirección. Nadie ve que las transacciones móviles tardías todavía se están recuperando, que un proceso de sesionización ha perdido particiones y que un campo renombrado produce muchos más nulos que su línea base. El panel parece fiable porque la salida visible se ha renderizado, no porque la cadena de entrega haya seguido siendo fiable.
Esa distinción importa cuando la analítica, las operaciones y los sistemas de IA consumen las mismas canalizaciones. La fiabilidad de la calidad de datos no es una lista de verificación aplicada a una tabla a posteriori. Es una propiedad operativa de toda la cadena, que incluye frescura, completitud, comportamiento del esquema, validez, linaje y gobernanza. Esta guía trata la fiabilidad como un asunto de producción y muestra cómo medirla sin convertir cada despliegue en un cuello de botella de pruebas manuales.
Índice de contenidos
El fallo oculto detrás de paneles de aspecto fiable
Por qué calidad y fiabilidad no son lo mismo
El error de inversión
Las métricas que realmente miden la fiabilidad
Comprobaciones por reglas, comprobaciones estadísticas y detección de anomalías con IA
Apílelas por grado de certeza
Observabilidad, comprobaciones in-database y validación trabajando juntas
Salvaguardas operativas que evitan que los programas de fiabilidad se estanquen
Dirija las alertas al producto de datos
Separe los niveles de servicio
Mantenga los controles en la ruta de entrega
Qué exige realmente una fiabilidad de datos preparada para la IA
Siga la cadena completa de entradas de IA
Cómo encajarlo todo y qué viene después
El fallo oculto detrás de paneles de aspecto fiable
El primer problema aparece en el flujo de eventos. Una versión móvil cambia la forma de emitir las transacciones, de modo que algunos registros llegan tarde en lugar de dentro de la ventana de procesamiento prevista. El trabajo de ingesta termina con éxito porque recibió datos, pero los datos no están completos en el momento en que los consumidores posteriores los leen.
A continuación, la sesionización procesa las particiones disponibles. Faltan tres y, aun así, la transformación produce una tabla. Los recuentos diarios de filas se mantienen dentro de un rango histórico amplio porque el tráfico de escritorio enmascara el hueco móvil. La actualización del panel se completa y sus totales aún pueden cuadrar con finanzas si finanzas recibe una recuperación posterior o usa otro corte.
El tercer fallo es estructural. Un campo aguas arriba se renombra y la transformación conserva la columna mediante una ruta de compatibilidad. La tasa de nulos del campo sube, pero ninguna alerta compara el cambio con una línea base conocida. Las características de atribución contienen ahora menos información utilizable, mientras el modelo de churn sigue entrenándose como si la característica conservara su significado anterior.
Un panel en verde demuestra que una consulta se ejecutó y devolvió un resultado. No demuestra que llegaran los datos correctos, que cada transformación se comportara correctamente ni que los consumidores los recibieran dentro de la ventana exigida.
Por eso los equipos pueden confiar en la superficie visual y aun así tomar decisiones poco fiables. Un informe puede ser numéricamente coherente con un sistema de referencia y seguir siendo incompleto, obsoleto o semánticamente dañado para otro caso de uso. Un modelo también puede absorber la degradación mucho antes de que alguien note un error visible en el reporte.
La respuesta práctica es monitorizar la cadena de entrega, no solo la tabla final. Un panel necesita evidencia de frescura, completitud de particiones, historial de esquema, contexto de linaje y una responsabilidad asignada para cada activo crítico aguas arriba. Los equipos que solo se fijan en los síntomas del panel pueden ampliar con los paneles de calidad de datos, pero la solución de fondo es identificar qué control falló antes de que el panel se volviera engañoso.
Por qué calidad y fiabilidad no son lo mismo
La calidad de datos describe si los datos cumplen las condiciones esperadas. Un valor puede ser válido, no nulo, correctamente tipado, dentro de un rango permitido y vinculado a un registro de referencia existente. Estas comprobaciones examinan el contenido y la estructura de los registros.
La fiabilidad de datos pregunta si los consumidores pueden depender de los datos a lo largo del tiempo y en todo el proceso de entrega. Incluye la calidad, pero también pregunta si llegaron los datos esperados, si la canalización los puso a disposición dentro de su ventana de servicio, si se conoce su linaje y si los cambios se comunicaron y controlaron.
La analogía del ladrillo concreta la diferencia. La calidad pregunta si cada ladrillo es sólido y tiene la forma correcta. La fiabilidad pregunta si el muro llega a tiempo, contiene todas las hiladas, tiene un origen conocido y sigue en pie cuando cambian las condiciones.
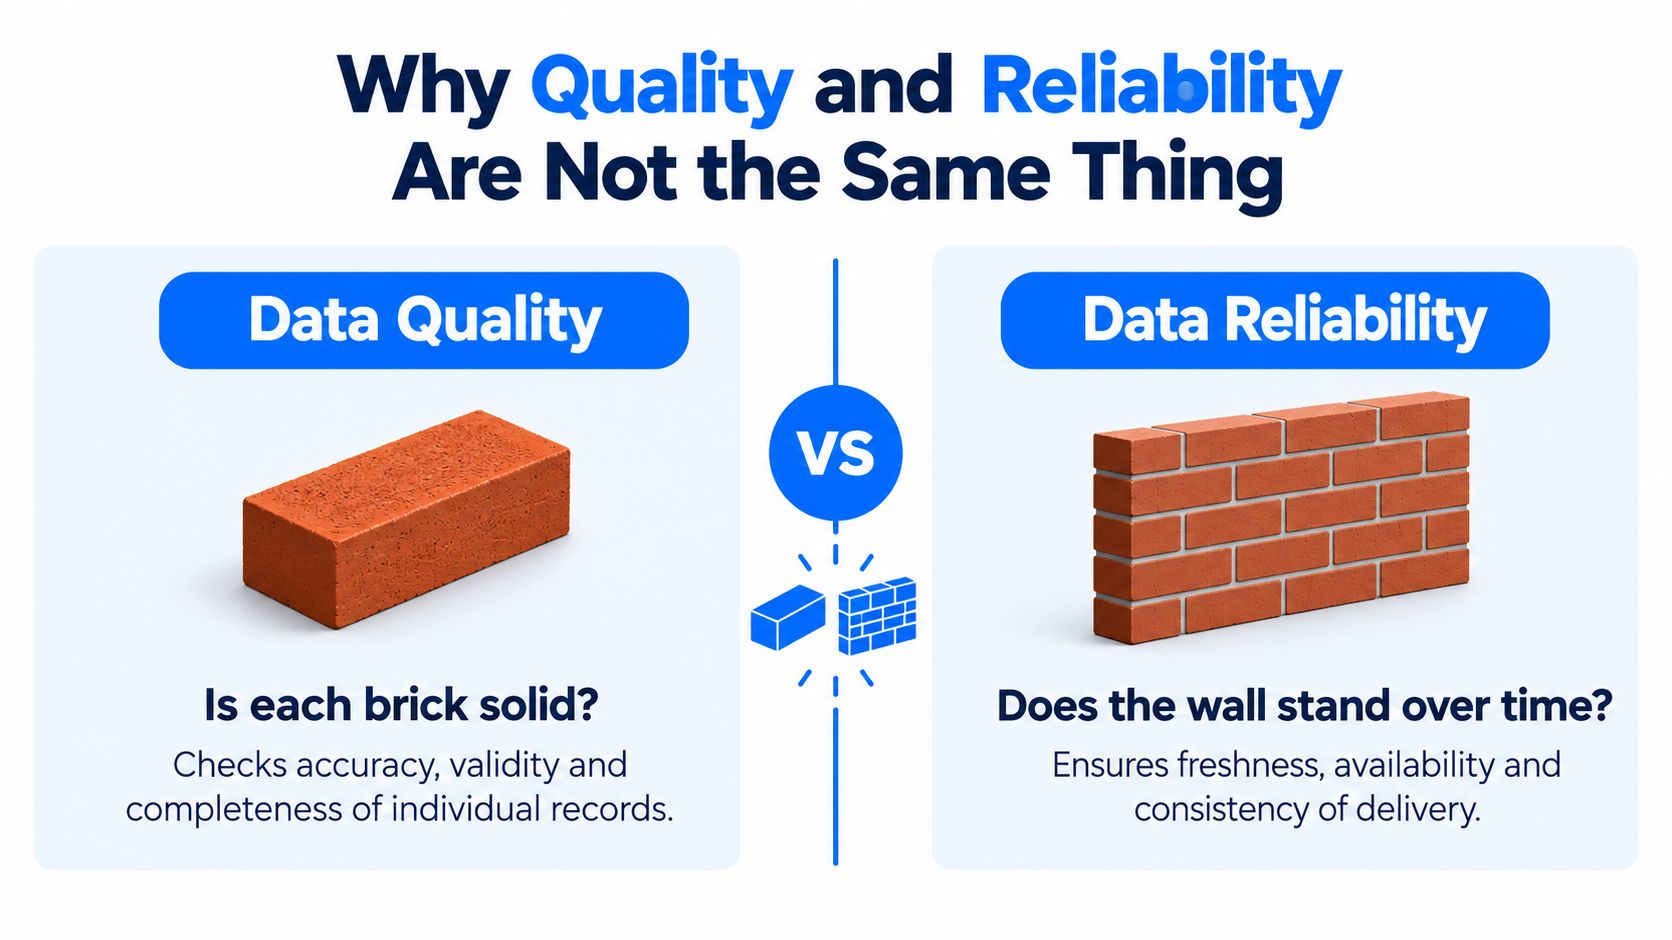
Una tabla puede superar la validación a nivel de fila y fracasar como producto fiable. Cada registro recibido puede tener un identificador de cliente válido y, aun así, faltar una partición entera. Un validador de esquema puede confirmar que existe una columna, mientras el linaje está roto y nadie sabe qué origen la produjo. Un conjunto de datos puede ser exacto en reposo y seguir siendo demasiado obsoleto para una decisión operativa.
El error de inversión
Cuando los equipos tratan calidad y fiabilidad como sinónimos, suelen comprar o construir los controles equivocados. Añaden más comprobaciones de nulos, aserciones de tipo y reglas de dominio mientras dejan sin definir las expectativas de frescura. Inspeccionan valores dentro del almacén, pero no monitorizan particiones tardías, duración de ejecución, dependencias aguas arriba ni impacto aguas abajo.
Eso crea un sistema de control desigual. Las comprobaciones deterministas protegen el ladrillo, mientras nadie verifica si el muro está completo o si llegó cuando el consumidor lo necesitaba. El resultado es una gran colección de pruebas superadas adosada a un producto poco fiable.
La fiabilidad necesita, por tanto, definiciones de servicio de extremo a extremo. Productor y consumidor deben acordar qué debe llegar, cuándo, con qué forma, con qué restricciones de negocio y con qué evidencia de linaje. La calidad a nivel de fila sigue siendo esencial, pero pasa a ser una parte del contrato de entrega en lugar de la definición completa de la confianza.
Las métricas que realmente miden la fiabilidad
La fiabilidad en producción se vuelve manejable cuando los equipos traducen las expectativas en señales observables. Cinco métricas cubren los principales modos de fallo: frescura, completitud, estabilidad de esquema, validez y deriva de distribución. No deben tratarse como valores universales de aprobado o suspenso. Cada umbral pertenece a un contrato que refleja la tolerancia del consumidor y el papel del activo.
La frescura mide la distancia entre la disponibilidad esperada de un evento y su llegada real. Una implementación útil compara marcas de tiempo de alto nivel con una ventana de nivel de servicio y alerta cuando una partición llega tarde o falta. Las guías técnicas sobre monitorización de frescura describen este enfoque basado en SLA, en lugar de tratar una marca de tiempo como prueba suficiente de salud.
La completitud compara lo que debería haber llegado con lo que llegó. La comprobación debe operar a nivel de partición o de unidad de entrega, porque un conjunto completo de filas dentro de un día incompleto puede producir igualmente un resultado engañoso. Una alerta puede activarse cuando falta una partición esperada o cuando el recuento entregado queda fuera de la banda operativa acordada.
La estabilidad de esquema sigue adiciones, eliminaciones, renombrados y cambios de tipo frente a una línea base o un contrato explícito. Estos cambios pueden romper transformaciones, alterar significados o aumentar tasas de nulos sin provocar un fallo inmediato de la canalización. Azure Databricks expone campos de deriva como count_delta, avg_delta, percent_null_delta, percent_zeros_delta, percent_distinct_delta y non_null_columns_delta, mostrando cómo los equipos pueden cuantificar cambios estructurales y de distribución en una tabla comparativa. La documentación de Azure Databricks sobre métricas de deriva explica este modelo de salida.
La validez comprueba los valores frente a restricciones y reglas de dominio. Cubre nulabilidad, rangos, categorías permitidas, formatos, expectativas de unicidad e integridad referencial. Una condición de alerta práctica puede ser cualquier violación de una restricción clave, mientras que las reglas más blandas pueden alertar cuando la tasa de fallos supera la tolerancia acordada con el consumidor.
La deriva de distribución mide el movimiento en el comportamiento de valores numéricos, categóricos y nulos. Detecta cambios que superan las reglas estáticas, como una categoría legítima que se vuelve inusualmente dominante o un campo normalmente poblado que se queda disperso. Los incidentes de deriva de esquema por encima del 5 % de los campos se han asociado a un aumento del 30 % en problemas de calidad de datos reportados por usuarios finales, según el análisis de incidentes de deriva de esquema de Integrate.io. Úselo como señal de riesgo, no como umbral universal de producción.
Métrica | Qué mide | Umbral habitual | Modo de fallo detectado |
|---|---|---|---|
Frescura | Latencia de llegada esperada frente a real | Una ventana de SLA definida, a menudo con aviso antes del incumplimiento duro | Cargas tardías, paneles obsoletos, características retrasadas |
Completitud | Registros o particiones esperados frente a entregados | Particiones requeridas presentes y volumen de entrega dentro de una banda acordada | Porciones ausentes, cargas parciales, eventos perdidos |
Estabilidad de esquema | Cambio estructural respecto a una línea base o un contrato | Sin cambios rupturistas no aprobados, con revisión de los cambios aditivos | Renombrados, eliminaciones, cambios de tipo, roturas aguas abajo |
Validez | Conformidad con restricciones y reglas de negocio | Las reglas críticas deben cumplirse, con tasas toleradas en reglas no críticas | Claves inválidas, valores imposibles, referencias erróneas |
Deriva de distribución | Movimiento estadístico a lo largo del tiempo | Alertar cuando el movimiento supera una línea base calibrada | Desplazamientos de población, picos de nulos, cambios de categoría |
Estas métricas forman un contrato entre productores y consumidores. La pregunta útil no es si un conjunto de datos tiene «buena calidad». Es si la cadena de entrega cumplió las condiciones que exigía una decisión, un modelo o un informe concretos. Los equipos pueden usar un marco práctico para medir la fiabilidad y conectar esas condiciones con la monitorización a nivel de activo.
Comprobaciones por reglas, comprobaciones estadísticas y detección de anomalías con IA
Ningún método de detección aislado ve todos los fallos. Las comprobaciones por reglas son más potentes cuando el comportamiento esperado es explícito. Una clave no nula, un valor de estado aprobado, una referencia válida o un patrón requerido se expresan con claridad y se evalúan de forma económica en las fronteras de ingesta o transformación.
Las comprobaciones estadísticas resuelven otro problema. Establecen una línea base para comportamientos que no pueden reducirse a una regla determinista, como el volumen de filas, el valor medio, la varianza, la cardinalidad, la proporción de nulos o el momento de llegada. Una regla puede decir que una columna no puede ser nula, mientras que una comprobación estadística puede notar que los nulos se han vuelto de pronto frecuentes aunque la columna siga técnicamente poblada.
La detección de anomalías aprendida por IA añade una tercera capa. Los modelos pueden combinar varias señales e identificar comportamientos correlacionados que el autor de las reglas no previó. Un desplazamiento simultáneo en volumen, frescura, distribución y consumo aguas abajo puede indicar un problema de despliegue incluso cuando ninguna señal individual cruza un límite fijado a mano.
Enfoque | Ideal para | Limitaciones | Capa |
|---|---|---|---|
Validación por reglas | Garantías contractuales y restricciones de negocio | Carga de mantenimiento cuando cambia la lógica, cobertura limitada del comportamiento desconocido | Fronteras de ingesta y transformación |
Comprobaciones estadísticas | Deriva, estacionalidad, volumen, latencia y cambios de distribución | Requiere una línea base útil y una calibración cuidadosa de los falsos positivos | Monitorización de conjuntos de datos y canalizaciones |
Detección de anomalías con IA | Riesgo correlacionado y emergente en múltiples señales | Menos explicable de inmediato y dependiente de un histórico representativo | Observabilidad y priorización entre señales |
Apílelas por grado de certeza
Empiece por reglas para condiciones que nunca deben violarse. Estas comprobaciones deben fallar de forma ruidosa cuando una clave rota o una referencia inválida harían insegura la salida. Coloque monitorización estadística alrededor de métricas que varían de forma natural y ajuste la sensibilidad con el histórico de incidentes en lugar de elegir un límite arbitrario.
La detección con IA se gana su sitio cuando el entorno ofrece suficiente contexto de comportamiento del que aprender. Debe proponer candidatos a investigación, no bloquear automáticamente cada canalización. La revisión humana sigue correspondiendo allí donde la anomalía tiene impacto material en el negocio, la línea base está cambiando o el sistema no puede explicar a qué consumidor afectará.
El enfoque adecuado de detección de anomalías para datos de series temporales depende del comportamiento de la señal y de la acción asociada a la alerta. Un aviso ruidoso sin responsable no es observabilidad. Es otra cola más que los ingenieros van a ignorar.
Observabilidad, comprobaciones in-database y validación trabajando juntas
Piense en una canalización que ingiere eventos desde Kafka, los transforma con dbt y sirve tablas curadas desde Snowflake. La fiabilidad mejora cuando el equipo trata la observabilidad, las comprobaciones in-database y la validación de negocio como una única capa de control repartida por esa línea temporal.
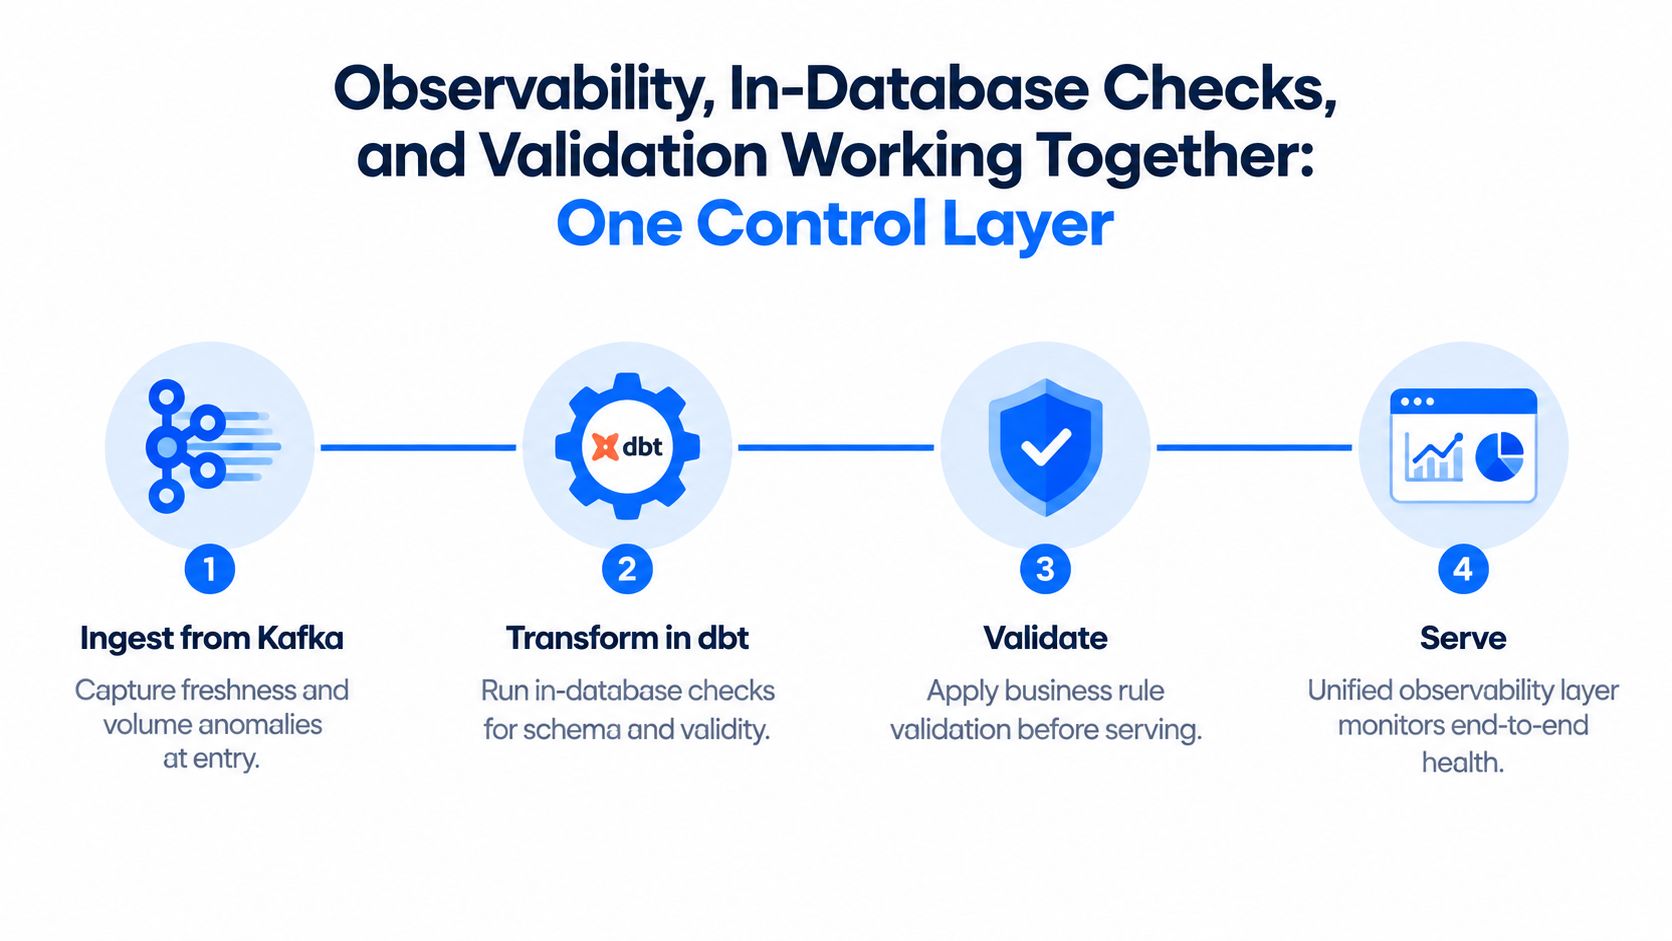
En la ingesta, comprobaciones ligeras comparan el momento de llegada y el volumen con el patrón esperado. Las restricciones nativas del almacén y las consultas programadas pueden detectar campos ausentes, tipos inesperados o recuentos anómalos cerca de donde residen los datos. Estas comprobaciones no explicarán todos los síntomas posteriores, pero pueden evitar que un problema estructural evidente se propague.
Durante la transformación, las pruebas de dbt hacen cumplir contratos de columna y supuestos de negocio. Mientras tanto, una capa de observabilidad vigila la duración de la ejecución, los recuentos de filas, la salud de las particiones, el linaje y el comportamiento de las dependencias. Si un modelo termina correctamente pero produce una relación inesperadamente pequeña, la telemetría de la canalización aporta un contexto que una aserción de columna por sí sola no puede dar.
Tras el servicio, el equipo compara el consumo aguas abajo con las expectativas aguas arriba. Un panel puede consultar con éxito y recibir a la vez una partición obsoleta, así que la línea temporal del incidente debe conectar la llegada tardía en Kafka, la ejecución de dbt, el estado de la tabla en Snowflake y el panel afectado.
Las comprobaciones in-database ven las infracciones donde viven los datos. La validación ve si los datos obedecen al significado de negocio. La observabilidad ve cómo se comportó el sistema que los rodea.
El punto de integración es un conjunto compartido de indicadores de nivel de servicio y un registro común de incidentes. Cada alerta debería identificar el activo, el productor, el consumidor, la condición incumplida, el primer momento observado y el linaje conocido. Las pautas sobre reglas de validación de datos y calidad de datos continua ayudan a definir la capa de reglas, pero el valor operativo aparece cuando esa capa comparte contexto con la monitorización de canalizaciones.
Sin contexto compartido, los equipos intercambian capturas entre herramientas y debaten si el fallo pertenece a Kafka, a dbt, a Snowflake o al panel. Con una sola línea temporal, pueden separar el desencadenante del síntoma y asignar la remediación al equipo que controla el contrato correspondiente.
Salvaguardas operativas que evitan que los programas de fiabilidad se estanquen
Los programas de fiabilidad suelen estancarse por motivos organizativos antes de fallar técnicamente. Las alertas van a una cola de infraestructura, los responsables de los conjuntos de datos no están nombrados y cada equipo define «sano» de forma distinta. Las salvaguardas hacen explícito el modelo operativo.
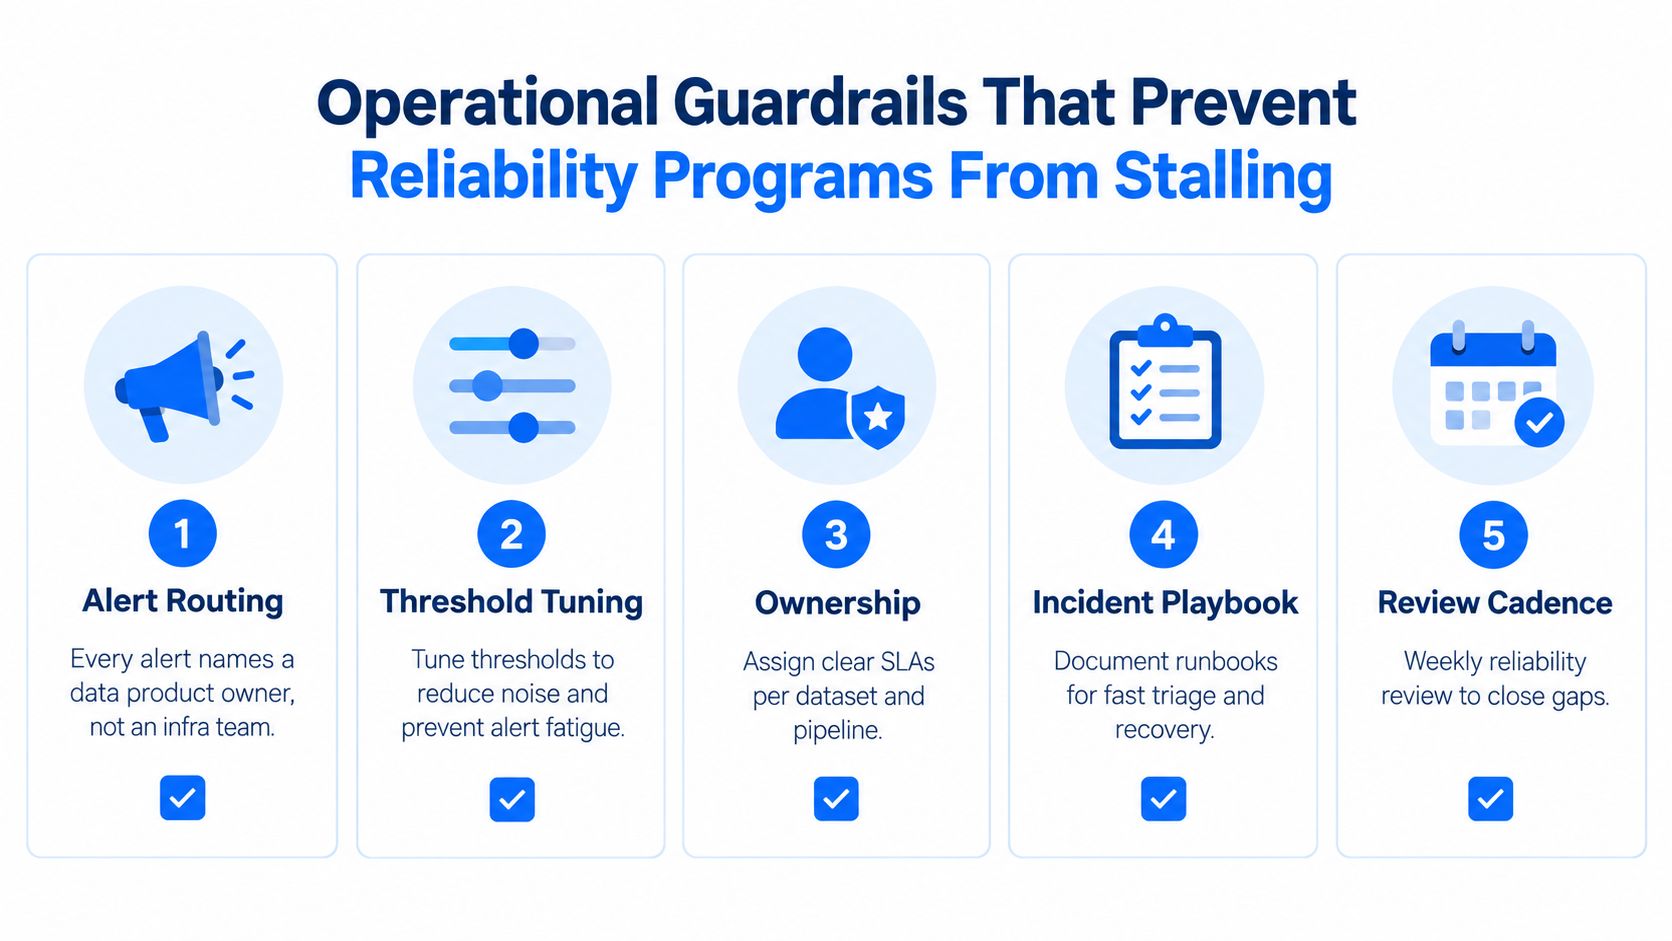
Dirija las alertas al producto de datos
Una alerta debe nombrar el producto de datos afectado, su responsable y su consumidor posterior. Los equipos de infraestructura pueden asumir las capacidades compartidas de ejecución y monitorización, mientras que los equipos de analítica embebida o de dominio asumen los conjuntos cuyo significado controlan. Una responsabilidad compartida sin un respondedor principal suele significar que nadie actúa rápido.
Separe los niveles de servicio
No condense todas las condiciones en una puntuación única ni en un solo «SLA de calidad de datos». Defina expectativas separadas para:
Frescura: el retardo de ingesta permitido, con una ventana de aviso antes del incumplimiento duro.
Corrección: la proporción exigida de registros que superan las reglas críticas de validación.
Disponibilidad: la finalización esperada de las ejecuciones programadas de la canalización.
Impacto: los consumidores y procesos de negocio afectados cuando se produce un incumplimiento.
Esta separación ayuda a los equipos a elegir la respuesta adecuada. Una tabla tardía pero por lo demás correcta puede necesitar una recuperación, mientras que una tabla de aspecto válido con integridad referencial rota puede necesitar cuarentena.
Mantenga los controles en la ruta de entrega
Las comprobaciones nativas del almacén, las pruebas de dbt, las puertas de cambio de esquema y las pruebas de contrato evitan que la fiabilidad se convierta en una fase de QA manual aparte. El flujo de monitorización documentado de AWS SageMaker separa la captura de datos, la creación de la línea base y los trabajos de monitorización programados, y su línea base usa Deequ para calcular restricciones de esquema y estadísticas. La documentación de AWS sobre monitorización de la calidad de datos del modelo ofrece un ejemplo concreto de cómo convertir expectativas en controles de producción programados.
Vigile tres antipatrones:
Paneles sin responsable: una página de estado visual sin respondedor genera conciencia sin acción.
Erosión de umbrales: los equipos amplían gradualmente los umbrales hasta que las alertas dejan de dispararse, en lugar de arreglar la línea base o el origen.
Teatro de la fiabilidad: las casillas satisfacen una auditoría mientras los datos tardíos, el linaje roto y los cambios de esquema sin revisar siguen afectando a los consumidores.
Revise la calidad de las alertas después de cada incidente. Si una alerta no llevó a una decisión, cambie su enrutamiento, su contexto, su umbral o su acción. El objetivo no es la máxima cobertura de monitorización. Es una detección fiable ligada a la recuperación.
Qué exige realmente una fiabilidad de datos preparada para la IA
La preparación para la IA no empieza cuando se despliega un modelo. Empieza con la evidencia de que las entradas, las características, el contexto de recuperación y las salidas siguen siendo fiables en condiciones de producción.
Los informes recientes dibujan la brecha con claridad. El 71 % de los profesionales de datos señala las salidas incorrectas o alucinadas que llegan a los stakeholders como una de sus principales preocupaciones, mientras que PwC halló que solo el 51 % de los encuestados establece una base de datos limpia y estructurada antes de escalar iniciativas digitales, según se resume en este informe sobre aceleración de la IA y confianza. Estas cifras apuntan a un problema operativo, no solo a un problema de evaluación de modelos.
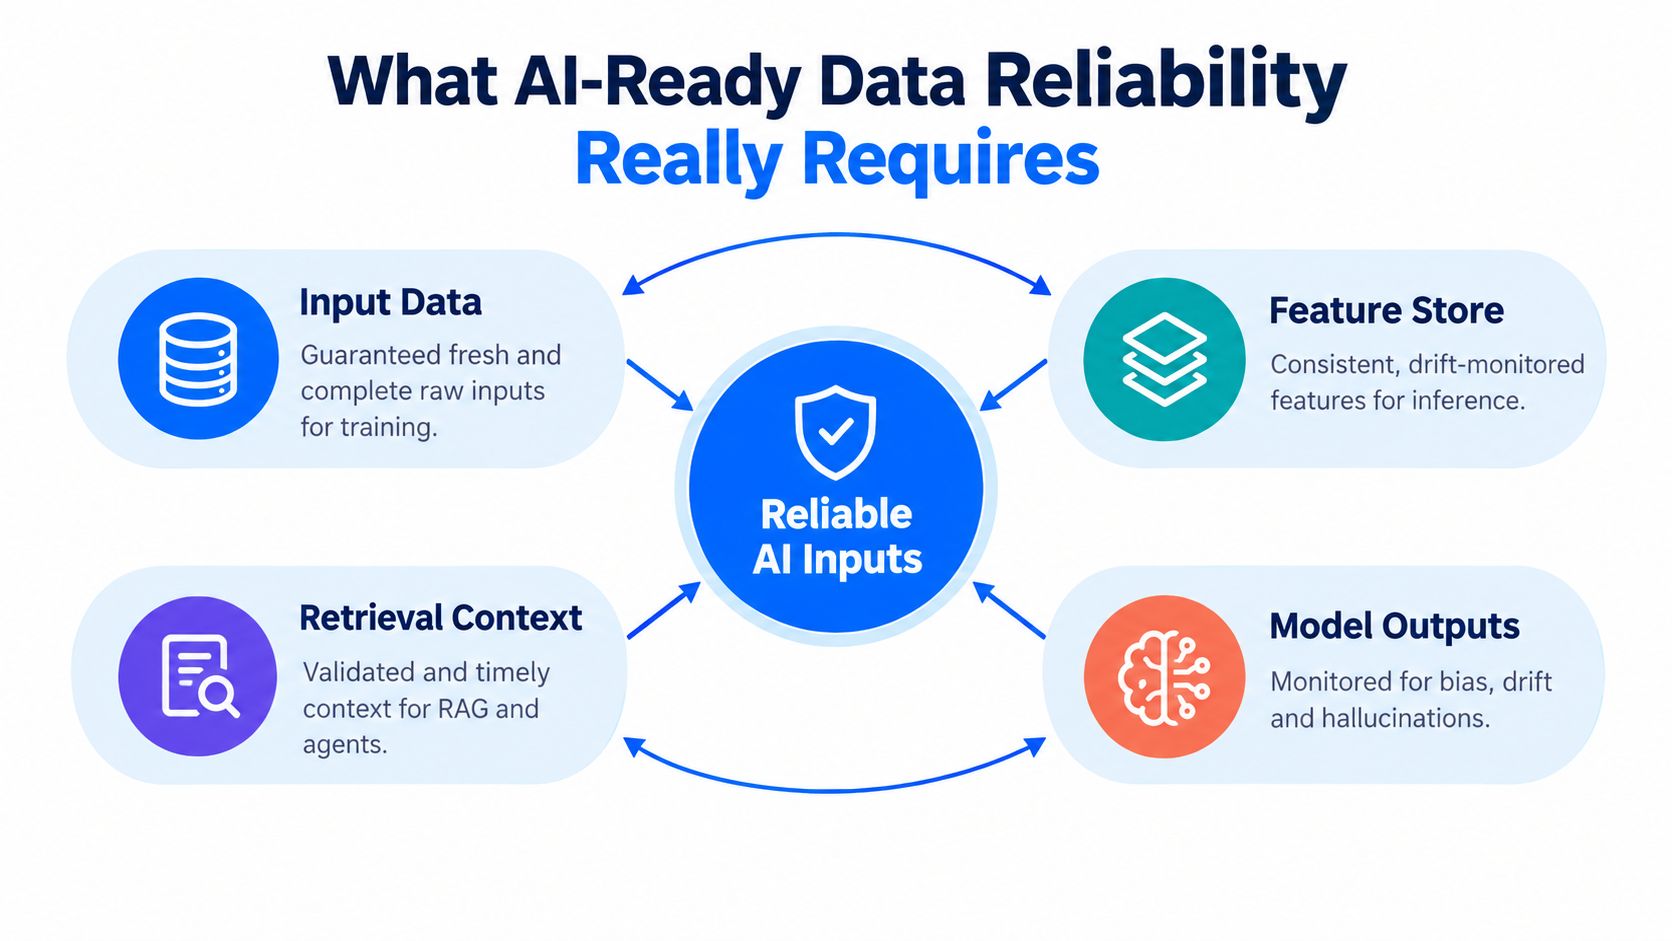
Siga la cadena completa de entradas de IA
Las entradas en bruto necesitan garantías de frescura y completitud. Los feature stores necesitan definiciones consistentes y monitorización de deriva alineada con las ventanas de inferencia. Los sistemas de generación aumentada por recuperación y los agentes necesitan un contexto validado y oportuno, incluida la evidencia de que los documentos no se han borrado, alterado ni obtenido de una ubicación no monitorizada.
El linaje debe conectar las características y el contenido recuperado con sus orígenes y transformaciones. Sin esa trazabilidad, una regresión de calidad del modelo puede convertirse en una investigación sin final definido. Los ingenieros necesitan saber si el cambio vino de los datos de origen, de la lógica de características, de la indexación, de la recuperación o del propio modelo.
Las salidas del modelo necesitan su propio bucle de retroalimentación. Monitorice señales de sesgo, deriva y alucinación allí donde puedan evaluarse y conecte después los fallos con las condiciones de los datos aguas arriba. Las puertas de promoción deberían bloquear o pausar una versión cuando los SLA de entrada críticos se incumplen, en lugar de dejar que un modelo consuma características que ya se sabe obsoletas.
El marco de ETSI refleja esta visión más amplia al definir 18 métricas medibles de calidad de datos que incluyen fiabilidad, cobertura, linaje, trazabilidad y puntualidad, según la fuente citada. La preparación para la IA se desprende, por tanto, del programa de fiabilidad que ya protege la analítica y las operaciones. No es un ejercicio de cumplimiento aparte ni una casilla final de exactitud. El principio que subyace a la relación entre los modelos de IA y la calidad de datos es operativo: unas entradas poco fiables producen un comportamiento posterior poco fiable, aunque el modelo en sí no haya cambiado.
Cómo encajarlo todo y qué viene después
Un primer sprint de fiabilidad debe ser lo bastante acotado para terminarlo y lo bastante importante para que cuente. Elija un conjunto de datos crítico para los ingresos, mapee sus dependencias aguas arriba y aguas abajo y defina las condiciones que lo hacen seguro para su consumidor principal.
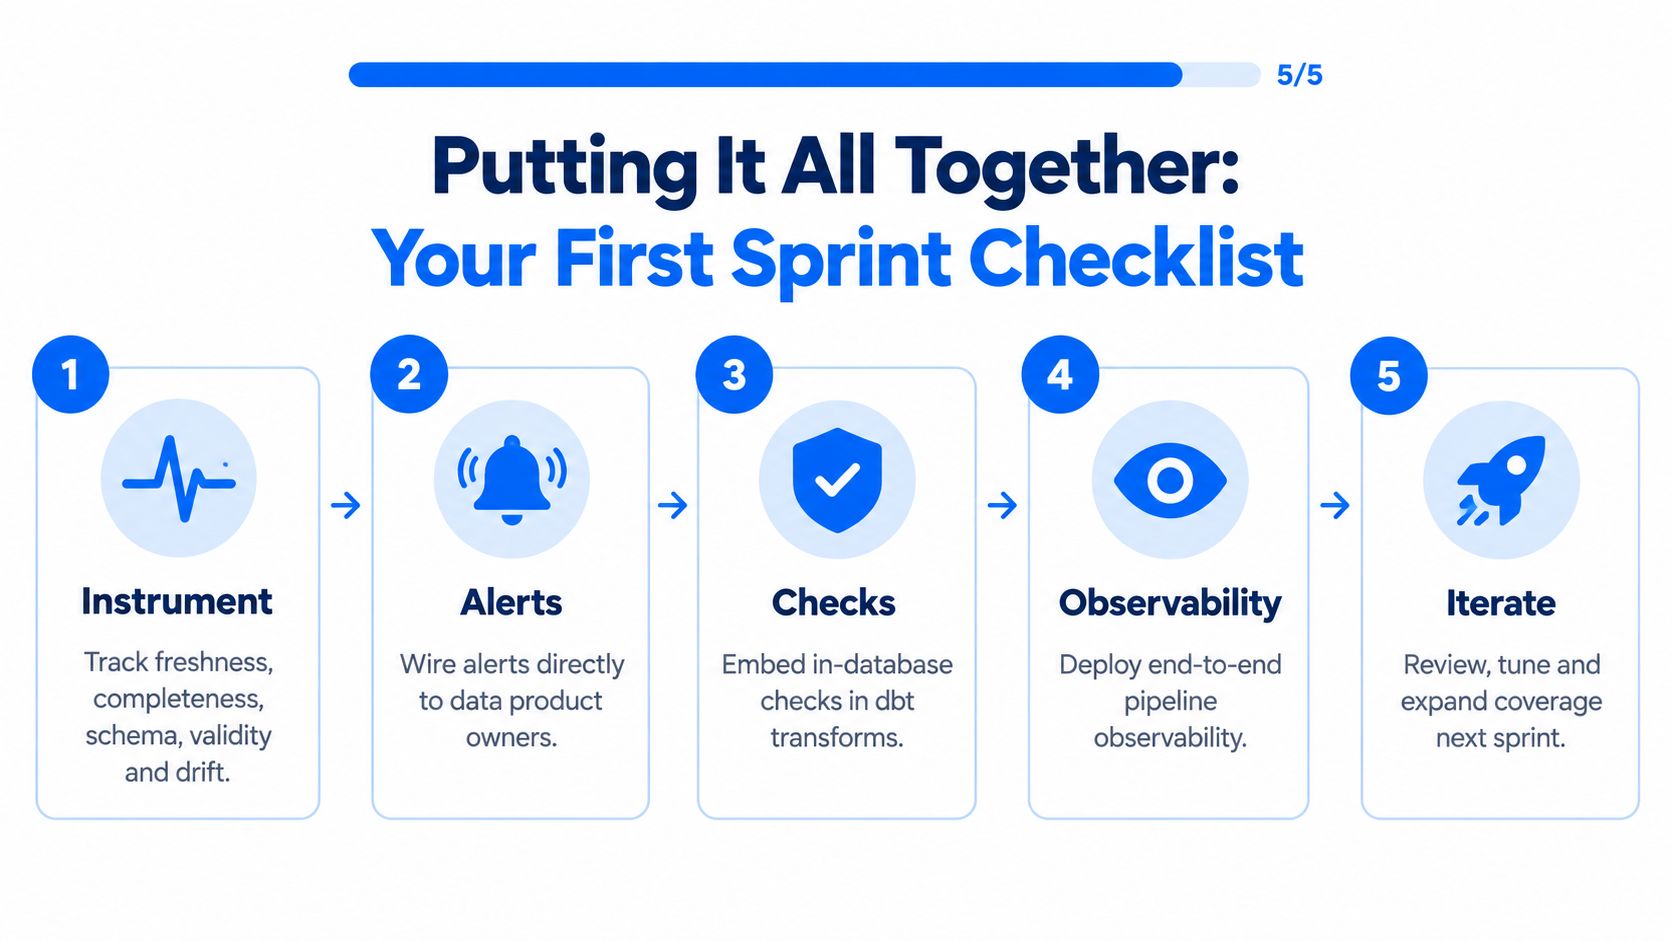
Siga esta secuencia:
Instrumente la cadena: haga seguimiento de frescura, completitud, estabilidad de esquema, validez y deriva de distribución.
Asigne la respuesta: dirija cada alerta a un responsable nombrado del producto de datos e identifique al consumidor afectado.
Codifique el contrato: documente las expectativas de frescura, corrección y disponibilidad del activo.
Coloque las comprobaciones con criterio: use reglas deterministas para garantías firmes, comprobaciones estadísticas para la deriva y detección aprendida para anomalías correlacionadas.
Extienda la protección a las entradas de IA: aplique los mismos controles a los datos de características, al contexto de recuperación y a los conjuntos que alimentan modelos.
El mercado avanza hacia la garantía cuantificada más que hacia un lenguaje vago de confianza. El reto operativo es hacer que esas mediciones sean utilizables entre equipos, canalizaciones, almacenes y métricas de negocio. Los cuadros de mando de fiabilidad compartidos y los SLO entre equipos resultan más útiles que los paneles aislados de cada herramienta porque conectan la salud técnica con las decisiones que dependen de ella.
Los equipos siguen enfrentándose a un cuello de botella de pruebas manuales. Las encuestas indican que el 61 % depende de comprobaciones manuales o validación basada en SQL, mientras que solo el 27 % usa una plataforma de observabilidad dedicada y el 14 % aplica SLA en toda la organización, según el informe de tendencias de calidad de datos y observabilidad 2025 de Integrate.io. La respuesta práctica no es probarlo todo a mano. Es automatizar la evidencia en el momento de la entrega, dar un responsable a cada control y tratar un incumplimiento en un activo crítico como un incidente de producción.
Elija ese conjunto de datos esta semana. Defina tres métricas de fiabilidad, asigne un responsable y revise el primer incumplimiento como un incidente con línea temporal y plan de remediación, no como un ticket de datos corriente.
digna ofrece una plataforma empresarial de calidad de datos y observabilidad que se ejecuta dentro de su entorno y combina validación in-database, monitorización de Timeliness, seguimiento de esquemas y detección de anomalías en almacenes, lagos y canalizaciones. Para integrar estos controles en un programa práctico de fiabilidad para analítica e IA, visite digna y explore la plataforma.
Para ver estos mismos controles organizados por el fallo que previene cada uno, y no por la métrica que lo mide, consulte los ocho casos de uso de observabilidad de datos y el responsable y la ruta de respuesta asociados a cada uno.
Preguntas frecuentes
¿Cuál es la diferencia entre calidad de datos y fiabilidad de datos?
La calidad pregunta si cada registro cumple: válido, no nulo, correctamente tipado, dentro de rango. La fiabilidad pregunta si los consumidores pueden depender del conjunto a lo largo del tiempo, incluido si las particiones esperadas llegaron dentro de la ventana de servicio con un linaje conocido. El ladrillo puede ser sólido mientras al muro le faltan hiladas.
¿Qué métricas miden realmente la fiabilidad de los datos?
Cinco cubren los principales modos de fallo: frescura, completitud, estabilidad de esquema, validez y deriva de distribución. Ninguna debería ser un valor universal de aprobado o suspenso. Cada umbral pertenece a un contrato que refleja la tolerancia del consumidor, y la completitud conviene comprobarla por partición y no por fila.
¿Cuándo conviene usar detección de anomalías en lugar de comprobaciones por reglas?
Las reglas encajan con condiciones que nunca deben violarse, como una clave no nula o una referencia válida. Las comprobaciones estadísticas gestionan señales que varían de forma natural, entre ellas el volumen, la cardinalidad, la proporción de nulos y el momento de llegada. La detección con IA se gana su sitio en desplazamientos correlacionados entre varias señales que ningún autor de reglas previó.
¿Por qué se estancan los programas de fiabilidad de datos?
Normalmente por razones organizativas antes que técnicas. Las alertas caen en una cola de infraestructura sin respondedor nombrado, cada equipo define «sano» a su manera y los umbrales se amplían hasta que nada se dispara. Vigile los paneles sin responsable, la erosión de umbrales y las casillas que satisfacen una auditoría mientras los consumidores siguen recibiendo datos tardíos.
¿Qué exige una fiabilidad de datos preparada para la IA?
Evidencia a lo largo de toda la cadena de entrada, y no una comprobación final de exactitud. Las entradas en bruto necesitan garantías de frescura y completitud, los feature stores necesitan monitorización de deriva alineada con las ventanas de inferencia, y el linaje debe conectar las características con sus orígenes para que una regresión del modelo no se convierta en una investigación sin final definido.


