Por qué es importante la calidad de datos y cómo los datos deficientes dañan el ROI
|
7
minuto de lectura

Un panel puede tener un formato impecable, actualizarse según lo previsto y aun así llevar a un equipo directivo hacia la decisión equivocada. Un registro de cliente duplicado puede inflar la demanda, una carga de transacciones tardía puede distorsionar el reporte de tesorería y un cambio de tipo en una columna puede romper un modelo. El defecto técnico puede parecer pequeño. La consecuencia de negocio rara vez lo es.
Gartner ha estimado que los datos deficientes cuestan a las organizaciones al menos 12,9 millones de USD al año de media, mientras que una investigación citada por MIT Sloan Management Review sitúa la pérdida de ingresos derivada de la mala calidad de datos entre el 15 % y el 25 % en muchas empresas (evidencia sobre la mejora de la calidad de datos). Estas cifras explican por qué la calidad de datos importa como superficie de control económico y no solo como una tarea de ingeniería de datos.
Índice de contenidos
Introducción: por qué los datos deficientes rompen buenas decisiones
El coste es mayor que el defecto
Qué significa realmente una buena calidad de datos
La exactitud abre la receta
Las demás dimensiones definen la usabilidad
Cómo la mala calidad de datos perjudica al negocio y a la tecnología
Dónde aparece el daño
Por qué la calidad de datos es aún más importante para la IA y la gobernanza
La IA amplifica los defectos en los flujos de trabajo
La preparación es una idoneidad que se puede demostrar
Ejemplos reales de riesgo cuando falla la calidad de datos
Reparación reactiva frente a control temprano
Cómo controlar la calidad de datos con validación, Timeliness y monitorización
Empiece por expectativas explícitas
Monitorice la entrega y la estructura
Conclusión: construir confianza en los datos para la analítica y la IA
Introducción: por qué los datos deficientes rompen buenas decisiones
Una responsable financiera observa que los ingresos se desaceleran en una región y retrasa contrataciones, recorta inventario y pospone una campaña. Más tarde, un analista descubre que un sistema de origen cambió su clasificación de transacciones. El panel mostraba cifras plausibles, así que el error pasó desapercibido y condicionó decisiones reales.
La analítica y la IA generan la misma exposición en formas distintas. Un modelo de previsión puede producir una recomendación pulida a partir de un histórico incompleto. Un flujo de riesgo de cliente puede usar atributos obsoletos. Un informe de dirección puede cuadrar técnicamente mientras une registros construidos sobre definiciones diferentes. El resultado es retrabajo, acción retrasada y menor confianza en la plataforma de datos.
El coste es mayor que el defecto
La mala calidad de datos se comporta como una avería en una línea de suministro compartida. Los ingenieros revisan las canalizaciones, los analistas concilian cifras contradictorias, los responsables esperan confirmación y los equipos de negocio posponen decisiones. Si el problema alcanza varios sistemas posteriores, cada copia se convierte en otro punto que investigar y corregir.
La evidencia del sector resumida en la explicación de calidad de datos de TechTarget indica que los incidentes mensuales medios de calidad de datos pasaron de 59 en 2022 a 67 en 2023, mientras que la proporción media de ingresos afectados subió del 26 % al 31 %. Una encuesta financiera independiente de 2022 halló que el 86 % de los líderes de negocio no confiaba en que sus datos pudieran sustentar la toma de decisiones, según esa misma fuente.
La superficie de control económico es, por tanto, tanto el tiempo como la corrección. Un defecto detectado antes de la publicación puede requerir una sola corrección. El mismo defecto detectado después de que paneles, flujos operativos y modelos lo hayan consumido exige investigar cada ruta afectada. La prevención y la detección rápida reducen ese trabajo de recuperación, incluso cuando los datos perfectos siguen siendo inalcanzables.
La pérdida de confianza también cambia la forma de trabajar. Los equipos añaden comprobaciones manuales, mantienen hojas de cálculo paralelas y piden aprobaciones repetidas. La organización puede tener almacenes modernos, paneles y sistemas de aprendizaje automático y, aun así, las decisiones se ralentizan porque nadie puede verificar rápidamente las entradas.
Un punto de partida útil es la definición de calidad de datos: los datos son valiosos cuando resultan aptos para la decisión, el proceso o el modelo que los usa. El criterio es el uso fiable, medido por la rapidez con que los problemas se previenen o se detectan.
Qué significa realmente una buena calidad de datos
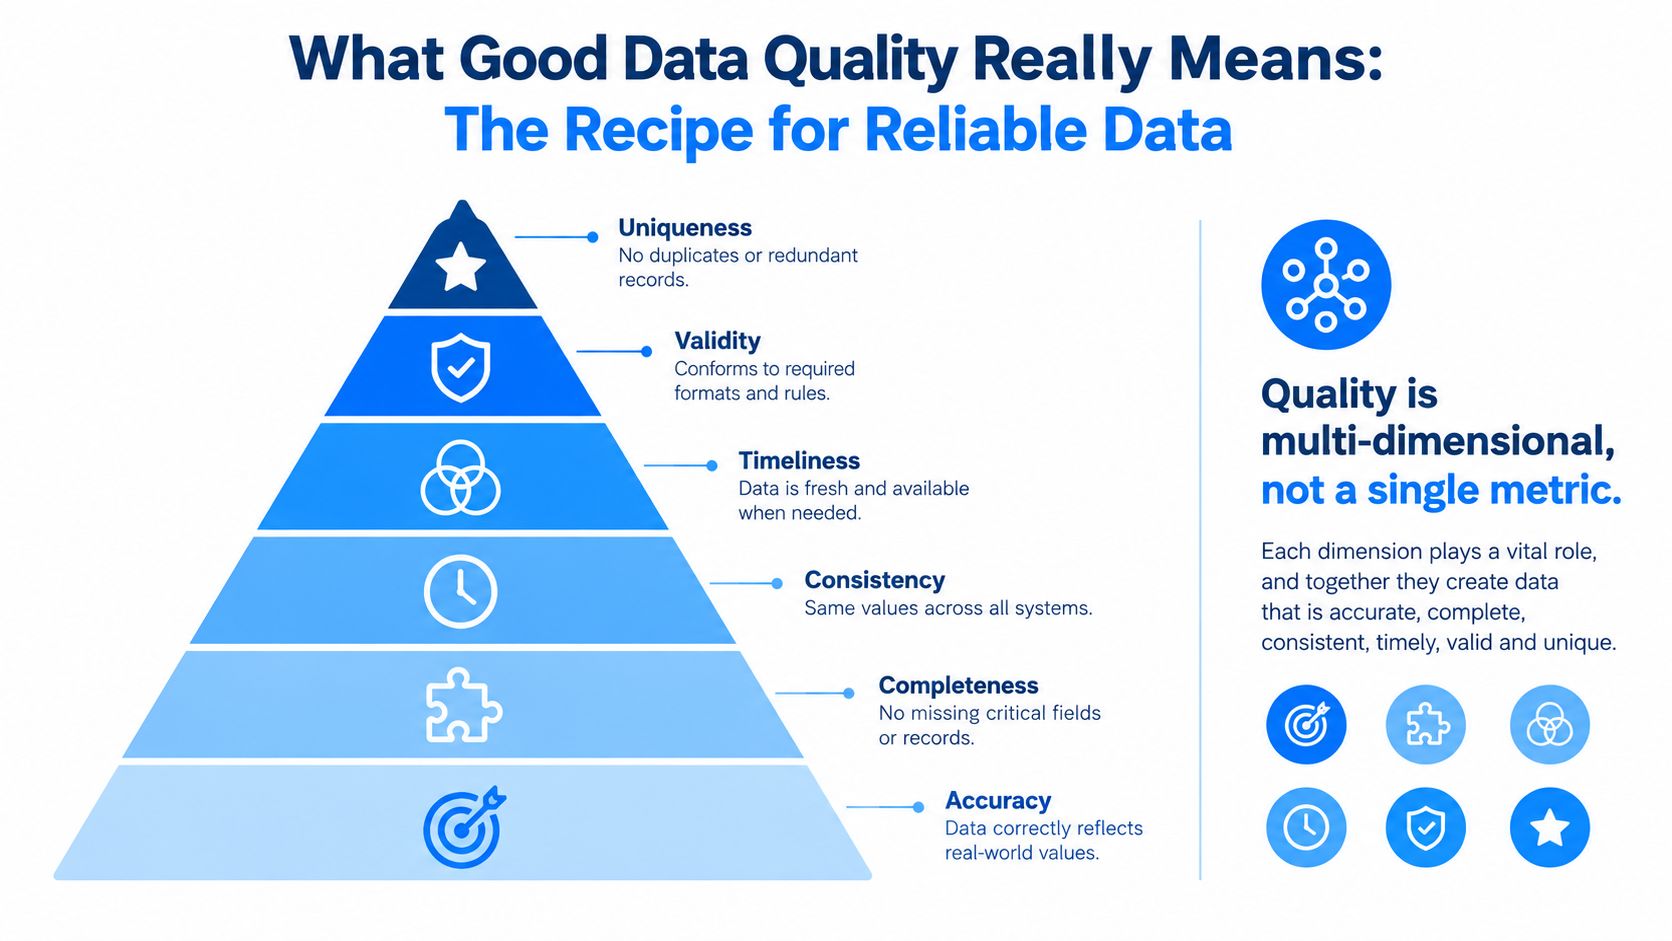
Piense en un conjunto de datos como los ingredientes de una receta. Los ingredientes frescos no bastan si las cantidades son incorrectas, falta un elemento necesario, dos envases etiquetan el mismo producto de forma distinta o los ingredientes llegan cuando la cocina ya ha cerrado. Un resultado fiable depende de varias condiciones que funcionan juntas.
La calidad de datos significa idoneidad para el uso. Un conjunto de datos puede estar presente, ser consultable y técnicamente válido y seguir siendo inadecuado para una pregunta de negocio concreta.
La exactitud abre la receta
La exactitud pregunta si un valor refleja la realidad. Una dirección de cliente, un saldo de cuenta, un precio de producto o un código médico puede estar almacenado en el campo correcto y seguir siendo erróneo. La exactitud suele requerir comparación con una fuente fiable, una regla transaccional o una condición de negocio conocida.
La completitud pregunta si existen los registros y campos críticos. Un identificador de cliente ausente puede impedir uniones. Una marca de tiempo ausente puede hacer imposible medir la puntualidad. No todo vacío es un error, pero todo vacío importante necesita una interpretación definida.
La consistencia pregunta si los sistemas coinciden. Si una aplicación considera a un cliente «activo» y otra aplica una regla de estado distinta, cada tabla puede parecer coherente en sí misma mientras la vista corporativa se contradice.
Las demás dimensiones definen la usabilidad
Timeliness mide si los datos llegan lo bastante frescos para su propósito. Un informe de planificación diaria y un flujo de detección de fraude en tiempo real tienen expectativas distintas.
La validez comprueba si los valores siguen los formatos y las reglas requeridos. Las fechas deben interpretarse como fechas, los identificadores deben seguir patrones aceptados y los valores de estado deben pertenecer a un conjunto aprobado.
La unicidad evita que registros duplicados o redundantes alteren recuentos, saldos o historiales de cliente.
Estas dimensiones no son intercambiables. Un conjunto de datos puede ser exacto pero tardío, completo pero inconsistente, o puntual pero inválido. Por eso una única puntuación de calidad suele ocultar el problema subyacente.
La tarea práctica es definir la calidad por caso de uso. Un informe regulatorio puede priorizar completitud, validez y auditabilidad. Un modelo de recomendación puede necesitar representatividad, vigencia y equilibrio además de exactitud. Las dimensiones de la calidad de datos dan a los equipos un vocabulario para convertir preocupaciones vagas en expectativas comprobables.
Cómo la mala calidad de datos perjudica al negocio y a la tecnología
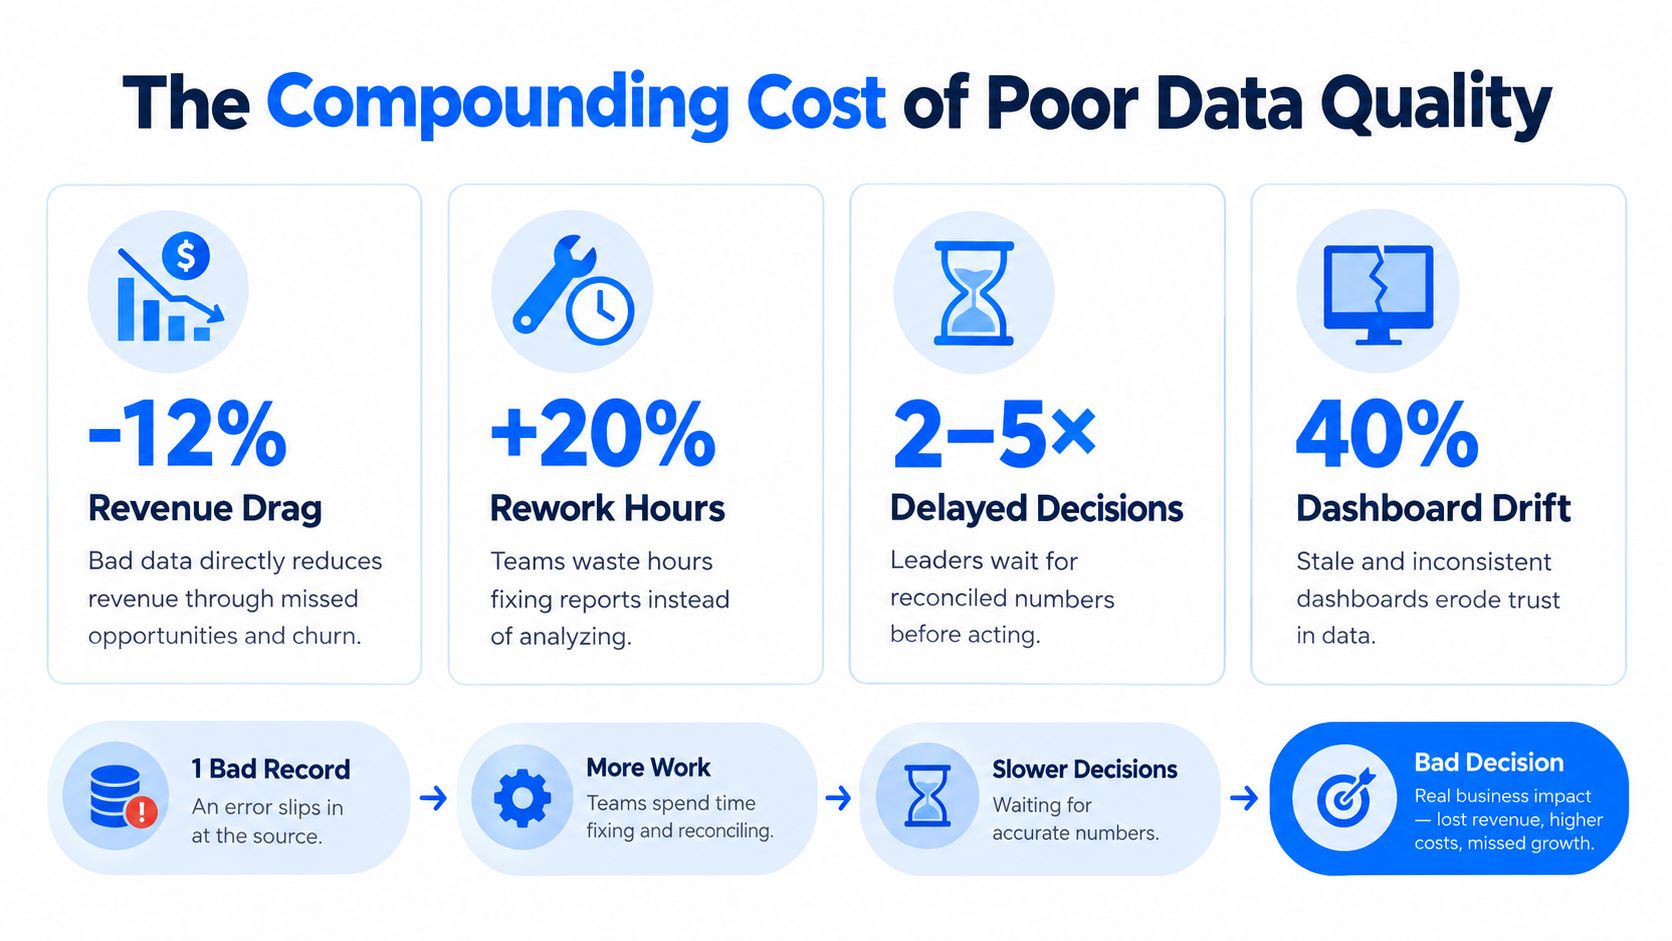
Un registro defectuoso puede recorrer una organización más rápido de lo que su responsable alcanza a notar. Entra en una canalización, altera un agregado, aparece en un panel, influye en una decisión y más tarde puede convertirse en datos de entrenamiento. Cada traspaso añade otro lugar donde el defecto original puede quedar enmascarado, copiado o asignado a otra persona para que lo corrija.
La estimación ampliamente citada de Gartner sitúa el coste medio de la mala calidad de datos por organización en 12,9 millones de USD al año (impacto económico de la mala calidad de datos). El gasto aparece como conciliación manual, procesos fallidos, desperdicio, retrabajo, decisiones retrasadas e ingresos perdidos. Los beneficios de negocio de la calidad de datos se ven con más claridad cuando la calidad se trata como superficie de control de esos costes y no solo como una tarea de limpieza.
Una investigación resumida en un artículo revisado por pares señala que la mala calidad de datos puede consumir entre el 8 % y el 12 % de los ingresos en algunos estudios propietarios, mientras que otras estimaciones sitúan el coste entre el 15 % y el 25 % de los ingresos en muchas empresas (discusión revisada por pares sobre los costes de la calidad de datos). Los métodos y las organizaciones difieren, pero el mecanismo se mantiene. La información defectuosa afecta a los márgenes y a la ejecución, no solo al aspecto de un informe.
Dónde aparece el daño
Los equipos suelen ver los efectos en formas reconocibles:
Fuga de ingresos: los registros duplicados, ausentes o mal clasificados pueden distorsionar la actividad de cliente y ocultar oportunidades.
Retrabajo operativo: analistas e ingenieros concilian resultados contradictorios en lugar de mejorar los sistemas subyacentes.
Latencia de decisión: los responsables esperan a que se verifiquen las cifras antes de aprobar una acción.
Deriva de paneles: las fuentes obsoletas o inconsistentes hacen que los informes discrepen y debilitan la confianza.
Distorsión de modelos: los flujos de entrenamiento y puntuación usan entradas que ya no representan las condiciones operativas.
El tiempo hasta la detección cambia la economía. Un defecto encontrado en la ingesta puede requerir una sola corrección. El mismo defecto encontrado después del reporte, la entrega o la puntuación de un modelo puede exigir investigación en varios sistemas y equipos.
El término técnico para esta interrupción suele ser data downtime. Un marco de ETSI para medir la calidad de datos describe un modelo accionable basado en el número de incidentes multiplicado por el tiempo de detección y resolución. Una detección y resolución más rápidas reducen el trabajo y la interrupción, aunque los datos perfectos no sean alcanzables de inmediato. Las reglas de prevención son valiosas por la misma razón: detienen defectos recurrentes antes de que cada traspaso posterior genere más retrabajo.
Una encuesta a 20.000 organizaciones con diez o más empleados halló que la mala calidad solo en datos relacionales provocó unos 400 millones de euros de coste adicional anual en los Países Bajos (investigación empírica sobre el impacto de negocio de la calidad de datos). Los fallos locales repetidos pueden convertirse así en costes de escala corporativa.
La pregunta práctica es con qué rapidez un equipo puede detectar un cambio, contener sus efectos y asignar a alguien su corrección antes de que el defecto alcance una decisión.
Por qué la calidad de datos es aún más importante para la IA y la gobernanza
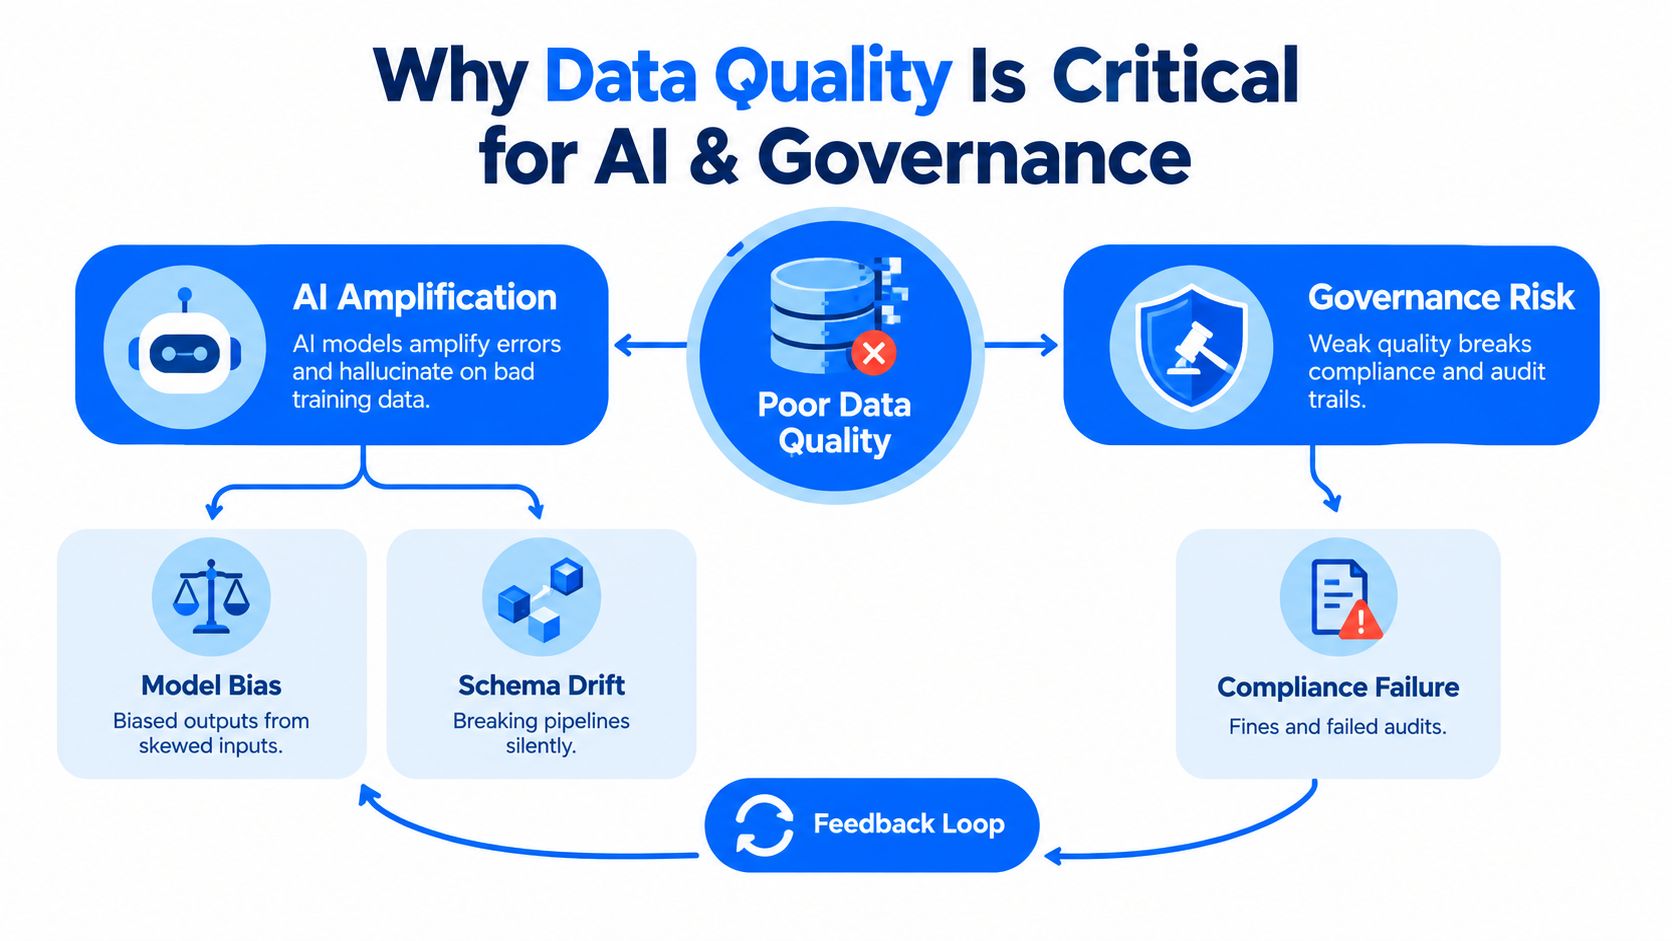
La IA puede convertir un pequeño defecto de datos en una acción de negocio segura de sí misma. El reporte tradicional puede exponer un error evidente cuando un total no cuadra o un panel está obsoleto. Un sistema de IA, en cambio, puede transformar esa misma entrada defectuosa en una clasificación, una recomendación, un texto generado o una decisión automatizada que parece razonable.
La preparación para la IA depende de algo más que de valores exactos. Los equipos deben saber si los datos son vigentes, equilibrados, representativos, accesibles, auditables y trazables a lo largo de su ciclo de vida. Un modelo puede rendir bien en un conjunto de prueba estrecho y luego fallar cuando los datos de producción cambian o entran casos infrarrepresentados en el flujo. La calidad de los datos detrás de un modelo de IA determina cuánta confianza merece su salida.
La IA amplifica los defectos en los flujos de trabajo
Un campo ausente puede afectar a un solo informe. En un flujo de aprendizaje automático, esa omisión puede influir en la creación de características, el entrenamiento, la evaluación y la puntuación en producción. Un cambio de esquema puede detener una canalización o pasar inadvertido mientras altera el significado de una característica.
La gobernanza añade una exigencia de evidencia. Los equipos deben mostrar qué datos usó un sistema, qué reglas se aplicaron, cuándo llegaron los datos y cómo se gestionó un incidente. Sin ese registro, explicar una decisión automatizada resulta difícil aunque el resultado parezca plausible.
ISO/IEC 5259-5:2025 define un marco de gobernanza de la calidad de datos para analítica y aprendizaje automático a lo largo del ciclo de vida del dato. Sus dimensiones incluyen accesibilidad, auditabilidad, vigencia, exactitud, puntualidad, equilibrio, diversidad y representatividad (marco ISO/IEC 5259-5:2025).
La preparación es una idoneidad que se puede demostrar
Un estudio de mercado citado junto con la norma halló que solo el 12 % de las organizaciones consideraba que sus datos tenían calidad y accesibilidad suficientes para una implementación eficaz de IA, mientras que el 64 % señalaba la calidad de datos como su principal reto de integridad de datos. Las cifras indican una brecha de preparación, no una exigencia de datos impecables en todas partes.
El objetivo práctico es el uso controlado. Defina qué dimensiones importan para cada modelo, monitorícelas de forma continua, conserve la evidencia y detenga o ponga en cuarentena los datos fuera de los límites acordados. La gobernanza funciona mejor cuando se conecta con las canalizaciones que crean y consumen datos, de modo que los equipos detecten problemas temprano y eviten costes posteriores recurrentes en lugar de tratar la calidad como papeleo tras el despliegue.
Ejemplos reales de riesgo cuando falla la calidad de datos
Un fallo de calidad de datos puede permanecer invisible mientras los sistemas siguen operando con normalidad. El impacto de negocio depende menos de que exista un error que del tiempo que ese error permanece disponible para los consumidores posteriores.
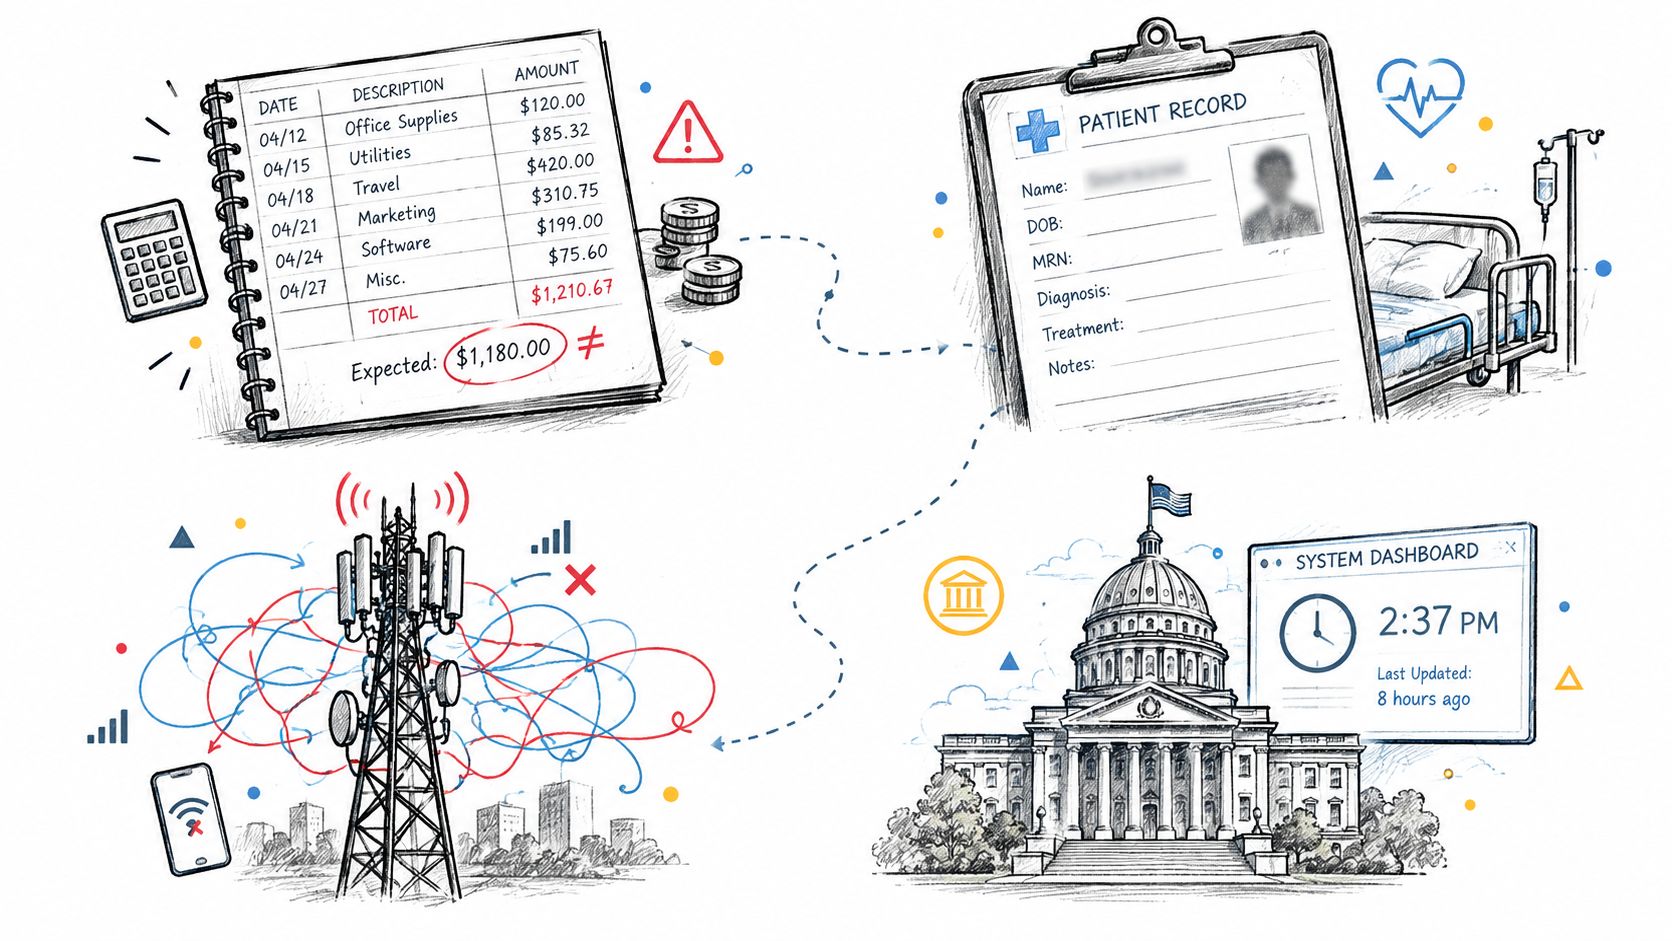
En finanzas, una carga de transacciones tardía puede hacer que un panel de riesgo parezca más tranquilo que la cartera subyacente. En sanidad, atributos de paciente ausentes o inconsistentes pueden complicar el reporte clínico y las presentaciones regulatorias. En telecomunicaciones, un cambio de esquema en los datos de uso puede alterar la lógica de agregación y dejar a los equipos analizando una actividad de cliente incompleta. En el sector público, los identificadores inconsistentes pueden impedir una conciliación fiable entre organismos.
Estos fallos no requieren una caída espectacular. Un informe puede actualizarse correctamente omitiendo una partición. Una canalización puede aceptar un nuevo tipo de dato mientras la lógica posterior lo interpreta mal. Un modelo puede seguir puntuando después de que su distribución de entrada se desplace, produciendo resultados que parecen válidos pero ya no sostienen la misma decisión.
Reparación reactiva frente a control temprano
La regla 1-10-100 ilustra por qué el tiempo de detección tiene efecto económico. Cuesta alrededor de 1 USD prevenir un error de datos, 10 USD corregirlo una vez ha entrado en el sistema y 100 USD afrontarlo si se deja sin controlar (modelo de coste 1-10-100 de la calidad de datos).
Enfoque | Qué ocurre | Consecuencia habitual |
|---|---|---|
Control preventivo | Una regla o un contrato bloquea un valor inválido antes de su publicación | El problema permanece cerca de su origen |
Detección temprana | La monitorización identifica un valor inusual, un retraso o un cambio estructural | Un equipo más reducido puede investigar antes del uso posterior |
Remediación reactiva | Los usuarios descubren el problema en un informe, un modelo o un proceso de negocio | La conciliación, el retrabajo y la recuperación de la confianza llevan más tiempo |
Los datos perfectos no son el requisito operativo. El objetivo práctico es identificar los defectos mientras son locales, antes de que informes, modelos y procesos de negocio dependan de ellos.
La evidencia del sector resumida por TechTarget indica que los incidentes mensuales medios pasaron de 59 a 67 entre 2022 y 2023, mientras que la proporción media de ingresos afectados subió del 26 % al 31 % (evidencia de incidentes e impacto en ingresos). En este contexto, las cifras apuntan a una pregunta de prevención: ¿con qué rapidez puede un equipo detectar un defecto, identificar a los consumidores expuestos y detener su uso posterior? Una detección más rápida limita el número de sistemas que hay que corregir y mantiene la remediación más cerca del origen.
Cómo controlar la calidad de datos con validación, Timeliness y monitorización
Un programa de calidad viable combina controles en distintos puntos del ciclo de vida del dato. La validación previene infracciones de reglas conocidas. La detección de anomalías encuentra comportamientos que las reglas no describen. La monitorización de Timeliness identifica fallos de entrega, mientras que el seguimiento de esquemas detecta cambios estructurales capaces de romper a los consumidores.
Empiece por expectativas explícitas
La validación a nivel de registro es la herramienta adecuada para condiciones deterministas. Compruebe campos obligatorios, valores aceptados, unicidad, integridad referencial, relaciones entre fechas y reglas de negocio. Un registro de pago puede necesitar una referencia de cuenta válida. Un pedido puede requerir una cantidad no negativa y una fecha de entrega posterior a la fecha del pedido.
La detección de anomalías responde a otra pregunta: ¿difiere el comportamiento de hoy del patrón establecido? Un umbral estático puede pasar por alto un desplazamiento gradual o marcar un cambio estacional normal. El aprendizaje de líneas base ayuda a identificar volúmenes, distribuciones o movimientos de métricas inusuales sin exigir que los ingenieros escriban todas las reglas posibles.
Monitorice la entrega y la estructura
La monitorización de Timeliness debe reflejar cómo usan los datos sus consumidores. Haga seguimiento de la llegada esperada, las cargas ausentes, las particiones tardías y las entregas inesperadamente tempranas. Un conjunto de datos que llega después de una decisión matutina puede estar técnicamente completo y ser operativamente inútil.
El seguimiento de esquemas vigila columnas añadidas o eliminadas, campos renombrados y modificaciones de tipo de dato. Da a productores y consumidores la oportunidad de coordinarse antes de que un cambio estructural altere un panel o un modelo.
Regla práctica: detecte el fallo lo más cerca posible del punto en que entra en el sistema y encamine la alerta hacia la persona que puede corregirlo.
Un panel compartido ayuda a ingenieros de datos, analistas y responsables de negocio a ver el mismo incidente, el mismo historial y el mismo estado. La ejecución in-database puede mantener el cálculo de métricas dentro del entorno del cliente, reduciendo el movimiento innecesario de datos y alineando la monitorización con los requisitos de seguridad. Los equipos pueden combinar estas prácticas con el enfoque de reglas de validación de datos y calidad continua.
Etapa | Coste relativo | Impacto de negocio |
|---|---|---|
Prevenir | Unos 1 USD | Detiene un error antes de que se propague |
Detectar y corregir pronto | Unos 10 USD | Limita los sistemas afectados y reduce el esfuerzo de investigación |
Remediar tras el fallo | Unos 100 USD | Prolonga el retrabajo, retrasa decisiones y daña la confianza |
El orden importa. La prevención protege el proceso, la detección protege la decisión y la remediación restaura el sistema una vez el daño ya se ha extendido.
Conclusión: construir confianza en los datos para la analítica y la IA
Un programa de calidad fiable empieza por una elección, no por una lista de verificación. Seleccione los tres conjuntos de datos cuyo fallo podría afectar más gravemente a ingresos, cumplimiento, operaciones o un sistema de IA. Esos conjuntos se convierten en el primer banco de pruebas de controles lo bastante específicos para sostener decisiones.
Para cada uno, anote la decisión que sustenta, el tiempo de llegada aceptable y las condiciones que hacen utilizable un registro. Asigne un responsable capaz de actuar cuando esas condiciones fallen. La validación comprueba entonces si los datos son aptos para su propósito, mientras que los controles de Timeliness confirman que están disponibles cuando la decisión los requiere.
Use el mismo pequeño conjunto de preguntas para cada conjunto de datos:
Idoneidad: ¿qué campos, valores y relaciones deben ser exactos, completos, válidos, consistentes y únicos?
Timeliness: ¿cuánto pueden tardar en llegar los datos antes de afectar a la decisión que sustentan?
Responsabilidad: ¿quién investiga la alerta, corrige el origen y confirma la recuperación?
Evidencia: ¿qué registro muestra el fallo, la respuesta y el resultado?
Este enfoque evita una trampa habitual: dedicar el mismo esfuerzo a cada tabla. Un conjunto exploratorio de bajo impacto puede esperar, mientras que una métrica financiera, un flujo regulatorio o un modelo en producción reciben atención primero. El objetivo no son datos perfectos en todas partes. Son datos fiables allí donde los errores tienen consecuencias, con controles que se pueden probar y mejorar.
digna sostiene este modelo operativo como plataforma de calidad de datos y observabilidad dentro del propio entorno. Sus módulos ofrecen detección de anomalías, validación a nivel de registro, monitorización de Timeliness, seguimiento de cambios de esquema, análisis histórico y visibilidad compartida en almacenes, lagos y canalizaciones sin mover los datos de producción fuera del entorno del cliente.
Visite digna para ver cómo su plataforma modular puede ayudar a su equipo a validar registros críticos, seguir la puntualidad de las entregas, detectar anomalías e identificar cambios de esquema dentro de su propia infraestructura. Empiece documentando los tres conjuntos de datos principales y amplíe después la monitorización a medida que el equipo aprenda qué controles previenen los fallos de mayor consecuencia.
Timeliness es la dimensión que los equipos dejan sin definir con más frecuencia, y es la que decide si un conjunto de datos correcto sigue siendo útil en el momento de la decisión; para las métricas y los patrones de monitorización que hay detrás, consulte la guía de digna sobre Data Timeliness.
Preguntas frecuentes
¿Por qué es importante la calidad de datos para el ROI del negocio?
Porque los defectos viajan. Un registro de cliente duplicado puede inflar la demanda y una carga de transacciones tardía puede distorsionar el reporte de tesorería. Gartner sitúa el coste medio de la mala calidad de datos en 12,9 millones de USD al año, y una investigación citada por MIT Sloan estima la pérdida de ingresos entre el 15 % y el 25 % en muchas empresas.
¿Cuánto cuesta resolver un problema de calidad de datos una vez se ha propagado?
La regla 1-10-100 es la referencia de trabajo: en torno a 1 USD para prevenir un error, 10 USD para corregirlo una vez ha entrado en el sistema y 100 USD para afrontarlo si se deja sin controlar. El tiempo hasta la detección, y no el tamaño del defecto, impulsa la mayor parte de ese coste.
¿Cuáles son las dimensiones de la calidad de datos?
Exactitud, completitud, consistencia, Timeliness, validez y unicidad. No son intercambiables: un conjunto de datos puede ser exacto pero tardío, completo pero inconsistente, o puntual pero inválido. Por eso una única puntuación de calidad suele ocultar precisamente el problema que habría que corregir.
¿Por qué la calidad de datos importa más para la IA que para el reporte?
El reporte suele exponer un error cuando un total no cuadra o un panel queda obsoleto. Un sistema de IA convierte esa misma entrada defectuosa en una clasificación o una recomendación formulada con seguridad. Solo el 12 % de las organizaciones considera que sus datos tienen calidad y accesibilidad suficientes para una implementación eficaz de IA.
¿Cómo se pone en marcha un programa de calidad de datos?
Elija los tres conjuntos de datos cuyo fallo afectaría más a los ingresos, al cumplimiento o a un modelo en producción. Para cada uno, anote la decisión que sustenta, cuánto puede tardar en llegar y las condiciones que hacen utilizable un registro, y designe después a un responsable que actúe cuando esas condiciones fallen.


