8 casos de uso de observabilidad de datos para datos fiables
|
9
minuto de lectura

El primer fallo en un entorno de datos rara vez es una canalización caída. Es un panel que se actualiza correctamente con datos incompletos, un modelo que recibe entradas estructuralmente válidas pero con el comportamiento cambiado, o un KPI que se sale de su patrón normal sin que nadie tenga asignada la investigación. Una encuesta ampliamente citada halló que los incidentes de datos mensuales pasaron de 59 en 2022 a 67 en 2023, mientras que el 68 % de los encuestados dijo que detectar un incidente de datos costó al menos cuatro horas en 2023, frente al 62 % de 2022. La misma encuesta reportó un aumento del 166 % en el tiempo medio de resolución, hasta 15 horas por incidente (cobertura de Business Wire sobre la encuesta de Monte Carlo).
Esa evidencia aclara el propósito de la observabilidad de datos. Los equipos necesitan monitorizar el comportamiento de los datos, la entrega, la estructura, el significado de negocio y las operaciones de plataforma, y conectar después cada señal con un responsable nombrado y una ruta de respuesta. Los ocho casos de uso de observabilidad de datos que siguen ordenan el trabajo de fiabilidad según el fallo que un equipo necesita evitar. Cada uno identifica el rol responsable, la señal, un incidente representativo, los módulos de digna relevantes y la siguiente acción. digna se ejecuta dentro del entorno del cliente y combina detección de anomalías, Timeliness, validación, seguimiento de esquemas, monitorización de negocio y observabilidad de plataforma sin mover datos de producción.
Índice de contenidos
2. Desplazamiento de datos no detectado y prevención de deriva de modelos
3. Retrasos de entrega en canalizaciones y monitorización de SLA
4. Detección de cambios de esquema y prevención de cambios rupturistas
6. Aplicación de reglas de negocio y validación de cumplimiento
7. Observabilidad de la plataforma de datos y monitorización del consumo
8. Cumplimiento regulatorio y gobernanza de datos lista para auditoría
1. Detección de paneles obsoletos y rotos
Un panel puede estar disponible cuando sus decisiones ya son inseguras. La capa visual puede cargar, pero una tabla aguas arriba quizá contenga una partición ausente, una entrega retrasada o una distribución de métricas que ya no refleja la operación actual. Eso convierte la detección de paneles obsoletos en uno de los casos de uso de observabilidad de datos más directos para los equipos de analítica y de negocio.
El responsable principal suele ser la analytics engineer o la desarrolladora de BI, con el data engineer a cargo de la canalización aguas arriba. La señal combina frescura, volumen, completitud y distribución. Una alerta de panel debe identificar qué conjunto de datos llega tarde o incompleto, qué métrica cambió y qué informes posteriores dependen de él.
Una entidad financiera podría detectar que un panel de riesgo diario no se actualizó porque un proceso ETL aguas arriba entregó tarde. Un equipo de operaciones sanitarias podría identificar datos de volumen de pacientes ausentes antes de que las decisiones de dotación se apoyen en una vista incompleta. Un equipo de analítica de retail podría detectar datos de ventas parciales antes de que la dirección revise los KPI diarios.

La detección debe llevar al diagnóstico
Los módulos Data Anomalies y Timeliness de digna pueden aprender patrones de llegada esperados y comportamiento de métricas, y señalar después cargas ausentes, entregas retrasadas y valores inusuales. Su ejecución in-database mantiene el análisis dentro de las bases de datos del cliente, mientras el panel compartido da a ingenieros y stakeholders una visión común del incidente. Los equipos pueden usar la guía de digna sobre Data Timeliness para definir las señales de entrega que más importan.
Empiece por los paneles que influyen en el riesgo, las operaciones asistenciales, los ingresos o las decisiones de dirección. Dirija las alertas a los responsables de las canalizaciones en lugar de enviar cada notificación a un grupo amplio de datos. Revise el comportamiento de la línea base durante el despliegue inicial, porque una alerta útil refleja la cadencia real del conjunto de datos y no un calendario arbitrario.
Regla práctica: una alerta de panel debe indicar si el fallo es una entrega tardía, un volumen incompleto o un cambio en el comportamiento de la métrica. Esas condiciones requieren investigaciones distintas.
2. Desplazamiento de datos no detectado y prevención de deriva de modelos
Una canalización puede ejecutarse sin errores y aun así entregar datos que ya no representan el comportamiento que espera un modelo o un proceso de decisión. Los cambios de distribución son especialmente difíciles de detectar con monitorización del estado de los trabajos, porque la infraestructura informa de éxito mientras el contenido se ha desplazado.
Los roles responsables son el data scientist, el ML engineer y el data engineer. Deben monitorizar distribuciones de características, frecuencias de categoría, comportamiento de nulos, patrones de transacción y otras señales que describen la población de entrada. El incidente puede ser una plataforma de comercio electrónico que ve un cambio en el comportamiento de compra que debilita la previsión de demanda, o un operador de telecomunicaciones que nota un desplazamiento en los patrones de churn antes de que un modelo pierda fiabilidad.
Los equipos sanitarios pueden ver un cambio inesperado en las tasas de ingreso que exige investigación operativa. Los equipos de servicios financieros pueden detectar patrones de transacción inusuales que reflejen un problema de canalización, un evento de negocio real o una señal de fraude. La observabilidad no decide qué explicación es correcta. Acorta el camino entre el comportamiento inusual y la persona capaz de comprobar la explicación.
Use aprendizaje de líneas base antes que umbrales manuales
El módulo Data Anomalies de digna aplica aprendizaje continuo de líneas base al comportamiento de los conjuntos de datos, mientras que Data Analytics ayuda a los equipos a revisar patrones históricos, volatilidad y cambios recurrentes. El recurso de digna sobre detección de deriva de modelos resulta pertinente cuando los equipos necesitan conectar los cambios de datos con la monitorización de modelos en lugar de tratarlos como incidentes separados.
Una alerta práctica debe incluir el conjunto de datos afectado, el modelo o proceso de decisión que lo consume, la señal que cambió y el responsable de la escalada. Los ingenieros pueden entonces comparar la anomalía con el rendimiento del modelo, el historial de despliegues, los cambios en el sistema de origen o el comportamiento estacional. Si las alertas se envían a una plataforma de monitorización de ML, el equipo puede investigar la deriva de entrada y la degradación de salida por una única ruta de incidente.
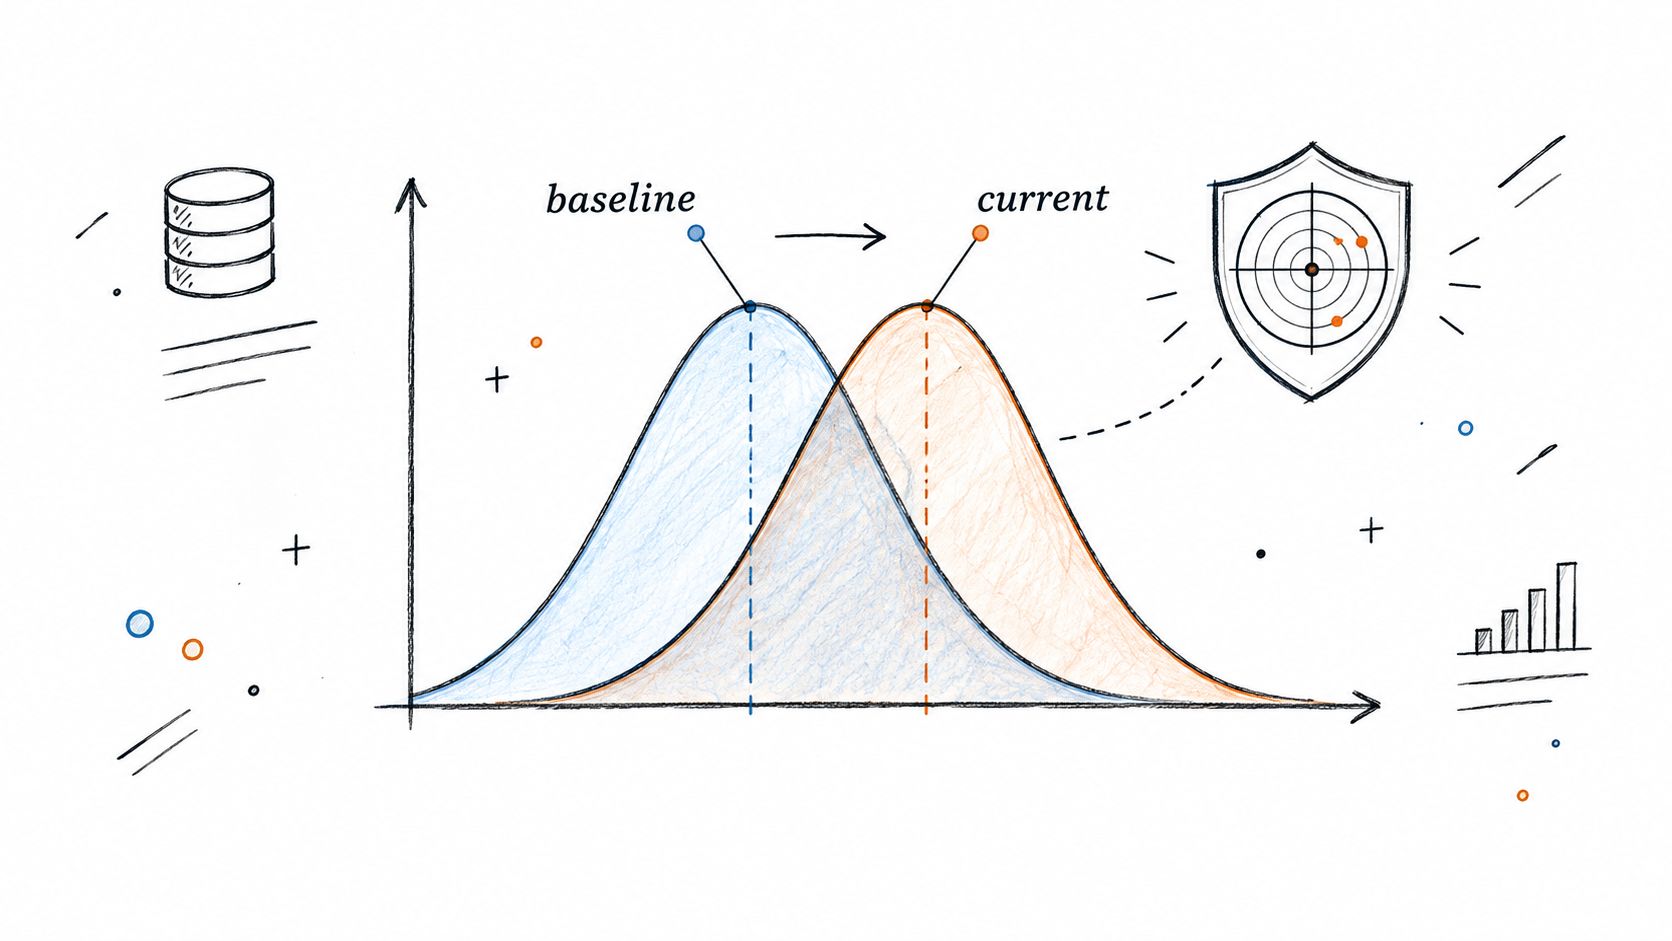
El riesgo estratégico no es solo la precisión del modelo. Una entrada alterada puede cambiar previsiones, priorización, revisión de fraude, planificación asistencial o el trato al cliente antes de que nadie califique el evento como incidente de modelo.
3. Retrasos de entrega en canalizaciones y monitorización de SLA
Los datos tardíos crean un fallo distinto al de los datos erróneos. La transformación puede ser correcta y el origen puede estar disponible, pero la tabla llega después de que el proceso de negocio la necesitaba. Eso convierte a Timeliness en un control de negocio y no solo en una métrica de ingeniería.
El responsable es el data platform engineer o el propietario de la canalización. La señal es el tiempo de entrega esperado frente a la llegada real, apoyado en la presencia de la carga, la duración de la ejecución y la cadencia histórica. Por ejemplo, una tabla que debería refrescarse cada hora puede disparar una alerta cuando lleva más de 2 horas sin actualizarse, convirtiendo una queja vaga sobre datos tardíos en un umbral de incidente definido (explicación de observabilidad de datos de DataDriven).
Un banco puede necesitar datos de riesgo nocturnos antes de una reunión del comité de riesgos. Un proveedor sanitario puede depender de datos diarios de pacientes para sus paneles operativos. Una empresa de telecomunicaciones podría monitorizar cargas de clientes de alto volumen que sustentan el aprovisionamiento, mientras un minorista puede requerir datos de ventas antes del reporte matutino.
Trate la entrega como un contrato operativo
El módulo Timeliness de digna aprende calendarios y ventanas de entrega esperadas, y señala después retrasos, cargas ausentes y entregas anticipadas. Los equipos pueden usar el recurso de digna sobre monitorización de canalizaciones de datos en AWS cuando necesiten alinear la monitorización de Timeliness con las operaciones de canalización en la nube.
La siguiente acción debe ser explícita. Configure la escalada cuando se supere el tiempo de entrega esperado, envíe el incidente al responsable de la canalización e integre la alerta con la gestión de incidentes. Siga la tendencia de los tiempos de entrega esperados, no solo los incumplimientos aislados. Un deterioro gradual puede revelar problemas de capacidad o de dependencias antes de que se produzca un fallo completo.
Un SLA de entrega solo es útil cuando alguien asume el incumplimiento, entiende su impacto aguas abajo y sabe cuándo escalarlo.
La detección identifica la ventana incumplida. El diagnóstico revisa el orquestador, el sistema de origen, la cadena de dependencias y el estado de la carga. La respuesta puede implicar reejecutar un trabajo, contactar con el responsable del origen o marcar las salidas posteriores como temporalmente no fiables.
4. Detección de cambios de esquema y prevención de cambios rupturistas
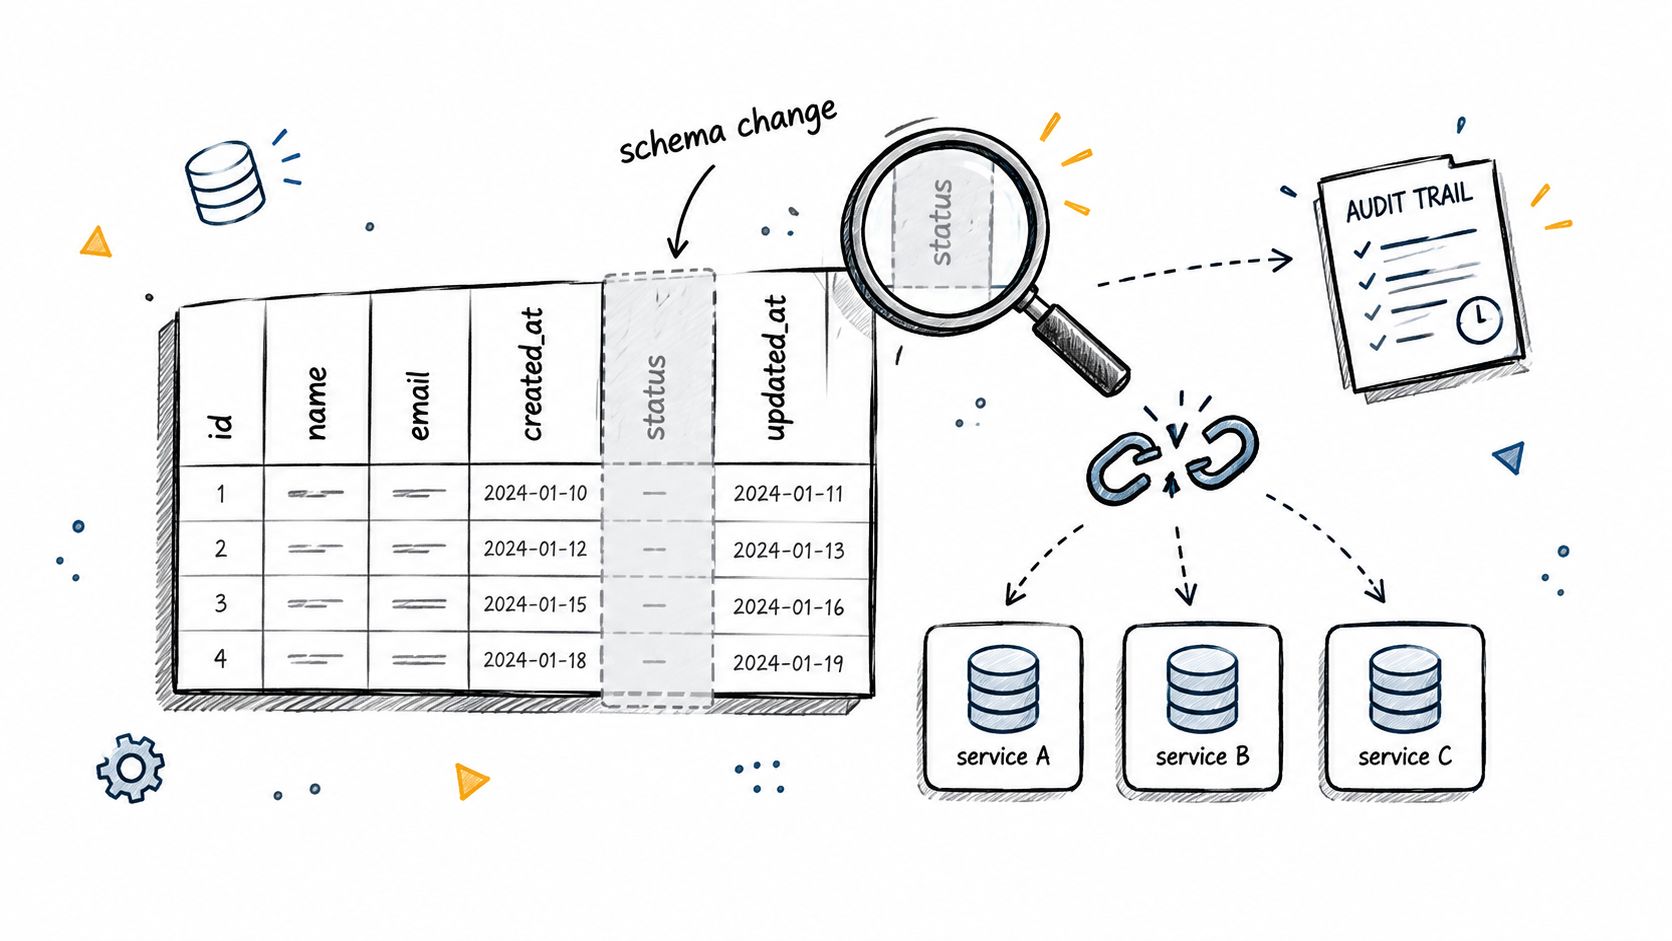
Los cambios estructurales son peligrosos porque pueden romper a los consumidores sin parecer fallos operativos. Columnas añadidas, columnas eliminadas, campos renombrados, cambios de tipo y cambios entre admitir nulos y no admitirlos pueden causar valores ausentes, coerción de tipos, transformaciones fallidas o uniones incorrectas incluso cuando la canalización informa de una ejecución correcta (explicación de Ataccama sobre esquema y observabilidad de datos).
El data engineer o el analytics engineer asume la respuesta, mientras que los responsables de los sistemas de origen deberían aprobar los cambios intencionados. La señal es una comparación entre el esquema actual y la estructura esperada. Un incidente representativo podría implicar que una aplicación de origen añada una columna sin anunciarla, cambie un identificador de cliente de cadena a entero o elimine un campo usado en un cálculo de riesgo.
Los equipos de TI sanitaria afrontan un problema de control adicional cuando las estructuras de datos clínicos evolucionan sin una comunicación clara. El problema técnico inmediato puede ser una transformación fallida, pero el riesgo mayor es la pérdida de trazabilidad sobre qué versión de los datos sustentó un informe.
Detecte el cambio antes de que lo descubran los consumidores
El Schema Tracker de digna monitoriza de forma continua las propiedades estructurales y alerta a los equipos cuando los esquemas derivan. El módulo Schema Tracker de digna puede sostener un flujo en el que los equipos documenten los esquemas esperados, dirijan las alertas a los responsables posteriores y revisen si un cambio fue intencionado.
El diagnóstico exige más que confirmar que una columna cambió. Los ingenieros deben identificar tablas, transformaciones, paneles, modelos y salidas regulatorias afectados. La siguiente acción puede ser actualizar un contrato, restaurar la compatibilidad, revisar una transformación o aprobar formalmente el cambio. Enlace las alertas de esquema con los procesos de catálogo y gobernanza para que las decisiones estructurales no queden en mensajes privados o tickets sin documentar.
Una alerta de esquema es, por tanto, una señal de control de impacto. Le dice al equipo no solo que una estructura cambió, sino que una dependencia posterior puede necesitar revisión.
5. Monitorización de KPI de negocio y alertas de anomalías
Las comprobaciones técnicas pueden pasar mientras el resultado de negocio parece incorrecto. Un almacén puede recibir datos a tiempo, conservar su esquema y completar cada transformación y, sin embargo, los ingresos, el valor del pedido, el volumen de clientes, el churn o los resultados de tratamiento pueden salirse del comportamiento esperado.
El responsable es la analista de negocio o la stakeholder operativa, con apoyo de analytics engineering. La señal es una métrica de negocio comparada con su comportamiento histórico, su estacionalidad, su volatilidad y las condiciones de datos relevantes. Una organización de retail podría detectar una caída inusual de ingresos y empezar a investigar antes de que el asunto llegue a una revisión formal de desempeño. Un equipo de telecomunicaciones podría notar un churn anómalo, mientras un grupo de servicios financieros investiga un cambio en el volumen de transacciones que podría reflejar fraude o un problema de sistema.
Ponga el significado de negocio junto al contexto técnico
La solución Business Monitoring de digna aplica detección de anomalías a métricas almacenadas en el almacén o el lago. Su módulo Data Analytics ayuda a los equipos a entender patrones históricos de KPI, tendencias y volatilidad, mientras que el sistema de monitorización de negocio de digna ofrece una vía enfocada para vigilar el comportamiento del negocio.
Empiece por los KPI que tienen un responsable de decisión claro. Defina qué acción sigue a una alerta, como comprobar la completitud del origen, validar una promoción, revisar controles de transacciones o contactar con un equipo operativo. Evite tratar cada movimiento como un incidente. La sensibilidad debe reflejar la variación normal de la métrica y la consecuencia de pasar por alto una anomalía.
Prueba de responsabilidad: si nadie sabe nombrar la decisión que cambia tras una alerta de KPI, esa métrica probablemente no está lista para monitorización continua.
El diagnóstico conecta el movimiento de negocio con la calidad de datos, los eventos del origen, los cambios de producto o el comportamiento real del mercado. La respuesta corresponde entonces al equipo capaz de corregir la condición subyacente, no necesariamente al equipo que mantiene el panel.
6. Aplicación de reglas de negocio y validación de cumplimiento
La detección de anomalías pregunta si los datos se comportan de forma distinta a su línea base. La validación pregunta si cada registro satisface una regla conocida de negocio, lógica o de cumplimiento. Ambas son necesarias porque un conjunto de datos puede parecer estadísticamente normal mientras incumple una condición exigida.
El responsable suele ser la dirección de calidad de datos, el data steward, el equipo de cumplimiento o la persona experta del dominio. Entre las señales están la presencia de campos obligatorios, los segmentos válidos, los rangos de valores, las secuencias de fechas, la integridad referencial y otras restricciones deterministas. Un equipo de servicios financieros podría validar que las transacciones contienen los campos obligatorios y se mantienen dentro de los umbrales de cumplimiento. Los equipos sanitarios pueden comprobar que los registros cumplen los requisitos de reporte antes de su envío. Los operadores de telecomunicaciones pueden validar registros de facturación contra las reglas del plan tarifario, mientras los organismos públicos pueden probar condiciones de auditoría y trazabilidad.
Haga operativa la evidencia de validación
El módulo Data Validation de digna realiza comprobaciones a nivel de registro contra reglas de negocio documentadas. Los equipos deberían empezar por dominios regulados o de alto riesgo, implicar a las personas expertas al diseñar las reglas y registrar qué conjuntos de datos pasaron o fallaron. El catálogo de datos puede ofrecer una vista compartida del estado de validación y ayudar a los analistas a distinguir los datos aptos para el uso de los que requieren revisión.
La detección identifica los registros que incumplen una regla. El diagnóstico determina si el fallo lo causó la regla, el origen, la transformación o el proceso de negocio. La respuesta puede implicar poner en cuarentena los registros afectados, corregir el origen, aprobar una excepción o documentar la remediación para la revisión de auditoría.
Las guías independientes sobre observabilidad de canalizaciones subrayan que la monitorización debe evaluar la calidad de la salida, incluidos los recuentos de registros, los cambios en la distribución de campos y los cambios de esquema, en lugar de apoyarse solo en el éxito del trabajo (guía sobre monitorización y controles de canalizaciones a nivel de datos). Esa distinción importa en entornos sensibles al cumplimiento, donde un trabajo completado no es prueba suficiente de que la salida sea fiable o auditable.
7. Observabilidad de la plataforma de datos y monitorización del consumo
Los equipos de plataforma de datos pueden heredar problemas de fiabilidad del comportamiento de los recursos y no del contenido de los datos. Un pico de carga, una consulta ineficiente, una canalización descontrolada, una tabla sin uso o una tendencia inesperada de almacenamiento pueden reducir la disponibilidad y hacer menos predecible la entrega posterior.
El rol responsable es el data platform engineer. Entre las señales están los patrones de carga, el volumen de consultas, la capacidad de procesamiento, el tiempo de ejecución de canalizaciones, la disponibilidad, el crecimiento del almacenamiento y los cambios de consumo. Un equipo de almacén en la nube podría encontrar tablas sin uso que complican la gestión del almacenamiento. Una analytics engineer podría identificar consultas que consumen recursos en exceso y optimizar el SQL. Un equipo de plataforma podría detectar un patrón de consumo anómalo causado por una canalización descontrolada.
Monitorice la infraestructura detrás de los datos
La solución Data Platform Observability de digna se centra en la salud de la plataforma, su comportamiento, su consumo y sus cambios operativos. Su módulo Data Analytics puede ayudar a los equipos a seguir la tendencia de las métricas de plataforma y distinguir un pico puntual de un problema de capacidad en desarrollo. Comparta los paneles de plataforma con los consumidores de datos para que los ingenieros no sean los únicos que vean las consecuencias de un uso ineficiente.
La siguiente acción depende de la señal. Una anomalía de consulta puede requerir optimización de SQL. Una tendencia de almacenamiento puede requerir gestión del ciclo de vida o una revisión de responsabilidades. Un cambio en la ejecución de una canalización puede requerir análisis de capacidad, investigación de dependencias o ajuste del calendario. Establezca líneas base de carga normal, dirija las alertas graves a los responsables de plataforma y use las tendencias de consumo para informar la planificación de infraestructura.
Este caso de uso también expone un problema de priorización. Una encuesta de observabilidad de 2025 halló que solo el 13 % de la telemetría recogida se usaba activamente para monitorización, alertas o resolución de problemas, mientras que el 84 % de las empresas usaba menos de una cuarta parte de lo que recopilaba (informe de observabilidad de Sawmills AI). Más telemetría no genera automáticamente más fiabilidad. Los equipos necesitan seleccionar señales que conduzcan a una decisión.
8. Cumplimiento regulatorio y gobernanza de datos lista para auditoría
Las organizaciones reguladas necesitan más que un panel impecable el día en que un auditor pide evidencias. Necesitan supervisión continua de la calidad de datos crítica, la validación, Timeliness, los cambios estructurales, la responsabilidad asignada y el historial de controles.
Los roles responsables son el responsable de gobernanza de datos, el compliance officer, el auditor interno y el propietario de datos del dominio. Las señales combinan resultados de validación, estado de entrega, historial de esquema, anomalías de calidad de datos y evidencia de que los controles funcionaron como estaba previsto. Un banco puede necesitar demostrar que los datos de reporte regulatorio cumplían los requisitos definidos y llegaron a tiempo. Una organización sanitaria puede necesitar trazabilidad para datos clínicos sensibles. Un organismo público puede necesitar demostrar que los datos críticos permanecieron sujetos a controles documentados dentro del entorno exigido.
Conecte la monitorización de controles con la evidencia
digna combina para ello Data Validation, Schema Tracker, Timeliness y ejecución in-database. Sus opciones de despliegue en nube privada o en local mantienen los datos sensibles dentro de la nube, la VPC o el centro de datos del cliente. Esa arquitectura sostiene requisitos de gobernanza en los que mover datos de producción a un servicio de monitorización externo no resulta aceptable.
Los equipos de cumplimiento deberían identificar los dominios de datos que requieren supervisión continua, documentar las reglas en la plataforma de gobernanza y establecer ciclos de revisión recurrentes. La siguiente acción de cada alerta debe especificar si el asunto requiere remediación, aprobación de excepción, conservación de evidencia o escalada. El registro resultante debería ayudar a un auditor a entender qué se comprobó, cuándo se comprobó, qué falló, quién lo investigó y cómo respondió la organización.
El contexto de mercado muestra por qué esto se ha convertido en un asunto de plataforma y no en una tarea estrecha de calidad. Los estudios estiman el mercado de observabilidad de datos en 2.940 millones de USD en 2025 y proyectan 6.020 millones de USD para 2030, lo que supone una CAGR del 15,4 %, con Norteamérica identificada habitualmente como el mayor mercado y Asia-Pacífico como la región de crecimiento más rápido (informe de mercado de The Business Research Company). La adopción se extiende porque gobernanza, fiabilidad y responsabilidad operativa se solapan cada vez más.
Para una perspectiva adicional sobre la construcción de controles de privacidad y cumplimiento, consulte las reflexiones de Nexus IT Group.
Observabilidad de datos: comparativa de 8 casos de uso
Característica | 🔄 Complejidad de implementación | ⚡ Recursos & velocidad | ⭐ Eficacia esperada | 📊 Resultados clave / impacto | 💡 Casos de uso ideales |
|---|---|---|---|---|---|
Detección de paneles obsoletos y rotos | Moderada, requiere periodo de ajuste de la línea base de IA | Recursos moderados; ejecución in-database; alertas en tiempo real | ⭐⭐⭐⭐ | Menos caídas de paneles; menor tiempo de resolución con datos obsoletos | Paneles críticos, informes de dirección, finanzas, retail, sanidad |
Desplazamiento de datos no detectado y prevención de deriva de modelos | Alta, necesita datos históricos y ajuste de sensibilidad | Cómputo moderado-alto para análisis de distribución; monitorización continua | ⭐⭐⭐⭐ | Detección temprana de deriva; protege el rendimiento de los modelos de ML | Previsión, detección de fraude, modelos de churn, canalizaciones de ML |
Retrasos de entrega en canalizaciones y monitorización de SLA | Moderada, aprende calendarios y tiempos de entrega esperados | Recursos bajos-moderados; detección rápida; reduce el MTTD ⚡ | ⭐⭐⭐⭐ | Hacer cumplir SLA; alertas de entrega puntual; menos cargas perdidas | Trabajos nocturnos, reporte sensible al tiempo, plazos regulados |
Detección de cambios de esquema y prevención de cambios rupturistas | Baja-moderada, fijar el esquema base y luego comprobar en continuo | Pocos recursos; detección inmediata de cambios estructurales | ⭐⭐⭐⭐⭐ | Evitar fallos silenciosos; reducir tiempo de depuración; traza de auditoría de esquema | Orígenes dinámicos, canalizaciones ETL, analytics engineering |
Monitorización de KPI de negocio y alertas de anomalías | Moderada, exige definición de KPI y líneas base de estacionalidad | Recursos moderados; paneles para usuarios; alertas oportunas | ⭐⭐⭐⭐ | Detectar anomalías con impacto de negocio; reducir la fatiga de alertas | Seguimiento de ingresos, métricas de producto, KPI operativos |
Aplicación de reglas de negocio y validación de cumplimiento | Alta, definición inicial de reglas y mantenimiento continuo | Recursos moderados-altos para comprobaciones a nivel de registro; registro de auditoría | ⭐⭐⭐⭐⭐ | Aplicación continua de reglas; evidencia lista para auditoría; menos errores posteriores | Dominios regulados (finanzas, sanidad), facturación, reporte de cumplimiento |
Observabilidad de la plataforma de datos y monitorización del consumo | Alta, integra métricas de plataforma y líneas base de carga | Recursos moderados; telemetría continua; permite optimizar costes | ⭐⭐⭐⭐ | Planificación de capacidad; ahorro de costes; detectar cuellos de botella de rendimiento | Almacenes en la nube, equipos de plataforma, modelos de chargeback |
Cumplimiento regulatorio & gobernanza de datos lista para auditoría | Muy alta, integración entre módulos y alineación con la gobernanza | Alto esfuerzo de recursos y procesos; despliegues in-database & privados | ⭐⭐⭐⭐⭐ | Evidencia lista para auditoría; menor riesgo de cumplimiento; soberanía del dato | Banca, sanidad, sector público, flujos de reporte regulado |
Convierta las alertas en un modelo operativo de fiabilidad
Los ocho casos de uso de observabilidad de datos resultan útiles cuando un equipo los adopta en un orden que coincide con el riesgo de negocio. Empiece por los conjuntos de datos críticos y las señales de entrega. Si los equipos no saben si llegaron las tablas esenciales, o si los paneles están completos, la monitorización de anomalías y de KPI producirá síntomas confusos en lugar de incidentes accionables.
A continuación, añada detección de anomalías de comportamiento y monitorización de esquemas. Estos controles abordan fallos que las comprobaciones de estado de trabajos no ven, incluidos desplazamientos de distribución, valores ausentes y cambios estructurales. En entornos dependientes de la IA, esta base es cada vez más importante. En 2025 la adopción de monitorización de IA subió del 42 % al 54 % de las organizaciones, mientras el 73 % seguía sin observabilidad de pila completa y el número medio de herramientas de observabilidad bajó de 6 a 4,4 a medida que los equipos consolidaban plataformas (conclusiones de la encuesta de observabilidad de Databahn). La implicación práctica es clara. Los equipos necesitan un único flujo de investigación que relacione la salud de los conjuntos de datos, el comportamiento de las características, las señales del modelo y los resultados de negocio.
Extienda después la cobertura a validación, KPI de negocio, consumo de plataforma y evidencia regulatoria. La validación protege reglas conocidas. La monitorización de negocio protege decisiones. La observabilidad de plataforma protege la infraestructura que entrega y sirve los datos. La monitorización de gobernanza convierte la actividad operativa en evidencia que los equipos de cumplimiento y auditoría pueden revisar.
Cada alerta debería tener cinco atributos:
Responsable nombrado: identifique a la persona o al equipo encargado de la investigación.
Severidad: vincule la prioridad al impacto de negocio, no solo a la desviación técnica.
Señal de detección: indique si el disparador afecta a frescura, volumen, distribución, esquema, validación, comportamiento de KPI o consumo de plataforma.
Ruta de investigación: enlace la alerta con el origen, la canalización, la tabla, la métrica, el modelo o el consumidor posterior que necesita examen.
Vía de escalada: defina cuándo el responsable debe implicar a los equipos de plataforma, negocio, cumplimiento o respuesta a incidentes.
digna sostiene este modelo operativo mediante licenciamiento modular, que permite a las organizaciones empezar con un módulo y ampliar según las tablas activas y las necesidades de monitorización. Su ejecución in-database y sus opciones de despliegue en nube privada o en local mantienen los datos de producción en el entorno del cliente. La plataforma incluye un planificador, un catálogo de datos, integraciones y funciones de colaboración desde la selección inicial del módulo, y da a los equipos de ingeniería y gobernanza un lugar compartido para revisar incidentes y tendencias.
Elija los primeros activos planteando preguntas prácticas. ¿Qué tablas alimentan los paneles o modelos de mayor consecuencia? ¿Qué entregas tienen la dependencia temporal más fuerte? ¿Qué esquemas cambian sin comunicación fiable? ¿Qué registros cargan riesgo regulatorio o financiero? ¿Qué KPI disparan decisiones operativas? ¿Qué cargas de plataforma amenazan la disponibilidad o el control de recursos?
Monitorice primero esas tablas y métricas. Asigne el responsable antes de activar la alerta. Defina la respuesta antes de medir la cobertura. La fiabilidad mejora cuando las señales de observabilidad se convierten en trabajo gestionado y no en otro flujo de telemetría que nadie tiene tiempo de usar.
digna ofrece observabilidad de datos dentro del propio entorno mediante detección de anomalías, monitorización de Timeliness, seguimiento de esquemas, validación a nivel de registro, monitorización de negocio y observabilidad de plataforma. Visite digna para evaluar cómo su plataforma modular e in-database puede conectar estos casos de uso de observabilidad de datos con responsables nombrados y rutas de respuesta accionables.
Para la capa de medición que sostiene estos casos de uso —frescura, completitud, estabilidad de esquema, validez y deriva de distribución, y los umbrales que pertenecen a un contrato de entrega—, consulte fiabilidad de la calidad de datos.
Preguntas frecuentes
¿Cuáles son los principales casos de uso de la observabilidad de datos?
Ocho cubren la mayor parte del trabajo de fiabilidad: detección de paneles obsoletos, desplazamiento de datos y deriva de modelos, retrasos de entrega en canalizaciones, detección de cambios de esquema, anomalías en KPI de negocio, validación de reglas de negocio, monitorización de plataforma y consumo, y gobernanza lista para auditoría. Cada uno empareja una señal con un responsable nombrado y una ruta de respuesta definida.
¿En qué se diferencia la observabilidad de datos de la monitorización de canalizaciones?
La monitorización del estado de los trabajos informa de que una canalización se ejecutó; la observabilidad pregunta qué entregó. Una transformación puede completarse con tres particiones ausentes, y una columna renombrada puede pasar por una ruta de compatibilidad mientras su tasa de nulos sube. El panel se actualiza con éxito en ambos casos.
¿Por qué caso de uso de observabilidad de datos debería empezar un equipo?
Empiece por los conjuntos de datos críticos y las señales de entrega. Si nadie sabe si llegaron las tablas esenciales o si los paneles están completos, la monitorización de anomalías y de KPI produce síntomas confusos en lugar de incidentes accionables. La detección de anomalías de comportamiento y la monitorización de esquemas vienen después, y luego la validación, los KPI, el consumo de plataforma y la evidencia regulatoria.
¿Por qué los cambios de esquema provocan fallos silenciosos?
Las columnas añadidas, eliminadas, renombradas o con el tipo cambiado rara vez detienen una canalización. Provocan valores ausentes, coerción de tipos y uniones incorrectas mientras la ejecución sigue informando de éxito. Una alerta de esquema es una señal de control de impacto, así que debería nombrar las tablas, transformaciones, paneles, modelos y salidas regulatorias afectados, no solo la columna.
¿Qué hace que una alerta de observabilidad de datos sea accionable?
Cinco atributos: un responsable nombrado, una severidad ligada al impacto de negocio, la señal de detección, una ruta de investigación hasta el origen o el consumidor, y una vía de escalada. El volumen por sí solo no ayuda. Una encuesta de 2025 halló que solo el 13 % de la telemetría recogida se usaba activamente para monitorización o resolución de problemas.


