7 ejemplos de catálogos de datos para una mejor gobernanza
|
7
minuto de lectura

Un catálogo solo es útil cuando la gente confía en él. El consejo habitual es tratar un ejemplo de catálogo de datos como un inventario en el que se pueden hacer búsquedas, pero eso pasa por alto la prueba que realmente importa. El catálogo más sólido depende de qué metadatos captura, de cómo se aplican la propiedad y el linaje, de cómo se organizan los activos y de si cada registro incluye suficientes señales de fiabilidad para que los equipos actúen con confianza. Por eso los mejores ejemplos varían según el modelo operativo: desde plataformas centradas en la gobernanza hasta sistemas de metadatos activos, y desde la flexibilidad del código abierto hasta la observabilidad con privacidad desde el diseño dentro de su propio entorno.
Esta perspectiva es importante porque los catálogos modernos han pasado de ser simples listas de esquemas a convertirse en sistemas de gobernanza. Los orígenes de los catálogos se remontan a los diccionarios de datos y los repositorios manuales de metadatos, mientras que las plataformas más recientes admiten linaje, flujos de revisión y confianza en grandes entornos de datos, como resumen la evolución histórica de los catálogos y los patrones de adopción en la gobernanza de datos empresarial la historia del catálogo de datos de DataGalaxy y el resumen de adopción de 2026 de StatPit. Para los equipos que buscan un ejemplo de catálogo de datos, la pregunta clave no es si una herramienta puede listar tablas, sino si el catálogo ayuda a las personas a descubrir, validar, clasificar y utilizar los datos con menos fricción.
Ahí es donde la observabilidad al estilo de digna tiene cabida en la comparación, porque digna combina el descubrimiento propio de un catálogo con la detección de anomalías, la puntualidad, la validación y el seguimiento de esquemas dentro del entorno del cliente. Los siete patrones siguientes muestran cómo funcionan los distintos diseños de catálogo, dónde encajan y qué compromisos deben esperar los equipos.
Índice
1. digna
digna encaja en el patrón de ejemplo de catálogo de datos con privacidad desde el diseño porque trata los metadatos como parte de la fiabilidad operativa, no solo del descubrimiento. La plataforma se ejecuta dentro de su propia nube, VPC o centro de datos, de modo que los datos de producción permanecen en su entorno y las comprobaciones se ejecutan dentro de la base de datos, lo que reduce el movimiento de datos y se alinea con los controles de seguridad. Esto la convierte en una opción práctica para los equipos que necesitan visibilidad de catálogo junto con evidencias de observabilidad fiables en entornos regulados.

El contexto de fiabilidad importa más que un inventario estático
El punto fuerte de digna es que reúne la detección de anomalías, el seguimiento de la puntualidad, la validación a nivel de registro y la monitorización de cambios de esquema en una única interfaz. AWS separa la gestión de metadatos, el catálogo y la gobernanza: el catálogo respalda el descubrimiento y la gobernanza define la política de uso guía de AWS sobre gestión de metadatos. digna se sitúa más cerca del frente operativo, donde los equipos necesitan ver si los datos llegaron a tiempo, si un esquema cambió o si una regla de negocio falló antes de que se rompa un dashboard o un modelo.
La plataforma se adapta a equipos de finanzas, sanidad, telecomunicaciones y sector público que necesitan trazabilidad y evidencias preparadas para el cumplimiento normativo. Además, incluye desde el principio un planificador, un catálogo, integraciones y funciones de colaboración, de modo que el registro del catálogo y el flujo de monitorización permanecen conectados en lugar de dispersarse en herramientas separadas. Para los equipos que comparan modelos de catálogo, esa combinación es importante porque vincula la gobernanza con las comprobaciones de fiabilidad diarias en lugar de dejar las señales de calidad en otro sistema. Su enfoque de observabilidad de datos muestra claramente este patrón.
Regla práctica: Si su equipo dedica más tiempo a explicar por qué los datos son incorrectos que a encontrarlos, los metadatos vinculados a la observabilidad suelen superar a un simple inventario.
digna también ayuda a que grupos técnicos mixtos trabajen desde el mismo sistema, incluidos ingenieros, analistas, responsables de gobernanza y usuarios de negocio. La contrapartida es la responsabilidad del despliegue, ya que la organización tiene que gestionar el entorno por sí misma. Para los equipos que pueden asumir ese modelo, el resultado es un patrón de catálogo construido en torno a la confianza y las evidencias operativas.
Sitio web: digna.ai
2. Alation Data Catalog
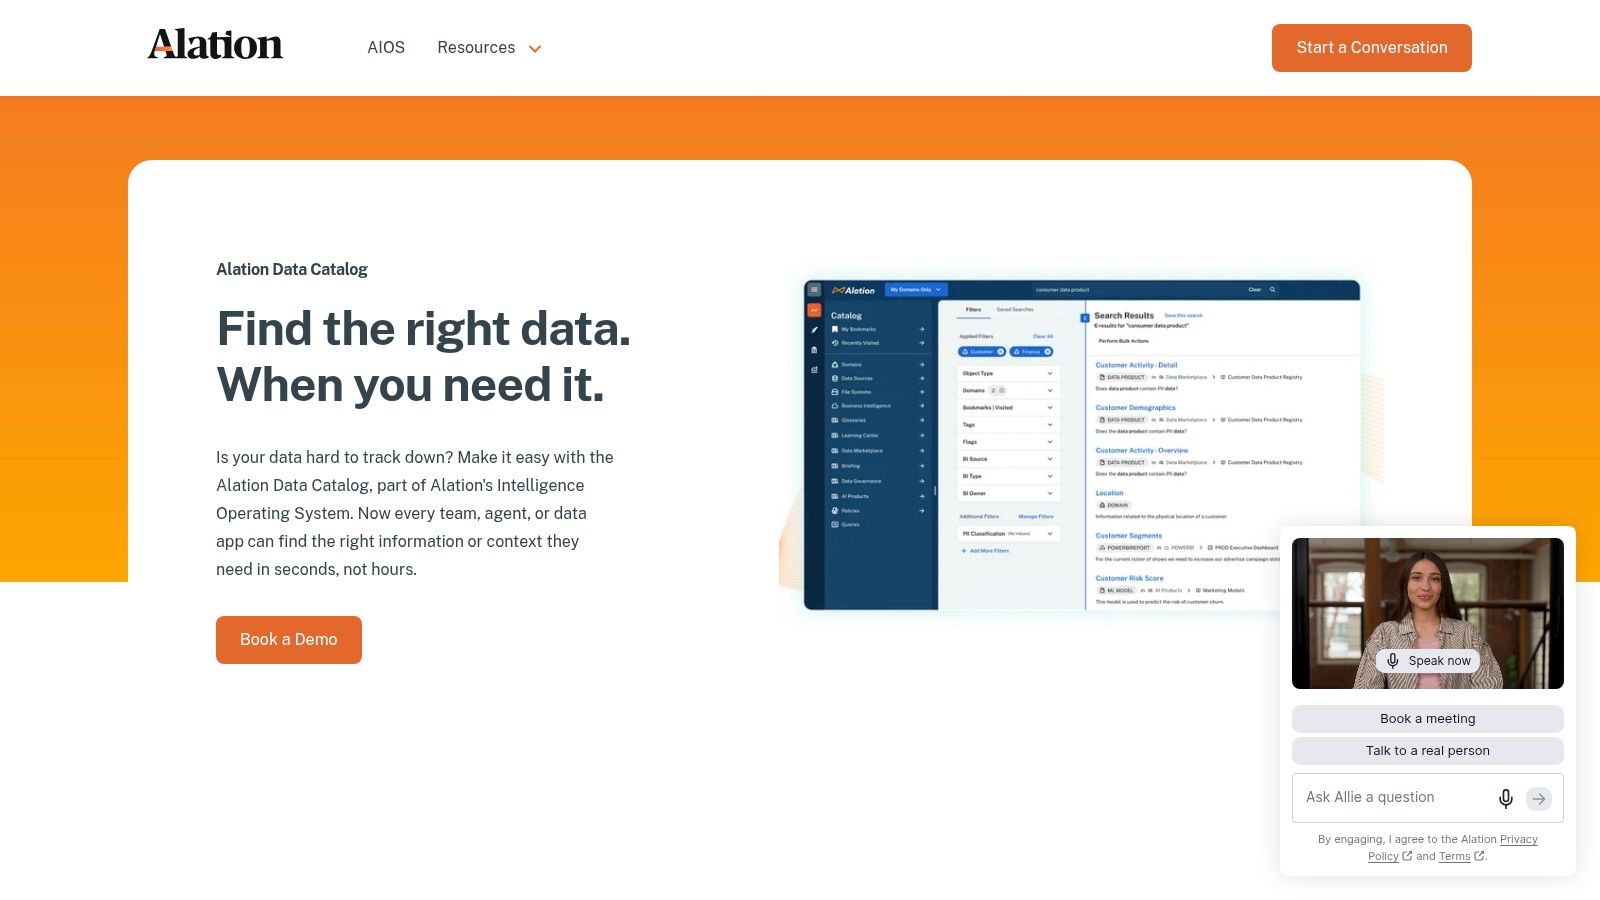
Un catálogo basado en la búsqueda solo funciona cuando los usuarios confían en lo que devuelve la búsqueda. Alation es el ejemplo más claro de este patrón. Está pensado para grandes empresas que necesitan descubrimiento, linaje y una amplia cobertura de conectores, pero la verdadera prueba es si los usuarios de negocio pueden partir de una pregunta y llegar igualmente a contenido gobernado.
Una búsqueda sólida depende de la disciplina en la custodia de datos
El valor va más allá de la indexación. Los términos del glosario, el contexto de las políticas, el linaje y las señales de uso deben mantenerse lo suficientemente bien como para que los resultados de búsqueda no se conviertan en un montón de activos atractivos pero poco fiables. La página del producto de Alation destaca la búsqueda en lenguaje natural, el linaje de extremo a extremo, más de 120 conectores predefinidos y un marco de conectores abierto. Esa combinación tiene sentido cuando la custodia de datos está federada entre muchos sistemas y la propiedad del glosario es explícita.
Esa condición es importante. Si una organización tiene muchas fuentes pero ninguna regla de certificación, una búsqueda clasificada por popularidad puede mostrar contenido más rápido sin mejorar la confianza. En ese caso, el descubrimiento va por delante de la gobernanza y los usuarios siguen necesitando validación manual.
El patrón funciona mejor cuando la adopción es el cuello de botella y ya existe disciplina en la gestión de metadatos. Los usuarios de negocio disponen de una experiencia de búsqueda familiar, mientras que los equipos de datos mantienen una estructura gobernada en un entorno fragmentado. La contrapartida es el esfuerzo operativo. Una cobertura amplia suele implicar más trabajo de capacitación, sobre todo cuando la propiedad y las definiciones de negocio aún no son coherentes.
Como ejemplo de catálogo de datos, Alation muestra cómo el descubrimiento gobernado puede resultar natural sin volverse superficial. El catálogo es más sólido cuando la búsqueda, la custodia y la certificación ya están conectadas. Es más débil cuando la organización todavía necesita definir quién es el propietario de los activos, cuáles son fiables y cómo deben utilizarse los términos. Lectura relacionada: Cómo define digna un catálogo de datos en la práctica
Sitio web: Alation Data Catalog
3. Collibra Data Catalog
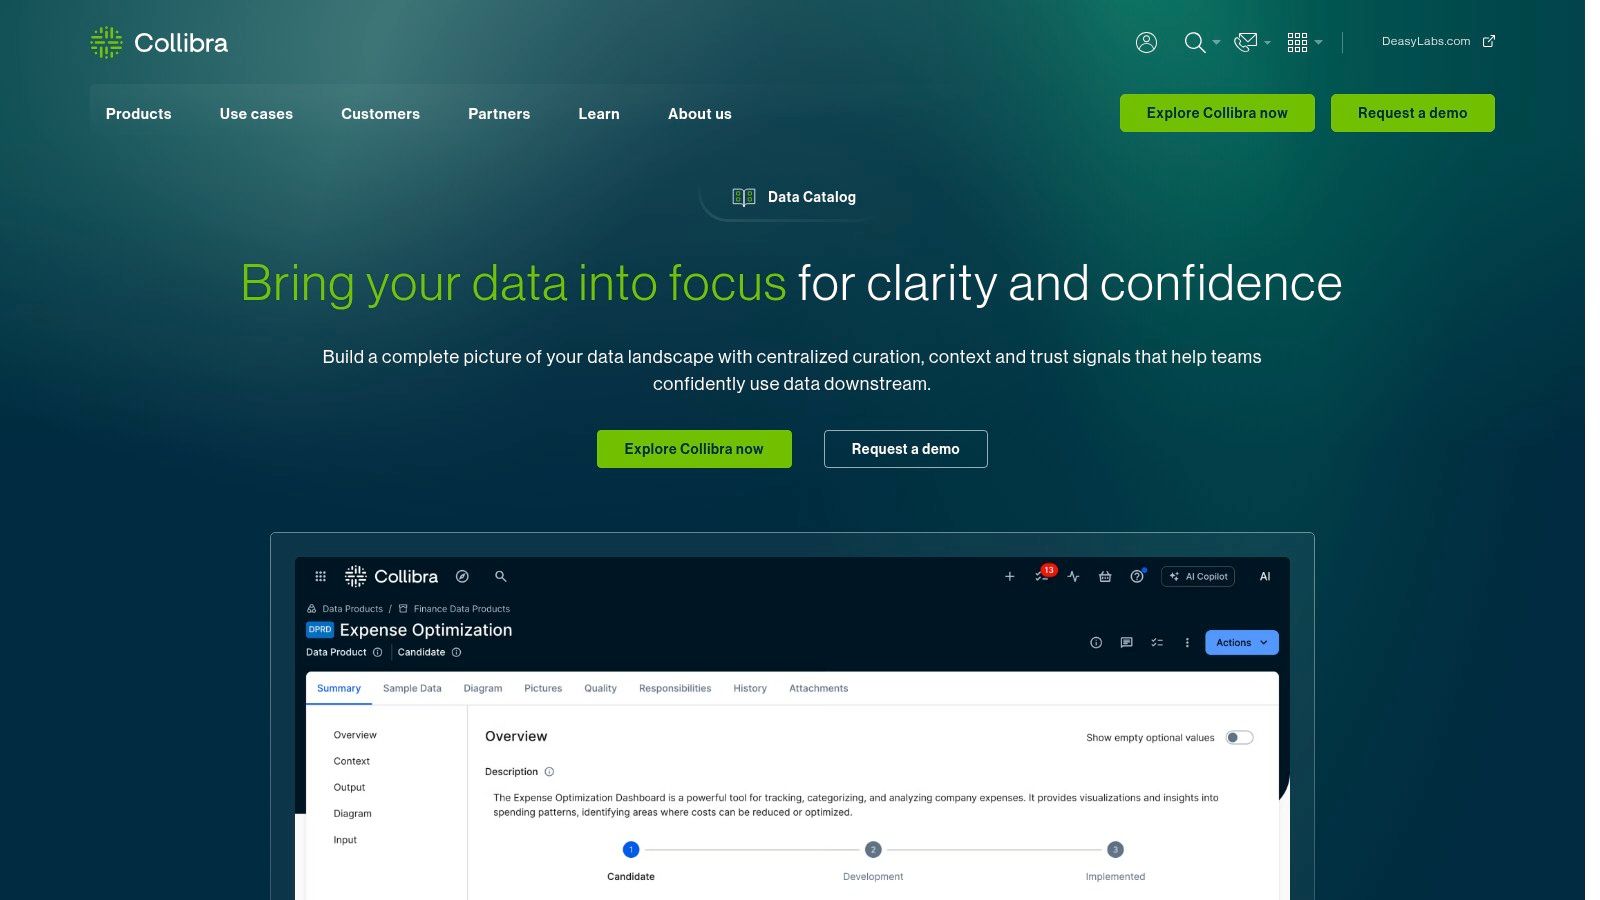
Collibra encaja en el patrón de gobernanza empresarial. Está diseñado para organizaciones que necesitan que el descubrimiento, el linaje, la clasificación de datos sensibles y los flujos basados en políticas funcionen dentro de un modelo más amplio de inteligencia de datos. Esto es importante cuando los departamentos jurídico, de riesgos, de cumplimiento y la oficina de datos necesitan revisar el mismo registro de un activo.
La profundidad de la gobernanza compensa en modelos operativos complejos
La ventaja práctica es el control. La página del producto de Collibra menciona un inventario centralizado, más de 100 integraciones nativas, curación automatizada, etiquetado de datos sensibles, linaje interactivo y un flujo de acceso de tipo marketplace. Esa combinación funciona cuando el catálogo debe mostrar qué es un activo, quién lo aprobó, qué política se aplica y cómo se gobierna el acceso.
El patrón resulta práctico cuando los departamentos jurídico, de riesgos y de cumplimiento deben aprobar conjuntamente los activos y cuando el etiquetado de datos sensibles es obligatorio. También encaja con organizaciones que tienen varias capas de custodia y procesos de revisión formales. Es menos práctico cuando la organización tiene menos de 3 capas de custodia y necesita un descubrimiento ligero. En ese contexto, la carga operativa puede superar el valor del control adicional.
Collibra también es adecuado para equipos que están convirtiendo productos de datos en reutilización gobernada. El acceso de tipo marketplace y el contexto del glosario ayudan a empaquetar datos fiables, pero solo si las responsabilidades de propiedad y revisión ya están claras. La contrapartida es evidente: cuanto más rico es el modelo de control, más disciplina necesitan los equipos en torno a los roles, la administración y la gestión de excepciones.
Un catálogo centrado en la gobernanza debe mostrar la política en el momento del descubrimiento, para que los usuarios vean la regla antes de solicitar el activo.
Cómo define digna una estrategia de gobernanza de datos ofrece aquí un punto de referencia útil. Collibra hace operativa esa estrategia a través de la capa de catálogo. Para las organizaciones que necesitan trazabilidad, gestión de datos sensibles y responsabilidad compartida, ese es el valor del patrón.
Sitio web: Collibra Data Catalog
4. Atlan Active Metadata Catalog
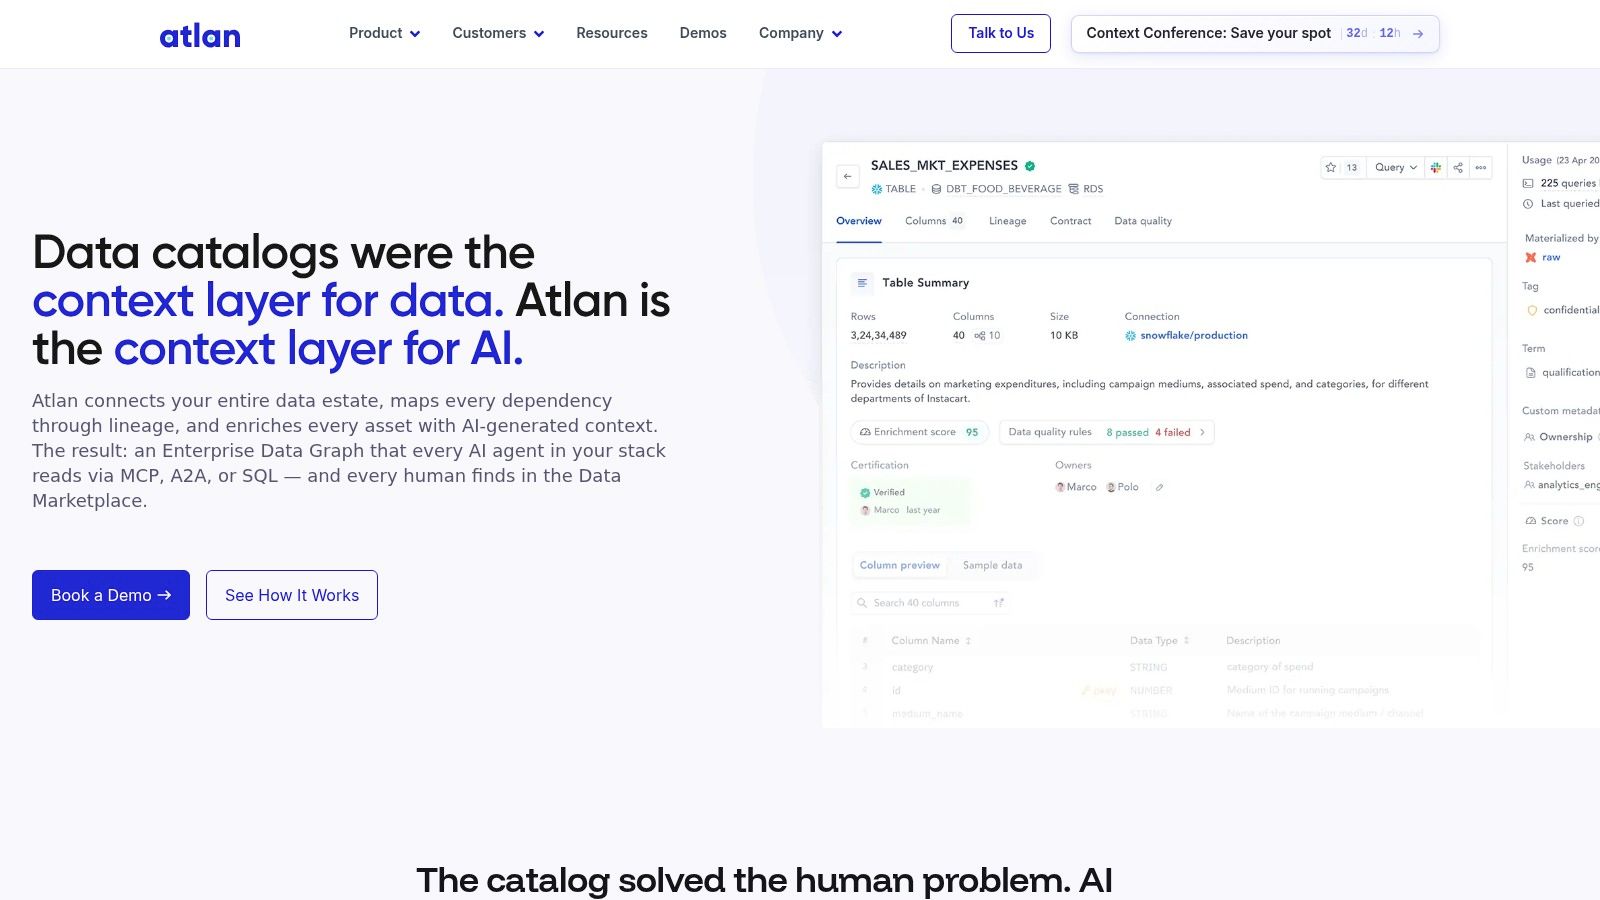
Atlan encaja en el patrón de metadatos activos. El catálogo está diseñado para equipos que quieren que los metadatos cambien a medida que cambian los datos, de modo que la actualidad, el linaje, la certificación y el contexto del dominio permanezcan visibles en el flujo de trabajo. Esto lo hace útil para grupos de analítica y programas de data mesh en los que la propiedad cambia con rapidez y el mantenimiento manual se queda atrás.
Los metadatos activos funcionan cuando el modelo operativo ya es explícito
La página del catálogo de descubrimiento de datos de Atlan menciona la búsqueda en lenguaje natural, el linaje automatizado, las automatizaciones de metadatos activos y la documentación asistida por IA. Estas funciones son más relevantes cuando el catálogo necesita reflejar el contexto operativo en vivo y no una documentación puntual. Si la propiedad, la actualidad y la certificación cambian con frecuencia, un catálogo estático queda obsoleto rápidamente.
El patrón funciona cuando los límites de los dominios están definidos, los contratos de propiedad existen en el código y los pipelines de metadatos están basados en eventos. En ese contexto, el catálogo puede actualizar el contexto a medida que se producen los cambios y mantener la custodia distribuida. Sin esas condiciones, la automatización puede escalar la confusión con la misma facilidad con la que escala la documentación.
Cuándo funciona: los equipos de dominio ya son propietarios de productos de datos, los eventos de metadatos son fiables y el catálogo puede publicar actualizaciones sin intervención manual. Cuándo falla: los límites son difusos, la propiedad está en hojas de cálculo y las señales obsoletas sobrescriben el contexto local.
Aquí encaja un apunte de analista de digna sobre el descubrimiento de datos. El descubrimiento solo resulta útil cuando el catálogo refleja cómo trabajan ya los equipos. Atlan es más sólido cuando la velocidad de colaboración es importante y la organización quiere una interfaz moderna que fomente la participación, pero la contrapartida es clara: depende de un diseño disciplinado de los dominios antes de que la automatización pueda ayudar.
Sitio web: Atlan Data Discovery Catalog
5. Microsoft Purview Unified Catalog
Microsoft Purview encaja en el patrón de custodia nativa en la nube, pero solo en las condiciones operativas adecuadas. Es más práctico cuando un entorno con fuerte presencia de Microsoft ya abarca Azure, Fabric y OneLake, y el equipo necesita que la gobernanza se amplíe por etapas en lugar de mediante un cambio completo de plataforma. En esa configuración, el catálogo sigue a la plataforma que la organización ya utiliza.
La gobernanza basada en el uso encaja con implantaciones graduales
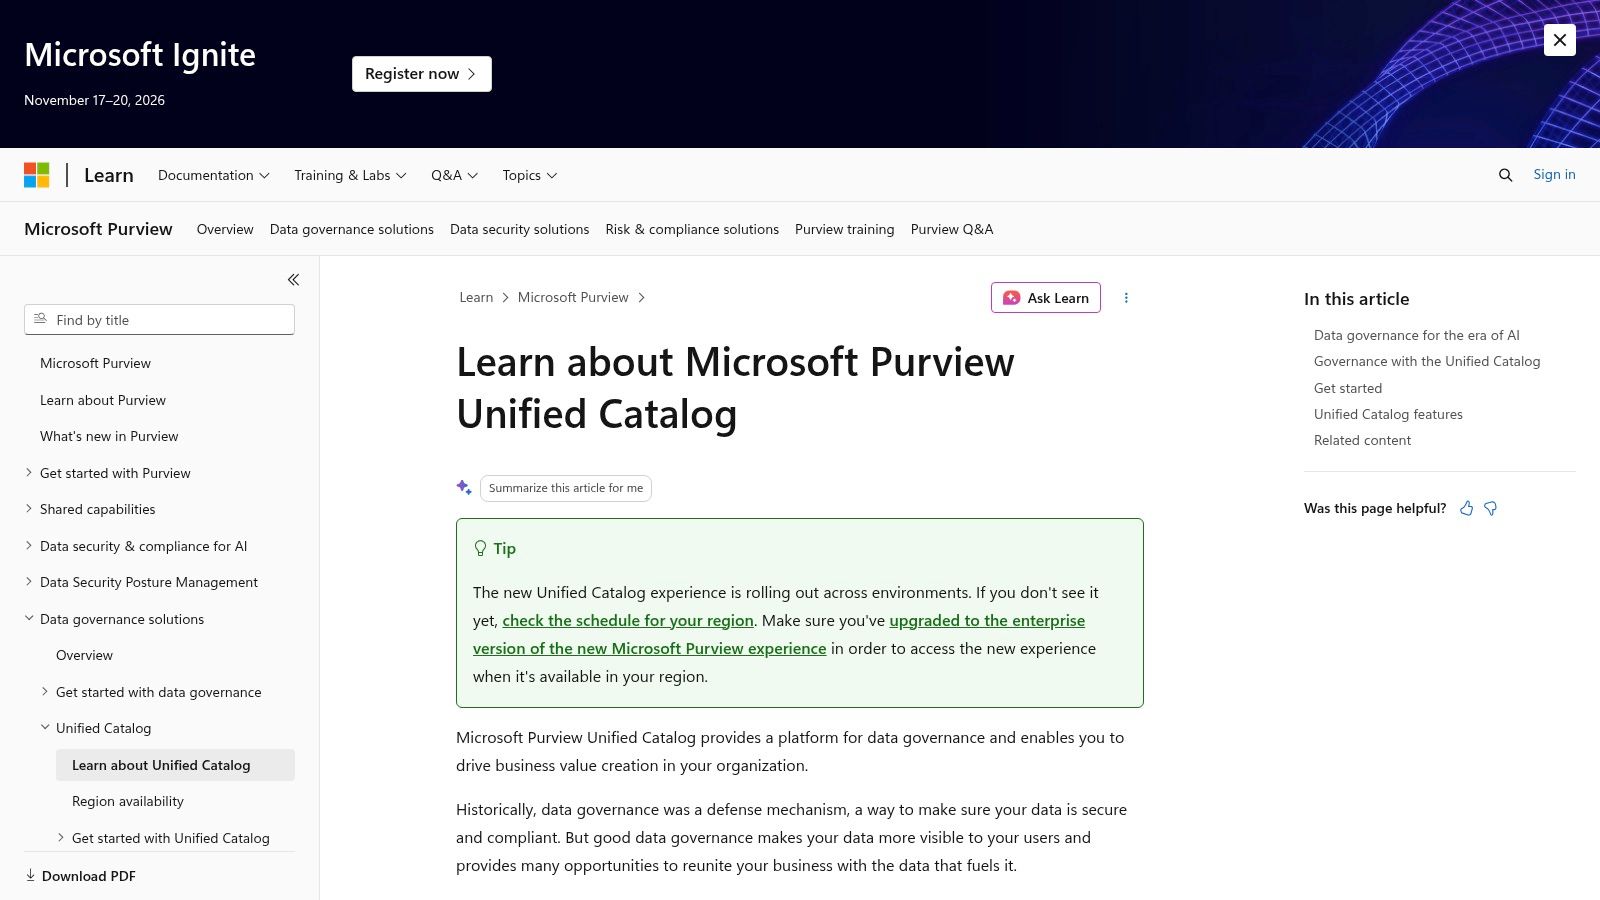
La documentación de Unified Catalog de Purview muestra un modelo basado en el escaneo multinube, mapas de datos centralizados, linaje, clasificaciones y procesamiento de gobernanza basado en DGPU. El valor práctico no está en una teoría amplia sobre catálogos, sino en la posibilidad de empezar con un alcance limitado, validar los conectores y ampliar la gobernanza donde el uso justifique el gasto.
Elija este patrón cuando necesite una gobernanza de pago por uso y la integración con Fabric sin cambiar de plataforma. Reserve de 2 a 3 sprints para validar los conectores de fuentes que no son de Microsoft, porque la cobertura varía según el conector y eso afecta a la adopción. El modelo es práctico cuando aproximadamente el 70 % o más de los activos se encuentran en Azure, Fabric u OneLake, y menos práctico cuando el entorno es multinube con poca presencia de Microsoft.
Esto deja clara la contrapartida. Los equipos centrados en Microsoft obtienen un mejor encaje, menos fricción de integración y una capa de gobernanza próxima al stack de seguridad que ya utilizan. Los equipos con entornos de fuentes mixtas pueden seguir usando Purview, pero la variabilidad de los conectores puede dejar activos importantes fuera de la cobertura más fiable del catálogo.
Como ejemplo de catálogo de datos en un entorno con fuerte presencia de Microsoft, se trata de un patrón reutilizable más que de un catálogo genérico. Funciona mejor cuando la madurez de la gobernanza puede crecer por fases y la organización quiere que el catálogo siga su modelo operativo de Microsoft.
Sitio web: documentación de Microsoft Purview
Lectura relacionada: digna sobre la gestión de metadatos
6. DataHub Open Source y DataHub Cloud
DataHub representa el patrón de flexibilidad liderada por ingeniería. Encaja con equipos que quieren linaje, búsqueda, flujos de gobernanza y señales de observabilidad sin comprometerse con un stack de catálogo cerrado. La edición de código abierto da el control a los equipos técnicos. DataHub Cloud mantiene el mismo modelo, pero elimina gran parte de la carga de infraestructura.
Control de ingeniería frente a carga operativa: lo que cuesta realmente el compromiso del código abierto
El punto fuerte de DataHub no es una amplitud genérica de catálogo, sino la capacidad de dar forma a los metadatos como parte de la plataforma, en lugar de limitarse a consumirlos como una herramienta de front-end. Esto hace que el patrón sea práctico para equipos que ya gestionan plataformas internas, conectores personalizados y pipelines de metadatos que pueden mantener a medida que cambia el stack.
DataHub Cloud reduce la carga operativa, pero la contrapartida no desaparece. El control del código abierto sigue exigiendo gestionar las actualizaciones, mantener los conectores y contar con alguien capaz de mantener la ingesta en buen estado cuando cambian los sistemas de origen. Encaja cuando un equipo de plataforma puede asumir ese trabajo, y resulta más difícil de justificar cuando la organización carece de capacidad dedicada de SRE o de operaciones de catálogo.
Señal de encaje | Práctico si | Menos práctico si |
|---|---|---|
Modelo operativo | ingeniería es propietaria de los flujos de metadatos | se espera que el catálogo funcione con poco soporte práctico |
Opción de despliegue | las extensiones personalizadas y el autoalojamiento son importantes | el equipo quiere una responsabilidad mínima sobre la infraestructura |
Enfoque en la fiabilidad | los pipelines de ingesta se supervisan y se mantienen | las actualizaciones y los conectores se dejan a esfuerzos puntuales |
Para los compradores que comparan un ejemplo de catálogo de datos entre distintos estilos de despliegue, DataHub es el caso más claro de control autoalojado junto con una opción gestionada. Funciona mejor cuando la infraestructura de metadatos se trata como software, con propiedad, disciplina de versiones y una responsabilidad operativa clara.
Sitio web: DataHub
7. Informatica Cloud Data Governance and Catalog
En entornos híbridos donde la amplitud de los escáneres determina si el catálogo está completo, Informatica prioriza la cobertura sobre una experiencia de descubrimiento más ligera. Es adecuado para organizaciones que ya utilizan herramientas de Informatica y necesitan que la catalogación se conecte con el trabajo de integración, calidad y gobernanza.
La amplitud importa cuando el entorno de datos es desordenado
La página del producto del catálogo destaca el escaneo automatizado, el perfilado, el linaje, el glosario, la gestión de políticas y los servicios complementarios de calidad e integración de datos. Ese perfil es importante cuando hay que cubrir tanto sistemas en la nube como on-premises, y cuando los artefactos de gobernanza deben mantenerse alineados con los metadatos técnicos. El valor reside en una cobertura completa de metadatos más que en un descubrimiento ligero.
Este patrón encaja con empresas que necesitan una amplia compatibilidad de escáneres y un acoplamiento más estrecho con un stack de gestión de datos existente. La contrapartida es el peso operativo. El alcance, la administración y la capacitación pueden llegar a ser considerables, sobre todo cuando tanto los equipos técnicos como los usuarios de gobernanza dependen del mismo catálogo. La adopción suele ser mayor cuando el trabajo de catalogación forma parte de un modelo operativo más amplio y no funciona como una herramienta de búsqueda independiente.
Elija Informatica cuando el entorno requiera una amplia cobertura de escáneres y servicios de calidad o integración vinculados a IDMC. Elija Collibra cuando la gobernanza de tipo marketplace y los flujos para usuarios de negocio importen más que la profundidad del escaneo. Para los lectores que comparan un ejemplo de catálogo de datos con la máxima amplitud de plataforma, Informatica es la opción más clara para las organizaciones que quieren que la catalogación funcione como parte de un programa de gestión de datos más amplio.
Sitio web: Informatica Cloud Data Governance and Catalog
Comparativa de los 7 principales catálogos de datos
Producto | Complejidad de implementación (🔄) | Recursos y operaciones (⚡) | Resultados esperados (⭐📊) | Casos de uso ideales | Ventajas clave (💡) |
|---|---|---|---|---|---|
digna | Media (🔄🔄), instalación en el entorno y configuración de módulos | Moderado‑alto ⚡, el cliente gestiona la infraestructura; el cálculo en la base de datos reduce el movimiento de datos | Altos ⭐⭐⭐⭐, observabilidad de nivel empresarial, rápido tiempo hasta el valor (información en <2 h) | Empresas reguladas que necesitan comprobaciones in situ con privacidad desde el diseño | Ejecución en el propio entorno, comprobaciones en la base de datos, licencias modulares, anomalías con IA + validación determinista |
Alation Data Catalog | Media‑alta (🔄🔄🔄), trabajo de gobernanza y adopción | Moderado ⚡, conectores + capacitación para entornos amplios | Altos ⭐⭐⭐⭐, descubrimiento sólido, búsqueda y adopción de la gobernanza | Grandes empresas que buscan descubrimiento y búsqueda de datos gobernados | Búsqueda en lenguaje natural, linaje, más de 120 conectores, flujos de gobernanza |
Collibra Data Catalog | Alta (🔄🔄🔄), requiere configurar roles y modelo a nivel de organización | Alto ⚡, esfuerzo considerable de capacitación y de modelo operativo | Altos ⭐⭐⭐⭐, gobernanza integral, controles de datos sensibles | Organizaciones complejas con necesidades de cumplimiento y de productos de datos | Gobernanza centralizada, etiquetado de datos sensibles, AI Copilot, marketplace/flujos de trabajo |
Atlan, Active Metadata Catalog | Media (🔄🔄), UX más rápida, pero requiere diseño de dominios | Moderado ⚡, la UX moderna reduce la fricción; cierta configuración para los dominios | Buenos ⭐⭐⭐, adopción más rápida y gestión colaborativa de metadatos | Equipos de data mesh/dominio, equipos de analítica centrados en la colaboración | Automatizaciones de metadatos activos, documentación asistida por IA, flujos de dominio/producto |
Microsoft Purview, Unified Catalog | Baja‑media (🔄🔄), nativo en la nube, implantación gradual | Moderado ⚡, facturación de pago por uso (DGPU); variabilidad de conectores | Buenos ⭐⭐⭐, catálogo unificado para ecosistemas de Microsoft | Organizaciones centradas en Microsoft/Azure/Fabric | Escaneo multinube, integración con Fabric/OneLake, precios transparentes basados en el uso |
DataHub (código abierto) / DataHub Cloud | Media (🔄🔄), la versión OSS requiere ingeniería; Cloud facilita las operaciones | Variable ⚡, alto si es autoalojado; DataHub Cloud reduce la carga operativa | Buenos ⭐⭐⭐, metadatos adaptados a desarrolladores, linaje/búsqueda sólidos | Equipos que buscan la flexibilidad del OSS o una vía SaaS gestionada | Comunidad de código abierto, despliegue flexible, precios de entrada transparentes (Cloud) |
Informatica, Cloud Data Governance & Catalog (IDMC) | Alta (🔄🔄🔄), despliegue y gobernanza a escala empresarial | Alto ⚡, escáneres amplios y administración continua | Altos ⭐⭐⭐⭐, escaneo profundo, perfilado e integraciones empresariales | Entornos híbridos muy grandes que necesitan una amplia cobertura de fuentes | Amplitud de escáneres empresariales, linaje detallado, integración con el ecosistema IDMC |
Elija el patrón que su modelo operativo pueda sostener
El catálogo adecuado depende menos del número de funciones y más de si su modelo operativo puede sostener el comportamiento que espera la herramienta. Si necesita gobernanza empresarial y evidencias de cumplimiento, Collibra o Informatica tienen sentido. Si la adopción depende de una búsqueda rápida e intuitiva, Alation es la opción más acertada. Si sus equipos trabajan por dominios y productos, Atlan ofrece un espacio práctico para los metadatos activos. Si su entorno está centrado en Microsoft, Purview encaja de forma natural. Si ingeniería quiere control y flexibilidad, DataHub es la vía abierta. Si lo más importante es la fiabilidad, la privacidad y la ejecución dentro del propio entorno, digna es el patrón con mayor base operativa.
Una forma útil de compararlos es plantear seis preguntas. ¿Pueden las personas encontrar el activo rápidamente? ¿Pueden ver un linaje en el que confíen? ¿Puede el glosario o la taxonomía mantener la coherencia de los términos? ¿Pueden las señales de observabilidad o de actualidad advertirles antes de que utilicen datos obsoletos? ¿Puede el modelo de despliegue ajustarse a su postura de seguridad? ¿Y puede su equipo asumir la carga operativa que conlleva el diseño elegido?
Descubrimiento: Alation y Atlan lideran el descubrimiento basado en la búsqueda, mientras que Collibra, Purview, DataHub, Informatica y digna combinan el descubrimiento con distintas capas de gobernanza o fiabilidad.
Linaje: Collibra, Purview, DataHub, Informatica y Alation hacen hincapié en la visibilidad del linaje, mientras que digna vincula las comprobaciones de fiabilidad con las señales de esquema y puntualidad.
Compatibilidad con taxonomías o glosarios: Collibra, Alation, DataHub e Informatica ofrecen el contexto de glosario y de políticas más sólido, mientras que Atlan y Purview se inclinan por el contexto operativo.
Contexto de observabilidad: digna es la opción más explícita, mientras que DataHub y Collibra incorporan señales complementarias a la capa de catálogo.
Modelo de despliegue: Purview y los proveedores en la nube favorecen las vías gestionadas o nativas en la nube, DataHub ofrece autoalojamiento o nube, y digna se ejecuta dentro de la infraestructura del cliente.
Carga operativa: Tanto la flexibilidad del código abierto como la profundidad de la gobernanza empresarial exigen asumir responsabilidades. La diferencia está en dónde recae la carga: en ingeniería, en administración o en ambas.
La secuencia práctica es sencilla. Primero, defina el registro de metadatos; en segundo lugar, establezca las reglas de propiedad y taxonomía; en tercer lugar, realice un piloto con un conjunto de datos de alto valor; a continuación, añada señales de confianza como el linaje, la actualidad o la validación, y, por último, mida si los usuarios pueden encontrar el activo y utilizarlo con confianza. Un catálogo se gana la adopción cuando ayuda a las personas a tomar decisiones más rápido y con menos discusiones sobre el significado de los datos.
digna ofrece a los equipos un tipo distinto de experiencia de catálogo, en la que el descubrimiento y la observabilidad permanecen conectados dentro del mismo entorno. Si necesita una plataforma que vincule los metadatos con las anomalías, la puntualidad, la validación y los cambios de esquema sin sacar los datos de producción de su control, visite digna y evalúe si ese modelo operativo se ajusta a su ejemplo de catálogo de datos mejor de lo que podría hacerlo un inventario estático.
Si el registro del catálogo debe incluir señales de actualidad, cambios de esquema y validación en lugar de un inventario estático, vea cómo gestiona digna la observabilidad de plataformas de datos dentro de su propio entorno.
Preguntas frecuentes
¿Qué es un buen ejemplo de catálogo de datos?
No existe un único mejor ejemplo; el artículo compara siete patrones. Alation representa el descubrimiento basado en la búsqueda; Collibra, la gobernanza empresarial; Atlan, los metadatos activos; Microsoft Purview, la custodia nativa en la nube; DataHub, la flexibilidad del código abierto; Informatica, la amplitud de escáneres, y digna, un patrón con privacidad desde el diseño que vincula los registros del catálogo con comprobaciones de observabilidad dentro de su propio entorno.
¿Es Microsoft Purview un buen catálogo de datos para un entorno de nube mixto?
Purview funciona mejor cuando aproximadamente el 70 % o más de los activos se encuentran en Azure, Fabric u OneLake. Para las fuentes que no son de Microsoft, el artículo aconseja reservar de 2 a 3 sprints para validar los conectores, ya que la cobertura varía según el conector y algunos activos importantes pueden quedar fuera de la cobertura más fiable del catálogo.
¿Cuál es la diferencia entre los catálogos de datos de Collibra e Informatica?
Elija Informatica cuando el entorno necesite una amplia cobertura de escáneres y vínculos con los servicios de calidad o integración de IDMC. Collibra es la mejor opción cuando la gobernanza de tipo marketplace, el etiquetado de datos sensibles y los flujos para usuarios de negocio importan más que la profundidad del escaneo, aunque es menos práctico para organizaciones con menos de 3 capas de custodia.
¿Cuándo funciona un catálogo de metadatos activos como Atlan?
Los metadatos activos funcionan cuando los límites de los dominios están definidos, los contratos de propiedad existen en el código y los pipelines de metadatos están basados en eventos. Fallan cuando los límites son difusos y la propiedad está en hojas de cálculo, porque entonces la automatización escala la confusión con la misma facilidad que la documentación. La búsqueda en lenguaje natural y el linaje automatizado de Atlan solo ayudan una vez sentadas esas bases.
¿Cómo debo implantar un catálogo de datos?
Siga una secuencia de cinco pasos: primero, defina el registro de metadatos; en segundo lugar, establezca las reglas de propiedad y taxonomía, y en tercer lugar, realice un piloto con un conjunto de datos de alto valor. Después, añada señales de confianza como el linaje, la actualidad o la validación y, por último, mida si los usuarios pueden encontrar el activo y utilizarlo con confianza antes de ampliar el catálogo.



