Was ist Datenqualitätsmanagement im Gesundheitswesen?
|
8
min. Lesezeit

Eine Ärztin öffnet vor der Morgenvisite ein Dashboard und sieht einen beruhigenden Trend. Der jüngste Laborwert wirkt normal, doch der Feed kam erst nach dem Berichtszeitfenster an. An anderer Stelle widerspricht ein Diagnosecode der Krankengeschichte des Patienten, weil ein Quellsystem den Wert beim Datenaustausch anders gemappt hat. Der Datensatz existiert, ist aber für die anstehende Entscheidung nicht geeignet.
Genau das bedeutet Datenqualitätsmanagement im Gesundheitswesen in der Praxis: die kontinuierliche Disziplin, zu prüfen, ob klinische, betriebliche, Public-Health-, Forschungs- und regulatorische Daten vollständig, korrekt, konsistent, aussagekräftig und dann verfügbar sind, wenn sie gebraucht werden. Die Arbeit reicht von Kontrollen bei der Erfassung über die Validierung beim Datenaustausch, Anomalieerkennung und Fehlerbehebung bis hin zu Lineage und Governance.
Inhaltsverzeichnis
Was bei klinischer Datenintegrität auf dem Spiel steht
Wo Fehler sichtbar werden
Die Kerndimensionen der Datenqualität im Gesundheitswesen
Vier Fragen an denselben Datensatz
Aus Dimensionen werden Kontrollen
Typische Fallstricke bei der Validierung von Gesundheitsdaten
Drei Fehlerarten, die man trennen sollte
Warum aggregierte Scores Risiken verdecken
Von statischen Audits zu kontinuierlicher Observability
Audit-Kontrollen und Observability im Vergleich
Was kontinuierliches Monitoring sichtbar machen sollte
Interoperabilität und regulatorische Compliance sicherstellen
Strukturelle Konformität ist keine semantische Übereinstimmung
Auch saubere Daten können zu unsicherer KI führen
Ein skalierbares Datenqualitäts-Framework umsetzen
Die Kontrollebene schichtweise aufbauen
Datenbewegung und Alarmrauschen reduzieren
Datenstrategien im Gesundheitswesen zukunftssicher machen
Was bei klinischer Datenintegrität auf dem Spiel steht
Ein verspätetes Ergebnis kann ebenso viel Schaden anrichten wie ein falsches. Erhält ein klinisches Data Warehouse einen Laborwert erst, nachdem das Behandlungsteam den Zustand des Patienten bereits beurteilt hat, sind die Daten zwar technisch korrekt, aber operativ unsicher. Dasselbe gilt für eine fehlende Allergie, eine doppelt angelegte Patientenidentität, eine veraltete Medikationsliste oder eine Diagnose, deren Bedeutung sich zwischen zwei Systemen verändert hat.
Teams im Gesundheitswesen treffen Entscheidungen über vernetzte Systeme. Elektronische Patientenakten, Laborplattformen, Bildgebungssysteme, Register, Abrechnungsumgebungen und Reporting-Warehouses liefern jeweils einen Teil der Patientengeschichte. Fällt eine Komponente aus, wiederholen Mitarbeitende Untersuchungen, gleichen Datensätze manuell ab, verzögern Berichte oder handeln auf Basis eines unvollständigen Bildes.
Der Umfang des Datenaustauschs macht Verfügbarkeit zu einer Qualitätsanforderung statt zu einem bloßen Komfortmerkmal. 2021 haben 88 % der US-Krankenhäuser Gesundheitsinformationen von Patienten elektronisch versendet oder abgerufen, entweder per Abfrage oder durch den elektronischen Empfang von Summary-of-Care-Dokumenten, so der Interoperabilitäts-Datenbericht des Office of the National Coordinator for Health IT. Daten, die am Point of Care nicht gefunden, interpretiert oder genutzt werden können, verfehlen ihren Zweck, auch wenn sie irgendwo gespeichert bleiben.
Wo Fehler sichtbar werden
Schlechte Datenqualität erzeugt verschiedene Arten operativer Risiken:
Klinisches Risiko: Fehlende oder widersprüchliche Informationen können Diagnose, Medikationsabgleich und Therapieentscheidungen verfälschen.
Reporting-Risiko: Unvollständige Ereignisse oder instabile Nenner können Qualitätsindikatoren besser oder schlechter erscheinen lassen, als sie tatsächlich sind.
Forschungsrisiko: Inkonsistente Kodierung und unklare Herkunft schwächen die Reproduzierbarkeit und machen Kohortendefinitionen schwerer zu verteidigen.
Compliance-Risiko: Teams können unter Umständen nicht belegen, welche Datensätze geprüft wurden, welche Regel fehlgeschlagen ist und wie die Behebung erfolgte.
Vertrauensrisiko: Ärztinnen, Ärzte und Analysten verlassen sich nicht mehr auf Dashboards, wenn sie immer wieder Abweichungen finden.
Ein periodisches Bereinigungsprojekt löst diese Probleme nicht. Bis ein Audit eine verspätete Schnittstelle, ein fehlerhaftes Mapping oder eine fehlende Ladung einer Einrichtung entdeckt, haben nachgelagerte Berichte und Modelle die Daten womöglich längst verarbeitet. Die eigentliche Frage ist nicht, ob eine Organisation Fehler hat. Jede komplexe Gesundheitsumgebung hat sie. Die Frage ist, ob sie relevante Fehler früh erkennen, ihre Ursache bestimmen und die Reaktion darauf nachvollziehbar dokumentieren kann.
Wie sich solche Fehler konkret auf die Versorgung auswirken, zeigen fünf schwerwiegende Vorfälle, die durch schlechte Datenqualität im Gesundheitswesen verursacht wurden. Die zentrale Lehre ist einfach: Datenintegrität ist Teil der Patientensicherheit und der operativen Kontrolle und kein isoliertes Thema für das Backlog des Data Engineering.
Die Kerndimensionen der Datenqualität im Gesundheitswesen
Das Data-Quality-Review-Framework der Weltgesundheitsorganisation bietet Teams im Gesundheitswesen eine nützliche Grundlage. Es definiert Qualität über Vollständigkeit, interne Konsistenz, externen Vergleich und externe Konsistenz der Bevölkerungsdaten, wie im WHO-Leitfaden zu Framework und Metriken beschrieben.
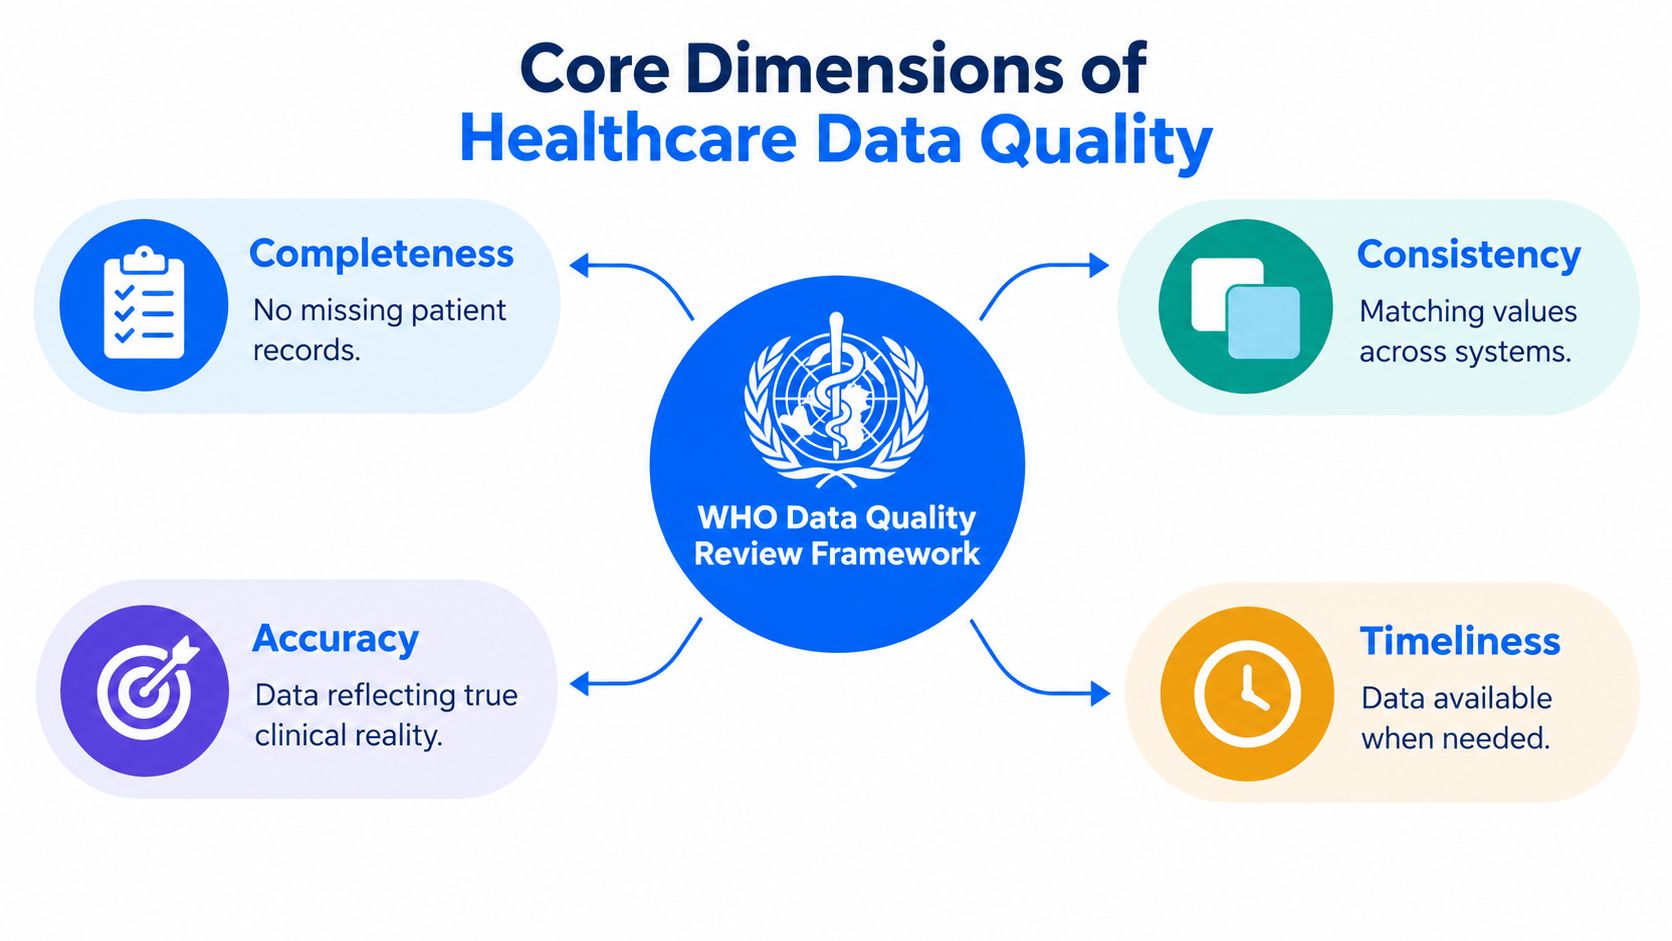
Diese Dimensionen liefern ein gemeinsames Vokabular, um zu beurteilen, ob Daten für einen definierten Zweck geeignet sind. Sie sollten aber nicht zu einer Checkliste werden, die vom Kontext des Arbeitsablaufs losgelöst ist.
Vier Fragen an denselben Datensatz
Vollständigkeit fragt, ob die erforderlichen Datensätze, Felder, Ereignisse und Berichtseinheiten vorhanden sind. Eine Einrichtung liefert vielleicht Behandlungsfälle, lässt aber Entlassungsereignisse weg, oder sie befüllt demografische Angaben, während klinisch wichtige Felder leer bleiben. Zur Vollständigkeit gehört auch das Lieferverhalten. Eine vollständige Datei, die nach einer Berichtsfrist eintrifft, kann für diesen Zweck dennoch unbrauchbar sein.
Interne Konsistenz fragt, ob zusammengehörige Werte übereinstimmen. Datumsangaben sollten gültigen Abfolgen folgen, verknüpfte Datensätze sollten auf existierende Entitäten verweisen, und Werte sollten klinische oder fachliche Regeln einhalten. Alter, Behandlungsdatum, Diagnose und Eingriffshistorie eines Patienten können einzeln gültig aussehen und zusammen dennoch eine unmögliche Kombination ergeben.
Externer Vergleich prüft Summen gegen eine unabhängige Quelle. Die Aktivität einer Einrichtung lässt sich mit einem Register, einer Quellanwendung, einem Laborsystem oder einem Berichtsjournal abgleichen. So lässt sich systematische Untererfassung erkennen, die Prüfungen auf Datensatzebene übersehen.
Externe Konsistenz der Bevölkerungsdaten untersucht, ob Nenner und Bevölkerungsschätzungen die berichteten Raten aussagekräftig machen. Eine Impfquote, eine Aufnahmerate oder ein Krankheitsindikator kann korrekt berechnet sein und Entscheidungsträger dennoch in die Irre führen, wenn die zugrunde liegende Bevölkerungsschätzung veraltet ist oder nicht passt.
Das Framework unterstützt außerdem praktische Anforderungen an Genauigkeit, Zuverlässigkeit und Aktualität. Genauigkeit beschreibt, wie nah ein Wert an der tatsächlichen Leistungserbringung oder klinischen Realität liegt. Zuverlässigkeit beschreibt, ob wiederholte Messungen stabil und belastbar bleiben. Aktualität beschreibt, ob Informationen innerhalb des Zeitfensters verfügbar sind, das der vorgesehene Zweck erfordert.
Aus Dimensionen werden Kontrollen
Ein Qualitätsprogramm sollte Schwellenwerte je Datensatz und Arbeitsablauf festlegen, statt einen einzigen organisationsweiten Score zu veröffentlichen. Sinnvolle Kontrollen sind:
Prüfungen der Abdeckung von Pflichtfeldern und Ereignissen.
Validierung von Wertebereichen, Code-Sets und bedingten Regeln.
Systemübergreifender Abgleich von Summen und Identifikatoren.
Überwachung verspäteter, fehlender oder ungewöhnlich kleiner Ladungen.
Dokumentation von Ausnahmen, Verantwortlichkeiten, Behebung und Nachweisen.
Die Dimensionen der Datenqualität sind wichtig, weil ein Datensatz vollständig, aber ungenau, konsistent, aber veraltet, oder strukturell gültig, aber inhaltlich irreführend sein kann. Datenqualitätsmanagement beginnt dort, wo Teams jede Dimension mit der Entscheidung verknüpfen, die die Daten unterstützen sollen.
Typische Fallstricke bei der Validierung von Gesundheitsdaten
Der häufigste Validierungsfehler besteht darin, befüllte Felder als Qualitätsbeweis zu betrachten. Ein Wert kann vorhanden und korrekt typisiert sein und trotzdem für den Patienten, für die Episode oder in seiner Bedeutung nach dem Austausch falsch sein. Teams im Gesundheitswesen brauchen getrennte Kontrollen für Vollständigkeit, Genauigkeit, Gültigkeit, Konsistenz, Eindeutigkeit und Aktualität.
Die Unterscheidung hat praktische Folgen. Die Qualitätsmethodik der britischen Regierung für Berichte zu therapieassoziierten Infektionen definiert Genauigkeit als Nähe zur Realität, Vollständigkeit als Vorhandensein erwarteter Datensätze und wesentlicher Werte und Aktualität als Zeitnähe und Verfügbarkeit für den abgebildeten Zeitraum. Sie hält zudem einen entscheidenden Punkt fest: Vollständigkeit ist nicht gleich Genauigkeit.
Drei Fehlerarten, die man trennen sollte
Fehlende Daten: Der erwartete Behandlungsfall, die Beobachtung, der Nenner oder das Pflichtfeld kommt nie an. Die Reaktion besteht darin, Erfassung, Schnittstellenlieferung und Ingestion zu untersuchen.
Falsche Daten: Der Datensatz kommt an, doch sein Wert widerspricht einer maßgeblichen Quelle, einem Wertebereich oder einer klinischen Regel. Die Reaktion erfordert Abgleich, Validierung und Korrektur.
Verspätete oder veraltete Daten: Der Wert ist korrekt, steht aber nicht zur Verfügung, wenn der Arbeitsablauf ihn braucht. Die Reaktion erfordert Liefer-Baselines und ein Monitoring der Aktualität.
Eine vierte Kategorie verdient ebenso viel Aufmerksamkeit: semantisches Versagen. Zwei Systeme können einen syntaktisch gültigen Code austauschen und ihm dennoch unterschiedliche Bedeutungen zuweisen. Eine Transformation kann das Format erhalten und dabei Kontext, Einheiten, Herkunft oder die Beziehung zu einer anderen Ressource verlieren.
Warum aggregierte Scores Risiken verdecken
Eine multizentrische Studie aus dem Jahr 2025 mit 19 Krankenhäusern ergab, dass 17,7 % der festgestellten Datenqualitätsprobleme große Auswirkungen hatten und mindestens die Hälfte der betroffenen Datensätze betrafen und dass eine unvollständige Untersuchung der Fehlerursachen kritische systemische Mängel übersah, wie in der Studie im Journal of the American Medical Informatics Association berichtet. Die Studie identifizierte Fehler bei der Aktenauswertung, Unterschiede zwischen Quellsystemen und Extraktionsfehler. Das zeigt, warum Teams Ursachen untersuchen müssen, statt bei einem Genauigkeitsprozentsatz stehen zu bleiben.
Eine sinnvolle Validierungsabfolge sieht so aus:
Struktur validieren: Datentypen, Pflichtelemente, zulässige Werte und referenzielle Integrität prüfen.
Bedeutung validieren: Klinische, betriebliche und feldübergreifende Regeln anwenden.
Lieferung validieren: Ankunftszeit, Volumen, Null-Raten und Verteilungen mit dem erwarteten Verhalten vergleichen.
Auswirkung validieren: Betroffene Berichte, Kennzahlen, Modelle, Einrichtungen und Patientengruppen ermitteln.
Behebung dokumentieren: Regel, Quelle, Zeitstempel, Anzahl betroffener Datensätze, Verantwortliche und Status festhalten.
Dieser Ansatz versteht Validierung als Kontrollsystem und nicht als einmalige Bereinigungsübung. Die Validierung von Gesundheitsdaten im großen Maßstab sollte Teams helfen, die fehlerhafte Ebene zu lokalisieren und die Mängel zu priorisieren, die ein klinisches oder regulatorisches Ergebnis verändern können.
Von statischen Audits zu kontinuierlicher Observability
Periodische Audits haben weiterhin ihre Berechtigung. Sie liefern unabhängige Sicherheit, prüfen die Governance und untersuchen, ob Kontrollen wie vorgesehen funktionieren. Als primärer Erkennungsmechanismus für schnelllebige klinische Daten reichen sie jedoch nicht aus.
Eine Untersuchung elektronischer klinischer Dokumente ergab, dass 86,3 % der Stichprobendokumente Fehler enthielten, im Durchschnitt 4,9 Fehler pro Dokument, so die begutachtete Untersuchung elektronischer klinischer Dokumente. Dieselbe Untersuchung unterschied zwischen Vollständigkeits- und Syntaxwarnungen und zeigt damit, warum eine erfolgreich eingetroffene Datei dennoch Mängel enthalten kann, die die nachgelagerte Nutzung beeinträchtigen.
Audit-Kontrollen und Observability im Vergleich
Betriebsmodell | Was es gut kann | Wo es versagt |
|---|---|---|
Periodisches manuelles Audit | Liefert Prüftiefe und Governance-Nachweise | Erkennt Fehler erst, nachdem sich die Daten verbreitet haben |
Feste Regelbibliothek | Setzt explizite fachliche und klinische Anforderungen durch | Erfordert Pflege und kann Alarmrauschen erzeugen |
Kontinuierliche Observability | Erkennt Verhaltensänderungen, fehlende Ladungen und Lieferabweichungen | Braucht durchdachte Baselines, klare Verantwortlichkeiten und sinnvolle Eskalation |
Menschliche Untersuchung | Interpretiert den Kontext und bestätigt die Grundursache | Skaliert nicht als erster Filter für jeden Datensatz |
Ein großes, von Hand gebautes Regelwerk kann gründlich wirken und gleichzeitig immer schwerer zu pflegen sein. Teams ignorieren Alarme, wenn Schwellenwerte fragil sind, Duplikate häufig auftreten oder jede kleine Verteilungsverschiebung dieselbe Priorität erhält. Umgekehrt kann ein System ohne deterministische Regeln ungewöhnliches Verhalten erkennen, ohne zu verstehen, ob die Änderung gegen eine klinische Anforderung verstößt.
Das praxistaugliche Modell kombiniert beide Ansätze. Deterministische Validierung deckt bekannte Vorgaben ab, etwa Pflichtfelder, gültige Codes, Referenzbeziehungen und bedingte klinische Logik. Verhaltensbasiertes Monitoring lernt erwartete Muster für Datensatzvolumen, Null-Raten, Lieferzeiten, Werteverteilungen und Auslastung und markiert Abweichungen, die eine Untersuchung verdienen.
Was kontinuierliches Monitoring sichtbar machen sollte
Eine sinnvolle Observability-Ebene kann Folgendes erkennen:
Eine fehlende Ladung einer Einrichtung oder einen unerwarteten Rückgang der Datensätze.
Eine Schemaänderung, die eine Spalte hinzufügt, entfernt oder verändert.
Eine plötzliche Verschiebung bei Code-Verteilungen oder Null-Raten.
Einen Feed, der später eintrifft als nach seinem gelernten Liefermuster.
Eine Geschäftskennzahl, die ihren normalen Bereich verlässt.
Einen wiederholten Validierungsfehler, der sich auf eine Quelle oder Schnittstelle konzentriert.
Der Wert liegt nicht im Alarm an sich, sondern im Kontext: welcher Datensatz sich verändert hat, wann, welche Quelle ihn erzeugt hat, wie viele Datensätze betroffen sind und welche nachgelagerten Produkte davon abhängen. Data Quality Observability beschreibt genau diesen Wandel von reaktiver Bereinigung hin zu fortlaufendem Zuverlässigkeits-Monitoring.
Interoperabilität und regulatorische Compliance sicherstellen
Interoperabilität wird oft darauf reduziert, ob Systeme Nutzdaten austauschen können. Für die klinische Arbeit ist diese Definition zu schwach. Ein empfangendes System muss die Informationen innerhalb des erforderlichen Zeitfensters parsen, interpretieren, in Beziehung setzen und nutzen können.
Die United States Core Data for Interoperability, kurz USCDI, definieren zentrale Datenklassen und -elemente, die zertifizierte Health-IT-Systeme unterstützen müssen. Zu den maßgeblichen Spezifikationen gehören HL7 FHIR US Core und die Consolidated Clinical Document Architecture. Die Anforderungen von HL7 Patient Information Quality Improvement beschreiben außerdem Mechanismen zur Bewertung strukturierter Daten, darunter Pflichtfelder, Terminologie-Bindungen, Dokumentstruktur und Beziehungen zwischen ausgetauschten Ressourcen.
Strukturelle Konformität ist keine semantische Übereinstimmung
FHIR-Validierung kann Datentypen, Kardinalität, Ausdrücke, Terminologie und Referenzen prüfen. Diese Prüfungen sind notwendig, garantieren aber nicht, dass zwei Organisationen ein Konzept im selben operativen Kontext verwenden. Semantische Abweichungen zwischen Standards wie HL7 FHIR und SNOMED CT können dazu führen, dass technisch interoperable Daten eine uneinheitliche Bedeutung haben.
Hinzu kommt, dass sich Standards weiterentwickeln. USCDI und die zugehörigen Austauschspezifikationen werden jährlich aktualisiert, daher brauchen Organisationen eine laufende Nachverfolgung von Änderungen statt eines einmaligen Konformitätsprojekts. Ein geändertes Element, eine geänderte Terminologie-Bindung, ein geändertes Profil oder eine geänderte Dokumentstruktur kann Ingestion, Reporting, Analytics und nachgelagerte Modelle beeinflussen.
Praxisregel: Behandeln Sie jede Austauschgrenze als Qualitätsgrenze. Validieren Sie, was angekommen ist, was es bedeutet, wann es angekommen ist und wie es sich zu den maßgeblichen Quelldaten verhält.
Auch saubere Daten können zu unsicherer KI führen
Ein Datensatz kann Schema- und Vollständigkeitsprüfungen bestehen und dennoch nicht repräsentativ sein. Fehlende Werte können sich in einer Bevölkerungsgruppe häufen, Kodierungspraktiken können je nach Einrichtung variieren, und seltene Erkrankungen können untererfasst sein. Diese Muster betreffen nicht nur deskriptive Analysen, sondern auch die Entwicklung und Überwachung von Modellen.
Eine Übersichtsarbeit der National Academies aus dem Jahr 2025 hob hervor, dass Datenverfügbarkeit, Datenqualität und Bias in der KI im Gesundheitswesen eng miteinander verknüpft sind, und warnte, dass automatisierte Systeme semantische Schwächen und Datenqualitätsmängel eher verstärken als korrigieren können, wie in der Übersichtsarbeit der National Academies zusammengefasst. Damit verschiebt sich die Qualitätsfrage von „Ist die Tabelle sauber?“ zu „Wer ist repräsentiert, wessen Daten fehlen, und wie verändert sich die Leistung über Versorgungssettings und Gruppen hinweg?“
Ein belastbares Programm verbindet technische Kontrollen mit Governance:
Lineage von der Erfassung bis zur Transformation erhalten.
Herkunft und semantische Mappings dokumentieren.
Vollständigkeit und Verteilungsverschiebungen je Untergruppe überwachen.
Kodierungsänderungen und quellspezifisches Verhalten nachverfolgen.
Nachgelagerte Ergebnisse prüfen, nicht nur Erfolgsquoten der Validierung.
Unerklärte Verschlechterungen an die klinisch und für Governance Verantwortlichen eskalieren.
Compliance für Gesundheitsdaten erfordert daher mehr als Formatprüfungen. Sie verlangt den Nachweis, dass Daten verständlich, nachvollziehbar, aktuell und für die jeweilige Entscheidung oder regulierte Nutzung angemessen bleiben.
Ein skalierbares Datenqualitäts-Framework umsetzen
Ein skalierbares Framework beginnt beim Verwendungszweck, nicht beim Tooling. Ermitteln Sie die klinischen, betrieblichen und regulatorischen Entscheidungen, die von jedem Datensatz abhängen, und definieren Sie dann, wie ein Fehler für diesen Zweck aussieht. Ein Labor-Feed braucht unter Umständen ein strenges Liefer-Monitoring, während ein historischer Forschungsdatensatz Verzögerungen toleriert, aber eine stärkere Dokumentation von Herkunft und Vollständigkeit erfordert.
Die Kontrollebene schichtweise aufbauen
Beginnen Sie mit einem Dateninventar, das Quellen, Tabellen, Pipelines, Verantwortliche, nachgelagerte Produkte und Verwendungszwecke miteinander verbindet. Priorisieren Sie Datensätze mit hoher Wirkung, statt alles auf einmal überwachen zu wollen.
Etablieren Sie anschließend vier sich ergänzende Kontrollebenen:
Validierung auf Datensatzebene: Pflichtfeldprüfungen, Code-Set-Validierung, Bereichsprüfungen, referenzielle Integrität und bedingte Geschäftsregeln anwenden.
Monitoring der Datenbestände: Volumen, Null-Raten, Duplikate, Verteilungen und unerwartete Volatilität je Quelle und Einrichtung verfolgen.
Liefer-Monitoring: Das erwartete Ankunftsverhalten lernen und fehlende Ladungen, Verzögerungen und ungewöhnliche Lieferzeiten markieren.
Strukturelles Monitoring: Hinzugefügte oder entfernte Spalten, geänderte Datentypen und anderen Schema-Drift erkennen, bevor nachgelagerte Verbraucher unerwartet ausfallen.
Halten Sie die Nachweise nah an der Kontrolle. Jeder Vorfall sollte Datensatz, Regel oder Signal, Zeitstempel, Quelle, Anzahl betroffener Datensätze, Schweregrad, Verantwortliche, Behebungsstatus und Lösungsnotizen festhalten. Diese Dokumentation stützt die Governance und hilft Engineers, ein lokales Dokumentationsproblem von einem Schnittstellenfehler weiter vorne in der Kette zu unterscheiden.
Datenbewegung und Alarmrauschen reduzieren
Im Gesundheitswesen gelten strenge Grenzen für die Bewegung sensibler Daten. Durch In-Database-Ausführung können Teams Metriken berechnen und Analysen direkt im Warehouse oder auf der Plattform des Kunden ausführen. Das reduziert unnötige Kopien und erhält bestehende Zugriffskontrollen. Private-Cloud- und On-Premises-Bereitstellungen unterstützen Umgebungen, in denen Produktionsdaten in der Cloud, im virtuellen privaten Netzwerk oder im Rechenzentrum der Organisation verbleiben müssen.
Das Design der Alarmierung ist ebenso wichtig wie die Erkennung. Leiten Sie nur handlungsrelevante Abweichungen weiter, gruppieren Sie zusammenhängende Fehler, zeigen Sie die wahrscheinliche Auswirkung und erlauben Sie Teams, bekannte Wartungsereignisse zu unterdrücken, ohne neues Verhalten zu verbergen. Eine modulare Plattform wie digna kann Anomalieerkennung, Validierung auf Datensatzebene, Aktualitäts-Monitoring, Schema-Tracking und eine gemeinsame Vorfallsprüfung kombinieren, während die Berechnung in der Umgebung des Kunden bleibt.
Das Ziel der Umsetzung ist kein perfekter Score, sondern ein wiederholbarer Betriebskreislauf: erkennen, einordnen, untersuchen, beheben, verifizieren und daraus lernen.
Datenstrategien im Gesundheitswesen zukunftssicher machen
Gesundheitsdaten werden künftig aus noch mehr Versorgungssettings, Geräten, Anwendungen und Austauschwegen stammen. Telemedizin, Wearables, Genomforschung und von Patienten erzeugte Informationen liefern nützliche Signale, bringen aber auch andere Erfassungsweisen, Einheiten, Muster fehlender Werte und Anforderungen an die Herkunft mit sich. Eine resiliente Strategie geht davon aus, dass sich die Qualität mit der Umgebung verändert.
Am beständigsten ist ein Ansatz, der Kontrollen im gesamten Lebenszyklus verankert:
Bei der Erfassung: Den erforderlichen Kontext explizit machen und mehrdeutige Eingaben verhindern, wo es praktikabel ist.
Bei der Ingestion: Struktur, Terminologie, Beziehungen und Identität der Quelle validieren.
Während der Transformation: Lineage, Einheiten, Herkunft und semantische Entscheidungen erhalten.
Im Produktivbetrieb: Lieferung, Verteilungen, Schemaverhalten und geschäftliche Auswirkungen überwachen.
Nach Vorfällen: Die Grundursache dokumentieren und wiederkehrende Fehler in präventive Kontrollen überführen.
Programmatische Software Development Kits können Qualitätsprüfungen direkt in Datenpipelines und Anwendungen platzieren. Das verkürzt den Abstand zwischen dem Moment, in dem ein Engineer eine Transformation ändert, und dem Moment, in dem ein Governance-Team die Folgen später entdeckt. Die Prüfungen sollten dennoch beobachtbar, versioniert, testbar und mit Verantwortlichen verknüpft sein.
Datenqualität wird dauerhaft, wenn Teams sie als operative Eigenschaft jeder Pipeline behandeln und nicht als letzte Kontrolle vor der Veröffentlichung.
Die stärksten Programme im Gesundheitswesen widerstehen außerdem einer zu engen Definition von „sauber“. Sie überwachen Vollständigkeit je Untergruppe und Versorgungssetting, unterscheiden gültige von aussagekräftigen Werten, testen Aktualität gegen klinische Fristen und prüfen, ob sich Modelle oder Berichte nach Änderungen an Quellen anders verhalten. Kontinuierliche Verbesserung bedeutet, Schwellenwerte zu verfeinern, verrauschte Prüfungen abzuschaffen, Lineage auszubauen und klinische Stakeholder einzubeziehen, wenn technische Anomalien die Versorgung beeinträchtigen könnten.
Was ist also Datenqualitätsmanagement im Gesundheitswesen? Es ist die fortlaufende Praxis, Informationen für ihren vorgesehenen klinischen, betrieblichen, Forschungs-, Public-Health- und regulatorischen Zweck geeignet zu halten. Organisationen, die diese Disziplin in Erfassung, Austausch, Pipelines und Entscheidungssysteme einbauen, können Daten zu einem kontrollierten Asset machen statt zu einer wiederkehrenden Quelle der Unsicherheit.
digna bietet In-Database-Datenqualität und Observability für Datensätze im Gesundheitswesen, einschließlich Anomalieerkennung, Validierung auf Datensatzebene, Aktualitäts-Monitoring und Schema-Tracking in Ihrer eigenen Umgebung. Besuchen Sie digna und prüfen Sie einen modularen Ansatz, mit dem klinische, betriebliche und regulatorische Daten zuverlässiger werden.
Doppelte Patientenidentitäten und Behandlungsfälle, die auf nicht mehr existierende Datensätze verweisen, sind ebenso Beziehungsfehler wie Wertfehler. Wie Sie diese Verknüpfungen über EHR-, Labor- und Reporting-Systeme hinweg testen, lesen Sie im Beitrag zur referenziellen Integrität von Gesundheitsdaten.
Häufig gestellte Fragen
Was ist Datenqualitätsmanagement im Gesundheitswesen?
Es ist die fortlaufende Disziplin, zu prüfen, ob klinische, betriebliche, Forschungs-, Public-Health- und regulatorische Daten vollständig, korrekt, konsistent, aussagekräftig und bei Bedarf verfügbar sind. Die Arbeit reicht von Kontrollen bei der Erfassung über Validierung beim Datenaustausch, Anomalieerkennung und Fehlerbehebung bis zu Lineage und Governance und ist kein einmaliges Bereinigungsprojekt.
Welche Dimensionen nutzt die WHO zur Bewertung der Datenqualität im Gesundheitswesen?
Das Data-Quality-Review-Framework der WHO nutzt Vollständigkeit, interne Konsistenz, externen Vergleich mit einer unabhängigen Quelle und externe Konsistenz der Bevölkerungsdaten, etwa der Nenner. Es unterstützt zudem Anforderungen an Genauigkeit, Zuverlässigkeit und Aktualität. Teams sollten jede Dimension in Schwellenwerte für einen konkreten Datensatz und Arbeitsablauf übersetzen statt in einen organisationsweiten Score.
Warum ist ein vollständiger Datensatz kein Beweis für gute Gesundheitsdaten?
Vollständigkeit ist nicht gleich Genauigkeit. Ein Wert kann vorhanden und korrekt typisiert sein und dennoch für den Patienten, die Episode oder in seiner Bedeutung nach dem Austausch falsch sein. Fehlende, falsche, verspätete und semantisch abweichende Daten sind getrennte Fehlerarten, und jede braucht eigene Kontrollen, von Schnittstellenprüfungen über Liefer-Baselines bis zum Terminologie-Mapping.
Warum reichen periodische Audits für klinische Daten nicht aus?
Audits erkennen Fehler erst, wenn die Daten bereits in Berichte und Modelle eingeflossen sind. Eine Untersuchung fand Fehler in 86,3 % der geprüften elektronischen klinischen Dokumente. Kontinuierliche Observability ergänzt Audits, indem sie fehlende Ladungen von Einrichtungen, verspätete Feeds, Schemaänderungen und Verschiebungen bei Null-Raten oder Code-Verteilungen meldet, solange noch Zeit zum Handeln bleibt.
Wie baut man ein skalierbares Datenqualitäts-Framework im Gesundheitswesen auf?
Beginnen Sie bei den Entscheidungen, die jeder Datensatz unterstützt, und schichten Sie dann Kontrollen: Validierung auf Datensatzebene, Monitoring der Datenbestände nach Volumen und Verteilungen, Liefer-Monitoring anhand gelernter Ankunftsmuster und strukturelles Monitoring für Schema-Drift. In-Database-Prüfungen begrenzen die Bewegung sensibler Daten, und jeder Vorfall sollte Verantwortliche, betroffene Datensätze und Behebungsstatus festhalten.


