10 Big-Data-Validierungstools im Vergleich
|
10
min. Lesezeit

Die besten Big-Data-Validierungstools sind nicht die mit der längsten Funktionsliste. Eine Plattform kann Profiling, Alerts, Lineage und Dutzende Konnektoren bieten und ein Finanzteam trotzdem im Unklaren lassen: Lief eine kritische Transaktionsregel tatsächlich? Wo wurde eine fehlgeschlagene Prüfung ausgeführt? Und wer ist für die Ausnahme verantwortlich?
Validierung im großen Maßstab umfasst unterschiedliche Probleme. Geschäftsregeln auf Datensatzebene prüfen, ob Werte und Beziehungen plausibel sind. Statistische Anomalieerkennung identifiziert ungewöhnliche Verteilungen. Freshness-Monitoring erkennt verspätete oder fehlende Ladevorgänge. Schema-Tracking deckt strukturelle Änderungen auf. Migrationstests vergleichen Ergebnisse über Systeme hinweg, während Lineage und Plattform-Monitoring Auswirkungen und operativen Kontext erklären. Diese Kontrollen überschneiden sich, sind aber nicht austauschbar. Genau diese Unterscheidung ist zentral dafür, warum Validierungstests wichtig sind.
Dieser Vergleich bewertet zehn Tools nach Validierungsumfang, Ausführungsmodell, Deployment, operativer Verantwortung, Implementierungsaufwand, Governance, Preistransparenz und Eignung für den jeweiligen Anwendungsfall. Regelbasierte Tests und automatisierte Observability werden dabei als sich ergänzende und nicht als konkurrierende Ansätze betrachtet. digna ist eine relevante Option für Teams, die Validierung und Observability direkt in der Datenbank und innerhalb der eigenen Infrastruktur benötigen, aber nicht automatisch der Sieger für jede Datenlandschaft.
Inhaltsverzeichnis
1. Data Validation
Wo digna operativ passt
Stärken und Kompromisse
2. Great Expectations, GX Cloud und Open Source
3. Soda, Soda Core und Soda Cloud
4. Monte Carlo
5. Anomalo
6. Bigeye
7. Datafold
8. AWS Deequ
9. Acceldata
10. Talend Data Quality, heute Teil von Qlik Talend Cloud und Talend Data Fabric
Die 10 besten Big-Data-Validierungstools im Vergleich
Wählen Sie das Tool passend zu dem Fehler, den Sie verhindern müssen
1. Data Validation
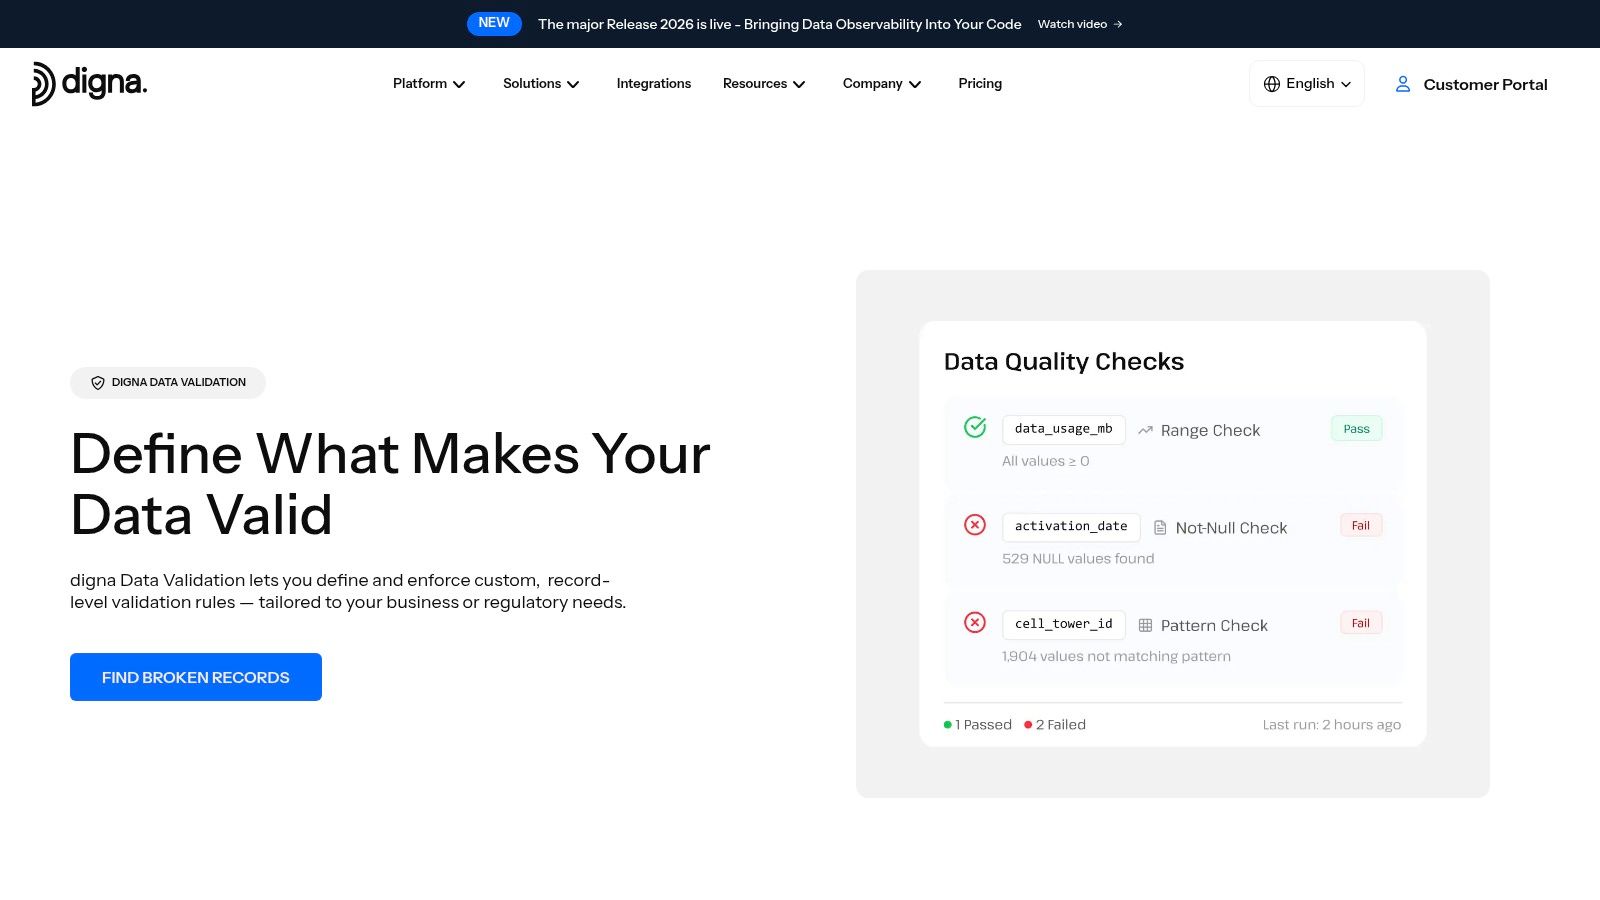
Das Data Validation-Modul von digna ist für ein Problem gebaut, das Anomalie-Scores allein nicht lösen können: den Nachweis, dass einzelne Datensätze explizite Geschäftslogik einhalten. Teams können Prüfungen für exakte Werte, Schwellenwerte, Wertebereiche, den Umgang mit Nullwerten, Referenzlisten und spaltenübergreifende Konsistenz definieren und die Ergebnisse für Analytics, Reporting, operative Abläufe und regulatorische Prüfungen nutzen. Die Unterscheidung ist wichtig, denn ein Datensatz kann einem vertrauten statistischen Muster folgen und dennoch gegen eine kritische Geschäftsregel verstoßen.
Wo digna operativ passt
digna führt Validierung und Metrikberechnung direkt in den Datenbanken des Kunden aus, statt Produktionsdaten in eine externe Verarbeitungsumgebung zu verschieben. Die Plattform läuft in der Cloud, VPC oder im Rechenzentrum des Kunden. Damit ist das Deployment-Modell besonders relevant für Organisationen mit strengen Anforderungen an Datenresidenz, Zugriff oder Governance. Laut Produktunterlagen erfolgt die Ausführung in Datenbanken wie Teradata, Snowflake, Databricks und PostgreSQL, mit protokollierten Pass- und Fail-Ergebnissen sowie Audit-Trails.
Das Modul verknüpft Fehler auf Datensatzebene außerdem mit KI-gestützter Anomalieerkennung, Timeliness-Monitoring und Schema-Tracking. Diese Korrelation ist oft nützlicher als ein isolierter Alert. Eine fehlgeschlagene Regel zusammen mit einem verspäteten Ladevorgang oder einer kürzlichen Strukturänderung gibt der Untersuchung einen deutlich besseren Ausgangspunkt als eine fehlgeschlagene Regel ohne Kontext.
Praxisregel: Wählen Sie digna, wenn die Nachweise hinter einer fehlgeschlagenen Prüfung genauso wichtig sind wie der Alert selbst.
Stärken und Kompromisse
Ausführung in der Datenbank: Produktionsdaten bleiben, wo sie sind. Das reduziert Datenbewegungen und bringt die Validierung in Einklang mit Anforderungen an private Deployments.
Audit-fähige Prüfungen: Ergebnisse auf Zeilenebene liefern Nachweise für Geschäftsregeln, Ausnahmebehandlung und Compliance-Prüfungen.
Korrelierte Vorfälle: Anomalien, Lieferverzögerungen und Schemaänderungen lassen sich gemeinsam mit Validierungsfehlern betrachten.
Modularer Ausbau: Teams können mit priorisierten Tabellen beginnen und weitere Monitoring-Module ergänzen, wenn die Abdeckung wächst.
Der Kompromiss liegt in der Verantwortung für die Implementierung. digna muss in Kundendatenbanken bereitgestellt und integriert werden und kann daher mehr Infrastrukturarbeit erfordern als ein reiner SaaS-Dienst. Auch das Erstellen und Pflegen von Regeln bleibt notwendig, und durch die Abrechnung pro aktiver Tabelle können Kosten und operativer Aufwand mit wachsender Abdeckung steigen. Teams, die digna evaluieren, sollten vor einem breiten Rollout Tabellenverantwortliche, Regelverantwortliche, Ablaufzeiten für Ausnahmen und Service-Levels für die Behebung festlegen.
Einen tieferen Einblick in Implementierungsmuster bietet der Leitfaden von digna zu Datenvalidierungsregeln, Prüfungen und kontinuierlicher Datenqualität. Aktuelle Informationen zu Deployment und Lizenzierung finden Sie auf der Produktseite von digna Data Validation.
2. Great Expectations, GX Cloud und Open Source
Great Expectations passt gut, wenn ein Team deklarative, regelbasierte Validierung auf Open-Source-Basis sucht. Mit dem Expectations-Modell definieren Engineers Annahmen über Datensätze, Spalten, Verteilungen und Werte und führen diese Suites gegen SQL-Warehouses, Data Lakes, Dateien oder Dataframes aus. Die Trennung zwischen dem Schreiben von Tests und der Verwaltung der Ausführungen ist hilfreich für Teams, die Code-Reviews für Prüfungen wollen, aber auch eine gemeinsame operative Sicht brauchen.
Open-Source-GX eignet sich besser für Teams, die Python-basierte Workflows, Repositories und Ausführungsinfrastruktur selbst betreiben können. GX Cloud ergänzt gehostete Zusammenarbeit, Validierungshistorie, Alerting und Governance-Workflows. Damit ist das Produkt weniger eine einzelne Deployment-Entscheidung als ein Weg von Code-first-Tests hin zu verwaltetem Betrieb.
Die größte Einschränkung ist der Aufwand für die Abdeckung. Ein umfangreicher Expectation-Katalog nimmt Ihnen nicht die Entscheidung ab, welche Regeln geschäftskritisch sind, wie Ausnahmen funktionieren und wo Suites in Produktion laufen. Das Schreiben von Regeln kann arbeitsintensiv werden, wenn eine große Datenlandschaft explizite Abdeckung über viele Tabellen braucht. GX ist zudem nicht in erster Linie eine automatisierte Observability-Plattform. Teams, die gelernte Baselines, Freshness-Intelligenz oder breite Korrelation von Vorfällen suchen, benötigen möglicherweise ergänzende Funktionen.
Für den praktischen Kontext im Open-Source-Bereich lohnt sich ein Vergleich des Frameworks mit dem Überblick von digna über Funktionen von Open-Source-Datenqualitätstools. Prüfen Sie die aktuellen Produktoptionen bei Great Expectations, vor allem wenn Preise, Hosting-Limits oder Cloud-Pakete die Beschaffung beeinflussen.
3. Soda, Soda Core und Soda Cloud
Soda trennt die Ausführungs-Engine von der operativen Steuerungsebene. Mit Soda Core und Soda Library formulieren Entwickler Prüfungen in SodaCL, einer YAML-basierten Syntax für die Pipeline-Integration. Soda Cloud ergänzt eine gemeinsame Oberfläche für Ergebnisse, Alerts, Trends, rollenbasierten Zugriff und Triage.
Diese Aufteilung passt zu Teams, die Validierung nah am Warehouse ausführen und Analysten sowie Data Ownern gleichzeitig eine Cloud-Oberfläche zur Prüfung bieten wollen. Sodas Integrationen mit Plattformen wie Snowflake und Databricks sowie CI/CD-Anbindungen ermöglichen Prüfungen als Teil der Delivery-Workflows statt nur als geplante Dashboard-Scans.
Der entscheidende Unterschied ist die Zugänglichkeit. YAML kann die Hürde für Engineers senken, die nicht jede Prüfung im Anwendungscode verankern wollen, während Profiling und automatische Vorschläge helfen, eine erste Qualitäts-Baseline aufzubauen. Entscheidungen über Schweregrad, Verantwortung und Eskalation bleiben dennoch nötig. Eine Prüfung, die erfolgreich läuft, aber keinen verantwortlichen Owner hat, ist nur ein technisches Ereignis und keine operative Kontrolle.
Der Ausführungsort ist wichtiger als die Alert-Oberfläche. Eine ausgefeilte Cloud-Oberfläche bedeutet nicht automatisch, dass Produktionsdaten das Warehouse verlassen haben.
Sodas stärkster Anwendungsfall ist ein Warehouse-zentriertes Qualitätsprogramm, das von Entwicklern geschriebene Prüfungen mit gemeinsamer Triage kombiniert. Die Einschränkung liegt in der Paketierung. Einige erweiterte Funktionen gibt es nur in der Cloud-SKU, und öffentliche Preise sind nicht angegeben. Käufer müssen aktuelle Funktionsgrenzen und Angebotsannahmen daher direkt klären. Teams, die Soda mit digna vergleichen, sollten sich darauf konzentrieren, ob sie eine SaaS-Steuerungsebene, eine private Installation oder ein breiteres korreliertes Monitoring benötigen. Die Soda-Plattform informiert über aktuellen Produktumfang, Deployment und kommerzielle Details. Alternativen mit Fokus auf Validierung und Observability direkt vor Ort finden Sie unter digna als Alternative zu Soda.
4. Monte Carlo
Monte Carlo adressiert ein anderes Fehlermuster als eine Regelbibliothek. Der Kern ist Data Observability über Freshness, Volumen, Schema, Lineage und BI, unterstützt durch ML-gestützte Monitore und Incident-Workflows. Damit ist die Plattform eine naheliegende Wahl für größere Datenteams, die unerwartetes Verhalten erkennen müssen, ohne für jede Tabelle und jede Metrik eine Regel zu schreiben.
Lineage und Impact-Analyse der Plattform sind bei der Untersuchung besonders wichtig. Ein Freshness-Problem wird greifbarer, wenn ein Team die betroffenen nachgelagerten Assets, Dashboards oder Workflows sieht. Incident-Triage und Runbook-Funktionen verschieben das Produkt zudem in Richtung operativer Reaktion statt reiner Testerstellung.
Monte Carlo wird häufig über Enterprise-Beschaffungskanäle wie den AWS Marketplace evaluiert. Das kreditbasierte Verbrauchsmodell kann den Einkauf für Organisationen vereinfachen, die diesen Weg bereits nutzen, wirft aber Fragen zu variablen Kosten auf. Teams sollten modellieren, wie überwachte Assets, Scan-Häufigkeit, Aufbewahrung der Historie und Anzahl der Vorfälle den Verbrauch beeinflussen, statt den Marketplace-Weg als vollständige Antwort auf die Preisfrage zu betrachten.
Die Einschränkung liegt in der deterministischen Abdeckung. Observability kann erkennen, dass sich eine Verteilung verändert hat oder ein Ladevorgang verspätet ist, ersetzt aber keine explizite Regel für eine rechtlich oder operativ relevante Bedingung. Eine starke Implementierung kombiniert die automatisierten Monitore von Monte Carlo mit gezielten Tests, die das jeweilige Fachteam verantwortet.
Prüfen Sie den aktuellen Umfang und die Beschaffungsoptionen direkt bei Monte Carlo. Käufer sollten ein Kostenmodell auf Basis ihrer tatsächlich überwachten Landschaft anfordern und die Antwort mit Tools vergleichen, die Prüfungen in der eigenen Infrastruktur ausführen. Eine kontrastierende Produktperspektive bietet die Analyse von digna zu Alternativen zu Monte Carlo.
5. Anomalo
Anomalo richtet sich an Teams, die mit automatisierter Anomalieerkennung schnell eine breite Abdeckung erreichen wollen. Die Plattform analysiert das Verhalten von Tabellen, Spalten, Metriken und Verteilungen und unterstützt konfigurierbare Validierung auf Tabellen-, Spalten- und Zeilenebene. Diese Kombination löst ein häufiges Spannungsfeld bei der Implementierung: Teams brauchen explizite Kontrollen, können aber oft nicht jede sinnvolle Baseline von Hand schreiben, bevor das Monitoring startet.
Die Oberfläche ist auf Prüfung im großen Maßstab ausgelegt. Native Anbindungen an moderne Warehouses und Kataloge wie Alation machen den Zustand der Daten dort sichtbar, wo Nutzer und Data Stewards ohnehin arbeiten. Automatisierte Erkennung kann ungewöhnliche Verschiebungen aufdecken, die ein manuell gewählter Schwellenwert übersehen würde, insbesondere in breiten Warehouse-Umgebungen, in denen die relevante Baseline beim Design noch nicht offensichtlich ist.
Der Kompromiss liegt in der Kalibrierung der Alerts. Auch ML-gestützte Monitore brauchen Triage-Richtlinien, Entscheidungen zur Unterdrückung und klare Verantwortung. Wer jede Abweichung als Fehler behandelt, erzeugt Rauschen. Wer zu aggressiv unterdrückt, verliert Abdeckung. Das richtige Betriebsmodell klassifiziert Probleme nach ihren geschäftlichen Folgen und behält deterministische Prüfungen für Bedingungen bei, die niemals mehrdeutig sein dürfen.
Automatisierte Abdeckung reduziert den Aufwand für das Schreiben von Regeln, ersetzt aber keine verantwortlichen Entscheidungen.
Anomalo passt zu Organisationen, die schnelle Observability über große Warehouse-Landschaften und einen visuellen Workflow für die Prüfung von Problemen priorisieren. Weniger geeignet ist die Plattform, wenn private Deployments, Nachweise direkt aus der Datenbank oder strenge Audit-Trails auf Datensatzebene die wichtigsten Auswahlkriterien sind. Die Preise werden im Vertrieb verhandelt und sind nicht öffentlich. Käufer sollten daher während der Evaluierung Konnektorumfang, Grenzen des Datenzugriffs und Unterstützung beim Tuning prüfen. Das aktuelle Angebot finden Sie bei Anomalo. Vergleichen Sie den Anomaly-first-Ansatz mit dem Leitfaden von digna zur frühzeitigen Erkennung von Datenproblemen durch Anomalieerkennung.
6. Bigeye
Bigeye positioniert Observability als Teil eines AI Trust-Betriebsmodells. Das Monitoring deckt Freshness, Volumen, Schema und Verteilungen ab, während Lineage und Impact-Analyse einen auffälligen Datensatz mit nachgelagerten Nutzern verknüpfen. Damit ist Bigeye relevant, wenn Governance-Teams mehr als eine Benachrichtigung brauchen. Sie benötigen Kontext dazu, was sich geändert hat und welche Workloads betroffen sein könnten.
Die praktische Stärke des Produkts ist Lineage-basierte Triage. Untersuchende können vor- und nachgelagerte Beziehungen nutzen, um die Suche nach der Ursache einzugrenzen, während Enterprise-Sicherheitsfunktionen und ein breites Konnektor-Portfolio heterogene Landschaften unterstützen. Bigeye bietet außerdem Leitfäden und Dokumentation, die Teams helfen, den Rollout zu standardisieren, statt jede Fachdomäne ihren eigenen Monitoring-Prozess erfinden zu lassen.
Der breitere Umfang kann jedoch auch ein Nachteil sein. Ein Team, das eine kleine Bibliothek deterministischer Prüfungen sucht, findet eine AI-Trust-Plattform möglicherweise größer als den unmittelbaren Bedarf. Mehr Funktionen bedeuten mehr Entscheidungen über Verantwortung, Integration, Schweregrade von Vorfällen und Betriebsabläufe. Das Einkaufsteam sollte den Bedarf an Observability vom Bedarf an Kontrollen für Model Governance trennen und klären, welche Produktkomponenten tatsächlich benötigt werden.
Bigeye ist ein guter Kandidat, wenn Lineage im Mittelpunkt der Untersuchung steht und die Organisation eine strukturierte Enterprise-Implementierung wünscht. Für eine Spark-native Entwicklerbibliothek oder einen Migrations-Diff-Workflow ist es nicht die naheliegende erste Wahl. Preise werden nicht veröffentlicht und die Beschaffung läuft vor allem über Demos. Die Evaluierung sollte daher Deployment-Grenzen, den Umgang mit sensiblen Daten und die Aufbewahrung von Nachweisen umfassen. Aktuelle Produktinformationen gibt es bei Bigeye.
7. Datafold
Datafold löst ein engeres Problem außergewöhnlich gut: Vergleiche auf Werteebene und Regressionstests. Die Data-Diff-Funktion vergleicht Ergebnisse über große Datensätze hinweg, während Lineage auf Spaltenebene Änderungen über Warehouses, dbt-Projekte und BI-Assets verknüpft. Das ist nützlich, bevor ein Pull Request gemergt wird, während einer Warehouse-Migration oder wenn eine Transformation neu geschrieben wurde und das Team die tatsächlichen Auswirkungen auf die Daten sehen muss.
Das ist nicht dasselbe wie kontinuierliche Observability. Datafold ist am stärksten, wenn es eine bekannte Änderung gibt und jemand den Nachweis braucht, dass das neue Ergebnis dem alten entspricht, es verbessert oder bewusst davon abweicht. CI-Integrationen machen diesen Vergleich zum Teil des Entwicklungsworkflows, sodass Engineers Regressionen erkennen, bevor Nutzer in Produktion darauf stoßen.
Eine VPC-Deployment-Option unterstützt Organisationen, die eine private Ausführung benötigen. Die zentrale Frage bei der Implementierung ist das Design des Vergleichs. Teams müssen festlegen, welche Zeilen, Spalten, Aggregate, Toleranzen und Ausschlüsse einen aussagekräftigen Paritätstest ergeben. Ein mechanisch vollständiger Diff kann operativ trotzdem nutzlos sein, wenn fachlich genehmigte Änderungen im Test nicht abgebildet sind.
Datafold passt zu migrationsintensiven, dbt-zentrierten und regressionssensiblen Umgebungen. Es ersetzt weder Freshness-Monitoring noch Anomalie-Baselines oder Compliance-Regeln auf Datensatzebene. Die Preise für die vollständige Plattform sind individuell und werden im Vertrieb verhandelt. Das Open-Source-Projekt data-diff wurde zugunsten des Cloud-Produkts eingestellt, Käufer sollten den aktuellen kommerziellen Weg also klären. Die neuesten Funktionen finden Sie bei Datafold.
8. AWS Deequ
AWS Deequ ist eine Scala- und Apache-Spark-Bibliothek und keine vollständige Observability-Plattform. Diese Unterscheidung bestimmt sowohl den Reiz als auch die Betriebskosten. Datenteams, die direkt im JVM- und Spark-Ökosystem arbeiten, können Constraints für Vollständigkeit, Eindeutigkeit, Verteilungen und verwandte Metriken formulieren und sie zusammen mit großen ETL- oder ELT-Jobs ausführen.
Mit dem Metrics-Repository-Muster von Deequ können Teams Profile über die Zeit speichern. Das schafft eine Grundlage für Trendanalysen, doch alles Drumherum bleibt in der Verantwortung des Kunden. Engineers müssen Scheduling, Alerting, Ergebnisdarstellung, Verantwortungs-Workflows und die Aufbewahrung von Vorfällen selbst bauen, sofern die bestehende Plattform diese Funktionen nicht liefert.
Die Bibliothek ist attraktiv, wenn die Vermeidung von Vendor-Lock-in zählt und Spark bereits die Ausführungsumgebung ist. Sie lässt sich in ETL-Jobs und CI-Workflows einbetten, und für Teams mit Bedarf an einer Python-Schnittstelle gibt es Python-Bindings aus der Community. Die Flexibilität setzt allerdings Expertise voraus. Teams ohne fundiertes Wissen im Betrieb von Scala oder Spark investieren unter Umständen mehr Aufwand in die Pflege der Validierungsschicht als in das Schreiben der Constraints selbst.
Deequ ist eine Komponente, aus der Sie ein Validierungssystem zusammenbauen. Ein fertiger Governance-Workflow ist es nicht.
Setzen Sie Deequ für Spark-native Constraint-Tests ein, wenn technische Kontrolle und Open-Source-Lizenzierung wichtiger sind als eine integrierte Oberfläche. Wählen Sie stattdessen eine Plattform, wenn Analysten, Data Stewards oder Auditoren gemeinsamen Kontext zu Vorfällen ohne Eigenentwicklung brauchen. Aktueller Code und Dokumentation des Projekts sind im AWS-Deequ-Repository verfügbar.
9. Acceldata
Acceldata verbindet Datenzuverlässigkeit mit Kostenoptimierung und Plattformzustand. Damit ist die Plattform ein Kandidat für komplexe Landschaften, in denen Teams Datenqualitäts-Alerts nicht isoliert von Workload-Verhalten, Performance-Signalen und Verbrauchsänderungen betrachten wollen. Der Umfang reicht über Zeilenprüfungen hinaus bis zu den operativen Bedingungen, die bestimmen, ob Datenplattformen nutzbar und wirtschaftlich kontrollierbar bleiben.
Die Plattform unterstützt Zuverlässigkeitsmonitore, Alerts und Kontrollen im Stil von Data Contracts über heterogene Stacks hinweg. Enterprise-Deployment und Sicherheitsfunktionen sind relevant für Organisationen, die sowohl On-Premises als auch in der Cloud arbeiten, vor allem wenn Plattform-Engineers und Governance-Teams gemeinsam für Service-Levels verantwortlich sind.
Breite kann wertvoll sein, vergrößert aber auch den Implementierungsumfang. Ein Team, das nur Null-Prüfungen, Validierung gegen Referenzlisten oder einige wenige Schema-Kontrollen sucht, evaluiert womöglich Funktionen, die es nie in Betrieb nehmen wird. Der Auswahlprozess sollte den Fehler benennen, der die Plattform rechtfertigt, und dann prüfen, ob Kosten- und Zustandssignale vom selben Team oder von separaten Plattformfunktionen verantwortet werden.
Acceldata eignet sich für Landschaften, in denen Qualität, Zuverlässigkeit und Plattformökonomie gemeinsam betrachtet werden müssen. Die Preise werden im Vertrieb auf Angebotsbasis festgelegt. Käufer sollten daher eine klare Aufschlüsselung nach Modulen, überwachten Assets, Deployment und Support anfordern. Aktuelle Positionierung und Plattformdetails finden Sie bei Acceldata.
10. Talend Data Quality, heute Teil von Qlik Talend Cloud und Talend Data Fabric
Talend Data Quality ist die etablierte Enterprise-Option in dieser Liste, mit Funktionen für Profiling, Bereinigung, Standardisierung, Anreicherung, Stewardship und Trust Scoring. Am sinnvollsten ist es für Organisationen, die für Integration, Governance und Datenmanagement bereits auf Qlik oder Talend standardisieren, denn der Mehrwert entsteht ebenso aus dem umgebenden Ökosystem wie aus einzelnen Validierungsregeln.
Das Toolset unterstützt Qualitätsregeln und Profiling zusammen mit Stewardship-Workflows. Abonnements sind über Qlik Talend Cloud erhältlich, während On-Premises- und kundenverwaltete Optionen innerhalb der breiteren Data-Fabric-Familie existieren. Diese Bandbreite hilft Organisationen mit gemischten Deployment-Anforderungen, macht es aber auch wichtig, die Produktpakete genau zu prüfen.
Bei Talend geht es weniger um eine schlanke Entwicklerbibliothek als um die Verankerung von Qualitätsprozessen über verschiedene Rollen hinweg. Data Stewards können an der Behebung mitwirken, während Integrationsteams Qualitätsprozesse mit Datenbewegung und Governance verbinden. Der Kompromiss ist die Komplexität. Öffentliche Listenpreise gibt es nicht, Stufen und SKUs sind schwer vergleichbar, und durch das Rebranding unter Qlik sollten Käufer klären, welche Funktionen zu welchem aktuellen Paket gehören.
Talend passt gut zu Unternehmen, die bereits in das Qlik- und Talend-Ökosystem investiert haben. Für einen fokussierten Migrations-Diff, eine Spark-Constraint-Bibliothek oder einen reinen Anomalie-Rollout kann es überdimensioniert sein. Klären Sie aktuelle Pakete, Deployment, Support und Lizenzierung über Qlik Talend Data Fabric.
Die 10 besten Big-Data-Validierungstools im Vergleich
Tool | Kernfunktionen | UX & Qualität (★) | Alleinstellungsmerkmale (✨ / 🏆) | Zielgruppe (👥) | Preis / Leistung (💰) |
|---|---|---|---|---|---|
Data Validation (digna) | Validierung auf Datensatzebene direkt in der Datenbank, integriert mit Anomalie, Timeliness & Schema | ★★★★★ Gemeinsame Oberfläche, Enterprise-tauglich | ✨ Läuft in der Kundeninfrastruktur; korrelierte Vorfälle → schnellere Ursachenanalyse 🏆 | 👥 Regulierte Unternehmen (Finanzwesen, Gesundheitswesen, Telko, öffentlicher Sektor) | 💰 Modulare Lizenz + pro aktiver Tabelle; transparent, nutzungsstabil |
Great Expectations (GX) | Deklarative Expectation-Suites, Profiling, Unterstützung mehrerer Backends | ★★★★ Code-first-UX; GX Cloud ergänzt eine verwaltete Oberfläche | ✨ Umfangreiche Expectation-Bibliothek, Doku & Test-Lineage 🏆 | 👥 Data Engineers, Code-first-Teams | 💰 OSS kostenlos; GX Cloud mit kostenpflichtigen Stufen (variiert) |
Soda (Core + Cloud) | YAML-Prüfungen (SodaCL), Profiling, Cloud-Oberfläche, Ausführung nah an den Daten | ★★★★ Entwicklerfreundlich; Cloud für Triage & RBAC | ✨ YAML + einfache Pipeline-Einbindung, automatische Vorschläge 🏆 | 👥 Entwicklerteams, die CI/CD + Cloud-UX wollen | 💰 Core OSS kostenlos; Cloud = Vertrieb/Angebot |
Monte Carlo | ML-Monitore (Freshness, Volumen, Schema), Lineage, BI-Monitoring | ★★★★★ Ausgereifte Incident-Triage & Runbooks | ✨ Enterprise-ML-Monitoring + umfangreiche Triage-Workflows 🏆 | 👥 Große Organisationen mit reifem Data Ops | 💰 Vertriebsgesteuert; Credit-/Verbrauchsmodell (variabel) |
Anomalo | KI-Anomalieerkennung, deklarative Validierungen, Katalog-Integrationen | ★★★★ Schnelle Abdeckung; Oberfläche zur Prüfung von Problemen | ✨ Automatisierte Prüfungen für schnelle Abdeckung 🏆 | 👥 Teams, die schnelle Anomalieerkennung im großen Maßstab brauchen | 💰 Vertriebsgesteuerte Enterprise-Preise |
Bigeye | Automatisiertes Monitoring (Freshness/Volumen/Schema), tiefe Lineage | ★★★★ Lineage-basierte Triage & Governance-UX | ✨ Lineage + Observability für Governance 🏆 | 👥 Governance- und Compliance-orientierte Teams | 💰 Demo-/angebotsbasiert (Enterprise) |
Datafold | Data-Diffing auf Werteebene, CI-Regressionstests, Spalten-Lineage | ★★★★ Starke UX für Validierung vor dem Merge | ✨ Data Diff + CI-Integration für PRs & Migrationen 🏆 | 👥 Engineering-Teams, dbt- & Migrations-Workflows | 💰 Vertriebsgesteuert; VPC-Deployment-Option |
AWS Deequ (OSS) | Deklarative Spark-Constraints, Metrics-Repository, Prüfungen im Spark-Maßstab | ★★★ Bibliothek (keine integrierte Oberfläche), Code/nativ | ✨ Kostenlos, Spark-nativ und skalierbar für JVM-Teams 🏆 | 👥 JVM-/Spark-Big-Data-Engineers | 💰 Open Source (kostenlos); nur Infrastruktur-/Entwicklungskosten |
Acceldata | Zuverlässigkeitsmonitore, Kostenoptimierung, Plattformzustand | ★★★★ Enterprise-Dashboards & SLO-Tooling | ✨ Verbindet Datenqualität mit Kosten- und Plattform-Insights 🏆 | 👥 Komplexe Unternehmen mit mehreren Plattformen | 💰 Angebotsbasierte Enterprise-Preise |
Talend Data Quality (Qlik) | Profiling, Bereinigung, Stewardship, Trust Scoring | ★★★★ Ausgereifte Governance- & Stewardship-UX | ✨ Lange Tradition in Datenqualität + Integration 🏆 | 👥 Unternehmen, die auf Talend/Qlik standardisieren | 💰 Abonnement-Stufen (vertriebsgesteuert) |
Wählen Sie das Tool passend zu dem Fehler, den Sie verhindern müssen
Die Tool-Auswahl wird klarer, wenn das Team den Fehler benennt, bevor es Funktionen vergleicht. Liegt das Hauptrisiko in einem ungültigen Betrag, einem unzulässigen Status, einem fehlenden Referenzwert oder einem inkonsistenten Feldpaar, beginnen Sie mit deterministischer Validierung auf Datensatzebene. digna, Great Expectations, Soda, Talend und Deequ unterstützen alle regelbasierte Kontrollen, unterscheiden sich aber in Ausführung, Oberflächen, Deployment und darin, wie viel Workflow das Team selbst drumherum bauen muss.
Geht es um unerwartete Verschiebungen in einer breiten Landschaft, priorisieren Sie automatisierte Anomalieerkennung. Monte Carlo, Anomalo, Bigeye, Acceldata und digna gehen dieses Problem über Monitoring und Verhaltenskontext an. Die entscheidende Frage ist nicht, ob ein Tool Machine Learning nutzt. Fragen Sie, wie Teams Alerts justieren, Verantwortliche zuweisen, eine Abweichung erklären und das Ereignis mit den nachgelagerten Auswirkungen verknüpfen.
Freshness- und Schemafehler brauchen eine eigene Bewertung. Eine Regel-Suite kann bestehen, während ein Ladevorgang verspätet eintrifft, oder eine Schemaänderung wird von einem Tabellenformat technisch akzeptiert und bricht trotzdem eine Annahme weiter unten in der Pipeline. Die Dokumentation von Apache Iceberg zeigt, warum Schema-Evolution aktiv nachverfolgt werden muss: Felder können als Metadatenänderung hinzugefügt, entfernt, aktualisiert oder umbenannt werden, und ältere Daten können unter früheren Partitionsspezifikationen verbleiben. Auch eine strukturell gültige Änderung braucht einen operativen Nachweis darüber, was sich geändert hat, ab wann es gilt und welche Nutzer davon abhängen.
Änderungen bei Migrationen und Transformationen erfordern Diffing und Nachweise gegen Regressionen, wo Datafold klarer passt als eine allgemeine Observability-Plattform. Spark-zentrierte Teams bevorzugen möglicherweise Deequ, weil die Prüfungen in derselben Verarbeitungsumgebung laufen. Organisationen, die Lineage-gestützte Triage brauchen, sollten Monte Carlo, Bigeye, Acceldata oder Talend danach bewerten, wie tief die Impact-Analyse geht und welche Rollen an der Behebung beteiligt sind.
Gehen Sie bei der Evaluierung in dieser Reihenfolge vor:
Fehler definieren: Unterscheiden Sie Verstöße auf Datensatzebene, auffälliges Verhalten, verspätete Lieferung, strukturellen Drift, Abweichungen bei Migrationen und Plattformprobleme.
Ausführungsort klären: Prüfen Sie, ob Prüfungen im Warehouse, in der Spark-Umgebung, in einer VPC, einer Private Cloud, auf On-Premises-Infrastruktur oder in einem vom Anbieter kontrollierten Dienst laufen.
Verantwortung zuweisen: Legen Sie fest, wer Regeln schreibt, Alerts untersucht, Ausnahmen genehmigt und die Behebung bestätigt.
Nachweise testen: Fordern Sie reproduzierbare Ergebnisse, betroffene Datensätze oder Metriken, Zeitstempel, Lineage-Kontext und eine prüfbare Ausnahmehistorie.
Betriebskosten modellieren: Vergleichen Sie aktive Tabellen, Scan-Verhalten, Rechenverbrauch, Credits, Module, Support und Implementierungsaufwand, statt sich auf Lizenzzahlen zu verlassen.
Repräsentativen Pilot durchführen: Beziehen Sie eine kritische Tabelle, einen verspäteten Ladevorgang, eine Schemaänderung, einen bekannten Verstoß gegen eine Geschäftsregel und eine bewusste Transformationsänderung ein.
Schlechte Datenqualität ist ein wesentliches Geschäftsrisiko. In einem Bericht des IBM Institute for Business Value aus dem Jahr 2025 nannten 43 % der Chief Operating Officers Datenqualitätsprobleme als ihre wichtigste Datenpriorität. Laut demselben Bericht schätzten mehr als 25 % der Organisationen ihre jährlichen Verluste auf über 5 Millionen USD, während 7 % Verluste von mindestens 25 Millionen USD meldeten. Das sind umfragebasierte Schätzungen und keine universelle Bilanzgröße, aber sie erklären, warum Validierung als Governance- und operative Kontrolle behandelt werden sollte.
Eine Umfrage aus dem Jahr 2025 unter mehr als 200 Datenfachleuten ergab, dass 23,4 % dedizierte Data-Observability-Tools nutzten, verglichen mit 39,2 %, die automatisierte Tests einsetzten, und 22,6 %, die Validierungstools wie Great Expectations nutzten. Dieses Nutzungsmuster spricht für einen mehrschichtigen Ansatz. Teams sollten sich nicht zwischen Regeln und Observability entscheiden müssen, wenn kritische Daten sowohl explizite fachliche Constraints als auch frühe Warnungen bei Verhaltensänderungen brauchen. Messen Sie Abdeckung in Produktion, Untersuchungszeit, Belastung durch Fehlalarme, Verantwortung für die Behebung und aufbewahrte Nachweise.
digna ist besonders relevant, wenn Ausführung in der Datenbank, privates Deployment, korreliertes Monitoring und modularer Ausbau zentrale Anforderungen sind. Teams können damit Validierung auf Datensatzebene mit Anomalie-, Timeliness- und Schema-Kontrollen in der eigenen Umgebung kombinieren. Bei anderen Prioritäten passen Great Expectations, Soda, Monte Carlo, Anomalo, Bigeye, Datafold, Deequ, Acceldata oder Talend möglicherweise direkter.
digna kombiniert Validierung auf Datensatzebene direkt in der Datenbank mit Anomalieerkennung, Timeliness-Monitoring und Schema-Tracking in Ihrer Cloud, VPC oder Ihrem Rechenzentrum. Wenn Ihr Team audit-fähige Prüfungen braucht, ohne Produktionsdaten zu bewegen, entdecken Sie digna und bewerten Sie die Plattform anhand eines repräsentativen kritischen Datensatzes.
Falls das Budget eine kommerzielle Plattform vorerst nicht zulässt, stellt unsere Übersicht über kostenlose Datenvalidierungstools die Open-Source-Optionen vor, die sich für einen Pilot lohnen, bevor Sie sich für eines der oben genannten Produkte entscheiden.
Häufig gestellte Fragen
Was ist ein Big-Data-Validierungstool?
Software, die prüft, ob große Datensätze die erwarteten Regeln und Verhaltensmuster erfüllen. Manche Tools prüfen Geschäftsregeln auf Datensatzebene wie Wertebereiche, Nullwerte und Referenzwerte, andere erkennen Anomalien bei Freshness, Volumen oder Verteilungen, und einige vergleichen Ergebnisse zwischen Versionen, um Regressionen zu finden, bevor eine Änderung gemergt wird.
Welche Big-Data-Validierungstools sind Open Source?
Great Expectations, Soda Core und AWS Deequ haben alle eine Open-Source-Basis. Great Expectations nutzt deklarative Expectations, Soda Core die YAML-basierte SodaCL-Syntax, und Deequ ist eine Scala- und Apache-Spark-Bibliothek. Zu jedem gibt es eine kostenpflichtige oder verwaltete Ebene wie GX Cloud oder Soda Cloud für gemeinsame Ergebnisse und Alerting.
Was ist der Unterschied zwischen Datenvalidierung und Data Observability?
Validierung weist nach, dass einzelne Datensätze explizite Geschäftslogik einhalten, etwa einen zulässigen Status oder einen gültigen Betrag. Observability beobachtet Freshness, Volumen, Schema und Verteilungen, um unerwartetes Verhalten ohne eine Regel für jede Tabelle zu erkennen. Monte Carlo und Bigeye setzen eher auf Observability, Great Expectations und Soda eher auf Regeln.
Kann Datenvalidierung laufen, ohne Daten aus dem Warehouse zu bewegen?
Ja. digna berechnet Metriken und führt die Validierung direkt in den Datenbanken des Kunden aus, in dessen Cloud, VPC oder Rechenzentrum, sodass Produktionsdaten an Ort und Stelle bleiben. Auch Deequ läuft zusammen mit Spark-Jobs dort, wo die Daten bereits liegen, während mehrere SaaS-Plattformen Ergebnisse in einer vom Anbieter gehosteten Umgebung verarbeiten.
Wie wähle ich das richtige Big-Data-Validierungstool aus?
Benennen Sie den Fehler, den Sie verhindern müssen, bevor Sie Funktionen vergleichen. Ungültige Werte und fehlerhafte Feldbeziehungen erfordern deterministische Validierung auf Datensatzebene, unerwartete Verschiebungen bei Volumen oder Verteilung erfordern Anomalieerkennung, und riskante Codeänderungen erfordern Diffing auf Werteebene wie mit Datafold, bevor ein Pull Request gemergt wird.


