Datenmanagement in Finanzdienstleistungen: Ein Praxisleitfaden
|
8
min. Lesezeit

Eine Stresstest-Anfrage der Aufsicht trifft noch vor dem Mittagessen ein. Am Nachmittag hat der Chief Risk Officer immer noch keine verlässliche Sicht auf die Exposures über Rechtseinheiten, Regionen, Produkte und Anlageklassen hinweg. Ein Team gleicht Tabellen ab, ein anderes wartet auf eine verspätete Quelldatei, und das Dashboard, auf das sich alle verlassen, basiert auf den Daten von gestern.
Diese Situation ist nicht deshalb typisch, weil Finanzinstituten Daten fehlen. Sie kämpfen, weil Daten nicht mit genug Kontrolle, Kontext und Geschwindigkeit durch die Organisation fließen. Genau dieses Problem löst die praktische Disziplin des Datenmanagements in Finanzdienstleistungen: von der Entstehung in Kernsystemen über Aggregation, Validierung und Reporting bis zur Nutzung in Modellen und zum Prüfnachweis.
Inhaltsverzeichnis
Als Risikodaten nicht schnell genug flossen
Was Datenmanagement im Finanzsektor tatsächlich umfasst
Vier Säulen des Betriebsmodells
BCBS 239 in technische Kontrollen übersetzen
Vom Prinzip zur Pipeline
Die sechs Datenqualitätsdimensionen, auf die Banken nicht verzichten können
Die Dimensionen in operativer Praxis
Deterministische Prüfungen und adaptive Erkennung
Lineage, Schema-Tracking und Aktualität als ein System
Was die Control Plane erfassen sollte
Modernisieren, ohne alles zu zentralisieren
Eine Control Plane statt nur einer Zielplattform
Datenqualität als Laufzeitkontrolle für KI und Modelle
Ein 90-Tage-Betriebsmodell für das Datenmanagement im Finanzsektor
Als Risikodaten nicht schnell genug flossen
Spätestens während der globalen Finanzkrise 2007-2009 ließ sich das Muster nicht mehr ignorieren. Die Aufsicht stellte fest, dass viele große Banken ihre Exposures über Geschäftsbereiche, Rechtseinheiten, Regionen und Produkte hinweg nicht schnell aggregieren konnten, besonders unter Stress. Eine Bank verfügte vielleicht über die relevanten Datensätze, doch ihre Systeme lieferten keine belastbare gruppenweite Sicht, wenn Entscheidungsträger sie brauchten.
Eine Stresstest-Anfrage legt die Schwachstelle schnell offen. Das Risikoteam fordert das Kontrahenten-Exposure über alle Tochtergesellschaften an. Der erste Extrakt kommt mit fehlenden Entity-Identifikatoren. Eine zweite Quelle verwendet eine andere Produkttaxonomie. Das Treasury hat einen aktuelleren Saldo, das Finanzressort jedoch die freigegebene Meldezahl. Der Betrieb weiß, dass ein Feed verspätet eintraf, trotzdem zeigt das Dashboard das Ergebnis als vollständig an.
Praxisregel: Wenn ein Risikobericht in einer Krise von manuellem Abgleich abhängt, hat das Institut keinen Reporting-Prozess. Es hat eine ungesteuerte operative Abhängigkeit.
Der Basler Ausschuss reagierte im Januar 2013 mit den „Principles for effective risk data aggregation and risk reporting“. Das Rahmenwerk umfasst 14 Grundsätze, von denen 11 direkt für Banken gelten und drei sich mit aufsichtlicher Überprüfung, Instrumenten und Zusammenarbeit befassen. Die Erwartungen reichen weit über Reporting-Technologie hinaus. Banken brauchen Governance, eine angemessene Architektur, verlässliche und vollständige Daten, zeitnahe Aggregation, Anpassungsfähigkeit für Ad-hoc-Anfragen und ein klares Reporting. Die Fähigkeit muss im Normalbetrieb ebenso funktionieren wie in einer Krise, wobei die Aggregation weitgehend automatisiert erfolgen soll, um Fehler zu reduzieren. Das Basler Rahmenwerk bleibt eine grundlegende Referenz für Bankdaten und Risikomanagement.
Die Lehre daraus ist operativ. Datenqualität, Lineage, Abstimmung, Aktualität und strukturelle Konsistenz sind keine getrennten Verbesserungen, die auf eine künftige Plattformmigration warten können. Sie entscheiden darüber, ob das Senior Management Konzentrationen erkennen, Veränderungen erklären, der Aufsicht antworten und handeln kann, bevor aus einem Risiko ein Verlust wird. Wer die Folgen praxisnah betrachten möchte, findet hier mehr dazu, wie schlechte Datenqualität Kosten für Finanzinstitute verursacht.
Der Rest der Disziplin ergibt sich aus diesem Punkt. Governance legt die Verantwortlichkeit fest, die Architektur transportiert Daten und bewahrt ihren Kontext, Qualitätsprüfungen testen die Eignung für den Zweck, und das Reporting belegt, dass dem Ergebnis vertraut werden kann.
Was Datenmanagement im Finanzsektor tatsächlich umfasst
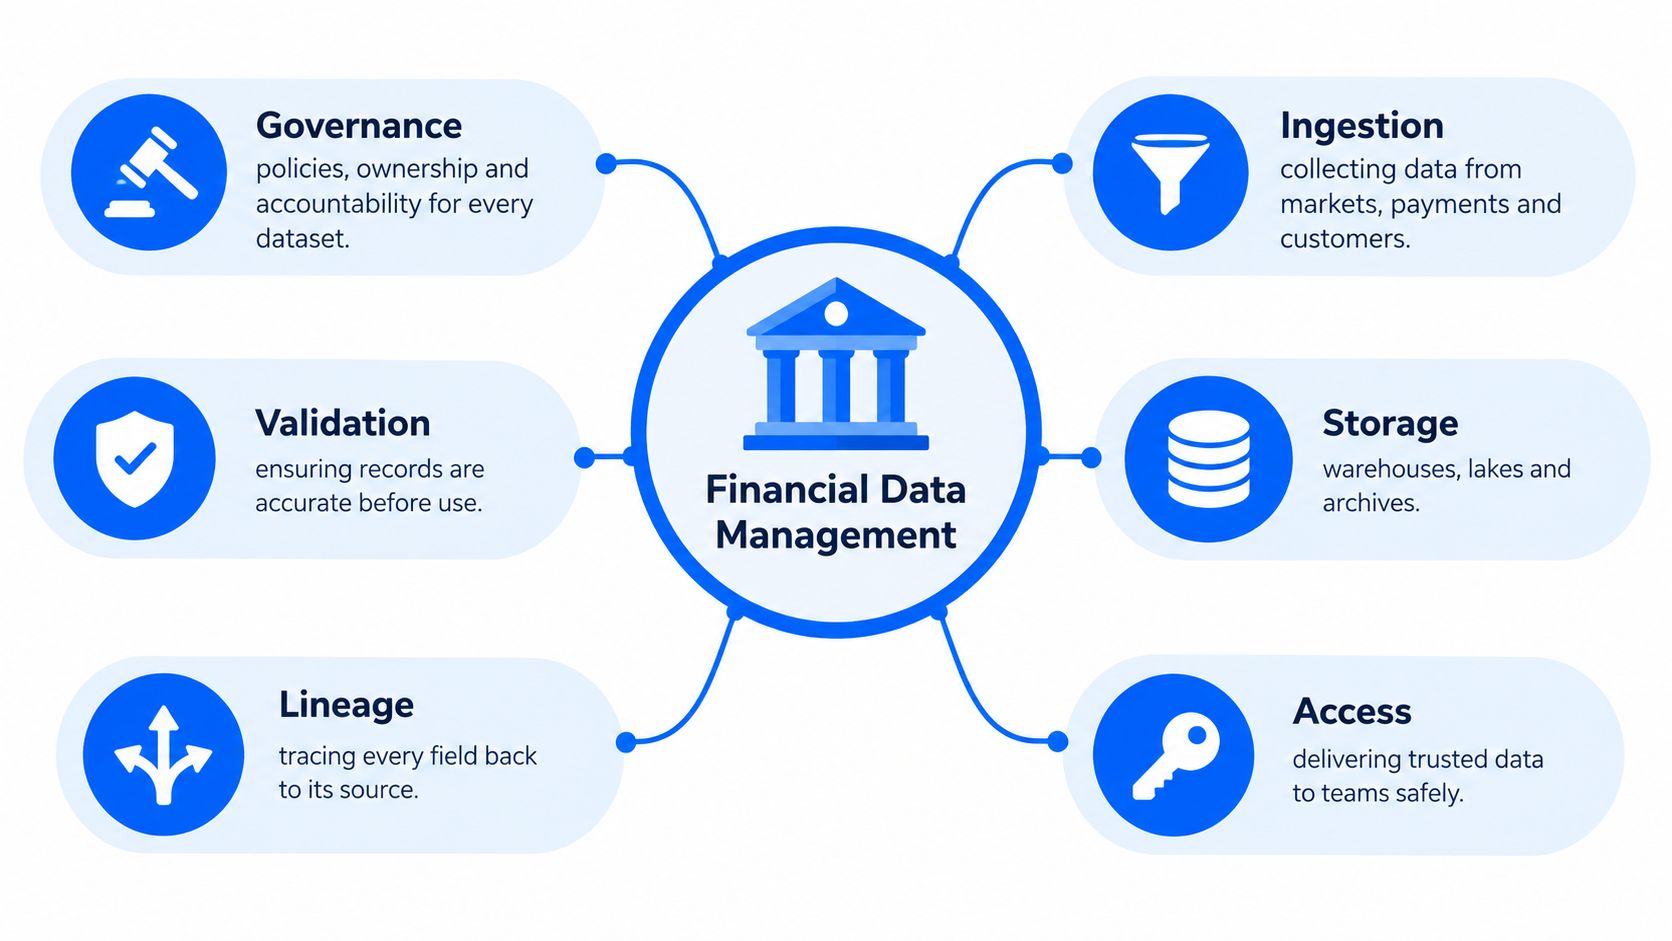
Datenmanagement in Finanzdienstleistungen ist die durchgängige Disziplin, Daten in einem Institut zu steuern, zu bewegen, zu validieren, zu speichern, bereitzustellen und zu berichten. Sie beginnt, wenn ein Kunden-, Zahlungs-, Handels-, Kredit- oder Marktereignis in ein Quellsystem gelangt. Sie setzt sich fort über Data Warehouses, Data Lakes, regulatorische Engines, Risikoberechnungen, Managementberichte und Modelle bis hin zu aufbewahrten Nachweisen.
Eine hilfreiche Analogie ist die Messtechnik. Die Produkte und Prozesse der Bank sind der Motor, das Datenmanagement liefert Anzeigen, Sensoren, Warnmeldungen und Wartungsprotokolle. Die Messtechnik erzeugt keine Geschäftstätigkeit, doch ohne sie kann der Fahrer nicht erkennen, ob der Motor normal läuft oder kurz vor dem Ausfall steht.
Vier Säulen des Betriebsmodells
Governance: Weist kritischen Daten verantwortliche Owner, Stewards, Definitionen, Schwellenwerte, Eskalationswege und zulässige Verwendungen zu.
Architektur: Verbindet Kernbankensystem, Zahlungsverkehr, Handel, Finanzen, Risiko, Data Warehouses, Data Lakes und Reporting-Services, ohne Bedeutung oder Kontrolle zu verlieren.
Datenqualität: Prüft, ob Datensätze für einen definierten Anwendungsfall vollständig, korrekt, aktuell, gültig, eindeutig und konsistent sind.
Reporting: Liefert klare, umfassende und abgestimmte Informationen in der Frequenz, die Vorstand, Management, Aufsicht und operative Teams benötigen.
Diese Säulen bedingen einander. Eine Qualitätsregel ohne Owner hat keinen dauerhaften Reaktionspfad. Ein Bericht ohne Lineage kann nicht erklären, woher eine Zahl stammt. Ein zentraler Speicher ohne Validierung bündelt lediglich unzuverlässige Datensätze. Eine Governance-Richtlinie ohne maschinenlesbare Kontrollen bleibt schwer prüfbar und wird von Abteilung zu Abteilung leicht unterschiedlich ausgelegt.
Beginnen Sie mit dem Anwendungsfall, nicht mit dem Repository. Ein Liquiditätsbericht, eine Berechnung des Kredit-Exposures, eine Kundenrisikoentscheidung und eine aufsichtliche Meldung können sich überschneidende Daten nutzen, stellen aber jeweils andere Anforderungen an Aktualität, Vollständigkeit und Abstimmung. Die Architektur sollte diese Unterschiede bewahren und den Teams zugleich gemeinsame Definitionen und sichtbare Kontrollnachweise bieten.
BCBS 239 in technische Kontrollen übersetzen
BCBS 239 wird in Lenkungsausschüssen oft als Governance-Anforderung zitiert und dann als weiteres Reporting-Projekt umgesetzt. Damit verfehlt man die eigentliche operative Absicht. Die bankbezogenen Grundsätze formulieren Erwartungen dazu, wie ein Institut wesentliche Daten identifiziert, sie gruppenweit aggregiert, das Ergebnis validiert und Informationen liefert, die sowohl im Normalbetrieb als auch unter Stress nützlich bleiben.
Der Basler Ausschuss gliederte die 11 bankbezogenen Grundsätze in drei operative Bereiche: übergreifende Governance und Infrastruktur, Fähigkeiten zur Risikodatenaggregation sowie Praktiken der Risikoberichterstattung. Engineering-Teams können diese Bereiche in Kontrollen übersetzen, die Nachweise statt bloßer Richtlinientexte erzeugen. Die ursprüngliche BCBS-239-Veröffentlichung ist die maßgebliche Referenz für das Rahmenwerk.
BCBS-239-Säule | Was die Aufsicht erwartet | Technische Kontrolle | Aufzubewahrende Nachweise |
|---|---|---|---|
Governance und Infrastruktur | Klare Verantwortlichkeit, angemessene Architektur, verlässliche Technologie und Kontrollen über alle wesentlichen Risikodaten | Register kritischer Datenelemente mit Owner, Steward, Definition, Quelle, Ziel, Schwellenwert und Eskalationspfad | Freigegebene Metadaten, Historie der Verantwortlichkeiten, Kontrollspezifikationen, Architekturdokumentation |
Risikodatenaggregation | Korrekte, vollständige, zeitnahe und anpassungsfähige Aggregation über alle relevanten Dimensionen | Abstimmungen von Quelle zu Ziel, referenzielle Prüfungen, Dublettenerkennung, Aktualitätsmonitoring, Lineage und Aggregationspfade auf Abruf | Regelergebnisse, Abstimmungssummen, Lineage-Snapshots, Ladezeitstempel, Incident-Protokolle |
Risikoberichterstattung | Korrektes, umfassendes, klares, nützliches Reporting in angemessener Frequenz | Validierung auf Berichtsebene, Verteilungskontrollen, Drill-down-Verknüpfungen, empfängerspezifische Ansichten und Berichtszertifizierung | Berichtsextrakte, Validierungsergebnisse, Freigaben, Verteilungsprotokolle, Ausnahmeentscheidungen |
Vom Prinzip zur Pipeline
Governance wird zu Metadaten, die Systeme durchsetzen können. Halten Sie für jeden kritischen Datensatz fest, wer die fachliche Bedeutung verantwortet, wer die Kontrolle betreibt, was als Fehler gilt und wer handeln muss. Die Verantwortlichkeit sollte den Daten über Quelle, Transformation, Aggregation und Berichtsebene folgen und nicht an der Anwendungsgrenze enden.
Aggregationsfähigkeit erfordert mehr als einen erfolgreich abgeschlossenen Job. Vergleichen Sie Summen in Quelle und Ziel, stimmen Sie Salden systemübergreifend ab, prüfen Sie Pflichtdimensionen wie Rechtseinheit und Geschäftsbereich und bewahren Sie das Ergebnis für jeden Berichtszyklus auf. Eine Pipeline, die fehlerfrei durchläuft, kann trotzdem eine Partition auslassen, Datensätze duplizieren oder das falsche Referenzmapping anwenden.
Reporting-Kontrollen sollten das Ergebnis als Entscheidungsprodukt testen. Versteht ein Senior Manager das Exposure? Kann ein Analyst bis zur beitragenden Einheit oder Anlageart navigieren? Kann die Bank eine Ad-hoc-Anfrage sinnvoll beantworten, ohne den Bericht manuell neu aufzubauen?
Die Umsetzung von BCBS 239 bleibt eine erhebliche technische Herausforderung. Die Bewertung des Basler Ausschusses von 2023 umfasste 31 G-SIBs und ergab, dass die Banken fast ein Jahrzehnt nach Veröffentlichung der Grundsätze und sieben Jahre nach dem erwarteten Umsetzungstermin unterschiedlich weit waren. Die praktische Konsequenz ist eindeutig: Eine Risikoplattform muss eine kontrollierte, wiederholbare Pipeline für Aggregation, Abstimmung, Lineage und Bereitstellung sein und kein passives Reporting-Repository. Die Basler Bewertung liefert den aufsichtlichen Kontext. Teams, die Umsetzungsoptionen prüfen, können sich zudem einen KI-gestützten Ansatz zur Erfüllung der BCBS-239-Grundsätze ansehen.
Die sechs Datenqualitätsdimensionen, auf die Banken nicht verzichten können
Ein Datensatz ist nicht abstrakt „hochwertig“. Er ist für eine bestimmte Entscheidung, einen Bericht, ein Modell oder eine Kontrolle geeignet oder eben nicht. Ein Kreditbuch kann vollständig, aber veraltet sein. Ein Kunden-Feed kann aktuell, aber ungenau sein. Ein regulatorischer Extrakt kann Formatprüfungen bestehen und dennoch Währungen zwischen Einheiten uneinheitlich behandeln.

Die Dimensionen in operativer Praxis
Vollständigkeit fragt, ob die erforderlichen Datensätze und Felder vorhanden sind. Fehlende Attribute zur Kundenidentifikation in einem KYC-Feed oder ein fehlender Rechtseinheiten-Code in einem Kreditextrakt können einen ansonsten befüllten Datensatz unbrauchbar machen.
Genauigkeit fragt, ob der Wert die tatsächlichen Verhältnisse abbildet. Ein Kreditsaldo, der nicht mit dem maßgeblichen Datensatz der Kreditverwaltung übereinstimmt, sollte eine Untersuchung auslösen, bevor er in einen Kapital- oder Managementbericht gelangt.
Aktualität fragt, ob Informationen rechtzeitig eintreffen, um die Entscheidung noch zu unterstützen. Eine verspätete Handelsdatei kann technisch gültig, für eine Intraday-Risikosicht aber operativ falsch sein.
Gültigkeit prüft, ob Werte definierten fachlichen und strukturellen Regeln folgen. Datumsangaben, Kontokennungen, Währungen, Klassifikationen und Produktcodes brauchen akzeptierte Formate und zulässige Werte.
Eindeutigkeit verhindert, dass derselbe Kunde, Kontrahent, dasselbe Konto oder dieselbe Transaktion mehrfach erscheint, wo nur ein Datensatz erwartet wird. Doppelte Kontrahenten können die Exposure-Aggregation und Beziehungssichten verzerren.
Konsistenz prüft, ob derselbe Sachverhalt systemübergreifend übereinstimmt. Ein Saldo, eine Währungsnormalisierung, eine Entity-Hierarchie oder eine Risikoklassifizierung sollte sich zwischen Kernplattform und Data Warehouse nicht unbemerkt ändern.
Diese Dimensionen wirken zusammen, sollten aber nicht zu einem einzigen Score verdichtet werden. Ein zusammengesetzter Score kann einen wesentlichen Fehler verbergen. Berichten Sie stattdessen die verletzte Dimension, das betroffene Datenelement, die geschäftlichen Auswirkungen, den Owner und den Behebungsstatus. Ein Risikokomitee muss wissen, dass ein Feed verspätet ist oder eine Saldenabstimmung fehlgeschlagen ist, nicht bloß, dass ein Qualitätsscore gesunken ist.
Deterministische Prüfungen und adaptive Erkennung
Deterministische Validierung ist dort am stärksten, wo die Regel explizit ist. Prüfen Sie, dass jeder Kredit eine Rechtseinheit hat, jeder Handel auf ein bekanntes Instrument verweist, jedes Konto eine zulässige Währung nutzt und die Summen von Quelle und Ziel übereinstimmen. Diese Prüfungen sind nachvollziehbar und lassen sich leicht mit Prüfnachweisen verknüpfen.
Anomalieerkennung ergänzt eine andere Fähigkeit. Sie kann eine ungewöhnliche Volumenverschiebung, eine Verteilungsänderung oder eine Saldenbewegung im Vergleich zum normalen Verhalten eines bestimmten Datensatzes erkennen. Sie sollte fachliche Regeln nicht ersetzen. Sie sollte bei der Einordnung helfen, ob eine Bewegung ein echtes Portfolioereignis, eine unvollständige Quellladung oder eine fehlerhafte Transformation ist.
Eine praxisnahe Darstellung der Dimensionen und ihrer Anwendung finden Sie unter die sechs Dimensionen der Datenqualität. Die wichtige operative Veränderung besteht darin, Qualität kontinuierlich zu überwachen. Das Profiling einer Tabelle während eines Bereinigungsprojekts zeigt, was damals war. Laufzeitkontrollen zeigen, ob der Datensatz heute noch sicher nutzbar ist.
Lineage, Schema-Tracking und Aktualität als ein System
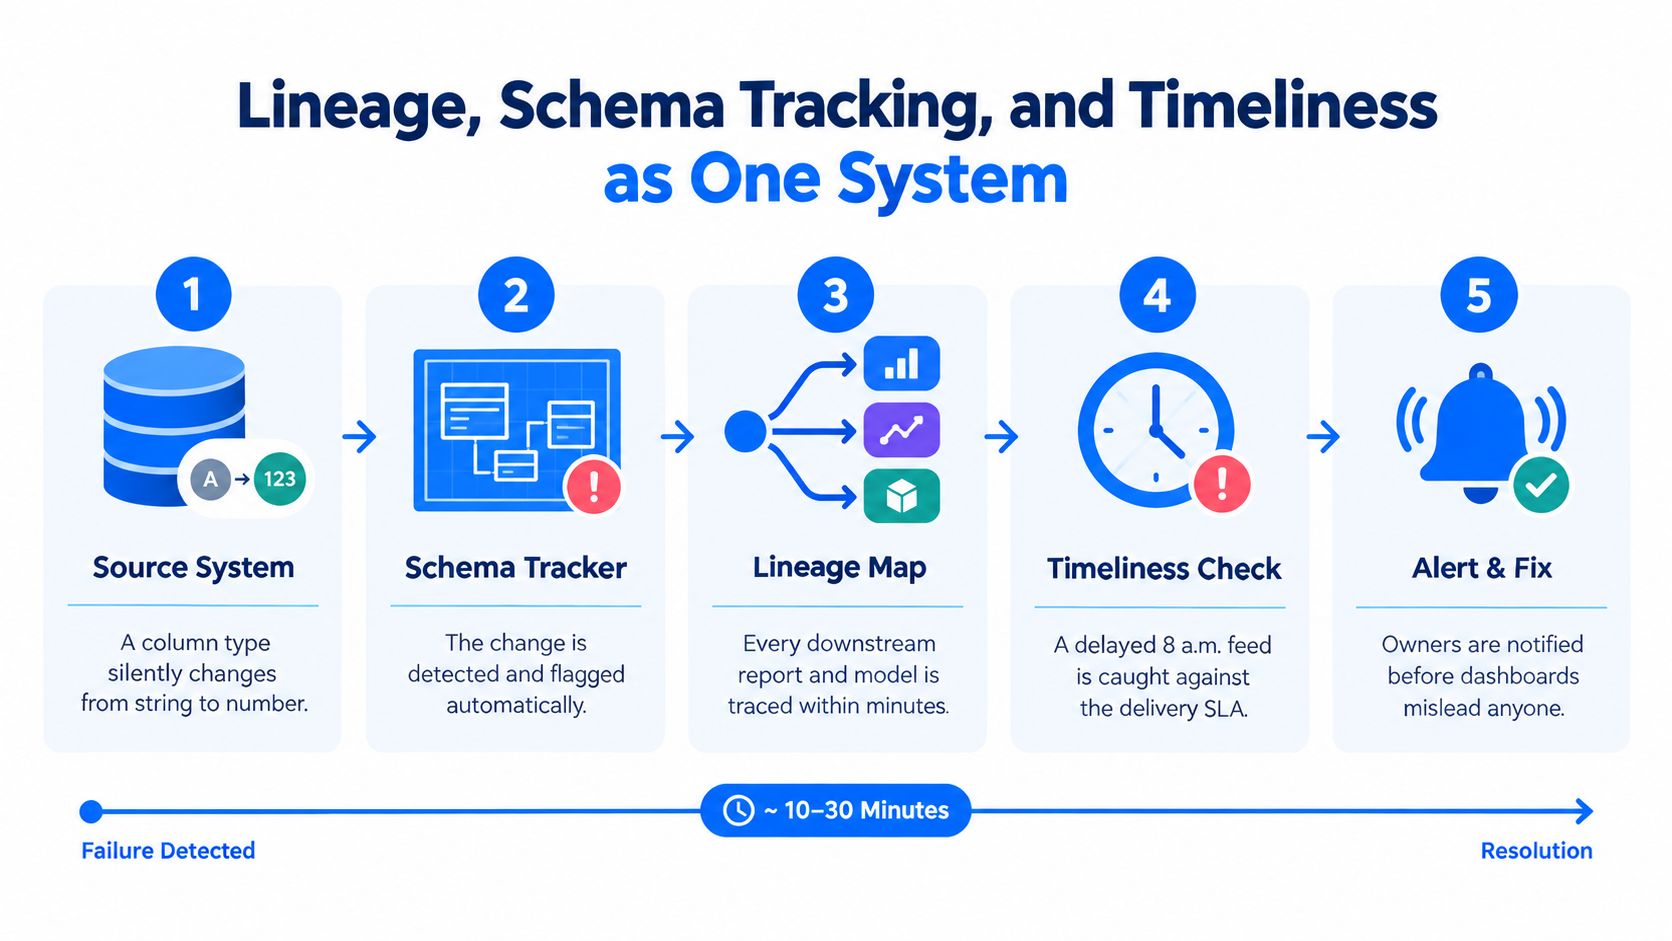
Lineage wird oft als Diagrammübung behandelt. Aktualität wird an den Betrieb delegiert. Schema-Tracking wird erst ergänzt, nachdem ein nachgelagerter Job abgebrochen ist. Im Finanzsektor gehören diese drei Kontrollen zusammen, denn eine strukturelle Änderung oder Lieferverzögerung kann die Aussage eines Berichts verändern, selbst wenn jeder geplante Job Erfolg meldet.
Nehmen wir ein Quellsystem, das ein numerisches Exposure-Feld in einen String ändert. Der Ingestion-Prozess akzeptiert den neuen Typ, eine Transformation wandelt einige Werte um, und der Reporting-Job läuft durch. Das resultierende Exposure kann Nullwerte, abgeschnittene Werte oder fehlgeschlagene Joins enthalten. Ohne Schema-Tracking entdeckt die Organisation den Fehler erst, wenn jemand die Zahl hinterfragt.
Eine fehlende Partition verursacht ein ähnliches Problem. Die Pipeline läuft, aber eine Region oder Rechtseinheit fehlt. Ein verspäteter Markt- oder Transaktions-Feed kann ebenso schädlich sein, wenn ein Bericht den letzten gültigen Wert verwendet und ihn als aktuell darstellt.
Was die Control Plane erfassen sollte
End-to-End-Lineage sollte die Quelltabelle, das Feld, die Transformation, die Referenzdaten, den Zieldatensatz, den Bericht und das Modell identifizieren, die von einem kritischen Element abhängen. Sie benötigt außerdem Versionshistorie, Verantwortlichkeiten, die letzte erfolgreiche Lieferung und die Kontrollergebnisse jedes Laufs.
Schema-Tracking sollte Folgendes erkennen:
Hinzugefügte oder entfernte Spalten: Ein neues Feld kann harmlos sein, während ein entfernter Identifikator Joins oder die regulatorische Klassifizierung unterbrechen kann.
Änderungen des Datentyps: Ein neu typisierter Betrag, ein Datum oder ein Schlüssel kann Berechnungen verändern, ohne eine Pipeline anzuhalten.
Definitionsänderungen: Ein Feld kann seinen Namen behalten, während sich seine fachliche Bedeutung oder Befüllungslogik ändert.
Strukturelle Drift nachgelagert: Eine Data-Warehouse- oder Reporting-Schicht kann vom freigegebenen Vertrag abweichen, auch wenn die Quelle stabil bleibt.
Das Aktualitätsmonitoring sollte das erwartete Lieferverhalten lernen, statt einen festen Zeitplan auf jeden Feed anzuwenden. Markt-, Transaktions- und Batch-Quellen funktionieren unterschiedlich. Ein Feed, der normalerweise früh eintrifft, kann dennoch auffällig sein, wenn er sein erwartetes Zeitfenster verpasst, während eine starre Uhrzeit bei einer Quelle mit legitimer Schwankung nur Fehlalarme erzeugt.
Die Bewertung des Basler Ausschusses von 2023 umfasste 31 G-SIBs und zeigte Institute auf unterschiedlichen Stufen der BCBS-239-Umsetzung. Das unterstreicht den Bedarf an kontrollierten Pipelines, die Aggregation, Abstimmung, Lineage und Bereitstellung unter normalen wie unter Stressbedingungen unterstützen. Die Details der Bewertung machen die technische Konsequenz deutlich.
Hilfreich ist die Unterscheidung zwischen Provenienz und Lineage. Provenienz beantwortet, was mit den Daten geschehen ist und unter welchem Prozess. Lineage bildet ab, wie ein Feld durch Systeme und Abhängigkeiten wandert. Wer beide Konzepte vergleichen möchte, kann diesen Leitfaden zu Data Provenance und Data Lineage nutzen. Keines von beiden genügt allein. Lineage ohne Struktur- und Aktualitätskontrollen ist nur eine unvollständige Control Plane.
Modernisieren, ohne alles zu zentralisieren
Eine Bank kann ihre Reporting-Daten zentralisieren und dennoch bei einer BCBS-239-Prüfung durchfallen. Die zentrale Kopie kann unvollständig, verspätet oder vom System getrennt sein, das den Geschäftsprozess verantwortet. Zentralisierung verändert, wo Daten liegen. Sie schafft für sich genommen weder Verantwortlichkeit noch Validierung, Aktualität oder Nachweise.
Sensible Produktionsdaten verursachen zudem Kosten, wenn sie in eine neue Plattform kopiert werden. Die Bank muss ein weiteres Repository absichern, klassifizieren, abstimmen, steuern und erklären. Ein zentraler Speicher kann manchen Nutzern den Zugriff erleichtern, erhöht aber zugleich Duplizierung, Datenschutzrisiken, Latenz und Integrationsaufwand.
Die operative Realität ist verteilt. Kundendaten können in Kernsystemen verbleiben, Transaktionen in Data Warehouses, Marktdaten in Spezialplattformen und länderspezifische Kopien unter separaten Kontrollen. Die praktische Frage lautet, ob die Bank nachweisen kann, dass kritische Daten überall dort, wo sie liegen, für ihren Zweck geeignet sind.
Eine Control Plane statt nur einer Zielplattform
Eine verteilte Control Plane führt Prüfungen nahe an den Quellsystemen oder direkt in der Datenbank des Kunden aus und zentralisiert anschließend Metadaten und Nachweise statt sensibler Datensätze. Zu ihren operativen Kontrollen sollten gehören:
Validierung vor Ort: Fachliche Regeln auf Quelltabellen anwenden, ohne eine weitere Produktionskopie zu erzeugen.
Verantwortlichkeit: Jeden kritischen Datensatz, jede Regel, jede Ausnahme und jede Behebungsmaßnahme einem verantwortlichen Team zuordnen.
Strukturmonitoring: Schemaänderungen am Entstehungsort erkennen und betroffene Konsumenten über die Lineage identifizieren.
Aktualitätskontrollen: Die tatsächliche Lieferung mit dem erwarteten Verhalten jedes Feeds vergleichen.
Aufbewahrung von Nachweisen: Regelergebnisse, Ausnahmen, Freigaben, Eskalationen und Behebungshistorie sichern.
Risikobasierte Priorisierung: Mit den Datensätzen beginnen, die Kapital-, Liquiditäts-, Kredit-, Finanz- und Aufsichtsreporting stützen.
Dieses Design macht aus aufsichtlichen Erwartungen aus BCBS 239, EZB-Prüfungen und SR 11-7 operative Nachweise. Teams können zeigen, wer eine Kontrolle verantwortet, welche Validierung lief, ob ein Feed in seinem erwarteten Zeitfenster eintraf, welches Schema sich geändert hat und wie Ausnahmen gelöst wurden.
Der Zielkonflikt bleibt real. Kontrollen vor Ort erfordern bessere Metadaten, Konnektoren und Disziplin bei den Verantwortlichkeiten. Zentrale Plattformen können die Analyse vereinfachen, doch eine zentrale Kopie kann Fehler in der Quelle verdecken oder zur maßgeblichen Quelle werden, ohne dass belegt ist, dass sie synchron bleibt. Banken, die zwischen diesen Mustern wählen, können diesen Vergleich von Data Mesh und zentralen Datenplattformen heranziehen. Die Entscheidung sollte sich nach Kontrollabdeckung, Datensensibilität, Performance, Rechtsraum und Altsystemen richten, nicht nach einer Vorliebe für eine bestimmte Architektur.
Datenqualität als Laufzeitkontrolle für KI und Modelle
KI-Reife ist im Finanzsektor in erster Linie ein Problem des Datenverhaltens, kein Problem der Modellauswahl. Ein validiertes Modell kann sich trotzdem unsicher verhalten, wenn sein Input-Feed verspätet eintrifft, das Schema ändert, eine Klasse verliert, eine neue Verteilung entwickelt oder sich von der bei der Validierung verwendeten Baseline entfernt.
Eine IIF-EY-Umfrage von 2025 ergab, dass 79 % der Finanzdienstleister insgesamt sowie 100 % der G-SIBs und global systemrelevanten Versicherer Datenqualität als eine der größten Herausforderungen bei der KI-Entwicklung nannten. Von diesen Unternehmen sahen 96 % verrauschte, verspätete, ungenaue oder nicht anpassbare Daten als größtes Hindernis für den Produktivbetrieb. Die IIF-EY-Umfrage liefert die Belege für dieses operative Anliegen.
SR 11-7 ergänzt die Perspektive der Modellrisiko-Governance. Banken benötigen dokumentierte Kontrollen über Modellentwicklung, Implementierung, Validierung, laufende Überwachung und Governance hinweg. Das Federal Reserve Supervisory Letter SR 11-7 bedeutet, dass eine Datenanomalie zu einem Modellrisikoereignis werden kann, wenn sie einen Input ohne freigegebene Erklärung verändert.
Bewahren Sie Nachweise für die Zeit nach der Validierung auf, nicht nur das Validierungspaket selbst:
Baseline-Änderung: Was sich verschoben hat, wann es sich verschoben hat und ob die Bewegung erwartet war.
Feed-Verhalten: Ob der Datensatz verspätet, unvollständig oder mit fehlenden Partitionen eintraf.
Schema-Zustand: Welche Felder, Typen oder Definitionen sich geändert haben.
Verteilungsverhalten: Ob sich Klassen- oder Werteverteilungen über den akzeptierten Schwellenwert hinaus bewegt haben.
Entscheidungsprotokoll: Wer den Vorfall bewertet hat und ob die Reaktion Fortführen, Zurückrollen oder Revalidieren lautete.
Teams, die KI-Lösungen für den Finanzbereich prüfen, sollten diesen Nachweiskreislauf als Teil der Implementierung behandeln und nicht als nachträglichen Governance-Anhang. Ein Modell-Owner braucht datensatzspezifische Schwellenwerte und klare Auslöser für Untersuchung, Rollback oder Revalidierung.
Die IIF-EY-Umfrage von 2025 berichtete außerdem, dass 72 % der Unternehmen über Feedback-Mechanismen oder Kontrollen zur Korrektur von KI-Modellen verfügten und weitere 25 % daran arbeiteten. Diese Entwicklung bestätigt den Punkt: Modell-Governance wird korrigierend und operativ. Data Observability muss direkt in diesen Kreislauf eingebunden sein.
Ein 90-Tage-Betriebsmodell für das Datenmanagement im Finanzsektor
Beginnen Sie mit den Daten, die eine Risikoentscheidung, eine aufsichtliche Meldung, eine Kapitalberechnung oder einen Modellinput verändern können. Definieren Sie kritische Datenelemente nach Risikobereich, Rechtseinheit, Geschäftsbereich, Anlageklasse, Region und Reporting-Anwendungsfall.
Hinterlegen Sie verantwortlichen Owner und Steward als maschinenlesbare Metadaten. Verknüpfen Sie jedes Element mit Kontrollen für Vollständigkeit, Aktualität, Abstimmung, referenzielle Integrität, Dubletten und Schema. Führen Sie Prüfungen nach Möglichkeit nahe an der Quelle aus, bewahren Sie Nachweise für jeden Berichtszyklus auf und leiten Sie Ausnahmen an namentlich benannte Personen weiter.
Nutzen Sie deterministische Validierung für bekannte Regeln und Baseline-basierte Anomalieerkennung für unerwartetes Verhalten. Testen Sie das Betriebsmodell mit einer normalen Lieferung und einem Stressszenario, bevor Sie die Abdeckung ausweiten. Eine kleine Zahl kontrollierter, belegter Datensätze ist besser zu verteidigen als ein breiter Katalog ohne verlässlichen Reaktionspfad.
digna bietet Datenqualität und Observability direkt in Ihrer Umgebung für Teams im Finanzsektor, einschließlich In-Database-Validierung, Aktualitätsmonitoring, Anomalieerkennung, Schema-Tracking und Nachweisen für verteilte Datenpipelines. Besuchen Sie digna und erfahren Sie, wie der Control-Plane-Ansatz Ihnen hilft, kritische Daten zu überwachen, ohne vorauszusetzen, dass Zentralisierung die Antwort ist.
Doppelte Kontrahenten und Kredite ohne gültige Rechtseinheit sind im Kern gebrochene Beziehungen zwischen Systemen. Die Prüfungen, die diese Schlüssel vom Kernbankensystem bis zum Risiko-Data-Warehouse konsistent halten, finden Sie unter referenzielle Integrität in Bankdaten.
Häufig gestellte Fragen
Was umfasst Datenmanagement in Finanzdienstleistungen?
Es umfasst das Steuern, Bewegen, Validieren, Speichern und Berichten von Daten ab dem Moment, in dem eine Zahlung, ein Handel, ein Kredit oder ein Kundenereignis in ein Quellsystem gelangt, bis die Daten in Risikoberechnungen, aufsichtliche Meldungen und Modelle einfließen. Governance, Architektur, Datenqualität und Reporting bilden vier Säulen, die nur funktionieren, wenn sie ineinandergreifen.
Wie übersetzt man BCBS 239 in technische Kontrollen?
Übersetzen Sie jeden Grundsatzbereich in Kontrollen, die Nachweise erzeugen: ein Register kritischer Datenelemente mit Ownern und Schwellenwerten für die Governance, Abstimmungen von Quelle zu Ziel und Aktualitätsmonitoring für die Aggregation sowie Validierung und Zertifizierung auf Berichtsebene für das Reporting. Bewahren Sie Regelergebnisse, Lineage-Snapshots und Incident-Protokolle für jeden Berichtszyklus auf.
Welche Datenqualitätsdimensionen sind für Banken am wichtigsten?
Vollständigkeit, Genauigkeit, Aktualität, Gültigkeit, Eindeutigkeit und Konsistenz. Jede beantwortet eine andere Frage, etwa ob ein Kredit seinen Rechtseinheiten-Code trägt oder ob ein Saldo zwischen Kernplattform und Data Warehouse übereinstimmt. Berichten Sie verletzte Dimension, Owner und Auswirkung getrennt, statt sie zu einem zusammengesetzten Score zu verdichten, der einen wesentlichen Fehler verbergen kann.
Müssen Banken für BCBS 239 alle Daten zentralisieren?
Nein. Auch eine zentrale Kopie kann unvollständig, verspätet oder vom prozessverantwortlichen System getrennt sein. Eine verteilte Control Plane führt Prüfungen vor Ort nahe an den Quellsystemen aus und zentralisiert nur Metadaten und Nachweise. So entstehen keine zusätzlichen Kopien sensibler Daten, und dennoch lässt sich belegen, dass kritische Daten für ihren Zweck geeignet sind.
Warum ist Datenqualität eine Laufzeitkontrolle für KI-Modelle im Finanzsektor?
Ein validiertes Modell kann sich unsicher verhalten, wenn sein Input verspätet eintrifft, das Schema ändert oder von seiner Baseline abweicht. In einer IIF-EY-Umfrage von 2025 nannten 79 % der Finanzdienstleister Datenqualität als eine der größten KI-Herausforderungen. Unter SR 11-7 kann eine unerklärte Input-Änderung zu einem Modellrisikoereignis werden, das eine Untersuchung oder Revalidierung erfordert.


