Parquet-Datei: Architektur, Performance und Einsatz
|
10
min. Lesezeit

Sie stecken vermutlich gerade in einer von zwei Situationen. Entweder wählen Sie ein Speicherformat für einen neuen Datensatz und jede Option klingt vage „optimiert“, oder Sie haben Parquet bereits in Produktion und Ihr Problem ist nicht das Lesen, sondern zu verstehen, warum ein Datensatz schnell ist, ein anderer träge und ein dritter sich plötzlich nicht mehr öffnen lässt.
Genau dort greifen die meisten Parquet-Texte zu kurz. Sie erklären den Idealpfad. Sie sagen, Parquet sei spaltenorientiert, komprimiert und gut für Analytik, was stimmt, aber nicht reicht, wenn Sie Row Groups abstimmen, beschädigte Uploads debuggen oder entscheiden müssen, ob neue logische Typen die Interoperabilität zwischen Engines brechen.
Parquet zählt, weil es im Zentrum moderner Datenplattformen sitzt. Es ist das Dateiformat, das viele Teams als physische Schicht unter Data Lakes, Lakehouses, Feature Stores, Archivzonen und werkzeugübergreifendem Austausch einsetzen. Wer die Dateimechanik versteht, trifft bessere Entscheidungen über Layout, Abfrageverhalten, Governance und Fehlerbehandlung.
Inhaltsverzeichnis
Wie Predicate Pushdown und Page-Indizes Abfragen beschleunigen
Komprimierung, Encoding, Partitionierung und Schemaevolution
Was eine Parquet-Datei ist und warum sie zählt
Eine Parquet-Datei ist ein offenes spaltenorientiertes Dateiformat für analytische Workloads. Es begann als gemeinsame Open-Source-Anstrengung von Twitter und Cloudera, erschien erstmals als Parquet 1.0 im Juli 2013 und wurde am 27. April 2015 zum Top-Level-Projekt der Apache Software Foundation. Sein Entwurf stützte sich auf Dremel-artiges Record Shredding and Assembly, was es zu einer natürlichen Wahl für großangelegte Analytik in Cloud-Data-Lakes machte, wie im Hintergrund zu Apache Parquet beschrieben.
Dieser Ursprung zählt, weil analytische Workloads sich anders verhalten als transaktionale Systeme. Analystinnen und Analysten holen selten einen vollständigen Datensatz nach dem anderen. Sie scannen viele Zeilen, berühren wenige Spalten, filtern hart, aggregieren härter und wiederholen dieses Muster den ganzen Tag. Ein zeilenorientiertes Format wie CSV zwingt die Engine, viel Irrelevantes zu lesen, nur um eine einfache Frage zu beantworten.
Warum spaltenorientierte Speicherung das Kostenprofil verändert
Angenommen, Ihre Tabelle hat customer_id, event_date, country, device_type, revenue, campaign, browser und ein Dutzend weiterer Felder. Braucht Ihre Abfrage nur event_date und revenue, schleift ein zeilenbasiertes Format trotzdem jedes Feld durch I/O und Parsing. Parquet nicht.
Das ist der praktische Gewinn. Spaltenorientierte Speicherung lässt Query-Engines nur die Spalten lesen, die sie brauchen, was verschwendete I/O und Speicher bei selektiver analytischer Arbeit reduziert. Auch deshalb wurde Parquet zur Standard-Austauschschicht zwischen Werkzeugen, die keine gemeinsame Laufzeit teilen.
Warum Teams in gemischten Werkzeuglandschaften darauf setzen
Eine Parquet-Datei trägt ihr eigenes Schema und ihre Metadaten in der Dateistruktur, sodass sie gut zwischen Spark, Hive, Pandas, DuckDB, Trino und warehouse-nahen Engines reist. Sie brauchen nicht immer einen externen Katalog, nur um den Inhalt zu deuten.
Praxisregel: Wenn Ihr Team erwartet, dass derselbe Datensatz zwischen Verarbeitungs-Engines wandert, spart ein selbstbeschreibendes Format viel brüchigen Klebecode.
Parquet ist faktisch zur gemeinsamen Speichersprache des Lakehouse-Stacks geworden. Wenn Sie breiter über Plattformdesign nachdenken, ist das ein Grund, warum das Fundament der Datenplattform so viel ausmacht. Das Dateiformat ist kein Nebendetail. Es prägt, wie jede nachgelagerte Engine Ihre Daten liest, überspringt, validiert und ihnen vertraut.
Im Inneren der Parquet-Dateiarchitektur
Am saubersten verstehen Sie eine Parquet-Datei, wenn Sie aufhören, sie als Blob zu sehen, und beginnen, sie als kleine Bibliothek zu denken.
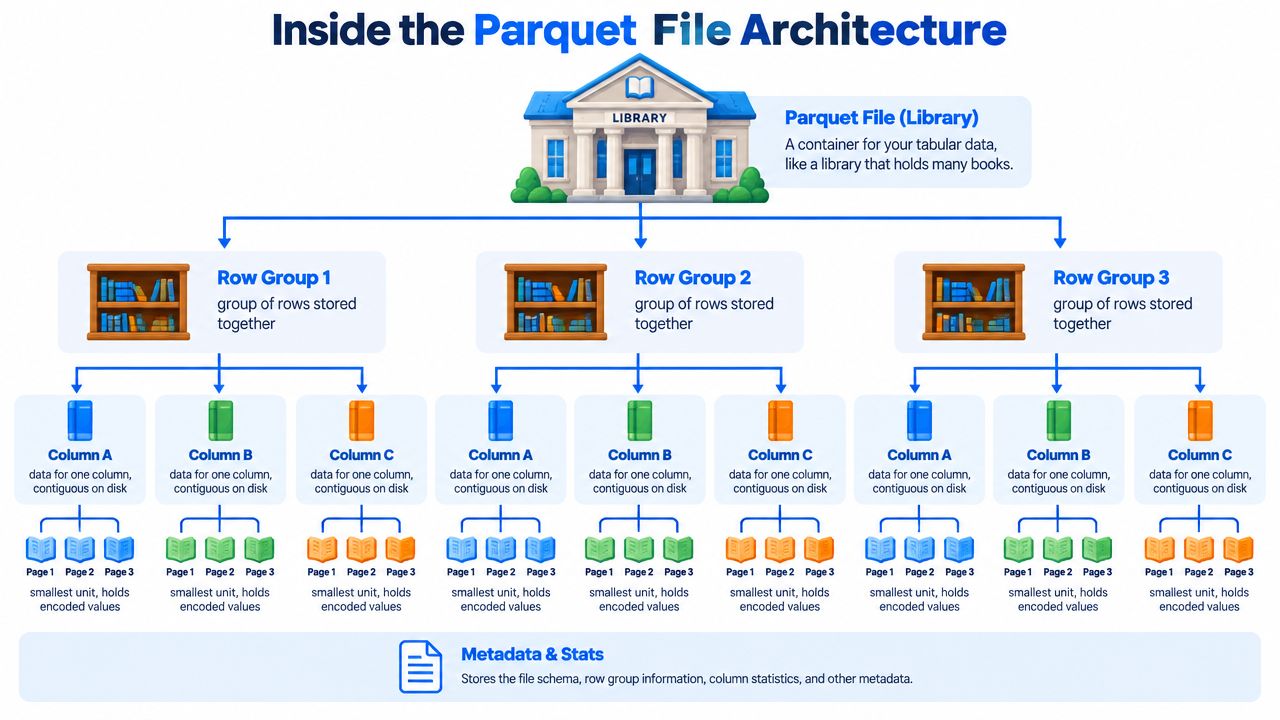
Die Datei ist das Gebäude. Darin sind Row Groups die Abteilungen der Bibliothek. Innerhalb jeder Row Group ist jeder Column Chunk ein Regal für eine Spalte. Und jeder Column Chunk enthält Pages, die kleineren Einheiten, die sequenziell von der Platte gelesen werden.
Die Apache-Konzeptdokumentation legt das direkt dar: Eine Datei enthält eine oder mehrere Row Groups, jede Row Group enthält genau einen Column Chunk je Spalte, und jeder Column Chunk enthält eine oder mehrere Pages. Sie hält außerdem fest, dass Column Chunks zusammenhängend in der Datei liegen, einer der Gründe, warum spaltenorientierte Lesevorgänge in der Praxis effizient funktionieren, wie in der Parquet-Konzeptreferenz dokumentiert.
Die Hierarchie, die Reader tatsächlich nutzen
Diese Hierarchie ist nicht akademisch. Query-Engines nutzen sie ständig.
Die Dateiebene gibt dem Reader ein einzelnes Objekt zum Öffnen und Prüfen.
Die Row-Group-Ebene fungiert als praktische Einheit für paralleles Scannen.
Die Column-Chunk-Ebene lässt die Engine nur die von der Abfrage angeforderten Spalten ziehen.
Die Page-Ebene ist der Ort, an dem codierte Werte gespeichert und der Reihe nach dekodiert werden.
Wenn Sie an Datensystemarchitektur gearbeitet haben, sollte sich das vertraut anfühlen. Effiziente Systeme sind meist hierarchisch, weil Hierarchie den Lesenden Haltepunkte gibt. Parquet bietet diese Haltepunkte auf mehreren Ebenen.
Was an den Rändern der Datei liegt
Eine gesunde Parquet-Datei beginnt und endet mit den Magic Bytes PAR1. Das ist eine der ersten Integritätsprüfungen, die viele Werkzeuge nutzen. Fehlt die Endmarkierung, ist die Datei womöglich abgeschnitten, unvollständig oder gar kein Parquet.
Der Footer nahe dem Dateiende ist der Ort, an dem ein Großteil der Intelligenz liegt. Er speichert das Schema, Row-Group-Metadaten und Key-Value-Metadaten. Deshalb ist Parquet selbstbeschreibend. Reader müssen die Gestalt des Datensatzes nicht erraten.
Eine Parquet-Datei ist leicht zu lesen, wenn die Data Pages in Ordnung sind. Sie ist leicht zu diagnostizieren, wenn der Footer in Ordnung ist. Schmerzhaft wird es, wenn der Transport die Datei zerstört hat, bevor eine dieser Schichten helfen konnte.
Wie Parquet verschachtelte Daten behandelt
Parquet wurde um Dremel-artiges Shredding and Assembly herum entworfen, womit es verschachtelte Strukturen wie Structs, Listen und Maps darstellt, ohne Feldnamen in jeder Zeile zu wiederholen. Der Kniff ist, dass der Writer verschachtelte Datensätze in spaltenweise Teile zerlegt und genug Positionsinformationen behält, um sie später wieder zusammenzusetzen.
Diese Positionsinformation wird üblicherweise über Definition Levels und Repetition Levels ausgedrückt. Schlicht gesagt helfen diese Ebenen dem Reader zu unterscheiden zwischen „dieses Feld ist null“, „diese Liste ist leer“ und „dieses verschachtelte Kind gehört zum selben Elternteil wie der vorherige Wert“. Wenn Sie je verschachtelte Daten mit überraschenden Nullwerten oder Formabweichungen zurückgelesen haben, steckt meist diese Mechanik dahinter.
Unter der Haube können Pages je nach Daten und Writer-Verhalten verschiedene Encodings nutzen. In echten Systemen begegnen Ihnen Plain Encoding, Dictionary Encoding, Run-Length Encoding, Bit-Packing, Delta-artige Encodings und Byte Stream Split. Der springende Punkt ist nicht, jedes Encoding auswendig zu kennen. Es geht darum zu verstehen, dass Parquet Werte in kompakten, codierten Page-Einheiten speichert statt als rohen, zeilenweisen Text.
Wie Predicate Pushdown und Page-Indizes Abfragen beschleunigen
Eine Parquet-Abfrage wird schnell, wenn der Reader beweisen kann, dass große Teile der Datei irrelevant sind, bevor er die Data Pages öffnet. Das ist der Gewinn. Komprimierung hilft bei Bytes auf der Platte und im Netz. Predicate Pushdown hilft bei etwas, das in der Produktion wertvoller ist: weniger Lesevorgänge, weniger Dekomprimierungen und weniger Arbeit in der Ausführungs-Engine.
Ausgangspunkt sind die Footer-Metadaten, wie in der Parquet-Dateiformatdokumentation beschrieben. Neben Schema- und Layoutdetails kann Parquet je Row Group Spaltenstatistiken speichern, darunter Minimalwerte, Maximalwerte und Null-Anzahlen. Query-Engines prüfen mit diesen Statistiken Ihren Filter gegen jede Row Group, bevor sie die eigentlichen Spaltendaten scannen.
Ein häufiger Fall macht das konkret. Angenommen, Ihre Abfrage filtert auf:
WHERE event_date BETWEEN '2026-01-01' AND '2026-01-31'
Liegen die event_date-Grenzen einer Row Group vollständig im März, kann die Engine sie allein aus den Metadaten ausschließen. Deckt eine andere Row Group Januartage ab, braucht diese Gruppe weitere Prüfung. Das Ergebnis ist simpel:
Row Groups, deren Min und Max das Prädikat nicht erfüllen können, werden übersprungen.
Row Groups, deren Bereich das Prädikat überlappt, bleiben Kandidaten.
Kandidatengruppen erfordern weiterhin Page-Lesevorgänge oder Wertprüfungen, um Treffer zu bestätigen.
Das klingt geradlinig, doch zwei Produktionsdetails zählen.
Erstens sind Row-Group-Statistiken nur so nützlich wie das Datenlayout. Sind Werte nach event_date geclustert, sind Min- und Max-Bereiche eng und das Pruning ist scharf. Wurde die Datei aus stark durchmischten Daten geschrieben, kann jede Row Group einen weiten Datumsbereich abdecken, und die Metadaten werden deutlich unselektiver. Predicate Pushdown läuft weiterhin. Es hat nur weniger Angriffsfläche.
Zweitens sind Row Groups eine grobe Einheit. Sie wirken wie Kisten in einem Lager. Sagt das Etikett, dass jeder Artikel in der Kiste aus dem März stammt, überspringen Sie die ganze Kiste. Sagt es, die Kiste enthalte Januar bis März, müssen Sie sie öffnen, selbst wenn darin nur wenige Januar-Datensätze passen könnten.
Hier kommen Page-Indizes ins Spiel. Parquet unterstützt optionale Metadaten auf Page-Ebene über ColumnIndex und OffsetIndex, definiert in der Parquet-Page-Index-Spezifikation. ColumnIndex speichert Page-Grenzen und Null-Informationen für eine Spalte. OffsetIndex bildet Pages auf physische Offsets und Zeilenbereiche ab. Zusammen geben sie einem Reader eine feinere Karte innerhalb der Row Group.
Der praktische Effekt lässt sich leicht übersehen, wenn man nur Idealpfad-Tutorials liest. Ohne Page-Indizes weiß eine Engine womöglich, dass eine Row Group prüfenswert ist, liest darin aber trotzdem viele Pages. Mit Page-Indizes kann die Engine nicht passende Pages überspringen und näher an jene springen, die den Filter erfüllen könnten. Bei selektiven Abfragen auf großen Row Groups spart das viel unnötige I/O.
Die Unterscheidung lohnt sich:
Row-Group-Statistiken entscheiden, ob eine Row Group überhaupt gelesen wird.
Page-Indizes entscheiden, welche Pages innerhalb dieser Row Group anzufassen sind.
Auch deshalb kann sich Parquet-Tuning über Werkzeuge hinweg uneinheitlich anfühlen. Die Writer-Unterstützung für Page-Indizes schwankt. Die Reader-Unterstützung ebenso. Eine Engine nutzt Page-Indizes offensiv. Eine andere ignoriert sie und fällt auf reines Row-Group-Pruning zurück. 2026 zeigt sich diese Lücke weiterhin in gemischten Stacks, besonders dort, wo Spark, Trino, Warehouse-Engines und Python-Reader dieselben Dateien anfassen.
Bloom-Filter gehören zur selben Familie von Skip-Work-Features, lösen aber ein engeres Problem. Sie können bei Mitgliedschaftstests auf Spalten hoher Kardinalität wie user_id helfen, vorausgesetzt der Writer hat sie erzeugt und der Reader weiß sie zu nutzen. Wenn Teams sagen, „der Parquet-Pushdown funktioniert nicht mehr“, liegt die Ursache oft nicht am Format selbst. Es ist eine dieser Mechaniken: schwaches Clustering, schwache Statistiken, nicht unterstützte Page-Indizes oder Reader-Verhalten, das auf einen vollständigen Scan zurückfällt.
Diese diagnostische Haltung zählt heute mehr, weil neuere logische Typen wie Variant, Geodaten und der FILE-Typ erweitern, was Teams in Parquet ablegen. Da Dateien komplexere Daten tragen, lautet die Frage nicht mehr nur „Kann ich diese Datei lesen?“. Sie lautet „Welche Teile dieser Datei darf meine Engine gefahrlos überspringen, und welche Metadaten nutzt sie für diese Entscheidung?“
Parquet gegenüber CSV, Avro und ORC
Die Wahl von Parquet wird leichter, wenn Sie aufhören zu fragen, welches Format „das beste“ ist, und stattdessen fragen, welches Zugriffsmuster Sie unterstützen müssen.
CSV ist universell und leicht zu inspizieren. Es ist zugleich schwach bei Schema, Typisierung und selektiven Lesevorgängen. Avro ist zeilenorientiert und passt meist besser, wenn das Schreiben und Lesen vollständiger Datensätze wichtiger ist als das Scannen weniger Spalten. ORC ist wie Parquet spaltenorientiert und bleibt in Hive-lastigen Umgebungen stark. Parquet sitzt in der Mitte als das verbreitetste engine-übergreifende Analytics-Format.
Die Abwägungen auf einen Blick
Format | Layout | Schema | Komprimierung | Scankosten | Schreibkosten | Am besten für |
|---|---|---|---|---|---|---|
Parquet | Spaltenorientiert, gegliedert in Row Groups und Column Chunks | In der Datei eingebettet | Stark, unterstützt durch spaltenorientiertes Layout und Encoding | Niedrig bei selektiven analytischen Abfragen | Höher als reiner Text und oft aufwendiger als einfache Zeilenformate | Analytik, Data Lakes, Austausch zwischen Engines |
CSV | Zeilenorientierter Klartext | Nicht im Format enthalten | Externe Komprimierung möglich, die Datei selbst ist jedoch Text | Hoch, weil Reader vollständige Zeilen parsen und Typen erschließen müssen | Sehr niedrig | Einfacher Export und menschenlesbarer Austausch |
Avro | Zeilenorientiert binär | Starke Schemaunterstützung | Kompakte binäre Codierung | Besser für zeilenweisen Zugriff als für Column Pruning | Gut für schreiblastige Abläufe | Streaming, Ereignisdaten, Lesen auf Zeilenebene |
ORC | Spaltenorientiert | Eingebettetes Schema und Metadaten | Stark | Niedrig bei analytischen Scans | Ähnliche Entwurfsabwägungen wie Parquet | Hive-zentrierte Analytik und Tabellen-Ökosysteme |
Wie Sie über die Entscheidung nachdenken
Nutzen Sie CSV, wenn Portabilität und menschliche Sichtprüfung mehr zählen als analytische Effizienz. Es bleibt die Lingua franca für einfachen Austausch, doch Teams zahlen diese Bequemlichkeit später durch Parsing, schwache Typisierung und verschwendete Lesevorgänge.
Nutzen Sie Avro, wenn Ihnen Zeilentreue, Schemaevolution in Event-Pipelines und schreiblastige Muster wichtig sind. Kafka-nahe Systeme landen aus guten Gründen oft hier.
Nutzen Sie ORC, wenn Ihr Stack an Hive-artige Verarbeitung und ORC-spezifisches Tabellenverhalten gebunden ist. Es löst viele derselben Probleme wie Parquet, doch der Schwerpunkt liegt anders.
Nutzen Sie Parquet, wenn die meisten Workloads gefilterte Scans, Projektionen und Aggregationen über große Datensätze sind. Es ist das Format, das Werkzeugwechsel meist überlebt, weil so viele Reader es verstehen.
Arbeiten mit Parquet in Spark, Hive und Pandas
Das Interessante an Parquet ist nicht read_parquet() selbst. Es ist, dass verschiedene Writer unterschiedliche Fingerabdrücke hinterlassen, und diese Fingerabdrücke wirken auf spätere Lesevorgänge.
Spark, Hive und Pandas können alle mit demselben Parquet-Datensatz arbeiten, schreiben ihn aber nicht immer gleich. Das zeigt sich im Row-Group-Layout, im Sortierverhalten, in der Qualität der Statistiken, in der Partitionsverzeichnisstruktur und darin, wie effizient eine andere Engine später Daten ausschließen kann.
Spark und partitionierte Datensätze
In Spark ist das übliche Muster schlicht: einen DataFrame lesen, transformieren und Parquet zurück in den Object Storage schreiben. Teams kombinieren das oft mit partitionBy(...), was Hive-artige Verzeichnisbäume wie event_date=2026-01-01/ erzeugt. Diese Verzeichnisse werden beim Lesen zu virtuellen Partitionsspalten.
Das ist nützlich, schafft aber auch eine Falle. Teams partitionieren mitunter zu fein und landen bei zu vielen kleinen Dateien. Ist das passiert, zersplittern die Footer-Metadaten über viele Objekte und die Abfrageplanung wird lauter.
Wenn Sie ohnehin die Verlässlichkeit von Databricks oder Spark überwachen, wird Datenqualitätsüberwachung für Databricks relevant, weil Layoutfehler sich zuerst als uneinheitliches Laufzeitverhalten zeigen und nicht als saubere Formatfehler.
Hive und sein ausgereifter Parquet-Pfad
Hive unterstützt Parquet seit Jahren und liest es in vielen Umgebungen nativ über die üblichen Tabellenabstraktionen. Operativ wichtig ist, dass sich eine Hive-Tabelle zwar „logisch“ anfühlt, die Leistung aber weiterhin aus dem darunterliegenden physischen Parquet-Layout kommt. Sind die Dateien schlecht partitioniert oder tragen schwache Statistiken, kann Hive das nicht mit Metadaten allein retten.
Überraschungen bei Pandas und PyArrow
Pandas erreicht Parquet meist über PyArrow oder fastparquet. Mit PyArrow kann die Spaltenauswahl beim Lesen den Hauptvorteil des spaltenorientierten Zugriffs bewahren. Das ist eine gute Gewohnheit, wenn Analystinnen nur einen Ausschnitt des Datensatzes brauchen.
Das subtile Problem liegt beim Schreiben. Eine im Notebook erzeugte Parquet-Datei funktioniert lokal oft gut, verhält sich später aber schlecht, wenn eine andere Engine Filter pushen oder Scans parallelisieren will. Das heißt nicht, dass Pandas falsch liegt. Es heißt, dass Notebook-Standardwerte nicht dasselbe sind wie ein produktionsreifer Speicherentwurf.
Wenn ein Datensatz im Notebook entsteht und in einer geteilten Pipeline endet, schreiben Sie ihn mit Produktionseinstellungen neu, bevor Sie ihn für fertig erklären.
Ein letzter Punkt, den viele Teams übersehen: Ein von Spark geschriebener und von DuckDB gelesener Datensatz kann sich anders verhalten als einer, der von PyArrow geschrieben und von Spark gelesen wird. Gleiches Format, andere Writer-Entscheidungen.
Komprimierung, Encoding, Partitionierung und Schemaevolution
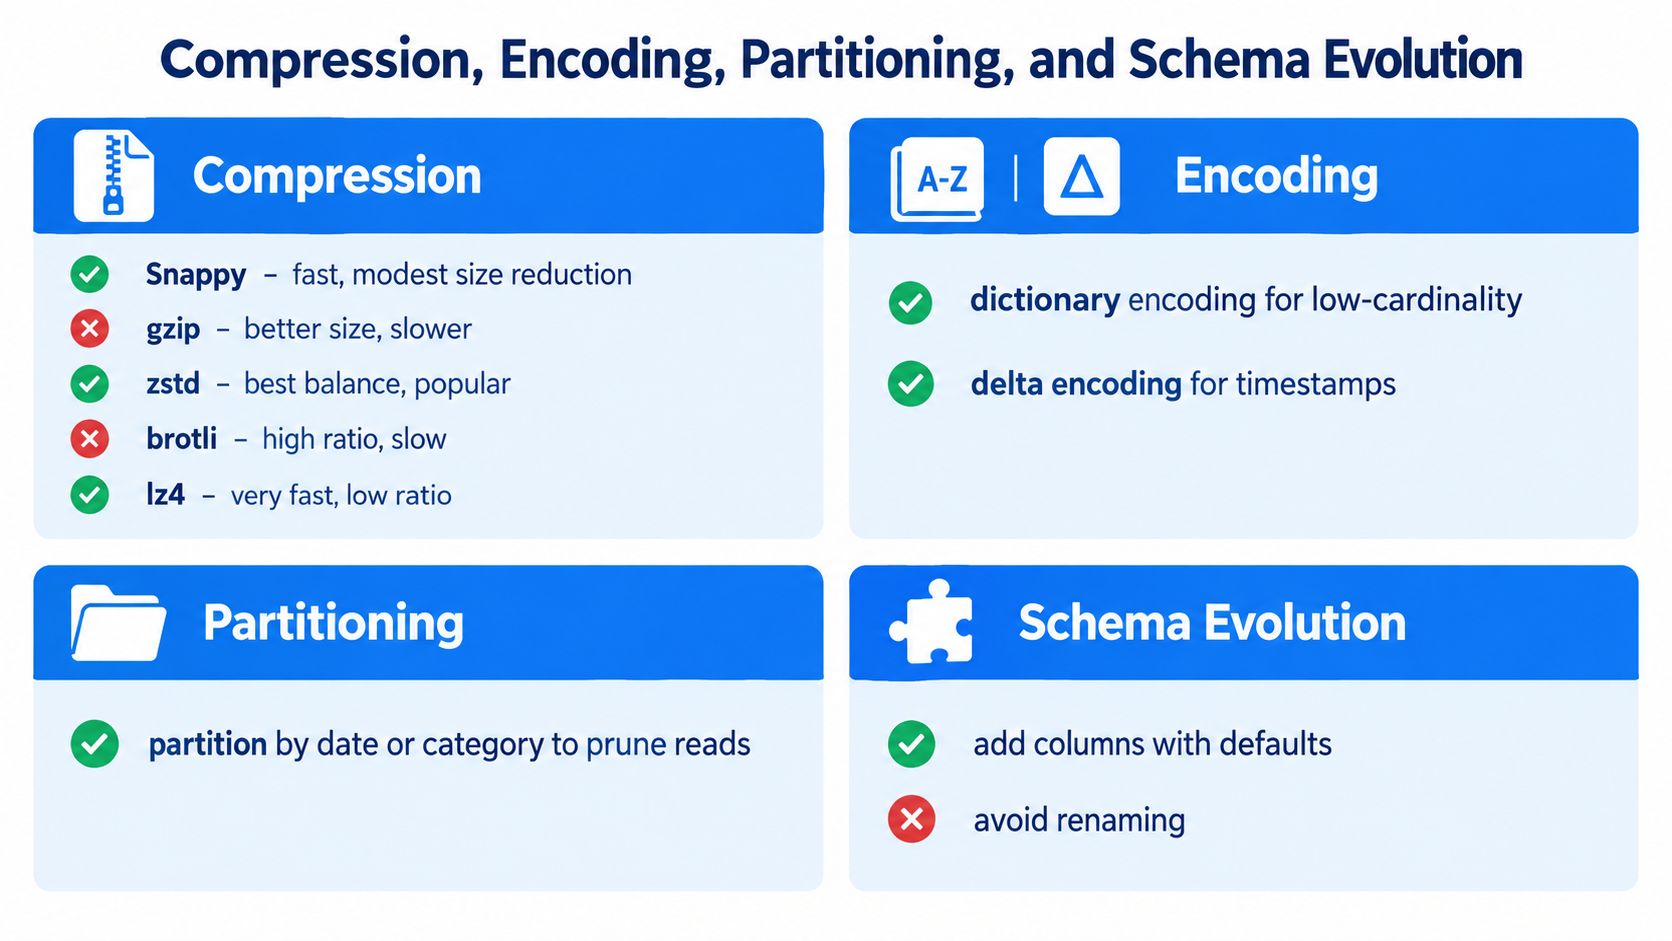
Ein Parquet-Datensatz kann von außen gesund wirken und sich in der Produktion trotzdem schlecht verhalten. Die Dateien öffnen sich. Abfragen liefern Zeilen. Dann scannt eine Tabelle weit mehr Daten als erwartet, eine andere erzeugt Hunderte winziger Dateien, und eine dritte bricht nach einem Writer-Upgrade. Diese vier Stellschrauben erklären das meist: Komprimierung, Encoding, Partitionierung und Schemaevolution.
Komprimierung und Encoding lösen verschiedene Probleme
Komprimierung entscheidet, wie Bytes für die Speicherung gepresst werden. Encoding entscheidet, wie Werte angeordnet sind, bevor die Komprimierung sie sieht.
Diese Unterscheidung zählt, weil eine schwache Encoding-Wahl den Kompressor unnötig arbeiten lässt. Eine starke Encoding-Wahl kann gewöhnliche Komprimierung deutlich besser aussehen lassen.
Bei der Komprimierung geht es meist um CPU gegen Größe:
Snappy ist ein üblicher Standard, wenn schnelle Lese- und Schreibvorgänge mehr zählen als die kleinste Dateigröße.
gzip komprimiert oft stärker, kostet aber mehr CPU.
zstd passt gut zu vielen gemischten Workloads, weil es Verhältnis und Geschwindigkeit oft gut ausbalanciert.
brotli kann sinnvoll sein, wenn Speicherersparnis mehr zählt als Schreibdurchsatz.
lz4 bevorzugt Geschwindigkeit.
Encoding reagiert empfindlicher auf die Gestalt der Spalte. Dictionary Encoding funktioniert gut, wenn eine Spalte denselben kleinen Wertevorrat wiederholt, etwa Ländercodes oder Statusfelder. Delta-Encodings passen zu geordneten Ganzzahlen, Zeitstempeln und anderen Werten, die sich allmählich ändern. Byte Stream Split kann manchen Gleitkommaspalten helfen. Wenn Komprimierung das Packen eines Koffers ist, ist Encoding die Art, wie Sie die Kleidung vorher falten.
Die Row-Group-Größe steckt den Leistungsrahmen ab
Row Groups gehören zu den unscheinbarsten Parquet-Einstellungen und zu den teuersten, wenn man sie falsch setzt. Sie steuern, wie viele Daten für Scan, Skip und parallele Arbeit gebündelt werden.
Die Parquet-Konfigurationsempfehlung rät zu großen Row Groups, weil größere Gruppen oft Scaneffizienz und Komprimierung verbessern. In echten Systemen wählen Teams häufig kleinere Ziele, um Speichergrenzen, Task-Größen und Pruning-Verhalten auszubalancieren. Eine größere Row Group gibt jedem Scan-Task mehr nützliche Arbeit. Eine kleinere gibt der Engine mehr Gelegenheiten, Irrelevantes zu überspringen.
Die Frage ist also nicht, ob größere Row Groups immer besser sind. Die nützliche Frage lautet: Profitieren Ihre Workloads mehr von höherem Scandurchsatz oder von feinkörnigerem Überspringen?
Filtern Analystinnen stark auf einen engen Datumsbereich, können übergroße Row Groups Reader zwingen, mehr Daten zu ziehen als nötig. Besteht der Workload überwiegend aus breiten Tabellenscans, zahlen sich größere Gruppen oft aus.
Partitionierung sollte abbilden, wie Daten tatsächlich gelesen werden
Partitionierung funktioniert am besten, wenn sie einem groben, stabilen Filter folgt, etwa Ereignisdatum, Region oder einem anderen Feld, das in vielen Abfragen auftaucht. Sie funktioniert schlecht, wenn Teams nach Spalten hoher Kardinalität partitionieren, weil diese auf dem Papier selektiv aussehen.
Eine gute Regel ist einfach. Partitionieren Sie für das Auffinden von Dateien, nicht für jedes denkbare Prädikat.
Überpartitionierung erzeugt einen Verzeichnisbaum, der teuer zu listen und teuer zu planen ist und zu einer Flut winziger Dateien neigt. Unterpartitionierung schiebt zu viel Filterarbeit in die Dateien selbst. Das richtige Layout ist meist langweilig. Das ist ein gutes Zeichen.
Das Sortieren innerhalb von Partitionen ist oft genauso wichtig wie die Partitionierung selbst. Liegen Zeilen mit ähnlichen Werten beieinander, haben Parquet-Statistiken und Page-Indizes eine bessere Chance, dem Reader sauberes Überspringen zu ermöglichen.
Bei der Schemaevolution zeigt sich die Kompatibilitätsschuld
Eine Nullable-Spalte hinzuzufügen ist meist einfach. Ein Feld über Engines hinweg umzubenennen, logische Typen zu ändern oder verschachtelte Strukturen umzuschreiben ist der Punkt, an dem Ärger beginnt.
Parquet ist nachsichtig genug, dass Änderungen wochenlang zu funktionieren scheinen, bevor sie in einem nachgelagerten Reader scheitern. Eine Engine deutet einen logischen Typ so, eine andere weitet ihn, eine dritte materialisiert Nullwerte. Deshalb sollte Schemaevolution als Kompatibilitätsprozess behandelt werden und nicht als Häkchen im Dateiformat.
Die Komplexität wächst, weil sich das Parquet-Ökosystem weiter verändert. Der Blog des Apache-Parquet-Projekts verfolgt laufende Arbeiten an Funktionen wie Variant für halbstrukturierte Daten, Geodatentypen und dem logischen Typ FILE sowie breitere Format- und Versionierungsdiskussionen, die für engine-übergreifende Kompatibilität zählen. Diese Funktionen sind nützlich, werfen für Produktionsteams aber eine praktische Frage auf: Welche Reader in Ihrem Stack können sie heute korrekt parsen?
Dort hilft diszipliniertes Schema-Tracking. Ein Werkzeug wie Schema-Drift-Tracking für Parquet-Pipelines kann strukturelle Änderungen erkennen, bevor sie als stille Uneinigkeit zwischen Readern auftauchen.
Die sichere Haltung ist konservativ. Nutzen Sie neuere Parquet-Funktionen, wenn sie ein echtes Problem lösen, aber sichern Sie sie durch Reader-Kompatibilitätsprüfungen ab, testen Sie Dateien, die von den tatsächlichen Engines Ihres Stacks geschrieben wurden, und behandeln Sie Writer-Upgrades als Verhaltensänderung und nicht als Routine-Patch.
Parquet-Dateifehler in der Produktion diagnostizieren
Wenn sich eine Parquet-Datei nicht lesen lässt, schieben Engineers es oft zuerst auf das Format. Das ist meist der falsche Reflex. Aktuelle Community-Hinweise zeigen, dass die härtesten realen Fehler oft mit Dateiintegrität und Transport zu tun haben und nicht mit Parquets Kernentwurf, und dass dasselbe Symptom von Speicher-, Writer- oder Reader-Problemen kommen kann statt allein von der Dateistruktur, wie in den FAQ zur Parquet-Fehlerdiagnose dargelegt.
Besser ist es, Fehler in Archetypen zu sortieren.
Vier Fehlerklassen, die Zeit sparen
Abruffehler
Der Reader hat nie die richtigen Bytes bekommen. Denken Sie an veraltete Objektlisten, falsche Manifesteinträge, unvollständige Downloads oder eine HTML-Fehlerseite, die mit der Endung.parquetgespeichert wurde.Footer-Fehler
Das Objekt existiert, doch der Footer fehlt, ist beschädigt oder unlesbar. Abgeschnittene Uploads und unvollständige Multipart-Writes tauchen hier oft auf.Schema-Bindungsfehler
Die Datei öffnet sich, doch der Reader bildet Typen anders ab, als der Writer es meinte. Sie bekommen stille Nullwerte, kaputte verschachtelte Felder oder Abweichungen bei logischen Typen.Dekodier- und Materialisierungsfehler
Die Metadaten wirken in Ordnung, bis die Engine Pages dekodiert oder Werte in den Speicher materialisiert. Kompressionskompatibilität, Page-Korruption und readerspezifische Grenzen landen oft hier.
Eine praktische Triage-Reihenfolge
Nutzen Sie eine einfache Abfolge, bevor Sie Code ändern:
Prüfen Sie zuerst den Abruf. Bestätigen Sie, dass das Objekt vollständig ist und tatsächlich eine Parquet-Datei, kein falsch benannter Inhalt.
Prüfen Sie die Randmarkierungen und den Footer. Ist das Ende kaputt, hilft nichts darüber.
Inspizieren Sie Schema und logische Typen. Vergleichen Sie Writer-Ausgabe und Reader-Erwartung.
Erst danach debuggen Sie das Dekodierverhalten. Springen Sie nicht zu Codec-Theorien, bevor Sie wissen, dass die Datei vollständig ist.
Kaputte Parquet-Pipelines beginnen oft außerhalb von Parquet. Speicher, Transport, Benennung und Objekt-Lebenszyklusregeln verursachen einen überraschend großen Teil des Schmerzes.
Dateiüberwachung und Pipeline-Observability helfen mehr als Formatwissen allein. Nutzen Teams bereits Data-Lake-Monitoring, können sie fehlende Partitionen, verspätete Ankünfte oder abrupte Schemaverschiebungen oft entdecken, bevor ein Reader einen tieferliegenden Fehler wirft.
Der entscheidende Perspektivwechsel ist einfach. Fragen Sie nicht „Warum ist Parquet kaputt?“. Fragen Sie „An welcher Stelle hörten Bytes, Metadaten, Schemabindung oder Dekodierpfad auf, vertrauenswürdig zu sein?“
Betriebs-Checkliste für Parquet-Dateien in Pipelines
Gesundes Parquet entsteht nicht, weil das Format gut ist. Es entsteht, weil Teams bei jedem Schreiben, Validieren und Veröffentlichen dieselben Regeln anwenden.

Die Checkliste, die ins Runbook gehört
Fixieren Sie Writer-Versionen. Halten Sie Bibliotheksversionen über Jobs hinweg stabil, die denselben Datensatz schreiben. Gemischte Writer erzeugen oft gemischtes Verhalten.
Prüfen Sie Footer-Statistiken. Stellen Sie sicher, dass Row-Group-Metadaten vorhanden und plausibel genug sind, damit Reader wirksam prunen können.
Wählen Sie Row-Group-Ziele bewusst. Viele Teams landen in der Praxis nahe 128 MB, während die Projektempfehlung je nach Workload und Engine-Verhalten 512 MB bis 1 GB für große Row Groups nennt, gemäß der zuvor verlinkten Parquet-Empfehlung.
Prüfen Sie das Partitionslayout. Die Verzeichnisstruktur sollte widerspiegeln, wie Menschen die Daten abfragen.
Testen Sie Schemaevolution vor dem Merge. Hinzugefügte Spalten sind eine Sache. Drift logischer Typen eine andere.
Prüfen Sie Komprimierungs- und Encoding-Entscheidungen. Übernehmen Sie keine Notebook-Standardwerte in der Annahme, sie passten zur Produktion.
Validieren Sie die Transportintegrität. Ein korrekter Writer schützt Sie nicht vor kaputten Uploads oder Überraschungen im Object Store.
Observability und Governance machen das nachhaltig
Diese Checkliste wird nützlicher, wenn sie an automatisierte Prüfungen gebunden ist. Great Expectations kann erwartete Schema- und Inhaltsregeln validieren. Apache Griffin kann Datenqualitätsabläufe unterstützen. Datafold kann helfen, Änderungen über Umgebungen hinweg zu vergleichen. digna ist eine weitere Option in dieser Kategorie. Es läuft in der Umgebung der Kundin oder des Kunden und überwacht Datenverhalten, Timeliness, Validierungen und Schemaänderungen über Pipelines hinweg, was zu jenen stillen Parquet-Regressionen passt, die einfache Dateiprüfungen übersehen.
Governance gehört ebenfalls hierher. Spaltenmetadaten können PII-Kennzeichnungen tragen. Tabellenformate und Katalogschichten können Aufbewahrung und Zugriffsrichtlinien durchsetzen. Berechtigungen im Object Store zählen weiterhin, denn die sauberste Parquet-Datei der Welt nützt nichts, wenn der falsche Job sie überschreiben kann.
Operative Gewohnheit: Behandeln Sie jeden Parquet-Datensatz zugleich als Dateiformat- und als Vertragsproblem. Die Leistung kommt aus dem Format. Die Verlässlichkeit kommt aus dem Vertrag.
Eine Parquet-Datei ist einfach zu nutzen, wenn jemand anderes die richtigen Entscheidungen für Sie getroffen hat. In der Produktion ist Ihr Team dieser Jemand.
Wenn Parquet in Ihrer Umgebung kritische Analytics- oder KI-Workloads trägt, kann digna helfen, genau die Teile zu überwachen, die üblicherweise scheitern: Schema-Drift, fehlende oder verspätete Daten, Qualitätsprobleme auf Satzebene und ungewöhnliches Verhalten über Pipelines hinweg. Das ist besonders nützlich, wenn ein Parquet-Problem gar kein Formatproblem ist, sondern ein Liefer-, Metadaten- oder Vertragsproblem weiter oben. Sehen Sie sich digna an, wenn Sie diese Transparenz in der eigenen Umgebung wollen.
Die Variante dieser Checkliste auf Datensatzebene, fortlaufend statt Datei für Datei angewendet, zeigt sich darin, wie Data Quality Management in der Praxis funktioniert.
Häufig gestellte Fragen
Wann wurde Parquet geschaffen?
Parquet begann als gemeinsame Open-Source-Anstrengung von Twitter und Cloudera, mit Parquet 1.0 im Juli 2013, und wurde am 27. April 2015 zum Top-Level-Projekt der Apache Software Foundation. Sein Entwurf stützte sich auf Dremel-artiges Record Shredding, womit es verschachtelte Strukturen darstellt, ohne Feldnamen in jeder Zeile zu wiederholen.
Wie speichert Parquet verschachtelte Daten wie Structs, Listen und Maps?
Über Dremel-artiges Shredding and Assembly. Der Writer zerlegt verschachtelte Datensätze in spaltenweise Teile und behält genug Positionsinformationen, um sie beim Lesen wieder zusammenzusetzen, sodass Feldnamen nicht je Zeile wiederholt werden. Deshalb bleiben tief verschachtelte Schemata kompakt, statt wie verschachteltes JSON aufzublähen.
Warum lässt sich eine Parquet-Datei nicht lesen?
Integritäts- und Transportprobleme verursachen mehr reale Fehler als das Format selbst. Eine gesunde Datei beginnt und endet mit den Magic Bytes PAR1, sodass eine fehlende Endmarkierung auf Abschneiden, einen unvollständigen Download oder eine als .parquet gespeicherte HTML-Fehlerseite hindeutet. Prüfen Sie den Abruf, bevor Sie Code ändern.
Welche Row-Group-Größe sollte ich verwenden?
Row Groups steuern, wie viele Daten für Scan, Skip und parallele Arbeit gebündelt werden, und gehören zu den teuersten Einstellungen, wenn man sie falsch setzt. Größere Gruppen verbessern die Scaneffizienz, vergrößern aber den Schadensradius bei schwachen Statistiken; kleinere geben Readern mehr Gelegenheiten zum Überspringen. Stimmen Sie sie auf reale Scanmuster ab.
Wie halten Sie Parquet-Datensätze in der Produktion verlässlich?
Wenden Sie bei jedem Schreiben dieselben Regeln an. Fixieren Sie Writer-Versionen, damit Jobs, die einen Datensatz schreiben, kein gemischtes Verhalten erzeugen, partitionieren Sie nach stabilen groben Filtern und validieren Sie mit den Reader-Engines statt nur mit dem Writer. Werkzeuge wie Great Expectations, Apache Griffin, Datafold und digna automatisieren diese Prüfungen.



