Operative Gefahrenanalyse für Datenteams
|
6
min. Lesezeit

Viele Teams behandeln die operative Gefahrenanalyse noch immer wie eine Abnahmeübung. Sie schreiben die Checkliste, geben das Release frei und gehen davon aus, dass das Risikobild bis zum nächsten Review stabil bleibt. Diese Gewohnheit funktioniert im modernen Daten- und KI-Betrieb nicht mehr, denn die Ausfälle, auf die es am meisten ankommt, zeigen sich meist nach dem Deployment, nicht davor.
Statische Reviews übersehen genau die Signale, die Ergebnisse verändern: Schema Drift, verspätete Ladevorgänge, defekte Validierungspfade, sich verschiebende Entscheidungsbefugnisse der Automatisierung und menschliche Workarounds, die in keinem Pre-Launch-Dokument auftauchen. Sicherer ist eine kontinuierliche, datengetriebene Gefahrenanalyse, bei der Observability-Metriken als laufende Evidenz dienen und jede Änderung im Betriebsumfeld die Risikofrage neu aufwerfen kann.
Inhaltsverzeichnis
Operative Gefahrenanalyse im Datenbetrieb neu denken
Eine operative Gefahrenanalyse funktioniert nur, wenn sie dem System folgt und nicht dem Kalender. Ein einmaliges Review kann offensichtliche Designfehler aufdecken, hält aber nicht Schritt mit einer Pipeline, deren Quelldaten, Orchestrierungslogik oder nachgelagerte Nutzung sich Woche für Woche ändern. Diese Lücke ist relevant, weil die Gefahr selten in einem einzelnen Symptom steckt. Meist zeigt sie sich als Kette kleiner Fehler, die zum falschen Zeitpunkt zusammenkommen.
Warum stichtagsbezogene Reviews scheitern
Eine Pipeline kann eine Launch-Checkliste bestehen und trotzdem später riskant werden. Ein Upstream-Team ändert ein Schema, eine Transformation läuft weiter, eine Reporting-Tabelle füllt sich mit Nullwerten, und das Unternehmen handelt weiter auf Basis veralteter Daten, weil niemand diese Ereignisse miteinander verknüpft hat. Genau hier kommt es auf Lebenszyklusdenken an, denn die Gefahr ist nicht die Schemaänderung allein, sondern der kausale Pfad von der Änderung bis zur fehlerhaften Entscheidung.
Praxisregel: Wenn sich das Umfeld ohne formales Release ändern kann, muss sich auch die Gefahrenanalyse ändern, ohne auf ein quartalsweises Review zu warten.
Data Observability wird in diesem Kontext zu mehr als einer Annehmlichkeit für das Engineering. Wenn Verspätungen, Validierungsfehler, Brüche in der Zeilenanzahl oder Schema Drift als Betriebsevidenz erfasst werden, werden sie zum Rohmaterial der Gefahrenanalyse und nicht bloß zu Dashboard-Rauschen. Ein Team, das diese Signale als Sicherheitsinputs behandelt, kann reagieren, bevor das Problem zu Reporting-Verlusten, Modelldegradation oder einem Kontrollversagen führt.
Data Observability wirkt am besten, wenn sie in dieselbe Kontrolldenkweise eingebunden ist, die Sicherheitsprogramme in regulierten Branchen nutzen. Die entscheidende Frage ist nicht, ob eine Pipeline „bestanden“ hat. Sondern ob sich das System noch so verhält, wie die Gefahrenanalyse es angenommen hat.
Von qualitativen Checklisten zu quantitativen Modellen

Die moderne Disziplin begann nicht mit Dashboards. Sie begann, als Sicherheitsingenieure breite Checklisten nicht mehr als ausreichend betrachteten und anfingen zu modellieren, wie sich Ausfälle kombinieren. Die Fehlerbaumanalyse (Fault Tree Analysis) entstand Anfang der 1960er-Jahre als deduktive Methode, die bei einem unerwünschten Ereignis auf Systemebene ansetzt und rückwärts zu den Komponentenausfällen, menschlichen Handlungen und äußeren Bedingungen arbeitet, die es verursachen könnten. Die Bell Laboratories entwickelten sie um 1961 bis 1962 für das Startkontrollsystem der Minuteman-Rakete, und Boeing übernahm sie 1963 für die Sicherheitsanalyse von Verkehrsflugzeugen, was die Gefahrenanalyse in Richtung expliziter Logikmodelle und Wahrscheinlichkeitsberechnungen lenkte. Der NASA-Überblick zur FTA zeichnet diese Entwicklung in sicherheitskritischen Bereichen wie Kernenergie, chemischer Verfahrenstechnik und Pharmazie nach. NASA-Überblick zur FTA
Warum die alte Logik weiterhin zählt
Die zentrale Lehre der FTA ist struktureller Natur: Gefahren lassen sich besser als Kombinationen beobachtbarer Bedingungen verstehen denn als isolierte Vorfälle. Im Datenbetrieb ergeben eine verspätete Quelldatei, eine fehlgeschlagene Validierung und eine unbemerkte Schemaänderung ein nützlicheres Risikomodell als „die Pipeline ist ausgefallen“. Die erste Variante unterstützt Untersuchung und Prävention. Die zweite unterstützt vor allem Schuldzuweisungen.
Ein gutes Gefahrenmodell benennt die Bedingungen, die sich messen lassen, nicht nur das Ergebnis, das alle erst bemerken, wenn der Schaden bereits entstanden ist.
Diese Logik hilft Teams auch, Single Points of Failure und minimale Schnittmengen (Minimal Cut Sets) zu identifizieren, was wichtig ist, wenn eine einzige fragile Abhängigkeit eine komplette Reporting-Kette unterbrechen kann. Ziel ist nicht, Datenplattformen in Luft- und Raumfahrtsysteme zu verwandeln. Ziel ist, dieselbe Disziplin zu nutzen, die Hochrisiko-Engineering überhaupt erst zuverlässiger gemacht hat.
Für Teams, die diese Ideen in moderne Analytics-Praxis übertragen wollen, ist die Monte-Carlo-Simulation eine sinnvolle Ergänzung, wenn der Eingaberaum unsicher ist. Sie ersetzt keine Kausalanalyse, kann aber einem Stresstest unterziehen, wie sich Kombinationen aus Timing-, Volumen- und Transformationsfehlern unter Last verhalten.
Systemgrenzen und Kausalketten abbilden

Eine Gefahrenanalyse ist schwach, wenn die Systemgrenze vage ist. Die Safety-Management-Leitlinien der FAA verlangen, dass Analysten das System und den Betriebskontext definieren, Gefahren detailliert genug zur Risikobestimmung identifizieren, Schweregrad und Eintrittswahrscheinlichkeit analysieren, das Risiko mit Leistungszielen vergleichen und Kontrollen anhand von Betriebsdaten neu bewerten. Diese Lebenszyklussicht passt gut zu Datenplattformen, denn das System umfasst meist Ingestion, Transformation, Speicherung, Orchestrierung, menschliche Prüfung und nachgelagerte Konsumenten. Safety-Management-Leitlinien der FAA
Eine praxistaugliche Systemgrenzen-Karte
Beginnen Sie mit dem gesamten Datenpfad, nicht nur mit der Warehouse-Tabelle, die jeden Morgen abgefragt wird. Beziehen Sie Upstream-Feeds, Batch-Fenster, Stream-Prozessoren, dbt-Modelle, Freigabeschritte, manuelle Overrides und die Teams ein, die die Daten für Reporting oder Automatisierung nutzen. Wenn ein Risiko über ein Upstream-System eintreten und drei Ebenen später sichtbar werden kann, gehört es in dieselbe Analyse.
Formulieren Sie Gefahren anschließend als Kausalketten. Eine Schemaänderung kann eine Transformation brechen, was zu unvollständigem regulatorischem Reporting führen kann, was wiederum ein Kontrollversagen im geschäftlichen Review-Prozess verursachen kann. Das ist ein aussagekräftigerer Eintrag als „Schema Drift“, weil er die auslösende Bedingung, die Auswirkung und den Betriebskontext benennt, in dem der Schaden sichtbar wird.
Datensystemarchitektur spielt hier eine wichtige Rolle, denn die Architektur legt fest, wo Evidenz verfügbar ist und wo Kontrollen platziert werden können. Wenn ein Team nicht genau benennen kann, in welcher Stufe Verspätungen, Null-Spitzen oder ungültige Datensätze erkannt werden, bleibt die Analyse abstrakt.
KI-Agenten-Sicherheit im Finanzwesen ist eine nützliche Referenz, wenn Sie sehen möchten, wie sich die Risikoanalyse verändert, sobald automatisierte Entscheidungen im Spiel sind. Der gemeinsame Nenner ist einfach: Sobald Software handeln kann, muss die Systemgrenze sowohl die Handlung als auch die Bedingungen umfassen, die sie unsicher machen.
Was jeder Gefahreneintrag enthalten sollte
Ein brauchbarer Eintrag erfasst Betriebsmodus, auslösende Bedingung, Auswirkung, Schweregrad, Eintrittswahrscheinlichkeit, bestehende Schutzmaßnahmen, Kontrollverantwortlichen, Erkennungssignal und Freigabeinstanz. So wird aus einer Gefahr, an die man sich erinnert, ein gesteuertes Objekt. Außerdem erleichtert das die Neubewertung bei Systemänderungen, weil das Team genau weiß, welche Annahme verletzt wurde.
Risikobewertung mit beobachtbaren Datenmetriken
Die aussagekräftigsten Risikobewertungen entstehen durch die Kombination von Auswirkung und Eintrittswahrscheinlichkeit, nicht durch das Zählen von Symptomen. Die FAA-Richtlinie definiert Sicherheitsrisiko als Kombination aus Schweregrad und Eintrittswahrscheinlichkeit, und die Praxis auf Basis von MIL-STD-882 bewertet Gefahren über Hardware, Software, Mensch-Maschine-Schnittstellen und Betriebsumgebungen hinweg. Das ist im Datenbetrieb relevant, weil derselbe technische Fehler in einem Geschäftsprozess ein geringes Risiko und in einem anderen ein ernstes Risiko darstellen kann. FAA Order 8040.4B
Observability in ein Risikosignal verwandeln
Ein verspäteter Ladevorgang ist nicht nur ein technisches Ärgernis. Wenn der nachgelagerte Anwendungsfall auf aktuelle Daten angewiesen ist, erhöht die Verspätung die Exposition, weil sie eine Entscheidung verzögert oder einen veralteten Modell-Score einspeist. Ein Ausreißer bei der Null-Rate kann auf eine unvollständige Quellerfassung, einen fehlgeschlagenen Join oder eine defekte Transformation hindeuten, und jede dieser Ursachen beeinträchtigt die Glaubwürdigkeit des Ergebnisses auf andere Weise.
Risikokomponente | Abstrakte Definition | Beobachtbare Datenmetrik |
|---|---|---|
Eintrittswahrscheinlichkeit | Wie oft die Gefahr eintreten kann | Ladeverspätungen, Rate fehlgeschlagener Validierungen |
Schweregrad | Wie schwerwiegend die Folgen sein könnten | Auswirkung auf Business-KPIs, Vollständigkeit des regulatorischen Reportings |
Erkennung | Wie schnell das Team das Problem sehen kann | Alert-Latenz, Brüche in der Zeilenanzahl |
Kontrollstärke | Wie gut Schutzmaßnahmen das Problem blockieren oder sichtbar machen | Erkennung von Schemaänderungen, Validierungsabdeckung |
Die Tabelle ist am nützlichsten, wenn Teams sie nicht mehr als Reporting-Artefakt behandeln, sondern zur Priorisierung ihrer Arbeit nutzen. Ein wiederholt verspäteter Feed mit schwacher Erkennung erfordert einen anderen Kontrollplan als ein isoliertes Formatierungsproblem, das vor der Veröffentlichung abgefangen wird. Das ist der Unterschied zwischen einem ordentlichen Log und einem echten Risikomodell.
Betriebsregel: Bewerten Sie die glaubwürdige Auswirkung des kausalen Szenarios und passen Sie die Bewertung an, nachdem Kontrollen angewendet wurden.
Was eine Bewertung belastbar macht
Eine belastbare Bewertung ist nachvollziehbar. Wenn ein Schadensdatensatz verspätet eintrifft, sollte das Team auf die Verspätungshäufigkeit, den Erkennungspfad, die geschäftliche Exposition und die Kontrolle verweisen können, die das Restrisiko reduziert hat. Nur so wird die Akzeptanz des Restrisikos von einer vagen Geste zu einer dokumentierten Entscheidung.
Für einen tieferen Blick auf die Metrikebene sind Data-Observability-Metriken die praktische Brücke zwischen Plattformverhalten und Risikobewertung. Sie geben der Analyse eine messbare Grundlage statt einer pauschalen Beruhigungsaussage.
Testbare Kontrollen für die menschliche Aufsicht gestalten
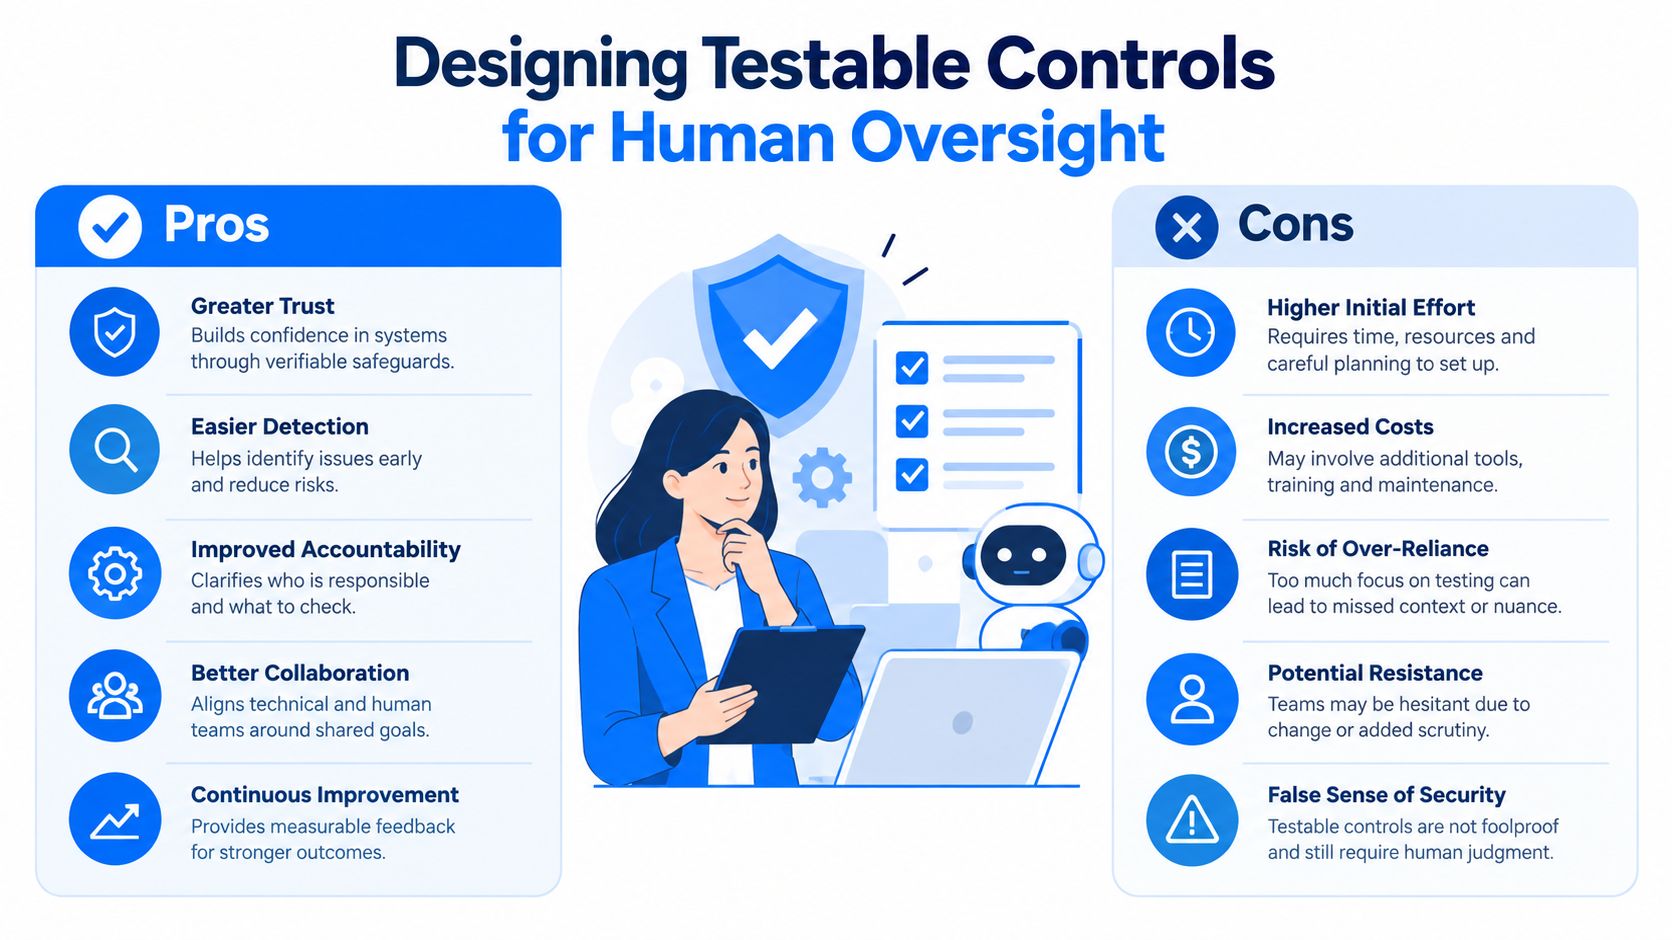
Menschliche Prüfung wird vielen Kontrollplänen hinzugefügt, weil sie sicher klingt. In der Praxis kann sie auf subtile Weise versagen. Regulierungsbehörden und Sicherheitsorganisationen betonen immer wieder, dass die menschliche Verantwortung nicht verschwindet, wenn KI beteiligt ist, und empfehlen, Arbeitsbelastung, Aufmerksamkeit, Entscheidungsfindung, Rollenklarheit, Eskalationsverhalten und Reaktionen auf falsche oder zurückgehaltene Empfehlungen zu testen. Leitlinien zu Human Factors
Human-in-the-Loop ist für sich allein keine Kontrolle
Ein Prüfer, der zu viele Alerts erhält, beginnt zu triagieren statt zu validieren. Ein Prüfer, der unklare Erklärungen sieht, akzeptiert den Output des Systems, weil Widerspruch zu lange dauert. Ein Prüfer, der nicht weiß, wer für die Eskalation zuständig ist, bemerkt das Problem womöglich und lässt es trotzdem durchgehen.
Deshalb muss menschliche Aufsicht testbar sein. Simulieren Sie degradierte Daten, verzögerte Inputs, Schemaänderungen, widersprüchliche Signale, Automatisierungsausfälle und hohe Arbeitslast, und messen Sie dann Erkennungszeit, Qualität der Overrides, Abschluss von Eskalationen, Wiederherstellungszeit und Wiederholungsrate. Diese Ergebnisse zeigen Ihnen, ob der Mensch die Zeit, die Informationen, die Befugnis und die Kompetenz hat, einzugreifen.
Ein zusätzlicher Prüfer kann das Risiko erhöhen, wenn er überflutet, unzureichend geschult oder am Handeln gehindert wird.
Genau diesen Punkt übersehen viele Teams. Eine menschliche Ebene ist nicht automatisch eine präventive Kontrolle. In manchen Umgebungen wird sie zum Engpass, der Verzögerung ohne zusätzliche Sicherheit bringt, vor allem wenn der Alert-Strom verrauscht oder die Systemerklärung schwach ist.
Wie sich Aufsicht messbar machen lässt
Halten Sie fest, wann der Operator das Problem gesehen hat, ob er es hinterfragt hat, welche Maßnahme er ergriffen hat und ob sich das System sauber erholt hat. Bewahren Sie diese Evidenz neben der technischen Telemetrie auf, denn ein nominell erfolgreicher Workflow kann dennoch unsicheres menschliches Verhalten verbergen. Wenn der Operator raten, aufschieben oder den Prozess umgehen muss, ist die Kontrolle noch nicht ausgereift.
Kontinuierliches Monitoring in regulierten Branchen
Ein Team im Finanzdienstleistungssektor kann auf dem Papier alles richtig machen und die Gefahr in der Praxis dennoch übersehen. Ein Transaktions-Feed, der normalerweise pünktlich eintrifft, kommt zunehmend später als üblich, doch die Volumenänderung ist so gering, dass ein statischer Schwellenwert nie auslöst. Der Report wird weiterhin erzeugt, das Dashboard aktualisiert sich weiterhin, und die veralteten Daten fließen unbemerkt in einen Entscheidungsprozess, der von aktuellen Daten ausgeht.
Kontinuierliches Monitoring verändert dieses Fehlerbild. In einem regulierten Umfeld müssen Business-KPIs, Schema Drift, Aktualität, Validierung und Plattformzustand gemeinsam überwacht werden. digna für Datenqualität und Compliance passt zu diesem Modell, weil die Plattform in der eigenen Umgebung des Kunden bleibt und das Datenverhalten direkt vor Ort überwacht, wodurch die Betriebsevidenz nah an dem System bleibt, das sie schützt.
Warum starre Schwellenwerte in regulierten Umgebungen scheitern
Eine starre Regel erkennt nur das, wofür sie geschrieben wurde. Sie übersieht einen Ladevorgang, der zwar vorhanden, aber verspätet ist, oder eine Schemaänderung, die Syntaxprüfungen besteht und dennoch eine nachgelagerte Annahme bricht. Außerdem gerät sie ins Hintertreffen, wenn sich der geschäftliche Kontext schneller ändert als das Regelwerk.
Kontinuierliches Monitoring funktioniert besser, weil es ungewöhnliche Verhaltenskombinationen erkennen kann und nicht nur isolierte Schwellenwertüberschreitungen. Das ist im Gesundheitswesen, im Finanzsektor, in der Telekommunikation und im öffentlichen Sektor wichtig, wo eine subtile Verschiebung von Volumen oder Struktur zu einem Reporting- oder Serviceproblem werden kann, bevor jemand ein Incident-Ticket eröffnet.
Die besten Alerts sind frühzeitig, spezifisch und mit einer geschäftlichen Auswirkung verknüpft, die der Verantwortliche bereits versteht.
Datenplattform und Kontrollsystem überschneiden sich an dieser Stelle. Wenn die Observability-Schicht kritische Geschäftsregeln validieren, strukturelle Änderungen verfolgen und auffällige Muster sichtbar machen kann, ohne Produktivdaten aus der Umgebung herauszubewegen, bleibt die Risikoevidenz sowohl für den Betrieb als auch für Audits nutzbar. Im regulierten Datenbetrieb unterstützt dieselbe Evidenz zudem einen lückenlosen Compliance-Nachweis, wie digna für Datenqualität und Compliance zeigt.
Was gutes operatives Monitoring braucht
Gutes Monitoring leistet drei Dinge gleichzeitig. Es erkennt das Verhalten der Pipeline, validiert die geschäftliche Bedeutung und bewahrt den Nachweis, dass die Kontrolle funktioniert hat. Fehlt eines dieser Elemente, erhält das Team Rauschen statt Gewissheit.
Neubewertung bei Systemänderungen auslösen

Die operative Gefahrenanalyse für KI-gestützte Abläufe wird noch immer zu oft als einmalige Übung vor dem Deployment behandelt, obwohl sich die größten Risiken meist erst nach dem Deployment zeigen. Aktuelle Sicherheitsleitlinien betonen schrittweise Einführung, kontinuierliches Monitoring, Change Control, lokale Validierung und klare Verantwortlichkeiten, statt anzunehmen, dass ein Modell oder ein automatisiertes System nach der Freigabe sicher bleibt. FAA-Sicherheitsleitlinien zu KI-gestützten Abläufen
Was ein neues Review auslösen sollte
Eine Neubewertung sollte beginnen, wenn sich das System so verändert, dass sich das Risiko ändern kann. Dazu gehören neue Modell- oder Softwareversionen, veränderte Verteilungen der Eingangsdaten, neue Entscheidungsbefugnisse der Automatisierung, auffällige Override-Muster, personelle Veränderungen, Vorfälle und Beinahe-Vorfälle. Ebenso gehören Prozessänderungen dazu, die beeinflussen, wer einen Alert sieht, wer eine Entscheidung freigeben darf oder wie schnell eine Wiederherstellung erfolgen kann.
Für Teams, die mit regulierten Daten oder automatisiert erzeugten Inhalten arbeiten, ist eine nützliche verwandte Referenz die Übersicht zu Regeln für KI-generierte Videos. Der Grund ist einfach: Wenn ein automatisiertes System verändert, was Menschen sehen, wem sie vertrauen oder was sie freigeben, muss die Risikoanalyse sowohl den Output als auch die menschliche Reaktion abdecken.
Wie die Evidenzkette nutzbar bleibt
Dokumentieren Sie Unsicherheit, Nutzerreaktion, nachgelagerte Maßnahme, Schweregrad, betroffene Teilgruppe, Korrekturmaßnahme und Wiederauftreten. Das gibt dem nächsten Review genug Kontext, um zu beurteilen, ob die Gefahr vollständig behoben oder nur unterdrückt wurde. Außerdem verhindert es den häufigen Fehler, dass ein Modell im Aggregat genau wirkt, aber dennoch operativen Schaden verursacht, weil Menschen ihm zu sehr vertrauen, es ignorieren oder nicht schnell genug auf seinen Output reagieren können.
Der stärkste Prozess ist ereignisgesteuert, nicht kalendergesteuert. Wenn sich die Daten, der Workflow oder das Befugnismodell ändern, sollte die Gefahrenanalyse automatisch neu aufgerollt und die Kontrollevidenz entsprechend aktualisiert werden.
digna hilft Teams, Pipeline-Metriken, Schema Drift, Validierungsergebnisse und Aktualitätssignale in ihrer eigenen Umgebung in kontinuierliche Gefahrenindikatoren zu verwandeln. Wenn Sie statische Checklisten durch laufende Betriebsevidenz ersetzen, besuchen Sie digna und erfahren Sie, wie Data Observability einen sichereren und verantwortungsvolleren Datenbetrieb unterstützen kann.
Verspätete Ladevorgänge gehören zu den häufigsten auslösenden Bedingungen in diesen Kausalketten, daher hängt die Bewertung der Eintrittswahrscheinlichkeit davon ab, sie früh zu erkennen. Das Timeliness-Modul von digna lernt das normale Ankunftsmuster jeder Tabelle und meldet Daten, die verspätet oder gar nicht eintreffen, wodurch der Gefahreneintrag ein messbares Erkennungssignal erhält.
Häufig gestellte Fragen
Was ist eine operative Gefahrenanalyse im Datenbetrieb?
Die operative Gefahrenanalyse ermittelt, wie sich Ausfälle in einem laufenden System zu einem Schaden verketten können, und steuert diese Risiken anschließend. Im Datenbetrieb folgt sie dem gesamten Datenpfad, von Upstream-Feeds und dbt-Modellen über manuelle Overrides bis zu den nachgelagerten Konsumenten, und wird bei jeder Änderung des Systems neu aufgerollt.
Warum scheitern stichtagsbezogene Gefahrenreviews bei Data Pipelines?
Weil die meisten schädlichen Ausfälle erst nach dem Deployment auftreten. Eine Pipeline kann ihre Launch-Checkliste bestehen, dann füllt eine Schemaänderung im Upstream eine Reporting-Tabelle mit Nullwerten, während die Transformation weiterläuft, und das Unternehmen handelt auf Basis veralteter Daten. Ein quartalsweises Review kann keine Kausalkette erkennen, die sich zwischen zwei Reviews bildet.
Wie lassen sich Observability-Metriken zur Bewertung von Gefahrenrisiken nutzen?
Ordnen Sie jeder Risikokomponente ein messbares Signal zu. Die Eintrittswahrscheinlichkeit kann aus Ladeverspätungen und fehlgeschlagenen Validierungen abgeleitet werden, der Schweregrad aus den Auswirkungen auf Business-KPIs oder der Vollständigkeit des regulatorischen Reportings, die Erkennung aus Alert-Latenz und Brüchen in der Zeilenanzahl und die Kontrollstärke aus Schemaänderungserkennung und Validierungsabdeckung. Bewerten Sie nach Anwendung der Kontrollen neu.
Was sollte ein Gefahreneintrag enthalten?
Ein brauchbarer Gefahreneintrag enthält Betriebsmodus, auslösende Bedingung, Auswirkung, Schweregrad, Eintrittswahrscheinlichkeit, bestehende Schutzmaßnahmen, Kontrollverantwortlichen, Erkennungssignal und Freigabeinstanz. Werden Gefahren als Kausalketten formuliert, etwa Schemaänderung, dann fehlerhafte Transformation, dann unvollständiges regulatorisches Reporting, zeigt sich bei einer Systemänderung genau, welche Annahme verletzt wurde.
Wann sollte eine operative Gefahrenanalyse neu bewertet werden?
Immer dann, wenn eine Änderung das Risiko verändern kann, nicht nach festem Kalender. Auslöser sind unter anderem neue Modell- oder Softwareversionen, veränderte Verteilungen der Eingangsdaten, neue Entscheidungsbefugnisse der Automatisierung, auffällige Override-Muster, personelle Veränderungen, Vorfälle und Beinahe-Vorfälle sowie Prozessänderungen, die beeinflussen, wer einen Alert sieht oder wer eine Entscheidung freigeben darf.


